Multivariat testing: hva testen av innholdsvariantene kan fortelle deg
Å endre overskrift og bilde samtidig kan hjelpe deg å velge en ferdig variant. For å lære om hvert element trengs en annen sammenligning. Historiske Upworthy-design viser hvilke muligheter som kan bestå selv når noen kombinasjoner mangler.
Influence IQs analyse av den utforskende delen av Upworthy Research Archive, med nettsideforsøk fra tidlig i 2013 til april 2015. Hovedsammenligningen har 188 kvalifiserte tester som varierte både overskriftstekst og bilde-ID-er. Dette er en kartlegging av forsøksdesign, ikke en analyse av klikk eller kampanjeresultater.
Sammendrag
Et ufullstendig multivariat design kan fortsatt gi separate sammenligninger av overskrifter eller bilder. Blant 188 kvalifiserte Upworthy-tester som varierte både overskriftstekst og bilde-ID-er, inneholdt 31 alle kombinasjoner. Av de andre 157 hadde 150 minst 1 sammenligning der enten overskriften eller bildet ble holdt fast; 75 hadde begge typer. Tallene beskriver kombinasjonene som fantes, ikke om testene ga pålitelige eller nyttige resultater om ytelse. [1]
Studien bruker et historisk, utforskende delutvalg av nettsideforsøk fra tidlig i 2013 til april 2015. Utdragsteksten holdes lik, og hovedutvalget utelater en dokumentert periode med mulige problemer med fordelingen mellom variantene. Når perioden tas med, er hovedlærdommen den samme: 180 av 199 ufullstendige design beholder minst 1 slik sammenligning. For bedrifter og innholdsskapere er det praktiske valget å tilpasse kombinasjonene til spørsmålet: velge en hel variant, sammenligne 1 element eller undersøke hvordan 2 elementer virker sammen.
Teamet har 2 kampanjeversjoner klare. Den ene kombinerer et produktbilde med en direkte overskrift; den andre bruker et annet bilde og en mer samtalepreget overskrift. Hva har dere lært hvis én gjør det bedre?
En godt gjennomført sammenligning kan hjelpe dere å velge mellom disse ferdige versjonene. Den viser ikke i seg selv hvilken endring som utgjorde forskjellen. Multivariat testing varierer mer enn 1 element i et sett med kombinasjoner. Start med å spørre hva kombinasjonene skal hjelpe dere å avgjøre.
Antallet versjoner alene svarer ikke på spørsmålet. 4 overskrifter med 1 bilde lar teamet sammenligne overskrifter i den situasjonen. 2 overskrifter med 2 bilder gir også 4 varianter når alle par tas med, men åpner for andre sammenligninger. Ved å skrive opp parene blir forskjellen synlig før testen begynner.
En ferdig innholdsvariant rommer flere valg
Ufullstendige design beholdt ofte en nyttig sammenligning
Vi undersøkte kombinasjoner av overskrift og bilde innenfor hver enkelt Upworthy-test på nettstedet. Av 3 212 tester som oppfylte hovedkriteriene, varierte 188 begge elementer. De fleste andre varierte bare ett. Hver test ble holdt atskilt og telt én gang, uansett hvor mange som kan ha sett den. [2]
Bare 31 av de 188 inneholdt alle kombinasjoner av de observerte overskriftene og bilde-ID-ene. De andre 157 var ufullstendige rutenett. Det virker begrensende til man ser hvilke sammenligninger som fortsatt fantes. Av de 157 hadde 75 både en overskriftssammenligning med samme bilde og en bildesammenligning med samme overskrift. Ytterligere 30 hadde bare den første typen og 45 bare den andre. 7 hadde ingen av dem.
Til sammen beholdt 150 av de 157 ufullstendige designene, eller 95,5 %, minst 1 måte å sammenligne et element på mens det andre ble holdt fast. Dette beviser ikke at sammenligningen hadde nok trafikk, forsvarlig fordeling mellom variantene eller et meningsfullt resultat. Det viser hvorfor «ikke alle kombinasjoner ble testet» er en for vid begrunnelse for å avvise et design.
Tabellen viser komplette og ufullstendige design sammen. Av alle 188 hadde 106 begge sammenligningstyper, 30 bare overskriftssammenligninger, 45 bare bildesammenligninger og 7 ingen av dem. «Begge» betyr minst 1 av hver, ikke at alle overskrifter eller bilder kan sammenlignes på like vilkår.
Den opprinnelige arkivartikkelen forklarer allerede at redaktørene ofte valgte varianter uten å teste alle mulige kombinasjoner. Vårt bidrag er kartleggingen av sammenligningene valgene lot stå åpne. Vi kan ikke rekonstruere hver redaktørs mål eller vurdere om et design oppfylte det. [1]
De fleste design som endret begge elementer, beholdt en sammenligning av én del
188 kvalifiserte historiske Upworthy-tester som varierer overskriftstekst og bilde-ID-er, med lik utdragstekst og den angitte datoavgrensningen. Hver test teller likt.
| Sammenligninger som finnes i designet | Tester | Andel av 188 tester |
|---|---|---|
| Både overskrifts- og bildesammenligning | 106 | 56,4 % |
| Bare overskriftssammenligning | 30 | 16,0 % |
| Bare bildesammenligning | 45 | 23,9 % |
| Ingen separat sammenligning av elementene | 7 | 3,7 % |
3 design svarer på ulike spørsmål
Se for deg et keramikkstudio som markedsfører et helgekurs. Det har 2 overskrifter: A, «Lag din første keramikkskål», og B, «Tilbring lørdagen ved dreieskiven». Bilde 1 viser en ferdig skål, og bilde 2 viser dreieskiven. Dette er illustrerende valg, ikke Upworthy-eksempler eller målte kampanjeresultater. Hold tilbudet og annen vist tekst lik mens du vurderer 3 mulige design.
Det første, komplette rutenettet har A med bilde 1, A med bilde 2, B med bilde 1 og B med bilde 2. Teamet kan sammenligne overskriftene med bilde 1 fast og gjenta sammenligningen med bilde 2. Bildene kan også sammenlignes under hver overskrift. De 4 cellene gir disse mulighetene, men fastslår ikke hvor mye dokumentasjon som samles i hver celle.
Det andre, delvis utfylte rutenettet har A med bilde 1, B med bilde 1 og B med bilde 2. A med bilde 2 mangler. Teamet kan sammenligne A og B med bilde 1 fast. Det kan også sammenligne bildene med overskrift B fast. Den manglende cellen fjerner ikke disse 2 sammenligningene.
Men det delvise rutenettet kan ikke besvare et annet spørsmål med en direkte sammenligning av 4 celler: Ville forskjellen mellom A og B vært den samme med bilde 2? Det finnes ikke noe resultat for A med bilde 2. Teamet kan heller ikke finne den beste av alle 4 mulige varianter ved bare å velge blant de 3 observerte. Den utestede varianten kan oppføre seg annerledes.
Det tredje, diagonale designet har bare A med bilde 1 og B med bilde 2. Ingen av elementene holdes fast mellom de 2 variantene. En gyldig test kan fortsatt støtte valget mellom disse 2 ferdige versjonene, men vil ikke alene skille bidraget fra overskrift og bilde.
Ingen av designene er best i alle situasjoner. Hvis studioet må velge mellom 2 godkjente konsepter til en bestemt lansering, kan sammenligning av hele varianter passe. Hvis en overskrift skal gjenbrukes på tvers av bilder, trengs dokumentasjon relevant for det bredere valget. Flere kombinasjoner forsvares når de svarer på et spørsmål teamet faktisk har. [3]
3 illustrerende design har ulike kombinasjoner
Et oppdiktet keramikkstudio med 2 overskrifter, A og B, og 2 bilder, 1 og 2. Cellene illustrerer design og er ikke observasjoner fra arkivet.
| Kombinasjon av overskrift og bilde | Komplett rutenett | Delvis utfylt rutenett | Diagonalt design |
|---|---|---|---|
| Overskrift A + bilde 1 | 1 | 1 | 1 |
| Overskrift A + bilde 2 | 1 | 0 | 0 |
| Overskrift B + bilde 1 | 1 | 1 | 0 |
| Overskrift B + bilde 2 | 1 | 1 | 1 |
En sammenligning i hver retning er ikke en fullstendig 2×2-test
Arkivet gjør skillet konkret. Av de 106 designene med begge sammenligningstyper hadde 74 ikke engang 1 fullstendig rektangel med 2 overskrifter og 2 bilder. Et design kan altså gi en overskriftssammenligning ett sted og en bildesammenligning et annet uten de 4 cellene som trengs for å sammenligne forskjellene direkte.
Se på studioets delvise rutenett igjen. Å sammenligne A og B med bilde 1 svarer på ett spørsmål. Å sammenligne bilde 1 og bilde 2 under B svarer på et annet. Ingen av dem forteller om selve overskriftsforskjellen endres når bildet byttes. Det tredje spørsmålet gjelder samspill: om forholdet mellom ett element og responsen avhenger av det andre elementet.
I settet med 188 design hadde 32 minst 1 fullstendig rektangel. Det omfatter alle de 31 komplette rutenettene og 1 større ufullstendig rutenett. Et slikt rektangel gir et grunnlag for en direkte samspillskontrast. Det viser ikke at samspill finnes, og er ikke det eneste mulige grunnlaget for å undersøke samspill med andre design eller modellforutsetninger.
For et kampanjeteam hører skillet hjemme i grunnlaget før det hører hjemme i en statistisk modell. «Sammenlign disse 2 overskriftene med dette bildet» er en snevrere bestilling enn «finn en overskrift som fungerer på tvers av bildene våre». Et svar på det første spørsmålet bør ikke ubemerket bli et svar på det andre.
Et bredere tidsrom gir samme lærdom for planleggingen
Hovedkartleggingen utelater tester med et opprettelsesdatospenn som berører perioden 25. juni 2013 til 10. januar 2014. Arkivforskerne identifiserte mulige problemer med fordelingen mellom variantene i dette tidsrommet. Dette er viktig for årsaksforskning, men gjør ikke kombinasjonsregistreringene ubrukelige for en strukturell kartlegging. Vi gjentok derfor også sammenligningen med perioden inkludert. [4]
Det bredere utvalget inneholder 239 tester som varierer begge elementer. 40 har alle kombinasjoner, og 199 er ufullstendige. Blant de ufullstendige beholder 180, eller 90,5 %, minst 1 sammenligning med 1 element fast, mens 93, eller 46,7 %, beholder begge typer. Tilsvarende andeler i hovedutvalget er 95,5 % og 47,8 %. De nøyaktige andelene flytter seg, men ufullstendige design beholder fortsatt ofte en bestemt sammenligning.
Vi kontrollerte også et valg i tekstbehandlingen. Hovedanalysen sammenligner overskrift- og utdragstekst nøyaktig. Når blanktegn i starten og slutten fjernes og gjentatte blanktegn slås sammen, får vi 189 tester som varierer begge elementer. Utvalget har 31 komplette rutenett, 108 tester med begge sammenligningstyper og 32 med et fullstendig rektangel. Denne kontrollen endrer hvilke design som kvalifiserer, så antallene vises med egen nevner. [5]
Median dekning er 50 % i alle de 3 utvalgene. Dekning er antall observerte overskrift–bilde-kombinasjoner delt på antallet som er mulig med testens observerte overskrifter og bilde-ID-er. Medianen er en beskrivelse, ikke en kvalitetsskår. En manglende kombinasjon kan ha vært irrelevant, uegnet eller utenfor redaktørens tilsiktede sammenligning. Arkivet avgjør ikke hvorfor den ble utelatt.
Endret avgrensning bevarer skillet mellom dekning og sammenligninger
Alle kolonnene teller tester, og hver rad har egen nevner for tester som varierer begge elementer. Tekstbehandlingskontrollen beholder hovedavgrensningen for dato, mens kontrollen med alle perioder beholder nøyaktig tekstbehandling.
| Analyseavgrensning | Tester som endrer begge elementer | Komplette rutenett | Begge sammenligningstyper | Minst 1 komplett 2×2 |
|---|---|---|---|---|
| Hovedutvalg: nøyaktig tekst, datoavgrensning | 188 | 31 | 106 | 32 |
| Blanktegnsnormalisert tekst, datoavgrensning | 189 | 31 | 108 | 32 |
| Nøyaktig tekst, alle perioder inkludert | 239 | 40 | 133 | 42 |
La beslutningen styre grunnlaget for neste test
For keramikkstudioet begynner planleggingen med hva som skal skje etter testen. Skal teamet velge én ferdig kurskampanje, beholde 1 bilde og endre overskriften, eller bruke en overskrift i flere senere design? Hvert valg krever ulike sammenligninger. Et større rutenett er ikke automatisk bedre bruk av teamets innsats.
Gjelder beslutningen ferdige varianter, før dem opp uten å love en forklaring på hver del. Gjelder den en overskrift, angi hvilket bilde som skal holdes fast. Må teamet undersøke om overskriftsforskjellen endres på tvers av 2 bilder, ta med de relevante 4 kombinasjonene eller skaff et faglig begrunnet alternativt design. Hold dette atskilt fra valg av responsmål, fordeling og observasjonsperiode.
Kontroller at de foreslåtte kombinasjonene gir mening før de legges til. En tilbudsspesifikk overskrift kan passe til bare 1 produktbilde. Å lage et uegnet par bare for å fylle rutenettet ville endre oppgaven. Teamet kan heller snevre inn spørsmålet eller lage versjoner som kan kombineres fornuftig. Et komplett rutenett er nyttig når sammenligningene støtter beslutningen, ikke fordi en fylt tabell ser grundigere ut.
Bruk disse feltene som et kort planleggingsgrunnlag. Teksten i hakeparenteser skal fylles ut for egen kampanje og er ikke et funn fra studien.
Beslutning etter testen: [velg en ferdig variant; sammenlign et navngitt element i en angitt situasjon; undersøk en bestemt kombinasjon av elementer].
Elementer og versjoner: [nøyaktige overskriftstekster; bildefiler eller stabile ID-er; annet innhold som endres].
Inkluderte varianter: [overskrift–bilde-parene som faktisk skal vises].
Nødvendige sammenligninger: [hvilke par som holder et element fast; hvilke 4 celler som støtter samspillsspørsmålet, hvis aktuelt].
Dokumentasjonsplan: [responsmål; målgruppe og fordeling mellom variantene; eksponeringsvilkår; planlagt observasjon og regel for gjennomgang].
Grense for konklusjonen: [hva designet kan underbygge; hvilke utestede kombinasjoner eller situasjoner som ligger utenfor beslutningen].
Et studio som bruker det delvise designet med 3 celler, kan for eksempel skrive: «Vi skal sammenligne overskriftene med bilde 1 og bildene med overskrift B. Vi tester ikke overskrift A med bilde 2.» Setningen holder de 2 nyttige spørsmålene og den manglende sammenligningen synlige uten å erklære designet utilstrekkelig.
En innholdsskaper som arbeider for en kunde, kan bruke samme skille i en samtale om endret miniatyrbilde og tittel. Spørsmålet er hvilken versjon eller hvilket element kunden vil velge. Tallene våre kommer imidlertid fra en utgivers nettsted og fastslår ikke hvordan en nåværende sosial plattform fordeler eller måler innholdsvarianter.
Behold spørsmålet ved siden av kombinasjonene
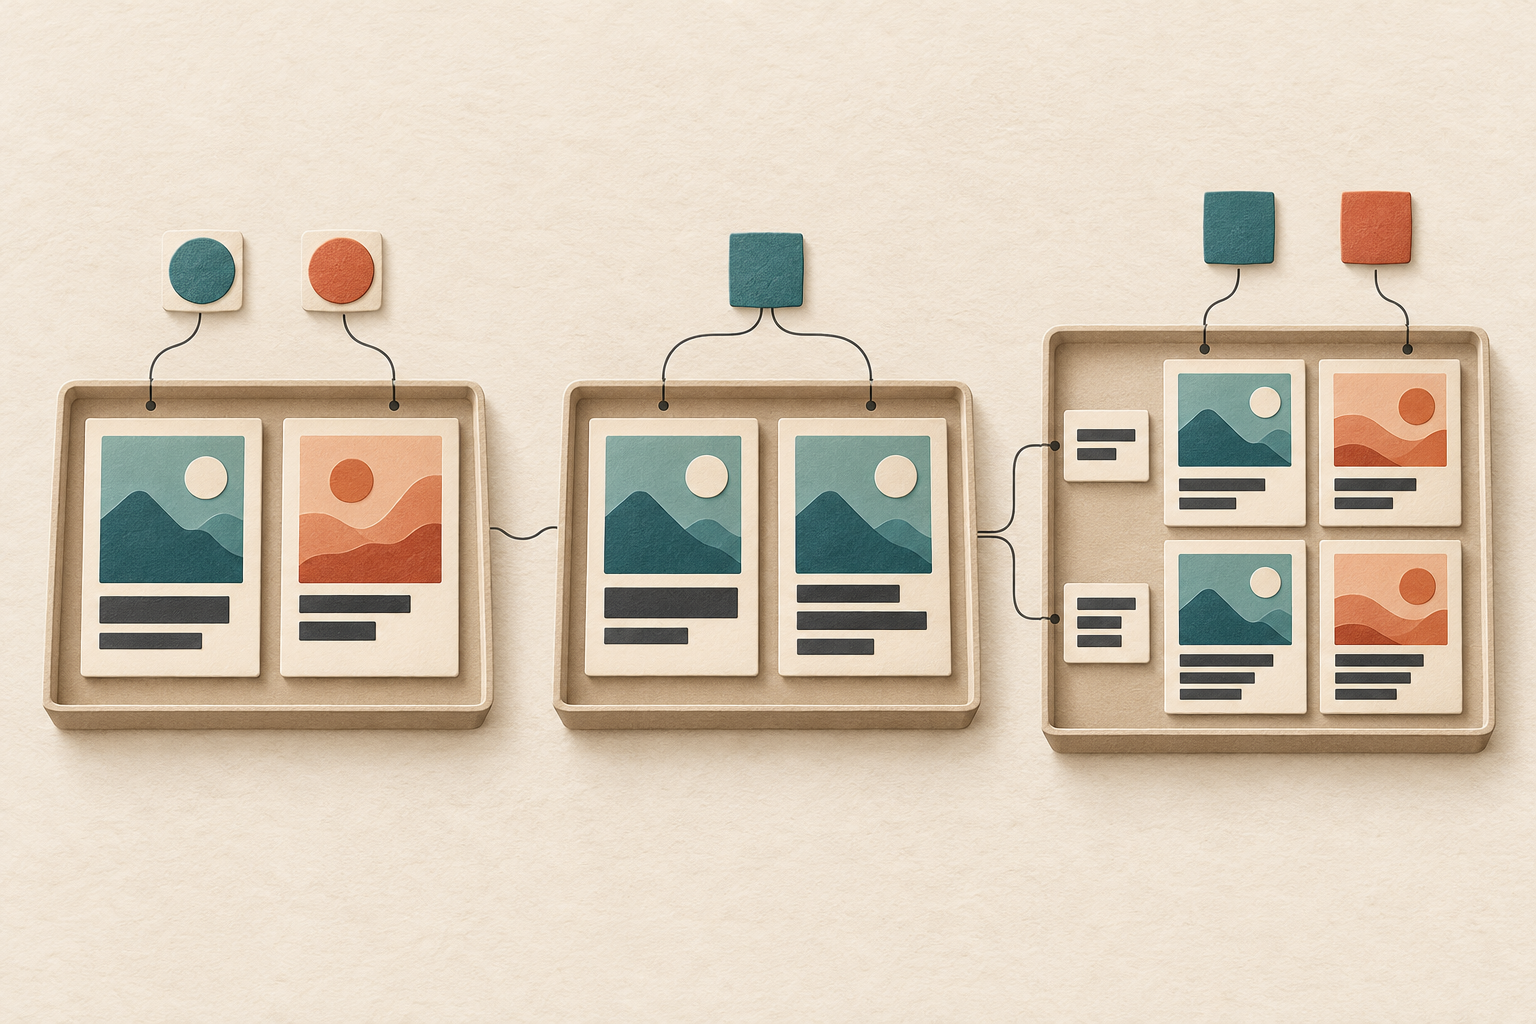
Velg en ferdig innholdsvariant
Sammenlign variantene som er aktuelle for beslutningen.
Sammenlign 1 element
Hold det andre elementet fast i sammenligningen du trenger.
Undersøk kombinasjonen
Ta med kombinasjonene som trengs for å spørre om overskriftsforskjellen endres på tvers av bilder.
Slik bygget vi oversikten over forsøksdesign
Kilden er den offentlig publiserte, utforskende filen fra Upworthy Research Archive, beskrevet av J. Nathan Matias, Kevin Munger, Marianne Aubin Le Quere og Charles Ebersole. Den har 22 666 rader med innholdsvarianter gruppert i 4 873 tester fra det historiske arkivet for 2013–2015. Vi brukte overskrift, bildeidentifikator, utdrag, testidentifikator, opprettelsestidspunkt og radindeks i arkivet. Klikk, visninger og redaksjonelle utvalg ble ikke brukt. [1] [6]
En strukturell gjennomførbarhetskontroll kom før den endelige planen for designgjennomgangen og bidro til spørsmålsstillingen. Dette er derfor en utforskende reanalyse, ikke en forhåndsregistrert bekreftende studie. Reglene beholder tester med brukbare strukturfelt, bruker hovedavgrensningen for dato og krever identisk utdragstekst i variantene. Kravet om likt utdrag er forsiktig fordi artikkelen og arkivdokumentasjonen er uenige om feltet ble vist. [6]
Utvalgstabellen viser utelatelser i rekkefølge, deretter en oppdeling av de kvalifiserte testene. 5 tester mangler overskrift eller bilde-ID; deretter faller 1 050 utenfor datokravet, og 606 har varierende utdrag. De 3 212 gjenværende testene omfatter 1 624 som bare varierer overskrift, 1 078 som bare varierer bilde-ID, 188 som varierer begge, og 322 med én observert kombinasjon. Den siste kategorien kan fortsatt ha flere kilderader.
Innenfor en test teller gjentatte, identiske par av overskrift og bilde som én designcelle. 5 av de 188 testene som varierer begge elementer, har gjentatte celler. Et komplett rutenett har alle par av overskriftstekster og bilde-ID-er observert i den testen. Ulike tekststrenger trenger ikke uttrykke ulike ideer, og ulike bilde-ID-er trenger ikke vise synlig forskjellige bilder. Bildefilene er ikke tilgjengelige.
Resultatene teller alle design likt, ikke personer, visninger eller bedrifter. De fastslår verken dagens markedsføringspraksis, ytelse eller statistisk styrke. Nedlastingene inneholder aggregatresultater og reproduksjonsmetode, inkludert begge kontrollene av avgrensningen. Dermed kan leserne undersøke forskjellen mellom en observert kombinasjon og en konklusjon trukket fra den. [7]
Hovedsammenligningen starter med 188 av 3 212 kvalifiserte tester
Utvalg fra de 4 873 testene i den offentlige, utforskende filen. Utelatelsene brukes i vist rekkefølge. De 4 siste designkategoriene deler de 3 212 kvalifiserte testene i atskilte grupper.
Vis utvalgstrinnene og alle kvalifiserte kategorier
| Utvalgstrinn eller kvalifisert designkategori | Tester |
|---|---|
| Utforskende tester ved start | 4 873 |
| Utelatt: manglende overskrift eller bilde-ID | 5 |
| Utelatt: angitt intervall for opprettelsesdato | 1 050 |
| Deretter utelatt: varierende utdragstekst | 606 |
| Kvalifisert etter utelatelser | 3 212 |
| Kvalifisert: overskrift varierer, bilde er fast | 1 624 |
| Kvalifisert: bilde varierer, overskrift er fast | 1 078 |
| Kvalifisert: både overskrift og bilde varierer | 188 |
| Kvalifisert: 1 observert kombinasjon | 322 |
- Last ned figurverdier og avgrensningsetiketter (CSV)
- Last ned resultater, strukturelle testregistreringer og analysekode (ZIP)
CSV-filen inneholder 41 verdier fra de 4 figurene. Designceller som brukes som illustrasjon, er merket separat fra observerte antall og andeler. ZIP-filen inneholder aggregerte resultater, strukturelle testregistreringer og analysekode. Oversatte instruksjoner for å reprodusere analysen følger med; last ned det opprinnelige offentlige arkivet separat. Ingen klikk- eller visningsutfall er inkludert.
Kilder og merknader
- Matias, J. Nathan; Munger, Kevin; Aubin Le Quere, Marianne; og Ebersole, Charles (2021), Upworthy Research Archive, en tidsserie med 32 487 forsøk i amerikanske medier, Scientific Data 8, 195. DOI: 10.1038/s41597-021-00934-7. Influence IQs analyse bruker det utforskende delutvalget og den korrigerte kildebeskrivelsen. Originalartikkelen forklarer kvalitativt at redaktørene ofte ikke testet alle kombinasjoner av overskrift og bilde.
- Hovednevneren for tester som varierer begge elementer, er 188 tester. Komplette rutenett: 31; ufullstendige: 157. Den ufullstendige gruppen har 75 med begge sammenligningstyper, 30 med bare overskrift, 45 med bare bilde og 7 med ingen. Dermed beholder 150/157 = 95,5 % minst 1 type. «Sammenligning» betyr en strukturell mulighet, ikke en estimert effekt eller et verifisert gyldig forsøk.
- De 3 designene fra keramikkstudioet er illustrerende. Et fullstendig design med 2 faktorer og 2 nivåer har alle de 4 kombinasjonene. Det delvise eksemplet utelater A med bilde 2, og det diagonale beholder bare A med bilde 1 og B med bilde 2. Et design med 4 celler alene fastslår ikke kvaliteten på fordelingen, tilstrekkelig utvalgsstørrelse eller meningsfullt samspill. NISTs håndbok forklarer fullstendige faktorielle design og kombinasjonene deres.
- Arkivets korrigering fra juni 2024 peker på mulige randomiseringsproblemer fra 25. juni 2013 til 10. januar 2014 og fraråder årsaksforskning med denne perioden. Andre forskningsformål beholdes uttrykkelig. Hovedanalysen vår utelater alle tester der opprettelsesdatospennet overlapper intervallet. Tidsstemplene beviser ikke eksponeringsdatoer, og tidssonen er ukjent. Den strukturelle kontrollen med alle perioder beholder disse postene.
- Blanktegnskontrollen fjerner blanktegn i starten og slutten og slår sammen interne blanktegn i overskrift og utdrag. Store og små bokstaver og tegnsetting bevares. 8 tester blir kvalifisert, og 1 felles kvalifisert test endrer strukturkategori. Nevnerne beregnes på nytt og holdes ikke fast på 188. Hovedutvalg, blanktegnsnormalisering og alle perioder har henholdsvis 188, 189 og 239 tester som varierer begge elementer.
- Den låste, utforskende CSV-filen er upworthy-archive-exploratory-packages-03.12.2020.csv, OSF-filversjon 1, 14 260 949 byte. SHA-256 er 8368313b060f4015a0c6fb34e6d788163cee29554144aba9390b14922eb9d8ce. Filen mangler oppdatert problemmerking, så datoavgrensningen utledes separat. Artikkelen beskriver utdragstekst som vist; arkivdokumentasjonen fører feltet blant dem man ikke tror ble vist. Ved å holde utdraget fast unngår vi å tilskrive forskjeller til det omstridte feltet.
- Cornell University publiserer Upworthy Research Archive med tilhørende kode og dokumentasjon under Creative Commons Attribution 4.0 International. Influence IQ står for denne avledede strukturelle analysen; det innebærer ingen godkjenning fra Upworthy eller arkivets forfattere. Analysepakken inneholder aggregerte resultater, strukturelle testregistreringer, kode og oversatte instruksjoner for å reprodusere analysen. Hent de opprinnelige offentlige dataene separat fra arkivet.
Den engelske artikkelen er kildeutgaven. Hver språkutgave beskriver det samme historiske, utforskende Upworthy-delutvalget og de samme illustrerende designene. Oversettelsen gjør ikke funnene til en målestokk for et lokalt marked eller dagens plattformer.