Ukur tempoh suara latar terjemahan sebelum memuktamadkan suntingan
Rakaman bahasa Inggeris boleh muat dalam sesuatu adegan, tetapi versi terjemahannya mungkin melebihi masa itu. Perbandingan 200 petikan penyelidikan kami menunjukkan mengapa tempoh suara latar berbilang bahasa perlu disertakan semasa penyerahan, sebelum gambar dimuktamadkan.
Analisis deskriptif tempoh rakaman yang dilaporkan dalam metadata bagi 200 petikan terjemahan yang tersedia dalam semua 10 konfigurasi ujian FLEURS terpilih, daripada rangka 350 petikan bahasa Inggeris. Sumbernya ialah bacaan petikan penyelidikan, bukan tugasan suara latar komersial. Metadata diperoleh pada 24 Oktober 2026 (UTC).
Abstrak
Patutkah perniagaan menetapkan masa video yang disesuaikan untuk bahasa sasaran mengikut suara latar bahasa Inggeris? Ukur bacaan terjemahan dahulu. Kami membandingkan tempoh yang dilaporkan dalam metadata bagi 200 petikan yang tersedia dalam semua 10 konfigurasi ujian FLEURS terpilih. Setiap petikan mendapat wajaran sama selepas bacaan berulang diringkaskan kepada median bagi petikan itu. Median perubahan berpasangan berbanding bahasa Inggeris berjulat daripada −6.1% bagi rakaman Belanda hingga +82.4% bagi rakaman Filipino. Kedua-duanya bukan tambahan masa produksi yang terpakai kepada seluruh bahasa.[1][2]
Contoh tetap 15 saat menjelaskan penyerahan itu. Daripada 186 petikan dengan median Inggeris yang muat dalam masa tersebut, 110 median Filipino melebihinya. Mengikut peraturan lebih ketat, semua rakaman Inggeris yang diperhatikan muat bagi 178 petikan, manakala semua rakaman Filipino melebihi had bagi 72. Pembaca, komposisi gender, terjemahan dan jeda masih bercampur. Perbandingan yang boleh diperiksa ini merangkumi semua 9 konfigurasi sasaran serta satu contoh yang dipilih sebelum hasil tempoh dikira, untuk membantu pasukan meminta bacaan bermasa sebelum memuktamadkan suntingan.
Penyunting sudah menyiapkan video produk yang pendek. Suara latar bahasa Inggeris muat, produk muncul pada bingkai yang dirancang dan gambar penutup menyediakan ruang untuk tawaran. Teks terjemahan tiba dengan mesej yang sama. Rakaman suara mudah dianggap sebagai bahagian terakhir yang hanya perlu dimasukkan ke dalam garis masa yang sudah siap.
Di situlah maklumat yang belum ada boleh menjadi masalah produksi: tiada sesiapa mengukur tempoh bacaan terjemahan. Teks yang diluluskan dari segi makna tidak memberitahu berapa lama penyampaian rakamannya mengambil masa. Penyerahan yang berguna menyertakan teks yang diluluskan dan tempoh rakaman.
Kami meneliti perbezaan ini melalui FLEURS, korpus penyelidikan bacaan petikan terjemahan. Bagi 200 petikan yang sepadan, hubungan tempoh berbeza antara konfigurasi dan antara bacaan petikan yang sama. Jadual berikut mengekalkan perbezaan itu. Ia memberi perniagaan atau pencipta kandungan sebab untuk meminta bukti masa produksi sebenar, tanpa menjadikan purata penyelidikan sebagai jaminan masa tambahan.
Berikan setiap versi rakaman tempohnya sendiri
Bandingkan petikan yang sama sebelum menggunakan petua masa
Jadual pertama membandingkan setiap konfigurasi sasaran dengan bahasa Inggeris AS bagi 200 petikan sumber yang sama. Untuk setiap petikan dan konfigurasi, kami mengambil median semua tempoh rakaman yang tersedia. Kami kemudian membahagikan median sasaran dengan median Inggeris dan menyatakan perbezaan daripada 1 sebagai peratus. Akhirnya, kami meringkaskan 200 perubahan berpasangan itu. Petikan dengan 3 bacaan mendapat wajaran yang sama seperti petikan dengan 1.[2][4]
Bagi rakaman bahasa Sepanyol Amerika Latin, median perubahan berpasangan ialah +24.8%. Separuh tengah perubahan setiap petikan berjulat daripada +10.2% hingga +47.0%. Bagi bahasa Jepun, mediannya +36.6%, dengan separuh tengah daripada +17.8% hingga +61.8%. Angka ini menerangkan rakaman yang diterbitkan bagi petikan sepadan, bukan menetapkan cara sesuatu bahasa patut disampaikan.
Ini berbeza daripada membahagikan 2 median tempoh keseluruhan. Dalam petikan bersama yang sama, median ringkasan Inggeris bagi setiap petikan ialah 9.3 saat dan yang Sepanyol ialah 11.6 saat. Membahagikan angka paparan itu tidak menghasilkan semula keputusan berpasangan +24.8%. Kami memadankan setiap petikan dengan rujukan Inggerisnya sendiri, bukan membandingkan petikan sasaran yang pendek dengan petikan lain di tengah taburan.
Rakaman bahasa Belanda mempunyai median perubahan berpasangan −6.1%, manakala rakaman Filipino +82.4%. Mengekalkan kedua-duanya dalam jadual menunjukkan julat hubungan yang diperhatikan. Ia juga mengelakkan tanggapan bahawa semua rakaman terjemahan lebih panjang. Dalam set bersama, 71 median petikan Belanda lebih panjang daripada yang Inggeris, 2 sama dan selebihnya lebih pendek.
Baris mengikut susunan konfigurasi tetap yang digunakan dalam analisis, bukannya disusun berdasarkan keputusan. Baca baris yang berkaitan sambil mengekalkan konteks penyelidikannya. Bahasa Sepanyol Amerika Latin dan Filipino ialah skop bahasa sumber. Menerbitkan artikel ini dalam bahasa lain tidak menjadikan rakaman tersebut bukti tentang pasaran itu.
Perubahan berpasangan tempoh rakaman berbanding Inggeris AS
200 petikan terjemahan yang sama dalam setiap baris. Median tempoh sasaran setiap petikan dibahagikan dengan median Inggerisnya; perbezaan daripada 1 dinyatakan sebagai peratus. Q25 dan Q75 mengehadkan separuh tengah perubahan berpasangan itu.
| Konfigurasi rakaman sasaran | Median perubahan relatif (%) | Perubahan persentil ke-25 (%) | Perubahan persentil ke-75 (%) |
|---|---|---|---|
| Sepanyol Amerika Latin | 24.8% | 10.2% | 47.0% |
| Perancis (Perancis) | 5.7% | -10.0% | 29.1% |
| Jerman (Jerman) | 31.4% | 0.0% | 62.4% |
| Belanda (Belanda) | -6.1% | -21.6% | 8.9% |
| Indonesia (Indonesia) | 26.3% | 11.4% | 49.9% |
| Melayu (Malaysia) | 11.3% | -1.2% | 29.1% |
| Filipino (Filipina) | 82.4% | 54.2% | 120.1% |
| Thai (Thailand) | 20.8% | 1.6% | 42.0% |
| Jepun (Jepun) | 36.6% | 17.8% | 61.8% |
Taburan penting apabila tugasan mempunyai masa tetap
Median memadatkan 200 hubungan menjadi satu angka. Namun, sesuatu adegan perlu memuatkan bacaan tertentu. Kuartil di sebelah median menunjukkan mengapa membawa nilai tengah sahaja ke dalam taklimat akan mengetepikan maklumat yang penting untuk keputusan itu.
Rakaman bahasa Perancis mempunyai median perubahan berpasangan +5.7%, tetapi separuh tengahnya daripada −10.0% hingga +29.1%. Perbezaan tengah yang kecil wujud bersama petikan pada kedua-dua sisi tempoh Inggeris. Bagi bahasa Jerman, mediannya +31.4%, dengan separuh tengah antara kira-kira 0.0% hingga +62.4%. Nilai paparan 0.0% sudah dibundarkan; kuartil bawah yang belum dibundarkan sedikit positif.
Julat ini menerangkan separuh tengah perubahan berpasangan yang diperhatikan. Ia bukan selang keyakinan, had minimum dan maksimum, atau julat yang pasti merangkumi rakaman komersial akan datang. Petikan, terjemahan dan penyampaian berbeza daripada skrip produk baharu. Menyalin peratus median jadual dengan tepat sekalipun belum memberikan rakaman sebenar yang diperlukan untuk suntingan.
Ini mengubah soalan praktikal. Daripada bertanya berapa banyak masa tambahan yang sentiasa diperlukan oleh sesuatu bahasa, penerbit boleh bertanya sama ada bacaan terjemahan yang diluluskan muat dalam adegan yang dirancang. Jadual menerangkan mengapa semakan itu berguna; rakaman untuk tugasan sebenar memberikan jawapannya.
Satu petikan boleh hadir dengan beberapa tempoh rakaman
Petikan sumber 1662 dipilih sebagai ID terkecil yang tersedia dalam semua 10 konfigurasi, sebelum kami meringkaskan tempoh. Jadualnya merangkumi semua bacaan yang tersedia untuk petikan itu. Kami tidak mencari contoh dramatik selepas melihat tempoh dan tidak menyiarkan teks atau audionya di sini.[3][4]
2 fail Inggeris berdurasi kira-kira 8.4 dan 11.2 saat, memberikan median 9.8 saat. Sebanyak 3 fail Jerman berjulat daripada 10.4 hingga 23.5 saat, dengan median 10.5. Sebanyak 2 fail Filipino berjulat daripada 22.3 hingga 24.9 saat, dengan median 23.6. Ini ialah tempoh fail lengkap menurut metadata sumber, dibundarkan kepada 1 tempat perpuluhan untuk paparan.
Median 2 bacaan boleh menjadi titik tengah aritmetik dan bukannya tempoh fail yang benar-benar dirakam. Nilai Inggeris 9.8 saat yang dipaparkan ialah ringkasan sedemikian. Penyunting yang memilih rakaman masih perlu menggunakan tempoh fail pilihannya sendiri. Bilangan rakaman dan julat minimum hingga maksimum memperjelas perbezaan itu di sebelah median.
Julat Jerman juga mengingatkan supaya tidak mengaitkan setiap saat dengan panjang terjemahan. Kami tiada ID penutur, tidak mendengar rakaman dan tidak memisahkan pertuturan daripada jeda. Cara membaca, pembaca dan keadaan rakaman tidak dapat dipisahkan di sini. Contoh ini menyokong permintaan mudah: hantarkan rakaman yang dimaksudkan atau bacaan bermasa bagi teks yang dimaksudkan, bukan anggaran umum untuk bahasa sahaja.
Petikan 1662: kekalkan julat rakaman di sebelah median
ID sumber terkecil dengan rakaman dalam semua 10 konfigurasi, dipilih mengikut ketersediaan sebelum ringkasan tempoh. Semua rakaman tersedia disertakan. Saat merujuk fail lengkap dalam metadata, tanpa pemisahan jeda.
| Konfigurasi rakaman | Rakaman tersedia | Fail terpendek (saat) | Median fail (saat) | Fail terpanjang (saat) |
|---|---|---|---|---|
| Inggeris AS | 2 | 8.4 | 9.8 | 11.2 |
| Sepanyol Amerika Latin | 3 | 8.8 | 9.5 | 9.5 |
| Perancis (Perancis) | 2 | 6.4 | 6.8 | 7.1 |
| Jerman (Jerman) | 3 | 10.4 | 10.5 | 23.5 |
| Belanda (Belanda) | 1 | 7.9 | 7.9 | 7.9 |
| Indonesia (Indonesia) | 1 | 11.6 | 11.6 | 11.6 |
| Melayu (Malaysia) | 2 | 8.0 | 8.6 | 9.1 |
| Filipino (Filipina) | 2 | 22.3 | 23.6 | 24.9 |
| Thai (Thailand) | 3 | 6.5 | 8.7 | 10.1 |
| Jepun (Jepun) | 2 | 12.1 | 13.3 | 14.6 |
Contoh 15 saat memerlukan penyebutnya
Kami menetapkan 15 saat sebagai contoh perancangan sebelum mengira hasil. Ia bukan peraturan platform, panjang iklan yang disyorkan atau tambahan masa produksi yang selamat. Persoalannya ialah sama ada ringkasan tempoh Inggeris boleh muat dalam had itu sedangkan ringkasan sasaran yang sepadan melebihinya.
Daripada 200 petikan bersama, 186 mempunyai median Inggeris tidak melebihi 15 saat. Dalam kumpulan itu, median sasaran melebihi 15 saat bagi 20 petikan Sepanyol Amerika Latin, 39 Jerman, 9 Belanda, 110 Filipino dan 37 Jepun. Setiap kiraan menggunakan penyebut 186 yang sama; perbandingan lain ada dalam muat turun.[6]
Kami turut menggunakan peraturan lebih ketat untuk rakaman yang diperhatikan. Setiap bacaan Inggeris yang tersedia mesti muat dalam 15 saat dan setiap bacaan sasaran mesti melebihinya. Terdapat 178 petikan Inggeris yang layak. Ini berlaku bagi 11 petikan Sepanyol, 9 Jerman, 4 Belanda, 72 Filipino dan 14 Jepun. Kiraan ini hanya melibatkan rakaman yang diterbitkan, bukan setiap cara yang mungkin untuk membaca petikan itu.
Semakan lebih ketat mengelakkan pergantungan pada titik tengah aritmetik yang tidak pernah dirakam. Namun, ia masih tidak menunjukkan bahawa petikan tidak boleh dibaca lebih pantas, disunting secara berbeza atau ditulis semula dengan sesuai. Bagi pasukan, bezakan bukti bahawa rakaman yang dibekalkan muat daripada andaian versi lain akan muat kerana versi Inggeris muat.
Pelancaran rekaan menunjukkan tempat penyerahan itu
Bayangkan jenama kecil peralatan dapur rekaan yang menempah video produk 15 saat daripada pencipta kandungan. Konsepnya mengandungi demonstrasi, tawaran dan gambar produk penutup. Bacaan Inggeris mengambil 11 saat. Makna draf terjemahan sudah diluluskan, tetapi bacaan pertama penyampai suara yang dirancang mengambil 17 saat. Jenama, skrip, tempoh dan tugasan ini rekaan, bukan pemerhatian FLEURS.
Jika pencipta sudah menetapkan setiap syot mengikut bacaan Inggeris, fail 17 saat memerlukan keputusan pada penghujung suntingan. Penanggungjawab projek boleh memperjelas pilihan itu dengan meminta bacaan bermasa ketika teks terjemahan masih disemak. Taklimat perlu menyatakan mesej yang mesti kekal tepat, masa adegan yang tersedia dan siapa yang boleh meluluskan perubahan teks atau suntingan.
Jawapannya tidak semestinya mempercepat penyampai suara secara automatik. Penterjemah boleh mencadangkan ungkapan semula jadi yang lebih pendek sambil mengekalkan tawaran. Penyunting boleh memanjangkan demonstrasi, memindahkan butiran sampingan ke teks iringan atau menyediakan versi potongan lain jika format yang dipersetujui membenarkannya. Ini pilihan produksi untuk dibincangkan, bukan penambahbaikan yang dibuktikan analisis korpus kami.
Penyerahan yang berguna untuk tugasan rekaan ini boleh berbunyi: “Versi sasaran: __. Skrip diluluskan: __. Rakaman yang dimaksudkan: __ saat, diukur daripada fail dibekalkan. Peruntukan masa adegan: __ saat. Tawaran dan pendedahan wajib: __. Pelulus perubahan skrip: __. Pelulus suntingan: __.” Ruang kosong itu perlu diisi oleh pasukan sebenar; jadual penyelidikan tidak boleh mengisinya.
Bagi beberapa versi sasaran, penanggungjawab boleh menyimpan satu baris bagi setiap rakaman yang dimaksudkan, bukan menandakan seluruh projek sebagai “terjemahan diluluskan”. Kelulusan teks dan masa menjawab soalan berbeza. Jika penterjemah mengubah dakwaan produk selepas bacaan percubaan, baris itu perlu menunjukkan perubahan sebelum pencipta menggunakan tempoh lama semula. Ini cadangan mengurus tugasan rekaan, bukan pengurangan risiko projek yang diukur.
Setelah rakaman disemak semula dibekalkan, pencipta boleh meneliti versi lengkap bersama orang yang bertanggungjawab terhadap bahasa dan makna. Menilai kesesuaian berdasarkan tempoh sahaja boleh terlepas penyampaian janggal atau gambar penutup yang sukar dibaca. Kajian ini tidak mengukur mutu atau reaksi penonton. Sumbangannya kepada tugasan rekaan ialah mengetahui tempoh lebih awal; keputusan kreatif kekal pada orang yang menghasilkan video.
Kekalkan teks, rakaman dan gambar bersama semasa semakan
Untuk masa suara latar berbilang bahasa, dokumen yang berguna cukup ringkas untuk mengiringi kerja. Ia mengenal pasti versi teks yang diluluskan, rakaman yang dimaksudkan dan masa adegan. Jika salah satunya berubah, penerima seterusnya boleh melihat maklumat masa yang masih terpakai.
Bacaan percubaan bermasa boleh mendedahkan percanggahan ketika pasukan masih mempunyai pilihan. Kekalkan label sementara, bukan menganggapnya bukti penyampai akhir akan menghasilkan tempoh sama. Apabila rakaman yang dimaksudkan tiba, gantikan andaian dengan tempoh terukurnya dan semak dalam suntingan sebenar.
Kekalkan versi terjemahan yang lengkap semasa semakan. Orang yang memeriksa makna perlu mendengar penyampaian bersama gambar, manakala penyunting perlu melihat sama ada jeda, kemunculan produk dan gambar penutup berfungsi bersama. Fail yang muat dalam tempoh ialah satu bukti, bukan kelulusan seluruh versi.
4 langkah berikut ialah cadangan penyerahan, bukan aliran kerja yang diuji dalam FLEURS. Langkah ini menerapkan perbezaan antara teks dan tempoh rakaman kepada keputusan produksi. Ia tidak menjanjikan capaian, pengekalan penonton, penukaran atau bilangan semakan yang akan diperlukan.
Bawa tempoh rakaman melalui 4 penyerahan
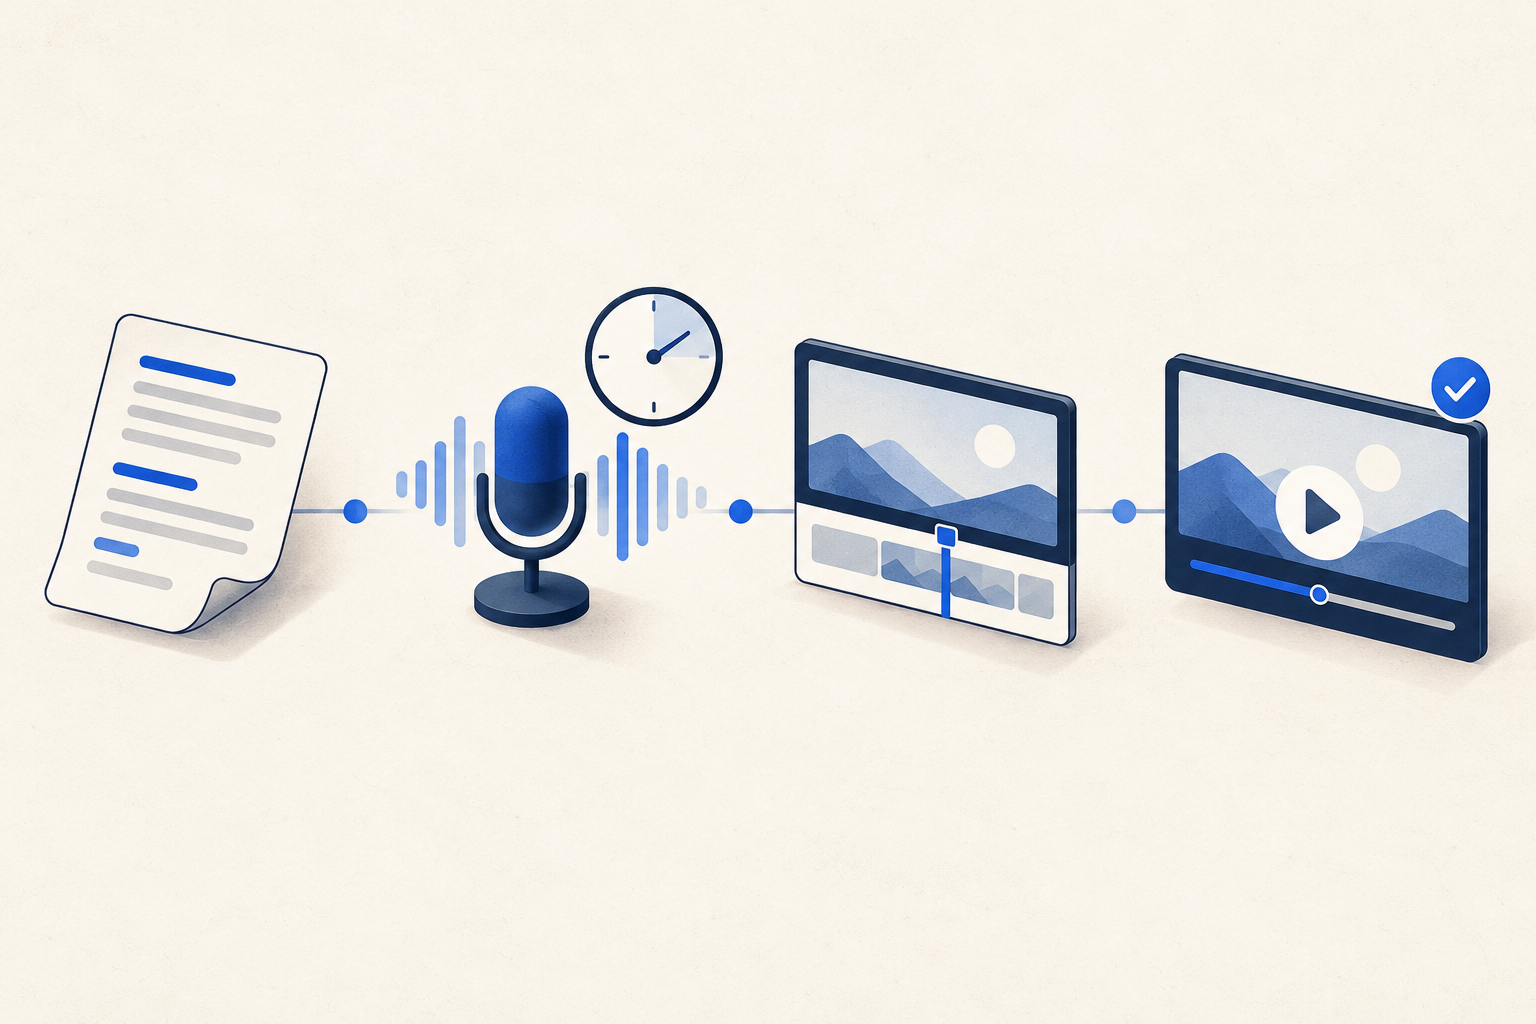
Persetujui teks
Kenal pasti versi sasaran, skrip diluluskan dan orang yang menyemak makna.
Ukur bacaan yang dimaksudkan
Sertakan tempoh rakaman yang diukur; labelkan bacaan percubaan sebagai sementara.
Selesaikan kesesuaian masa
Persetujui perubahan skrip atau adegan sebelum memuktamadkan suntingan.
Semak versi lengkap
Periksa rakaman pilihan bersama gambar, tawaran dan gambar penutup.
Kekalkan set padanan apabila menggunakan sesuatu angka
Perbandingan bersama merangkumi 200 daripada 350 petikan ujian Inggeris. Bagi 150 petikan yang lain, sekurang-kurangnya satu konfigurasi terpilih tidak tersedia. Ketersediaan lengkap mungkin terpilih secara tidak rawak, maka set bersama tidak patut diterangkan sebagai sampel rawak skrip, bahasa atau tugasan suara latar.
Kami mengulang setiap perbandingan Inggeris–sasaran dengan semua pasangan tersedia. Penyebutnya berjulat daripada 251 bagi Belanda hingga 349 bagi Filipino dan Thai. Kami juga mengulang perbandingan bersama hanya bagi petikan dengan sekurang-kurangnya 2 bacaan Inggeris serta 2 bacaan sasaran; subset itu mengandungi 66 hingga 166 petikan. Semua 9 hasil berpasangan dan penyebutnya disertakan dalam muat turun.[4]
Subset bacaan berulang mengekalkan arah median perubahan berpasangan yang sama seperti perbandingan utama dalam setiap konfigurasi. Itu semakan berguna terhadap pilihan ringkasan ini. Ia tidak mengawal pembaca atau menjadikan sampel pasangan yang berbeza sebagai populasi setara. Rakaman berulang tidak boleh dikira sebagai peserta bebas.
Rakaman Jerman, Belanda, Indonesia, Melayu dan Filipino yang diperoleh semuanya berlabel lelaki; rakaman Thai semuanya berlabel perempuan. Inggeris, Sepanyol, Perancis dan Jepun mempunyai label bercampur. Tanpa ID penutur, analisis tidak boleh memisahkan konfigurasi daripada komposisi pembaca, penyampaian, terjemahan atau pemilihan rakaman yang dikekalkan. Baca jadual sebagai gambaran rakaman ini dan sertakan batasan itu berdekatan setiap angka yang digunakan.[7]
Cara perbandingan tempoh rakaman dibuat
FLEURS ialah korpus penyelidikan yang diperkenalkan pada 2022, menggunakan bacaan petikan terjemahan. Dokumentasi pengeluar dan TensorFlow Datasets menyatakan ID teks sumber yang dikongsi antara bahasa serta medan metadata untuk jumlah sampel audio pada 16,000 Hz. Kami membahagikan medan itu dengan 16,000 bagi memperoleh saat fail lengkap yang dilaporkan metadata. Kami tidak menyahkod audio, mengesahkan panjang bentuk gelombang atau membuang senyap.[1][2]
Kami memperoleh 10 fail metadata ujian pada 24 Oktober 2026 (UTC), menggunakan revisi tetap pengeluar yang didokumenkan dalam nota. Fail itu mengandungi 7,528 rakaman bagi petikan tersedia. Padanan menggunakan ID sumber, bukan kedudukan baris. Set bersama 200 petikan, peraturan 15 saat, semakan bacaan berulang dan contoh 1662 ditetapkan selepas ketersediaan diketahui dan sebelum ringkasan tempoh dikira.[3][4]
Tarikh perolehan mengenal pasti versi sumber yang digunakan. Ia tidak menjadikan rakaman daripada korpus penyelidikan yang diperkenalkan pada 2022 sebagai tinjauan 2026 terhadap penyampai suara atau pencipta kandungan. Data awam mengekalkan revisi supaya pembaca membezakan analisis baharu bahan sedia ada daripada penyampaian yang baru dirakam.
Percubaan kebolehlaksanaan awal pada bahagian pembangunan menghasilkan hanya 91 petikan bersama, di bawah ambang 100, lalu diketepikan. Pengambilan ujian pada mulanya terhenti pada had saiz metadata Thai; had lebih besar yang didokumenkan melengkapkan rangka ujian tetap yang sama. Ini perubahan kebolehlaksanaan dan akses yang dinyatakan, bukan bukti kajian pradaftar tanpa pengetahuan hasil.
Semua pengiraan berpasangan menggunakan kiraan sampel dan pecahan tepat. Kuartil menggunakan interpolasi linear pada kedudukan (n−1) × p. Jadual memaparkan peratus dan saat dengan 1 tempat perpuluhan, dibundarkan kepada nilai terdekat dan menjauhi sifar apabila tepat separuh; bilangan rakaman kekal integer. Data terbitan awam mengekalkan ringkasan tepat bagi setiap petikan, hasil pasangan, semakan kepekaan dan kedua-dua takrif had masa. Kami tidak mengira selang keyakinan populasi atau kesan sebab-akibat.[4]
Kekangan masa dalam alih suara sudah menjadi bidang penyelidikan yang mantap.[5] Artikel ini menambah perbandingan yang boleh dihasilkan semula bagi tempoh fail yang diterbitkan untuk petikan tetap ini, berserta maklumat untuk menyemak liputan dan rakaman berulang. Ia menyokong permintaan bukti masa produksi terjemahan sebelum memuktamadkan suntingan; ia tidak memberikan peratus pemanjangan sejagat.
- Muat turun 67 dapatan yang dipaparkan (CSV)
- Muat turun semua 350 petikan × 10 konfigurasi dan ringkasan rakaman (CSV)
- Muat turun 9 perbandingan berpasangan, semakan kepekaan dan kiraan had masa (CSV)
- Muat turun sumber, kaedah dan kod penghasilan semula (ZIP)
Tiada pendaftaran diperlukan. Data terbitan mengekalkan gabungan yang tiada dan penyebut perbandingan sebenar. Pakej bersama mengandungi dokumentasi kaedah dalam bahasa Inggeris, rujukan sumber dan kod penghasilan semula; tiada transkrip atau audio asal diedarkan semula. Semua edisi bahasa menerangkan korpus tetap yang sama.[8]
Nota penyelidikan
- Conneau et al., FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech (2022), bahagian 2.1–2.3. Korpus mengandungi bacaan petikan terjemahan dengan sehingga 3 rakaman disahkan bagi setiap ayat, pada kadar sampel 16 kHz. Pengumpulan dan tujuan penyelidikannya tidak membuktikan keterwakilan produksi suara latar komersial. Teks sumber berasal daripada FLORES, bukan sampel skrip iklan.
- TensorFlow Datasets, dokumentasi ciri dan penghurai xtreme_s versi 2. ID teks sumber konsisten merentas bahasa dan boleh berulang antara bacaan; num_samples merekodkan jumlah sampel audio. Ciri audio menyatakan 16,000 Hz. Penghurai menyalin kiraan metadata tanpa menyemaknya dengan bentuk gelombang yang dinyahkod. Saat dalam kajian ini ialah tempoh fail lengkap menurut metadata, tanpa pemisahan jeda atau kawalan identiti penutur.
- Metadata Google FLEURS, revisi tetap ab93cf03f9d0cd083c853fad065a6377067408aa, bahagian ujian, diperoleh 24 Oktober 2026 (UTC). Konfigurasi: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th dan ja_jp. TSV Inggeris yang dipautkan ialah satu daripada 10 fail sumber; pakej menyatakan setiap URL tepat dan SHA256. Bahasa Sepanyol sumber ialah Amerika Latin dan fil_ph ialah Filipino.
- Pengiraan Influence IQ: satu median bagi setiap petikan dan konfigurasi; wajaran sama bagi petikan; nisbah berpasangan median sasaran kepada Inggeris serta perbezaan berpasangan dalam saat. Analisis utama merangkumi 200 petikan bersama dalam semua 10 konfigurasi daripada 350 petikan Inggeris. Perbandingan sekunder menggunakan semua pasangan Inggeris–sasaran tersedia dan petikan bersama dengan sekurang-kurangnya 2 rakaman pada setiap sisi. Kaedah dan contoh ditetapkan sebelum ringkasan tempoh, selepas ketersediaan diketahui. Pecahan tepat, interpolasi, pembundaran dan penyebut didokumenkan dalam pakej penghasilan semula.
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing (2023). Penyelidikan terdahulu sudah meneliti masa dalam alih suara manusia profesional. Sumbangan kami ialah jadual terhad tempoh fail FLEURS berpasangan dan tafsiran yang boleh digunakan semula untuk penyerahan produksi, bukan penemuan kekangan masa alih suara atau penanda aras alih suara profesional.
- Had 15 saat ditetapkan sebagai contoh perancangan sebelum hasil dikira. Peraturan median: 186 petikan bersama mempunyai median Inggeris ≤15 saat; kira median sasaran >15. Peraturan semua rakaman diperhatikan: 178 mempunyai semua rakaman Inggeris ≤15; kira petikan dengan semua rakaman sasaran yang diperhatikan >15. Nilai yang sama dengan had masih muat. Kiraan ini menerangkan rakaman yang diterbitkan, bukan panduan platform atau semua kemungkinan bacaan.
- Metadata yang diperoleh tiada ID penutur. Rakaman Jerman, Belanda, Indonesia, Melayu dan Filipino semuanya berlabel lelaki; rakaman Thai semuanya berlabel perempuan. Konfigurasi yang tiada menyingkirkan 150 daripada 350 petikan Inggeris daripada set bersama. Semakan pasangan dan bacaan berulang menerangkan subset terhad yang berbeza tanpa memisahkan pembaca, gender, penyampaian, terjemahan atau pemilihan rakaman. Tiada selang keyakinan, kedudukan kelajuan bahasa, kesan sebab-akibat atau ramalan komersial dilaporkan.
- Sumber: Google FLEURS, disediakan di bawah CC BY 4.0. Pemilihan, pengiraan, jadual, tafsiran editorial dan terjemahan ialah adaptasi Influence IQ; tiada sokongan pengarang set data disiratkan. Pakej awam mengedarkan ringkasan angka terbitan dan kod, bukan audio atau teks asal. Pembundaran paparan tidak mengubah kiraan sumber tepat atau populasi rakaman bersama.
Artikel Inggeris menjadi sumber semua versi bahasa. Setiap edisi melaporkan rakaman ujian dan petikan terjemahan FLEURS tetap yang sama; bahasa artikel tidak mewujudkan bukti tentang pasaran baharu. Influence IQ bertanggungjawab terhadap analisis, tafsiran dan terjemahan.