Merchandising e-dagang: uji andaian tentang kedudukan produk
Eksperimen terdahulu dengan sepuluh buku menunjukkan bagaimana pelarasan kedudukan yang ringkas boleh terlepas sebahagian pola, serta cara menguji andaian itu sebelum membandingkan kad produk.
Analisis semula asli terhadap eksperimen pemilihan buku tahun 2024 yang diterbitkan oleh Compiani, Morozov dan Seiler.
Abstrak
Sebelum memutuskan bahawa sesuatu tawaran lebih kukuh daripada yang lain, perniagaan perlu mempertimbangkan tempat setiap tawaran dipaparkan. Kami menggunakan eksperimen tahun 2024 yang diterbitkan, melibatkan sepuluh e-buku, untuk menguji dua cara mengambil kira kedudukan. Pelarasan berasingan bagi setiap kedudukan meramalkan pilihan dengan lebih baik secara keseluruhan berbanding pelarasan yang sama bagi setiap langkah ke bawah senarai. Namun, ramalannya kurang tepat pada beberapa kedudukan, jadi perbandingan lengkap tetap penting.
Kedua-dua model menggunakan maklumat buku dan harga yang sama. Kami melatihnya menggunakan 6,176 peserta dan menyemak ramalannya pada 3,088 peserta lain. Pilihan itu bersifat hipotetikal dan semua peserta mesti memilih sebuah buku. Bagi perniagaan dan pencipta kandungan yang membandingkan kad produk, pengajarannya ialah menguji andaian penempatan sebelum mengaitkan hasil dengan sesuatu tawaran. Kajian ini tidak menganggarkan peningkatan jualan atau menentukan susunan produk terbaik.
Katakan produk di bahagian paling atas halaman menerima klik terbanyak. Adakah tawarannya lebih kukuh, atau kedudukannya dalam senarai membantu? Perniagaan memerlukan jawapan yang berguna sebelum menulis semula kad lain, memberikan diskaun bagi barangan yang kelihatan lebih lemah atau mengubah pilihan produk.
Mengambil kira kedudukan kedengaran mudah sehingga kita bertanya caranya. Patutkah setiap langkah ke bawah senarai menerima pelarasan yang sama? Kami menggunakan eksperimen terdahulu untuk membandingkan pendekatan ringkas itu dengan pendekatan yang lebih fleksibel, kemudian menguji kedua-duanya pada peserta yang tidak digunakan untuk melatih model.
Produk yang sama, kedudukan berbeza
Apakah yang patut dijelaskan oleh perbandingan kedudukan produk?
Perbandingan kad produk patut membantu anda memisahkan barangan yang ditawarkan daripada cara ia dipersembahkan. Jika satu produk biasanya muncul dahulu dan satu lagi biasanya muncul terakhir, jumlah hasilnya sahaja tidak menjawab sama ada pembeli lebih menyukai sesuatu tawaran.
Pendekatan ringkas yang kami uji memberikan pelarasan yang sama kepada skor keutamaan asas model bagi setiap langkah ke bawah senarai. Soalan yang berguna ialah sama ada cara itu meramalkan pilihan dengan cukup baik, berbanding membenarkan pelarasan berbeza bagi kedudukan yang berlainan.
Kami menguji kedua-dua pendekatan menggunakan eksperimen pemilihan buku yang diterbitkan. Hasilnya relevan kepada perniagaan dan pencipta kandungan yang membandingkan produk pada halaman koleksi atau kedai dalam talian. Ia menyediakan cara meneliti andaian pengukuran, bukannya peraturan tentang tempat meletakkan produk terlaris.
Ini penting apabila tawaran muncul di lebih daripada satu tempat. Pencipta kandungan mungkin memaparkan muat turun yang sama pada halaman koleksi dan pelancaran. Peruncit mungkin mengubah susunan senarai kategori. Barangan, harga, khalayak dan persembahan boleh berubah serentak. Pelarasan kedudukan ialah andaian tentang sebahagian perbandingan itu, dan wajar disemak secara berasingan.
Apakah yang dipilih oleh peserta dalam eksperimen buku?
Giovanni Compiani, Ilya Morozov dan Stephan Seiler meminta peserta yang direkrut melalui Prolific membuat pilihan hipotetikal daripada sepuluh e-buku, dengan susunan dan harga yang dirawakkan. Peserta mesti memilih sebuah buku; tiada pilihan untuk tidak membeli apa-apa. Kami menggunakan tugasan pertama dalam setiap respons yang dikekalkan, bukan tugasan berikutnya yang mengeluarkan buku yang dipilih.[1]
Penulis asal sudah melaporkan tindak balas terhadap kedudukan dan harga. Penyelidikan mereka yang lebih luas mengkaji bagaimana teks dan imej membantu menganggarkan penggantian produk. Soalan kami lebih khusus: adakah menggantikan satu terma kedudukan meningkatkan ramalan bagi peserta yang pilihannya tidak digunakan untuk melatih model?
Mengikut peraturan kelayakan asal, 9,265 respons dikekalkan dengan 9,264 ID peserta Prolific yang berbeza. Satu ID muncul dua kali. Kami mengekalkan kedua-dua respons dalam kumpulan yang sama dan memberikan peserta itu jumlah wajaran yang sama seperti peserta lain. Sesuatu respons tidak semestinya mewakili orang berasingan, dan tugasan pertama tidak semestinya pendedahan pertama orang itu kepada eksperimen.[2][3]
Tarikh dalam rekod sumber yang dikekalkan merangkumi 11 hingga 26 Jun 2024. Manuskrip menyatakan 14–27 Jun, maka kami menjelaskan perbezaannya dan tidak mengecualikan rekod berdasarkan tarikh. Kelayakan negara dan umur tidak dapat dipastikan daripada bahan yang diteliti; ini bukan anggaran untuk pembeli Amerika Syarikat atau populasi negara lain.[1][2]
Peserta kekal bersama sepanjang perbandingan
Respons tugasan pertama yang dipilih mengikut peraturan kelayakan asal penulis; tarikh dalam rekod sumber yang dikekalkan ialah 11–26 Jun 2024.
| Kumpulan | Peserta (mengikut ID platform) | Respons yang dikekalkan |
|---|---|---|
| Semua yang dikekalkan | 9,264 | 9,265 |
| Latihan | 6,176 | 6,176 |
| Dikhaskan untuk penilaian | 3,088 | 3,089 |
Model kedudukan manakah lebih baik meramalkan pilihan kumpulan ujian?
Model kedudukan fleksibel meramalkan pilihan kumpulan ujian dengan lebih baik pada ukuran skor yang ditetapkan terlebih dahulu. Kedua-dua model mengambil kira buku yang ditawarkan dan harga yang dipaparkan. Perbezaannya hanya pada cara model mewakili kedudukan.
Model asas menggunakan satu pekali bagi setiap langkah ke bawah senarai. Model fleksibel menggunakan pelarasan berasingan bagi kedudukan kedua hingga kesepuluh, berbanding kedudukan pertama. Ini memberinya lebih kebebasan, tetapi juga lebih banyak parameter untuk dianggarkan. Padanan yang lebih baik dengan data latihannya sendiri belum cukup untuk menentukan hasil perbandingan.
Oleh itu, kami melatih kedua-dua model menggunakan 6,176 peserta dan menilainya pada 3,088 peserta lain. Semua respons seseorang peserta kekal pada sisi pembahagian yang sama. Kumpulan ujian mengandungi 3,089 respons kerana termasuk peserta yang muncul dua kali.
Untuk membandingkan ramalan, kami menggunakan skor log negatif. Model menerima penalti lebih kecil apabila ia memberikan kebarangkalian lebih tinggi kepada pilihan sebenar seseorang. Ia menerima penalti lebih besar apabila kebarangkalian yang diberikan kepada pilihan itu sangat rendah. Purata skor log negatif yang lebih rendah adalah lebih baik.
Purata bagi kumpulan ujian ialah 2.2260 untuk model asas dan 2.2154 untuk model fleksibel, dalam unit logaritma asli yang juga dipanggil nats. Ini ialah skor ramalan, bukan peratus jawapan betul. Skor latihan dan ujian ditunjukkan bersama supaya perbandingan tidak bergantung pada tugas yang lebih mudah, iaitu menerangkan data yang sudah dilihat oleh model.
Dua model, dinilai pada peserta yang sama
Pilihan tugasan pertama dengan sepuluh buku pada 2024 yang telah dipilih. Latihan: 6,176 peserta dan respons. Ujian: 3,088 peserta dan 3,089 respons.
| Model kedudukan | Skor latihan (nats) | Skor kumpulan ujian (nats) |
|---|---|---|
| Satu terma kedudukan linear | 2.2046 | 2.2260 |
| Terma kedudukan berasingan | 2.1899 | 2.2154 |
Peningkatan berpasangan ialah 0.0106 nats bagi setiap peserta, dengan selang anggaran 95% daripada 0.0044 hingga 0.0168. Di sini, peningkatan positif memihak kepada model fleksibel. Hasilnya kecil pada skala skor ini, tetapi keseluruhan selang berada di atas sifar.[4]
Selang ini menganggap kedua-dua model yang telah dilatih sebagai tetap serta mengandaikan kumpulan peserta yang bebas. Ia tidak merangkumi ketidakpastian akibat melatih model pada sampel latihan lain. Dapatan ini menyokong peningkatan ramalan dalam tugasan terdahulu yang telah dipilih ini; perbezaan skor itu bukan peningkatan jualan.
Model fleksibel meningkatkan skor log kumpulan ujian
Perbandingan berpasangan dalam kalangan 3,088 peserta ujian bagi tugasan terdahulu dengan sepuluh buku yang dipilih.
| Perbandingan | Peningkatan (nats) | Selang 95%: bawah (nats) | Selang 95%: atas (nats) |
|---|---|---|---|
| Skor log fleksibel ditolak model asas | 0.0106 | 0.0044 | 0.0168 |
Di manakah ramalan kedua-dua model berbeza daripada pilihan yang diperhatikan?
Perbandingan lengkap kedudukan menunjukkan mengapa skor keseluruhan perlu disertakan dengan perincian. Bagi setiap kedudukan, kami membandingkan bahagian pilihan yang diperhatikan dengan purata kebarangkalian yang diberikan oleh setiap model. Ini ialah purata dengan wajaran peserta yang sama dalam kumpulan ujian, bukannya kadar klik lalu.
Pada kedudukan pertama, bahagian yang diperhatikan ialah 17.16%. Model asas meramalkan 14.64%, manakala model fleksibel meramalkan 17.73%. Pada kedudukan kesepuluh, bahagian yang diperhatikan ialah 9.18%, berbanding ramalan 6.37% dan 8.74%. Model fleksibel lebih hampir pada kedua-dua hujung senarai khusus ini.
Pilihan yang diperhatikan dan diramalkan pada kesemua sepuluh kedudukan
Kumpulan ujian: 3,088 peserta dan 3,089 respons tugasan pertama daripada eksperimen 2024 yang diterbitkan.
| Kedudukan | Bahagian pilihan yang diperhatikan | Purata kebarangkalian model asas | Purata kebarangkalian model fleksibel | Respons yang memilih kedudukan ini |
|---|---|---|---|---|
| Kedudukan 1 | 17.16% | 14.64% | 17.73% | 530 |
| Kedudukan 2 | 13.60% | 13.20% | 14.84% | 420 |
| Kedudukan 3 | 9.91% | 12.06% | 9.74% | 306 |
| Kedudukan 4 | 10.91% | 11.21% | 9.26% | 337 |
| Kedudukan 5 | 9.20% | 10.09% | 8.94% | 284 |
| Kedudukan 6 | 7.08% | 9.25% | 8.01% | 219 |
| Kedudukan 7 | 8.00% | 8.44% | 7.57% | 247 |
| Kedudukan 8 | 7.12% | 7.67% | 7.47% | 220 |
| Kedudukan 9 | 7.84% | 7.08% | 7.69% | 242 |
| Kedudukan 10 | 9.18% | 6.37% | 8.74% | 284 |
Model fleksibel tidak lebih hampir di semua kedudukan. Pada kedudukan keempat, bahagian yang diperhatikan ialah 10.91%. Model asas meramalkan 11.21%, manakala model fleksibel meramalkan 9.26%. Fleksibiliti tambahan meningkatkan skor keseluruhan kumpulan ujian, tetapi meninggalkan perbezaan yang lebih besar pada kedudukan tersebut.
Jadual seterusnya menunjukkan bahagian yang diperhatikan ditolak ramalan. Jurang positif bermakna model meramalkan terlalu sedikit pilihan pada kedudukan itu; jurang negatif bermakna terlalu banyak. Memaparkan kesemua sepuluh kedudukan mengelakkan hasil yang kelihatan baik di satu hujung daripada mewakili keseluruhan perbandingan.
Jurang kedua-dua model daripada pilihan yang diperhatikan
Bahagian pilihan yang diperhatikan ditolak purata kebarangkalian ramalan bagi setiap kedudukan, menggunakan 3,088 peserta ujian yang sama.
| Kedudukan | Diperhatikan ditolak model asas | Diperhatikan ditolak model fleksibel |
|---|---|---|
| Kedudukan 1 | 2.52 mata peratusan | -0.57 mata peratusan |
| Kedudukan 2 | 0.41 mata peratusan | -1.24 mata peratusan |
| Kedudukan 3 | -2.15 mata peratusan | 0.17 mata peratusan |
| Kedudukan 4 | -0.29 mata peratusan | 1.65 mata peratusan |
| Kedudukan 5 | -0.89 mata peratusan | 0.26 mata peratusan |
| Kedudukan 6 | -2.17 mata peratusan | -0.93 mata peratusan |
| Kedudukan 7 | -0.44 mata peratusan | 0.43 mata peratusan |
| Kedudukan 8 | -0.55 mata peratusan | -0.35 mata peratusan |
| Kedudukan 9 | 0.76 mata peratusan | 0.14 mata peratusan |
| Kedudukan 10 | 2.81 mata peratusan | 0.44 mata peratusan |
Baris kedudukan ini bersifat deskriptif, tanpa tuntutan kesignifikanan berasingan. Eksperimen tidak mengukur pergerakan mata atau perhatian, dan analisis ini tidak mengenal pasti sebab sesuatu kedudukan berbeza. Pola melengkung pada bahagian yang diperhatikan juga tidak dengan sendirinya menyangkal model asas: terma kedudukannya linear dalam skor keutamaan asas model, bukannya dalam peratus pilihan.
Sekadar menolak bahagian yang diperhatikan pada kedudukan pertama dan terakhir akan menjawab soalan berbeza. Bahagian itu merumuskan pilihan merentas produk dan harga. Kedua-dua model mengambil kira identiti buku dan harga sebelum memberikan kebarangkalian merentas sepuluh pilihan. Perbezaan antara hujung senarai mahupun perbandingan model tidak memberitahu anda apa yang akan berlaku jika produk tertentu dipindahkan di kedai sebenar.
Templat pengukuran kedudukan produk yang boleh anda gunakan
Sebelum membandingkan tawaran, tulis ringkasan rancangan pengukuran. Templat berikut boleh digunakan tanpa pendaftaran dan bersifat ilustratif. Ia menerapkan pengajaran kajian tentang menyemak andaian; ia tidak menjanjikan model yang sama sesuai untuk kedai anda.
Keputusan: “Kami perlu memutuskan [perbandingan produk atau perubahan persembahan] bagi [halaman atau kempen] sepanjang [tempoh].” Nyatakan keputusan sebelum memilih metrik yang memihak kepada anda.
Hasil: “Kami akan mengukur [pilihan, klik, penambahan ke troli atau pembelian].” Pilih hasil yang benar-benar disokong oleh rekod anda. Simpan juga alternatif yang ditawarkan, susunannya dan harga yang dipaparkan. Hasil pilihan wajib perlu kekal berasingan daripada hasil pembelian.
Unit: “Unit kami ialah [peserta atau unit lain yang ditakrifkan dengan jelas]. Lawatan atau respons berulang akan dikendalikan melalui [peraturan].” Kekalkan pemerhatian daripada orang yang sama bersama-sama apabila menilai ramalan bagi orang baharu. Jangan anggap pengecam sesi tanpa nama sebagai bukti orang yang unik.
Perbandingan: “Kedua-dua model akan menggunakan produk, maklumat harga dan pemerhatian yang layak yang sama. Perbezaannya ialah [andaian kedudukan].” Tetapkan pilihan ringkas dan juga pilihan yang lebih fleksibel.
Penilaian: “Kami akan mengkhaskan [kumpulan yang ditakrifkan] sebelum latihan dan membandingkan [ukuran skor yang dinamakan]. Kami akan memaparkan semua kedudukan.” Tentukan cara melaporkan hasil yang belum muktamad atau lebih buruk sebelum melihatnya.
Kegunaan: “Hasil ini akan membantu [keputusan pengukuran]. Bukti tentang [hasil komersial yang tidak diukur di sini] masih diperlukan sebelum [keputusan komersial].” Ayat terakhir ini mengelakkan latihan ramalan daripada bertukar menjadi unjuran hasil pendapatan tanpa disedari.
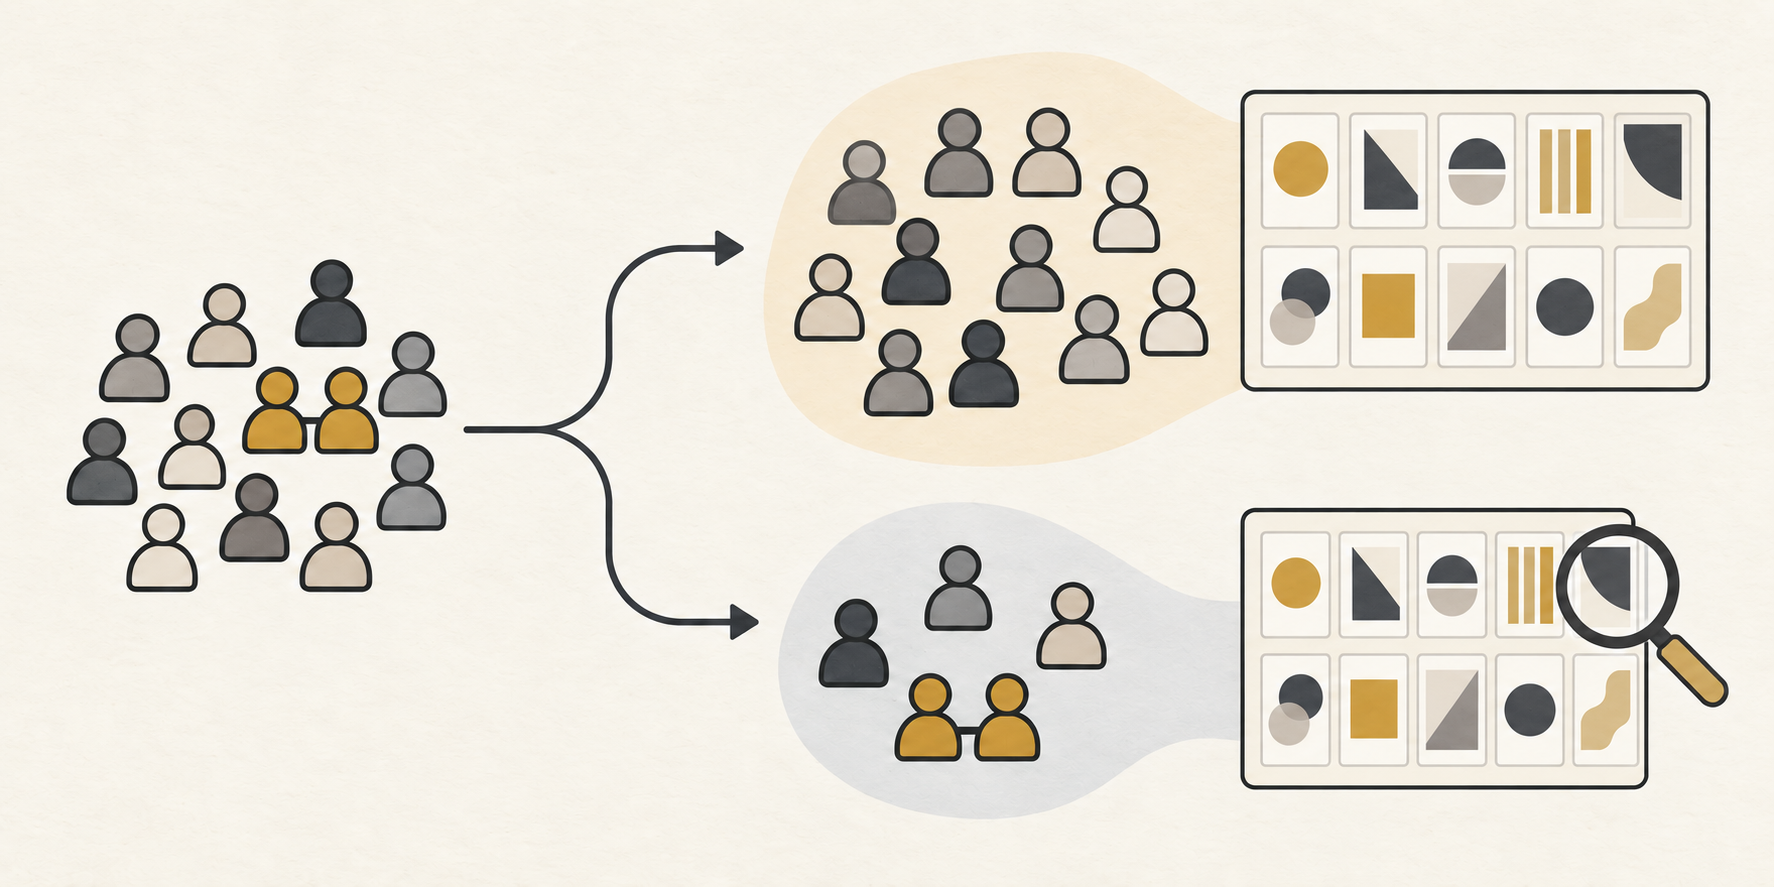
Kekalkan peserta yang sama pada satu sisi ujian
Takrifkan perbandingan
Nyatakan produk, kedudukan, hasil dan unit pemerhatian.
Khaskan kumpulan penilaian
Kekalkan semua respons setiap peserta bersama-sama.
Semak hasil lengkap
Bandingkan ramalan dan tunjukkan setiap kedudukan, termasuk hasil yang lebih buruk.
Contoh penerapan: pencipta kandungan membandingkan tawaran digital
Bayangkan seorang pencipta kandungan rekaan yang menjual buku latihan penulisan, bengkel dan pakej gabungan. Pakej gabungan muncul di bahagian atas halaman pelancaran dan menerima klik terbanyak. Pencipta itu sedang mempertimbangkan untuk menulis semula penerangan produk lain.
Rancangan pengukuran mengubah soalan awal. Hasil yang diperhatikan ialah klik, bukan jualan. Rekod yang tersedia perlu menunjukkan tawaran yang dipaparkan, susunannya dan harganya. Jika pakej gabungan sentiasa mengisi tempat pertama, rekod itu tidak dapat memisahkan pakej tersebut daripada kedudukannya dengan jelas.
Ringkasan lengkap pencipta itu boleh berbunyi: “Kami mahu mengetahui sama ada cara kami mengambil kira kedudukan meramalkan klik daripada pelawat baharu. Kami akan membandingkan tawaran dan maklumat harga yang sama, mengekalkan pemerhatian berulang bersama-sama, dan melaporkan perbandingan semua kedudukan. Kami tidak akan membuat tuntutan pembelian berdasarkan rekod klik.” Ini contoh rekaan soalan pengukuran, bukan hasil yang dicadangkan.
Langkah seterusnya yang munasabah ialah merancang perbandingan dengan variasi mencukupi untuk membezakan produk dan kedudukan, sambil mengekalkan takrif hasil yang sama. Pencipta itu kemudian boleh membandingkan pelarasan kedudukan ringkas dengan yang lebih fleksibel pada kumpulan yang dikhaskan. Ini akan menjadi kajian baharu tentang halaman tersebut; eksperimen buku tidak memberikan jangkaan kadar klik untuknya.
Jika pendekatan fleksibel meramalkan kumpulan yang dikhaskan dengan lebih baik, pencipta itu mempunyai sebab untuk meneliti semula cara laporan mengambil kira penempatan. Itu masih tidak menunjukkan bahawa memindahkan pakej gabungan akan meningkatkan pendapatan. Keputusan komersial memerlukan bukti tentang perubahan persembahan sebenar serta hasil yang penting kepada perniagaan.
Jika perbandingannya belum muktamad, pencipta itu patut menyatakannya. Fleksibiliti tambahan tidak semestinya alat perniagaan yang lebih baik. Manfaat praktikalnya ialah urutan yang lebih jelas: fahami perkara yang dapat dipisahkan oleh rekod, uji andaian pengukuran, kemudian tentukan sama ada eksperimen lain diperlukan.
Bagaimanakah Influence IQ mengira perbandingan ini?
Kami menggunakan keluaran respons yang telah disunting oleh penulis dan peraturan pemilihan asal. Sebanyak 553 rekod rintis atau ujian pertama dikecualikan mengikut kedudukan tetap dalam fail. Rangka yang tinggal mengandungi 10,775 respons. Penapisan kefahaman meninggalkan 9,344; penapisan penyempurnaan meninggalkan 9,265.[2]
Persetujuan, status selesai dan peraturan tempoh minimum 60 saat tidak menyingkirkan respons tambahan pada langkah masing-masing. Penyempurnaan dan tempoh ialah penapis selepas pendedahan, maka kumpulan yang dikekalkan ialah sampel terpilih.
ID peserta Prolific menentukan kumpulan. Pembahagian hash deterministik memperuntukkan dua pertiga kumpulan kepada latihan dan selebihnya kepada ujian, tanpa menggunakan pilihan mereka. Dalam setiap kumpulan, setiap respons tugasan pertama yang dikekalkan berkongsi sumbangan peserta itu secara sama rata. Wajaran yang sama digunakan untuk latihan, pemarkahan dan jadual kedudukan.[3]
Kedua-dua model ialah logit multinomial tanpa penalti, dengan sembilan penunjuk buku dan satu terma harga linear. Model asas menambah satu terma kedudukan linear, menjadikan 11 parameter. Model fleksibel menambah sembilan penunjuk kedudukan, menjadikan 19. Kedudukan pertama dan ID produk dengan nilai berangka terkecil menjadi kategori rujukan. Semua set pilihan yang layak mengandungi sepuluh produk yang sama; ID, harga dan kedudukan terpilih disemak kesepadanannya.
Kami melatih model pada kumpulan latihan, mengekalkan pekali yang diperoleh, kemudian memberi skor kepada pilihan ujian. Selang menggunakan sisihan piawai perbezaan skor peserta berpasangan, 3,088 unit peserta dan 3,087 darjah kebebasan. Ia merupakan selang Student-t anggaran kecuali apabila andaian skor normal untuk ketepatan eksaknya dipenuhi. Kesemua sepuluh perbandingan kedudukan kekal deskriptif.[4]
Pengoptimum utama model asas mengeluarkan amaran berangka. Namun, hasilnya memenuhi setiap syarat ketepatan yang ditetapkan sebelum latihan, termasuk perbandingan dengan titik mula kedua. Kami mengekalkan hasil asal itu; diagnostik terperinci disertakan dalam bahan penghasilan semula.[5]
Muat turun menyediakan hasil yang dipaparkan, kod analisis asli dan output berangka agregat. Baris respons sumber, ID peserta dan ilustrasi buku tidak disertakan. Dapatkan data sumber secara berasingan daripada keluaran penulis. Influence IQ bertanggungjawab terhadap analisis semula ini dan tafsirannya.
CSV menggunakan bahasa halaman ini. Pakej mengandungi kod pengiraan asli, dokumentasi kaedah dalam bahasa Inggeris dan hasil agregat. Baris respons sumber serta aset buku tidak disertakan; dapatkan data secara berasingan daripada keluaran penulis.
Sumber dan nota
- Compiani, Morozov dan Seiler, Demand Estimation with Text and Image Data, manuskrip versi 4, 17 Februari 2026, Bahagian 3 dan Lampiran C. Penulis sudah mengkaji tindak balas terhadap kedudukan dan harga. Perbandingan peserta ujian kami ialah analisis semula asli yang lebih khusus.
- Keluaran DeepLogitReplication oleh penulis pada commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Kami mengikuti batas rintis asal berdasarkan kedudukan dalam fail respons yang disunting serta peraturan kelayakan penulis. Tarikh sumber yang dikekalkan ialah 11–26 Jun 2024, berbeza daripada keterangan 14–27 Jun dalam manuskrip; tarikh tidak menentukan kemasukan.
- Prolific membezakan ID peserta daripada pengecam kajian atau respons. Kami mengekalkan ID peserta yang tepat untuk pengelompokan. ID ini tidak mengesahkan secara bebas bahawa setiap ID mewakili orang berlainan, atau bahawa respons yang dikekalkan ialah pendedahan pertama orang itu.
- Perbandingan Influence IQ yang ditetapkan terlebih dahulu mempuratakan log kebarangkalian model fleksibel ditolak model asas dalam setiap peserta ujian, kemudian merentas peserta. Selang 95% ialah purata ditambah atau ditolak nilai kritikal Student-t didarab sisihan piawai peserta, dibahagi punca kuasa dua 3,088. Ia mengandaikan kumpulan peserta bebas, bersyarat pada model latihan tetap dan tidak merangkumi ketidakpastian latihan; ketepatan eksak memerlukan perbezaan skor bagi setiap peserta dengan taburan normal yang sama dan varians yang sama.
- Latihan model asas daripada titik mula sifar mengeluarkan amaran ketepatan. Nilai mutlak maksimum kecerunan puratanya ialah 3.12×10⁻⁹, susutan Newton 2.50×10⁻⁸ dan perbezaan log kebarangkalian maksimum antara dua titik mula 7.46×10⁻⁸, di bawah had yang ditetapkan terlebih dahulu iaitu 10⁻⁸, 10⁻⁶ dan 10⁻⁷. Kedua-dua model turut memenuhi syarat kelengkungan positif dan kesepadanan nilai fungsi objektif. Pekali utama daripada titik mula sifar dikekalkan.
Artikel bahasa Inggeris ialah versi sumber. Versi bahasa menerangkan eksperimen terdahulu yang sama; hasilnya bukan anggaran tingkah laku membeli-belah khusus negara.