Cronometra la voce fuori campo tradotta prima di fissare il montaggio
Una lettura in inglese può rientrare in una scena, mentre la registrazione tradotta può superarne la durata. Il nostro studio su 200 brani di ricerca abbinati mostra perché la durata della voce fuori campo in più lingue vada inclusa nel passaggio di consegne della produzione, prima di rendere definitive le immagini.
Un’analisi descrittiva delle durate riportate nei metadati delle registrazioni di 200 testi tradotti comuni a 10 configurazioni di test di FLEURS, da un insieme iniziale di 350 testi in inglese. Sono brani di ricerca letti ad alta voce, non lavori commerciali di voce fuori campo. Metadati acquisiti il 24 ottobre 2026 (UTC).
Sintesi
Un’azienda dovrebbe fissare la durata di un video localizzato in base alla voce fuori campo in inglese? Prima cronometra le letture tradotte. Abbiamo confrontato le durate riportate nei metadati delle registrazioni di 200 testi disponibili in tutte le 10 configurazioni di test di FLEURS selezionate. Ogni testo ha ricevuto lo stesso peso dopo aver riassunto le letture ripetute con una mediana per testo. La variazione mediana nei confronti abbinati rispetto all’inglese andava da −6,1% per le registrazioni in olandese a +82,4% per quelle in filippino; nessuno dei 2 valori è un margine di produzione valido per un’intera lingua.[1][2]
Un esempio con una durata fissa di 15 secondi rende concreto il passaggio di consegne. Dei 186 testi la cui mediana inglese rientrava in quella durata, 110 mediane in filippino la superavano. Con una regola più rigorosa, tutte le registrazioni inglesi osservate rientravano per 178 testi, mentre tutte le registrazioni in filippino osservate la superavano per 72. Persone che leggono, composizione per genere, traduzione e pause restano intrecciate. Il contributo è un confronto verificabile delle durate delle registrazioni, con tutti i 9 confronti di destinazione e un esempio scelto prima dei risultati sulle durate, per aiutare i team a richiedere una lettura cronometrata prima di fissare il montaggio.
Chi monta ha pronto un breve video di prodotto. La narrazione in inglese rientra nella durata, il prodotto viene svelato nel fotogramma previsto e l’inquadratura finale lascia spazio all’offerta. Arriva un copione tradotto con lo stesso messaggio. È facile considerare la registrazione come l’ultimo elemento da inserire in una sequenza di montaggio già conclusa.
È qui che un’informazione mancante può diventare un problema di produzione: nessuno ha cronometrato la lettura tradotta. Un copione approvato per il significato non dice a chi monta quanto durerà la sua esecuzione registrata. Un passaggio di consegne utile comprende sia il testo approvato sia la durata della registrazione.
Abbiamo esaminato questa distinzione in FLEURS, un corpus di ricerca di brani tradotti letti ad alta voce. Nei 200 testi corrispondenti, i rapporti tra le durate registrate variavano sia tra le configurazioni sia tra le letture dello stesso brano. Le tabelle seguenti conservano queste differenze. Offrono a un’azienda o a chi crea contenuti un motivo per richiedere riscontri sulle durate della produzione effettiva, senza trasformare una media di ricerca in un margine promesso.
Assegna a ogni versione registrata la propria durata
Confronta lo stesso brano prima di adottare una regola sulla durata
La prima tabella confronta ogni configurazione di destinazione con l’inglese statunitense per gli stessi 200 testi di partenza. Per ogni testo e configurazione abbiamo calcolato la mediana delle durate delle registrazioni disponibili. Abbiamo poi diviso la mediana di destinazione per quella inglese ed espresso lo scarto da 1 come percentuale. Infine abbiamo riassunto queste 200 variazioni abbinate. Un testo con 3 letture ha quindi ricevuto lo stesso peso di uno con 1.[2][4]
Per le registrazioni in spagnolo latinoamericano, la variazione mediana abbinata era +24,8%. La metà centrale delle variazioni per testo andava da +10,2% a +47,0%. Per il giapponese, la mediana corrispondente era +36,6%, con una metà centrale da +17,8% a +61,8%. Questi valori descrivono le registrazioni pubblicate di brani corrispondenti; non prescrivono come debba essere eseguita la lettura in nessuna delle 2 lingue.
Questo calcolo è diverso dal dividere 2 mediane complessive delle durate. Sugli stessi testi comuni, la mediana dei valori riepilogativi dei testi inglesi era 9,3 secondi e l’equivalente spagnola era 11,6 secondi. Dividere questi numeri visualizzati non ricostruirebbe il risultato abbinato di +24,8%. Abbiamo prima abbinato ogni brano, così il confronto mantiene un breve brano di destinazione accanto al proprio riferimento inglese anziché a un altro brano vicino al centro della distribuzione.
Le registrazioni in olandese avevano una variazione mediana abbinata di −6,1%, mentre quelle in filippino di +82,4%. Mantenerle entrambe nella tabella rende visibile la varietà dei rapporti osservati. Evita anche che l’articolo lasci intendere che ogni registrazione tradotta fosse più lunga. Nell’insieme comune, 71 mediane per testo in olandese erano superiori a quelle inglesi, 2 erano uguali e le restanti erano inferiori.
Le righe seguono l’ordine fisso delle configurazioni usato nell’analisi, anziché essere ordinate per risultato. Leggi la riga pertinente al confronto con la fonte e mantieni il suo contesto di ricerca. Lo spagnolo latinoamericano e il filippino sono gli ambiti di origine del dataset; pubblicare questo articolo in un’altra lingua non trasforma quelle registrazioni in prove relative a quel mercato.
Variazione abbinata della durata delle registrazioni rispetto all’inglese statunitense
Gli stessi 200 testi di partenza tradotti in ogni riga. La durata mediana di destinazione di ogni testo viene divisa per la sua mediana inglese; lo scarto da 1 è espresso come percentuale. Q25 e Q75 delimitano la metà centrale di queste variazioni abbinate.
| Configurazione di registrazione di destinazione | Variazione relativa mediana (%) | Variazione al 25º percentile (%) | Variazione al 75º percentile (%) |
|---|---|---|---|
| spagnolo latinoamericano | 24,8% | 10,2% | 47,0% |
| francese (Francia) | 5,7% | -10,0% | 29,1% |
| tedesco (Germania) | 31,4% | 0,0% | 62,4% |
| olandese (Paesi Bassi) | -6,1% | -21,6% | 8,9% |
| indonesiano (Indonesia) | 26,3% | 11,4% | 49,9% |
| malese (Malaysia) | 11,3% | -1,2% | 29,1% |
| filippino (Filippine) | 82,4% | 54,2% | 120,1% |
| thailandese (Thailandia) | 20,8% | 1,6% | 42,0% |
| giapponese (Giappone) | 36,6% | 17,8% | 61,8% |
La dispersione conta quando il lavoro ha una durata fissa
Una mediana riassume 200 rapporti in un solo numero. Una scena specifica deve comunque accogliere una lettura specifica. I quartili accanto a ogni mediana mostrano perché riportare nel brief solo il valore centrale significherebbe scartare informazioni pertinenti a quella decisione.
Le registrazioni in francese avevano una variazione mediana abbinata di +5,7%, ma la metà centrale andava da −10,0% a +29,1%. Una differenza centrale modesta coesisteva con brani sia più brevi sia più lunghi della durata inglese. Le registrazioni in tedesco avevano una variazione mediana di +31,4%, con una metà centrale da circa 0,0% a +62,4%. Lo 0,0% visualizzato è arrotondato; il quartile inferiore non arrotondato era leggermente positivo.
Questi intervalli descrivono la metà centrale delle variazioni abbinate osservate. Non sono intervalli di confidenza, limiti dal minimo al massimo o un intervallo che conterrà una futura registrazione commerciale. I brani, le traduzioni e le esecuzioni di partenza sono diversi da un nuovo copione di prodotto. Anche riprodurre esattamente la percentuale mediana della tabella lascerebbe il team di produzione senza la registrazione effettiva necessaria per il montaggio.
Questa distinzione cambia la domanda in modo pratico. Anziché chiedere quanto tempo in più serva sempre a una lingua, chi produce può chiedere se la lettura tradotta approvata rientra nella scena prevista. La tabella spiega perché questa verifica è utile; la registrazione del lavoro fornisce la risposta.
Uno stesso brano può avere più durate di registrazione
Il testo di partenza 1662 è stato scelto perché aveva l’ID più basso disponibile in tutte le 10 configurazioni, prima di riassumere le durate. La sua tabella include ogni lettura disponibile per quel testo. Non abbiamo cercato un esempio eclatante dopo aver visto le durate e qui non riproduciamo né le parole né l’audio del testo.[3][4]
I 2 file inglesi duravano circa 8,4 e 11,2 secondi, con una mediana di 9,8 secondi. I 3 file tedeschi andavano da 10,4 a 23,5 secondi, con una mediana di 10,5. I 2 file in filippino andavano da 22,3 a 24,9 secondi, con una mediana di 23,6. Sono durate dei file completi riportate nei metadati di origine, arrotondate a 1 decimale per la visualizzazione.
La mediana di 2 letture può essere un punto medio aritmetico anziché la durata di un file effettivamente registrato. Il valore inglese visualizzato di 9,8 secondi è proprio un riepilogo di questo tipo. Chi monta e sceglie una registrazione deve comunque usare la durata del file selezionato. Il numero di registrazioni e l’intervallo dal minimo al massimo rendono visibile questa distinzione accanto alla mediana.
La dispersione tedesca invita anche a non attribuire ogni secondo alla lunghezza della traduzione. Non abbiamo ID delle persone che leggono e non abbiamo ascoltato le registrazioni né separato il parlato dalle pause. Qui non è possibile distinguere gli effetti della modalità di lettura, delle persone e delle condizioni di registrazione. L’esempio sostiene una semplice richiesta di produzione: invia la registrazione prevista, oppure una lettura cronometrata del testo previsto, anziché una sola stima per lingua.
Testo 1662: mantieni l’intervallo delle registrazioni accanto alla mediana
L’ID di origine più basso con registrazioni in tutte le 10 configurazioni, scelto in base alla disponibilità prima dei riepiloghi delle durate. Sono incluse tutte le registrazioni disponibili. I secondi descrivono i file completi nei metadati di origine, senza separare le pause.
| Configurazione di registrazione | Registrazioni disponibili | File più breve (secondi) | Durata mediana dei file (secondi) | File più lungo (secondi) |
|---|---|---|---|---|
| inglese statunitense | 2 | 8,4 | 9,8 | 11,2 |
| spagnolo latinoamericano | 3 | 8,8 | 9,5 | 9,5 |
| francese (Francia) | 2 | 6,4 | 6,8 | 7,1 |
| tedesco (Germania) | 3 | 10,4 | 10,5 | 23,5 |
| olandese (Paesi Bassi) | 1 | 7,9 | 7,9 | 7,9 |
| indonesiano (Indonesia) | 1 | 11,6 | 11,6 | 11,6 |
| malese (Malaysia) | 2 | 8,0 | 8,6 | 9,1 |
| filippino (Filippine) | 2 | 22,3 | 23,6 | 24,9 |
| thailandese (Thailandia) | 3 | 6,5 | 8,7 | 10,1 |
| giapponese (Giappone) | 2 | 12,1 | 13,3 | 14,6 |
Un esempio da 15 secondi richiede il suo denominatore
Abbiamo fissato 15 secondi come esempio per la pianificazione prima di calcolare i risultati. Non è un requisito di una piattaforma, una durata consigliata per un annuncio o un margine sicuro per la produzione. La domanda era se un valore riepilogativo di una registrazione inglese potesse rientrare in quella durata mentre il corrispondente valore di destinazione la superava.
Dei 200 testi comuni, 186 avevano una mediana inglese non superiore a 15 secondi. In questo gruppo idoneo, la mediana di destinazione superava 15 secondi per 20 testi in spagnolo latinoamericano, 39 in tedesco, 9 in olandese, 110 in filippino e 37 in giapponese. Ogni conteggio ha lo stesso denominatore di 186; gli altri confronti sono conservati nel file scaricabile.[6]
Abbiamo usato anche una regola più rigorosa sulle registrazioni osservate. Ogni lettura inglese disponibile doveva rientrare in 15 secondi e ogni lettura di destinazione disponibile doveva superarli. I testi inglesi idonei erano 178. Questo accadeva per 11 testi in spagnolo, 9 in tedesco, 4 in olandese, 72 in filippino e 14 in giapponese. Questi conteggi riguardano solo le registrazioni pubblicate, non ogni possibile esecuzione del brano.
La verifica più rigorosa evita di affidarsi a un punto medio aritmetico che nessuno ha registrato. Non dimostra comunque che un brano non possa essere letto più rapidamente, montato diversamente o riscritto in modo appropriato. Per un team, la distinzione utile è tra la prova che una specifica registrazione fornita rientri nella durata e l’ipotesi che un’altra versione vi rientri perché ci rientrava quella inglese.
Un lancio immaginario mostra dove inserire il passaggio di consegne
Immagina un piccolo marchio inventato di utensili da cucina che commissiona a una persona che crea contenuti un video di prodotto di 15 secondi. L’idea prevede una dimostrazione, un’offerta e un’inquadratura finale del prodotto. La lettura in inglese dura 11 secondi. Una bozza tradotta viene approvata per il significato, ma la prima lettura della voce narrante prevista dura 17 secondi. Il marchio, il copione, le durate e l’incarico di questo esempio sono immaginari; non sono osservazioni di FLEURS.
Se chi crea il video ha già fissato ogni inquadratura sulla lettura inglese, il file da 17 secondi impone una decisione a montaggio avanzato. Chi segue il cliente può evitare che questa scelta resti implicita chiedendo una lettura cronometrata mentre il testo tradotto è ancora in revisione. Il brief dovrebbe indicare il messaggio che deve restare accurato, il tempo disponibile per la scena e chi può approvare modifiche all’uno o all’altro.
La risposta non deve essere per forza accelerare automaticamente la voce narrante. Chi traduce potrebbe proporre una formulazione naturale più breve che conservi l’offerta. Chi monta potrebbe dare più tempo alla dimostrazione, spostare un dettaglio secondario nel testo di accompagnamento o preparare un montaggio separato se il formato concordato lo consente. Sono opzioni di produzione da discutere, non miglioramenti dimostrati dalla nostra analisi del corpus.
Un passaggio di consegne utile per questo lavoro immaginario potrebbe essere: «Versione di destinazione: __. Copione approvato: __. Registrazione prevista: __ secondi, misurati sul file fornito. Tempo assegnato alla scena: __ secondi. Testo dell’offerta e informative obbligatorie: __. Persona che approva le modifiche al copione: __. Persona che approva il montaggio: __.» Gli spazi vuoti spettano al team effettivo; la tabella di ricerca non può compilarli.
Con più versioni di destinazione, chi segue il cliente può mantenere una riga per ogni registrazione prevista anziché segnare l’intero progetto come «traduzione approvata». L’approvazione del testo e quella della durata rispondono a domande diverse. Se chi traduce modifica un’affermazione sul prodotto dopo la lettura provvisoria, la riga dovrebbe indicare quella modifica prima che chi crea il video riutilizzi la durata precedente. È un modo proposto per organizzare l’incarico immaginario, non una riduzione del rischio di progetto verificata.
Quando viene fornita una registrazione rivista, chi crea il video può rivedere la versione completa con la persona responsabile della lingua e del significato. Valutare l’idoneità solo dalla durata può far sfuggire una lettura poco naturale o un fotogramma finale illeggibile. Questo studio non ha misurato né la qualità né la risposta del pubblico. Il suo contributo all’incarico immaginario è conoscere prima la durata della registrazione, mentre le persone che realizzano il video restano responsabili della scelta creativa.
Mantieni testo, registrazione e immagini insieme durante la revisione
Per la durata della voce fuori campo in più lingue, il documento utile è abbastanza breve da accompagnare il lavoro. Identifica la versione approvata del copione, la registrazione prevista e la durata della scena. Se uno di questi elementi cambia, chi riceve il successivo passaggio di consegne può vedere quali riscontri sulle durate sono ancora validi.
Una lettura provvisoria cronometrata può far emergere un conflitto mentre il team ha ancora possibilità di scelta. Deve restare indicata come provvisoria, anziché essere considerata la prova che la voce narrante finale manterrà la stessa durata. Quando arriva la registrazione prevista, sostituisci l’ipotesi con la durata misurata e rivedila nel montaggio effettivo.
Mantieni integra la versione tradotta durante questa revisione. Chi verifica il significato deve ascoltare la lettura insieme alle immagini, mentre chi monta deve vedere se pause, momenti in cui viene svelato il prodotto e fotogramma finale funzionano insieme. Un file che rientra in una durata è un elemento di riscontro; non è l’approvazione di tutto ciò che compone la versione.
I 4 passaggi seguenti sono una proposta di passaggio di consegne, non un flusso di lavoro verificato in FLEURS. Applicano la distinzione dello studio tra testo e durata registrata a una decisione di produzione. Non promettono risultati su copertura, fidelizzazione del pubblico, conversioni o numero di revisioni necessarie per un progetto.
Accompagna la durata della registrazione nei 4 passaggi di consegne
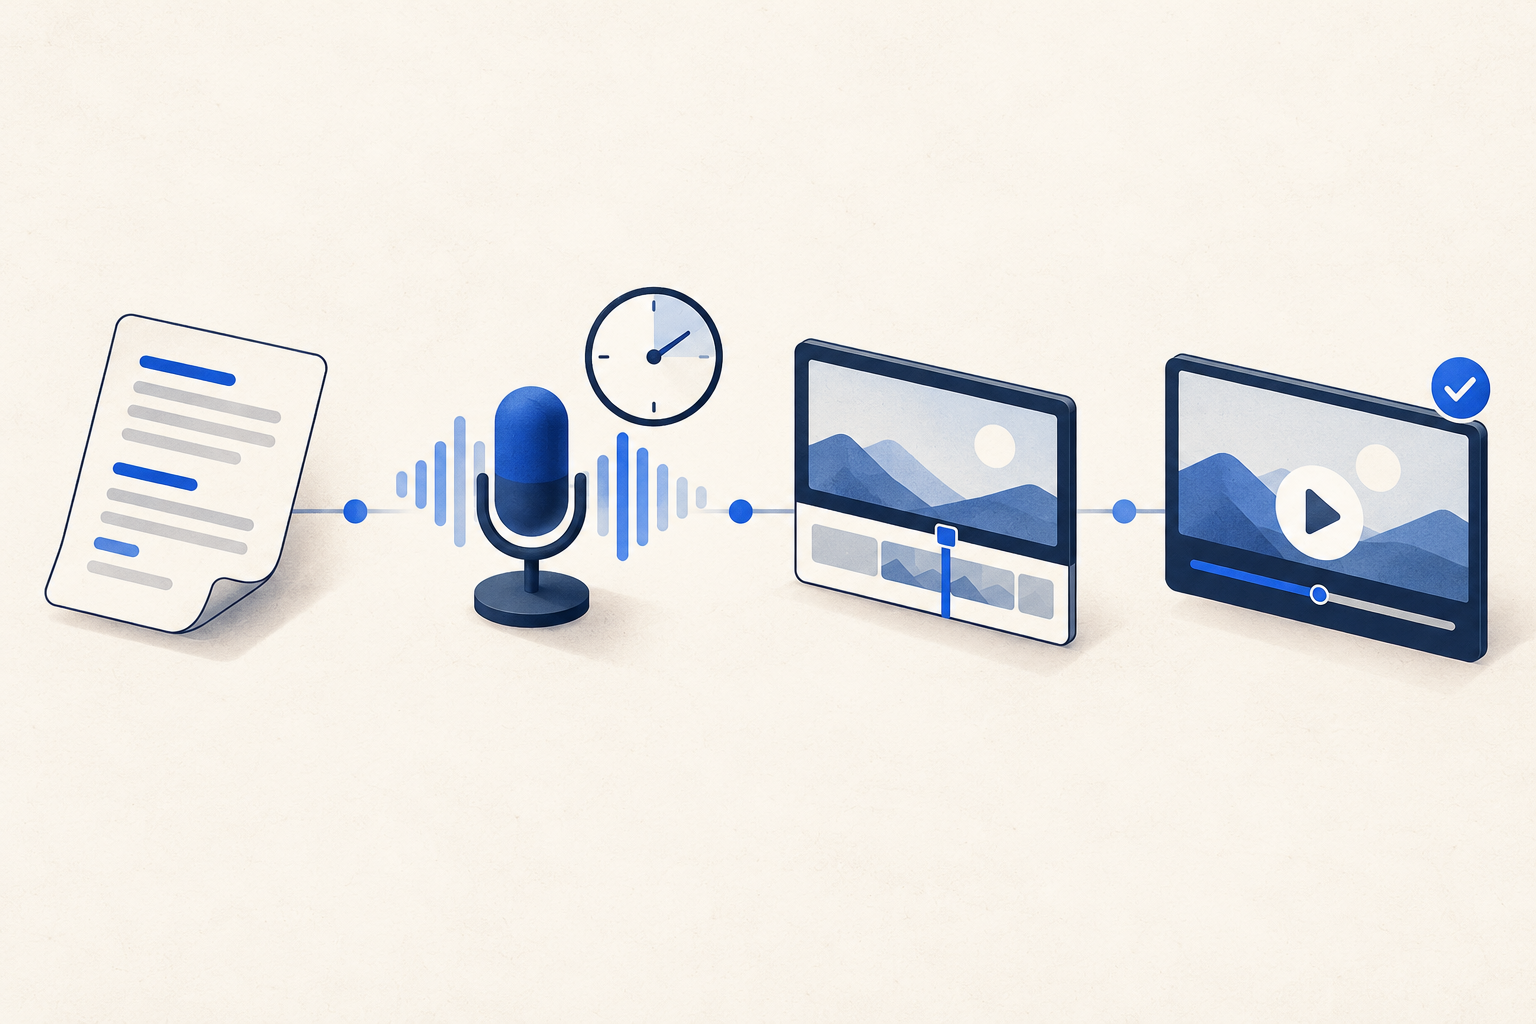
Concorda il testo
Identifica la versione di destinazione, il copione approvato e la persona che verifica il significato.
Cronometra la lettura prevista
Allega la durata misurata della registrazione; indica come provvisoria una lettura di prova.
Risolvi il problema della durata
Concorda ogni modifica al copione o alla scena prima di fissare il montaggio.
Rivedi l’intera versione
Verifica la registrazione scelta insieme alle immagini, all’offerta e al fotogramma finale.
Mantieni visibile l’insieme abbinato quando riutilizzi un numero
Il confronto comune include 200 dei 350 testi di test inglesi. Nei restanti 150 mancava almeno una delle configurazioni selezionate. La disponibilità completa può essere selettiva, quindi l’insieme comune non va descritto come un campione casuale di copioni, lingue o lavori di voce fuori campo.
Abbiamo ripetuto ogni confronto inglese–destinazione usando tutte le coppie corrispondenti disponibili. Questi denominatori andavano da 251 per l’olandese a 349 per il filippino e il thailandese. Abbiamo anche ripetuto i confronti sull’insieme comune usando solo testi con almeno 2 letture inglesi e 2 letture di destinazione; questi sottoinsiemi andavano da 66 a 166 testi. Tutti i 9 risultati abbinati e i relativi denominatori sono nel file scaricabile.[4]
I sottoinsiemi con letture ripetute mantenevano la stessa direzione della variazione mediana abbinata del confronto principale in ogni configurazione. È una verifica utile di questa specifica scelta di riepilogo. Non controlla chi legge e non rende i diversi campioni abbinati popolazioni confrontabili. Le registrazioni ripetute non sono partecipanti indipendenti.
Le registrazioni acquisite in tedesco, olandese, indonesiano, malese e filippino erano tutte etichettate come maschili; quelle in thailandese erano tutte etichettate come femminili. Inglese, spagnolo, francese e giapponese avevano etichette miste. Senza identificativi delle persone che leggono, l’analisi non può separare la configurazione dalla composizione di chi legge, dall’esecuzione, dalla traduzione o dal mantenimento delle registrazioni nel corpus. Leggi la tabella come una descrizione di queste registrazioni, riportando questo limite accanto a ogni numero riutilizzato.[7]
Come è stato realizzato il confronto delle durate delle registrazioni
FLEURS è un corpus di ricerca presentato nel 2022 che usa brani tradotti letti ad alta voce. La documentazione del produttore e di TensorFlow Datasets identifica un ID del testo di origine condiviso tra le lingue e un campo di metadati per il numero totale di campioni audio a 16.000 Hz. Abbiamo diviso quel campo per 16.000 per ottenere i secondi del file completo riportati nei metadati. Non abbiamo decodificato l’audio, verificato la lunghezza delle forme d’onda o rimosso il silenzio.[1][2]
Abbiamo acquisito i 10 file di metadati di test alla revisione fissa del produttore documentata nelle note il 24 ottobre 2026 (UTC). Contengono 7.528 registrazioni sui testi disponibili. L’abbinamento ha usato gli ID di origine, mai la posizione delle righe. L’insieme comune di 200 testi, le regole dei 15 secondi, la verifica delle letture ripetute e l’esempio 1662 sono stati fissati dopo aver conosciuto la disponibilità e prima di calcolare i riepiloghi delle durate.[3][4]
La data di acquisizione identifica la versione della fonte che abbiamo usato. Non trasforma registrazioni introdotte con un corpus di ricerca del 2022 in un’indagine del 2026 su voci narranti o persone che creano contenuti. I dati pubblici conservano la revisione della fonte, così chi legge in seguito può distinguere una nuova analisi di materiale esistente da esecuzioni raccolte di recente.
Un precedente tentativo di fattibilità sulla partizione di sviluppo aveva prodotto solo 91 testi comuni, sotto la soglia di 100 testi, ed era stato accantonato. L’acquisizione di test si era inizialmente fermata a un limite di dimensione dei metadati thailandesi; un limite maggiore documentato ha completato lo stesso insieme di test fissato. Sono modifiche dichiarate di fattibilità e accesso, non prove di uno studio preregistrato selezionato senza conoscere i risultati.
Tutti i calcoli abbinati hanno usato conteggi esatti di campioni audio e frazioni. I quartili usano l’interpolazione lineare alle posizioni definite da (n−1) × p. Le tabelle mostrano percentuali e secondi con 1 decimale, arrotondando al più vicino e, a parità di distanza, lontano da zero; i conteggi delle registrazioni restano interi. I dati derivati pubblici conservano i riepiloghi esatti per testo, i risultati a coppie, le verifiche di sensibilità e le 2 definizioni della durata limite. Non abbiamo calcolato intervalli di confidenza della popolazione o effetti causali.[4]
I vincoli di durata nel doppiaggio sono già un tema consolidato di ricerca.[5] Questo articolo aggiunge un confronto riproducibile delle durate dei file pubblicati per questi brani fissi, insieme alle informazioni necessarie per esaminarne la copertura e le registrazioni ripetute. Sostiene la richiesta di riscontri sulle durate per una produzione tradotta prima di fissare il montaggio; non fornisce una percentuale universale di allungamento.
- Scarica i 67 risultati visualizzati (CSV)
- Scarica tutti i 350 testi × 10 configurazioni e i riepiloghi delle registrazioni (CSV)
- Scarica tutti i 9 confronti abbinati, le verifiche di sensibilità e i conteggi per le durate limite (CSV)
- Scarica le fonti, il metodo e il codice di riproduzione (ZIP)
Non serve registrarsi. I dati derivati conservano le combinazioni mancanti e i denominatori effettivi dei confronti. Il pacchetto condiviso contiene documentazione del metodo in inglese, riferimenti alle fonti e codice di riproduzione; non vengono ridistribuiti trascrizioni o audio originali. Ogni edizione linguistica descrive lo stesso corpus fisso.[8]
Note di ricerca
- Conneau e altri, FLEURS: valutazione dell’apprendimento con pochi esempi di rappresentazioni universali del parlato (2022), sezioni 2.1–2.3. Il corpus contiene brani tradotti letti ad alta voce con fino a 3 registrazioni validate per frase, campionate a 16 kHz. La raccolta e la finalità di ricerca non ne dimostrano la rappresentatività per la produzione commerciale di voce fuori campo. I brani di origine provengono da FLORES; non sono un campione di copioni pubblicitari.
- TensorFlow Datasets, documentazione delle caratteristiche della versione 2 di xtreme_s e relativo parser. L’ID del testo di origine è coerente tra le lingue e può ripetersi tra le letture; num_samples registra il numero totale di campioni audio. La caratteristica audio dichiara 16.000 Hz. Il parser copia i conteggi dei metadati anziché verificarli rispetto alle forme d’onda decodificate. I nostri secondi sono durate dei file completi riportate nei metadati, senza separare le pause né controllare l’identità di chi legge.
- Metadati Google FLEURS, revisione fissa ab93cf03f9d0cd083c853fad065a6377067408aa, partizione di test, acquisiti il 24 ottobre 2026 (UTC). Configurazioni: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th e ja_jp. Il TSV inglese collegato è uno dei 10 file di origine; il pacchetto registra ogni URL di origine esatto e il relativo SHA256. Lo spagnolo della fonte è latinoamericano e fil_ph è il filippino.
- Calcoli di Influence IQ: una mediana per testo in ogni configurazione; pesi uguali per i testi; rapporto tra mediane di destinazione e inglesi abbinate e differenza abbinata in secondi. L’insieme primario comprende i 200 testi comuni a tutte le 10 configurazioni, da 350 testi inglesi. I confronti secondari usano tutte le coppie inglese–destinazione disponibili e i testi comuni con almeno 2 registrazioni per lato. Il metodo e la scelta dell’esempio sono stati fissati prima dei riepiloghi delle durate, dopo aver conosciuto la disponibilità. Frazioni esatte, interpolazione, arrotondamento e tutti i denominatori sono documentati nel pacchetto di riproduzione.
- Il doppiaggio nella pratica: uno studio su larga scala della localizzazione umana con indicazioni per il doppiaggio automatico (2023). Studi precedenti esaminano già le durate nel doppiaggio professionale umano. Il nostro contributo è la tabella finita delle durate abbinate dei file FLEURS e la sua interpretazione riutilizzabile per il passaggio di consegne nella produzione, non la scoperta dei vincoli di durata nel doppiaggio o un riferimento prestazionale per il doppiaggio professionale.
- La durata di 15 secondi è stata fissata come esempio di pianificazione prima dei risultati. Regola della mediana: 186 testi comuni hanno una mediana inglese ≤15 secondi; si contano le mediane di destinazione >15. Regola di tutte le registrazioni osservate: 178 testi hanno ogni registrazione inglese ≤15; si contano i testi con ogni registrazione di destinazione osservata >15. L’uguaglianza al limite rientra nella durata. I conteggi sono risultati descrittivi delle registrazioni pubblicate, non indicazioni di una piattaforma o un’affermazione su ogni lettura possibile.
- I metadati acquisiti non hanno ID delle persone che leggono. Le registrazioni in tedesco, olandese, indonesiano, malese e filippino sono tutte etichettate come maschili; quelle in thailandese sono tutte etichettate come femminili. Le configurazioni mancanti escludono 150 dei 350 testi inglesi dall’insieme comune. Le verifiche a coppie e con letture ripetute descrivono sottoinsiemi finiti diversi e non eliminano l’intreccio tra chi esegue, genere, modalità di lettura, traduzione e mantenimento delle registrazioni nel corpus. Non vengono riportati intervalli di confidenza, classifiche di velocità delle lingue, effetti causali o previsioni commerciali.
- Fonte: Google FLEURS, fornito con licenza CC BY 4.0. Selezione, calcoli, tabelle, interpretazione editoriale e traduzioni sono adattamenti di Influence IQ; non è implicita alcuna approvazione da parte degli autori del dataset. Il pacchetto pubblico ridistribuisce riepiloghi numerici derivati e codice, non audio o testi dei brani originali. L’arrotondamento per la visualizzazione non modifica i conteggi esatti della fonte o l’insieme condiviso delle registrazioni.
L’articolo inglese è la fonte di tutte le versioni linguistiche. Ogni edizione riporta le stesse registrazioni di test e gli stessi brani tradotti di FLEURS fissati per lo studio; la lingua dell’articolo non crea prove relative a un nuovo mercato. Influence IQ è responsabile dell’analisi, dell’interpretazione e delle traduzioni.