Misura le clip dei podcast prima di normalizzarle di nuovo
In uno studio di caso su 72 clip, controllare l’esportazione esistente e correggere 9 clip ha permesso di rispettare gli stessi limiti di consegna ottenuti normalizzandole tutte e 72. Il compromesso comprendeva 9 esportazioni aggiuntive.
Abbiamo confrontato 72 clip fisse da 6 programmi HPR pubblicati dall’8 al 21 ottobre 2026, dopo aver normalizzato in laboratorio ogni episodio completo.
Sintesi
Un creator dovrebbe normalizzare di nuovo ogni clip di un podcast dopo aver preparato il master dell’episodio completo? Abbiamo confrontato 3 flussi di lavoro su 72 clip fisse da 15, 30 e 60 secondi ricavate da 6 programmi HPR pubblicati. Riutilizzando il master dell’episodio abbiamo ottenuto 63 esportazioni chiaramente entro i nostri limiti di loudness e picco reale, 7 sicuramente fuori limite e 2 casi al limite.
Sia normalizzare ogni estratto sia misurare le esportazioni esistenti prima di correggerle in modo selettivo hanno prodotto 72 file finali entro i limiti. La correzione selettiva ha richiesto 9 normalizzazioni e 81 esportazioni; normalizzare sempre ne ha richieste rispettivamente 72 e 72. Con la correzione selettiva, la somma delle mediane del tempo trascorso di elaborazione nativa per finestra è stata di 64,0 secondi, contro 108,6 secondi normalizzando sempre. Questo test circoscritto supporta una decisione di conservazione o correzione sull’esportazione finale; non stima la risposta degli ascoltatori né il tempo completo di produzione di chi monta l’audio.
Hai completato un episodio del podcast e preparato il suo master audio. Ora a chi si occupa della pubblicazione servono estratti brevi. La loudness dell’episodio è già stata impostata, ma i nuovi file ne contengono solo una piccola parte. Ogni estratto deve essere normalizzato di nuovo oppure alcune esportazioni possono mantenere l’audio ereditato dal master?
Abbiamo testato questa decisione con 3 flussi di lavoro effettivi: riutilizzare il master, normalizzare ogni estratto oppure misurare ogni esportazione esistente e correggere solo quelle che non rispettavano chiaramente i limiti scelti. Il confronto comprendeva i controlli e le esportazioni sostitutive richiesti da ogni percorso: evitare un passaggio di normalizzazione non bastava, da solo, a essere considerato un risparmio.
La maggior parte delle esportazioni di questo insieme poteva essere conservata. Secondo la regola scelta, 9 richiedevano una correzione. Controllare prima ha prodotto lo stesso numero di file finali entro i limiti ottenuto normalizzando sempre, con meno operazioni di normalizzazione ma più esportazioni. Per un creator o una piccola attività, la scelta riguarda come preparare e approvare i file da consegnare alla persona successiva.
Un episodio completo diventa più file brevi
La decisione si prendeva sull’esportazione finita
Un episodio può rispettare un obiettivo complessivo di loudness mentre un estratto breve ne resta fuori. La loudness integrata riassume l’audio nell’intervallo misurato. Cambiare quell’intervallo cambia ciò che viene riassunto. Uno scambio a basso volume, un passaggio più forte o una pausa possono occupare una quota diversa di una clip breve rispetto all’intero episodio.
Abbiamo usato 2 misure di consegna. La loudness integrata, qui espressa in LUFS, descrive il livello sull’intera clip secondo le regole di ponderazione e gating del misuratore. Il picco reale stima i picchi tra i campioni digitali. Superare un controllo non dimostra che sia superato anche l’altro e nessuno dei due è una valutazione all’ascolto della chiarezza del parlato, del rumore o della qualità del montaggio.
Il nostro riferimento era la raccomandazione di Apple per i podcast: loudness complessiva intorno a −16 con una tolleranza di ±1 e picco reale non superiore a −1. Apple esprime la raccomandazione di loudness in LKFS; il nostro misuratore FFmpeg riporta LUFS. Abbiamo testato un intervallo di consegna da −17 a −15 LUFS e un limite di picco reale di −1 dBTP. Sono i limiti scelti per questo confronto, non un requisito di ogni piattaforma social.[3]
L’elaborazione dell’episodio completo puntava a −16 LUFS e −1,5 dBTP. Abbiamo poi ricavato gli stessi estratti fissi da quel master per tutti e 3 i flussi di lavoro. Ogni file finale era AAC stereo a 192 kbps e 48 kHz in un contenitore M4A. Abbiamo misurato l’esportazione decodificata: il risultato descrive quindi il file prodotto dal flusso di lavoro, non solo l’audio in ingresso al codificatore.
Il flusso di riutilizzo esportava ogni estratto e lo controllava. Quello di normalizzazione sistematica normalizzava ogni estratto prima di esportarlo e controllarlo. Il flusso di misurazione e correzione partiva dall’esportazione di riutilizzo, la conservava se superava il controllo e altrimenti la correggeva. Tutti e 3 comprendevano quindi un controllo finale di consegna.
L’esito finale di consegna per le stesse 72 finestre
Ogni flusso di lavoro ha usato tutte e 72 le finestre fisse dagli stessi master degli episodi. I conteggi descrivono finestre distinte; le ripetizioni cronometriche non sono clip aggiuntive.
| Flusso di lavoro | Chiaramente entro i limiti | Sicuramente fuori limite | Casi al limite |
|---|---|---|---|
| Riutilizza il master | 63 | 7 | 2 |
| Normalizza ogni estratto | 72 | 0 | 0 |
| Misura, poi correggi | 72 | 0 | 0 |
9 correzioni hanno sostituito 72 normalizzazioni
Delle 72 esportazioni ricavate direttamente dai master degli episodi, 63 rientravano chiaramente in entrambi i limiti di consegna. Altre 7 erano chiaramente fuori da almeno 1 limite. Le restanti 2 erano troppo vicine a un confine perché la precisione visualizzata del misuratore permettesse di stabilire con certezza un esito positivo o negativo. Abbiamo mantenuto visibile questa terza categoria, senza trattare quei file come sicuramente fuori limite.
Il flusso selettivo ha corretto sia i 7 file sicuramente fuori limite sia i 2 casi al limite. Tutte le sue 72 esportazioni finali rispettavano la regola conservativa di esito positivo. Anche normalizzare ogni estratto ha prodotto 72 esportazioni finali che rispettavano quella regola. La differenza era quanto audio veniva elaborato di nuovo: 9 estratti nel flusso selettivo, contro tutti e 72 in quello di normalizzazione sistematica.
Quel risparmio comportava esportazioni aggiuntive. La correzione selettiva produceva prima 72 file, poi ne sostituiva 9, per un totale di 81 esportazioni. Normalizzare sempre produceva 72 esportazioni. A un creator che deve scegliere servono entrambi i numeri. Meno operazioni di normalizzazione non significano automaticamente meno file scritti o meno elaborazione totale.
Per ogni correzione siamo tornati all’estratto originale senza perdita ricavato dal master dell’episodio. Abbiamo misurato quell’estratto per normalizzarlo, applicato il secondo passaggio, esportato un file AAC sostitutivo e controllato il sostituto. Non abbiamo normalizzato un file AAC già codificato né usato le sue misurazioni per impostare il guadagno di un diverso ingresso PCM.
Controllare prima aveva comunque un costo di elaborazione
Il flusso selettivo ha impiegato meno tempo di elaborazione misurato rispetto alla normalizzazione di ogni clip, anche includendo le esportazioni e i controlli aggiuntivi. Le somme delle mediane del tempo trascorso per finestra erano 52,3 secondi per il riutilizzo, 108,6 secondi normalizzando sempre e 64,0 secondi misurando prima e correggendo poi. Il tempo CPU seguiva lo stesso ordine: rispettivamente 56,3, 120,1 e 69,3 secondi.
Questi totali includono i processi FFmpeg e ffprobe richiesti da ogni flusso: esportazione, lettura delle proprietà dei file, decodifica per i controlli di qualità, scansione PCM per la normalizzazione ed eventuale esportazione sostitutiva. Nel flusso selettivo, la prima esportazione e il primo controllo venivano conteggiati anche quando il file richiedeva poi una correzione. Venivano conteggiati anche la seconda esportazione e il secondo controllo.
Ogni finestra ha attraversato ciascun flusso di lavoro 3 volte, con ordine di esecuzione ruotato. Abbiamo calcolato il tempo mediano di elaborazione per ogni finestra, poi sommato quelle 72 mediane. La tabella mostra quindi una somma di mediane per finestra, non il tempo trascorso di 1 insieme di produzione osservato. Le 648 esecuzioni sono ripetizioni cronometriche delle stesse 72 finestre nei 3 flussi di lavoro, non 648 clip diverse.
Le misurazioni provengono da 1 computer Apple M4 con 1 worker. Comprendono l’elaborazione nativa di FFmpeg e ffprobe, incluso l’avvio dei processi. Escludono hashing e serializzazione in Python, la preparazione condivisa dei master degli episodi completi e degli estratti e il tempo che una persona dedica a scegliere, rivedere o consegnare le clip. Non sono stime del tempo completo di lavoro di chi monta l’audio.
Questo ambito cambia la scelta pratica. Un team il cui sistema di esportazione misura già i file finali potrebbe usare il risultato per decidere quali estratti richiedono un altro passaggio di normalizzazione. Un team che deve aprire uno strumento separato e gestire manualmente i sostituti potrebbe affrontare un compromesso diverso. I nostri totali di elaborazione non attribuiscono un costo a quel lavoro manuale né stabiliscono come si comporteranno altri editor o dispositivi.
La correzione selettiva ha usato meno normalizzazioni e più esportazioni
Operazioni effettive per 1 insieme di 72 finestre; le colonne dei tempi sommano la mediana di ogni finestra su 3 esecuzioni su un Apple M4, con 1 worker.
| Flusso di lavoro | Operazioni di normalizzazione | Esportazioni AAC | Tempo trascorso di elaborazione nativa (secondi) | Tempo CPU di elaborazione nativa (secondi) |
|---|---|---|---|---|
| Riutilizza il master | 0 | 72 | 52,3 | 56,3 |
| Normalizza ogni estratto | 72 | 72 | 108,6 | 120,1 |
| Misura, poi correggi | 9 | 81 | 64,0 | 69,3 |
In questo insieme, le clip da 15 secondi hanno richiesto più correzioni
Ogni durata aveva lo stesso denominatore: 24 finestre, ricavate da 4 posizioni in ciascuno dei 6 programmi. Il riutilizzo ha superato il controllo per 19 clip da 15 secondi, 22 da 30 secondi e 22 da 60 secondi. I numeri corrispondenti inviati alla correzione erano 5, 2 e 2.
Il motivo della correzione era diverso per la durata maggiore. Tutti e 5 i casi da 15 secondi ed entrambi quelli da 30 secondi erano sicuramente fuori dai limiti scelti. I 2 casi restanti da 60 secondi erano casi al limite. Considerarli candidati alla correzione era una scelta di flusso stabilita prima dei risultati, non una prova che fossero entrambi sicuramente fuori dall’intervallo di consegna.
Le clip erano annidate intorno agli stessi centri. Un estratto da 15 secondi era contenuto in uno da 30 secondi, a sua volta contenuto in uno da 60 secondi. Sono estratti correlati degli stessi programmi. La tabella descrive questo insieme; non stabilisce una probabilità generale che una clip di podcast da 15 secondi richieda una correzione.
Tutte e 9 le correzioni erano concentrate in 2 programmi: 4 in HPR Beer Garden 22 - Bitter e 5 nella presentazione di murph alla conferenza. Gli altri 4 programmi hanno fornito ciascuno 12 clip di riutilizzo entro i limiti. Questa concentrazione rende una sola percentuale complessiva una promessa poco affidabile per il prossimo episodio. Un team può trovare un insieme senza correzioni o uno con diverse correzioni, anche usando le stesse impostazioni di esportazione.
5 delle 24 clip più brevi sono state inviate alla correzione
Ogni durata comprende 4 centri fissi per ciascuno dei 6 programmi. Le finestre più lunghe circondano gli stessi centri, quindi sono estratti correlati.
| Durata della clip | Finestre testate | Riutilizzi chiaramente entro i limiti | Inviate alla correzione |
|---|---|---|---|
| 15 secondi | 24 | 19 | 5 |
| 30 secondi | 24 | 22 | 2 |
| 60 secondi | 24 | 22 | 2 |
1 episodio con una presentazione mostra il passaggio di consegne
L’episodio pubblicato «murph gives a presentation talk about Hacker Public Radio at the OLF conference» ha fornito 12 estratti fissi. HPR lo ha pubblicato il 15 ottobre 2026; la sua pagina descrive una presentazione a una conferenza tenuta nel dicembre 2025. Abbiamo usato il contenuto completo del podcast pubblicato, compresi gli elementi identificativi del programma, poi preparato il master dell’intero episodio usato in questo test.[6]
Per quei 12 estratti, il flusso di riutilizzo ha prodotto 7 esiti chiaramente positivi, 4 sicuramente negativi e 1 caso al limite. Secondo la regola selettiva, i 7 file entro i limiti sono stati conservati. Gli altri 5 estratti sono tornati alla fonte senza perdita per la normalizzazione e un’esportazione sostitutiva. L’insieme finale da consegnare conteneva 12 file entro i limiti, ottenuti con 5 operazioni di normalizzazione e 17 esportazioni.
Anche normalizzare sempre gli stessi 12 estratti ha prodotto 12 file entro i limiti, con 12 operazioni di normalizzazione e 12 esportazioni. Il percorso selettivo ha quindi evitato di elaborare di nuovo 7 estratti, ma ha effettuato 5 esportazioni aggiuntive. Questo episodio offre un esempio concreto del compromesso mostrato nei risultati complessivi, senza presumere che il solo numero di normalizzazioni misuri il lavoro.
Per un creator o un’attività che consegna quell’insieme a chi si occupa della pubblicazione, una nota finale utile identificherebbe i 12 file finali, i limiti di consegna usati e quali 5 file hanno sostituito un’esportazione precedente. Una cartella con versioni originali e corrette, senza una selezione finale chiara, crea un problema separato nel passaggio di consegne che le misure di loudness non possono risolvere.
Questi conteggi riguardano le nostre versioni di laboratorio dell’episodio. Non sono un giudizio sul relatore, sulla produzione originale o sulla sua idoneità per gli ascoltatori. Non abbiamo scelto gli estratti in base a ciò che veniva detto o a come suonavano. Le posizioni erano fisse prima di misurare qualsiasi risultato di loudness.
Controlla il file che verrà pubblicato
Per un episodio già sottoposto a mastering, la prima decisione riguarda le specifiche di consegna delle clip. Concorda l’intervallo di loudness, il limite di picco, il formato del file e la destinazione prevista prima di interpretare un esito positivo. Se un cliente o una piattaforma usa specifiche diverse, questi conteggi non si trasferiscono invariati a quelle specifiche.
Poi decidi se conservare o correggere il file esportato. Nel flusso selettivo testato, chi montava l’audio poteva conservare ogni file che rispettava chiaramente entrambi i limiti. Un esito sicuramente negativo o troppo vicino al confine richiedeva una correzione dall’estratto originale senza perdita, seguita da un’esportazione sostitutiva e un altro controllo. Questa regola stabilisce che cosa succede a un risultato incerto, anziché lasciarlo a un via libera senza spiegazioni.
Il controllo finale deve seguire l’ultima modifica che influisce sull’audio consegnato. Aggiungere un’introduzione, musica, una dissolvenza o un nuovo montaggio produce un file diverso da quello misurato qui. Un risultato associato a una versione precedente non dovrebbe essere trasferito come se descrivesse l’esportazione successiva. Conserva la misurazione insieme al file effettivamente scelto per la consegna.
Rendi la nota di consegna abbastanza specifica da essere utile alla persona successiva: file scelto, valori di loudness e picco, limiti applicati e stato risultante. Una nota che dice solo «normalizzato» indica un passaggio di elaborazione. Non dice a chi pubblica se il file finale codificato sia stato misurato né se rispettasse i limiti concordati.
La scelta tra elaborazione selettiva e normalizzazione sistematica dipende anche dal passaggio di consegne. Qui la correzione selettiva era utile perché la maggior parte delle esportazioni esistenti poteva essere conservata e solo 9 richiedevano sostituti. Normalizzare sempre offriva un percorso più semplice, con un’unica esportazione per ogni estratto. Entrambi hanno ottenuto lo stesso risultato di consegna misurato in questo insieme, organizzando l’elaborazione in modo diverso.
Un piccolo team può scegliere il percorso che i suoi strumenti gestiscono bene. Le prove suggeriscono di misurare prima di decidere che ogni estratto richieda un altro passaggio di normalizzazione. Non dimostrano che una persona debba dedicare diversi minuti a gestire i file per risparmiare pochi secondi di elaborazione nativa. Mantieni separato il compromesso tecnico misurato dal lavoro editoriale che resta da fare.
3 percorsi dall’estratto di un episodio a un’esportazione verificata
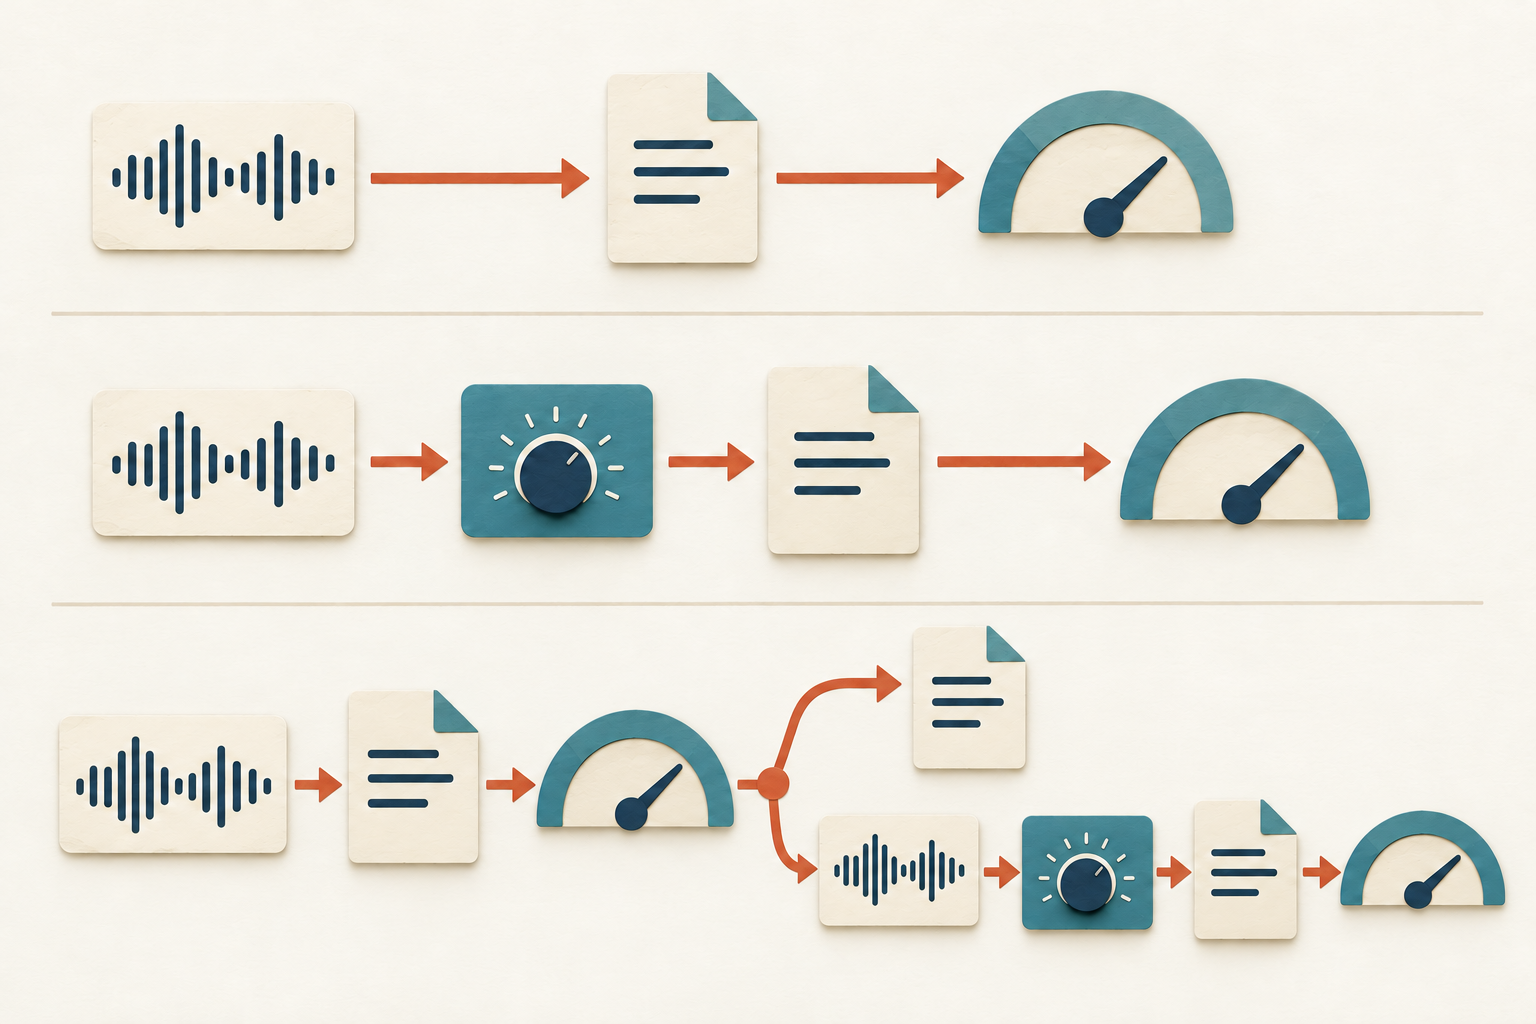
Riutilizza il master
Esporta l’estratto originale, poi misura il file finale.
Normalizza ogni estratto
Misura l’estratto PCM, normalizzalo, esportalo e controlla il file finale.
Misura, poi correggi
Controlla l’esportazione esistente. Conserva i file chiaramente entro i limiti; negli altri casi torna all’estratto PCM originale, normalizzalo, esportalo di nuovo e ricontrolla.
Come sono state confrontate le 72 clip
Abbiamo selezionato i 6 programmi HPR completi più recenti pubblicati prima del 23 ottobre 2026, escluso quel giorno, con durate sulle pagine del produttore comprese tra 20 e 60 minuti. Le date di pubblicazione andavano dall’8 al 21 ottobre. L’idoneità era stata stabilita dai metadati prima dei risultati audio. Abbiamo conservato i contenuti pubblicati completi, con gli elementi identificativi del programma, e registrato le durate effettive dopo la decodifica separatamente da quelle delle pagine.[1][2]
È uno studio di caso su 1 podcast tecnologico di comunità, non un campione rappresentativo di podcast o creator. 2 programmi selezionati erano tavole rotonde Beer Garden consecutive con partecipanti ricorrenti. Le fonti pubblicate avevano già subito un processo di produzione di cui non abbiamo ricostruito i dettagli. La nostra normalizzazione dell’intero episodio era un passaggio di laboratorio aggiuntivo, non una simulazione di registrazioni grezze da microfono.
Abbiamo preparato ogni episodio completo con loudnorm a 2 passaggi di FFmpeg 8.1.2, puntando a −16 LUFS e −1,5 dBTP, poi conservato un master PCM stereo a 48 kHz. LRA era impostato a 50 affinché l’impostazione predefinita di 7 LU non imponesse quell’obiettivo separato; l’intervallo di loudness non era un risultato delle clip brevi. La modalità effettiva di normalizzazione, lineare o dinamica, è stata conservata nei registri delle operazioni.[4]
Per ogni programma abbiamo posizionato i centri delle clip esattamente al 20%, 40%, 60% e 80% del conteggio dei campioni decodificati. In ogni centro abbiamo ritagliato finestre annidate da 15, 30 e 60 secondi, ottenendo 12 finestre per programma e 72 in totale. Tutti i flussi hanno usato gli stessi estratti dagli stessi master. Le posizioni non sono state scelte in base ai parlanti, ai contenuti, al silenzio o alla loudness misurata.
Le classificazioni finali usavano il misuratore nativo ebur128 sulla presentazione AAC decodificata. Abbiamo tenuto conto dei campioni iniziali di compensazione AAC e del riempimento finale, così che ogni misurazione coprisse il numero di campioni previsto. Il riepilogo finale del misuratore mostra loudness integrata e picco reale con precisione di 0,1. Abbiamo considerato quell’arrotondamento trattando ogni valore come un intervallo esteso di 0,05 in entrambe le direzioni; è un margine per l’arrotondamento visualizzato, non una dichiarazione sull’accuratezza della misurazione.[5]
Un esito positivo richiedeva che l’intero intervallo di arrotondamento della loudness fosse compreso tra −17 e −15 LUFS e che l’estremo superiore dell’intervallo del picco non superasse −1 dBTP. Un esito sicuramente negativo era chiaramente fuori da almeno 1 limite; i casi restanti erano classificati al limite e corretti dal flusso selettivo. Il download condiviso fornisce risultati tecnici per finestra, definizioni di elaborazione, codice di calcolo e riconciliazione tra misuratori. Non viene ridistribuito audio originale o derivato.[7]
- Scarica i risultati visualizzati (CSV)
- Scarica risultati tecnici, definizioni e codice di calcolo (ZIP)
Non serve registrarsi. Lo ZIP condiviso contiene misurazioni tecniche, istruzioni di calcolo originali in inglese e spiegazioni tradotte. Il testo dell’articolo, le etichette dei grafici e il CSV dei risultati visualizzati sono disponibili in ogni lingua dell’articolo. Il pacchetto riproduce i calcoli riportati dalle misurazioni fornite, anziché rieseguire l’intera pipeline audio. Non include audio originale o derivato.
Fonti e note
- Archivio degli episodi di Hacker Public Radio. Programmi selezionati: hpr4753, HPR Beer Garden 22 - Bitter, Kevie, 21 ottobre; hpr4749, presentazione OLF di murph, murph, 15 ottobre; hpr4748, Programmable Logic Controls - Episode 5, Whiskeyjack, 14 ottobre; hpr4747, UNIX Curio #13 - Replacements for cat, Vance, 13 ottobre; hpr4745, BruCON interview 1: The BruCON organization, Kristoff, 9 ottobre; hpr4744, HPR Beer Garden 21 - Mild, Kevie, 8 ottobre. Tutte le date sono del 2026. I link dei singoli episodi e gli identificatori dei contenuti sono inclusi nel pacchetto di analisi.
- Politica di contribuzione di Hacker Public Radio. Il produttore descrive le trasformazioni applicate alla pubblicazione, tra cui conversione del formato e introduzione e chiusura automatiche, e specifica Creative Commons Attribution-ShareAlike 4.0 per i programmi. Questo studio analizza contenuti pubblicati completi. Non ridistribuisce né quei contenuti né le clip derivate.
- Apple Podcasts for Creators, Audio requirements, Audio levels. Raccomanda una loudness complessiva intorno a −16 dB LKFS con una tolleranza di ±1 dB e un picco reale non superiore a −1 dB FS, con preparazione prima della codifica. Fornisce il riferimento per podcast usato qui, non specifiche di consegna universali per le piattaforme social.
- Documentazione dei filtri FFmpeg 8.1.2, loudnorm. Descrive la normalizzazione a passaggio singolo o doppio e in modalità lineare o dinamica. L’esperimento ha usato FFmpeg 8.1.2 nativo con impostazioni e modalità operative effettive conservate nel pacchetto.
- Codice sorgente ebur128 di FFmpeg 8.1.2, formattazione del riepilogo finale. Loudness integrata e picco reale sono visualizzati con 1 cifra decimale. La regola conservativa a 3 esiti dello studio gestisce questa precisione di visualizzazione; non dichiara l’accuratezza di un misuratore certificato. Le classificazioni finali di consegna sono separate dalle statistiche di ingresso e uscita del normalizzatore.
- Episodio HPR hpr4749, murph gives a presentation talk about Hacker Public Radio at the OLF conference. Conduttore murph; pubblicato il 15 ottobre 2026. La pagina di origine descrive la presentazione come avvenuta nel dicembre 2025. Il titolo dell’episodio e la data di pubblicazione identificano la fonte, non valutano la sua produzione audio originale.
- Pacchetto di calcolo di Influence IQ. Contiene misurazioni tecniche aggregate e per finestra, attribuzione delle fonti, regole fisse di selezione e delle finestre, definizioni dei tempi di elaborazione nativa, codice di calcolo e riconciliazione tra misuratori. Riproduce i calcoli riportati dalle misurazioni fornite; non è un pacchetto portabile per rieseguire l’intera pipeline di elaborazione audio. Non include audio grezzo o derivato, trascrizioni del parlato o registri operativi privati.
Ogni edizione linguistica descrive lo stesso studio di caso su 6 programmi HPR. La traduzione non crea risultati per un altro paese, un’altra popolazione di podcast o un’altra piattaforma social.