Quels commentaires de recettes lire pour recueillir des retours ?
Lire les commentaires qui ont reçu le plus de votes positifs ou les plus récents peut modifier la répartition des notes que vous voyez. Une comparaison de sélections de dix commentaires sur 100 recettes sélectionnées montre pourquoi la méthode de lecture doit dépendre de la question à résoudre.
Une analyse de 18 182 commentaires issus d’archives de recettes publiées par UCI en 2023.
Résumé
Pour refléter la répartition des notes dans une discussion sur une recette, le tirage au hasard était plus proche en moyenne que la sélection des commentaires ayant le plus de votes positifs ou des plus récents. Influence IQ a comparé des sélections de dix commentaires sur 100 recettes sélectionnées et très bien notées, dans des archives de 18 182 commentaires publiées par UCI en 2023. L’écart attendu moyen était de 16,5 points de pourcentage pour le tirage au hasard, de 18,7 pour les votes positifs et de 20,3 pour les commentaires les plus récents. [1][4]
Le résultat mesure la répartition des commentaires notés de une à cinq étoiles et sans note, et non l’utilité de leurs conseils. La sélection par votes était plus proche que le tirage au hasard pour 46 recettes et plus éloignée pour 54. Pour les créateurs de contenu culinaire et les responsables de communauté, cela invite à distinguer un échantillon servant à résumer une discussion des exemples qui aident à préparer une réponse.
Vous avez une recette à améliorer et une longue discussion en dessous. Vous pouvez lire quelques commentaires avant de décider ce qu’il faut clarifier. Commencez-vous par ceux qui ont reçu le plus de votes, les derniers arrivés ou une sélection tirée au hasard dans la discussion ?
Ce choix précède l’interprétation de la moindre phrase. Il détermine les voix qui figurent dans le brief transmis à un créateur, un rédacteur ou un collègue. Nous avons examiné comment trois règles explicites de sélection modifiaient un élément mesurable de ce brief : l’équilibre des notes, y compris les commentaires dont les auteurs n’ont pas donné de note.
Une sélection au sein d’une discussion plus vaste
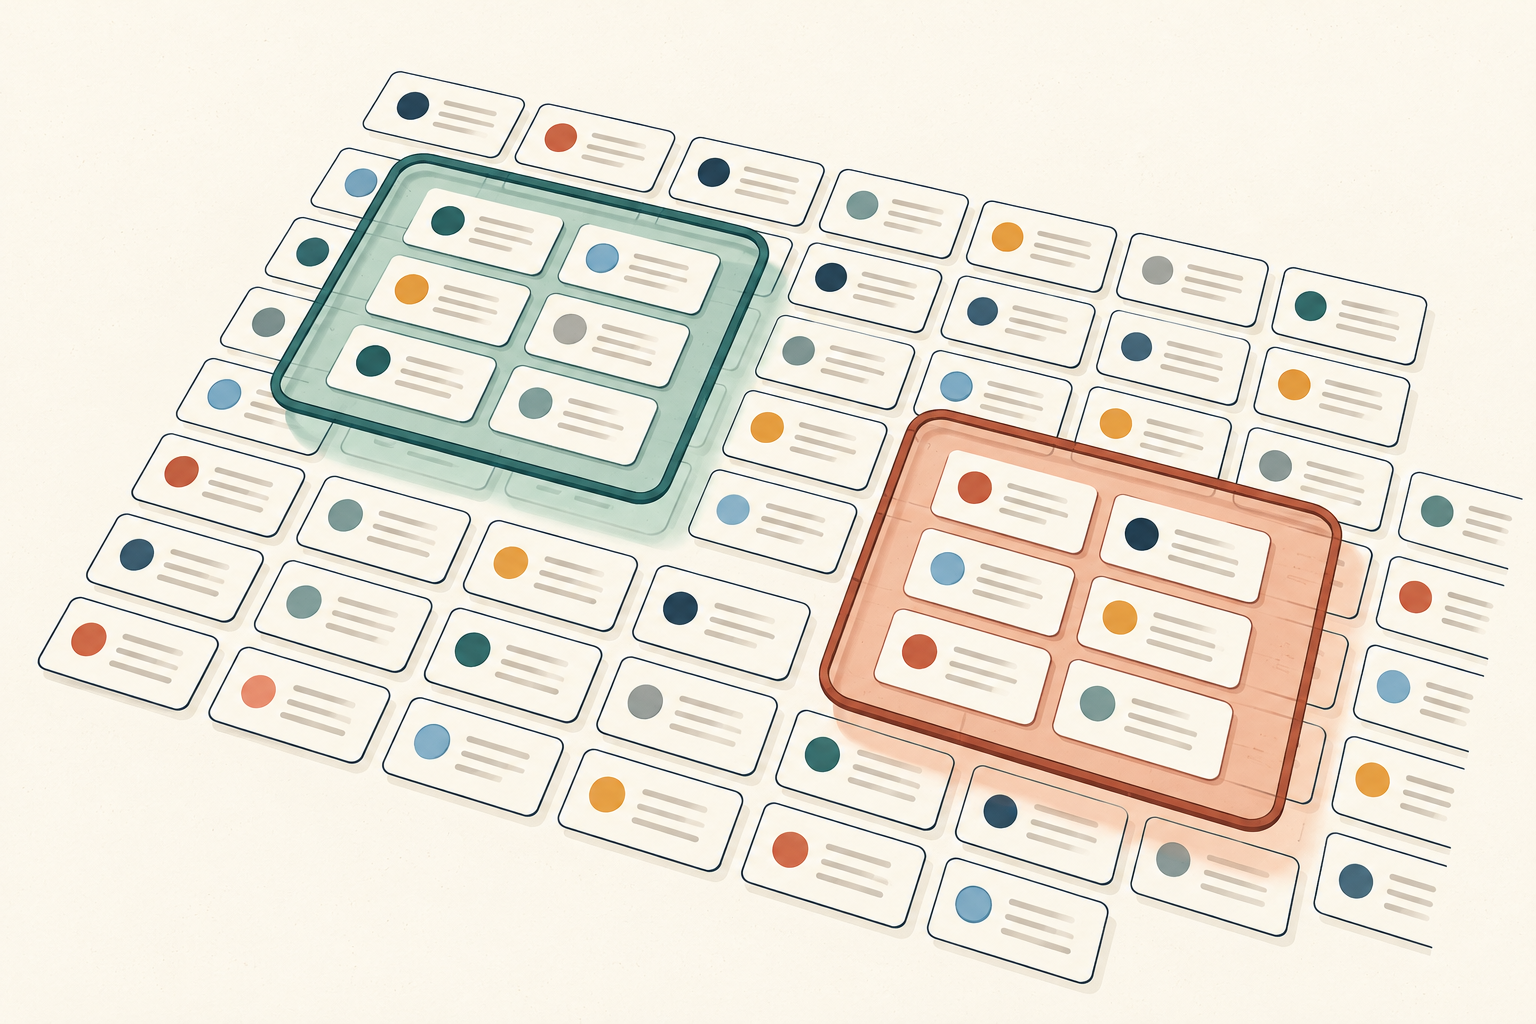
- Commentaires sélectionnés
- Discussion archivée complète
Dix commentaires peuvent donner trois visions différentes
Un créateur qui prépare un complément à une recette doit décider quoi lire en premier. Les commentaires qui ont reçu le plus de votes positifs peuvent sembler offrir un raccourci utile. Les plus récents donnent un autre point d’entrée. Les deux critères placent certains commentaires avant les autres, sans pour autant décrire automatiquement toute la discussion.
Nous avons étudié cette question précise à partir de 18 182 commentaires archivés sur 100 recettes de Taste of Home sélectionnées et très bien notées, dans un jeu de données public diffusé par UCI en 2023. Pour chaque recette, nous avons comparé dix commentaires choisis selon leurs votes positifs, dix selon leur date de création et dix au hasard. La référence était la répartition des notes de tous les commentaires archivés pour cette recette. [1]
L’écart attendu moyen par rapport à la répartition complète était de 18,7 points de pourcentage pour la sélection par votes, de 20,3 pour les plus récents et de 16,5 pour le tirage au hasard. Chaque recette contribuait à parts égales à ces moyennes, quel que soit son nombre de commentaires. [4]
Par rapport au tirage au hasard, l’écart était supérieur de 2,2 points de pourcentage avec les votes et de 3,8 points avec les commentaires les plus récents. Ces différences concernent la répartition des notes et des commentaires sans note. Nous n’avons pas mesuré quels commentaires donnaient les meilleurs conseils de cuisine, l’explication la plus claire ou l’idée la plus utile à une entreprise.
Cette distinction compte pour un créateur de contenu culinaire ou un responsable de communauté. Un commentaire peut être assez intéressant pour inspirer un tutoriel sans être typique de la discussion. L’utiliser comme exemple est une décision différente de celle qui consiste à traiter une courte sélection comme un résumé.
Écart moyen par rapport à la répartition complète des notes de chaque recette
Dix commentaires par sélection, pour 100 discussions sur des recettes choisies dans les archives d’UCI. Un écart plus faible indique une répartition plus proche des notes et des commentaires sans note.
| Méthode de sélection | Écart attendu moyen |
|---|---|
| Le plus de votes positifs | 18,7 points de pourcentage |
| Les plus récents selon la date de création | 20,3 points de pourcentage |
| Tirage au hasard | 16,5 points de pourcentage |
Que signifie un écart dans la répartition des notes ?
Considérez chaque discussion sur une recette comme une répartition entre six catégories : une à cinq étoiles, plus les commentaires sans note. Un échantillon de dix commentaires a sa propre répartition. Nous avons mesuré sa distance par rapport à la discussion archivée complète avec une mesure appelée distance en variation totale.
Voici un exemple hypothétique limité à deux catégories. Supposons que la moitié des commentaires donne quatre étoiles et l’autre moitié cinq. Si une sélection de dix commentaires comprend sept notes de quatre étoiles et trois de cinq étoiles, sa répartition est de 70 % contre 30 %, au lieu de 50 % contre 50 %. La distance est de 20 points de pourcentage : la moitié de la somme des deux différences absolues de 20 points.
Le même calcul s’applique aux six catégories. Une valeur plus faible indique une répartition plus proche de celle des archives. Elle ne signifie pas que le texte est plus instructif ou que les commentaires sont plus véridiques. Un résultat de 18,7 points ne signifie pas non plus que 18,7 % des commentaires sont faux.
Nous avons conservé les commentaires sans note dans la comparaison. UCI définit le zéro du champ de notation comme une absence de note, et non comme une note inférieure à une étoile. Les retirer modifierait la discussion que l’on résume. La catégorie numérique ne permet pas, à elle seule, de savoir si un commentaire sans note contient une question, un compliment, un problème ou autre chose. [1]
Le hasard était plus proche en moyenne, mais pas pour chaque recette
La comparaison globale ne désigne pas de gagnant universel. La sélection par votes présentait un écart attendu inférieur à celui du tirage au hasard pour 46 des 100 recettes, et supérieur pour 54. La sélection des plus récents était plus proche pour 42 recettes et plus éloignée pour 58. Aucune des deux comparaisons ne comportait d’égalité exacte. [4]
Ces comparaisons portent sur l’écart attendu de chaque méthode au sein d’une recette. Elles ne signifient pas que chaque tirage au hasard possible surpasse la sélection par votes dans ces 54 discussions. Un tirage particulier de dix commentaires peut ressembler de près à la discussion complète ou en laisser certaines parties de côté.
Le résultat du hasard est une moyenne sur tous les échantillons possibles de dix commentaires, chacun ayant la même probabilité. Il ne provient pas d’un seul tirage heureux ni d’une graine aléatoire choisie. Nous avons également fait la moyenne des sélections possibles pour départager les commentaires ayant le même nombre de votes ou le même horodatage au seuil de sélection.
Les ex æquo au seuil ont nécessité ce calcul de moyenne pour 70 recettes avec la sélection par votes et quatre avec les commentaires les plus récents. Nous n’avons favorisé aucun commentaire ex æquo en fonction de son auteur, de sa position dans le fichier ou de son identifiant. Le calcul examine une règle de sélection définie, sans traiter un ordre arbitraire comme une preuve. [4]
Pour un créateur, la conséquence pratique est limitée mais utile : les votes et la date sont des critères de sélection. Si vous utilisez l’un ou l’autre pour résumer une discussion, précisez-le. Ne supposez pas qu’une courte liste visible conserve l’équilibre de l’ensemble des archives.
La méthode la plus proche variait selon les discussions
Chaque sélection ordonnée est comparée au tirage au hasard au sein de la même recette. Il s’agit de comparaisons d’écarts attendus, pas des résultats de tirages aléatoires individuels.
| Méthode de sélection | Plus proche que le hasard | À égalité avec le hasard | Plus éloignée que le hasard |
|---|---|---|---|
| Votes positifs contre hasard | 46 | 0 | 54 |
| Plus récents contre hasard | 42 | 0 | 58 |
Définissez la question avant de choisir les commentaires
Les méthodes de recueil des retours clients répondent à des besoins différents. Une entreprise peut vouloir comprendre une tendance générale, examiner un problème précis ou trouver une question pour sa prochaine publication. Cette étude traite d’une partie de ce travail : une petite sélection conserve-t-elle la répartition des notes d’une discussion ? Elle ne classe pas toutes les façons de recueillir des retours.
Si votre question est « À quoi ressemble cette discussion dans son ensemble ? », commencez par définir les commentaires qui en font partie. Un tirage au hasard dans une liste complète et accessible évite de favoriser délibérément les votes ou les dates récentes. Dans ces archives, il était plus proche en moyenne, mais même un petit échantillon aléatoire présentait un écart mesurable. Dix était le nombre choisi pour notre comparaison, et non une recommandation selon laquelle dix commentaires suffiraient.
Si votre question est « À quoi répondre ensuite ? », un commentaire précis peut mériter votre attention à lui seul. Une question claire sur le remplacement d’un ingrédient peut justifier de vérifier la recette et de préparer une explication. Il n’est pas nécessaire de présenter cette question comme fréquente pour y répondre. Sa pertinence pour le prochain contenu relève d’un autre jugement.
Si la question concerne des changements récents, la date de création peut délimiter une période de lecture pertinente. Gardez cette période visible dans le résumé. Dans notre étude, les commentaires « les plus récents » avaient les dernières dates de création des archives sauvegardées ; il ne s’agissait ni des commentaires reçus aujourd’hui, ni de l’ordre actuellement affiché sur le site.
Même l’ensemble des archives de commentaires reste une référence limitée. Il rassemble les contributions de personnes qui ont choisi de commenter, et non de toutes celles qui ont lu ou essayé une recette. Si une entreprise veut l’avis de personnes qui ne commentent jamais, elle doit les joindre autrement. Une meilleure correspondance avec les archives ne comble pas cette absence. Gardez ces retours supplémentaires distincts afin que leur origine et leur sélection restent compréhensibles.
Conservez deux notes séparées : l’une décrit la sélection utilisée pour résumer la discussion ; l’autre liste les questions à examiner. C’est une proposition d’organisation du travail, et non un processus testé dans cette étude.
Un exemple fictif : préparer un complément à une recette
Imaginez un créateur culinaire qui prépare une suite à une recette de pâtisserie. Un commentaire ayant reçu de nombreux votes demande si un autre moule conviendrait. Le créateur est tenté de commencer la prochaine vidéo par « Tout le monde a des difficultés avec la taille du moule ». Cette situation est fictive : ni le commentaire ni la recette ne sont tirés du jeu de données.
La question du moule peut mériter une réponse sans que l’on démontre sa fréquence. Les votes ne permettent pas d’établir qui a essayé la recette ou vécu la même expérience.
Un brief plus précis serait : « Un lecteur demande comment le choix du moule influe sur cette recette. Montrez le moule utilisé, expliquez ses dimensions et indiquez ce qu’il faudrait vérifier avant d’en recommander un autre. » Le créateur peut ensuite contrôler les détails culinaires. Le commentaire fournit la question de départ ; il n’établit pas la réponse.
Si le créateur souhaite aussi résumer la discussion, il devrait noter séparément ce qu’il a lu et comment il l’a choisi. Un échantillon tiré au hasard dans une liste complète disponible doit donner la même chance à chaque commentaire, sans sélectionner deux fois le même. Faire défiler la page jusqu’à quelques endroits pratiques n’est pas la procédure aléatoire évaluée ici.
Lorsqu’une liste complète n’est pas disponible, décrivez la sélection réellement possible. « Nous avons lu les premiers commentaires affichés avec cet ordre de tri » est plus informatif que de parler d’un échantillon représentatif. N’appliquez pas les écarts numériques de nos archives à ce processus différent.
Le complément devrait montrer le matériel et répondre à la question après vérification. Gardez une trace des points clarifiés pour que la prochaine revue se concentre sur les questions restantes. Évaluez cette explication à partir des retours sur le complément lui-même.
Séparer sélection et interprétation
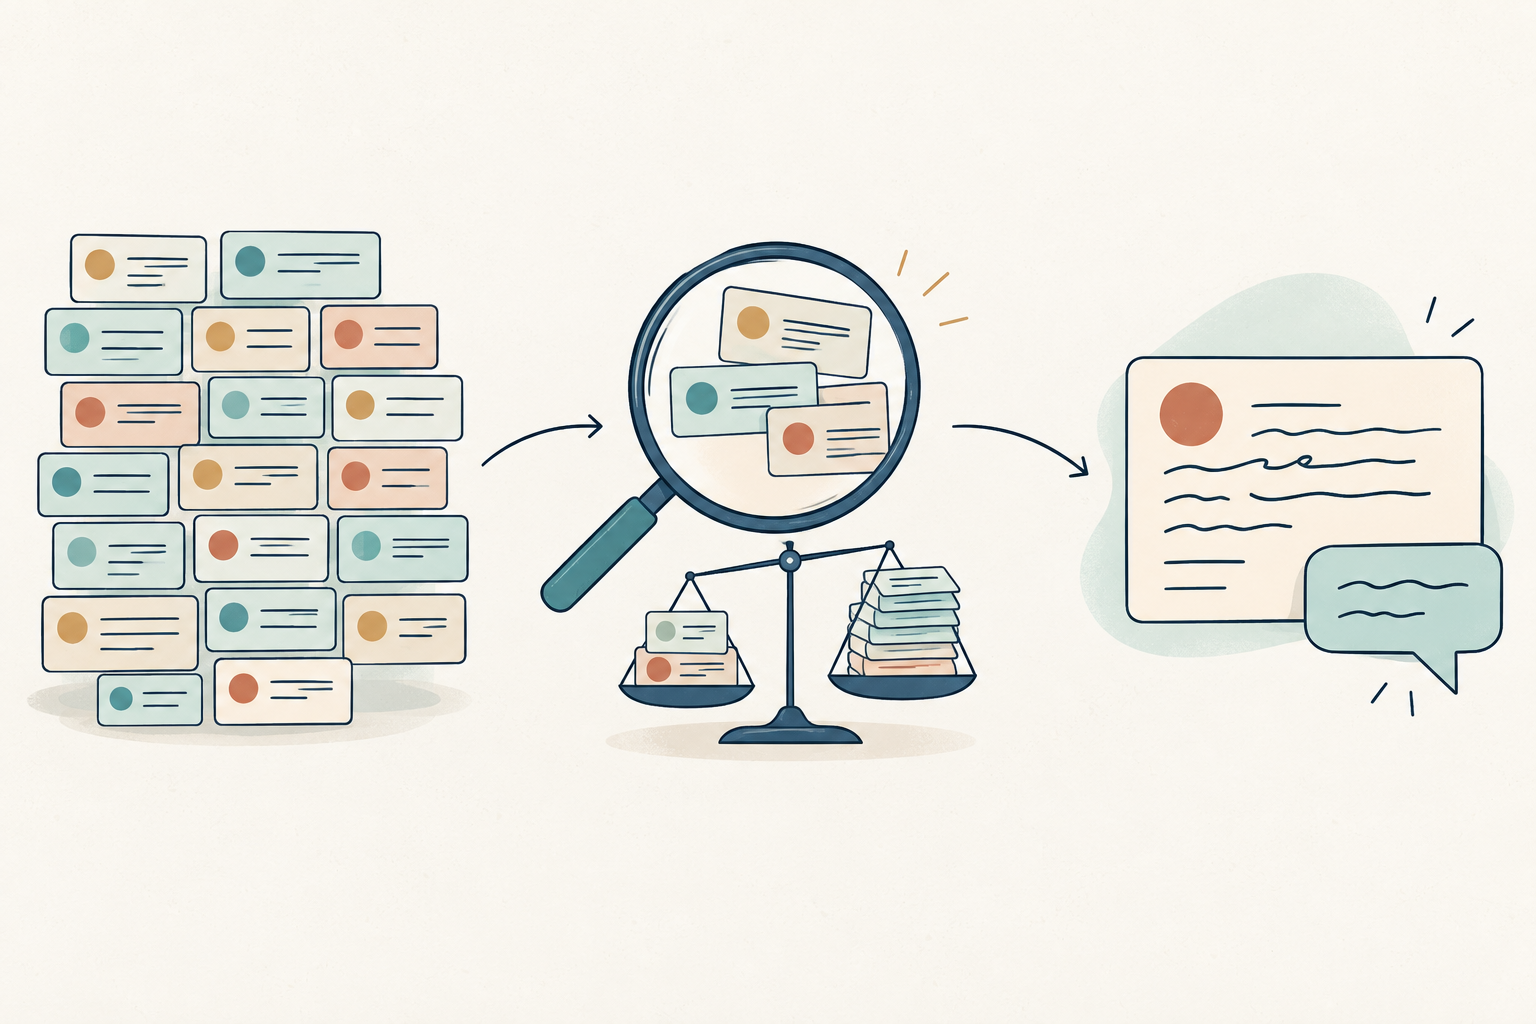
Définir ce qui sera lu
Nommez la discussion et la règle de sélection avant de lire.
Examiner ce que couvre la sélection
Distinguez la vue sélectionnée de la discussion complète.
Lire le commentaire dans son contexte
Partez de la question réelle pour préparer une réponse et la vérifier.
Une courte fiche pour lire les commentaires d’une recette
Utilisez ces questions avant de confier la lecture des commentaires à un créateur ou à un collègue. Elles aident à organiser le travail ; elles ne proviennent pas du jeu de données source.
Décision : à quoi servira la lecture ? Nommez une tâche concrète, comme clarifier une étape de la recette ou choisir un sujet de suivi. Distinguez une demande d’exemples d’une demande de description de toute la discussion.
Périmètre : quelle recette, quelle plateforme et quelle période sont incluses ? Précisez si la liste disponible est complète. Comptez des commentaires comme des commentaires ; sans preuve distincte, ne les présentez pas comme des personnes uniques ou des clients vérifiés.
Sélection : comment les commentaires entreront-ils dans le groupe à lire ? Notez l’ordre de tri ou la procédure aléatoire, le nombre lu et la règle applicable aux ex æquo. Incluez les commentaires sans note lorsqu’ils font partie de la discussion que vous cherchez à comprendre.
Observations : que disaient réellement les commentaires sélectionnés ? Distinguez une question explicite de votre interprétation. Conservez assez de contexte pour comprendre le problème, sans inclure d’informations personnelles dans le brief partagé.
Prochaine action : quelle affirmation ou quel détail de la recette faut-il vérifier avant publication ? Confiez cette vérification à quelqu’un qui peut y répondre. Rédigez l’explication proposée et précisez vers quoi elle orientera le lecteur, sans transformer les exemples sélectionnés en une affirmation non étayée sur la fréquence du problème.
Comment nous avons comparé les trois méthodes de sélection
La source est le jeu de données Recipe Reviews and User Feedback d’Ali, Matuszewski et Czupyt, publié par UCI en 2023 sous licence CC BY 4.0. Il contient les commentaires d’une sélection de 100 recettes de Taste of Home très bien notées. L’année de publication ne donne pas la date exacte de collecte, et la documentation disponible ne permet pas d’affirmer que tous les commentaires originaux ont été capturés. Il s’agit d’une analyse d’archives, pas d’un état actuel de la plateforme. [1][2][3]
Nous avons validé l’intégralité des archives publiées : 18 182 identifiants de commentaire distincts répartis sur 100 positions de recettes. Chaque recette comptait plus de dix commentaires ; les 100 ont donc été incluses. Les contributions répétées d’une même personne restent plusieurs commentaires. Nous n’avons pas dédupliqué par personne ni analysé le texte, les noms, la réputation des utilisateurs ou le score de classement de la source.
Pour chaque recette, la règle fondée sur les votes sélectionnait les dix commentaires ayant le plus de votes positifs observés. La règle des plus récents utilisait les dix dernières dates de création. En cas d’ex æquo au seuil, chaque façon de remplir les places restantes avec les commentaires concernés avait la même probabilité. Le tirage au hasard donnait la même probabilité à chaque sous-ensemble de dix commentaires des archives de la recette.
Pour chaque sélection possible, nous avons comparé sa répartition entre six catégories avec celle de l’ensemble des archives de la recette, puis calculé la moyenne de la distance selon la règle de sélection. Des calculs exacts de probabilité donnent cette espérance sans simulation. Il est important de moyenner les distances : calculer une distance seulement après avoir moyenné les proportions des catégories répondrait à une autre question et pourrait masquer la variation d’échantillonnage.
Nous avons ensuite moyenné les distances attendues propres à chaque recette, en donnant le même poids à chacune. Les différences ont été calculées avant l’arrondi à une décimale. Le nombre de dix commentaires, les critères d’inclusion, les comparaisons et le plan de présentation ont été fixés avant l’examen des résultats ciblés. Nous n’avons choisi après coup ni un autre nombre de commentaires ni un sous-ensemble favorable de recettes.
Les résultats décrivent cet ensemble fini de données archivées et les règles de sélection indiquées ; nous ne présentons donc ni intervalle de confiance pour une population ni effet causal. Les votes cumulés ne révèlent pas l’exposition ou l’historique des votes. L’article original des auteurs étudie la classification de textes ; notre analyse suit les catégories d’étoiles documentées par UCI et examine la sélection. La méthode technique explique la distinction entre les champs de la source. [1][2]
Les téléchargements fournissent les résultats agrégés, une vérification numérique pour chaque position de recette et le code de reproduction. Ils ne contiennent ni texte de commentaire, ni nom, ni identifiant d’utilisateur. Les données sources sont disponibles séparément auprès d’UCI ; citer les auteurs et le dépôt n’implique pas qu’ils approuvent notre interprétation. [1][3]
- Télécharger les résultats agrégés en français (CSV)
- Télécharger la méthode et le code de reproduction (ZIP, en anglais)
Aucune inscription nécessaire. Les téléchargements contiennent les comparaisons agrégées, les résultats numériques par position de recette et la méthode technique en anglais. Ils n’incluent ni texte de commentaire, ni nom d’utilisateur, ni identifiant de commentaire individuel. Le jeu de données source est disponible séparément auprès d’UCI. [1]
Sources et notes
- Ali, A., Matuszewski, S. et Czupyt, J. (2023). Recipe Reviews and User Feedback [Jeu de données]. UCI Machine Learning Repository. DOI : 10.24432/C5FG95. UCI documente 18 182 commentaires et définit stars de 1 à 5, le 0 signifiant aucune note. Les calculs d’Influence IQ utilisent les archives publiées, pas les données actuelles du site.
- L’article des auteurs, « Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models », décrit la source des recettes sélectionnées et une étude de classification de textes. Sa description de best_score contredit le champ de notation documenté par UCI. Nous utilisons stars et n’analysons ni best_score ni le texte des commentaires. La documentation disponible n’établit pas la date exacte de l’instantané ni l’exhaustivité de la collecte.
- Le jeu de données d’UCI est sous licence Creative Commons Attribution 4.0. Influence IQ en a tiré de nouvelles comparaisons agrégées. L’attribution n’implique pas l’approbation des auteurs, d’UCI ou de Taste of Home. Les téléchargements ne redistribuent ni commentaires individuels ni identités d’utilisateurs.
- Influence IQ (2026). Échantillonnage des commentaires de recettes : méthode d’analyse, résultats agrégés et code de reproduction. Le paquet documente la comparaison fixe de dix commentaires, les calculs exacts de variation totale attendue, le traitement des ex æquo et les résultats numériques des 100 positions de recettes. Les données sources s’obtiennent séparément auprès d’UCI. Les fichiers techniques sont en anglais.
L’article, la fiche de travail, les libellés des graphiques et le CSV des résultats sont disponibles en dix langues. Le paquet technique de reproduction est en anglais. Toutes les éditions décrivent les mêmes archives de recettes et la même analyse.