Deux étiquettes de modération peuvent venir de personnes différentes
Un dossier transmis pour examiner un commentaire peut afficher deux étiquettes sans indiquer qui les a choisies. Des évaluations historiques de Wikipédia montrent pourquoi cette précision compte pour la personne qui reprend le dossier.
Analyse originale d’Influence IQ sur une sélection d’évaluations du jeu historique de données sur les attaques personnelles de Wikipedia Detox. Analyse achevée le 25 octobre 2026 (UTC).
Résumé
Parmi 13 824 extraits historiques de discussions Wikipédia sélectionnés, 155 avaient reçu à la fois une étiquette de citation ou de récit d’une attaque et une étiquette d’attaque visant le destinataire, quelque part dans leurs 10 évaluations individuelles. Dans 98 de ces 155 extraits, au moins une personne avait choisi les deux. Dans les 57 autres, soit 36,8 %, les étiquettes venaient uniquement de personnes différentes. Ce pourcentage porte sur les 155 extraits, pas sur l’ensemble des 13 824.[1][4]
Pour les entreprises et les créateurs qui gèrent des commentaires sur les réseaux sociaux, l’enseignement pratique concerne la transmission du dossier : conservez les observations de chaque personne avec son évaluation. Deux étiquettes réunies ne prouvent pas qu’une même personne a choisi les deux. L’étude décrit des jugements subjectifs sur des extraits historiques, pas des erreurs de modération ni une règle pour supprimer un commentaire. La fiche à copier ci-dessous aide à préserver cette distinction dans un dossier concret.
Imaginez qu’un créateur demande à un collègue d’examiner un commentaire délicat. Le dossier comporte deux étiquettes : quelqu’un cite ou rapporte une attaque, et quelqu’un attaque le destinataire. Avant de décider quoi faire, le collègue a besoin d’un autre détail : est-ce la même personne qui a fait ces deux observations ?
Un résumé peut faire disparaître cette distinction. Une personne a peut-être choisi les deux options, ou deux personnes se sont intéressées à des aspects différents du même texte. Une liste d’étiquettes ne permet pas de savoir quel cas s’est produit. Elle peut aussi laisser dans le flou les mots que chacun décrivait.
Nous avons étudié cette question à partir des évaluations individuelles d’un jeu de données de recherche existant. Le matériau d’origine vient des pages de discussion de Wikipédia. Il permet de rendre visible le lien entre les étiquettes et leurs auteurs, puis d’aider une entreprise ou un créateur à choisir les informations à conserver dans ses propres transmissions.
Reliez chaque observation à la personne qui l’a faite
Commencez par ce que chaque étiquette décrit
La première option demandait si le texte citait ou rapportait une attaque personnelle provenant d’un autre commentaire. La seconde concernait une attaque personnelle visant le destinataire. Il était possible de choisir plusieurs options. Il s’agissait d’avis sur le texte présenté, pas de décisions de le masquer ni de preuves qu’une règle avait été enfreinte.[2]
Nous avons considéré une étiquette comme présente dès qu’au moins une des 10 personnes l’avait choisie. Il suffisait donc d’une sélection dans le groupe. Nous n’avons pas exigé de majorité, présenté les étiquettes comme un consensus ou vérifié si elles étaient justes.
Sur les 13 824 extraits sélectionnés, 12 025 ne portaient aucune de ces deux étiquettes. 406 autres avaient une étiquette de citation/récit sans étiquette d’attaque visant le destinataire, et 1 238 avaient une étiquette d’attaque visant le destinataire sans citation/récit. Il restait 155 extraits portant les deux quelque part dans leurs évaluations.
Ces descriptions ne concernent que ces deux options. Un extrait sans étiquette d’attaque visant le destinataire pouvait porter un autre type d’étiquette d’attaque. La présence d’une citation ou d’un récit ne certifie pas que le texte était inoffensif. Nommer les catégories précisément évite de les transformer discrètement en conclusions plus larges.
Comment les 13 824 extraits sélectionnés ont été étiquetés
Une étiquette était présente si au moins une des 10 personnes l’avait choisie. Ces cinq catégories ne concernent que deux options précises ; « aucune » ne signifie pas l’absence de tout type d’étiquette d’attaque.
| Citation/récit et attaque visant le destinataire | Extraits |
|---|---|
| Aucune de ces deux étiquettes | 12 025 |
| Étiquette de citation/récit, sans étiquette d’attaque visant le destinataire | 406 |
| Étiquette d’attaque visant le destinataire, sans étiquette de citation/récit | 1 238 |
| Les deux, avec au moins une personne ayant choisi les deux | 98 |
| Les deux, fournies uniquement par des personnes différentes | 57 |
57 extraits portaient les deux étiquettes, sans que personne ait choisi les deux
Dans les 155 extraits, nous avons retrouvé la réponse individuelle derrière chaque étiquette. Pour 98, au moins une personne avait choisi les deux options sur le même extrait. Pour 57, les sélections citation/récit et attaque visant le destinataire venaient uniquement de personnes différentes. Aucune réponse individuelle de ces 57 extraits ne contenait la paire.
La répartition était de 63,2 % avec au moins une personne ayant choisi les deux et de 36,8 % avec des étiquettes fournies uniquement par des personnes différentes. Les deux groupes appartenaient au même ensemble précisément défini de 155 extraits. Le cadre plus large de 13 824 extraits reste important : il montre d’où vient cette comparaison limitée aux extraits portant les deux étiquettes.[4]
Cette distinction change ce que vous pouvez affirmer à partir d’une synthèse. La présence des deux étiquettes permet de dire que chacune a été choisie quelque part dans les évaluations. Elle ne permet pas, à elle seule, d’affirmer qu’une personne a décrit le texte des deux façons.
Le fait qu’une personne ait choisi les deux ne règle pas non plus le sens des mots. Un extrait pouvait réunir des ajouts effectués lors d’une même modification de Wikipédia, y compris plusieurs messages. Cette double sélection ne prouve pas que le passage cité constituait lui-même l’attaque visant le destinataire. Nous n’avons pas examiné les extraits individuels pour expliquer les évaluations.[2][6]
57 des 155 extraits n’avaient aucune double sélection individuelle
Cette comparaison ne porte que sur les 155 extraits sélectionnés portant les deux étiquettes parmi leurs 10 jugements. Elle utilise les sélections de chaque personne, pas l’accord majoritaire ou des résultats de modération vérifiés.
| Qui a fourni les deux étiquettes | Extraits | Part des 155 extraits |
|---|---|---|
| Au moins une personne a choisi les deux | 98 | 63,2 % |
| Les étiquettes viennent uniquement de personnes différentes | 57 | 36,8 % |
Transmettez l’observation qui se trouve derrière l’étiquette
Dans une entreprise, un dossier peut passer de la personne qui surveille les commentaires à celle qui est responsable du compte. Pour un créateur, il peut passer d’un assistant au créateur lui-même. La personne qui reprend le dossier doit comprendre ce qui a été remarqué avant de répondre, de rechercher davantage de contexte ou d’appliquer la politique du compte.
Gardez ensemble les sélections de chaque personne. Si quelqu’un choisit les deux options, conservez cette paire comme son évaluation. Si deux personnes choisissent des options différentes, gardez leurs réponses séparées. Un dossier peut réunir plusieurs lectures sans les transformer en un avis que personne n’a réellement formulé.
Ajoutez ensuite une brève explication du passage concerné. Dans votre propre processus, précisez ce qui semble être cité, à qui le texte semble s’adresser et quelle réponse voisine aide à comprendre l’échange. Laissez l’incertitude visible lorsque le contexte ne permet pas de trancher. Ce sont des suggestions pratiques ; les données n’ont pas servi à tester leur effet sur les décisions.
Une note courte peut suffire. Le but est de permettre à la personne suivante de suivre le raisonnement sans refaire tout l’examen. Lorsqu’une équipe transmet des dossiers entre deux permanences, ou entre une marque et un créateur, cela implique de transmettre l’observation d’origine avec la catégorie qui lui a été attribuée.
Un exemple fictif avec des totaux identiques
Prenons deux groupes fictifs, chacun composé de 10 personnes examinant un extrait inventé. Ils servent à expliquer le calcul ; il ne s’agit ni de personnes, ni de citations, ni de cas réels du jeu de données. Les deux synthèses montrent une sélection citation/récit et une sélection attaque visant le destinataire.[8]
Dans le premier groupe, l’évaluateur A choisit les deux options. Les 9 autres personnes ne choisissent aucune de ces deux options. Une réponse individuelle contient donc la paire. La transmission peut conserver fidèlement cet avis combiné tout en réservant l’action finale à une décision distincte.
Dans le second groupe, l’évaluateur A choisit citation/récit et l’évaluateur B, attaque visant le destinataire. Les 8 autres ne choisissent aucune des deux. Les totaux restent un et un, mais personne n’a choisi les deux. Présenter cela comme l’avis combiné d’une seule personne ajouterait une relation absente des réponses individuelles.
L’exemple explique aussi pourquoi nous avons compté les extraits plutôt que toutes les personnes correspondantes. Si deux personnes du premier groupe avaient chacune choisi les deux étiquettes, l’extrait ne serait compté qu’une fois dans le groupe avec double sélection individuelle. La classification demande si une telle paire existait, pas combien de personnes l’ont fournie.
Pour le second groupe, une courte transmission fictive pourrait dire : « Décision encore ouverte. L’évaluateur A a identifié une citation ou un récit ; l’évaluateur B, un propos visant le destinataire. Conserver les deux notes avec l’extrait et la réponse précédente. La personne responsable du compte vérifiera le passage visé par chacun avant de choisir l’action. » Cette note transmet une question non résolue sans transformer les réponses de deux personnes en une conclusion individuelle.
Dans une transmission réelle, conservez séparément les deux notes du second groupe. La personne suivante peut les lire avec le texte, demander à chacun ce qu’il voulait dire et décider selon la politique du compte. L’étude ne permet pas d’établir si l’un avait raison ou quelle action conviendrait à ce cas fictif.
Les mêmes totaux peuvent cacher des évaluations différentes
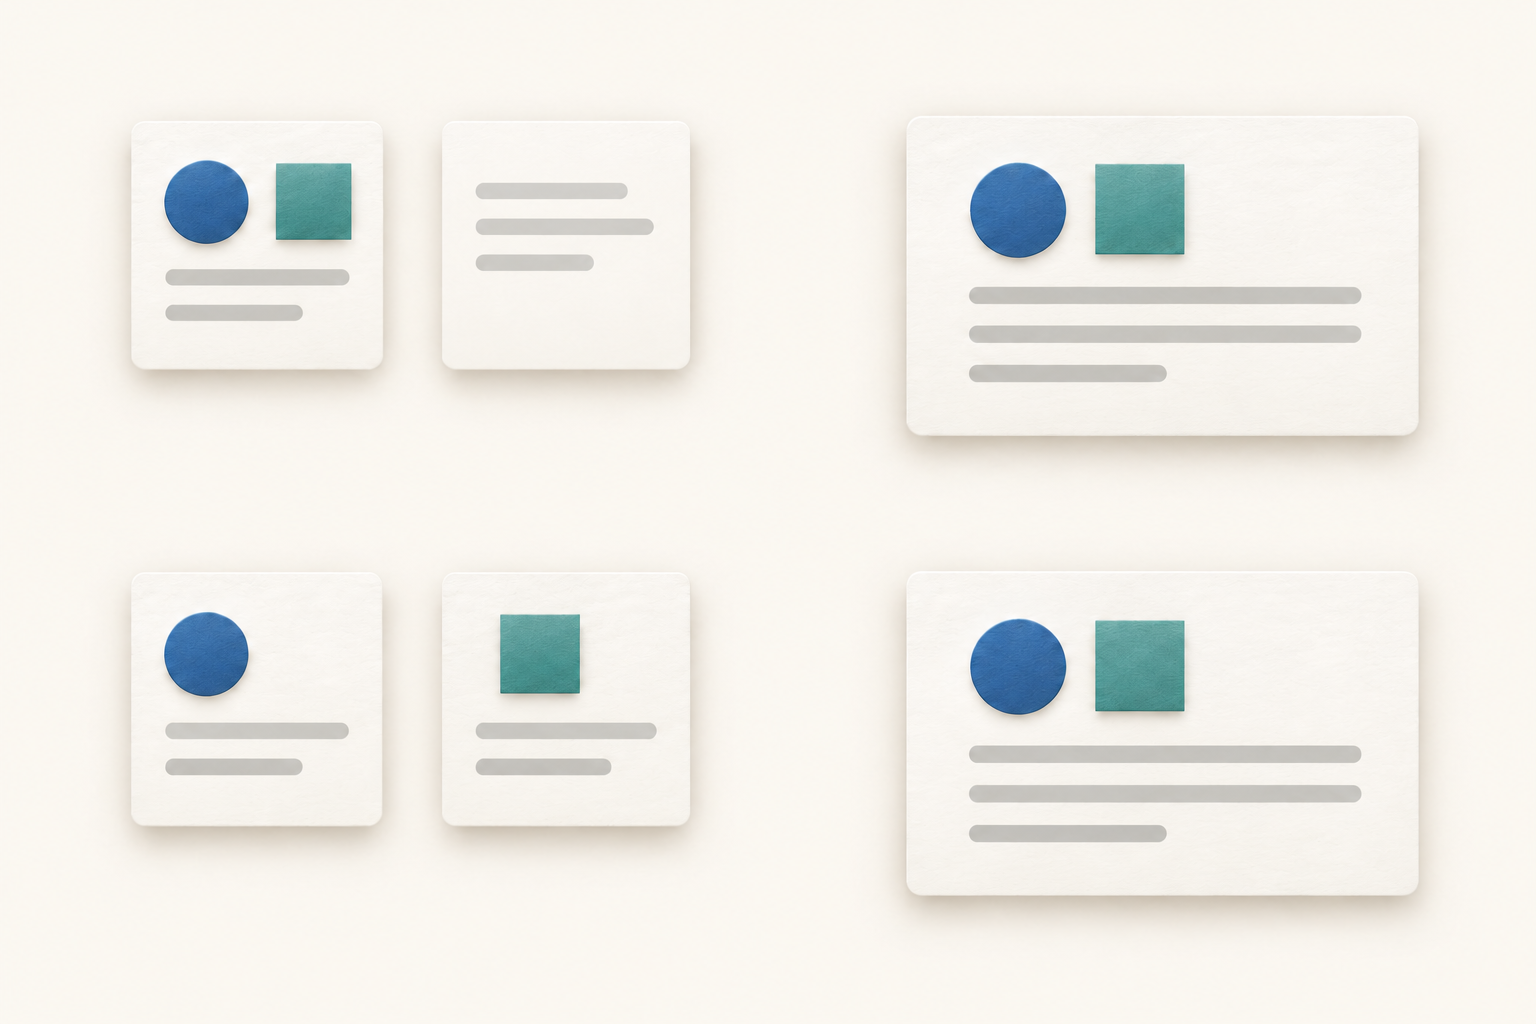
Une personne choisit les deux
Dans le premier groupe fictif, une personne choisit les deux étiquettes et 9 ne choisissent aucune de ces deux options.
Deux personnes en choisissent une chacune
Dans le second, une personne choisit citation/récit et une autre, attaque visant le destinataire. Les 8 autres ne choisissent aucune des deux.
Séparez la description de la décision fondée sur la politique du compte
Décrire ce qui apparaît dans un commentaire et décider quoi en faire répondent à deux objectifs distincts. Quelqu’un peut repérer du langage cité alors que le responsable du compte doit encore considérer l’échange et la politique applicable. Gardez ces étapes séparées pour qu’un lecteur ultérieur puisse comprendre la décision.
Lorsqu’une entreprise travaille avec un créateur, convenez de la personne qui décide avant qu’un échange difficile ne survienne. La personne qui comprend une réclamation produit n’est pas nécessairement autorisée à changer l’approche de modération du compte. Une transmission claire peut nommer les deux rôles sans supposer que chaque cas exige plusieurs évaluateurs.
Pour un créateur travaillant seul, la même distinction peut tenir dans une note : ce que vous avez remarqué, le contexte vérifié et la décision prise. Une personne peut réaliser plusieurs étapes tout en gardant leur rôle clair. Les données ne montrent pas qu’ajouter du personnel ou une étape d’examen améliore les résultats.
Gardez les observations séparées jusqu’à comprendre leur relation. Des sélections différentes peuvent refléter des centres d’attention différents plutôt que des récits contradictoires. Une étiquette de citation/récit n’est pas une exemption automatique, et une étiquette d’attaque visant le destinataire n’est pas une recommandation mesurée de supprimer le commentaire. L’action suivante doit s’appuyer sur l’échange réel et les règles du compte, pas sur une action déduite de nos pourcentages historiques.
Une fiche d’examen des commentaires à copier
Copiez ces champs dans votre document d’examen ou de transmission. Utilisez uniquement les informations nécessaires à l’équipe, avec un accès adapté à la conversation. La fiche est disponible ici sans inscription ; c’est une aide pratique, pas un processus observé dans l’étude.[8]
Dossier : [Lien ou référence interne.] Compte/canal : [Où l’échange apparaît.] Vérification effectuée le : [Date et heure.] Gardez une référence stable pour que la personne suivante retrouve le même contenu.
Objectif : [Quelle question nécessite une décision ?] Responsable : [Qui décide ?] Personne suivante : [Qui doit recevoir le dossier, le cas échéant ?]
Texte présenté : [Le passage examiné, conservé dans l’espace approuvé.] Contexte : [Réponses antérieures ou ultérieures utiles.] Contexte manquant : [Ce qui n’a pas pu être vérifié.]
Évaluateur : [Nom ou référence interne de la personne.] Évaluation effectuée le : [Date et heure.] Gardez une entrée distincte par personne, même si plusieurs utilisent les mêmes étiquettes.
Observation de citation/récit : [Oui, non ou incertain.] Justification : [Quel passage semble citer ou rapporter l’attaque d’une autre personne ?] N’utilisez pas ce champ pour décider que le texte est inoffensif.
Observation d’attaque visant le destinataire : [Oui, non ou incertain.] Justification : [Quel passage semble viser le destinataire, et pourquoi ?] Gardez cette réponse indépendante de l’observation de citation/récit.
Autres observations utiles : [Toute autre question que la politique du compte demande de considérer.] L’absence d’une des deux étiquettes étudiées ne décrit pas l’échange dans son ensemble.
Relation entre les évaluations : [Une personne a choisi les deux, plusieurs personnes ont choisi des options différentes, ou situation incertaine.] Si les avis diffèrent, conservez les notes individuelles avant de résumer le dossier.
Référence de la politique : [Règle ou recommandation applicable.] Décision : [Action effectivement choisie ou question non résolue.] Motif : [Comment les observations et le contexte justifient la décision.]
Suite à donner : [Qui fait quoi ensuite, le cas échéant ?] Transmission prévue le : [Quand le dossier passe à cette personne.] Résultat : [Ce qui s’est produit après la décision, si cela a été vérifié.] Ne marquez pas comme terminée une action simplement prévue.
Réexaminer lorsque : [Un événement précis ou un élément de contexte manquant, si un nouvel examen est nécessaire.] La fiche n’impose pas de réexaminer chaque dossier plusieurs fois ; choisissez un motif adapté à la situation.
Exclure 2016 a laissé les mêmes 155 extraits
Nous avons prévu deux vérifications complémentaires avant de calculer les sélections conjointes. La première excluait les extraits datés de 2016, car la plage d’années des fichiers publiés dépassait les périodes décrites dans la présentation de la source et l’article d’origine. Il restait 13 809 extraits admissibles de l’échantillon aléatoire. Les mêmes 155 portaient les deux étiquettes, avec la même répartition 98/57.[5]
L’autre vérification utilisait les données échantillonnées séparément autour d’événements de blocage. Avec la même règle de 10 évaluations exactement par extrait, ce groupe comptait 42 383 extraits. Parmi les 2 457 portant les deux étiquettes quelque part, 1 354 avaient au moins une double sélection individuelle et 1 103 avaient des étiquettes fournies uniquement par des personnes différentes : 55,1 % et 44,9 %, respectivement.
Le groupe enrichi autour des blocages répond à un autre objectif d’échantillonnage ; nous l’avons donc gardé séparé. Ses pourcentages ne remplacent pas le résultat principal et ne constituent pas des preuves sur les commentaires actuels des marques. La vérification par année traite la plage de dates indiquée ; aucune des deux ne dispense d’interpréter les résultats comme des jugements subjectifs sur des extraits historiques sélectionnés.
Ce qu’ont donné les deux vérifications prévues
Chaque ligne utilise exactement 10 jugements complets par extrait. Le groupe enrichi autour des blocages répond à un autre objectif. Exclure 2016 traite l’écart entre les années des fichiers et les descriptions de la source.
| Comparaison prévue à l’avance | Extraits admissibles | Extraits portant les deux étiquettes quelque part | Avec choix des deux par une même personne | Personnes différentes uniquement | Part des extraits portant les deux étiquettes uniquement chez des personnes différentes |
|---|---|---|---|---|---|
| Échantillon aléatoire, exactement 10 jugements | 13 824 | 155 | 98 | 57 | 36,8 % |
| Échantillon enrichi autour des blocages, séparé | 42 383 | 2 457 | 1 354 | 1 103 | 44,9 % |
| Échantillon aléatoire hors 2016 | 13 809 | 155 | 98 | 57 | 36,8 % |
Comment nous avons relié les étiquettes aux évaluations individuelles
Nous avons utilisé la version 6 de Wikipedia Talk Labels: Personal Attacks, un jeu public du projet Wikipedia Detox. Les fichiers contiennent du texte issu d’anciennes modifications de pages de discussion et plusieurs évaluations de personnes ayant participé à l’annotation de chaque extrait. Notre analyse a utilisé les réponses individuelles ; elle n’a créé aucun nouveau jugement ni évalué un système de modération.[1][2]
La comparaison principale est partie du groupe aléatoire de la version publiée et a retenu les extraits avec exactement 10 évaluations complètes de personnes distinctes. Fixer ce nombre à 10 donnait à chaque extrait le même nombre d’occasions de recevoir une sélection conjointe. Cela revenait aussi à sélectionner 13 824 des 37 492 extraits aléatoires publiés : le résultat ne décrit donc pas ce groupe entier.[3]
Chaque extrait sélectionné contribuait pour un au décompte. Nous avons vérifié si chaque étiquette apparaissait quelque part, puis si les deux figuraient dans la réponse d’une même personne au même extrait. Les cinq catégories sont exclusives et totalisent 13 824. Le dénominateur de 155 vient des deux catégories portant les deux étiquettes, pas de toutes les évaluations ou de tous les extraits sources.[4]
Avant d’examiner les sélections conjointes, nous avons fixé les groupes, la règle de couverture des évaluations, la vérification par année et un minimum de 100 extraits pour la comparaison principale limitée aux deux étiquettes. Les 155 observés satisfaisaient cette condition. Nous n’avons pas exigé de pourcentage particulier, changé la règle pour favoriser un résultat ou mélangé les données enrichies autour des blocages avec le groupe aléatoire.
La recherche originale utilisait déjà des évaluations individuelles, et des travaux ultérieurs ont agrégé chaque type d’attaque à la majorité. Notre contribution, plus ciblée, décrit qui a fourni les deux options dans un ensemble fixe de jugements. Elle ne corrige pas les méthodes de ces études. Le téléchargement fournit les résultats agrégés, les méthodes et les instructions de reproduction avec les fichiers publics sources disponibles séparément.[6][7]
Rendez le prochain examen plus facile à suivre
La question utile lors de la transmission d’un dossier de modération sur les réseaux sociaux est de savoir qui a fait chaque observation et ce qu’il décrivait. Dans cette comparaison historique sélectionnée, 57 des 155 extraits portant les deux étiquettes n’avaient aucune personne les ayant choisies ensemble. Cette relation disparaîtrait d’une synthèse ne contenant que les noms des étiquettes.
Gardez reliés les observations de la personne, le contexte utile et la décision finale. Une entreprise ou un créateur pourra ainsi expliquer ce que contient le dossier et pourquoi l’action choisie en découle, sans demander à une catégorie de remplacer tout l’examen.
- Télécharger tous les résultats affichés (CSV)
- Télécharger les résultats, les méthodes et la fiche (ZIP)
Aucune inscription nécessaire. Le dossier contient des résultats agrégés anonymes, les méthodes, les instructions de reproduction et la fiche réutilisable. Il ne contient aucun texte de discussion original, identifiant de modification ou d’évaluateur, ni donnée démographique. Les fichiers publics d’origine sont disponibles séparément dans la version liée.
Sources et notes
- Source : Wikipedia Talk Labels: Personal Attacks, version 6 sur Figshare, DOI 10.6084/m9.figshare.4054689.v6, publiée en février 2017 sous CC0. Nous avons utilisé attack_annotated_comments.tsv (fichier 7554634) et attack_annotations.tsv (fichier 7554637), avec les contrôles MD5 du producteur et des SHA-256 calculés indépendamment. Influence IQ a terminé la sélection, les calculs et l’interprétation le 25 octobre 2026 (UTC). L’étude n’a recueilli aucun nouveau commentaire, créé aucune nouvelle annotation ni mesuré une plateforme sociale en direct.
- Le producteur définit quoting_attack comme la perception, par un évaluateur, qu’un texte cite ou rapporte une attaque provenant d’un autre commentaire, et recipient_attack comme une attaque visant le destinataire. L’interface permettait plusieurs choix. L’indicateur général d’attaque est une réponse source distincte, pas un OU reconstruit à partir des sous-types dans cette analyse. Le texte publié concatène les ajouts d’une modification ; ce n’est ni un résumé de modification, ni nécessairement un message entier ou une conversation complète. Les espaces de discussion, groupes d’échantillonnage et divisions entraînement/développement/test conservent leur sens documenté.
- Les fichiers complets contenaient 115 864 extraits uniques, 1 365 217 paires uniques modification/évaluateur et 4 053 évaluateurs. La qualification structurelle n’a trouvé ni paires dupliquées, ni jointures sans correspondance, ni lignes mal formées, ni valeurs d’indicateur absentes ou invalides. L’admissibilité exigeait exactement 10 évaluations complètes de personnes distinctes sur les 5 indicateurs sources, les deux espaces de discussion documentés et toutes les divisions du modèle, avec un poids identique d’un par extrait. Le groupe aléatoire principal retenait 13 824 extraits sur 37 492. Le groupe enrichi autour des blocages, sélectionné séparément, en retenait 42 383 sur 78 372. Une même personne pouvait évaluer plusieurs extraits ; aucun texte identique n’a été fusionné, aucune suppression pour cohérence entre indicateurs ni aucun recodage de l’indicateur général n’a été imposé.
- Q indique toute sélection citation/récit et R toute sélection d’attaque visant le destinataire pour un extrait admissible. La présence des deux exige au moins un Q et un R parmi les 10 jugements. La présence chez une même personne exige en plus Q et R dans une réponse modification/évaluateur ; la catégorie « personnes différentes uniquement » ne contient aucune telle réponse. Le dénominateur principal est 98 + 57 = 155 ; les fractions exactes 98/155 et 57/155 sont affichées à 63,2 % et 36,8 %. Les pourcentages utilisent une arithmétique rationnelle exacte et un arrondi au plus proche, les demis vers le haut, à 1 décimale. Avant le calcul, nous exigions au moins 100 extraits portant les deux étiquettes pour la comparaison principale, sans seuil de pourcentage favorable. Aucun intervalle de confiance de population, test de significativité, postulat d’indépendance ou taux d’exactitude n’a été calculé.
- La sensibilité enrichie autour des blocages, définie à l’avance, utilisait la même règle d’exactement 10 jugements et restait séparée du groupe aléatoire principal. Ses cinq effectifs étaient de 20 911 sans aucune de ces deux étiquettes, 959 avec une étiquette de citation/récit sans étiquette d’attaque visant le destinataire, 18 056 avec une étiquette d’attaque visant le destinataire sans étiquette de citation/récit, 1 354 avec les deux chez une même personne et 1 103 avec les deux uniquement chez des personnes différentes ; total 42 383, dénominateur 2 457. Exclure 2016 du groupe aléatoire laissait 13 809 extraits, avec les effectifs 12 012 / 406 / 1 236 / 98 / 57 dans cet ordre. Les 155 extraits concernés et la répartition 98/57 étaient inchangés. Ce sont des vérifications descriptives, pas des réplications indépendantes en population ni la preuve que les groupes d’échantillonnage sont comparables.
- L’étude de Wulczyn, Thain et Dixon de 2017, Ex Machina: Personal Attacks Seen at Scale, a établi le travail de collecte collaborative et de modélisation sous-jacent. L’article WAC de Cécillon et ses collègues, en 2020, a conservé une matrice évaluateur/champ et agrégé séparément les champs d’attaque à la majorité. Ce sont des méthodes existantes, pas des erreurs établies par notre étude. Notre comparaison porte sur la présence d’une étiquette parmi 10 avis et sur le choix conjoint dans une même réponse, pas sur la performance des étiquettes majoritaires. Influence IQ compte si les deux options ont été fournies par la même personne ou uniquement par des personnes différentes au sein de chaque extrait sélectionné.
- La présentation de la source décrit 2001–2015 et l’article d’origine 2004–2015 ; les fichiers vérifiés de la version 6 contiennent des années de 2001–2016. Le schéma du producteur indique 0/1 pour la connexion, mais le fichier utilise False/True ; les chaînes binaires sont 0.0/1.0. Nous avons conservé ces différences entre documentation et observation sans leur attribuer de cause. Le lecteur accepte les valeurs littérales publiées, sans arrondir ni convertir les indicateurs. Le dossier documente les versions sources, les règles de sélection et les étapes pour reproduire l’analyse à partir des fichiers publics.
- Les deux groupes de 10 personnes, les réponses des évaluateurs A/B et les choix de transmission sont des exemples pédagogiques fictifs. Ils ne contiennent aucun texte de discussion ni identifiant d’origine. Les deux groupes inventés comptent une sélection citation/récit et une sélection d’attaque visant le destinataire, mais seul le premier contient la paire chez une même personne. La fiche et les illustrations sont des explications pratiques, pas des processus observés, des politiques de modération testées ou des garanties de meilleures décisions.
Toutes les versions linguistiques sont traduites directement de l’original anglais. Elles décrivent le même jeu historique de données de Wikipédia en anglais et la même sélection d’évaluations. La traduction ne crée pas de résultats propres à un marché local. Influence IQ est responsable de l’analyse, de l’interprétation et des traductions.