Cronometra la locución traducida antes de cerrar el montaje
Una grabación en inglés puede caber en una escena mientras que la versión traducida la supera. Nuestra comparación de 200 pasajes de investigación muestra por qué el tiempo de las locuciones multilingües debe entregarse antes de fijar las imágenes.
Análisis descriptivo de las duraciones declaradas en los metadatos de 200 pasajes traducidos comunes a 10 configuraciones de prueba de FLEURS, dentro de un conjunto de 350 pasajes en inglés. Son lecturas de investigación, no encargos comerciales de locución. Metadatos obtenidos el 24 de octubre de 2026 (UTC).
Resumen
¿Debe una empresa ajustar un vídeo localizado al tiempo de su locución en inglés? Cronometra primero las lecturas traducidas. Comparamos las duraciones declaradas en los metadatos de 200 pasajes presentes en las 10 configuraciones de prueba de FLEURS seleccionadas. Cada pasaje recibió el mismo peso tras resumir sus lecturas repetidas mediante una mediana. La variación mediana emparejada respecto al inglés fue del −6,1 % en las grabaciones neerlandesas al +82,4 % en las filipinas. Ninguna cifra es un margen de producción válido para toda una lengua.[1][2]
Un ejemplo fijo de 15 segundos concreta la entrega. De 186 pasajes cuya mediana inglesa cabía en ese tiempo, 110 medianas filipinas lo superaban. Con una regla más estricta, todas las tomas inglesas observadas cabían para 178 pasajes, mientras que todas las filipinas lo superaban para 72. Lectores, composición por género, traducción y pausas siguen entrelazados. La aportación es una comparación verificable de las duraciones, con las 9 comparaciones de destino y un ejemplo elegido antes de los resultados, para pedir una lectura cronometrada antes de cerrar el montaje.
El montaje de un vídeo breve de producto está listo. La narración inglesa encaja, el producto aparece en el fotograma previsto y el plano final deja espacio para la oferta. Llega una traducción con el mismo mensaje. Resulta tentador tratar la grabación como la última pieza que falta en una línea de tiempo ya terminada.
Ahí una información ausente puede convertirse en un problema de producción: nadie ha cronometrado la lectura traducida. Aprobar el sentido de un texto no indica cuánto ocupará su interpretación grabada. Una entrega útil incluye tanto el texto aprobado como la duración de la grabación.
Examinamos esa diferencia en FLEURS, un corpus de investigación de pasajes traducidos leídos en voz alta. En 200 pasajes correspondientes, las relaciones de duración variaban entre configuraciones y entre lecturas del mismo pasaje. Las tablas mantienen esas diferencias. Dan a empresas y creadores una razón para pedir tiempos de su producción real, sin convertir un promedio de investigación en un margen garantizado.
Da a cada versión grabada su propio tiempo
Compara el mismo pasaje antes de adoptar una regla de duración
La primera tabla compara cada configuración de destino con el inglés de Estados Unidos para los mismos 200 pasajes fuente. Para cada pasaje y configuración tomamos la mediana de las grabaciones disponibles. Después dividimos la mediana de destino entre la inglesa y expresamos la diferencia respecto a 1 como porcentaje. Por último, resumimos esas 200 variaciones emparejadas. Un pasaje con 3 lecturas recibió el mismo peso que uno con 1.[2][4]
En las grabaciones en español latinoamericano, la variación mediana emparejada fue de +24,8 %. La mitad central de las variaciones por pasaje iba de +10,2 % a +47,0 %. En japonés, la mediana correspondiente fue de +36,6 %, con una mitad central de +17,8 % a +61,8 %. Esto describe las grabaciones publicadas de pasajes correspondientes; no prescribe cómo debe interpretarse ninguna lengua.
No es lo mismo que dividir 2 medianas globales de duración. Para los mismos pasajes comunes, la mediana de los resúmenes ingleses por pasaje era de 9,3 segundos y la española de 11,6. Dividir esos valores mostrados no reconstruiría el resultado emparejado de +24,8 %. Primero relacionamos cada pasaje con su propia referencia inglesa, en lugar de comparar un pasaje de destino corto con otro pasaje situado en el centro de la distribución.
Las grabaciones neerlandesas tenían una variación mediana emparejada de −6,1 %, frente al +82,4 % de las filipinas. Mantener ambas filas permite ver la amplitud de las relaciones observadas. También evita sugerir que todas las grabaciones traducidas eran más largas. En el conjunto común, 71 medianas neerlandesas superaban las inglesas, 2 eran iguales y las restantes eran más cortas.
Las filas siguen el orden fijo de configuraciones de la comparación, sin ordenarse según el resultado. Lee la fila pertinente conservando su contexto de investigación. El español latinoamericano y el filipino son los ámbitos lingüísticos de la fuente; publicar este artículo en otra lengua no convierte esas grabaciones en evidencia sobre ese mercado.
Variación emparejada de duración respecto al inglés de Estados Unidos
Los mismos 200 pasajes traducidos en cada fila. La mediana de destino de cada pasaje se divide entre su mediana inglesa; la diferencia respecto a 1 se expresa como porcentaje. Q25 y Q75 delimitan la mitad central de esas variaciones.
| Configuración de grabación de destino | Variación relativa mediana (%) | Variación en el percentil 25 (%) | Variación en el percentil 75 (%) |
|---|---|---|---|
| Español latinoamericano | 24,8 % | 10,2 % | 47,0 % |
| Francés (Francia) | 5,7 % | -10,0 % | 29,1 % |
| Alemán (Alemania) | 31,4 % | 0,0 % | 62,4 % |
| Neerlandés (Países Bajos) | -6,1 % | -21,6 % | 8,9 % |
| Indonesio (Indonesia) | 26,3 % | 11,4 % | 49,9 % |
| Malayo (Malasia) | 11,3 % | -1,2 % | 29,1 % |
| Filipino (Filipinas) | 82,4 % | 54,2 % | 120,1 % |
| Tailandés (Tailandia) | 20,8 % | 1,6 % | 42,0 % |
| Japonés (Japón) | 36,6 % | 17,8 % | 61,8 % |
La dispersión importa cuando el trabajo tiene un tiempo fijo
Una mediana comprime 200 relaciones en un número. Una escena concreta debe alojar una lectura concreta. Los cuartiles junto a cada mediana muestran por qué llevar solo el valor central a un encargo eliminaría información pertinente para decidir.
Las grabaciones francesas tenían una variación mediana emparejada de +5,7 %, pero su mitad central iba de −10,0 % a +29,1 %. Una diferencia central pequeña coexistía con pasajes a ambos lados del tiempo inglés. En alemán, la mediana era de +31,4 %, con una mitad central entre aproximadamente 0,0 % y +62,4 %. El 0,0 % mostrado está redondeado; el cuartil inferior sin redondear era ligeramente positivo.
Estos intervalos describen la mitad central de las variaciones emparejadas observadas. No son intervalos de confianza, límites mínimo y máximo ni un rango que contenga una futura grabación comercial. Los pasajes, traducciones e interpretaciones difieren de un nuevo guion de producto. Ni siquiera copiar exactamente el porcentaje mediano de la tabla daría al equipo la toma real que necesita para editar.
Eso cambia la pregunta práctica. En vez de preguntar cuánto tiempo adicional necesita siempre una lengua, quien produce el vídeo puede preguntar si la lectura traducida aprobada cabe en la escena prevista. La tabla explica la utilidad de esa comprobación; la grabación del encargo da la respuesta.
Un pasaje puede llegar con varias duraciones
Elegimos el pasaje fuente 1662 por ser el identificador más pequeño disponible en las 10 configuraciones, antes de resumir las duraciones. Su tabla incluye todas las lecturas disponibles. No buscamos un ejemplo llamativo después de ver los tiempos y aquí no reproducimos ni sus palabras ni su audio.[3][4]
Los 2 archivos ingleses duraban aproximadamente 8,4 y 11,2 segundos, con una mediana de 9,8. Los 3 archivos alemanes iban de 10,4 a 23,5 segundos, con una mediana de 10,5. Los 2 archivos filipinos iban de 22,3 a 24,9 segundos, con una mediana de 23,6. Son tiempos de archivos completos según los metadatos fuente, redondeados a 1 decimal para mostrarlos.
La mediana de 2 lecturas puede ser su punto medio aritmético, no la duración de un archivo realmente grabado. Los 9,8 segundos ingleses mostrados son uno de esos resúmenes. Al elegir una toma, el editor debe trabajar con la duración del archivo seleccionado. El número de tomas y su rango de mínimo a máximo hacen visible esa diferencia junto a la mediana.
La dispersión alemana también aconseja no atribuir cada segundo a la longitud de la traducción. No tenemos identificadores de hablantes, no escuchamos las grabaciones ni separamos habla y pausas. No podemos distinguir aquí lectura, lectores y condiciones de grabación. El ejemplo respalda una petición sencilla: entregar la toma prevista, o una lectura cronometrada del texto previsto, en lugar de una estimación general para la lengua.
Pasaje 1662: conserva el rango de tomas junto a la mediana
El ID fuente más pequeño con grabaciones en las 10 configuraciones, elegido por disponibilidad antes de resumir las duraciones. Incluye todas las tomas. Los segundos describen archivos completos según los metadatos, sin separar pausas.
| Configuración de grabación | Tomas disponibles | Archivo más corto (segundos) | Mediana de los archivos (segundos) | Archivo más largo (segundos) |
|---|---|---|---|---|
| Inglés de Estados Unidos | 2 | 8,4 | 9,8 | 11,2 |
| Español latinoamericano | 3 | 8,8 | 9,5 | 9,5 |
| Francés (Francia) | 2 | 6,4 | 6,8 | 7,1 |
| Alemán (Alemania) | 3 | 10,4 | 10,5 | 23,5 |
| Neerlandés (Países Bajos) | 1 | 7,9 | 7,9 | 7,9 |
| Indonesio (Indonesia) | 1 | 11,6 | 11,6 | 11,6 |
| Malayo (Malasia) | 2 | 8,0 | 8,6 | 9,1 |
| Filipino (Filipinas) | 2 | 22,3 | 23,6 | 24,9 |
| Tailandés (Tailandia) | 3 | 6,5 | 8,7 | 10,1 |
| Japonés (Japón) | 2 | 12,1 | 13,3 | 14,6 |
Un ejemplo de 15 segundos necesita su denominador
Fijamos 15 segundos como ejemplo de planificación antes de calcular resultados. No es una regla de plataforma, una duración publicitaria recomendada ni un margen de producción seguro. La pregunta era si un resumen de grabación inglesa podía caber en ese tiempo mientras el resumen correspondiente de destino lo superaba.
De los 200 pasajes comunes, 186 tenían una mediana inglesa de como máximo 15 segundos. En ese grupo, la mediana de destino superaba los 15 segundos en 20 pasajes en español latinoamericano, 39 en alemán, 9 en neerlandés, 110 en filipino y 37 en japonés. Cada cantidad tiene el mismo denominador de 186; las demás comparaciones están en la descarga.[6]
También aplicamos una regla más estricta a las tomas observadas. Todas las lecturas inglesas disponibles debían caber en 15 segundos y todas las de destino debían superarlos. Había 178 pasajes ingleses aptos. Esto ocurrió en 11 pasajes españoles, 9 alemanes, 4 neerlandeses, 72 filipinos y 14 japoneses. Son cantidades de las tomas publicadas, no de toda interpretación posible del pasaje.
La comprobación más estricta evita depender de un punto medio aritmético que nadie grabó. Sigue sin demostrar que un pasaje no pueda leerse más rápido, montarse de otra forma o reescribirse adecuadamente. Para el equipo, la distinción útil es entre tener pruebas de que una grabación entregada cabe y suponer que otra versión cabrá porque la inglesa lo hizo.
Un lanzamiento ficticio muestra dónde hacer la entrega
Imagina una pequeña marca inventada de utensilios de cocina que encarga a un creador un vídeo de producto de 15 segundos. El concepto incluye una demostración, una oferta y un plano final del producto. La lectura inglesa dura 11 segundos. Se aprueba el sentido de la traducción, pero la primera lectura del narrador previsto dura 17. La marca, el texto, los tiempos y el encargo son ficticios; no son observaciones de FLEURS.
Si el creador ya ha fijado cada plano a la lectura inglesa, el archivo de 17 segundos obliga a decidir tarde en el montaje. La persona responsable del proyecto puede hacer explícita esa decisión pidiendo una lectura cronometrada mientras aún se revisa el texto traducido. El encargo debe identificar el mensaje que ha de seguir siendo correcto, el tiempo de escena disponible y quién puede aprobar un cambio en el texto o el montaje.
La respuesta no tiene por qué ser acelerar automáticamente al narrador. El traductor podría proponer una formulación natural más breve que conserve la oferta. El editor podría dar más tiempo a la demostración, mover un detalle secundario al texto de acompañamiento o preparar otro montaje si lo permite el formato acordado. Son opciones de producción que conviene comentar, no mejoras demostradas por nuestro análisis.
Una entrega útil para este encargo ficticio podría decir: «Versión de destino: __. Texto aprobado: __. Toma prevista: __ segundos, medidos en el archivo entregado. Tiempo asignado a la escena: __ segundos. Oferta y avisos obligatorios: __. Responsable de aprobar cambios de texto: __. Responsable de aprobar el montaje: __». Los espacios corresponden al equipo real; la tabla de investigación no puede rellenarlos.
Con varias versiones de destino, la persona responsable puede llevar una fila por toma prevista en vez de marcar todo el proyecto como «traducción aprobada». Aprobar el texto y aprobar su tiempo responden a preguntas distintas. Si el traductor cambia una afirmación del producto después de la lectura provisional, la fila debe indicarlo antes de reutilizar la duración anterior. Es una propuesta para organizar el encargo ficticio, no una reducción medida de su riesgo.
Cuando llega la toma revisada, el creador puede comprobar la versión completa con quien responda por la lengua y el sentido. Juzgar el encaje solo por la duración puede dejar pasar una interpretación poco natural o un plano final ilegible. El estudio no midió calidad ni reacción del público. Aporta a este encargo ficticio un conocimiento más temprano de la duración; la decisión creativa sigue en manos de quienes hacen el vídeo.
Mantén texto, toma e imagen juntos durante la revisión
Para el tiempo de las locuciones multilingües, sirve un documento breve que acompañe al trabajo. Identifica la versión aprobada del texto, la grabación prevista y el tiempo de escena. Si cambia alguno, la siguiente persona puede ver qué información de duración sigue siendo válida.
Una lectura provisional cronometrada puede revelar un conflicto cuando el equipo aún tiene opciones. Debe seguir identificada como provisional, sin presentarse como prueba de que el narrador final entregará la misma duración. Cuando llegue la toma prevista, sustituye la suposición por su tiempo medido y revísala en el montaje real.
Mantén completa la versión traducida durante esa revisión. Quien comprueba el sentido necesita oír la interpretación con la imagen, mientras que el editor debe ver si las pausas, la presentación del producto y el plano final funcionan juntos. Que un archivo quepa en un tiempo es un dato, no la aprobación de toda la versión.
Los 4 pasos siguientes son una propuesta de entrega, no un proceso probado en FLEURS. Aplican a una decisión de producción la diferencia entre texto y duración grabada. No prometen alcance, retención, conversiones ni un número de revisiones para el proyecto.
Transmite la duración de la grabación en 4 pasos
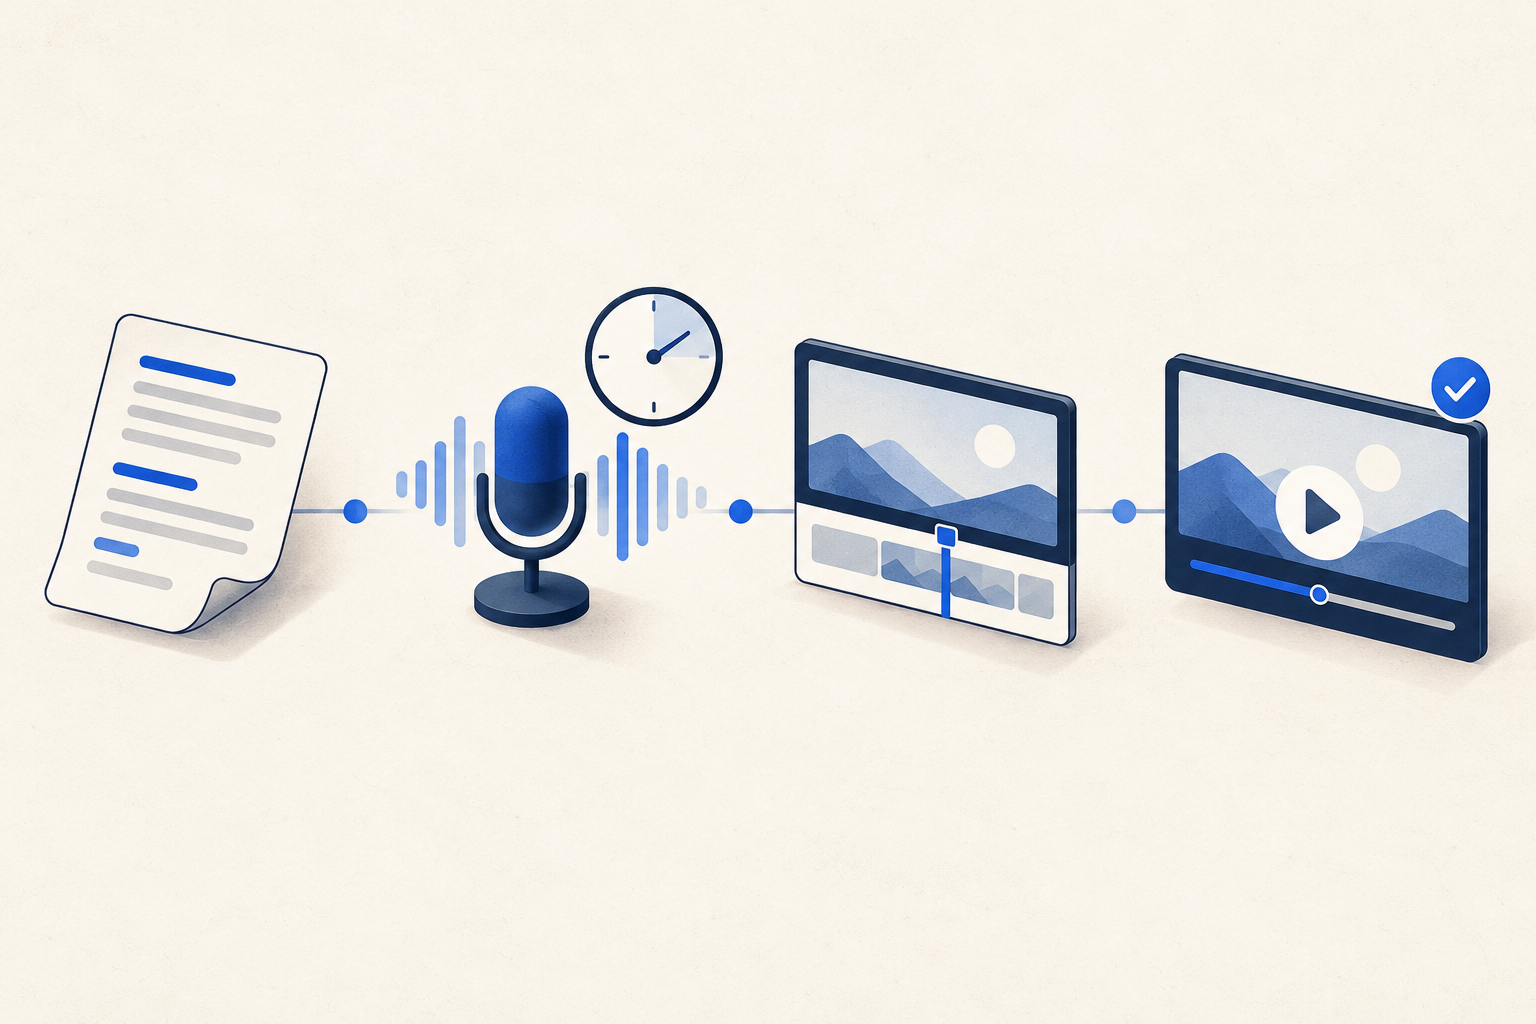
Acuerda el texto
Identifica la versión de destino, el texto aprobado y quién revisa el sentido.
Cronometra la lectura prevista
Adjunta la duración medida de la toma e identifica la lectura de prueba como provisional.
Resuelve el encaje
Acuerda los cambios de texto o escena antes de cerrar el montaje.
Revisa la versión completa
Comprueba la toma elegida junto con la imagen, la oferta y el plano final.
Conserva el conjunto de pasajes emparejados al reutilizar una cifra
La comparación común incluye 200 de los 350 pasajes de prueba ingleses. A los otros 150 les faltaba al menos una configuración elegida. La disponibilidad completa puede ser selectiva, por lo que el conjunto común no debe describirse como una muestra aleatoria de textos, lenguas o encargos de locución.
Repetimos cada comparación inglés–destino con todas las parejas disponibles. Los denominadores iban de 251 para el neerlandés a 349 para filipino y tailandés. También repetimos la comparación común solo con pasajes que tuvieran al menos 2 lecturas inglesas y 2 de destino; esos subconjuntos tenían entre 66 y 166 pasajes. Los 9 resultados emparejados y sus denominadores están en la descarga.[4]
En cada configuración, los subconjuntos con lecturas repetidas mantuvieron el mismo sentido de variación mediana que la comparación principal. Es una comprobación útil de esta forma de resumir. No controla a los lectores ni convierte los distintos conjuntos de pares en poblaciones comparables. Las tomas repetidas no son participantes independientes.
Las grabaciones adquiridas en alemán, neerlandés, indonesio, malayo y filipino estaban todas etiquetadas como masculinas; las tailandesas, como femeninas. Inglés, español, francés y japonés tenían etiquetas mixtas. Sin identificadores de hablantes, no podemos separar la configuración de la composición de lectores, interpretación, traducción o selección de las tomas conservadas. Lee la tabla como una descripción de estas grabaciones, con esa limitación junto a cualquier cifra que reutilices.[7]
Cómo hicimos la comparación de duraciones
FLEURS es un corpus de investigación presentado en 2022 con pasajes traducidos leídos en voz alta. La documentación del productor y de TensorFlow Datasets identifica un ID de texto fuente común entre lenguas y un campo de metadatos para el total de muestras de audio a 16.000 Hz. Dividimos ese campo entre 16.000 para obtener segundos del archivo completo según los metadatos. No decodificamos el audio, no comprobamos la longitud de sus formas de onda ni retiramos silencios.[1][2]
Obtuvimos los 10 archivos de metadatos de prueba el 24 de octubre de 2026 (UTC), en la revisión fija del productor documentada en las notas. Contienen 7528 grabaciones de los pasajes disponibles. Emparejamos por ID fuente, nunca por posición de fila. El conjunto común de 200 pasajes, las reglas de 15 segundos, la comprobación de lecturas repetidas y el ejemplo 1662 se fijaron tras conocer la disponibilidad y antes de calcular los resúmenes de duración.[3][4]
La fecha de obtención identifica la versión de la fuente utilizada. No transforma grabaciones presentadas con un corpus de 2022 en una encuesta de 2026 sobre narradores o creadores. Los datos públicos conservan la revisión para distinguir un análisis nuevo de material existente de interpretaciones recién grabadas.
Un intento anterior de viabilidad con la partición de desarrollo dio solo 91 pasajes comunes, por debajo de su umbral de 100, y quedó apartado. La adquisición de prueba se detuvo primero por un límite de tamaño de los metadatos tailandeses; un límite mayor documentado completó el mismo conjunto fijo de prueba. Son cambios declarados de viabilidad y acceso, no pruebas de un estudio prerregistrado sin conocimiento de resultados.
Todos los cálculos emparejados usaron cantidades de muestras y fracciones exactas. Los cuartiles usan interpolación lineal en las posiciones definidas por (n−1) × p. Las tablas muestran porcentajes y segundos con 1 decimal, con redondeo al más cercano y los empates alejándose de cero; el número de tomas es entero. Los datos derivados públicos conservan los resúmenes exactos por pasaje, resultados por pares, análisis de sensibilidad y ambas definiciones del límite temporal. No calculamos intervalos de confianza poblacionales ni efectos causales.[4]
Las restricciones temporales del doblaje ya son un tema de investigación establecido.[5] Este artículo añade una comparación reproducible de las duraciones de los archivos publicados para estos pasajes fijos, con datos para examinar la cobertura y las tomas repetidas. Respalda pedir el tiempo de la producción traducida antes de cerrar el montaje; no aporta un porcentaje universal de ampliación.
- Descargar los 67 resultados mostrados (CSV)
- Descargar los 350 pasajes × 10 configuraciones y los resúmenes de tomas (CSV)
- Descargar las 9 comparaciones, análisis de sensibilidad y recuentos de límites temporales (CSV)
- Descargar fuentes, método y código de reproducción (ZIP)
Sin registro. Los datos derivados conservan las combinaciones ausentes y los denominadores reales. El paquete común contiene documentación del método en inglés, referencias y código de reproducción; no redistribuye textos originales ni audio. Todas las ediciones describen el mismo corpus fijo.[8]
Notas de investigación
- Conneau et al., FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech (2022), secciones 2.1–2.3. El corpus contiene pasajes traducidos leídos en voz alta, con hasta 3 grabaciones validadas por frase, muestreadas a 16 kHz. Su recogida y finalidad de investigación no acreditan representatividad para la locución comercial. Los textos proceden de FLORES; no son una muestra de guiones publicitarios.
- TensorFlow Datasets, documentación de características y analizador de xtreme_s versión 2. El ID de texto fuente es coherente entre lenguas y puede repetirse entre lecturas; num_samples registra el total de muestras de audio. La característica de audio declara 16.000 Hz. El analizador copia los recuentos de metadatos sin verificarlos frente a formas de onda decodificadas. Nuestros segundos son duraciones de archivos completos declaradas en metadatos, sin separar pausas ni controlar la identidad de los hablantes.
- Metadatos de Google FLEURS, revisión fija ab93cf03f9d0cd083c853fad065a6377067408aa, partición de prueba, obtenidos el 24 de octubre de 2026 (UTC). Configuraciones: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th y ja_jp. El TSV inglés enlazado es uno de los 10 archivos fuente; el paquete recoge cada URL exacta y SHA256. El español fuente es latinoamericano y fil_ph corresponde al filipino.
- Cálculos de Influence IQ: una mediana por pasaje y configuración, igual peso por pasaje, razón emparejada entre medianas de destino e inglesa y diferencia emparejada en segundos. El análisis principal usa los 200 pasajes comunes a las 10 configuraciones, entre 350 ingleses. Los secundarios usan todas las parejas inglés–destino disponibles y los pasajes comunes con al menos 2 tomas por lado. Método y ejemplo se fijaron antes de resumir las duraciones, tras conocer la disponibilidad. El paquete documenta fracciones exactas, interpolación, redondeo y denominadores.
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing (2023). Trabajos anteriores ya examinan el tiempo en el doblaje humano profesional. Nuestra aportación es la tabla finita de duraciones de archivos FLEURS emparejados y su interpretación reutilizable para la entrega en producción, no descubrir las restricciones del doblaje ni ofrecer una referencia de doblaje profesional.
- El límite de 15 segundos se fijó como ejemplo de planificación antes de los resultados. Regla de medianas: 186 pasajes comunes tienen una mediana inglesa ≤15 segundos; se cuentan medianas de destino >15. Regla de todas las tomas observadas: 178 tienen todas las tomas inglesas ≤15; se cuentan pasajes con todas las tomas de destino observadas >15. La igualdad cabe en el tiempo. Son resultados descriptivos de grabaciones publicadas, no reglas de plataforma ni afirmaciones sobre toda lectura posible.
- Los metadatos no tienen identificadores de hablantes. Las grabaciones alemanas, neerlandesas, indonesias, malayas y filipinas están todas etiquetadas como masculinas; las tailandesas, como femeninas. Las configuraciones ausentes excluyen 150 de los 350 pasajes ingleses del conjunto común. Las comprobaciones por pares y con lecturas repetidas describen subconjuntos finitos distintos y no eliminan la confusión entre lectores, género, interpretación, traducción o selección. No se presentan intervalos de confianza, clasificaciones de velocidad lingüística, efectos causales ni previsiones comerciales.
- Fuente: Google FLEURS, disponible bajo CC BY 4.0. Selección, cálculos, tablas, interpretación editorial y traducciones son adaptaciones de Influence IQ, sin sugerir respaldo de los autores del conjunto de datos. El paquete público redistribuye resúmenes numéricos derivados y código, no audio ni textos originales. Redondear la visualización no cambia los recuentos exactos ni la población común de grabaciones.
El artículo inglés es la fuente de todas las versiones. Cada edición describe las mismas grabaciones de prueba y pasajes traducidos de FLEURS; la lengua del artículo no crea evidencia sobre un mercado nuevo. Influence IQ responde por el análisis, la interpretación y las traducciones.