Dos etiquetas de moderación pueden venir de revisores distintos
Al entregar un caso para revisar un comentario, pueden aparecer dos etiquetas sin indicar quién eligió cada una. Las evaluaciones históricas de Wikipedia muestran por qué ese detalle importa a la siguiente persona que lee el caso.
Análisis original de Influence IQ sobre una selección de evaluaciones del conjunto histórico de ataques personales de Wikipedia Detox. Análisis finalizado el 25 de octubre de 2026 (UTC).
Resumen
De 13.824 fragmentos históricos de conversaciones de Wikipedia seleccionados, 155 recibieron tanto una etiqueta de cita o relato de un ataque como una de ataque dirigido al destinatario en alguna de sus 10 evaluaciones individuales. En 98 de esos 155 fragmentos, al menos una persona eligió ambas etiquetas. En los otros 57, el 36,8 %, las etiquetas procedían únicamente de personas distintas. Ese porcentaje se refiere a los 155 fragmentos, no al conjunto de 13.824.[1][4]
Para las empresas y los creadores que gestionan comentarios en redes sociales, la aplicación práctica está en cómo entregan el caso: conserva las observaciones de cada persona junto a su evaluación. Que aparezcan dos etiquetas no demuestra que una misma persona eligiera ambas. El estudio describe evaluaciones subjetivas de fragmentos históricos, no errores de moderación ni una regla para eliminar comentarios. La ficha que puedes copiar más abajo lleva esta distinción a un documento de revisión útil.
Imagina que un creador pide a un compañero que revise un comentario complicado. El caso llega con dos etiquetas: alguien está citando o relatando un ataque y alguien está atacando al destinatario. Antes de decidir qué hacer, el compañero necesita otro dato: ¿hizo la misma persona ambas observaciones?
Es una distinción que puede perderse en un resumen. Quizá una persona eligió las dos opciones, o quizá dos personas se fijaron en aspectos distintos del mismo texto. Una lista de etiquetas no permite saber qué ocurrió. También puede dejar sin aclarar qué palabras estaba describiendo cada persona.
Estudiamos esa pregunta a partir de evaluaciones individuales de un conjunto de datos de investigación ya existente. El material original procede de páginas de discusión de Wikipedia. Nos permite mostrar la relación entre las etiquetas y quienes las eligieron, y ayudar a empresas y creadores a decidir qué información conservar cuando entregan sus propios casos.
Mantén cada observación vinculada a quien la hizo
Empieza por lo que describe cada etiqueta
La primera opción preguntaba si el texto citaba o relataba un ataque personal que se había producido en otro comentario. La segunda se refería a un ataque personal dirigido al destinatario. Se podía elegir más de una opción. Eran evaluaciones del texto presentado, no decisiones para ocultarlo ni pruebas de que se hubiera incumplido una norma.[2]
Consideramos que una etiqueta estaba presente si al menos una de las 10 personas la había elegido. Bastaba con que la seleccionara alguien del grupo. No exigimos una mayoría, no presentamos las etiquetas como un consenso ni comprobamos si eran correctas.
De los 13.824 fragmentos seleccionados, 12.025 no tenían ninguna de estas dos etiquetas. Otros 406 tenían una de cita o relato sin una de ataque al destinatario, y 1.238 tenían una de ataque al destinatario sin una de cita o relato. Quedaban 155 con ambas etiquetas en alguna de sus evaluaciones.
Estas descripciones se refieren solo a esas dos opciones. Un fragmento sin una etiqueta de ataque al destinatario podía tener otra clase de etiqueta de ataque. La etiqueta de cita o relato no certifica que el texto fuera inofensivo. Usar nombres precisos evita que una categoría útil se convierta, sin advertirlo, en una conclusión más amplia.
Cómo se etiquetaron los 13.824 fragmentos seleccionados
Una etiqueta estaba presente si al menos una de las 10 personas la había elegido. Estas cinco categorías se refieren a dos opciones concretas; «ninguna» no significa que el fragmento careciera de cualquier etiqueta de ataque.
| Etiquetas de cita o relato y ataque al destinatario | Fragmentos |
|---|---|
| Ninguna de estas dos etiquetas | 12.025 |
| Etiqueta de cita o relato, sin etiqueta de ataque dirigido al destinatario | 406 |
| Etiqueta de ataque dirigido al destinatario, sin etiqueta de cita o relato | 1238 |
| Ambas, con al menos una persona que eligió las dos | 98 |
| Ambas, aportadas solo por personas distintas | 57 |
57 fragmentos tenían ambas etiquetas, pero nadie eligió las dos
Dentro de los 155 fragmentos, comprobamos la respuesta individual que había detrás de cada etiqueta. En 98, al menos una persona eligió las dos opciones para el mismo fragmento. En 57, las selecciones de cita o relato y ataque al destinatario procedían únicamente de personas distintas. Ninguna respuesta individual de esos 57 contenía ambas.
El reparto fue del 63,2 % con al menos una persona que eligió ambas y del 36,8 % con etiquetas aportadas solo por personas distintas. Los dos grupos formaban parte del mismo conjunto específico de 155 fragmentos. El conjunto mayor de 13.824 sigue siendo importante: muestra de dónde parte esa comparación limitada a los casos con ambas etiquetas.[4]
La distinción cambia lo que puedes afirmar a partir de un resumen. Saber que aparecen las dos etiquetas permite decir que cada una fue elegida en alguna evaluación. Por sí solo, no permite afirmar que una misma persona describiera el texto de las dos maneras.
Tampoco la selección de ambas por una persona resuelve qué significaban las palabras. Un fragmento podía combinar texto añadido durante una misma modificación de Wikipedia, incluido más de un mensaje. Que alguien eligiera las dos opciones no demuestra que el pasaje citado fuera el ataque al destinatario. No examinamos los fragmentos individuales para explicar sus evaluaciones.[2][6]
En 57 de los 155 fragmentos nadie eligió las dos
Esta comparación incluye solo los 155 fragmentos seleccionados con ambas etiquetas entre sus 10 evaluaciones. Se basa en selecciones de cualquier persona, no en mayorías ni en resultados de moderación verificados.
| Quién aportó las dos etiquetas | Fragmentos | Porcentaje de los 155 fragmentos |
|---|---|---|
| Al menos una persona eligió ambas | 98 | 63,2 % |
| Las etiquetas llegaron solo de personas distintas | 57 | 36,8 % |
Entrega también la observación que hay detrás de la etiqueta
En una empresa, el caso puede pasar de quien está pendiente de los comentarios a quien es responsable de la cuenta. Para un creador, puede pasar de un asistente al propio creador. La siguiente persona necesita entender qué se observó antes de decidir si responde, busca más contexto o aplica la política de la cuenta.
Conserva juntas las selecciones de cada persona. Si alguien elige ambas opciones, mantén ese par como parte de su evaluación. Si dos personas eligen opciones distintas, conserva sus respuestas por separado. Un caso puede contener más de una lectura sin transformarlas en una evaluación que nadie hizo.
Añade después una breve explicación del pasaje relevante. En tu propio proceso, identifica qué parece una cita, a quién parece dirigirse el texto y qué respuesta cercana ayuda a entender el intercambio. Deja visible la incertidumbre cuando falte contexto. Son sugerencias prácticas; el conjunto de datos no puso a prueba su efecto sobre las decisiones.
Una nota breve puede bastar. El objetivo es que la siguiente persona pueda seguir el razonamiento sin rehacer toda la revisión. Cuando un equipo pasa casos entre turnos o entre una marca y un creador, eso implica entregar la observación original además de la categoría que se le asignó.
Un ejemplo ficticio con los mismos totales de etiquetas
Piensa en dos grupos ficticios de 10 personas que evalúan un fragmento inventado. Los grupos sirven para explicar el cálculo; no son personas, citas ni casos reales del conjunto de datos. Ambos resúmenes muestran una selección de cita o relato y otra de ataque al destinatario.[8]
En el primer grupo, el revisor A elige ambas opciones. Las otras 9 personas no eligen ninguna de estas dos. Hay una persona cuya respuesta contiene el par. Al entregar el caso, se puede conservar esa evaluación conjunta y dejar la acción final para una decisión aparte.
En el segundo grupo, el revisor A elige cita o relato y el revisor B, ataque al destinatario. Los otros 8 no eligen ninguna opción. Los totales siguen siendo uno y uno, pero nadie eligió las dos. Presentarlo como la evaluación conjunta de una persona añadiría una relación que no aparece en las respuestas individuales.
El ejemplo también explica por qué contamos fragmentos en vez de sumar a todas las personas coincidentes. Si dos personas del primer grupo hubieran elegido ambas etiquetas, el fragmento seguiría entrando una sola vez en el grupo con selección conjunta. Su clasificación pregunta si existía ese par, no cuántas personas lo aportaron.
Para el segundo grupo, una breve entrega ficticia podría decir: «La decisión sigue abierta. El revisor A identificó una cita o relato; el revisor B, lenguaje dirigido al destinatario. Conserva ambas notas con el fragmento y la respuesta anterior. La persona responsable de la cuenta comprobará qué pasaje señalaba cada uno antes de elegir la acción». La nota transmite una pregunta sin resolver sin convertir las respuestas de dos personas en la conclusión de una sola.
En una entrega real, conserva por separado las dos notas del segundo grupo. La siguiente persona puede leerlas junto al texto, preguntar qué quiso decir cada revisor y decidir según la política de la cuenta. El estudio no determina si alguno tenía razón ni qué acción debería aplicarse al caso ficticio.
Los mismos totales pueden proceder de evaluaciones diferentes
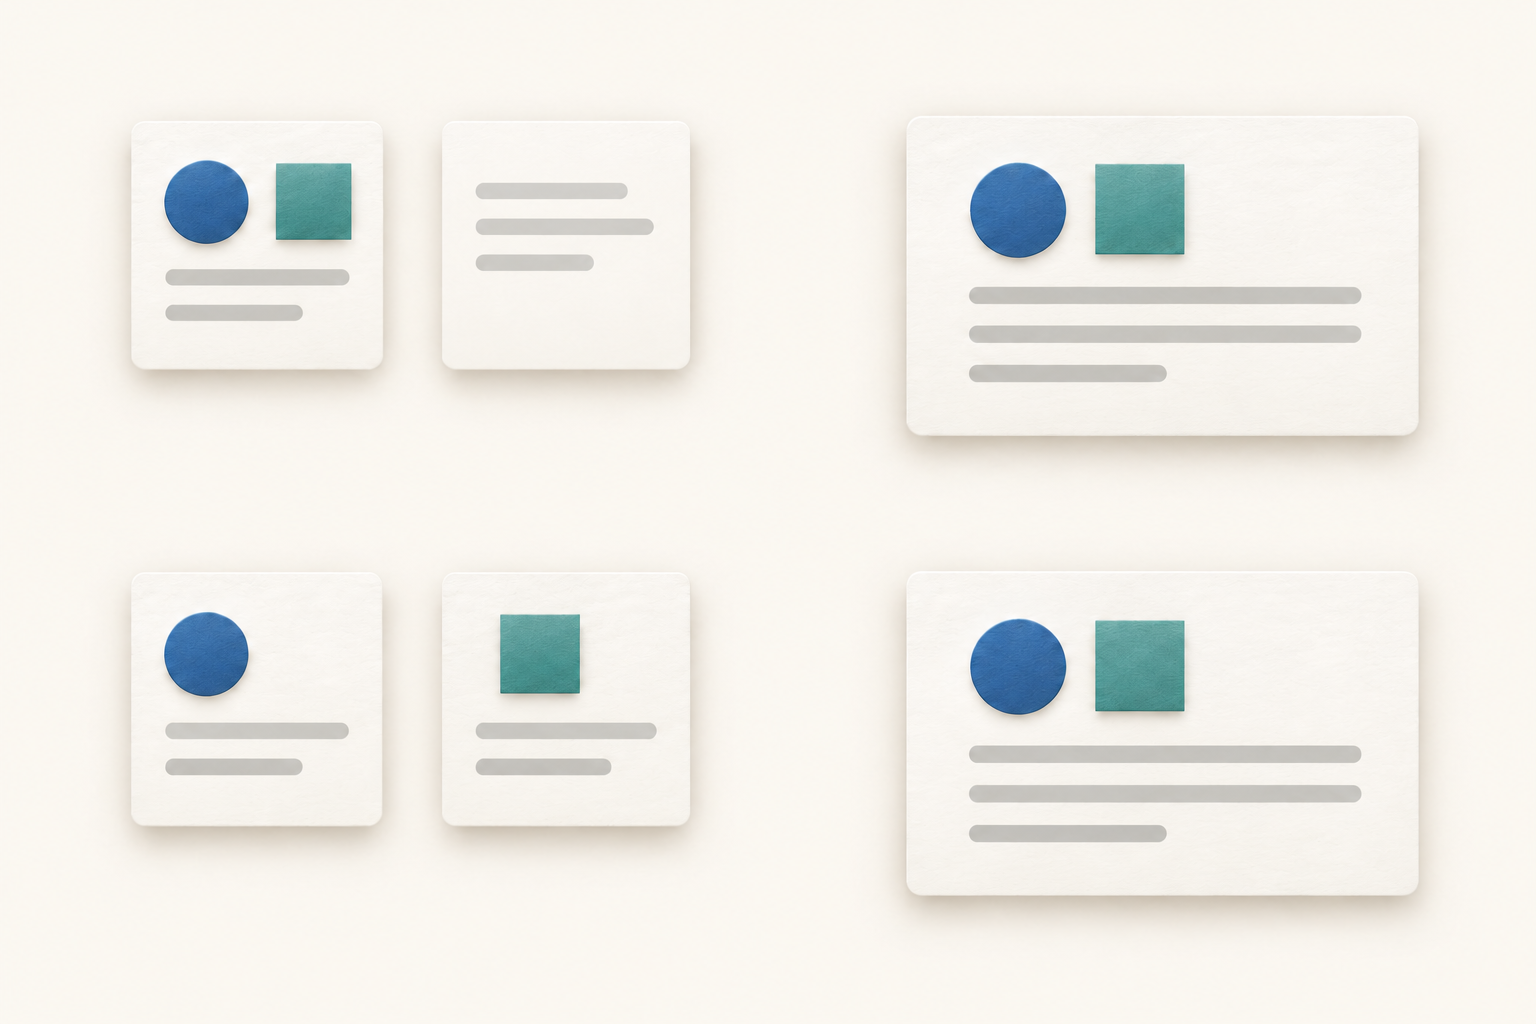
Una persona elige ambas
En el primer grupo ficticio, una persona elige las dos etiquetas y otras 9 no eligen ninguna de estas dos opciones.
Dos personas eligen una cada una
En el segundo, una persona elige cita o relato y otra, ataque dirigido al destinatario. Las otras 8 no eligen ninguna opción.
Separa la descripción de la decisión sobre la política
Describir lo que aparece en un comentario y decidir qué hacer con él son tareas distintas. Alguien puede detectar lenguaje citado mientras la persona responsable de la cuenta aún necesita revisar el intercambio y la política aplicable. Mantén esos pasos separados para que otra persona pueda ver cómo se llegó a la decisión.
Si una empresa trabaja con un creador, conviene acordar quién decide antes de que llegue una conversación difícil. Quien entiende una queja sobre el producto quizá no tenga autoridad para cambiar el enfoque de moderación de la cuenta. Una entrega clara puede identificar ambos papeles sin asumir que todos los casos necesitan varios revisores.
Si trabajas como creador sin ayuda, puedes mantener esa distinción en una sola nota: qué observaste, qué contexto comprobaste y qué decidiste. Una persona puede realizar varios pasos y dejar claro para qué sirve cada uno. Los datos no demuestran que añadir personal o una nueva revisión mejore los resultados.
Conserva las observaciones por separado hasta entender su relación. Las selecciones distintas pueden reflejar focos de atención diferentes, no versiones contradictorias. Una etiqueta de cita o relato no supone una exención automática, y una de ataque al destinatario no es una recomendación medida para borrar el comentario. La siguiente acción debe apoyarse en el intercambio real y en las normas de la cuenta, no en una acción deducida de nuestros porcentajes históricos.
Una ficha de revisión de comentarios que puedes copiar
Copia estos campos en tu documento de revisión o de entrega de casos. Usa solo la información que necesite el equipo, con un acceso adecuado a la conversación. La ficha está disponible aquí sin registrarte; es una orientación práctica, no un proceso observado en el estudio.[8]
Caso: [Enlace o referencia interna.] Cuenta/canal: [Dónde aparece el intercambio.] Momento de la comprobación: [Fecha y hora.] Mantén una referencia estable para que la siguiente persona encuentre el mismo material.
Objetivo: [¿Qué pregunta requiere una decisión?] Responsable: [¿Quién decidirá?] Siguiente persona: [¿Quién necesita recibir el caso, si procede?]
Texto presentado: [El pasaje revisado, guardado en el espacio aprobado.] Contexto: [Respuestas anteriores o posteriores relevantes.] Contexto que falta: [Lo que no se pudo comprobar.]
Revisor: [Nombre o referencia interna de la persona.] Momento de la evaluación: [Fecha y hora.] Conserva una entrada separada por persona, aunque varias usen las mismas etiquetas.
Observación de cita o relato: [Sí, no o no está claro.] Fundamento: [¿Qué pasaje parece citar o relatar un ataque de otra persona?] No utilices este campo para decidir que el texto es inofensivo.
Observación de ataque al destinatario: [Sí, no o no está claro.] Fundamento: [¿Qué pasaje parece dirigirse al destinatario y por qué?] Mantén esta respuesta independiente de la observación de cita o relato.
Otras observaciones relevantes: [Cualquier otra cuestión que deba considerarse según la política de la cuenta.] La ausencia de una de las dos etiquetas del estudio no describe por completo el intercambio.
Relación entre evaluaciones: [Una persona eligió ambas, distintas personas eligieron opciones diferentes o no está claro.] Si difieren, conserva sus notas individuales antes de resumir el caso.
Referencia de la política: [La norma u orientación aplicable.] Decisión: [La acción elegida o la pregunta pendiente.] Motivo: [¿Cómo respaldan esa decisión las observaciones y el contexto?]
Seguimiento: [¿Quién hace qué después, si procede?] Momento de la entrega: [¿Cuándo pasa el caso a esa persona?] Resultado: [¿Qué ocurrió tras la decisión, si se comprobó?] No marques como realizada una acción que solo está prevista.
Revisar de nuevo cuando: [Un hecho concreto o una pieza de contexto que falta, si hace falta otra revisión.] La ficha no exige revisar todos los casos repetidamente; utiliza un motivo adecuado a la situación.
Al excluir 2016 se mantuvieron los mismos 155 fragmentos
Definimos dos comprobaciones adicionales antes de calcular las selecciones conjuntas. La primera excluyó los fragmentos fechados en 2016, porque el intervalo de los archivos publicados superaba los periodos descritos en la presentación de la fuente y en el artículo original. Quedaron 13.809 fragmentos elegibles de la muestra aleatoria. Los mismos 155 tenían ambas etiquetas, con el mismo reparto de 98/57.[5]
La otra comprobación utilizó el material del conjunto de datos muestreado por separado en torno a bloqueos. Con la misma regla de exactamente 10 evaluaciones por fragmento, contenía 42.383 fragmentos. De los 2.457 con ambas etiquetas en alguna evaluación, 1.354 tenían una selección conjunta por la misma persona y 1.103 recibían las etiquetas solo de personas distintas: el 55,1 % y el 44,9 %, respectivamente.
El grupo enriquecido con casos próximos a bloqueos tiene otro propósito de muestreo, por eso lo mantuvimos separado. Sus porcentajes no sustituyen el resultado principal ni aportan pruebas sobre comentarios actuales de marcas. La comprobación por año aborda el intervalo de fechas indicado; ninguna de las dos elimina la necesidad de interpretar los datos como evaluaciones subjetivas de fragmentos históricos seleccionados.
Qué mostraron las dos comprobaciones previstas
Cada fila utiliza exactamente 10 evaluaciones completas por fragmento. La muestra enriquecida con bloqueos tiene otro propósito. Excluir 2016 aborda una diferencia entre los años de los archivos y las descripciones de la fuente.
| Comparación definida de antemano | Fragmentos elegibles | Fragmentos con ambas etiquetas en alguna evaluación | Con ambas por una misma persona | Solo por personas distintas | Porcentaje de casos con ambas etiquetas aportadas solo por personas distintas |
|---|---|---|---|---|---|
| Muestra aleatoria, exactamente 10 evaluaciones | 13.824 | 155 | 98 | 57 | 36,8 % |
| Muestra enriquecida con bloqueos, por separado | 42.383 | 2457 | 1354 | 1103 | 44,9 % |
| Muestra aleatoria sin 2016 | 13.809 | 155 | 98 | 57 | 36,8 % |
Cómo relacionamos las etiquetas con cada evaluación individual
Utilizamos la versión 6 de Wikipedia Talk Labels: Personal Attacks, un conjunto público del proyecto Wikipedia Detox. Los archivos publicados contienen texto derivado de modificaciones históricas de páginas de discusión y varias evaluaciones de colaboradores para cada fragmento. Este análisis usó las respuestas individuales; no creó evaluaciones nuevas ni examinó el rendimiento de un sistema de moderación.[1][2]
La comparación principal partió del grupo de muestreo aleatorio y conservó fragmentos con exactamente 10 evaluaciones completas de personas distintas. Mantener el número en 10 daba a cada fragmento el mismo número de oportunidades de recibir una selección conjunta. También supuso seleccionar 13.824 de los 37.492 fragmentos aleatorios publicados, por lo que el resultado no describe todo ese grupo.[3]
Cada fragmento seleccionado aportó un caso al recuento. Comprobamos si aparecía alguna de las etiquetas y después si ambas figuraban en la respuesta de una misma persona para ese fragmento. Las cinco categorías son excluyentes y suman 13.824. El denominador de 155 procede de las dos categorías con ambas etiquetas, no del total de evaluaciones ni de todos los fragmentos de origen.[4]
Antes de estudiar las selecciones conjuntas, fijamos los grupos de muestreo, la regla sobre el número de evaluaciones, la comprobación por año y un mínimo de 100 fragmentos para la comparación principal entre casos con ambas etiquetas. Los 155 observados cumplían ese requisito. No exigimos un porcentaje concreto, no cambiamos la regla para favorecer un resultado ni mezclamos el material enriquecido con bloqueos con el grupo aleatorio.
La investigación original ya utilizaba evaluaciones individuales, y trabajos posteriores agregaron cada categoría de ataque por mayoría. Nuestra contribución, más concreta, es esta comparación descriptiva de quién aportó las dos opciones dentro de un número fijo de evaluaciones. No corrige los métodos de esos estudios. La descarga incluye resultados agregados, métodos e instrucciones para reproducir el análisis con los archivos públicos de origen disponibles por separado.[6][7]
Haz que la siguiente revisión sea más fácil de seguir
La pregunta útil al entregar una revisión de moderación en redes sociales es quién hizo cada observación y qué estaba describiendo. En esta comparación histórica seleccionada, en 57 de los 155 fragmentos con ambas etiquetas nadie había elegido las dos. Esa relación se perdería en un resumen que contuviera solo los nombres de las etiquetas.
Mantén conectadas las observaciones de la persona, el contexto relevante y la decisión final. Así, una empresa o un creador puede explicar qué contiene el caso y por qué procede la acción elegida, sin pedirle a una etiqueta que sustituya toda la revisión.
- Descargar todos los resultados mostrados (CSV)
- Descargar resultados, métodos y ficha de revisión (ZIP)
Sin necesidad de registrarte. El paquete incluye resultados agregados anónimos, métodos, instrucciones para reproducir el análisis y una ficha reutilizable. No contiene texto original de las conversaciones, identificadores de modificaciones o colaboradores ni datos demográficos. Los archivos públicos originales están disponibles por separado en la versión enlazada.
Fuentes y notas
- Fuente: Wikipedia Talk Labels: Personal Attacks, versión 6 de Figshare, DOI 10.6084/m9.figshare.4054689.v6, publicada en febrero de 2017 bajo CC0. Utilizamos attack_annotated_comments.tsv (archivo 7554634) y attack_annotations.tsv (archivo 7554637), con comprobaciones MD5 del proveedor y SHA-256 calculadas de forma independiente. Influence IQ finalizó la selección, los cálculos y la interpretación el 25 de octubre de 2026 (UTC). El estudio no recogió comentarios nuevos, no creó anotaciones nuevas ni midió una plataforma social en directo.
- El proveedor define quoting_attack como la percepción de un colaborador de que el texto cita o relata un ataque de otro comentario, y recipient_attack como un ataque dirigido al destinatario. La interfaz permitía varias selecciones. El ataque general es una respuesta de origen independiente; este análisis no lo reconstruye mediante un OR de los subtipos. El texto publicado concatena añadidos de una modificación; no es un resumen de edición y no tiene por qué corresponder a un mensaje completo ni a una conversación entera. Los espacios de discusión, los grupos de muestreo y las divisiones de entrenamiento, desarrollo y prueba conservan sus significados documentados.
- Los archivos completos contenían 115.864 fragmentos únicos, 1.365.217 pares únicos de modificación y colaborador, y 4.053 colaboradores. La validación estructural no encontró pares duplicados, uniones sin correspondencia, filas mal formadas ni valores ausentes o no válidos en los indicadores. Se exigieron exactamente 10 evaluaciones completas de personas distintas en las 5 variables de origen, ambos espacios de discusión documentados y todas las divisiones del modelo, con un recuento de igual peso por fragmento. El grupo aleatorio principal conservó 13.824 de 37.492 fragmentos. El grupo enriquecido con bloqueos, seleccionado por separado, conservó 42.383 de 78.372. Una misma persona podía evaluar fragmentos distintos; no se fusionaron textos idénticos, no se eliminaron casos por coherencia entre indicadores ni se recodificó el ataque general.
- Q indica cualquier selección de cita o relato, y R cualquier selección de ataque al destinatario para un fragmento elegible. La presencia de ambas exige al menos una Q y una R entre las 10 evaluaciones. La selección conjunta exige además Q y R en una misma respuesta de modificación y colaborador; la categoría de personas distintas no contiene tal respuesta. El denominador principal es 98 + 57 = 155; las fracciones exactas 98/155 y 57/155 se muestran como 63,2 % y 36,8 %. Los porcentajes utilizan aritmética racional exacta y redondeo de mitades hacia arriba a 1 decimal. Antes de calcular las selecciones, exigimos al menos 100 fragmentos con ambas etiquetas para la comparación principal, sin un umbral de porcentaje favorable. No se calculó un intervalo de confianza poblacional, una prueba de significación, una afirmación de independencia ni una estimación de exactitud.
- La comprobación de sensibilidad enriquecida con bloqueos, definida de antemano, utilizó la misma regla de exactamente 10 evaluaciones y se mantuvo separada del grupo aleatorio principal. Sus cinco recuentos fueron 20.911 sin ninguna de estas dos etiquetas, 959 con etiqueta de cita o relato y sin etiqueta de ataque al destinatario, 18.056 con etiqueta de ataque al destinatario y sin etiqueta de cita o relato, 1.354 con ambas por una misma persona y 1.103 con ambas solo por personas distintas; total de 42.383 y denominador de 2.457. Excluir 2016 del grupo aleatorio dejó 13.809 fragmentos, con recuentos de 12.012 / 406 / 1.236 / 98 / 57 en ese mismo orden. No cambiaron los 155 fragmentos con ambas etiquetas ni el reparto de 98/57. Son comprobaciones descriptivas, no réplicas poblacionales independientes ni pruebas de que los grupos de muestreo sean comparables.
- El estudio Ex Machina: Personal Attacks Seen at Scale de Wulczyn, Thain y Dixon, de 2017, estableció el trabajo original de colaboración y modelización. El artículo WAC de Cécillon y sus colegas, de 2020, conservó una matriz de colaboradores por variable y agregó cada categoría de ataque por mayoría. Son métodos ya existentes, no errores demostrados por este estudio. Nuestra comparación usa la presencia de etiquetas en cualquiera de 10 evaluaciones y su coincidencia en una misma respuesta, no el rendimiento de etiquetas mayoritarias. Influence IQ cuenta si las dos opciones fueron aportadas por una misma persona o solo por personas distintas dentro de cada fragmento seleccionado.
- La presentación de la fuente describe 2001–2015 y el artículo original, 2004–2015; los archivos de la versión 6 verificada contienen años de 2001–2016. El esquema del proveedor indica 0/1 para la sesión iniciada, mientras el archivo usa False/True; los indicadores binarios son las cadenas 0.0/1.0. Conservamos estas diferencias entre lo documentado y lo observado sin atribuirles una causa. El lector acepta los valores literales publicados, sin redondear ni convertir los indicadores. El paquete documenta las versiones, las reglas de selección y los pasos para reproducir el análisis con los archivos públicos.
- Los dos grupos de 10 personas, las respuestas de los revisores A/B y las decisiones de entrega son ejemplos didácticos ficticios. No contienen texto original ni identificadores del conjunto de datos. Ambos grupos inventados tienen una selección de cita o relato y otra de ataque al destinatario, pero solo el primero tiene ambas en una misma persona. La ficha y las ilustraciones conceptuales son explicaciones prácticas, no procesos observados, políticas de moderación probadas ni garantías de mejores decisiones.
Todas las versiones se traducen directamente del original en inglés. Cada una describe el mismo conjunto histórico de Wikipedia en inglés y la misma selección de evaluaciones. La traducción no genera resultados de un mercado local. Influence IQ es responsable del análisis, la interpretación y las traducciones.