Mål varigheden af den oversatte voiceover, før du låser klipningen
En engelsk oplæsning kan passe til en scene, mens en oversat optagelse varer længere end scenen. Vores parvise analyse af 200 tekstforlæg fra et forskningskorpus viser, hvorfor varigheden af voiceover på flere sprog skal med i overleveringen, før billedsiden fastlægges.
En beskrivende analyse af optagelsesvarigheder ifølge metadata for 200 oversatte tekstforlæg, der findes i alle 10 FLEURS-testkonfigurationer, fra en afgrænsning på 350 engelske tekstforlæg. Det er oplæsningstekster til forskning, ikke kommercielle voiceoveropgaver. Metadata blev indhentet den 24. oktober 2026 (UTC).
Resumé
Bør en virksomhed låse en oversat video til varigheden af dens engelske voiceover? Mål først de oversatte oplæsninger. Vi sammenlignede optagelsesvarigheder ifølge metadata for 200 tekstforlæg, der var tilgængelige i alle 10 valgte FLEURS-testkonfigurationer. Hvert tekstforlæg fik samme vægt, efter at gentagne oplæsninger var samlet til en median for det enkelte tekstforlæg. Medianen af de parvise ændringer i forhold til engelsk spændte fra −6,1 % for nederlandske optagelser til +82,4 % for optagelser på filipino; ingen af tallene er et generelt tidstillæg til produktion på sproget.[1][2]
Et fast eksempel på 15 sekunder gør overleveringen konkret. Af 186 tekstforlæg, hvor den engelske median holdt sig inden for tidsrammen, overskred 110 medianer på filipino den. Med en strengere regel holdt alle observerede engelske optagelser sig inden for tidsrammen for 178 tekstforlæg, mens alle observerede optagelser på filipino overskred den for 72. Forskellige oplæsere, kønssammensætning, oversættelse og pauser er stadig sammenfiltrede. Bidraget er en efterprøvelig sammenligning af optagelsesvarigheder, hvor alle 9 målsprogssammenligninger og ét eksempel blev valgt før resultaterne om varighed, så teams kan bede om en oplæsning med målt varighed, før klipningen fastlægges.
Klipperen har en kort produktvideo klar. Den engelske fortællerstemme passer, produktet vises på det tilsigtede billede, og det afsluttende klip har plads til tilbuddet. Et oversat manuskript ankommer med det samme budskab. Det er fristende at se optagelsen som det sidste element, der bare skal lægges ind på en allerede færdig tidslinje.
Her kan en manglende oplysning blive et produktionsproblem: Ingen har målt varigheden af den oversatte oplæsning. Et manuskript, der er godkendt med hensyn til betydningen, fortæller ikke klipperen, hvor lang tid den indtalte version vil tage. En nyttig overlevering omfatter både den godkendte ordlyd og optagelsens varighed.
Vi undersøgte forskellen i FLEURS, et forskningskorpus med oversatte oplæsningstekster. På tværs af 200 matchende tekstforlæg varierede forholdet mellem optagelsesvarighederne både mellem konfigurationer og mellem oplæsninger af samme tekst. Tabellerne nedenfor bevarer forskellene. De giver en virksomhed eller indholdsskaber grund til at bede om dokumentation for varigheden i den konkrete produktion uden at gøre et sammenfattende forskningstal til en lovet tidsmargin.
Giv hver optaget version sin egen varighed
Sammenlign samme tekst, før du låner en tidsregel
Den første tabel sammenligner hver målkonfiguration med amerikansk engelsk for de samme 200 kildetekstforlæg. For hvert tekstforlæg og hver konfiguration tog vi medianen af de tilgængelige optagelsesvarigheder. Derefter dividerede vi medianen på målsproget med den engelske median og udtrykte forskellen fra 1 som en procentandel. Til sidst opsummerede vi de 200 parvise ændringer. Et tekstforlæg med 3 oplæsninger fik derfor samme vægt som et med 1.[2][4]
For optagelserne på latinamerikansk spansk var medianen af de parvise ændringer +24,8 %. Den midterste halvdel af ændringerne på tekstforlægsniveau gik fra +10,2 % til +47,0 %. For japansk var den tilsvarende median +36,6 %, med en midterste halvdel fra +17,8 % til +61,8 %. Det beskriver de frigivne optagelser af matchende tekster; det foreskriver ikke, hvordan nogen af sprogene bør fremføres.
Det adskiller sig fra at dividere 2 overordnede medianer for varighed. For de samme fælles tekstforlæg var medianen af de engelske opsummeringer pr. tekstforlæg 9,3 sekunder, og den spanske pendant var 11,6 sekunder. At dividere de viste tal ville ikke genskabe det parvise resultat på +24,8 %. Vi matchede først hver tekst, så sammenligningen holder en kort tekst på målsproget ved siden af dens egen engelske reference frem for en anden tekst nær fordelingens midte.
Nederlandske optagelser havde en median for parvis ændring på −6,1 %, mens optagelser på filipino havde +82,4 %. Ved at bevare begge i tabellen bliver spændet i de observerede forhold synligt. Det forhindrer også artiklen i at antyde, at alle oversatte optagelser var længere. I det fælles sæt var 71 nederlandske medianer pr. tekstforlæg længere end de engelske, 2 var ens, og resten var kortere.
Rækkerne følger den faste konfigurationsrækkefølge fra analysen frem for at være sorteret efter resultatet. Læs den række, der er relevant for din kildesammenligning, og bevar derefter forskningskonteksten. Latinamerikansk spansk og filipino er datasættets kildeafgrænsninger; at udgive artiklen på et andet sprog gør ikke optagelserne til dokumentation om det marked.
Parvis ændring i optagelsesvarighed i forhold til amerikansk engelsk
De samme 200 oversatte kildetekstforlæg i hver række. For hvert tekstforlæg divideres medianvarigheden på målsproget med den engelske median; ændringen fra 1 udtrykkes i procent. Q25 og Q75 afgrænser den midterste halvdel af de parvise ændringer.
| Konfiguration på målsproget | Median for relativ ændring (%) | Ændring ved den 25. percentil (%) | Ændring ved den 75. percentil (%) |
|---|---|---|---|
| Latinamerikansk spansk | 24,8 % | 10,2 % | 47,0 % |
| Fransk (Frankrig) | 5,7 % | -10,0 % | 29,1 % |
| Tysk (Tyskland) | 31,4 % | 0,0 % | 62,4 % |
| Nederlandsk (Nederlandene) | -6,1 % | -21,6 % | 8,9 % |
| Indonesisk (Indonesien) | 26,3 % | 11,4 % | 49,9 % |
| Malajisk (Malaysia) | 11,3 % | -1,2 % | 29,1 % |
| Filipino (Filippinerne) | 82,4 % | 54,2 % | 120,1 % |
| Thai (Thailand) | 20,8 % | 1,6 % | 42,0 % |
| Japansk (Japan) | 36,6 % | 17,8 % | 61,8 % |
Spredningen betyder noget, når opgaven har én fast tidsramme
En median samler 200 forhold i ét tal. En bestemt scene skal stadig rumme en bestemt oplæsning. Kvartilerne ved siden af hver median viser, hvorfor et oplæg, der kun tager den midterste værdi med, ville udelade oplysninger, der er relevante for beslutningen.
Franske optagelser havde en median for parvis ændring på +5,7 %, men den midterste halvdel gik fra −10,0 % til +29,1 %. Bag den beskedne forskel i midten lå optagelser, der var både kortere og længere end de engelske. Tyske optagelser havde en medianændring på +31,4 %, med en midterste halvdel fra cirka 0,0 % til +62,4 %. En vist værdi på 0,0 % er afrundet; den uafrundede nedre kvartil var svagt positiv.
Intervallerne beskriver den midterste halvdel af de observerede parvise ændringer. De er ikke konfidensintervaller, minimums- og maksimumsgrænser eller et interval, der vil rumme en fremtidig kommerciel optagelse. De underliggende tekster, oversættelser og fremførelser adskiller sig fra et nyt produktmanuskript. Selv en nøjagtig kopi af tabellens medianprocent ville efterlade produktionsteamet uden den konkrete optagelse, der skal klippes.
Forskellen ændrer spørgsmålet på en praktisk måde. I stedet for at spørge, hvor meget ekstra tid et sprog altid kræver, kan en producer spørge, om den godkendte oversatte oplæsning passer til den tilsigtede scene. Tabellen forklarer, hvorfor kontrollen er nyttig; optagelsen til opgaven giver svaret.
Én tekst kan komme med flere optagelsesvarigheder
Kildetekstforlæg 1662 blev valgt som det laveste ID, der var tilgængeligt i alle 10 konfigurationer, før vi opsummerede varighederne. Tabellen omfatter alle tilgængelige oplæsninger af tekstforlægget. Vi ledte ikke efter et dramatisk eksempel, efter at vi havde set varighederne, og tekstforlæggets ord eller lyd gengives ikke her.[3][4]
De 2 engelske filer var cirka 8,4 og 11,2 sekunder lange og gav en median på 9,8 sekunder. De 3 tyske filer spændte fra 10,4 til 23,5 sekunder med en median på 10,5. De 2 filer på filipino spændte fra 22,3 til 24,9 sekunder med en median på 23,6. Det er hele filers varigheder ifølge kildens metadata, afrundet til 1 decimal i visningen.
Medianen af 2 oplæsninger kan være et aritmetisk midtpunkt frem for varigheden af en fil, nogen faktisk har optaget. Den engelske visning på 9,8 sekunder er sådan en opsummering. En klipper, der vælger en optagelse, skal stadig arbejde med den valgte fils egen varighed. Antallet af optagelser og spændet fra minimum til maksimum gør forskellen synlig ved siden af medianen.
Den tyske spredning advarer også mod at tilskrive hvert sekund oversættelsens længde. Vi har ingen ID’er for oplæserne og lyttede ikke til optagelserne eller adskilte tale fra pauser. Fremførelse, oplæsere og optageforhold kan ikke skilles ad her. Eksemplet støtter en enkel produktionsanmodning: Send den tilsigtede optagelse eller en oplæsning med målt varighed af den tilsigtede ordlyd frem for kun et estimat for sproget.
Tekstforlæg 1662: bevar spændet mellem optagelserne ved siden af medianen
Det laveste kilde-ID med optagelser i alle 10 konfigurationer, valgt ud fra tilgængelighed før opsummeringerne af varighed. Alle tilgængelige optagelser er med. Sekunder beskriver komplette filer i kildens metadata uden adskillelse af pauser.
| Konfiguration for optagelserne | Tilgængelige optagelser | Korteste fil (sekunder) | Median af filvarigheder (sekunder) | Længste fil (sekunder) |
|---|---|---|---|---|
| Amerikansk engelsk | 2 | 8,4 | 9,8 | 11,2 |
| Latinamerikansk spansk | 3 | 8,8 | 9,5 | 9,5 |
| Fransk (Frankrig) | 2 | 6,4 | 6,8 | 7,1 |
| Tysk (Tyskland) | 3 | 10,4 | 10,5 | 23,5 |
| Nederlandsk (Nederlandene) | 1 | 7,9 | 7,9 | 7,9 |
| Indonesisk (Indonesien) | 1 | 11,6 | 11,6 | 11,6 |
| Malajisk (Malaysia) | 2 | 8,0 | 8,6 | 9,1 |
| Filipino (Filippinerne) | 2 | 22,3 | 23,6 | 24,9 |
| Thai (Thailand) | 3 | 6,5 | 8,7 | 10,1 |
| Japansk (Japan) | 2 | 12,1 | 13,3 | 14,6 |
Et eksempel på 15 sekunder kræver sin nævner
Vi fastlagde 15 sekunder som et planlægningseksempel, før vi beregnede resultaterne. Det er ikke et platformskrav, en anbefalet annoncelængde eller et sikkert tidstillæg til produktionen. Spørgsmålet var, om en opsummering af en engelsk optagelses varighed kunne holde sig inden for tidsrammen, mens den tilsvarende opsummering på målsproget overskred den.
Af de 200 fælles tekstforlæg havde 186 en engelsk median på højst 15 sekunder. Inden for den gruppe overskred medianen på målsproget 15 sekunder for 20 tekstforlæg på latinamerikansk spansk, 39 på tysk, 9 på nederlandsk, 110 på filipino og 37 på japansk. Hvert antal har samme nævner på 186; de øvrige sammenligninger er bevaret i downloaden.[6]
Vi brugte også en strengere regel for de observerede optagelser. Hver tilgængelig engelsk oplæsning skulle holde sig inden for 15 sekunder, og hver tilgængelig oplæsning på målsproget skulle overskride grænsen. Der var 178 engelske tekstforlæg, som opfyldte kravet. Det skete for 11 tekstforlæg på spansk, 9 på tysk, 4 på nederlandsk, 72 på filipino og 14 på japansk. Antallene vedrører kun de frigivne optagelser, ikke enhver mulig fremførelse af teksten.
Den strengere kontrol undgår at bygge på et aritmetisk midtpunkt, som ingen har optaget. Den viser stadig ikke, at en tekst ikke kan læses hurtigere, klippes anderledes eller omskrives på en passende måde. For et team er den nyttige forskel mellem dokumentation for, at en bestemt leveret optagelse passer, og en antagelse om, at en anden version vil passe, fordi den engelske gjorde.
En fiktiv lancering viser, hvor overleveringen hører til
Forestil dig et opdigtet lille brand for køkkenudstyr, der bestiller en produktvideo på 15 sekunder fra en indholdsskaber. Konceptet rummer en demonstration, et tilbud og et afsluttende produktbillede. Den engelske oplæsning tager 11 sekunder. Et oversat udkast godkendes med hensyn til betydningen, men den tiltænkte fortællers første oplæsning tager 17 sekunder. Brandet, manuskriptet, tiderne og opgaven i eksemplet er fiktive; de er ikke observationer fra FLEURS.
Hvis indholdsskaberen allerede har låst hvert klip til den engelske oplæsning, tvinger filen på 17 sekunder en beslutning frem sent i klipningen. Den kundeansvarlige kan undgå at lade valget være underforstået ved at bede om en oplæsning med målt varighed, mens den oversatte ordlyd stadig gennemgås. Oplægget bør angive det budskab, der skal forblive korrekt, den tilgængelige scenetid, og hvem der kan godkende en ændring af hver af delene.
Svaret behøver ikke automatisk at være at få fortælleren til at tale hurtigere. Oversætteren kan foreslå en kortere, naturlig formulering, der bevarer tilbuddet. Klipperen kan give demonstrationen mere tid, flytte en sekundær oplysning til den ledsagende tekst eller lave en separat klipning, hvis det aftalte format tillader det. Det er produktionsmuligheder, der kan diskuteres, ikke forbedringer fastslået af vores korpusanalyse.
En nyttig overlevering til den fiktive opgave kunne lyde: ”Ønsket version: __. Godkendt manuskript: __. Valgt optagelse: __ sekunder, målt ud fra den leverede fil. Tid afsat til scenen: __ sekunder. Tilbuddets ordlyd og påkrævede oplysninger: __. Person, der godkender manuskriptændringer: __. Person, der godkender klipningen: __.” Felterne tilhører det faktiske team; forskningstabellen kan ikke udfylde dem.
Med flere målversioner kan den kundeansvarlige beholde én række pr. valgt optagelse frem for at markere hele projektet som ”oversættelse godkendt”. Godkendelse af ordlyd og godkendelse af varighed besvarer forskellige spørgsmål. Hvis oversætteren ændrer en produktpåstand efter prøveoplæsningen, bør rækken angive ændringen, før indholdsskaberen genbruger den tidligere varighed. Det er et forslag til at organisere den fiktive opgave, ikke en afprøvet reduktion af projektrisikoen.
Når en revideret optagelse er leveret, kan indholdsskaberen gennemgå den komplette version med den, der er ansvarlig for sprog og betydning. Hvis man kun vurderer, om varigheden passer, kan man overse en akavet fremførelse eller et ulæseligt slutbillede. Analysen målte hverken kvalitet eller publikumsreaktion. Dens bidrag til den fiktive opgave er tidligere viden om optagelsens varighed, mens de mennesker, der laver videoen, fortsat har ansvaret for det kreative valg.
Hold ordlyd, optagelse og billedside samlet under hele gennemgangen
Når voiceover på flere sprog skal tidsmåles, er det nyttige dokument kort nok til at følge arbejdet. Det angiver den godkendte manuskriptversion, den valgte optagelse og scenens tidsramme. Hvis noget ændrer sig, kan den næste modtager af overleveringen se, hvilken dokumentation for varigheden der stadig gælder.
En prøveoplæsning med målt varighed kan afdække en konflikt, mens teamet stadig har valgmuligheder. Den skal fortsat være mærket som en prøveoplæsning frem for at blive behandlet som bevis for, at den endelige fortæller vil levere samme varighed. Når den valgte optagelse kommer, skal du erstatte antagelsen med dens målte varighed og gennemgå den i den faktiske klipning.
Bevar den oversatte version intakt under gennemgangen. Den, der kontrollerer betydningen, skal høre fremførelsen sammen med billedsiden, mens klipperen skal se, om pauser, produktvisninger og slutbilledet fungerer sammen. At en fil holder sig inden for en varighed, er én oplysning; det er ikke en godkendelse af alt i versionen.
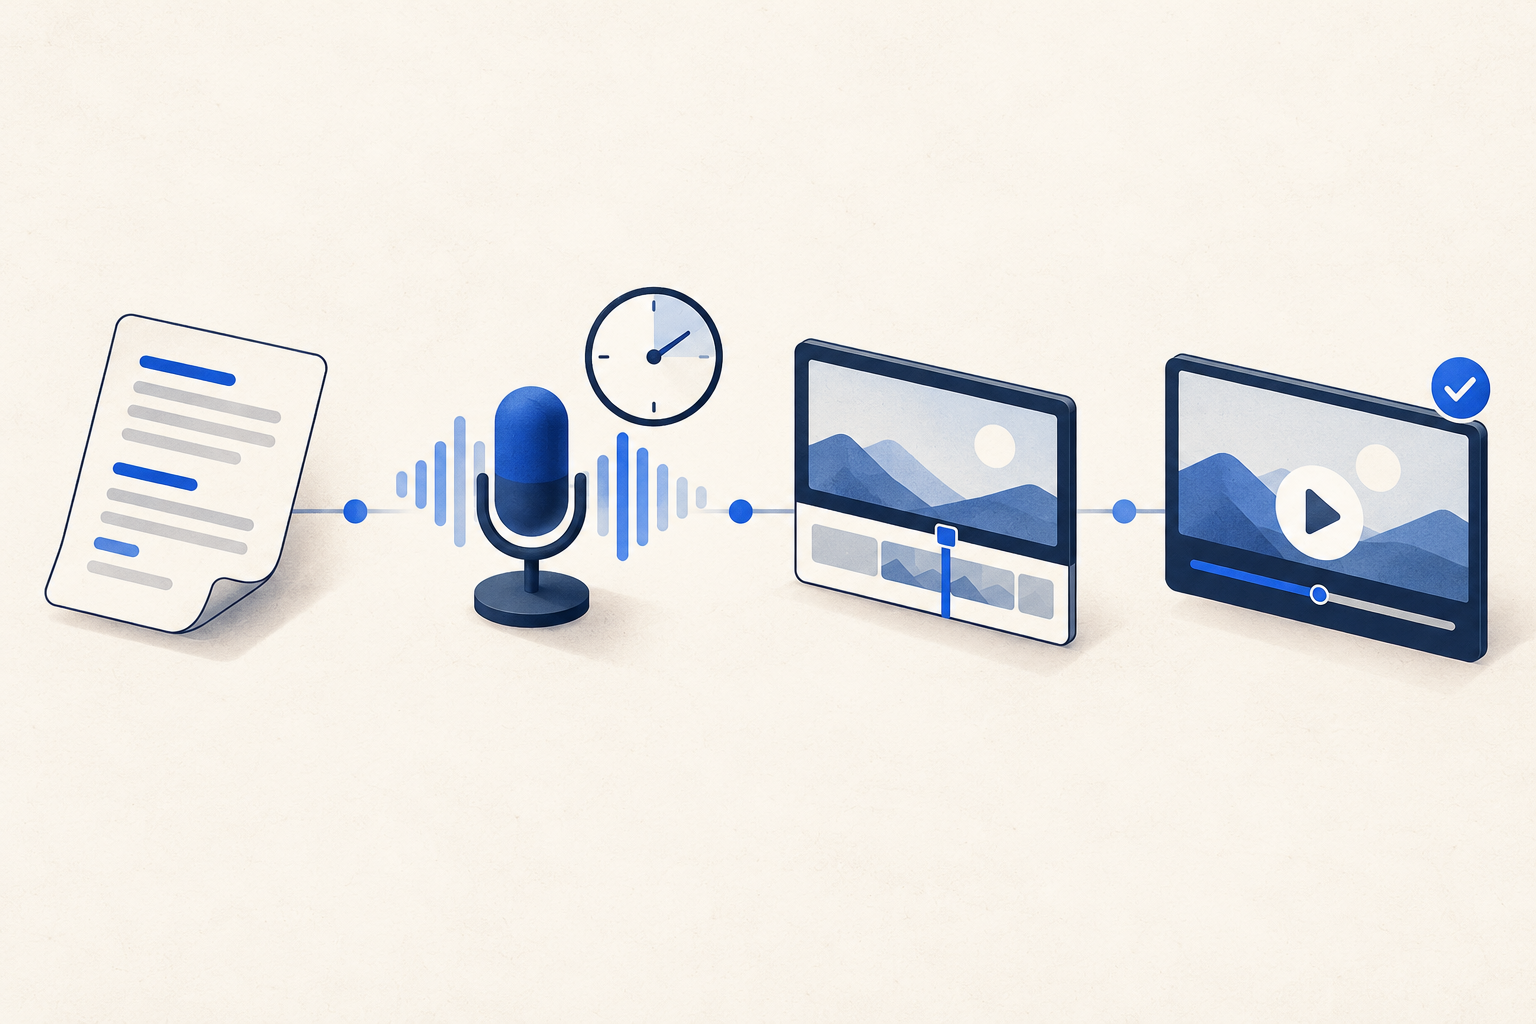
De 4 trin nedenfor er et forslag til overlevering, ikke en arbejdsgang afprøvet i FLEURS. De anvender analysens skelnen mellem ordlyd og optaget varighed på en produktionsbeslutning. De lover hverken rækkevidde, fastholdelse, konverteringer eller et bestemt antal ændringsrunder i et projekt.
Lad optagelsens varighed følge med gennem 4 overleveringer
Aftal ordlyden
Angiv målversionen, det godkendte manuskript og den, der gennemgår betydningen.
Tag tid på den valgte oplæsning
Vedlæg optagelsens målte varighed; mærk en prøveoplæsning som foreløbig.
Aftal tilpasningen
Aftal eventuelle ændringer i manuskript eller scene, før klipningen fastlægges.
Gennemgå hele versionen
Kontrollér den valgte optagelse sammen med billedsiden, tilbuddet og slutbilledet.
Bevar det matchede sæt synligt, når du genbruger et tal
Den fælles sammenligning omfatter 200 af de 350 engelske testtekstforlæg. De resterende 150 manglede mindst én af de valgte konfigurationer. Fuld tilgængelighed kan være selektiv, så det fælles sæt bør ikke beskrives som en tilfældig stikprøve af manuskripter, sprog eller voiceoveropgaver.
Vi gentog hver sammenligning mellem engelsk og målsprog med alle tilgængelige matchende par. Nævnerne gik fra 251 for nederlandsk til 349 for filipino og thai. Vi gentog også sammenligningerne i det fælles sæt med kun de tekstforlæg, der havde mindst 2 engelske oplæsninger og 2 oplæsninger på målsproget; delmængderne gik fra 66 til 166 tekstforlæg. Alle 9 parvise resultater og deres nævnere er med i downloaden.[4]
Delmængderne med gentagne oplæsninger bevarede samme retning for medianen af den parvise ændring som hovedsammenligningen i hver konfiguration. Det er en nyttig kontrol af netop dette valg af opsummering. Det kontrollerer ikke for oplæserne og gør ikke de forskellige parvise stikprøver til sammenlignelige populationer. Gentagne optagelser svarer ikke til uafhængige deltagere.
De indhentede optagelser på tysk, nederlandsk, indonesisk, malajisk og filipino havde alle kønsmarkeringen ”mand”; optagelserne på thai havde alle markeringen ”kvinde”. Engelsk, spansk, fransk og japansk havde blandede markeringer. Uden ID’er for oplæserne kan analysen ikke skille konfiguration fra oplæsersammensætning, fremførelse, oversættelse eller hvilke optagelser der blev bevaret. Læs tabellen som en beskrivelse af disse optagelser, med begrænsningen ved siden af ethvert genbrugt tal.[7]
Sådan blev optagelsesvarighederne sammenlignet
FLEURS er et forskningskorpus fra 2022 med oversatte oplæsningstekster. Kildeudgiveren og dokumentationen til TensorFlow Datasets angiver et fælles kildetekst-ID på tværs af sprog og et metadatafelt for det samlede antal lydframes ved 16.000 Hz. Vi dividerede feltet med 16.000 for at få metadataoplyste sekunder for hele filer. Vi afkodede ikke lyd, kontrollerede ikke bølgeformernes længde og fjernede ikke stilhed.[1][2]
Vi indhentede de 10 testmetadatafiler ved den faste kilderevision, der er dokumenteret i noterne, den 24. oktober 2026 (UTC). De indeholder 7.528 optagelser på tværs af de tilgængelige tekstforlæg. Vi matchede efter kilde-ID’er, aldrig efter rækkernes placering. Det fælles sæt på 200 tekstforlæg, reglerne for 15 sekunder, kontrollen med gentagne oplæsninger og eksempel 1662 blev fastlagt, efter at tilgængeligheden var kendt, og før opsummeringerne af varighed blev beregnet.[3][4]
Indhentningsdatoen identificerer det kildeøjebliksbillede, vi brugte. Den gør ikke optagelser, der blev introduceret med et forskningskorpus fra 2022, til en undersøgelse af fortællere eller indholdsskabere i 2026. De offentlige data bevarer kilderevisionen, så en senere læser kan skelne en ny analyse af eksisterende materiale fra nyindsamlede fremførelser.
Et tidligere forsøg med udviklingsdelen af datasættet gav kun 91 fælles tekstforlæg, under grænsen på 100 tekstforlæg, og blev lagt til side. Indhentningen af testdata stoppede først ved en størrelsesgrænse for metadata på thai; en dokumenteret højere grænse gjorde det muligt at fuldføre den samme faste testafgrænsning. Det er oplyste ændringer i gennemførlighed og adgang, ikke dokumentation for en forhåndsregistreret analyse uden kendskab til resultaterne.
Alle parvise beregninger brugte nøjagtige antal frames og brøker. Kvartilerne bruger lineær interpolation ved positioner defineret af (n−1) × p. Tabellerne viser procentværdier og sekunder med 1 decimal, hvor halve værdier afrundes væk fra nul; antal optagelser forbliver heltal. De offentlige afledte data bevarer de nøjagtige opsummeringer pr. tekstforlæg, parvise resultater, følsomhedskontroller og begge definitioner af tidsrammen. Vi beregnede ingen populationskonfidensintervaller eller kausale effekter.[4]
Tidsbegrænsninger i dubbing er allerede et etableret forskningsemne.[5] Artiklen tilføjer en reproducerbar sammenligning af de frigivne filers varigheder for disse faste tekster samt de oplysninger, der kræves for at undersøge dækningen og de gentagne optagelser. Den støtter, at man beder om dokumentation for varigheden i en oversat produktion, før klipningen låses; den giver ikke en universel procentdel for ekstra tid.
- Download de 67 viste resultater (CSV)
- Download alle 350 tekstforlæg × 10 konfigurationer og opsummeringer af optagelser (CSV)
- Download alle 9 parvise sammenligninger, følsomhedskontroller og optællinger for tidsrammen (CSV)
- Download kilderne, metoden og reproduktionskoden (ZIP)
Kræver ingen tilmelding. Afledte data bevarer manglende kombinationer og de faktiske nævnere i sammenligningerne. Den fælles pakke indeholder metodedokumentation på engelsk, kildereferencer og reproduktionskode; hverken oprindelige transskriptioner eller lyd videredistribueres. Hver sprogudgave beskriver det samme faste korpus.[8]
Noter til analysen
- Conneau m.fl., FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech (2022), afsnit 2.1–2.3. Korpusset indeholder oversatte oplæsningstekster med op til 3 validerede optagelser pr. sætning, samplet ved 16 kHz. Indsamlingen og forskningsformålet fastslår ikke repræsentativitet for kommerciel voiceoverproduktion. Kildeteksterne stammer fra FLORES; de er ikke en stikprøve af reklamemanuskripter.
- TensorFlow Datasets, dokumentation af felterne i xtreme_s version 2 og den tilhørende parser. Kildetekst-ID’et er det samme på tværs af sprog og kan gentages mellem oplæsninger; num_samples angiver det samlede antal lydframes. Lydfeltets definition angiver 16.000 Hz. Parseren kopierer antal fra metadata frem for at kontrollere dem mod afkodede bølgeformer. Vores sekunder er varigheder for hele filer ifølge metadata, uden adskillelse af pauser og uden kontrol for oplæseridentitet.
- Google FLEURS-metadata, fast revision ab93cf03f9d0cd083c853fad065a6377067408aa, testdel, indhentet den 24. oktober 2026 (UTC). Konfigurationer: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th og ja_jp. Den linkede engelske TSV-fil er én af de 10 kildefiler; pakken registrerer hver præcis kilde-URL og SHA256. Spansk i kilden er latinamerikansk, og fil_ph er filipino.
- Influence IQ-beregninger: én median inden for hvert tekstforlæg pr. konfiguration; lige vægt til tekstforlæggene; parvist forhold mellem medianen på målsproget og den engelske median samt parvis forskel i sekunder. Hovedgrundlaget er de 200 tekstforlæg, der er fælles for alle 10 konfigurationer, ud af 350 engelske tekstforlæg. Sekundære sammenligninger bruger alle tilgængelige par mellem engelsk og målsprog og fælles tekstforlæg med mindst 2 optagelser på hver side. Metoden og valget af eksempel blev fastlagt før opsummeringerne af varighed, efter at tilgængeligheden var kendt. Nøjagtige brøker, interpolation, afrunding og alle nævnere er dokumenteret i reproduktionspakken.
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing (2023). Tidligere arbejde undersøger allerede varighed i professionel dubbing udført af mennesker. Vores bidrag er den afgrænsede tabel over parvise filvarigheder i FLEURS og dens genbrugelige fortolkning til produktionsoverlevering, ikke opdagelsen af tidsbegrænsninger i dubbing eller et benchmark for professionel dubbing.
- Tidsrammen på 15 sekunder blev fastlagt som et planlægningseksempel før resultaterne. Medianregel: 186 fælles tekstforlæg har en engelsk median ≤15 sekunder; optæl medianer på målsproget >15 sekunder. Regel for alle observerede optagelser: For 178 er hver engelsk optagelse ≤15 sekunder; optæl tekstforlæg, hvor hver observeret optagelse på målsproget er >15 sekunder. Hvis varigheden er lig med grænsen, holder den sig inden for tidsrammen. Antallene er beskrivende resultater for frigivne optagelser, ikke platformvejledning eller en påstand om enhver mulig oplæsning.
- De indhentede metadata har ingen ID’er for oplæserne. Optagelser på tysk, nederlandsk, indonesisk, malajisk og filipino har alle kønsmarkeringen ”mand”; optagelser på thai har alle markeringen ”kvinde”. Manglende konfigurationer fjerner 150 af 350 engelske tekstforlæg fra det fælles grundlag. Parvise kontroller og kontroller af gentagne oplæsninger beskriver forskellige afgrænsede delmængder og fjerner ikke sammenblanding af fremfører, køn, fremførelse, oversættelse eller hvilke optagelser der er bevaret. Der rapporteres ingen konfidensintervaller, rangordning af sproghastighed, kausal effekt eller kommerciel prognose.
- Kilde: Google FLEURS, stillet til rådighed under CC BY 4.0. Udvælgelse, beregninger, tabeller, redaktionel fortolkning og oversættelser er tilpasninger foretaget af Influence IQ; det indebærer ingen godkendelse fra datasættets forfattere. Den offentlige pakke videredistribuerer afledte numeriske opsummeringer og kode, ikke oprindelig lyd eller tekstforlæggenes ordlyd. Visningsafrunding ændrer ikke kildens nøjagtige antal eller den fælles optagelsespopulation.
Den engelske artikel er kilden til alle sprogversioner. Hver udgave rapporterer de samme faste FLEURS-testoptagelser og oversatte tekster; artiklens sprog skaber ikke dokumentation om et nyt marked. Influence IQ har ansvaret for analysen, fortolkningen og oversættelserne.