Mål podcastklip, før du normaliserer dem igen
I en undersøgelse af 72 klip gav kontrol af den eksisterende eksport og rettelse af 9 klip samme resultat i forhold til leveringsgrænserne som normalisering af alle 72. Det krævede blandt andet 9 ekstra eksporter.
Vi sammenlignede 72 faste klip fra 6 HPR-programmer udgivet den 8.–21. oktober 2026, efter at vi havde normaliseret hver hel episode i laboratoriet.
Resumé
Bør en indholdsskaber normalisere hvert podcastklip igen efter mastering af hele episoden? Vi sammenlignede 3 arbejdsgange på 72 faste klip på 15, 30 og 60 sekunder fra 6 udgivne HPR-programmer. Genbrug af episodens master gav 63 eksporter, der klart lå inden for vores grænser for loudness og true peak, 7 klip klart uden for grænserne og 2 grænsetilfælde.
Både normalisering af hvert udsnit og måling af eksisterende eksporter før selektiv rettelse gav 72 færdige filer inden for grænserne. Selektiv rettelse krævede 9 normaliseringer og 81 eksporter; normalisering hver gang krævede 72 normaliseringer og 72 eksporter. Ved selektiv rettelse var summen af medianerne for den forløbne behandlingstid i FFmpeg og ffprobe pr. tidsvindue 64,0 sekunder mod 108,6 sekunder ved normalisering hver gang. Denne afgrænsede test understøtter en beslutning om at beholde eller rette den færdige eksport; den estimerer ikke lytterreaktioner eller en redigeringsmedarbejders samlede produktionstid.
Du har færdiggjort en podcastepisode og lavet dens lydmaster. Nu har en kollega, der skal udgive materialet, brug for korte uddrag. Episodens loudness er allerede indstillet, men de nye filer indeholder kun en lille del af den. Skal hvert udsnit normaliseres igen, eller kan nogle eksporter beholde lyden fra masteren?
Vi testede beslutningen med 3 faktiske arbejdsgange: genbrug masteren, normaliser hvert udsnit, eller mål hver eksisterende eksport, og ret kun dem, der ikke klart opfyldte de valgte grænser. Sammenligningen omfattede de kontroller og erstatningseksporter, hver vej krævede, så en undgået normalisering talte ikke i sig selv som en besparelse.
De fleste eksporter i denne samling kunne beholdes. 9 skulle rettes efter den valgte regel. Kontrol først gav samme antal færdige filer inden for grænserne som normalisering hver gang, med færre normaliseringer, men flere eksporter. For en indholdsskaber eller lille virksomhed handler valget om, hvordan filerne forberedes og godkendes, før de gives videre.
En hel episode bliver til flere kortere filer
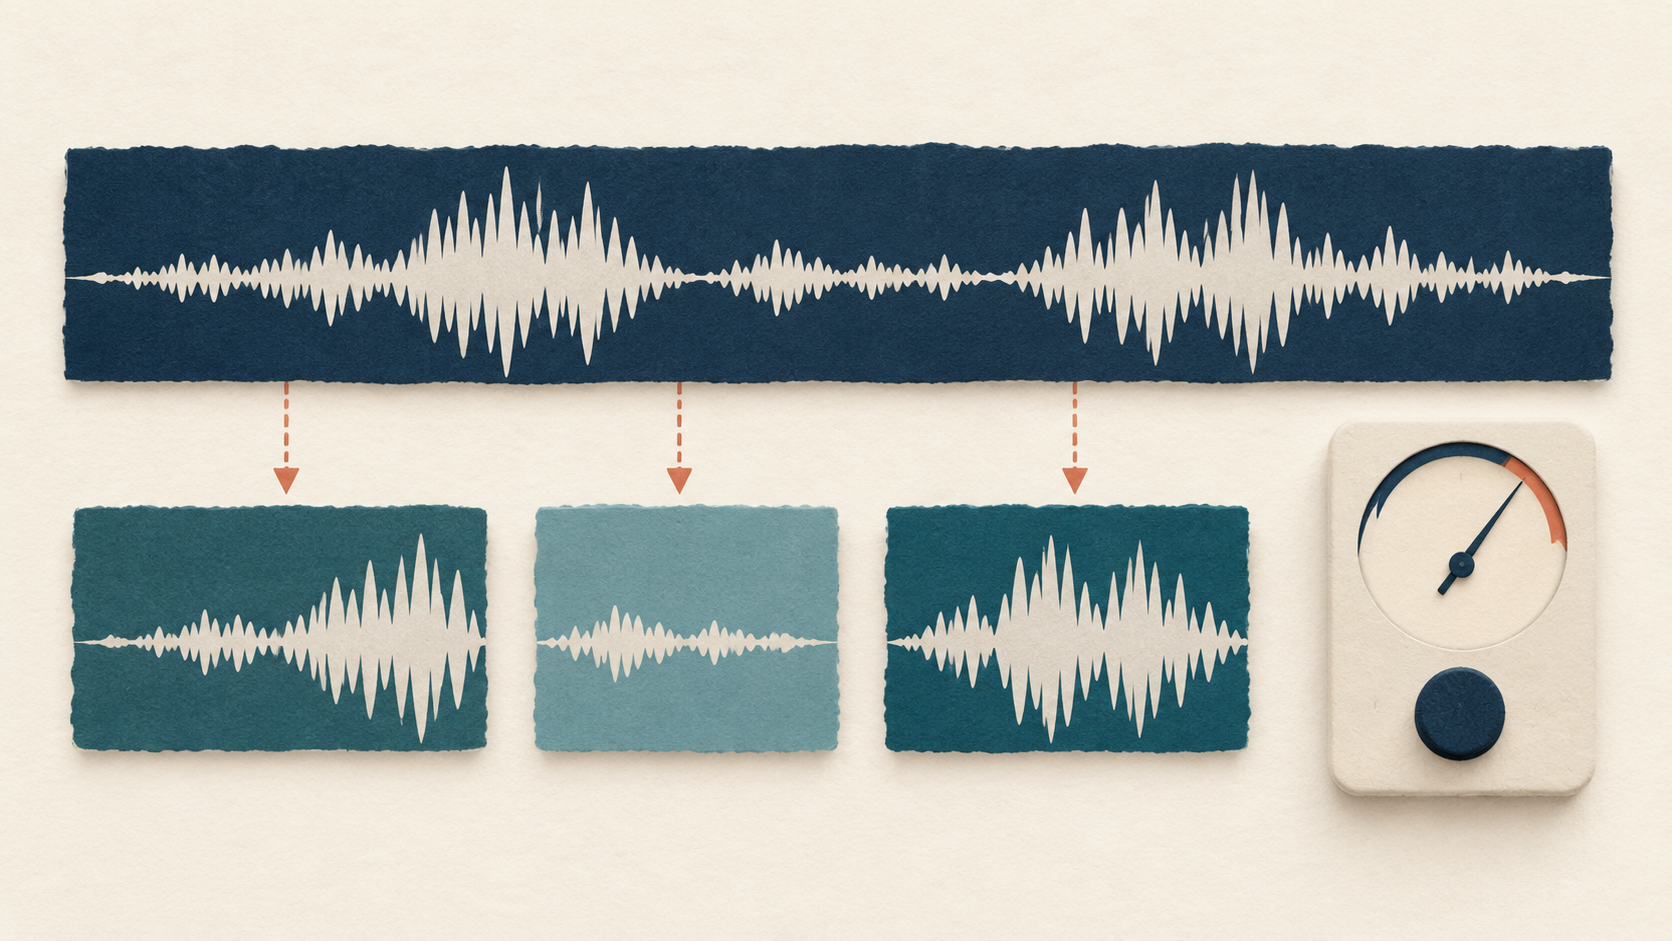
Beslutningen blev taget på den færdige eksport
En episode kan opfylde et samlet loudnessmål, selv om et kort uddrag ligger uden for det. Integreret loudness opsummerer lyden over det målte interval. Ændres intervallet, ændres også det, der opsummeres. En stille samtale, en kraftigere passage eller en pause kan fylde en anden andel af et kort klip end af hele episoden.
Vi brugte 2 leveringsmål. Integreret loudness, her angivet i LUFS, beskriver niveauet på tværs af klippet efter målerens regler for vægtning og gating. True peak estimerer spidser mellem digitale samples. At bestå 1 kontrol dokumenterer ikke, at den anden også bestås, og ingen af dem er en lyttevurdering af taletydelighed, støj eller redigeringskvalitet.
Vores reference var Apples podcastanbefaling: samlet loudness omkring −16 med en tolerance på ±1 og true peak på højst −1. Apple angiver loudnessanbefalingen i LKFS; vores FFmpeg-måler angiver LUFS. Vi testede et leveringsinterval fra −17 til −15 LUFS og et true peak-loft på −1 dBTP. Det er de valgte grænser for denne sammenligning, ikke et krav til alle sociale platforme.[3]
Processoren for hele episoden sigtede mod −16 LUFS og −1,5 dBTP. Derefter lavede vi de samme faste udsnit fra episodens master til alle 3 arbejdsgange. Hver færdig fil var stereo-AAC ved 192 kbps og 48 kHz i en M4A-container. Vi målte den afkodede eksport, så resultatet beskriver filen fra arbejdsgangen og ikke kun lyden, der gik ind i encoderen.
Arbejdsgangen med genbrug eksporterede og kontrollerede hvert udsnit. Arbejdsgangen med normalisering hver gang normaliserede hvert udsnit før eksport og kontrol. Arbejdsgangen med måling før rettelse begyndte med genbrugseksporten, beholdt den, når den bestod, og rettede den ellers. Alle 3 omfattede derfor en afsluttende leveringskontrol.
Det endelige leveringsresultat for de samme 72 tidsvinduer
Hver arbejdsgang brugte alle 72 faste tidsvinduer fra de samme episodemastere. Antallene beskriver særskilte tidsvinduer; tidsmålingsgentagelser er ikke ekstra klip.
| Arbejdsgang | Klart bestået | Klart ikke bestået | Grænsetilfælde |
|---|---|---|---|
| Genbrug masteren | 63 | 7 | 2 |
| Normaliser hvert udsnit | 72 | 0 | 0 |
| Mål, og ret derefter | 72 | 0 | 0 |
9 rettelser erstattede 72 normaliseringer
Af de 72 eksporter direkte fra episodernes mastere lå 63 klart inden for begge leveringsgrænser. Yderligere 7 lå klart uden for mindst 1 grænse. De sidste 2 lå for tæt på en grænse til, at målerens visningsopløsning kunne fastslå, om resultatet klart bestod eller ikke bestod. Vi holdt den 3. kategori synlig frem for at behandle filerne som bekræftet uden for grænserne.
Den selektive arbejdsgang rettede både de 7 klip, der klart lå uden for grænserne, og de 2 grænsetilfælde. Alle dens 72 færdige eksporter opfyldte den konservative regel for at bestå. Normalisering af hvert udsnit gav også 72 færdige eksporter, der opfyldte reglen. Forskellen var, hvor meget lyd hver arbejdsgang behandlede igen: 9 udsnit i den selektive arbejdsgang mod alle 72 ved normalisering hver gang.
Besparelsen medførte ekstra eksporter. Selektiv rettelse producerede først 72 filer og erstattede derefter 9 af dem, i alt 81 eksporter. Normalisering hver gang gav 72 eksporter. En indholdsskaber, der skal vælge, har brug for begge tal. Færre normaliseringer betyder ikke automatisk færre skrevne filer eller mindre samlet behandling.
Ved hver rettelse vendte vi tilbage til det oprindelige tabsfri udsnit fra episodens master. Vi målte udsnittet til normaliseringen, udførte anden gennemkørsel, eksporterede en ny AAC-fil og kontrollerede den. Vi normaliserede ikke en allerede AAC-kodet fil og brugte ikke dens målinger til at indstille forstærkningen på et andet PCM-input.
Kontrol først krævede stadig behandlingsarbejde
Den selektive arbejdsgang brugte mindre målt behandlingstid end normalisering af hvert klip, også med de ekstra eksporter og kontroller. Summerne af medianerne for forløben tid pr. tidsvindue var 52,3 sekunder ved genbrug, 108,6 sekunder ved normalisering hver gang og 64,0 sekunder ved måling før rettelse. CPU-tiden fulgte samme rækkefølge: henholdsvis 56,3, 120,1 og 69,3 sekunder.
Totalerne omfatter de nødvendige FFmpeg- og ffprobe-processer for hver arbejdsgang: eksport, læsning af filegenskaber, afkodning til kvalitetskontrol, scanning af PCM til normalisering og eventuel erstatningseksport. I den selektive arbejdsgang blev første eksport og kontrol medregnet, selv når filen senere skulle rettes. Anden eksport og kontrol blev også medregnet.
Hvert tidsvindue gennemløb hver arbejdsgang 3 gange med roteret kørselsrækkefølge. Vi tog medianen af behandlingstiden for hvert tidsvindue og lagde derefter de 72 medianer sammen. Tabellen viser derfor en sum af medianer pr. tidsvindue, ikke den forløbne tid for 1 observeret produktionskørsel. De 648 kørsler er tidsmålingsgentagelser af de samme 72 tidsvinduer på tværs af 3 arbejdsgange, ikke 648 forskellige klip.
Målingerne kom fra 1 Apple M4-computer med 1 arbejdsproces. De dækker behandling i FFmpeg og ffprobe, inklusive processtart. De udelader Python-hashning og -serialisering, den fælles forberedelse af hele episoders mastere og udsnit samt den tid, en person bruger på at vælge, gennemgå eller overdrage klip. De er ikke estimater af en redigeringsmedarbejders samlede arbejdstid.
Afgrænsningen påvirker det praktiske valg. Et team, hvis eksportsystem allerede måler færdige filer, kan bruge resultatet til at afgøre, hvilke udsnit der skal normaliseres igen. Et team, der skal åbne et særskilt værktøj og håndtere erstatningsfiler manuelt, kan stå med en anden afvejning. Vores behandlingstotaler prissætter ikke det manuelle arbejde og fastslår ikke, hvordan en anden medarbejder eller enhed vil præstere.
Selektiv rettelse brugte færre normaliseringer og flere eksporter
Faktiske operationer for 1 sæt med 72 tidsvinduer; tidskolonnerne summerer hvert tidsvindues median fra 3 kørsler på en Apple M4 med 1 arbejdsproces.
| Arbejdsgang | Normaliseringer | AAC-eksporter | Forløben behandlingstid i FFmpeg og ffprobe (sekunder) | CPU-tid til behandling i FFmpeg og ffprobe (sekunder) |
|---|---|---|---|---|
| Genbrug masteren | 0 | 72 | 52,3 | 56,3 |
| Normaliser hvert udsnit | 72 | 72 | 108,6 | 120,1 |
| Mål, og ret derefter | 9 | 81 | 64,0 | 69,3 |
Klippene på 15 sekunder krævede flere rettelser i denne samling
Hver varighed havde samme nævner: 24 tidsvinduer fra 4 positioner i hvert af 6 programmer. Genbrug bestod for 19 klip på 15 sekunder, 22 klip på 30 sekunder og 22 klip på 60 sekunder. Antallene sendt til rettelse var henholdsvis 5, 2 og 2.
Årsagen til rettelse var anderledes ved den længere varighed. Alle 5 tilfælde på 15 sekunder og begge tilfælde på 30 sekunder lå klart uden for de valgte grænser. De 2 resterende tilfælde på 60 sekunder var grænsetilfælde. At behandle dem som kandidater til rettelse var et valg af arbejdsgang, som blev taget før resultaterne, ikke dokumentation for, at begge klart lå uden for leveringsintervallet.
Klippene lå indlejret omkring de samme centre. Et udsnit på 15 sekunder lå inde i et udsnit på 30 sekunder, som lå inde i et udsnit på 60 sekunder. Det er indbyrdes forbundne uddrag af de samme programmer. Tabellen beskriver denne samling; den fastslår ikke en generel sandsynlighed for, at et podcastklip på 15 sekunder skal rettes.
Alle 9 rettelser var samlet i 2 programmer: 4 i HPR Beer Garden 22 - Bitter og 5 i murphs konferencepræsentation. De øvrige 4 programmer gav hver 12 genbrugsklip, der bestod. Den koncentration gør en samlet procent til et dårligt løfte for næste episode. Et team kan få en samling uden rettelser eller en med flere, selv med samme eksportindstillinger.
5 af de 24 korteste klip blev sendt til rettelse
Hver varighed omfatter 4 faste centre fra hvert af 6 programmer. Længere tidsvinduer omslutter de samme centre, så uddragene er indbyrdes forbundne.
| Klipvarighed | Testede tidsvinduer | Klart beståede genbrugsklip | Sendt til rettelse |
|---|---|---|---|
| 15 sekunder | 24 | 19 | 5 |
| 30 sekunder | 24 | 22 | 2 |
| 60 sekunder | 24 | 22 | 2 |
1 episode med en præsentation viser overdragelsen
Den udgivne episode ”murph gives a presentation talk about Hacker Public Radio at the OLF conference” gav 12 faste udsnit. HPR udgav den den 15. oktober 2026; siden beskriver en konferencepræsentation fra december 2025. Vi brugte hele den udgivne podcastfil inklusive dens branding og forberedte derefter masteren for hele episoden til testen.[6]
For de 12 udsnit gav genbrug 7 klare beståede resultater, 4 klip klart uden for grænserne og 1 grænsetilfælde. Efter den selektive regel blev de 7 filer, der bestod, beholdt. De øvrige 5 udsnit vendte tilbage til den tabsfri kilde til normalisering og en erstatningseksport. Den færdige leverance indeholdt 12 filer, der bestod kontrollen, efter 5 normaliseringer og 17 eksporter.
Normalisering hver gang af de samme 12 udsnit gav også 12 filer, der bestod, med 12 normaliseringer og 12 eksporter. Den selektive vej undgik derfor at behandle 7 udsnit igen, men gav 5 ekstra eksporter. Episoden er et konkret eksempel på afvejningen i resultaterne for hele samlingen uden at antage, at antallet af normaliseringer alene måler arbejdet.
For en indholdsskaber eller virksomhed, der giver filerne til en kollega til udgivelse, bør afslutningsnoten angive de 12 færdige filer, de anvendte leveringsgrænser, og hvilke 5 filer der erstattede en tidligere eksport. En mappe med både oprindelige og rettede versioner uden et klart valg af de færdige filer skaber et særskilt overdragelsesproblem, som loudnessmålingerne ikke kan løse.
Antallene vedrører vores laboratorieversioner af episoden. De er ikke en vurdering af oplægsholderen, den oprindelige produktion eller dens egnethed for lyttere. Vi valgte ikke udsnittene ud fra det, der blev sagt, eller hvordan de lød. Positionerne blev fastlagt, før nogen loudnessresultater blev målt.
Kontroller den fil, din kollega skal udgive
For en episode, der allerede er mastereret, er første beslutning leveringsspecifikationen for dens klip. Aftal loudnessinterval, spidsloft, filformat og den tilsigtede destination, før et bestået resultat fortolkes. Hvis en kunde eller platform bruger en anden specifikation, kan antallene ikke overføres uændret til den.
Beslut derefter, om den eksporterede fil skal beholdes eller rettes. I den testede selektive arbejdsgang kunne redigeringsmedarbejderen beholde enhver fil, der klart opfyldte begge grænser. Et resultat klart uden for grænserne eller for tæt på grænsen udløste rettelse fra det oprindelige tabsfri udsnit, efterfulgt af en erstatningseksport og ny kontrol. Reglen angiver, hvad der sker med et usikkert resultat, frem for at overlade det til et uforklaret grønt lys.
Den afsluttende kontrol hører til efter den sidste ændring, der påvirker den leverede lyd. En tilføjet introduktion, musik, fading eller en ny redigering giver en anden fil end den målte. Et resultat fra en tidligere version bør ikke følge med, som om det beskrev den senere eksport. Gem målingen sammen med den faktiske fil, der er valgt til levering.
Gør leveringsnoten konkret nok til, at næste person kan bruge den: den valgte fil, loudness- og spidsværdier, de anvendte grænser og den resulterende status. En note, der kun siger ”normaliseret”, angiver et behandlingstrin. Den fortæller ikke kollegaen, om den færdige kodede fil blev målt, eller om den opfyldte de aftalte grænser.
Valget mellem selektiv behandling og normalisering hver gang afhænger også af overdragelsen. Selektiv rettelse var nyttig her, fordi de fleste eksisterende eksporter kunne beholdes, og kun 9 skulle erstattes. Normalisering hver gang gav en enklere vej med 1 eksport for hvert udsnit. Begge nåede samme målte leveringsresultat i denne samling med forskellig tilrettelæggelse af behandlingen.
Et lille team kan vælge den vej, dets værktøjer understøtter godt. Resultaterne taler for at måle, før man beslutter, at hvert udsnit skal normaliseres igen. De dokumenterer ikke, at en person bør bruge flere minutter på filhåndtering for at spare få sekunders behandling i FFmpeg og ffprobe. Hold den målte tekniske afvejning adskilt fra det redaktionelle arbejde, der stadig skal udføres.
3 veje fra et episodeudsnit til en kontrolleret eksport
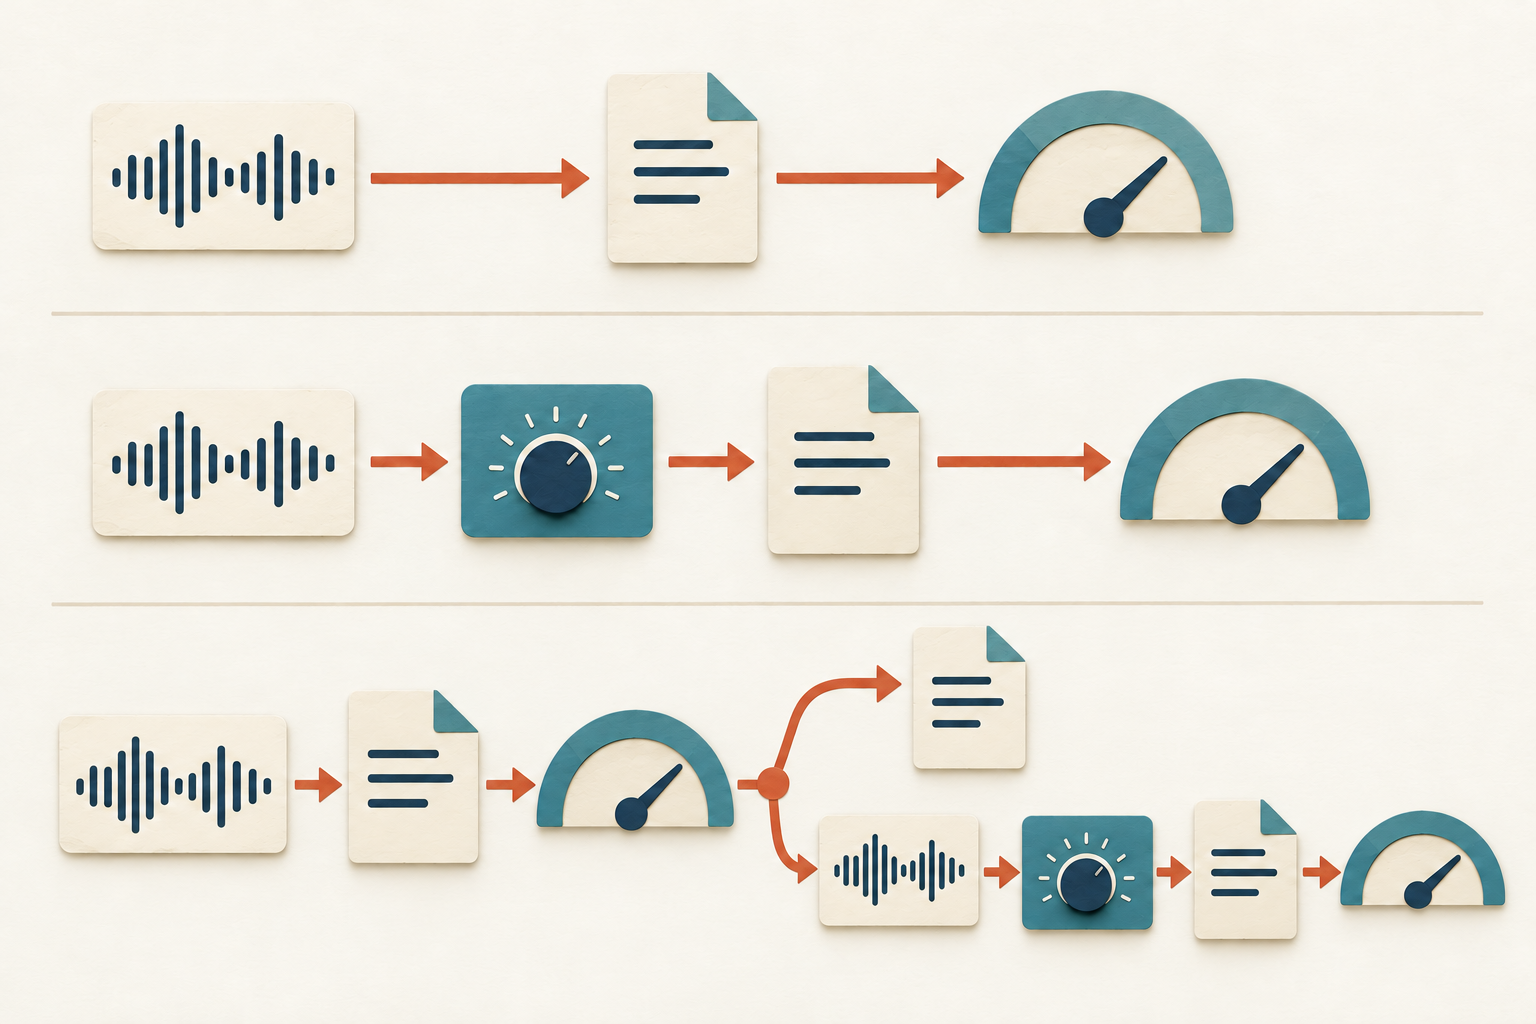
Genbrug masteren
Eksporter det oprindelige udsnit, og mål derefter den færdige fil.
Normaliser hvert udsnit
Mål PCM-udsnittet, normaliser og eksporter det, og kontroller den færdige fil.
Mål, og ret derefter
Kontroller den eksisterende eksport. Behold filer, der klart består kontrollen; vend i andre tilfælde tilbage til det oprindelige PCM-udsnit, normaliser, eksporter igen, og kontroller på ny.
Sådan blev de 72 klip sammenlignet
Vi udvalgte de 6 seneste komplette HPR-programmer udgivet strengt før den 23. oktober 2026, hvis varighed på producentens side var mellem 20 og 60 minutter. Udgivelsesdatoerne gik fra den 8. til den 21. oktober. Udvælgelseskriterierne blev fastlagt ud fra metadata før lydresultaterne. Vi beholdt de komplette udgivne filer med branding og registrerede deres faktiske afkodede varigheder særskilt fra sidernes varigheder.[1][2]
Dette er et casestudie af 1 teknologipodcast fra et fællesskab, ikke en repræsentativ stikprøve af podcasts eller indholdsskabere. 2 udvalgte programmer var på hinanden følgende Beer Garden-paneler med tilbagevendende deltagere. De udgivne kilder havde allerede gennemgået produktion, hvis detaljer vi ikke genskabte. Vores normalisering af hele episoder var et ekstra laboratorietrin, ikke en simulering af rå mikrofonoptagelser.
Vi forberedte hver hel episode med FFmpeg 8.1.2 og loudnorm i 2 gennemkørsler med mål på −16 LUFS og −1,5 dBTP og gemte derefter en 48 kHz stereo-PCM-master. LRA blev sat til 50, så standardindstillingen på 7 LU ikke ville pålægge det særskilte mål; loudness range var ikke et resultatmål for de korte klip. Den faktiske lineære eller dynamiske normaliseringstilstand blev bevaret i kørselsregistreringerne.[4]
For hvert program placerede vi klipcentrene ved præcis 20 %, 40 %, 60 % og 80 % af det afkodede antal samples. Ved hvert center skar vi indlejrede tidsvinduer på 15, 30 og 60 sekunder, i alt 12 tidsvinduer pr. program og 72 samlet. Alle arbejdsgange brugte de samme udsnit fra de samme mastere. Positionerne blev ikke valgt ud fra talere, indhold, stilhed eller målt loudness.
De endelige klassifikationer brugte FFmpegs ebur128-måler på den afkodede AAC-præsentation. Vi tog højde for AAC-priming og ekstra samples i slutningen, så hver måling dækkede det tilsigtede antal samples. Målerens afsluttende oversigt viser integreret loudness og true peak afrundet til 0,1. Vi tog højde for visningsafrundingen ved at behandle hver værdi som et interval, der strækker sig 0,05 i begge retninger; det er et tillæg for afrunding, ikke en påstand om målenøjagtighed.[5]
For at bestå skulle hele afrundingsintervallet for loudness ligge inden for −17 til −15 LUFS, og den øvre ende af spidsintervallet måtte højst være −1 dBTP. En fil bestod klart ikke, når resultatet tydeligt lå uden for mindst 1 grænse; resten blev klassificeret som grænsetilfælde og rettet i den selektive arbejdsgang. Den fælles download indeholder tekniske resultater pr. tidsvindue, definitioner af behandling, beregningskode og afstemning af målerne. Ingen kilde- eller afledt lyd videregives.[7]
- Download de viste resultater (CSV)
- Download tekniske resultater, definitioner og beregningskode (ZIP)
Ingen tilmelding nødvendig. Den fælles ZIP-fil indeholder tekniske målinger, den oprindelige beregningsvejledning på engelsk og oversatte forklaringer. Artikeltekst, figurlabels og CSV-filen med de viste resultater er tilgængelige på alle artiklens sprog. Pakken genskaber de rapporterede beregninger ud fra de medfølgende målinger frem for at genkøre hele lydbehandlingsforløbet. Ingen kilde- eller afledt lyd medfølger.
Kilder og noter
- Hacker Public Radios episodearkiv. Udvalgte programmer: hpr4753, HPR Beer Garden 22 - Bitter, Kevie, 21. oktober; hpr4749, murphs OLF-præsentation, murph, 15. oktober; hpr4748, Programmable Logic Controls - Episode 5, Whiskeyjack, 14. oktober; hpr4747, UNIX Curio #13 - Replacements for cat, Vance, 13. oktober; hpr4745, BruCON interview 1: The BruCON organization, Kristoff, 9. oktober; hpr4744, HPR Beer Garden 21 - Mild, Kevie, 8. oktober. Alle datoer er i 2026. Links til de enkelte episoder og filidentifikatorer indgår i analysepakken.
- Hacker Public Radios bidragspolitik. Producenten beskriver sine ændringer ved udgivelse, herunder formatkonvertering og automatisk introduktion/outro, og angiver Creative Commons Attribution-ShareAlike 4.0 for programmerne. Undersøgelsen analyserer komplette udgivne filer. Den videregiver hverken filerne eller afledte klip.
- Apple Podcasts for Creators, Audio requirements, Audio levels. Anbefaler samlet loudness omkring −16 dB LKFS med en tolerance på ±1 dB og true peak på højst −1 dB FS med forbehandling før kodning. Det er den podcastreference, der bruges her, ikke en universel leveringsspecifikation for sociale platforme.
- FFmpeg 8.1.2-filterdokumentation, loudnorm. Beskriver normalisering med 1 eller 2 gennemkørsler og lineær/dynamisk tilstand. Forsøget brugte FFmpeg 8.1.2 med de indstillinger og faktiske driftstilstande, der er bevaret i pakken.
- FFmpeg 8.1.2-kildekode for ebur128, formatering af den afsluttende oversigt. Integreret loudness og true peak vises med 1 decimal. Undersøgelsens konservative regel med 3 udfald håndterer denne visningspræcision; den er ikke en påstand om en certificeret målers nøjagtighed. De endelige leveringsklassifikationer er adskilt fra normaliseringsværktøjets egne input-/outputstatistikker.
- HPR-episode hpr4749, murph gives a presentation talk about Hacker Public Radio at the OLF conference. Vært: murph; udgivet den 15. oktober 2026. Kildesiden beskriver præsentationen som afholdt i december 2025. Episodetitlen og udgivelsesdatoen identificerer kilden og er ikke en vurdering af dens oprindelige lydproduktion.
- Influence IQs beregningspakke. Indeholder aggregerede tekniske målinger og målinger pr. tidsvindue, kildeangivelser, faste regler for udvælgelse og tidsvinduer, definitioner af behandlingstid i FFmpeg og ffprobe, beregningskode og afstemning af målerne. Den genskaber de rapporterede beregninger ud fra de medfølgende målinger; den er ikke en portabel pakke til at genkøre hele lydbehandlingsforløbet. Hverken rå eller afledt lyd, taletekst eller private driftsregistreringer medfølger.
Alle sprogudgaver beskriver det samme HPR-casestudie med 6 programmer. Oversættelse skaber ikke resultater for et andet land, en anden podcastpopulation eller en anden social platform.