Než uzavřete střih, změřte délku přeloženého mluveného komentáře
Anglické načtení se může vejít do scény, zatímco přeložená nahrávka přesáhne její délku. Naše párové srovnání 200 předloh z výzkumného korpusu ukazuje, proč při předání vícejazyčné produkce potřebujete znát délku komentáře ještě před uzavřením obrazové části.
Popisná analýza délek nahrávek uvedených v metadatech pro 200 přeložených předloh společných 10 testovacím konfiguracím FLEURS ze souboru 350 anglických předloh. Jde o texty načtené pro výzkum, nikoli o zakázky na mluvený komentář. Metadata získána 24. října 2026 (UTC).
Shrnutí
Má firma uzavřít lokalizované video podle délky anglického mluveného komentáře? Nejprve změřte přeložená načtení. Porovnali jsme délky nahrávek uvedené v metadatech pro 200 předloh dostupných ve všech 10 vybraných testovacích konfiguracích FLEURS. Každá předloha dostala stejnou váhu poté, co byla opakovaná načtení shrnuta mediánem v rámci předlohy. Medián párové změny oproti angličtině sahal od −6,1 % u nizozemských nahrávek po +82,4 % u filipínských. Ani jedna hodnota neurčuje produkční časovou rezervu pro celý jazyk.[1][2]
Konkrétní podobu předání ukazuje příklad s pevnou délkou 15 sekund. Ze 186 předloh, jejichž anglický medián se do tohoto času vešel, jej překročilo 110 filipínských mediánů. Při přísnějším pravidle se všechna pozorovaná anglická načtení vešla u 178 předloh, zatímco všechna pozorovaná filipínská načtení čas překročila u 72. Čtenáře, složení podle pohlaví, překlad a pauzy zde nelze oddělit. Přínosem je kontrolovatelné srovnání délek nahrávek se všemi 9 cílovými srovnáními a příkladem zvoleným před výsledky časování. Pomáhá týmům vyžádat si načtení se změřenou délkou před uzavřením střihu.
Střihač má připravené krátké produktové video. Anglický komentář se vejde, odhalení produktu vychází na zamýšlený snímek a v závěrečném záběru zbývá prostor pro nabídku. Přichází přeložený scénář se stejným sdělením. Svádí to k tomu považovat nahrávku za poslední položku, kterou stačí vložit do už hotové časové osy.
Právě zde se chybějící informace může změnit v produkční problém: nikdo nezměřil délku přeloženého načtení. Scénář schválený po významové stránce střihači neřekne, kolik času zabere jeho namluvení. Užitečné předání obsahuje schválené znění i změřenou délku nahrávky.
Toto rozlišení jsme zkoumali ve FLEURS, výzkumném korpusu přeložených načtených textů. U 200 odpovídajících si předloh se vztahy délek nahrávek lišily mezi konfiguracemi i mezi načteními stejného textu. Následující tabulky tyto rozdíly zachovávají. Dávají firmě nebo tvůrci důvod vyžádat si údaje o délce nahrávky pro skutečnou produkci, aniž by se výzkumný souhrnný údaj měnil ve slíbenou rezervu.
Změřte délku každé nahrané verze
Než převezmete pravidlo pro délku, porovnejte stejný text
První tabulka porovnává každou cílovou konfiguraci s americkou angličtinou pro stejných 200 zdrojových předloh. U každé předlohy a konfigurace jsme vzali medián dostupných délek nahrávek. Poté jsme cílový medián vydělili anglickým a rozdíl oproti 1 vyjádřili v procentech. Nakonec jsme shrnuli těchto 200 párových změn. Předloha se 3 načteními tak dostala stejnou váhu jako předloha s 1 načtením.[2][4]
U nahrávek v latinskoamerické španělštině činil medián párové změny +24,8 %. Prostřední polovina změn na úrovni předloh sahala od +10,2 % do +47,0 %. U japonštiny byl odpovídající medián +36,6 % a prostřední polovina sahala od +17,8 % do +61,8 %. Jde o popis zveřejněných nahrávek odpovídajících si textů. Neurčuje, jak má být kterýkoli z jazyků přednesen.
To se liší od vydělení 2 celkových mediánů délky. U stejných společných předloh činil medián anglických souhrnů po předlohách 9,3 sekundy a španělský protějšek 11,6 sekundy. Vydělení těchto zobrazených čísel by párový výsledek +24,8 % neobnovilo. Nejprve jsme spárovali jednotlivé texty, takže krátký cílový text zůstává vedle své vlastní anglické srovnávací předlohy, nikoli vedle jiného textu poblíž středu rozdělení.
Nizozemské nahrávky měly medián párové změny −6,1 %, filipínské +82,4 %. Zachování obou v tabulce ukazuje rozpětí pozorovaných vztahů. Článek tak zároveň nenaznačuje, že každá přeložená nahrávka byla delší. Ve společném souboru bylo 71 nizozemských mediánů předloh delších než anglické, 2 byly stejné a zbývající kratší.
Řádky zachovávají pevné pořadí konfigurací použité v analýze. Nejsou seřazeny podle výsledku. Přečtěte si řádek relevantní pro vaše srovnání se zdrojem a ponechte u něj výzkumný kontext. Latinskoamerická španělština a filipínština jsou vymezení zdrojových dat. Zveřejnění článku v jiném jazyce z těchto nahrávek nevytváří podklady o novém trhu.
Párová změna délky nahrávky oproti americké angličtině
V každém řádku je stejných 200 přeložených zdrojových předloh. Cílový medián délky každé předlohy se dělí jejím anglickým mediánem. Odchylka od 1 se vyjadřuje v procentech. Q25 a Q75 ohraničují prostřední polovinu těchto párových změn.
| Cílová konfigurace nahrávek | Medián relativní změny (%) | 25. percentil relativní změny (%) | 75. percentil relativní změny (%) |
|---|---|---|---|
| latinskoamerická španělština | 24,8 % | 10,2 % | 47,0 % |
| francouzština (Francie) | 5,7 % | -10,0 % | 29,1 % |
| němčina (Německo) | 31,4 % | 0,0 % | 62,4 % |
| nizozemština (Nizozemsko) | -6,1 % | -21,6 % | 8,9 % |
| indonéština (Indonésie) | 26,3 % | 11,4 % | 49,9 % |
| malajština (Malajsie) | 11,3 % | -1,2 % | 29,1 % |
| filipínština (Filipíny) | 82,4 % | 54,2 % | 120,1 % |
| thajština (Thajsko) | 20,8 % | 1,6 % | 42,0 % |
| japonština (Japonsko) | 36,6 % | 17,8 % | 61,8 % |
Při pevné délce zakázky záleží i na rozpětí
Medián shrnuje 200 vztahů do jednoho čísla. Konkrétní scéna však stále musí pojmout konkrétní načtení. Kvartily vedle každého mediánu ukazují, proč by převzetí samotné prostřední hodnoty do zadání zahodilo informace důležité pro toto rozhodnutí.
Francouzské nahrávky měly medián párové změny +5,7 %, ale prostřední polovina sahala od −10,0 % do +29,1 %. Malý středový rozdíl tak existoval vedle textů kratších i delších než anglické načtení. Německé nahrávky měly medián změny +31,4 % s prostřední polovinou přibližně od 0,0 % do +62,4 %. Zobrazených 0,0 % je zaokrouhlených. Nezaokrouhlený dolní kvartil byl mírně kladný.
Tato rozpětí popisují prostřední polovinu pozorovaných párových změn. Nejsou intervaly spolehlivosti, mezemi od minima po maximum ani rozpětím, do kterého se vejde budoucí komerční nahrávka. Výchozí texty, překlady i přednes se od nového produktového scénáře liší. I přesné převzetí procenta mediánu z tabulky by produkční tým ponechalo bez skutečné nahrávky, kterou potřebuje ke střihu.
Toto rozlišení prakticky mění otázku. Místo zjišťování, kolik času navíc jazyk vždy potřebuje, se producent může ptát, zda se schválené přeložené načtení vejde do zamýšlené scény. Tabulka vysvětluje smysl této kontroly. Odpověď dodá nahrávka pro danou zakázku.
Jeden text může mít několik nahrávek s různou délkou
Zdrojovou předlohu 1662 jsme zvolili jako nejnižší ID dostupné ve všech 10 konfiguracích, ještě před souhrnem délek. Tabulka zahrnuje každé dostupné načtení této předlohy. Po zjištění délek jsme nehledali výrazný příklad a slova ani zvuk této předlohy zde nereprodukujeme.[3][4]
2 anglické soubory měly délku přibližně 8,4 a 11,2 sekundy, tedy medián 9,8 sekundy. 3 německé soubory měly rozpětí od 10,4 do 23,5 sekundy s mediánem 10,5. 2 filipínské soubory sahaly od 22,3 do 24,9 sekundy s mediánem 23,6. Jde o délky celých souborů ze zdrojových metadat, pro zobrazení zaokrouhlené na 1 desetinné místo.
Medián 2 načtení může být aritmetickým středem, nikoli délkou souboru, který někdo skutečně nahrál. Zobrazených 9,8 sekundy u angličtiny je právě takovým souhrnem. Střihač vybírající nahrávku stále potřebuje pracovat s vlastní délkou zvoleného souboru. Počet načtení a rozpětí od minima po maximum toto rozlišení ukazují vedle mediánu.
Německé rozpětí také varuje před přisuzováním každé sekundy délce překladu. Nemáme ID mluvčích a nahrávky jsme neposlouchali ani jsme neoddělovali řeč od pauz. Přednes, čtenáře a podmínky nahrávání zde nelze rozlišit. Příklad podporuje jednoduchý produkční požadavek: poslat zamýšlenou nahrávku nebo načtení zamýšleného textu se změřenou délkou, nikoli jen odhad pro celý jazyk.
Předloha 1662: vedle mediánu zachovejte rozpětí načtení
Nejnižší zdrojové ID s nahrávkami ve všech 10 konfiguracích, vybrané podle dostupnosti před souhrny délek. Zahrnuta jsou všechna dostupná načtení. Sekundy popisují celé soubory ve zdrojových metadatech, bez oddělení pauz.
| Konfigurace nahrávek | Dostupné nahrávky | Nejkratší soubor (sekundy) | Medián délky souboru (sekundy) | Nejdelší soubor (sekundy) |
|---|---|---|---|---|
| americká angličtina | 2 | 8,4 | 9,8 | 11,2 |
| latinskoamerická španělština | 3 | 8,8 | 9,5 | 9,5 |
| francouzština (Francie) | 2 | 6,4 | 6,8 | 7,1 |
| němčina (Německo) | 3 | 10,4 | 10,5 | 23,5 |
| nizozemština (Nizozemsko) | 1 | 7,9 | 7,9 | 7,9 |
| indonéština (Indonésie) | 1 | 11,6 | 11,6 | 11,6 |
| malajština (Malajsie) | 2 | 8,0 | 8,6 | 9,1 |
| filipínština (Filipíny) | 2 | 22,3 | 23,6 | 24,9 |
| thajština (Thajsko) | 3 | 6,5 | 8,7 | 10,1 |
| japonština (Japonsko) | 2 | 12,1 | 13,3 | 14,6 |
K příkladu s 15 sekundami patří i jmenovatel
Před výpočtem výsledků jsme pro plánovací příklad pevně zvolili 15 sekund. Nejde o požadavek platformy, doporučenou délku reklamy ani bezpečnou produkční rezervu. Zkoumali jsme, zda se souhrn anglické nahrávky může do tohoto času vejít, zatímco odpovídající cílový souhrn jej překročí.
Ze 200 společných předloh mělo 186 anglický medián nejvýše 15 sekund. V této způsobilé skupině cílový medián překročil 15 sekund u 20 předloh v latinskoamerické španělštině, 39 v němčině, 9 v nizozemštině, 110 ve filipínštině a 37 v japonštině. Každý počet má stejný jmenovatel 186. Ostatní srovnání zůstávají v souboru ke stažení.[6]
Použili jsme také přísnější pravidlo pro pozorovaná načtení. Každé dostupné anglické načtení se muselo vejít do 15 sekund a každé dostupné cílové načtení muselo tento čas překročit. Způsobilých anglických předloh bylo 178. Situace nastala u 11 španělských předloh, 9 německých, 4 nizozemských, 72 filipínských a 14 japonských. Tyto počty se týkají pouze zveřejněných načtení, nikoli všech možných přednesů textu.
Přísnější kontrola se vyhýbá spoléhání na aritmetický střed, který nikdo nenahrál. Stále však neukazuje, že text nelze přečíst rychleji, jinak sestříhat nebo vhodně přepsat. Pro tým je užitečné rozlišit doklad, že se konkrétní dodaná nahrávka vejde, od předpokladu, že se jiná verze vejde jen proto, že se vešla angličtina.
Smyšlené uvedení produktu ukazuje, kam předání patří
Představme si smyšlenou malou značku kuchyňských potřeb, která si u tvůrce objedná produktové video o délce 15 sekund. Koncept zahrnuje ukázku, nabídku a závěrečný záběr produktu. Anglické načtení trvá 11 sekund. Přeložený návrh scénáře je schválený po významové stránce, ale první načtení zamýšleného mluvčího trvá 17 sekund. Značka, scénář, délky i zakázka v tomto příkladu jsou smyšlené. Nejde o pozorování z FLEURS.
Pokud tvůrce už pevně přizpůsobil každý záběr anglickému načtení, soubor o délce 17 sekund si vynutí rozhodnutí až v pozdní fázi střihu. Osoba odpovědná za klienta může tuto volbu vyjasnit tím, že si vyžádá načtení se změřenou délkou ještě během kontroly přeloženého znění. Zadání má určit sdělení, které musí zůstat přesné, dostupný čas scény a osobu, která může schválit změnu jednoho či druhého.
Řešením nemusí být automatické zrychlení přednesu. Překladatel může navrhnout kratší přirozenou formulaci, která zachová nabídku. Střihač může dát ukázce více času, přesunout vedlejší podrobnost do doprovodného textu nebo připravit samostatný střih, pokud to dohodnutý formát dovoluje. Jde o produkční možnosti k diskusi, nikoli o zlepšení doložená naší analýzou korpusu.
Užitečné předání této smyšlené zakázky může znít: „Cílová verze: __. Schválený scénář: __. Délka zamýšlené nahrávky v sekundách: __, změřena z dodaného souboru. Čas pro scénu v sekundách: __. Znění nabídky a povinné informace: __. Osoba schvalující změny scénáře: __. Osoba schvalující střih: __.“ Mezery patří skutečnému týmu. Výzkumná tabulka je nevyplní.
U několika cílových verzí může osoba odpovědná za klienta vést pro každou zamýšlenou nahrávku jeden řádek, místo aby celý projekt označila „překlad schválen“. Schválení znění a schválení délky odpovídají na různé otázky. Pokud překladatel po pracovním načtení změní tvrzení o produktu, má řádek tuto změnu označit dříve, než tvůrce znovu použije původní časový údaj. Jde o navržený způsob uspořádání smyšlené zakázky, nikoli o ověřené snížení rizika projektu.
Po dodání upravené nahrávky může tvůrce projít celou verzi s osobou odpovědnou za jazyk a význam. Posouzení pouze podle délky může přehlédnout nepřirozený přednes nebo nečitelný závěrečný snímek. Tato studie neměřila kvalitu ani reakci publika. Jejím přínosem pro smyšlenou zakázku je dřívější znalost délky nahrávky. Za tvůrčí volbu dál odpovídají lidé, kteří video připravují.
Při kontrole posuzujte znění, nahrávku a obraz společně
U vícejazyčného mluveného komentáře pomáhá stručný dokument, který si lidé předávají spolu s prací. Určuje schválenou verzi scénáře, zamýšlenou nahrávku a čas pro scénu. Když se něco z toho změní, příjemce dalšího předání vidí, které údaje o délce jsou stále platné.
Pracovní načtení se změřenou délkou může odhalit nesoulad, dokud má tým ještě možnosti řešení. Má zůstat označené jako pracovní načtení. Není důkazem, že konečný mluvčí dosáhne stejné délky. Po dodání zamýšlené nahrávky nahraďte předpoklad její změřenou délkou a zkontrolujte ji ve skutečném střihu.
Při této kontrole ponechte přeloženou verzi vcelku. Osoba kontrolující význam potřebuje slyšet přednes spolu s obrazem. Střihač potřebuje vidět, zda spolu fungují pauzy, odhalení produktu a závěrečný snímek. To, že se soubor vejde do daného času, je jedním podkladem. Není to schválení všeho v dané verzi.
Následující 4 kroky jsou návrhem předání, nikoli postupem ověřeným ve FLEURS. Přenášejí rozlišení mezi zněním a délkou nahrávky ze studie do produkčního rozhodnutí. Neslibují dosah, udržení pozornosti, konverze ani počet úprav, které bude projekt potřebovat.
Údaj o délce nahrávky zachovejte při 4 předáních
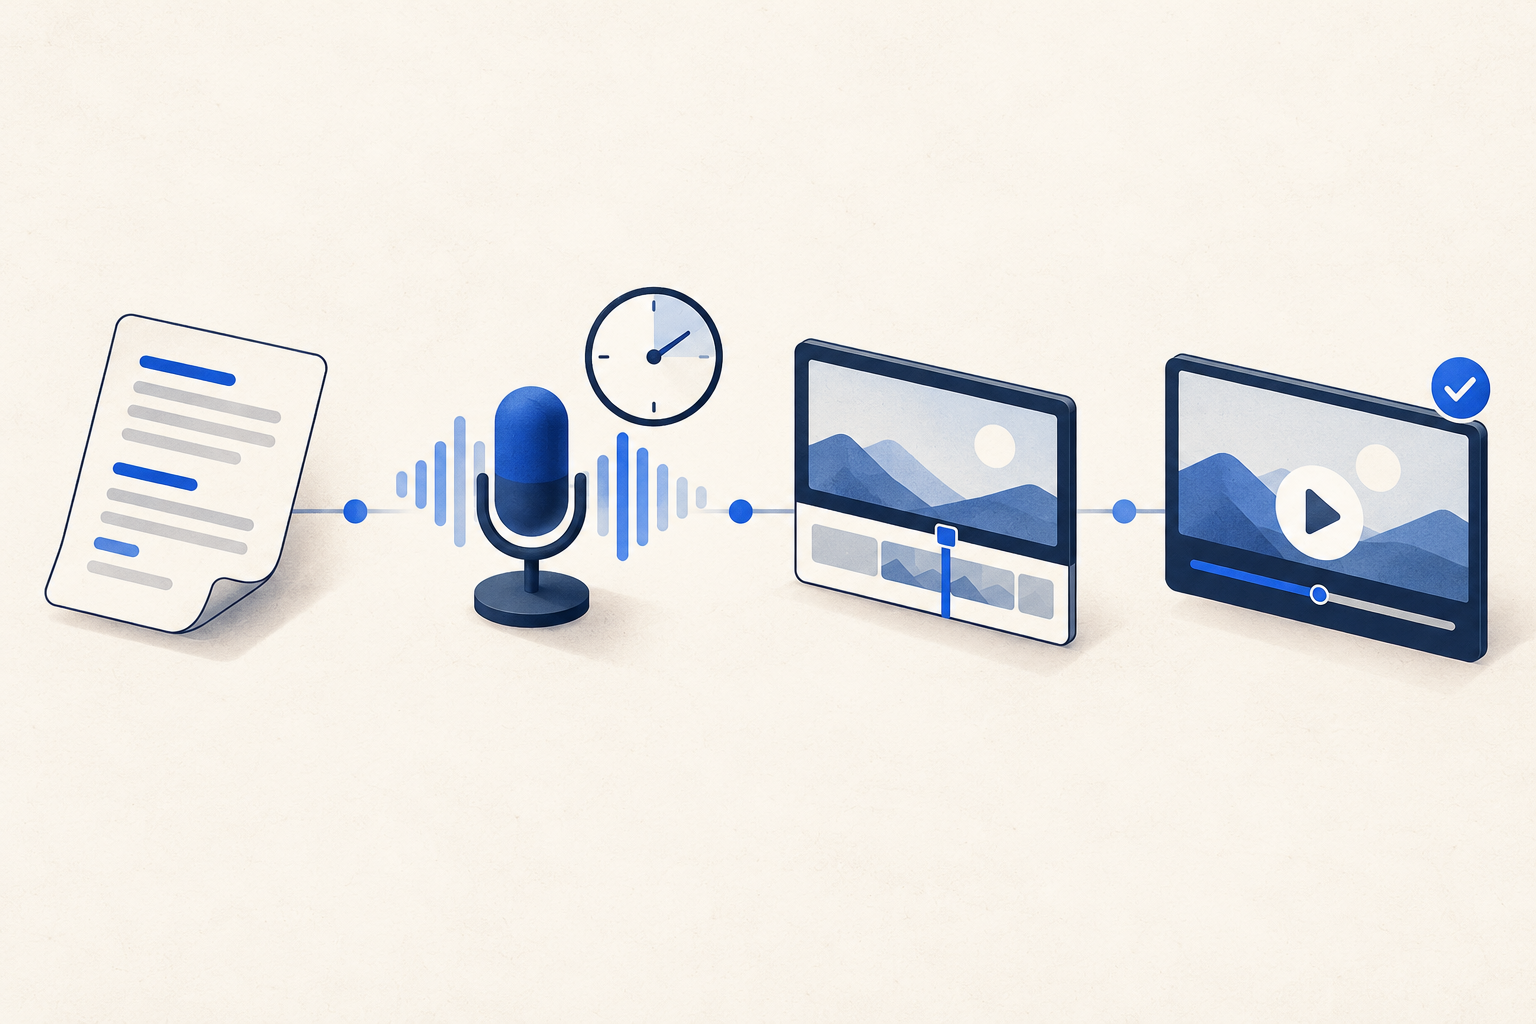
Dohodnout znění
Určit cílovou verzi, schválený scénář a osobu kontrolující význam.
Změřit délku zamýšleného načtení
Připojit změřenou délku nahrávky a pracovní načtení označit jako předběžné.
Dohodnout časové řešení
Dohodnout případné změny scénáře nebo scény před uzavřením střihu.
Zkontrolovat celou verzi
Ověřit zvolenou nahrávku s obrazem, nabídkou a závěrečným snímkem.
Při převzetí čísla zachovejte spárovaný soubor
Společné srovnání zahrnuje 200 z 350 anglických testovacích předloh. U zbývajících 150 chyběla alespoň jedna vybraná konfigurace. Úplná dostupnost může znamenat určitý výběr, proto se společný soubor nemá popisovat jako náhodný vzorek scénářů, jazyků nebo zakázek na mluvený komentář.
Každé srovnání angličtiny s cílovým jazykem jsme zopakovali se všemi dostupnými odpovídajícími si páry. Jmenovatele sahaly od 251 u nizozemštiny po 349 u filipínštiny a thajštiny. Zopakovali jsme také srovnání společného souboru pouze s předlohami, které měly alespoň 2 anglická a 2 cílová načtení. Tyto podmnožiny měly 66 až 166 předloh. Všech 9 párových výsledků a jejich jmenovatele jsou v souboru ke stažení.[4]
Podmnožiny s opakovaným načtením zachovaly v každé konfiguraci stejný směr mediánu párové změny jako hlavní srovnání. Je to užitečná kontrola této konkrétní volby způsobu shrnutí. Nekontroluje však čtenáře ani nečiní z různých párových vzorků srovnatelné populace. Opakovaná načtení nejsou nezávislí účastníci.
Získané německé, nizozemské, indonéské, malajské a filipínské nahrávky byly všechny označené jako mužské. Thajské byly všechny označené jako ženské. Anglické, španělské, francouzské a japonské nahrávky měly smíšená označení. Bez identifikátorů mluvčích analýza nemůže oddělit konfiguraci od složení čtenářů, přednesu, překladu nebo výběru ponechaných nahrávek. Tabulku čtěte jako popis těchto nahrávek a toto omezení ponechte u každého převzatého čísla.[7]
Jak vzniklo srovnání délek nahrávek
FLEURS je výzkumný korpus představený v roce 2022, který používá přeložené načtené texty. Dokumentace producenta a TensorFlow Datasets uvádí společné ID zdrojového textu napříč jazyky a metadatové pole celkového počtu zvukových rámců při 16 000 Hz. Toto pole jsme vydělili 16 000 a získali délku celého souboru v sekundách podle metadat. Nedekódovali jsme zvuk, neověřovali délky zvukových průběhů ani neodstraňovali ticho.[1][2]
10 testovacích metadatových souborů jsme získali v pevné revizi producenta uvedené v poznámkách dne 24. října 2026 (UTC). Obsahují 7 528 nahrávek napříč dostupnými předlohami. Párování používalo zdrojová ID, nikdy pořadí řádků. Společný soubor 200 předloh, pravidla s limitem 15 sekund, kontrola opakovaných načtení a příklad 1662 byly stanoveny po zjištění dostupnosti a před výpočtem souhrnů délek.[3][4]
Datum získání označuje zdrojový snímek, který jsme použili. Nedělá z nahrávek představených s výzkumným korpusem z roku 2022 šetření mluvčích nebo tvůrců z roku 2026. Veřejná data zachovávají revizi zdroje, aby pozdější čtenář odlišil novou analýzu existujícího materiálu od nově shromážděných přednesů.
Dřívější pokus o proveditelnost na vývojové části korpusu přinesl jen 91 společných předloh, méně než stanovený práh 100 předloh, a byl odložen. Získávání testovacích dat nejprve zastavil limit velikosti thajských metadat. Zdokumentovaný vyšší limit umožnil dokončit stejný pevně vymezený testovací soubor. Jde o zveřejněné změny proveditelnosti a přístupu, nikoli o důkaz předregistrované studie provedené bez znalosti výsledků.
Všechny párové výpočty používaly přesné počty rámců a zlomky. Kvartily používají lineární interpolaci na pozicích určených výrazem (n−1) × p. Tabulky zobrazují procenta a sekundy na 1 desetinné místo metodou half-up. Počty načtení zůstávají celými čísly. Veřejná odvozená data zachovávají přesné souhrny předloh, párové výsledky, kontroly citlivosti i obě definice časového limitu. Nepočítali jsme intervaly spolehlivosti pro populaci ani příčinné vlivy.[4]
Časová omezení v dabingu už jsou zavedeným tématem výzkumu.[5] Tento článek přidává reprodukovatelné srovnání délek zveřejněných souborů pro tyto pevně určené texty a informace potřebné k prověření pokrytí a opakovaných načtení. Podporuje vyžádání časových podkladů pro přeloženou produkci před uzavřením střihu. Nedává univerzální procento prodloužení.
- Stáhnout 67 zobrazených výsledků (CSV)
- Stáhnout souhrny načtení pro všech 350 předloh × 10 konfigurací (CSV)
- Stáhnout všech 9 párových srovnání, kontroly citlivosti a počty podle časových pravidel (CSV)
- Stáhnout zdroje, metodu a kód pro reprodukci výpočtů (ZIP)
Bez nutnosti registrace. Odvozená data zachovávají chybějící kombinace a skutečné jmenovatele srovnání. Společný balíček obsahuje anglickou dokumentaci metody, odkazy na zdroje a kód pro reprodukci výpočtů. Balíček nedistribuuje původní přepisy ani zvuk. Každá jazyková verze popisuje stejný pevně vymezený korpus.[8]
Poznámky ke studii
- Conneau a kol., FLEURS: vyhodnocení univerzálních reprezentací řeči při učení z malého počtu příkladů (2022), oddíly 2.1–2.3. Korpus obsahuje přeložené načtené texty s až 3 ověřenými nahrávkami na větu při vzorkování 16 kHz. Způsob sběru ani výzkumný účel nedokládají reprezentativnost pro komerční produkci mluvených komentářů. Zdrojové texty pocházejí z FLORES. Nejde o vzorek reklamních scénářů.
- TensorFlow Datasets, dokumentace vlastností xtreme_s verze 2 a příslušný parser. ID zdrojového textu je shodné napříč jazyky a může se opakovat u jednotlivých načtení. Pole num_samples zaznamenává celkový počet zvukových rámců. Zvuková vlastnost uvádí 16 000 Hz. Parser kopíruje metadatové počty, místo aby je ověřoval proti dekódovaným zvukovým průběhům. Naše sekundové údaje představují délky celých souborů podle metadat, bez oddělení pauz a bez kontroly totožnosti mluvčích.
- Metadata Google FLEURS, pevná revize ab93cf03f9d0cd083c853fad065a6377067408aa, testovací část, získána 24. října 2026 (UTC). Konfigurace: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th a ja_jp. Odkazovaný anglický TSV je jedním z 10 zdrojových souborů. Balíček zaznamenává každou přesnou zdrojovou URL a SHA256. Zdrojová španělština je latinskoamerická a fil_ph znamená filipínštinu.
- Výpočty Influence IQ: jeden medián v rámci předlohy pro každou konfiguraci; stejné váhy předloh; párový poměr cílového mediánu k anglickému a párový rozdíl v sekundách. Hlavní soubor tvoří 200 předloh společných všem 10 konfiguracím ze 350 anglických předloh. Vedlejší srovnání používají všechny dostupné páry angličtiny s cílovým jazykem a společné předlohy s alespoň 2 načteními na každé straně. Metoda i výběr příkladu byly stanoveny před souhrny délek, po zjištění dostupnosti. Přesné zlomky, interpolace, zaokrouhlení i všechny jmenovatele dokumentuje reprodukční balíček.
- Dabing v praxi: rozsáhlá studie lokalizace prováděné lidmi s poznatky pro automatický dabing (2023). Předchozí práce už zkoumají časování profesionálního dabingu s lidskými interprety. Naším přínosem je konečná párová tabulka délek souborů FLEURS a její opakovaně použitelný výklad pro produkční předání. Nejde o objev časových omezení dabingu ani o srovnávací základ pro profesionální dabing.
- Časový limit 15 sekund byl pevně zvolen jako plánovací příklad před výsledky. Pravidlo mediánu: 186 společných předloh má anglický medián ≤15 sekund; počítají se cílové mediány >15 sekund. Pravidlo všech pozorovaných načtení: 178 předloh má každé anglické načtení ≤15 sekund; počítají se předlohy, jejichž každé pozorované cílové načtení je >15 sekund. Hodnota rovná hranici se do limitu vejde. Počty jsou popisnými výsledky zveřejněných nahrávek, nikoli pokynem platformy nebo tvrzením o každém možném načtení.
- Získaná metadata nemají ID mluvčích. Německé, nizozemské, indonéské, malajské a filipínské nahrávky jsou všechny označené jako mužské. Thajské jsou všechny označené jako ženské. Chybějící konfigurace vyřazují ze společného souboru 150 z 350 anglických předloh. Párové kontroly a kontroly opakovaného načtení popisují různé konečné podmnožiny. Neodstraňují provázanost interpreta, pohlaví, přednesu, překladu nebo výběru ponechaných nahrávek. Neuvádíme intervaly spolehlivosti, žebříček rychlosti jazyků, příčinný vliv ani komerční předpověď.
- Zdroj: Google FLEURS, poskytovaný pod licencí CC BY 4.0. Za výběr, výpočty, tabulky, redakční výklad i překlady v tomto zpracování odpovídá Influence IQ. Neznamená to podporu autorů datové sady. Veřejný balíček dále distribuuje odvozené číselné souhrny a kód, nikoli původní zvuk nebo text předloh. Zaokrouhlení pro zobrazení nemění přesné zdrojové počty ani společnou populaci nahrávek.
Zdrojem všech jazykových verzí je anglický článek. Každá verze uvádí stejné pevně vymezené testovací nahrávky FLEURS a přeložené texty. Jazyk článku nevytváří podklady o novém trhu. Za analýzu, výklad a překlady odpovídá Influence IQ.