定剪前,先量測翻譯配音的時長
英語朗讀可能剛好配合畫面,翻譯版本的錄音卻可能超出時長。我們針對 200 段研究文本進行配對分析,說明為何多語配音的時長資訊應在畫面定稿前,就納入製作交接。
本研究以 350 段英語文本為起始範圍,描述分析 FLEURS 測試集 10 種錄音語系設定共有的 200 段翻譯文本,其錄音長度均依中繼資料所載數值計算。這些是研究用朗讀文本,不是商業配音案件。中繼資料取得日期為 2026 年 10 月 24 日(UTC)。
摘要
企業是否應以英語配音的時長,固定在地化影片的剪輯?應先量測翻譯版本的朗讀時長。我們比較了所選 10 種 FLEURS 測試語系設定都有的 200 段文本,錄音長度取自中繼資料。同一文本的重複朗讀先彙整為文本內中位數,再讓每段文本具有相同權重。相對於英語,配對變化的中位數介於荷蘭語錄音的 −6.1% 與菲律賓語錄音的 +82.4% 之間;兩者都不能當成適用整個語言的製作預留量。[1][2]
固定 15 秒的例子,讓交接需求更具體。英語中位數符合此時長的 186 段文本中,有 110 段的菲律賓語中位數超出時限。更嚴格的規則要求所有已觀測英語錄音都符合時長,共有 178 段文本符合資格;其中 72 段的所有已觀測菲律賓語錄音都超時。朗讀者、性別組成、翻譯與停頓等因素仍相互混雜。本研究提供可檢視的錄音時長配對比較,保留全部 9 組目標比較,並納入在得知時長結果前就選定的 1 個例子,協助團隊在確定剪輯前,要求提供計時朗讀資料。
剪輯師已準備好簡短的產品影片。英語旁白符合時長,產品在預定影格出現,結尾鏡頭也留有呈現優惠的空間。翻譯稿傳達相同訊息,於是很容易把錄音當成最後再放進完成時間軸的項目。
這時,缺少的資訊可能變成製作問題:沒有人替翻譯版本的朗讀計時。稿件通過語意審核,不代表剪輯師就知道錄製後會占用多久。有用的交接應同時提供已核准文字與錄音時長。
我們以收錄翻譯朗讀文本的研究語料庫 FLEURS,檢視這項差異。在 200 段配對文本中,錄音時長關係不僅因語系設定而異,同一文本的不同朗讀也有差異。下表保留了這些差異,說明企業或創作者為何應為實際製作索取計時證據,而不是把研究平均值當成保證可用的緩衝時間。
為每個錄音版本保留各自的時長
套用計時規則前,先比較同一文本
第 1 張表以相同的 200 段原始文本,比較各目標語系設定與美式英語。每段文本在各語系設定下,先取其可用錄音長度的中位數;再以目標中位數除以英語中位數,將比值與 1 的差異換算為百分比,最後彙整這 200 個配對變化。因此,錄製 3 次與只錄製 1 次的文本,具有相同權重。[2][4]
拉丁美洲西班牙語錄音的配對變化中位數為 +24.8%,文本層級變化的中間一半介於 +10.2% 至 +47.0%。日語對應的中位數為 +36.6%,中間一半介於 +17.8% 至 +61.8%。這些數值描述相同文本已發布的錄音,不是在規定這兩種語言應如何朗讀。
這與將 2 個整體時長中位數相除不同。在相同的共有文本中,英語各文本彙整值的中位數為 9.3 秒,西班牙語則為 11.6 秒;將這兩個顯示值相除,無法重建配對比較的 +24.8% 結果。我們先配對每段文本,讓較短的目標文本與自身的英語參照比較,而不是與分布中間的另一段文本比較。
荷蘭語錄音的配對變化中位數為 −6.1%,菲律賓語則為 +82.4%。兩者一併保留在表中,能呈現觀測關係的範圍,也避免暗示所有翻譯錄音都較長。在共有文本中,有 71 段荷蘭語文本的中位數長於英語,2 段相同,其餘較短。
各列依分析時使用的固定語系設定順序排列,並未按結果排序。查看與原始比較相關的列時,也應保留其研究背景。拉丁美洲西班牙語與菲律賓語是資料集的來源範圍;本文改以其他語言發布,也不會讓這些錄音成為該市場的證據。
相對美式英語的配對錄音長度變化
每列都使用相同的 200 段翻譯原始文本。以各文本的目標語系時長中位數除以其英語中位數,再將比值相對於 1 的變化表示為百分比。Q25 與 Q75 界定這些配對變化的中間一半。
| 目標錄音語系設定 | 相對變化中位數(%) | 變化的第 25 百分位數(%) | 變化的第 75 百分位數(%) |
|---|---|---|---|
| 拉丁美洲西班牙語 | 24.8% | 10.2% | 47.0% |
| 法語(法國) | 5.7% | -10.0% | 29.1% |
| 德語(德國) | 31.4% | 0.0% | 62.4% |
| 荷蘭語(荷蘭) | -6.1% | -21.6% | 8.9% |
| 印尼語(印尼) | 26.3% | 11.4% | 49.9% |
| 馬來語(馬來西亞) | 11.3% | -1.2% | 29.1% |
| 菲律賓語(菲律賓) | 82.4% | 54.2% | 120.1% |
| 泰語(泰國) | 20.8% | 1.6% | 42.0% |
| 日語(日本) | 36.6% | 17.8% | 61.8% |
錄音必須配合固定時長,分布範圍就很重要
中位數將 200 個關係濃縮為 1 個數字,但特定場景仍須容納特定朗讀。各中位數旁的四分位數,說明為何交接摘要若只保留中央數值,就會丟失與判斷相關的資訊。
法語錄音的配對變化中位數為 +5.7%,但中間一半介於 −10.0% 至 +29.1%。中央差異不大,個別文本的時長卻分布在英語參照的兩側。德語錄音的中位變化為 +31.4%,中間一半約介於 0.0% 至 +62.4%。顯示的 0.0% 是四捨五入結果,四捨五入前的下四分位數其實略為正值。
這些區間描述已觀測配對變化的中間一半,不是信賴區間、最小至最大值範圍,也不是保證能涵蓋未來商業錄音的區間。原始文本、翻譯與朗讀方式,都不同於新的產品稿件。即使完全照用表中的中位百分比,製作團隊仍沒有真正剪輯所需的錄音。
這項區分讓實務問題更明確。製作人不必問某種語言總是需要多留多少時間,而可以問:已核准的翻譯朗讀是否符合預定場景?表格說明為何值得檢查,真正案件的錄音才會提供答案。
1 段文本可能有多種錄音時長
原始文本 1662 是所有 10 種語系設定都有錄音的最小 ID,因此在彙整時長前就已選定。表中納入這段文本所有可用的朗讀。我們沒有在看過時長後才尋找戲劇化例子,也未在此重製該文本的文字或音訊。[3][4]
2 個英語檔案約長 8.4 與 11.2 秒,中位數為 9.8 秒。3 個德語檔案介於 10.4 至 23.5 秒,中位數為 10.5 秒。2 個菲律賓語檔案介於 22.3 至 24.9 秒,中位數為 23.6 秒。這些都是來源中繼資料所載的完整檔案時長,顯示時四捨五入至 1 位小數。
2 次朗讀的中位數,可能是算術中點,而不是實際錄製檔案的長度。英語的 9.8 秒顯示值就是這種彙整結果。剪輯師選擇錄音時,仍須依所選檔案本身的時長工作。錄音次數與最小至最大值範圍,讓這項差異能與中位數一併呈現。
德語錄音的分布範圍也提醒我們,不能把所有時長差異都歸因於翻譯文字的長短。我們沒有說話者 ID,也未聆聽錄音或將語音與停頓分開,因此無法拆解朗讀表現、朗讀者與錄音條件的影響。這個例子支持簡單的製作要求:提供預計採用的錄音,或對預定文字進行計時朗讀,而不只是提供語言層級的估計。
文本 1662:中位數旁,也要保留各次錄音的時長範圍
這是全部 10 種語系設定都有錄音的最小原始 ID,依可用資料範圍選定,早於時長彙整。所有可用錄音都已納入。秒數代表來源中繼資料中的完整檔案,未分離停頓。
| 錄音語系設定 | 可用錄音數 | 最短檔案時長(秒) | 檔案時長中位數(秒) | 最長檔案時長(秒) |
|---|---|---|---|---|
| 美式英語 | 2 | 8.4 | 9.8 | 11.2 |
| 拉丁美洲西班牙語 | 3 | 8.8 | 9.5 | 9.5 |
| 法語(法國) | 2 | 6.4 | 6.8 | 7.1 |
| 德語(德國) | 3 | 10.4 | 10.5 | 23.5 |
| 荷蘭語(荷蘭) | 1 | 7.9 | 7.9 | 7.9 |
| 印尼語(印尼) | 1 | 11.6 | 11.6 | 11.6 |
| 馬來語(馬來西亞) | 2 | 8.0 | 8.6 | 9.1 |
| 菲律賓語(菲律賓) | 2 | 22.3 | 23.6 | 24.9 |
| 泰語(泰國) | 3 | 6.5 | 8.7 | 10.1 |
| 日語(日本) | 2 | 12.1 | 13.3 | 14.6 |
15 秒範例也要說清楚分母
計算結果前,我們先將 15 秒固定為規劃示例。這不是平台要求、建議廣告長度,也不是安全的製作預留量。我們要問的是:英語錄音的彙整時長是否能符合這個時限,而對應的目標語系彙整時長卻超出?
在 200 段共有文本中,186 段的英語中位數不超過 15 秒。在這組符合資格的文本內,目標中位數超過 15 秒的文本數,分別為拉丁美洲西班牙語 20 段、德語 39 段、荷蘭語 9 段、菲律賓語 110 段,以及日語 37 段。各項計數的分母均為 186,其餘比較保留在下載檔中。[6]
我們也採用更嚴格的已觀測錄音規則:每次可用的英語朗讀都須在 15 秒內,每次可用的目標語系朗讀則都須超過時限。符合資格的英語文本有 178 段;西班牙語有 11 段、德語 9 段、荷蘭語 4 段、菲律賓語 72 段、日語 14 段符合上述情況。這些計數只涉及已發布的錄音,不代表該文本所有可能的朗讀方式。
更嚴格的檢查,避免依賴沒有人真正錄製過的算術中點;但仍不能證明文本無法讀得更快、以不同方式剪輯,或適當改寫。對團隊而言,有用的區分是:某個已交付錄音確實符合時長的證據,與只因英語版本符合,就假設另一版本也會符合。
虛構的產品推出案例,說明交接時機
假設有個虛構的小型廚具品牌,委託創作者製作 15 秒產品影片,內容包括示範、優惠與結尾產品鏡頭。英語朗讀花了 11 秒,翻譯草稿的語意已獲核准,但預定旁白者首次朗讀卻花了 17 秒。這個例子的品牌、稿件、時長與委託案都是虛構的,並非 FLEURS 觀測結果。
如果創作者早已依英語朗讀固定所有鏡頭,17 秒的檔案就會在剪輯後期迫使團隊做選擇。客戶專案負責人可以在翻譯文字仍受審核時,要求提供計時朗讀,明確提出這項選擇。製作摘要應標明必須準確保留的訊息、場景可用時間,以及誰有權核准兩者的變更。
不必自動要求旁白者加快速度。譯者可能提出較精簡、自然又保留優惠內容的說法;剪輯師可能延長示範畫面、把次要細節移到搭配文案,或在約定格式允許時另做剪輯版本。這些是可討論的製作選項,不是本語料分析已證實的改善方法。
這個虛構案件的實用交接內容可以寫成:「目標版本:__。已核准稿件:__。預計採用的錄音:__ 秒,依交付檔案量測。場景配置時間:__ 秒。優惠文字與必要揭露:__。核准稿件變更的人:__。核准剪輯的人:__。」空白應由實際團隊填寫,研究表格無法代填。
有多個目標版本時,客戶專案負責人可為每份預計採用的錄音各留 1 列,而不是將整個專案標記為「翻譯已核准」。文字核准與時長核准,回答的是不同問題。若譯者在試讀後更改產品宣稱,應在創作者沿用先前時長前,先在該列標示這項變更。這是整理虛構委託案的建議方式,不是經過測試、能降低專案風險的方法。
收到修改後的錄音,創作者就能與負責語言及語意的人,一起審核完整版本。只看時長是否符合,可能漏掉不自然的朗讀或無法讀清的結尾畫面。本研究沒有量測品質或觀眾反應。研究對這個虛構委託案的貢獻,是讓團隊提早知道錄音時長;創意選擇仍由製作影片的人負責。
讓文字、錄音與畫面一併接受審核
處理多語配音時長時,有用的文件應簡短到能隨作品一併交接,並標明已核准的稿件版本、預計採用的錄音與場景時長。只要其中有變動,下次接手的人就能看出哪些計時證據仍適用。
計時試讀能在團隊仍有選擇時,提早發現時長衝突;但應持續標示為試讀,不能當成正式旁白者一定會錄出相同時長的證據。預計採用的錄音送達後,應以檔案量測時長取代原先假設,並放入實際剪輯中審核。
審核時,應完整呈現翻譯版本。檢查語意的人需要配合畫面聆聽朗讀,剪輯師則須檢查停頓、產品亮相與結尾畫面是否相互配合。檔案符合時長,只是其中 1 項證據,不代表整個版本都已獲核准。
以下 4 個步驟是交接建議,不是在 FLEURS 中測試過的工作流程。它們將研究對文字與錄音時長的區分,用於製作決策;並不保證觸及、觀眾留存、轉換成效,或專案需要修改幾次。
4 次交接,都帶上錄音時長
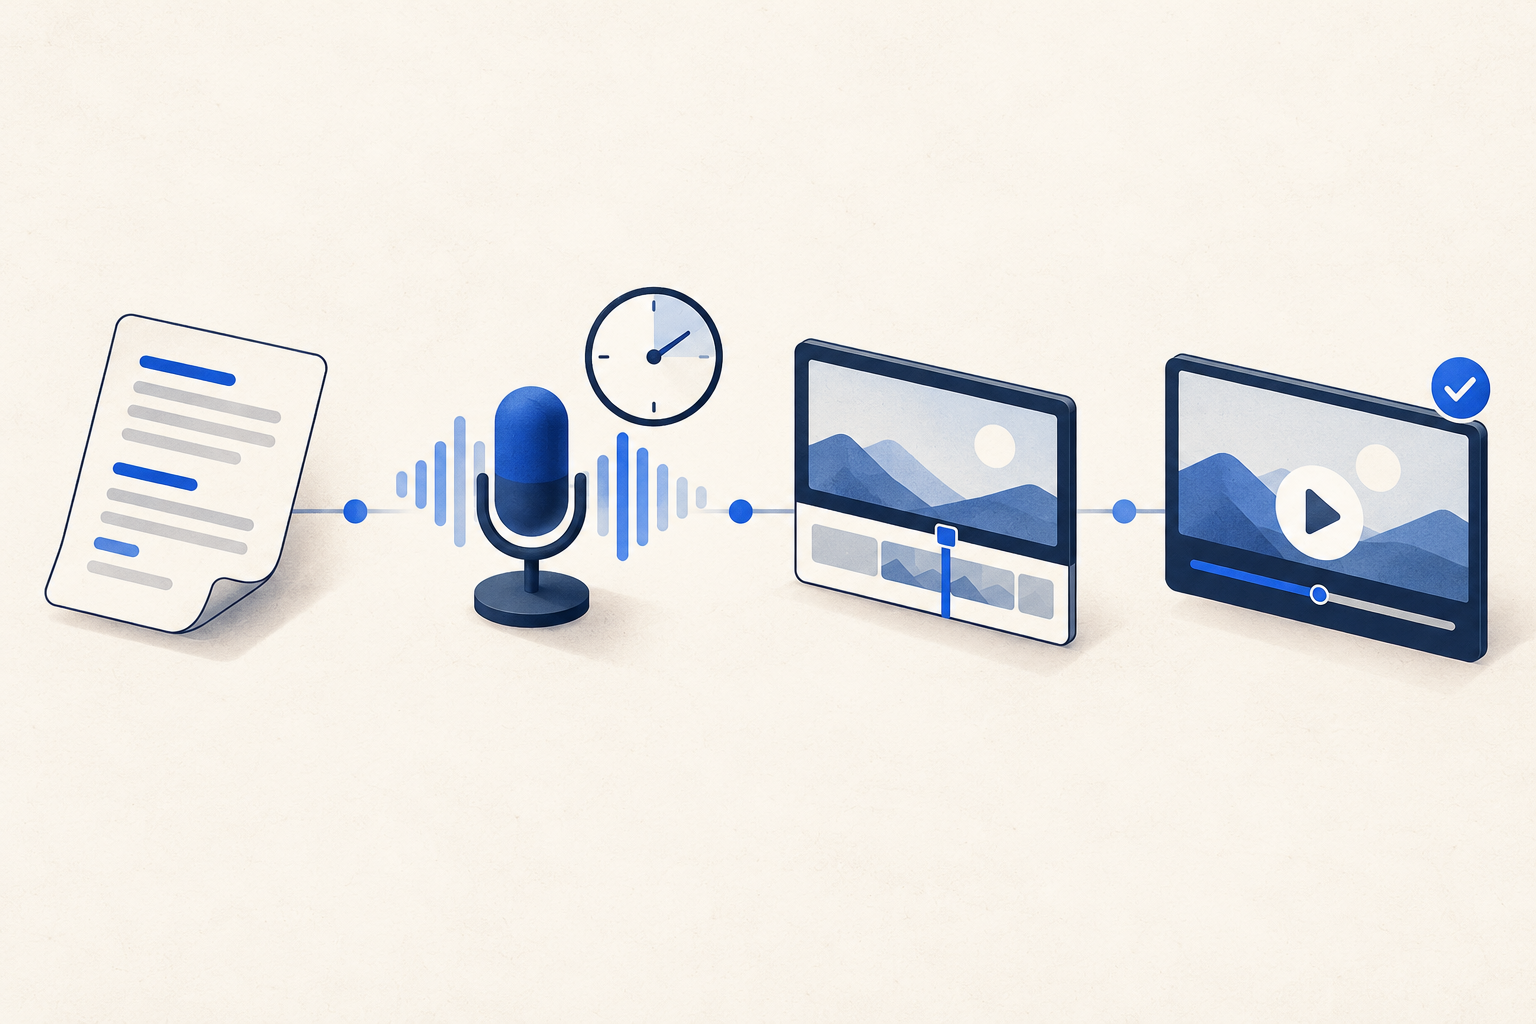
議定文字
標明目標版本、已核准稿件與語意審核人。
為預計採用的朗讀計時
附上所量測的錄音時長;試讀須標示為暫用。
確認如何符合時長
確定剪輯前,先議定任何稿件或場景變更。
審核完整版本
將所選錄音搭配畫面、優惠內容與結尾影格一併檢查。
引用數值時,也要交代配對文本範圍
共同比較涵蓋 350 段英語測試文本中的 200 段。其餘 150 段至少缺少 1 種所選語系設定的錄音。資料是否齊全,可能與納入條件有關,因此不應將共有文本集合描述為稿件、語言或配音案件的隨機樣本。
我們用所有可用配對,重做每項英語與目標語系的比較。各分母介於荷蘭語的 251 段,以及菲律賓語與泰語的 349 段之間。我們也重做共有文本的比較,但僅納入英語與目標語系各至少有 2 次朗讀的文本;這些子集合介於 66 至 166 段。全部 9 組配對結果與各自的分母,都保留在下載檔中。[4]
在每種語系設定中,重複朗讀子集合的配對變化中位數,都與主要比較維持相同方向。這有助於檢查這項特定彙整選擇,但沒有控制朗讀者,也沒有讓不同配對樣本成為可比較的母體。重複錄音不等於獨立參與者。
取得的德語、荷蘭語、印尼語、馬來語與菲律賓語錄音,都標記為男性;泰語錄音都標記為女性。英語、西班牙語、法語與日語則有混合標籤。沒有說話者識別碼,分析就無法將語系設定與朗讀者組成、朗讀表現、翻譯或錄音保留情形分開。請將表格視為對這批錄音的描述,引用任何數值時,也應附上這項限制。[7]
錄音時長的比較方法
FLEURS 是 2022 年推出、使用翻譯朗讀文本的研究語料庫。資料提供者與 TensorFlow Datasets 文件,指出不同語言共用原始文本 ID,並提供以 16,000 Hz 取樣的音訊總影格數欄位。我們將該欄位除以 16,000,作為中繼資料所載的完整檔案秒數,並未解碼音訊、驗證波形長度或移除靜音。[1][2]
我們於 2026 年 10 月 24 日(UTC),取得註記所載固定資料提供者修訂版的 10 份測試中繼資料檔,所有可用文本合計有 7,528 份錄音。配對使用原始 ID,從未使用資料列位置。200 段共有文本、15 秒規則、重複朗讀檢查與例子 1662,都是在得知可用資料範圍後、計算時長彙整結果前固定。[3][4]
取得日期用來識別我們採用的來源快照,不會將隨 2022 年研究語料庫推出的錄音,變成 2026 年的旁白者或創作者調查。公開資料保留來源修訂版,讓後來讀者能區分:對既有素材做的新分析,以及新蒐集的朗讀表現。
先前以開發集進行的可行性嘗試,只得到 91 段共有文本,未達 100 段門檻,因此暫時擱置。測試資料的取得最初也因泰語中繼資料大小上限而停止;之後採用文件記錄的較大上限,才完成同一個固定測試文本範圍。這些是已揭露的可行性與存取調整,不能證明研究是在不知結果下預先註冊的。
所有配對計算都使用精確影格數與分數。四分位數依 (n−1) × p 定義的位置進行線性內插。表格中的百分比與秒數以四捨五入法顯示至 1 位小數,錄音次數則保留整數。公開衍生資料保留精確的文本彙整、配對結果、敏感度檢查與兩種時限定義。我們沒有計算母體信賴區間或因果效果。[4]
配音中的時長限制,早已是既有研究主題。[5] 本文新增的是這些固定文本已發布錄音檔時長的可重現比較,以及檢視涵蓋範圍與重複錄音所需的資訊。它支持在定剪前,為翻譯製作索取計時證據;並未提供通用的時長增加百分比。
不需註冊。衍生資料保留缺少的組合與實際比較分母。共用套件包含英文方法文件、來源參照與重現程式碼,沒有重新散布原始逐字稿或音訊。所有語言版本都描述同一個固定語料庫。[8]
研究註記
- Conneau 等人,FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech(2022),第 2.1–2.3 節。語料庫收錄翻譯朗讀文本,每句最多有 3 份經驗證的錄音,取樣率為 16 kHz。其蒐集方式與研究目的,不能證明能代表商業配音製作。來源文本可追溯至 FLORES,不是廣告稿件樣本。
- TensorFlow Datasets 的 xtreme_s 第 2 版特徵文件與所屬解析器。原始文本 ID 在不同語言間一致,且可能在多次朗讀中重複;num_samples 記錄音訊總影格數,音訊特徵宣告為 16,000 Hz。解析器複製中繼資料中的計數,不會對照解碼後的波形檢查。我們的秒數是中繼資料所載完整檔案時長,未分離停頓,也未控制說話者身分。
- Google FLEURS 中繼資料,固定修訂版 ab93cf03f9d0cd083c853fad065a6377067408aa,測試集,取得於 2026 年 10 月 24 日(UTC)。語系設定為 en_us、es_419、fr_fr、de_de、nl_nl、id_id、ms_my、fil_ph、th_th 與 ja_jp。連結中的英語 TSV 是這 10 份來源檔中的 1 份;套件記錄每個確切來源網址與 SHA256。來源西班牙語為拉丁美洲設定,fil_ph 為菲律賓語。
- Influence IQ 計算:各語系設定先取每段文本內的錄音中位數,再賦予每段文本相同權重,計算目標與英語中位數的配對比值,以及配對秒數差。主要比較採用 350 段英語文本中,全部 10 種語系設定共有的 200 段。次要比較使用所有可用的英語與目標配對,以及兩側各至少有 2 次錄音的共有文本。方法與例子是在得知可用資料範圍後、彙整時長前固定。重現套件記錄精確分數、內插、四捨五入與所有分母。
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing(2023)。既有研究已探討專業人工配音的時長問題。我們的貢獻是有限範圍的 FLEURS 檔案時長配對表,以及可重複運用的製作交接詮釋;不是發現配音時長限制,也不是專業配音基準測試。
- 15 秒時限是在得知結果前固定的規劃示例。中位數規則:186 段共有文本的英語中位數 ≤15 秒,計算目標中位數 >15 秒的文本數。全部已觀測錄音規則:178 段文本的每次英語錄音都 ≤15 秒,計算每次已觀測目標錄音都 >15 秒的文本數。等於邊界值仍符合時限。計數只描述已發布錄音,不是平台指引,也不是對所有可能朗讀方式的主張。
- 取得的中繼資料沒有說話者 ID。德語、荷蘭語、印尼語、馬來語與菲律賓語錄音均標記為男性,泰語均標記為女性。語系設定缺漏,使 350 段英語文本中的 150 段無法納入共有集合。配對與重複朗讀檢查,描述的是不同的有限子集合,並未排除表演者、性別、朗讀方式、翻譯或錄音保留情形的混雜。本研究未報告信賴區間、語言速度排名、因果效果或商業預測。
- 來源:Google FLEURS,依 CC BY 4.0 提供。資料選取、計算、表格、編輯詮釋與翻譯,均為 Influence IQ 的改作,不暗示資料集作者背書。公開套件重新散布的是衍生數值彙整與程式碼,不是原始音訊或文本。顯示時四捨五入,不會改變精確來源計數或共用的錄音集合。
英文文章是所有語言版本的來源。各版本都報告同一批固定的 FLEURS 測試錄音與翻譯文本,文章使用的語言不會為新市場創造證據。Influence IQ 負責分析、詮釋與翻譯。