锁定剪辑前,先给译文配音计时
英语朗读可能刚好适合一个场景,译文录音却超时。我们对200段研究朗读文本作配对比较,说明多语言配音时长为何应在画面锁定前,纳入制作交接。
本研究描述性分析元数据报告的录音时长:从350条英语文本的范围中,取10个 FLEURS 测试配置共有的200条翻译文本。这些是研究朗读材料,不是商业配音任务。元数据获取于2026年10月24日(UTC)。
摘要
企业应把本地化视频锁定在英语配音时长上吗?先测译文朗读。我们比较了10个选定 FLEURS 测试配置中共有的200条文本的录音时长,这些时长由元数据报告。先把同一文本的重复朗读汇总为中位数,再让每条文本等权参与比较。相对英语的配对变化中位数,从荷兰语录音的−6.1%到菲律宾语录音的+82.4%不等;两者都不是适用于整种语言的制作时长余量。[1][2]
固定15秒的示例,让交接问题更具体。英语中位时长不超过15秒的186条文本中,有110条的菲律宾语中位时长超时。更严格的规则下,178条文本的所有已观察英语录音均未超时,其中72条的所有已观察菲律宾语录音均超时。不同朗读者、性别构成、翻译和停顿仍交织在一起。研究提供可检查的录音时长比较,全部9项目标比较和1个示例,均在时长结果得出前选定,帮助团队在确定剪辑前提出计时朗读的要求。
剪辑师准备好了一段产品短视频:英语旁白时长合适,产品在预定帧出现,结尾镜头也留得下销售信息。随后,表达同样信息的译文脚本到了。团队很容易把录音当成最后一项素材,直接放进已经完成的时间线。
此时,一项缺失信息就可能变成制作问题:没人给译文朗读计时。脚本含义获批,并不能告诉剪辑师录出来要占多长时间。有用的交接,应同时包含获批措辞和录音时长。
我们在 FLEURS 译文朗读研究语料中考察了这一区别。200条匹配文本的录音时长关系,既因配置而异,也因同一文本的不同朗读而异。下表保留了这些差异,让企业或创作者有依据要求实际制作的计时证据,而不把研究平均结果当作承诺的时长余量。
每个录音版本,都要有自己的时长
借用时长规则前,先比较同一段文本
第一张表用同样200条来源文本,比较各目标配置与美国英语。对每条文本、每个配置,先取可用录音时长的中位数,再将目标中位数除以英语中位数,把与1的差写成百分比,最后汇总200个配对变化。因此,有3次朗读的文本,与只有1次的文本权重相同。[2][4]
拉丁美洲西班牙语录音的配对变化中位数为+24.8%,文本级变化中间50%的范围为+10.2%至+47.0%。日语对应中位数为+36.6%,中间50%为+17.8%至+61.8%。这些描述的是同源文本已发布录音,不规定两种语言应该怎样演绎。
这不同于拿2个总体时长中位数相除。在相同共有文本中,英语文本汇总值的中位数为9.3秒,西班牙语为11.6秒。用这两个显示值相除,不能重建+24.8%的配对结果。我们先逐段匹配,让较短的目标文本始终对应自己的英语参考,而不是对应分布中部的另一段文本。
荷兰语录音的配对变化中位数为−6.1%,菲律宾语为+82.4%。把两者都留在表中,可以看清观察到的关系范围,也避免暗示每段译文录音都更长。共有文本中,71条荷兰语文本的中位时长长于英语,2条相等,其余更短。
表行按分析时固定的配置顺序排列,不按结果排序。找到与所需来源比较对应的行后,应保留其研究背景。拉丁美洲西班牙语和菲律宾语,是数据集原有范围;用另一种语言发表文章,不会让这些录音成为关于该市场的新证据。
相对美国英语的配对录音时长变化
每行使用同样200条译文来源文本。先将每条文本的目标中位时长除以其英语中位时长,再把与1的差表示为百分比。Q25和Q75界定这些配对变化中间50%的范围。
| 目标录音配置 | 相对变化中位数(%) | 相对变化第25百分位值(%) | 相对变化第75百分位值(%) |
|---|---|---|---|
| 拉丁美洲西班牙语 | 24.8% | 10.2% | 47.0% |
| 法语(法国) | 5.7% | -10.0% | 29.1% |
| 德语(德国) | 31.4% | 0.0% | 62.4% |
| 荷兰语(荷兰) | -6.1% | -21.6% | 8.9% |
| 印尼语(印度尼西亚) | 26.3% | 11.4% | 49.9% |
| 马来语(马来西亚) | 11.3% | -1.2% | 29.1% |
| 菲律宾语(菲律宾) | 82.4% | 54.2% | 120.1% |
| 泰语(泰国) | 20.8% | 1.6% | 42.0% |
| 日语(日本) | 36.6% | 17.8% | 61.8% |
制作只有一个固定时长,分布范围就很重要
中位数把200组关系浓缩为一个数值,但具体场景仍要容纳具体朗读。每个中位数旁的四分位点说明,只把中间值写进简报,会丢掉影响决定的信息。
法语录音的配对变化中位数为+5.7%,但中间50%的范围从−10.0%到+29.1%。中间值差异不大,却同时存在比英语更短和更长的文本。德语中位变化为+31.4%,中间50%约从0.0%到+62.4%。显示的0.0%经过舍入,未舍入的下四分位值略大于0。
这些区间描述已观察配对变化的中间50%,不是置信区间、最小至最大界限,也不保证未来商业录音会落在其中。语料中的文本、译文和演绎,与新的产品脚本不同。即使照抄表中的中位百分比,制作团队仍没有剪辑所需的实际录音。
这让实际问题变得不同。与其问某种语言总要多留多少时间,制片人可以问:获批译文的朗读,能否放进预定场景?表格解释为何要检查,本次任务的录音才提供答案。
同一段文本,也可能有多种录音时长
来源文本1662是在全部10个配置中都有录音的最小 ID,在汇总时长前选定。表格包含该文本的每次可用朗读。我们没有看过时长后再找醒目示例,此处也不转载该文本的文字或音频。[3][4]
2个英语文件约为8.4秒和11.2秒,中位数9.8秒。3个德语文件从10.4秒到23.5秒,中位数10.5秒;2个菲律宾语文件从22.3秒到24.9秒,中位数23.6秒。这些是来源元数据中的完整文件时长,显示时舍入到1位小数。
2次朗读的中位数,可能只是算术中点,并不是某个实际录音文件的时长。英语显示值9.8秒就是这种汇总。剪辑师挑选录音时,仍需按所选文件自身时长工作。录音次数及最短至最长范围,与中位数并列,能让这一区别更清楚。
德语的分散范围也提醒我们,不能把每一秒差异都归因于译文长度。我们没有说话人 ID,未听录音,也未将语音与停顿分开;演绎、朗读者和录音条件在这里无法区分。示例支持一个简单制作要求:提供拟用录音,或对拟用措辞作计时朗读,而不只给一个语言层面的估计。
文本1662:中位数旁,也保留录音时长范围
这是全部10个配置都有录音的最小来源 ID,在汇总时长前依据可用性选定,包含每次可用录音。秒数描述来源元数据中的完整文件,未将停顿分开。
| 录音配置 | 可用录音次数 | 最短文件时长(秒) | 文件时长中位数(秒) | 最长文件时长(秒) |
|---|---|---|---|---|
| 美国英语 | 2 | 8.4 | 9.8 | 11.2 |
| 拉丁美洲西班牙语 | 3 | 8.8 | 9.5 | 9.5 |
| 法语(法国) | 2 | 6.4 | 6.8 | 7.1 |
| 德语(德国) | 3 | 10.4 | 10.5 | 23.5 |
| 荷兰语(荷兰) | 1 | 7.9 | 7.9 | 7.9 |
| 印尼语(印度尼西亚) | 1 | 11.6 | 11.6 | 11.6 |
| 马来语(马来西亚) | 2 | 8.0 | 8.6 | 9.1 |
| 菲律宾语(菲律宾) | 2 | 22.3 | 23.6 | 24.9 |
| 泰语(泰国) | 3 | 6.5 | 8.7 | 10.1 |
| 日语(日本) | 2 | 12.1 | 13.3 | 14.6 |
15秒示例,也要写清分母
我们在计算结果前,固定15秒作为规划示例。它不是平台要求、推荐广告长度或安全制作余量。问题是:英语录音汇总时长不超过15秒时,对应目标汇总时长是否超过15秒。
200条共有文本中,186条英语中位时长不超过15秒。在这一组内,目标中位时长超过15秒的,分别有拉丁美洲西班牙语20条、德语39条、荷兰语9条、菲律宾语110条、日语37条。各计数分母同为186,其他比较保留在下载文件中。[6]
我们也采用了更严格的已观察录音规则:每次可用英语朗读时长都须≤15秒,而每次可用目标朗读都须超过15秒。符合英语条件的有178条文本,随后符合目标条件的分别为西班牙语11条、德语9条、荷兰语4条、菲律宾语72条、日语14条。这些计数只涉及已发布录音,不涵盖同一文本所有可能的演绎。
更严格的检查,避免依赖无人实际录下的算术中点,却仍不能证明文本无法读得更快、采用不同剪法或适当改写。团队需要区分:有证据表明所提供的某份录音合适,与只因英语合适就假定另一版本也合适。
一场虚构发布,说明交接应放在哪一步
设想一个虚构的小型厨具品牌,请创作者制作15秒产品视频,包含演示、销售信息和结尾产品镜头。英语朗读用时11秒,译文初稿含义已获批,但拟用旁白者第一次朗读用了17秒。示例中的品牌、脚本、时长和任务均属虚构,不是 FLEURS 观测记录。
若创作者已按英语朗读锁定所有镜头,17秒文件就会把决定拖到剪辑后期。客户负责人可以在译文措辞仍在审核时,先要求计时朗读,避免把这个选择含糊带过。简报应注明必须准确保留的信息、可用场景时长,以及谁能批准修改其中任何一项。
应对方式不必是自动加快旁白。译者可以提出更短且自然、仍保留销售信息的说法;剪辑师可以给演示更多时间,把次要细节移到配套文案,或在约定格式允许时制作单独剪辑版。这些是可讨论的制作选项,并非语料分析证明的改进。
这项虚构任务的交接可以写:“目标版本:__。获批脚本:__。拟用录音:__秒,根据所提供文件测得。场景分配:__秒。销售信息措辞与必需披露内容:__。脚本修改批准人:__。剪辑批准人:__。”空白应由实际团队填写,研究表格不能代填。
有多个目标版本时,客户负责人可为每份拟用录音单列一行,而不是把整个项目标成“译文已批准”。措辞批准与时长批准回答不同问题。临时试读后,若译者改动产品主张,该行应先注明变化,创作者再判断能否沿用先前时长。这只是组织虚构任务的建议,不是经测试能降低项目风险的方法。
收到修订录音后,创作者可与负责语言和含义的人,一起审核完整版本。只看时长合适,可能漏掉别扭的演绎,或来不及读清的结尾画面。本研究既未衡量质量,也未衡量受众反应。它为虚构任务提供的是更早知道录音时长,创意选择仍由制作视频的人负责。
审核时,把措辞、录音和画面放在一起
多语言配音时长的交接文档,应简短到能随工作流转,写明获批脚本版本、拟用录音和场景时长。任何一项改变,接手人都应能看出哪些计时依据仍然适用。
给临时试读计时,可以在团队仍有选择时暴露冲突。它仍应标为临时试读,不能当成最终旁白者会录出相同时长的证明。拟用录音到达后,应以测得的实际时长替代假设,并放进真实剪辑中审核。
审核时保留完整译文版本。核对含义的人需要结合画面听演绎,剪辑师需要看停顿、产品出现时点和最后一帧是否配合。文件符合时长,只是一项证据,并不表示版本中的一切都已获批。
下方4步是建议交接流程,未经 FLEURS 测试。它们把措辞与录音时长的区别,用于制作决定,不保证触达量、受众留存、转化,或项目所需修改次数。
让录音时长随4次交接传递
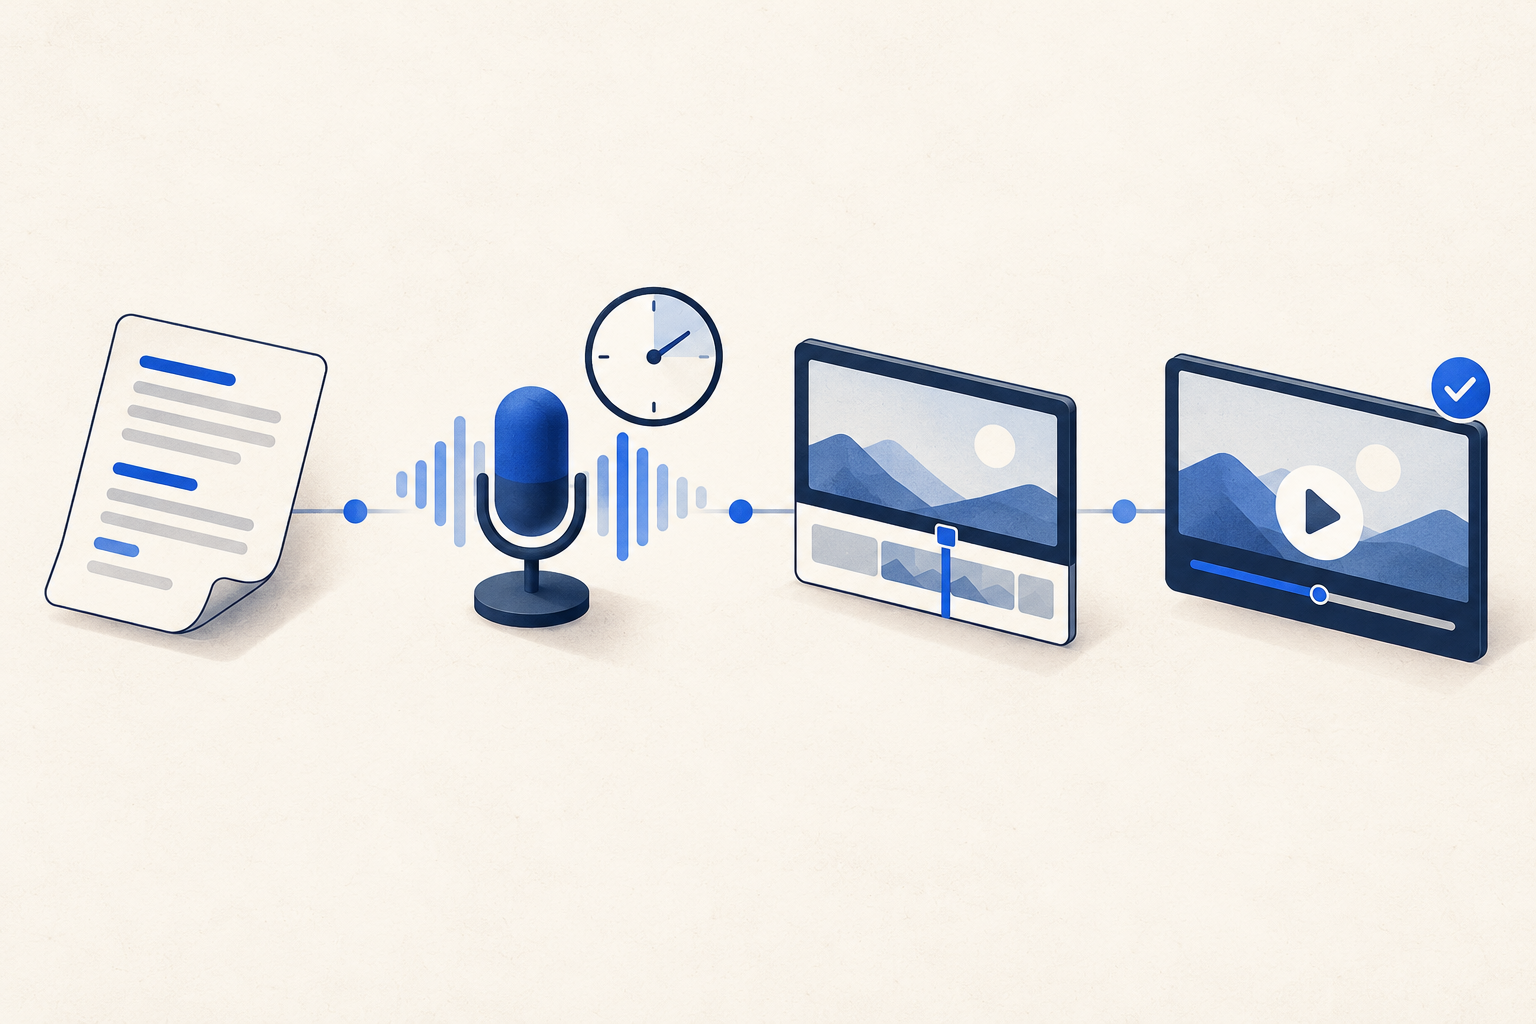
商定措辞
写明目标版本、获批脚本,以及审核含义的人。
给拟用朗读计时
附上这次录音测得的时长;临时试读须标明暂定。
解决时长适配问题
确定剪辑前,先商定脚本或场景的改动。
审核完整版本
结合画面、销售信息和结尾帧,检查所选录音。
复用数值时,也保留匹配文本集合
共有比较纳入350条英语测试文本中的200条,其余150条至少缺少一个选定配置。完整可用的文本可能具有选择性,因此不能把共有集合称为脚本、语言或配音任务的随机样本。
我们用每一对可用匹配文本,重做各项英语与目标配置比较。分母从荷兰语251条,到菲律宾语、泰语349条不等。我们还仅用共有集合中,英语和目标语言各至少有2次朗读的文本重复比较,子集有66至166条。全部9项配对结果及分母保留在下载中。[4]
每个配置的重复朗读子集,都保留了与主比较相同的配对变化中位数方向。这能检查本次特定汇总选择,但不能控制朗读者,也不能把不同配对样本变成可比总体。重复录音不是相互独立的参与者。
取得的德语、荷兰语、印尼语、马来语和菲律宾语录音,性别标签全为男性;泰语全为女性;英语、西班牙语、法语和日语则有混合标签。缺少说话人标识符,分析便无法将配置与朗读者构成、演绎、翻译或录音留存情况分开。复用任何数值时,都应把这一限制附在旁边,将表格视为对这些录音的描述。[7]
我们如何比较录音时长
FLEURS 于2022年推出,是采用译文朗读材料的研究语料。来源方与 TensorFlow Datasets 文档说明,跨语言共用来源文本 ID,元数据还记录16,000 Hz下的音频总帧数。我们用该字段除以16,000,得到元数据报告的完整文件秒数。我们未解码音频、验证波形长度或去除静音。[1][2]
我们于2026年10月24日(UTC),从注释所列的固定来源版本获取10份测试元数据文件,包含可用文本的7,528份录音。匹配依据是来源 ID,从不依靠行位置。200条共有集合、15秒规则、重复朗读检查和示例1662,都在已知可用性之后、计算时长汇总之前固定。[3][4]
获取日期标明我们采用的来源快照,不会把随2022年研究语料推出的录音,变成2026年对旁白者或创作者的调查。公开数据保留来源版本,让后来读者分清:这是对已有材料的新分析,还是新采集的演绎。
较早一次开发集可行性尝试,只得到91条共有文本,低于其100条门槛,因此搁置。测试集获取最初因泰语元数据大小上限而停止;记录在案的更大上限,随后完成了同一固定测试范围。这些是已披露的可行性与访问调整,不证明研究是在不知结果的情况下预注册的。
全部配对计算使用精确帧数与分数。四分位数按 (n−1) × p 确定的位置线性插值。表格中的百分比和秒数,采用四舍五入显示1位小数;录音次数保持整数。公开派生数据保留精确文本汇总、配对结果、敏感性检查和两种时长规则。我们未计算总体置信区间或因果效应。[4]
配音中的时长约束,已是既有研究主题。[5] 本文补充的是固定文本已发布文件时长的可复现比较,以及检查覆盖范围和重复录音所需的信息。它支持团队在锁定剪辑前,要求译文制作的计时证据,却不提供通用的时长增幅百分比。
无需注册。派生数据保留缺失组合和实际比较分母。共用数据包包含英文方法说明、来源参考和复现代码,不重新分发原始转录文本或音频。每个语言版本描述的都是同一个固定语料。[8]
研究注释
- Conneau 等,《FLEURS:通用语音表征的小样本学习评估》(2022),第2.1–2.3节。语料包含译文朗读材料,每句最多有3份经验证录音,采样率16 kHz。其采集方式和研究目的,不代表它能代表商业配音制作。来源文本可追溯到 FLORES,并非广告脚本样本。
- TensorFlow Datasets,xtreme_s 第2版特征文档及其解析器。来源文本 ID 跨语言一致,同一文本的多次朗读可重复使用该 ID;num_samples 记录音频总帧数,音频特征声明16,000 Hz。解析器复制元数据计数,并不对照解码波形核查。因此,我们的秒数是元数据报告的完整文件时长,未分离停顿,也未控制说话人身份。
- Google FLEURS 元数据,固定版本 ab93cf03f9d0cd083c853fad065a6377067408aa,测试集,获取于2026年10月24日(UTC)。配置为 en_us、es_419、fr_fr、de_de、nl_nl、id_id、ms_my、fil_ph、th_th 和 ja_jp。链接中的英语 TSV 是10份来源文件之一;数据包记录每份文件的精确来源 URL 和 SHA256。源西班牙语配置是拉丁美洲范围,fil_ph 是菲律宾语。
- Influence IQ 计算:每个配置内,每条文本取一个录音中位数;文本等权;比较目标与配对英语中位数的比值,以及配对秒数差。主比较以350条英语文本中,全部10个配置共有的200条为依据。补充比较使用全部可用英语—目标配对,以及双方各至少有2次录音的共有文本。方法和示例选择,在已知可用性之后、汇总时长之前固定。复现包记录精确分数、插值、舍入及全部分母。
- 《配音实践:大规模人工本地化研究及其对自动配音的启示》(2023)。既有研究已考察专业人工配音的时长问题。我们的贡献,是范围明确的 FLEURS 配对文件时长表及可复用的制作交接解读,不是发现配音时长约束,也不是专业配音基准。
- 15秒时长是在结果得出前固定的规划示例。中位数规则:186条共有文本的英语中位时长≤15秒,再计数目标中位时长>15秒的文本。全部已观察录音规则:178条文本的每次英语录音均≤15秒,再计数每次已观察目标录音都>15秒的文本。恰好等于界限也算合适。这些是已发布录音的描述性结果,不是平台指引,也不代表所有可能朗读。
- 取得的元数据没有说话人 ID。德语、荷兰语、印尼语、马来语和菲律宾语录音标签全为男性,泰语全为女性。配置缺失,使350条英语文本中的150条未进入共有集合。配对与重复朗读检查描述不同的有限子集,不能消除演绎者、性别、朗读方式、翻译或录音留存的混杂。本文不报告置信区间、语言速度排名、因果效应或商业预测。
- 来源:Google FLEURS,按 CC BY 4.0 提供。选取、计算、表格、编辑解读和译文,均为 Influence IQ 的改编,不表示获得数据集作者背书。公开包重新分发派生数字汇总和代码,不分发原始音频或文本。显示舍入,不改变精确来源计数或共有录音总体。
英文文章是所有语言版本的源文。每个版本都报告相同、固定的 FLEURS 测试录音和译文材料;文章语言不会产生关于新市场的证据。分析、解释和译文由 Influence IQ 负责。