播客片段再次做响度标准化前,先测量
在这项包含 72 条片段的个案研究中,检查已有导出文件并修复其中 9 条,与对全部 72 条做响度标准化达到了相同的交付限值。代价包括额外导出 9 次。
我们先在实验室对每期完整节目做响度标准化,再比较了 6 期 HPR 节目中的 72 条固定片段。这些节目发布于 2026 年 10 月 8–21 日。
摘要
整期节目完成母带处理后,创作者还应对每条播客片段再次做响度标准化吗?我们使用 6 期已发布 HPR 节目中的 72 条固定片段,比较了 3 种工作流;片段时长为 15、30 和 60 秒。复用整期母版时,63 个导出文件明确符合我们的响度和真峰值限值,7 个明确不达标,另有 2 个属于临界情况。
逐段标准化和先测量已有导出文件再选择性修复,都得到了 72 个符合限值的最终文件。选择性修复需要 9 次标准化和 81 次导出;逐段标准化需要 72 次标准化和 72 次导出。选择性修复的逐窗口原生处理实际耗时中位数之和为 64.0 秒,逐段标准化则为 108.6 秒。这项有限测试支持依据最终导出文件决定保留还是修复;它没有估算听众反应,也没有估算剪辑人员完整的制作时间。
你已完成一期播客,并准备好音频母版。负责发布的同事现在需要一些短片段。整期节目的响度已设定好,但新文件只包含其中很小一部分。每个剪切片段都需要再次标准化,还是有些导出文件可以保留从母版继承的音频?
我们通过 3 种实际工作流检验了这个选择:复用母版、逐段标准化,或测量每个已有导出文件,仅修复未明确符合所选限值的文件。比较包含了每条路径所需的检查和替代导出,因此不会仅凭少做一次标准化就认定节省了工作量。
本批次的大多数导出文件可以保留。按所选规则,9 条需要修复。先检查与逐段标准化得到了相同数量的达标最终文件,标准化操作更少,但导出次数更多。对于创作者或小型企业,这关系到如何准备并批准交给下一位同事的文件。
从一期完整节目得到多个短文件
以最终导出文件作为决策依据
整期节目可以达到整体响度目标,而其中一条短片段却超出限值。综合响度概括的是测量区间内的音频;改变区间,也就改变了被概括的内容。在短片段中,轻声交谈、较响的段落或停顿所占的比例,可能与整期节目不同。
我们使用了 2 项交付测量指标。这里以 LUFS 表示的综合响度,依据测量器的加权及门限规则描述整条片段的电平。真峰值估算数字采样点之间的峰值。通过一项检查并不证明另一项也通过;两者都不是对语音清晰度、噪声或剪辑质量的听感评估。
我们参考了 Apple 的播客建议:整体响度约为 −16,容差为 ±1,真峰值不高于 −1。Apple 用 LKFS 表述响度建议,我们的 FFmpeg 测量器则报告 LUFS。本次测试采用 −17 至 −15 LUFS 的交付区间,以及 −1 dBTP 的真峰值上限。这些是本次比较所选的限值,不是所有社交平台的要求。[3]
整期节目的处理目标为 −16 LUFS 和 −1.5 dBTP。随后,3 种工作流都从这份整期母版中截取相同的固定片段。每个最终文件均为 M4A 容器中的立体声 AAC,码率 192 kbps,采样率 48 kHz。我们测量了解码后的导出文件,因此结果描述的是工作流产出的文件,而不只是进入编码器的音频。
复用工作流导出并检查每条剪切片段。逐段标准化工作流先对每条片段做响度标准化,再导出并检查。先测量再修复工作流从复用导出文件开始,达标则保留,否则修复。因此,3 种工作流都包含最终交付检查。
相同 72 个窗口的最终交付结果
每种工作流都使用相同整期母版中的全部 72 个固定窗口。数量描述的是不同窗口;计时重复运行不算额外片段。
| 工作流 | 明确达标 | 明确不达标 | 临界情况 |
|---|---|---|---|
| 复用母版 | 63 | 7 | 2 |
| 逐段标准化 | 72 | 0 | 0 |
| 先测量,再修复 | 72 | 0 | 0 |
用 9 次修复替代 72 次标准化
直接从整期母版导出的 72 个文件中,63 个明确符合两项交付限值。另有 7 个明确超出至少一项限值。其余 2 个过于接近边界,测量器显示的精度不足以明确判定达标或不达标。我们保留了这第 3 类,没有将它们当成已确认的不达标文件。
选择性工作流修复了 7 个明确不达标文件和 2 个临界情况文件。其全部 72 个最终导出文件都符合保守达标规则。逐段标准化同样产出了 72 个符合该规则的最终文件。区别在于再次处理了多少音频:选择性工作流处理了 9 条,而逐段标准化处理了全部 72 条。
这种节省伴随着额外导出。选择性修复先产出 72 个文件,再替换其中 9 个,总计导出 81 次。逐段标准化导出 72 次。创作者在两者间作选择时,需要同时考虑这两个数字。标准化操作更少,并不自动意味着写入文件更少或总处理量更低。
每次修复时,我们都返回整期母版中的原始无损剪切片段。先为标准化测量该片段,再执行第二遍处理,导出替代 AAC 文件并检查。我们没有对已编码的 AAC 文件做响度标准化,也没有用其测量值来设定另一份 PCM 输入的增益。
先检查也有处理成本
即使包含额外导出和检查,选择性工作流测得的处理时间仍少于逐段标准化。逐窗口实际耗时中位数之和分别为:复用 52.3 秒、逐段标准化 108.6 秒、先测量再修复 64.0 秒。CPU 时间的顺序相同,分别为 56.3、120.1 和 69.3 秒。
这些总值包含每种工作流所需的 FFmpeg 和 ffprobe 进程:导出、读取文件属性、为质量检查而解码、为标准化而扫描 PCM,以及导出任何替代文件。在选择性工作流中,即使文件后来需要修复,首次导出和检查也计入成本;第二次导出和检查同样计入。
每个窗口都在每种工作流中运行了 3 次,并轮换执行顺序。我们先取每个窗口处理时间的中位数,再将这 72 个中位数相加。因此,表格展示的是逐窗口中位数之和,不是实际观测的 1 批制作任务的总耗时。648 次执行是相同的 72 个窗口在 3 种工作流中的计时重复运行,不是 648 条不同片段。
测量在 1 台 Apple M4 电脑上使用 1 个工作进程完成。范围包括 FFmpeg 和 ffprobe 的原生处理,以及进程启动;不包括 Python 哈希计算与序列化、整期母版和剪切片段的公共准备步骤,也不包括人们选择、审核或交接片段的时间。这些数据不是剪辑人员完整工作时间的估计。
这一范围会影响实际选择。如果团队的导出系统本就测量最终文件,可以依据结果决定哪些片段需要再次标准化。如果团队必须另开工具并手动管理替代文件,所面对的取舍可能不同。我们的处理总值没有为这些手工作业定价,也没有证明其他剪辑人员或设备会有怎样的表现。
选择性修复减少了标准化操作,但增加了导出
1 组 72 个窗口的实际操作;计时列将各窗口在 Apple M4 上使用 1 个工作进程执行 3 次的中位数相加。
| 工作流 | 标准化操作次数 | AAC 导出次数 | 原生处理实际耗时(秒) | 原生处理 CPU 时间(秒) |
|---|---|---|---|---|
| 复用母版 | 0 | 72 | 52.3 | 56.3 |
| 逐段标准化 | 72 | 72 | 108.6 | 120.1 |
| 先测量,再修复 | 9 | 81 | 64.0 | 69.3 |
本批次的 15 秒片段需要更多修复
每种时长的分母相同:均为 24 个窗口,来自 6 期节目的各 4 个位置。复用时,15 秒片段中有 19 条达标,30 秒和 60 秒片段中各有 22 条达标。对应送去修复的数量为 5、2 和 2 条。
较长片段需要修复的原因不同。全部 5 条 15 秒片段及 2 条 30 秒片段都明确不符合所选限值。剩余的 2 条 60 秒片段属于临界情况。将它们列为修复对象,是在结果出来前确定的工作流选择,并不证明它们都明确超出了交付区间。
片段围绕相同中心嵌套截取。15 秒片段位于 30 秒片段内,30 秒片段又位于 60 秒片段内。这些是来自相同节目的相关联片段。表格描述的是本批次,不能据此确定 15 秒播客片段通常需要修复的概率。
全部 9 次修复集中在 2 期节目中:HPR Beer Garden 22 - Bitter 有 4 条,murph 的会议演讲节目有 5 条。其余 4 期节目各提供了 12 条复用即达标的片段。这样的集中分布意味着,不宜用单个总体百分比对下一期节目作保证。即使使用相同导出设置,团队也可能遇到无需修复的批次,或需要多次修复的批次。
24 条最短片段中,5 条送去修复
每种时长均包含 6 期节目的各 4 个固定中心。较长窗口围绕相同中心截取,因此这些片段相互关联。
| 片段时长 | 测试窗口数 | 复用时明确达标 | 送去修复 |
|---|---|---|---|
| 15 秒 | 24 | 19 | 5 |
| 30 秒 | 24 | 22 | 2 |
| 60 秒 | 24 | 22 | 2 |
用 1 期演讲节目说明交接
已发布节目“murph gives a presentation talk about Hacker Public Radio at the OLF conference”提供了 12 条固定剪切片段。HPR 于 2026 年 10 月 15 日发布该节目;节目页面说明,这场会议演讲发生在 2025 年 12 月。我们使用了包含品牌标识内容的完整已发布播客文件,随后为本次测试准备整期母版。[6]
对这 12 条片段,复用工作流产出了 7 个明确达标文件、4 个明确不达标文件和 1 个临界情况文件。按选择性规则,7 个达标文件予以保留,其余 5 条片段返回无损源文件,做响度标准化并导出替代文件。最终交付集合包含 12 个达标文件,共进行了 5 次标准化和 17 次导出。
对相同的 12 条片段逐段标准化,同样得到了 12 个达标文件,进行了 12 次标准化和 12 次导出。因此,选择性路径避免了对 7 条片段再次处理,但额外导出了 5 次。这期节目具体呈现了整批结果中的取舍,并未假定标准化次数本身就能衡量工作量。
如果创作者或企业将这组文件交给负责发布的同事,有用的完成说明应指出 12 个最终文件、采用的交付限值,以及其中哪 5 个文件替换了先前的导出版本。如果文件夹同时放着原始版和修复版,却没有明确选定最终文件,就会产生另一个交接问题;响度测量无法解决它。
这些数量描述的是我们在实验室处理后的节目版本,不是对演讲者、原始制作或节目是否适合听众的评判。我们没有根据说话内容或听感挑选片段。在测量任何响度结果前,截取位置就已固定。
检查同事将要发布的文件
对于已完成母带处理的节目,首先要确定片段的交付规格。在解读“达标”标签前,先约定响度区间、峰值上限、文件格式及目标平台。如果客户或平台采用其他规格,这些数量不能原样套用。
随后,依据导出文件决定保留还是修复。在本次测试的选择性工作流中,剪辑人员可以保留明确符合两项限值的文件。明确不达标或过于接近边界的结果,会触发修复:返回原始无损剪切片段,导出替代文件,再次检查。这条规则明确了不确定结果的处理方式,而不是留下一个没有解释的绿灯。
最终检查应在最后一次影响交付音频的更改之后进行。添加片头、音乐、淡入淡出或重新剪辑,都会生成与这里测量的文件不同的文件。不能将早期版本的结果继续沿用,仿佛它描述的是后来导出的版本。测量结果应与实际选定的交付文件保持对应。
交付说明应足够具体,让下一位同事可以使用:选定的文件、响度与峰值数值、采用的限值及判定状态。只写“已标准化”仅仅说明一个处理步骤,无法告诉负责发布的同事,最终编码文件是否经过测量,以及是否符合约定限值。
选择性处理与逐段标准化之间的选择,也取决于交接方式。这里选择性修复有用,是因为大多数已有导出文件可以保留,仅有 9 条需要替换。逐段标准化则让每条片段都走更简单的单次导出路径。两者在本批次达到了相同的实测交付结果,只是处理安排不同。
小团队可以选择工具能够顺畅支持的路径。证据支持先测量,再决定是否每条片段都需要再次标准化;它没有证明,为了节省几秒原生处理时间,就应该花几分钟管理文件。应将测得的技术取舍,与仍需完成的编辑工作分开考虑。
从节目剪切片段到已检查导出文件的 3 条路径
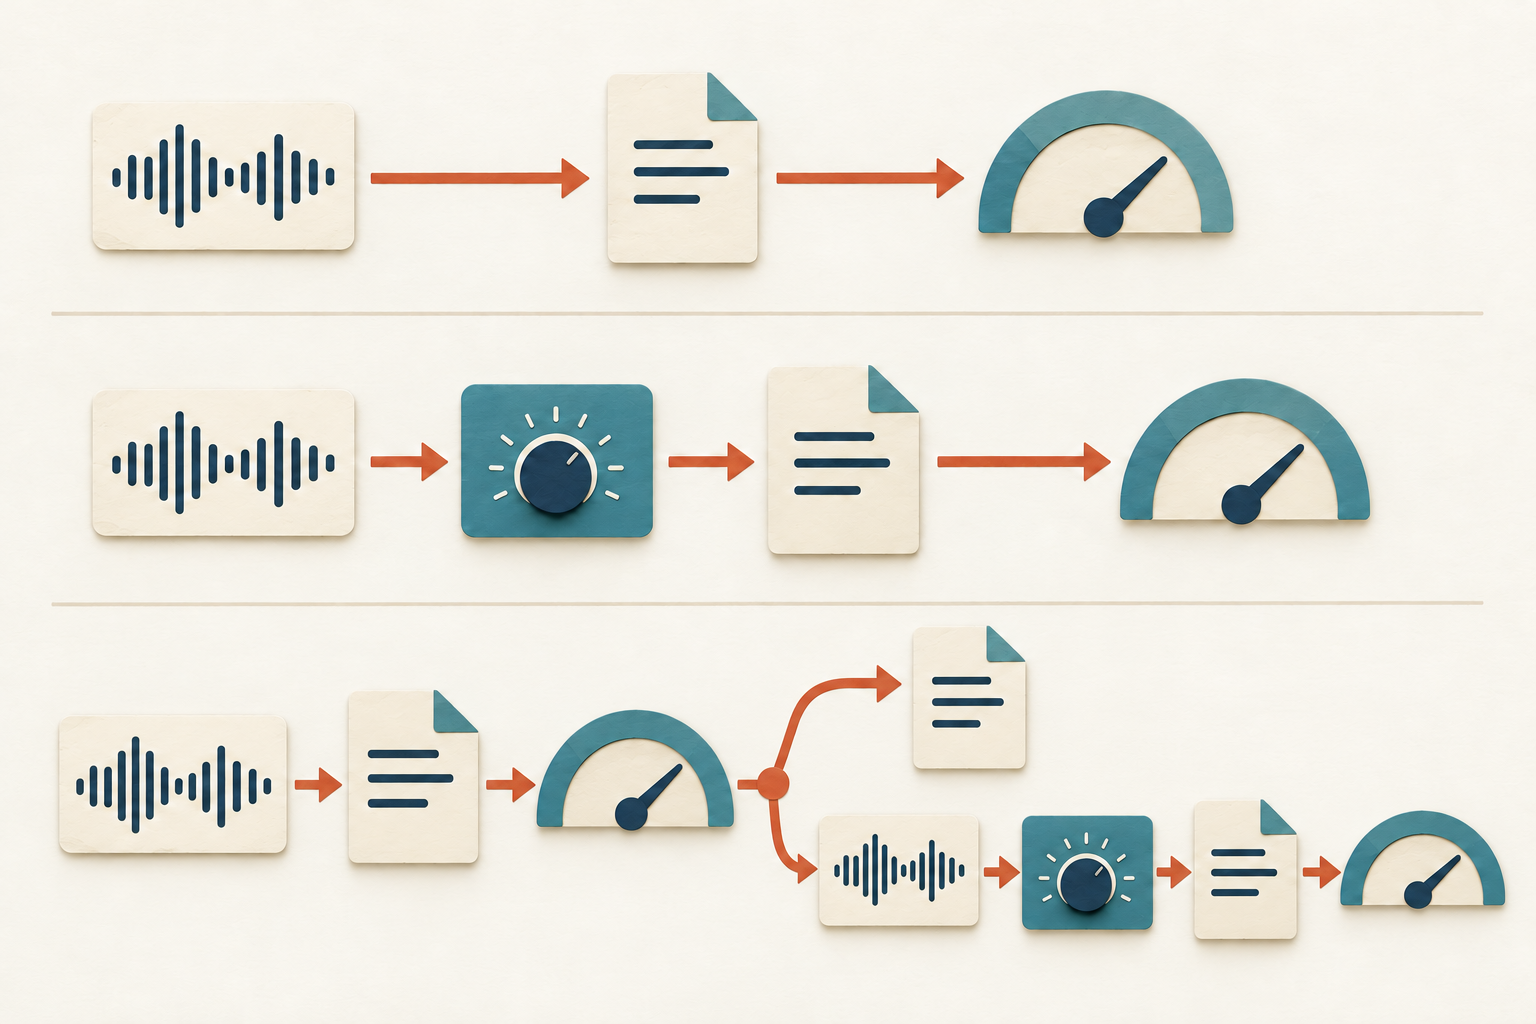
复用母版
导出原始剪切片段,再测量最终文件。
逐段标准化
测量 PCM 剪切片段,做响度标准化、导出,再检查最终文件。
先测量,再修复
检查已有导出文件。明确达标的文件予以保留;其他情况则返回原始 PCM 剪切片段,标准化、重新导出并再次检查。
如何比较这 72 条片段
我们选择了在 2026 年 10 月 23 日之前发布、且发布方页面标示时长为 20–60 分钟的最新 6 期完整 HPR 节目。它们的发布日期从 10 月 8 日至 10 月 21 日。入选条件在得到音频结果前已根据元数据确定。我们保留了包含品牌标识内容的完整已发布文件,并将实际解码时长与页面标示时长分别记录。[1][2]
这是针对 1 个社区科技播客的个案研究,不是播客或创作者的代表性样本。入选的 2 期节目是连续的 Beer Garden 圆桌讨论,参与者有重复。已发布源文件此前已做过制作处理,我们没有重建其具体过程。整期响度标准化是我们额外增加的实验室步骤,并非对原始麦克风录音的模拟。
我们使用 FFmpeg 8.1.2 的双遍 loudnorm 处理每期完整节目,目标为 −16 LUFS 和 −1.5 dBTP,随后保留 48 kHz 立体声 PCM 母版。LRA 设为 50,以避免默认的 7-LU 设置施加这一独立目标;响度范围并不是短片段的结果指标。操作记录保留了实际采用的线性或动态标准化模式。[4]
对每期节目,我们将片段中心精确设在解码后采样总数的 20%、40%、60% 和 80% 处。每个中心截取嵌套的 15、30 和 60 秒窗口,每期节目得到 12 个窗口,总共 72 个。所有工作流使用相同母版中的相同剪切片段。截取位置并非依据说话者、内容、静音或实测响度选择。
最终判定使用原生 ebur128 测量器,测量解码后实际呈现的 AAC 音频。我们处理了 AAC 起始延迟及尾部填充,使每次测量覆盖预定的采样数。测量器最终摘要将综合响度和真峰值显示至 0.1。为考虑显示舍入,我们将每个读数视为向两侧各延伸 0.05 的区间;这是舍入余量,不是对测量准确度的声明。[5]
只有当整个响度舍入区间都在 −17 至 −15 LUFS 内,且峰值区间上端不高于 −1 dBTP 时,才判定达标。明确超出至少一项限值的,判定为明确不达标;其他情况标记为临界,并由选择性工作流修复。共享下载包提供逐窗口技术结果、处理定义、计算代码及测量器差异核对。包内不含源音频或衍生音频。[7]
无需注册。共享 ZIP 包含技术测量值、原始英文计算说明及翻译后的解释。文章正文、图表标签及展示结果的 CSV 均提供与文章相同的语言版本。该包依据所提供的测量值复算所报告的计算结果,不会重新运行完整音频流程。包内不含源音频或衍生音频。
来源与备注
- Hacker Public Radio 节目存档。入选节目:hpr4753,HPR Beer Garden 22 - Bitter,Kevie,10 月 21 日;hpr4749,murph 的 OLF 演讲,murph,10 月 15 日;hpr4748,Programmable Logic Controls - Episode 5,Whiskeyjack,10 月 14 日;hpr4747,UNIX Curio #13 - Replacements for cat,Vance,10 月 13 日;hpr4745,BruCON interview 1: The BruCON organization,Kristoff,10 月 9 日;hpr4744,HPR Beer Garden 21 - Mild,Kevie,10 月 8 日。所有日期均为 2026 年。各期节目链接及文件标识列于分析包中。
- Hacker Public Radio 投稿政策。发布方描述了发布过程中的转换,包括格式转换及自动添加片头/片尾,并规定节目采用 Creative Commons Attribution-ShareAlike 4.0 许可。本研究分析完整的已发布文件,不分发这些文件或其衍生片段。
- Apple Podcasts for Creators,《音频要求》中的“音频电平”。建议整体响度约为 −16 dB LKFS,容差 ±1 dB,真峰值不高于 −1 dB FS,并在编码前进行预处理。这是本研究采用的播客参考,不是所有社交平台通用的交付规格。
- FFmpeg 8.1.2 滤镜文档,loudnorm。介绍单遍/双遍及线性/动态标准化。实验使用原生 FFmpeg 8.1.2;设置及实际操作模式保留在包中。
- FFmpeg 8.1.2 ebur128 源码,最终摘要格式。综合响度和真峰值显示至 1 位小数。本研究采用保守的 3 类判定规则处理这一显示精度,不是对认证测量器准确度的声明。最终交付判定与标准化器自身的输入/输出统计相互独立。
- HPR 节目 hpr4749,murph gives a presentation talk about Hacker Public Radio at the OLF conference。主持人 murph;发布于 2026 年 10 月 15 日。源页面说明,演讲发生于 2025 年 12 月。节目标题及发布日期用于标识来源,并非对其原始音频制作的评估。
- Influence IQ 计算包。包含汇总及逐窗口技术测量值、来源署名、固定的入选/窗口规则、原生处理时间定义、计算代码及测量器差异核对。它根据所提供的测量值复算所报告的计算结果,不是可移植的完整音频处理流程重跑包。包内不含原始或衍生音频、语音文本或私有操作记录。
每个语言版本描述的都是同一项包含 6 期 HPR 节目的个案研究。翻译不会生成针对其他国家、播客总体或社交平台的研究结果。