电商商品展示:检验你的产品位置假设
一项包含 10 本书的历史实验表明,简单的位置调整可能遗漏部分模式,也展示了如何在比较产品卡片前检验这一假设。
对 Compiani、Morozov 与 Seiler 已公开的 2024 年选书实验所作的原创再分析。
摘要
企业在判断哪个产品或服务更有吸引力之前,需要考虑它们各自出现的位置。我们使用一项已公开、包含 10 本电子书的 2024 年实验,检验了 2 种处理位置的方法。相较于列表每下移一位都作相同调整,为每个位置单独调整,整体上能更好地预测选择。但它在部分位置的准确度更低,因此必须查看完整比较。
两个模型使用相同的书籍及价格信息。我们用 6,176 名参与者拟合模型,再用另外 3,088 人检查预测。选择是假设性的,且每个人都必须选一本书。对比较产品卡片的企业和创作者而言,启示是在把结果归因于产品或服务之前,先检验位置假设。这项研究不估计销量增长,也不能确定最佳产品顺序。
假设页面顶部的产品获得最多点击。是它更有吸引力,还是列表位置帮了忙?企业在改写其他卡片、给看似较弱的产品打折,或调整产品组合之前,需要一个有用的答案。
处理位置影响听起来很直接,直到你问具体怎么处理:列表每下移一位,是否都应作相同调整?我们用一项历史实验,将这种简单方法与更灵活的方法比较,再用未参与模型拟合的参与者检验两者。
相同产品,不同位置
产品位置比较应告诉你什么?
产品卡片比较应帮助你区分产品本身与其展示方式。如果一个产品通常排第一,另一个通常排最后,仅凭各自总数无法回答购物者是否更喜欢其中一个。
我们检验的简单方法,对列表每下移一位,都给模型底层的偏好得分作相同调整。有用的问题是:与允许不同位置有不同调整的方法相比,它能否足够好地预测选择?
我们利用一项已公开的选书实验,检验了这 2 种方法。结果有助于企业和创作者思考,如何比较产品集合页或数字店面上的产品。它提供的是检查测量假设的方法,而非规定畅销产品应放在哪里。
同一产品出现在多个位置时,这点尤其重要。创作者可能在产品集合页与上新页面突出展示同一份下载资料,零售商也可能改变分类列表的顺序。产品、价格、受众及展示方式可能一起变化。位置调整是对其中一部分比较所作的假设,值得单独检查。
选书实验中,人们选择了什么?
Giovanni Compiani、Ilya Morozov 与 Stephan Seiler 请通过 Prolific 招募的参与者,从顺序及价格均随机化的 10 本电子书中作假设性选择。参与者必须选一本,没有什么都不买的选项。我们采用每份保留提交记录中的第一个任务,而非之后移除已选书的任务。[1]
作者已经报告了对位置及价格的反应。他们更广泛的研究考察文本和图像如何帮助估计产品替代关系。我们的问题更具体:替换单一位置项,能否改善对未参与模型拟合者的选择预测?
遵循原始纳入规则后,保留 9,265 份提交记录,包含 9,264 个不同的 Prolific 参与者 ID,其中 1 个 ID 出现 2 次。我们将这两份记录放在同一组,并给予这位参与者与其他每位参与者相同的总权重。一份提交记录不自动等于一个不同的人,第一个任务也不一定是此人首次接触该实验。[2][3]
保留来源记录的日期为 2024 年 6 月 11 日至 6 月 26 日,手稿则写 6 月 14–27 日。我们披露这个差异,不按日期排除记录。审阅材料未能确认国家与年龄纳入条件;这些不是对美国购物者或其他国家总体的估计。[1][2]
整个比较过程中,同一参与者的记录始终在一起
按原作者纳入规则选择的首任务提交;保留来源记录日期为 2024 年 6 月 11–26 日。
| 组 | 参与者数(按平台 ID) | 保留提交数 |
|---|---|---|
| 全部保留记录 | 9,264 | 9,265 |
| 训练 | 6,176 | 6,176 |
| 留出评估 | 3,088 | 3,089 |
哪个位置模型能更好地预测留出组的选择?
按预先指定的评分指标,灵活位置模型更好地预测了留出组的选择。两个模型都考虑提供哪本书及展示价格,仅在位置的表示方式上不同。
基准模型用 1 个共同系数,表示列表每下移一位的调整。灵活模型则相对于第一个位置,为位置 2 至 10 分别设置调整项。它有更大自由度,也有更多参数需要估计。仅在自身训练数据上拟合得更好,不能据此确定比较结果。
因此,我们用 6,176 名参与者拟合两个模型,再用其余 3,088 人评估。每位参与者的全部提交记录始终留在划分的同一侧。测试组包含那位重复参与者,因此共有 3,089 份提交记录。
我们使用负对数评分比较预测。模型给一个人实际选择的选项分配较高概率时,受到的惩罚较小;给该选项分配极低概率时,惩罚较大。平均负对数评分越低越好。
留出组平均值为:基准模型 2.2260,灵活模型 2.2154,单位为自然对数单位,也称 nats。这些是预测评分,不是答对的百分比。训练与测试评分一起展示,使比较不只依赖更容易完成的任务——描述模型已经见过的数据。
2 个模型,在同一批参与者上评估
选定的 2024 年 10 本书实验首任务选择。训练:6,176 名参与者及同等份数的提交。测试:3,088 名参与者、3,089 份提交。
| 位置模型 | 训练评分(nats) | 留出组评分(nats) |
|---|---|---|
| 1 个线性位置项 | 2.2046 | 2.2260 |
| 各位置单独设项 | 2.1899 | 2.2154 |
配对改善为每位参与者 0.0106 nats,近似 95% 区间为 0.0044 至 0.0168。这里,正的改善值有利于灵活模型。在这一评分尺度上,改善较小,但区间高于 0。[4]
这个区间将 2 个已拟合模型视为固定,并假定参与者组相互独立。它不包含换用另一训练样本拟合模型的不确定性。结果支持在这项选定的历史任务中预测有所改善,却不能将评分差异转化为销量增长。
灵活模型改善了留出组对数评分
选定的历史 10 本书任务中,3,088 名测试参与者的配对比较。
| 比较 | 改善(nats) | 95% 区间:下限(nats) | 95% 区间:上限(nats) |
|---|---|---|---|
| 对数评分:灵活模型减基准模型 | 0.0106 | 0.0044 | 0.0168 |
2 个模型在哪些位置偏离了实际观察到的选择?
完整的位置比较说明,为什么总体评分应配有细节。我们将每个位置观察到的选择比例,与各模型赋予该位置的平均概率比较。这些是留出组内按参与者等权计算的平均值,不是点击率。
位置 1 观察到的比例为 17.16%,基准模型预测 14.64%,灵活模型预测 17.73%。位置 10 观察到的比例为 9.18%,两个模型分别预测 6.37% 和 8.74%。在这份特定列表的两端,灵活模型都更接近观察值。
全部 10 个位置的观察与预测选择
留出组:已公开 2024 年实验中的 3,088 名参与者及 3,089 份首任务提交。
| 位置 | 观察到的选择比例 | 基准模型平均概率 | 灵活模型平均概率 | 选择该位置的提交数 |
|---|---|---|---|---|
| 位置 1 | 17.16% | 14.64% | 17.73% | 530 |
| 位置 2 | 13.60% | 13.20% | 14.84% | 420 |
| 位置 3 | 9.91% | 12.06% | 9.74% | 306 |
| 位置 4 | 10.91% | 11.21% | 9.26% | 337 |
| 位置 5 | 9.20% | 10.09% | 8.94% | 284 |
| 位置 6 | 7.08% | 9.25% | 8.01% | 219 |
| 位置 7 | 8.00% | 8.44% | 7.57% | 247 |
| 位置 8 | 7.12% | 7.67% | 7.47% | 220 |
| 位置 9 | 7.84% | 7.08% | 7.69% | 242 |
| 位置 10 | 9.18% | 6.37% | 8.74% | 284 |
灵活模型并非处处更接近。位置 4 观察到的比例为 10.91%,基准模型预测 11.21%,灵活模型预测 9.26%。额外灵活性改善了整体留出组评分,却在这个位置留下更大偏差。
下表展示观察比例减去预测比例。差值为正,表示模型低估了该位置被选择的比例;差值为负,则表示高估。展示全部 10 个位置,可以避免用一个看起来不错的端点代替完整比较。
两个模型与观察选择的差距
相同 3,088 名测试参与者中,10 个位置各自的观察选择比例减去平均预测概率。
| 位置 | 观察值减基准模型 | 观察值减灵活模型 |
|---|---|---|
| 位置 1 | 2.52 百分点 | -0.57 百分点 |
| 位置 2 | 0.41 百分点 | -1.24 百分点 |
| 位置 3 | -2.15 百分点 | 0.17 百分点 |
| 位置 4 | -0.29 百分点 | 1.65 百分点 |
| 位置 5 | -0.89 百分点 | 0.26 百分点 |
| 位置 6 | -2.17 百分点 | -0.93 百分点 |
| 位置 7 | -0.44 百分点 | 0.43 百分点 |
| 位置 8 | -0.55 百分点 | -0.35 百分点 |
| 位置 9 | 0.76 百分点 | 0.14 百分点 |
| 位置 10 | 2.81 百分点 | 0.44 百分点 |
这些位置数据属于描述性结果,不对各位置单独提出显著性主张。实验没有测量眼动或注意力,本分析也不确定位置之间为何不同。观察比例呈曲线分布,本身也不能否定基准模型:它的位置项与模型底层偏好得分呈线性关系,而非与选择百分比呈线性关系。
仅将首尾位置的观察比例相减,回答的是另一个问题。这些比例汇总了不同产品及价格下的选择。两个已拟合模型都先考虑书籍身份和价格,再为 10 个选项分配概率。端点差异或模型比较,都不能告诉你在真实商店移动某件产品会发生什么。
可直接使用的产品位置测量模板
比较产品或服务前,先写一份测量简报。以下模板无须注册,仅作示例。它应用了研究中检查假设的启示,并不承诺同一模型适合你的店面。
决定:“我们需要为[页面或活动]在[时期]决定[要作的产品比较或展示调整]。”先明确决定,再选取有利指标。
结果:“我们将衡量[选择、点击、加入购物车或购买]。”选择记录确实能支持的结果指标,同时保留所提供的备选产品、顺序及展示价格。强制选择结果应与购买结果分开。
单位:“我们的单位是[参与者或其他明确定义的单位]。重复访问或提交将按[规则]处理。”评估对新参与者的预测时,将同一个人的观察记录放在一起。不要将匿名会话标识符当作独立个人的证明。
比较:“两个模型将使用相同产品、价格信息及符合条件的观察记录,仅在[位置假设]上不同。”简单方法与更灵活的方法都要明确说明。
评估:“我们将在拟合前保留[明确界定的组],并比较[指定评分指标]。我们将展示所有位置。”在看到结果之前,决定如何报告尚无定论或更差的结果。
用途:“这个结果将为[测量决定]提供参考。在作出[商业决定]之前,仍需有关[此处未测量的商业结果]的证据。”最后一句,避免预测练习悄然变成收入预测。
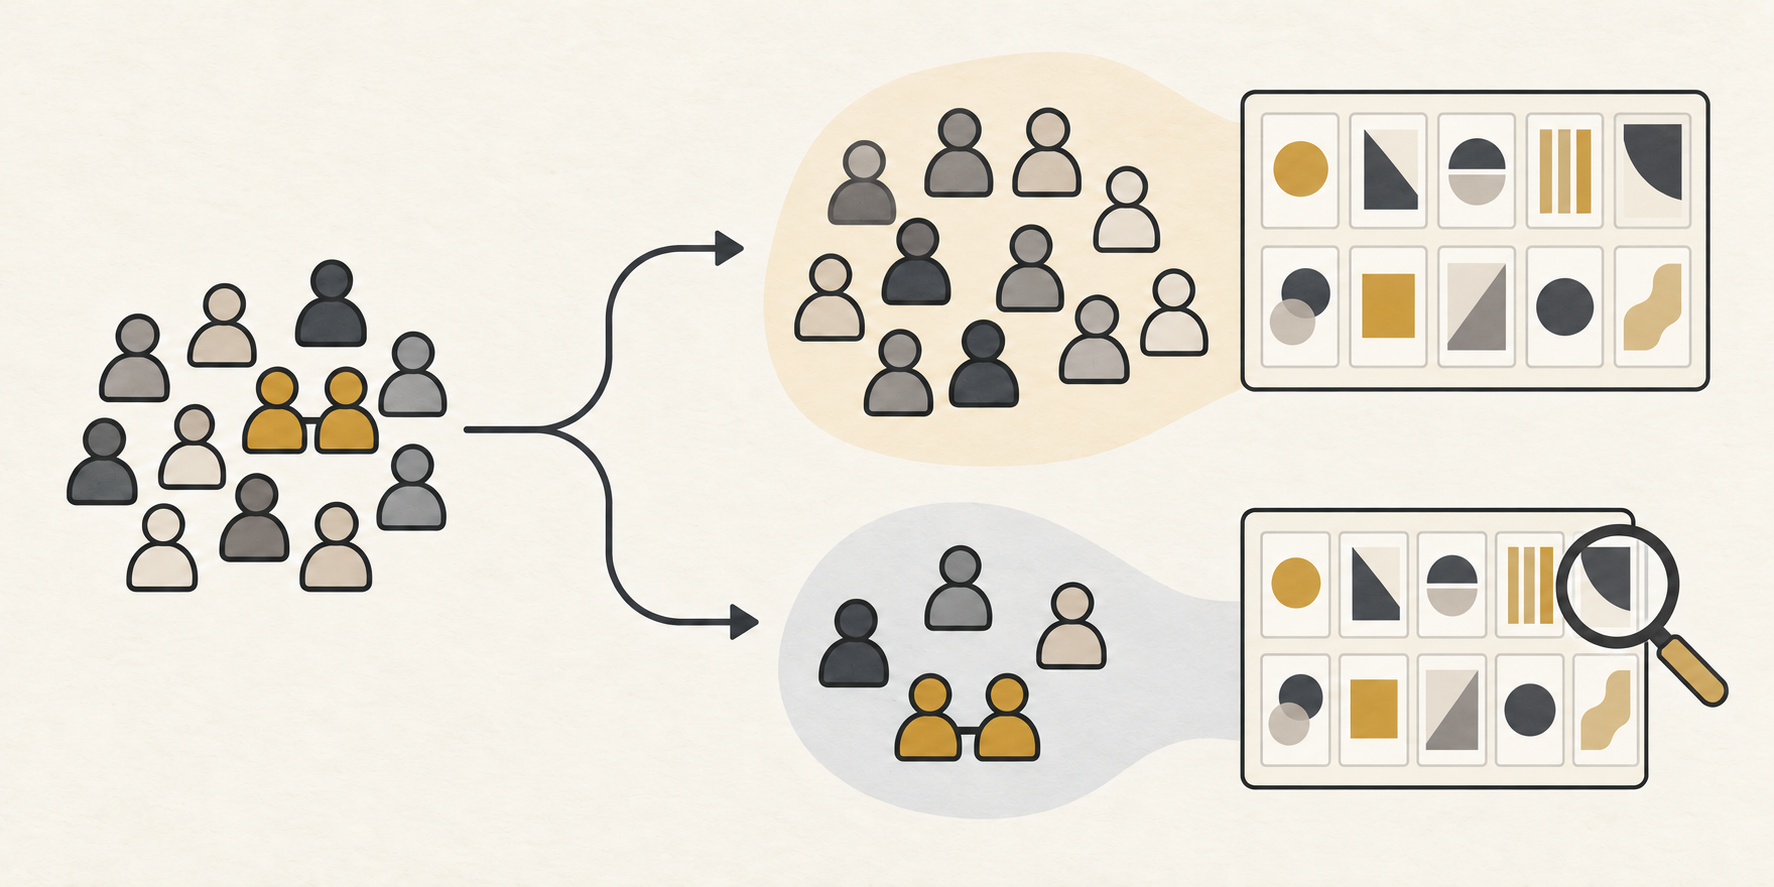
让同一参与者始终位于测试划分的同一侧
定义比较
明确产品、位置、结果及观测单位。
保留评估组
将每位参与者的提交记录放在一起。
检查完整结果
比较预测,并展示所有位置,包括更差的结果。
填写示例:创作者比较数字产品
设想一位虚构创作者,销售写作练习册、工作坊及组合包。组合包在上新页面顶部展示,并获得最多点击。创作者正考虑改写其他产品介绍。
测量简报改变了眼前的问题。观察结果是点击,不是销售。现有记录需要显示展示了哪些产品或服务、顺序如何、价格多少。如果组合包始终占据第一位,就无法从这些记录中清楚区分组合包本身与该位置。
创作者填好的简报可以写:“我们想知道,处理位置的方法是否能预测新访客的点击。我们将比较相同产品及价格信息,将重复观察放在一起,并报告完整位置比较。我们不会根据点击记录声称购买情况。”这是虚构的测量问题示例,不是提出预期结果。
合理的下一步,是规划一项有足够变化、能区分产品与位置的比较,同时保留相同结果定义。创作者随后可以在保留组上,比较简单位置调整与更灵活的方法。这将是针对该页面的新研究,选书实验并未提供其预期点击率。
如果灵活方法更好地预测保留组,创作者就有理由重新审视报告如何处理位置。但这仍不能说明移动组合包会增加收入。商业决定需要有关实际展示变化及企业关注结果的证据。
如果比较尚无定论,创作者应如实说明。更灵活不自动意味着是更好的商业工具。实际收益是过程更清楚:先了解记录能区分什么,检验测量假设,再决定是否需要另一项实验。
Influence IQ 如何计算这一比较?
我们使用作者经编辑的回答发布文件及原始选择规则。前 553 条试点或测试记录,按其在文件中的固定位置排除。其余范围包含 10,775 份提交记录。理解检查筛选后剩余 9,344 份,完成状态筛选后剩余 9,265 份。[2]
同意、已完成状态及至少 60 秒时长规则,在各自步骤未额外排除任何提交。完成与时长属于接触实验后的筛选,因此保留群体是经过选择的样本。
Prolific 参与者 ID 定义分组。确定性的哈希划分,不使用选择结果,将 2/3 的组分配到训练,其余到测试。每组内保留的各份首任务提交,均分该参与者的贡献。拟合、评分及位置表格使用相同权重。[3]
两个模型均为无惩罚的多项 logit 模型,包含 9 个书籍指示变量及 1 个线性价格项。基准模型加上 1 个线性位置项,共 11 个参数;灵活模型加上 9 个位置指示变量,共 19 个参数。位置 1 及数值最小的产品 ID 为参照类别。全部符合条件的选择集包含相同的 10 个产品,并已检查所选 ID、价格及位置是否一致。
我们在训练组拟合模型,保留拟合系数,再对测试选择评分。区间使用参与者配对评分差的标准差、3,088 个参与者单位及 3,087 个自由度。除非满足使其精确成立的正态评分假设,否则它是近似 Student-t 区间。全部 10 个位置比较仍为描述性结果。[4]
基准模型的主要优化器返回了数值警告,但仍满足拟合前指定的每项精度条件,包括第二起点比较。我们保留该原始拟合,详细诊断包含在复现材料中。[5]
下载提供展示结果、原创分析代码及汇总数值输出,不含来源回答行、参与者 ID 或书籍图像素材。来源数据请另从作者发布文件获取。本次再分析及其解释由 Influence IQ 负责。
CSV 使用本页语言。包内包含原创计算代码、方法文档译文及汇总结果,不含来源回答行或书籍素材;请另从作者发布文件获取数据。
来源与注释
- Compiani、Morozov 与 Seiler,Demand Estimation with Text and Image Data,手稿第 4 版,2026 年 2 月 17 日,第 3 节及附录 C。作者已研究对位置及价格的反应。我们对留出参与者的比较,是范围更具体的原创再分析。
- 作者的 DeepLogitReplication 发布版本,提交为 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec。我们遵循经编辑回答文件中,原始按位置设定的试点截止点及作者纳入规则。保留来源日期为 2024 年 6 月 11–26 日,与手稿所述 6 月 14–27 日不同;日期不决定是否纳入。
- Prolific 区分参与者 ID、研究标识符及提交标识符。我们保留确切参与者 ID 用于分组。这些 ID 本身不能核实每个 ID 代表不同的人,也不能确定某份保留提交是此人首次接触实验。
- Influence IQ 的预定比较,先在每位测试参与者内部平均“灵活模型减基准模型”的对数概率差,再跨参与者平均。95% 区间为均值加减误差幅度;误差幅度等于 Student-t 临界值乘以参与者差值的标准差,再除以 3,088 的平方根。它假定参与者组相互独立,以固定的训练拟合为条件,并排除训练拟合不确定性;精确成立要求参与者差值独立同分布、服从正态且方差相同。
- 基准模型从零起点拟合时返回精度警告。最大绝对平均梯度为 3.12×10⁻⁹,Newton 递减量为 2.50×10⁻⁸,2 起点之间最大对数概率差为 7.46×10⁻⁸,分别低于预定界限 10⁻⁸、10⁻⁶ 和 10⁻⁷。两个模型也均满足正曲率及目标函数一致条件。我们保留了主要零起点系数。
这篇英文文章为来源版本。各语言版本描述同一历史实验,并非针对不同国家的购物估计。