解读电商客户旅程,不只看首个产品
一项历史书店实验表明:首个产品不同,与所选产品没有记录,需要分别解释。
基于 Ilya Morozov 与 Anna Tuchman 在 2022 年开展的美国 MTurk 书店实验公开数据的原创分析。结果指报告的选书,而非已履约购买。
摘要
首个记录产品与所选产品不同时,事件历史中仍可能同时包含两者。我们分析了一项 2022 年带有奖励机制的书店实验:首个记录产品与报告选书不同的 3,165 名参与者中,3,048 人的已映射页面事件在某处仍包含所选书,占 96.3%。全部 11,460 名分析对象中,72.4% 的首个产品与选书一致,26.6% 的首个产品不同、但所选书有记录,1.0% 的所选书没有已映射记录。
实验让美国 MTurk 参与者从 100 本电子书中选书。首个记录事件并不能证明是首次关注,也不能证明发生在选择之前;报告选书也不等于已履约购买。这一结果有助于企业和创作者先分清产品历史中包含什么,再解释客户为何选择某件产品。它支持更具体地解读记录,并非商店转化基准,也不是广告影响的估计。
一份客户旅程报告将一个产品列为首个产品,将另一个列为所选产品。人们很容易据此编出完整故事:第一个产品丢掉了销售、引出了更好的选择,或吸引了不合适的访客。仅凭这两个信息,无法确定任何一种解释。
首先应问一个更简单的问题:所选产品是否出现在被分析的产品记录中的任何位置?这能区分两种历史:一种包含两个产品,另一种没有可识别的所选产品记录。无论企业销售大量产品,还是创作者只提供几件产品,这种区别都有用。
我们在一个细节异常丰富的公开书店数据集中考察了这个问题。主要发现是:大多数首个产品不一致的记录,仍包含可识别的所选书记录。少数没有该记录的案例需要单独解释,而数据仍无法完整解释其中原因。
产品记录与所选书是两条不同的证据
- 记录中包含的产品
- 报告选择的书
这项电商客户旅程研究衡量什么?
它衡量参与者捕获到的页面事件中,首个可识别产品与该参与者报告选书之间的关系。我们分析了 Ilya Morozov 与 Anna Tuchman 在 2022 年实验中的 11,460 名符合条件参与者。在线书店共有 100 本电子书。参与者居住在美国,通过 Amazon Mechanical Turk 招募。[1]
这是一项带有奖励机制的研究任务。参与者获得 $3 购书预算,且必须选书。书店任务结束后,他们另行选择:如果抽中履约,是更希望获得书及剩余预算,还是全额 $3 现金。每位参与者抽中履约的概率为 50%。我们的结果仅采用问卷中报告的选书,不使用那项独立偏好或履约信息。[2]
我们将报告的选择关联到匹配问卷时间范围内捕获的产品页面事件。“已映射事件”指标签能够匹配到实验目录中某本书的事件。“首个”指该时间范围内最早捕获、且没有歧义的产品事件。它无法确定某人最先注意到的产品、首次查看的产品,或决定之前的事件。该时间范围可能包含选择之后的事件。
原论文研究广告内容与搜索。我们合并实验条件,考察另一个描述性问题:当首个产品与所选书不同,所选书是否出现在其他捕获记录中?这个比较不估计广告效果,也不描述普通商店的转化率。
将首个产品与选择结果一起看,会有什么不同?
首个产品一致的参与者占分析对象的 72.4%,其余案例则对应 2 种不同情形。26.6% 的人首先出现的是另一个产品,而所选书也出现在已映射记录的某处;1.0% 的人首先出现另一个产品,但已映射记录中没有所选书。
书店分析对象的 3 种状态
首个已映射产品是否与报告的选择一致,以及所选书是否出现在已映射记录的任何位置。
| 记录中的选择状态 | 占指定组的比例 | 参与者 |
|---|---|---|
| 首个产品与所选书一致 | 72.4% | 8,295 |
| 首个产品不同;所选书有记录 | 26.6% | 3,048 |
| 首个产品不同;所选书无记录 | 1.0% | 117 |
表格中每位参与者只计数 1 次。3 行分别有 8,295、3,048 和 117 人,共用 11,460 这一分母。前 2 行都有所选书的记录,仅在该书是否也是首个可识别产品这一点上不同。
对审核产品流量的企业来说,这些区别会改变接下来要问的问题。首个产品不同,本身不意味着最终所选产品没有出现在事件历史中。同样,一致也不能说明首个产品导致了选择。在附加商业解释之前,这个比较只告诉我们 2 条信息如何对应。
销售多个产品的创作者也面临同样的解读问题。某人可能在活动中接触一件产品,却选择另一件。有用的报告应保留涉及的产品身份。没有支持特定结论的证据,就不应把每个不一致案例都归为产品页失败、辅助促成销售或客户流失。
首个产品不同,通常意味着所选书没有记录吗?
不是。首个记录产品与报告选择不同的 3,165 名参与者中,3,048 人的已映射页面事件在某处包含所选书,占这个不一致组的 96.3%。其余 117 人占该组的 3.7%。
首个产品不同的案例中,96.3% 仍包含所选产品
首个产品与报告选择不同的参与者中,所选书是否出现在已映射记录内。
| 已映射记录中的所选书 | 占指定组的比例 | 参与者 |
|---|---|---|
| 所选书出现在已映射记录中 | 96.3% | 3,048 |
| 所选书不在已映射记录中 | 3.7% | 117 |
这里的分母比上表更窄。96.3% 回答的是首个产品与所选产品不同的参与者的情况,并非占全部参与者、访客或购买者的比例。它也不表示 96.3% 的人在查看另一产品后完成了购买。
尽管所选书出现的时间与决定之间的先后关系未明,它的存在仍是有关记录的有用证据。这说明,将历史缩减为首个产品,会在多数不一致案例中丢弃一条与选择有关的可识别联系。更完整的记录可以将这种情形与看不到此类联系的情形区分开来。
这支持在分析中保留第 2 个字段:所选产品是否出现在规定事件时间范围内的任何位置。它不支持将收入贡献归给更早的产品。交易时间可靠的商店可以另行研究购买前的事件,但本实验匹配的问卷时间范围并没有提供经过验证的此类截止点。
记录中的产品数量为何会改变整体图景?
整体首个产品一致率合并了 2 类非常不同的记录历史。7,656 名记录仅映射到 1 个产品的参与者中,99.5% 报告选择了该产品;3,804 名有 2 个或以上不同已映射产品的参与者中,17.8% 选择了最先记录的产品。
已映射产品数量不同,首个产品一致率也不同
记录仅映射到 1 个产品,或映射到 2 个及以上不同产品时,各自的 3 种选择状态。
| 不同的已映射产品数量 | 首个产品与选择一致 | 首个产品不同;所选产品有记录 | 首个产品不同;所选产品无记录 | 组内人数 |
|---|---|---|---|---|
| 1 个已映射产品 | 99.5% | 0.0%此单元参与者少于 30 人定义决定的零值 | 0.5% | 7,656 |
| 2 个或以上已映射产品 | 17.8% | 80.1% | 2.1% | 3,804 |
只有 1 个产品的组需要谨慎解读。如果唯一的已映射产品与选择不同,所选产品就不可能同时出现在已映射集合中。因此,中间单元按定义恰好为 0。这不是该组从未考虑其他产品的证据;较高的一致率也不是一项关于果断购物者的独立发现。
在有 2 个或以上已映射产品的组中,80.1% 的首个产品不同,但所选书出现在记录其他位置;另有 2.1% 没有所选书的已映射事件。这些比例描述的是捕获到的产品身份,而非从浏览到购买的过程。
对报告而言,启示是将产品覆盖广度与主要一致率并列展示。以仅记录 1 个产品的历史为主的报告,与包含大量多产品历史的报告,回答的是不同的描述性问题。本研究中的覆盖广度来自观察,且部分与定义本身相关。不能说记录更多产品导致一个人改变选择。
应如何理解所选书没有记录的情况?
所选书没有已映射记录的 117 名参与者,并不是一个原因已完全明确的单一类别。其中 89 人的时间范围内,还包含至少 1 个标签为空或无法有效匹配产品的页面事件;其余 28 人没有这类保留事件。
多数所选产品无记录的案例,也有无法识别的事件
所选书没有已映射记录的参与者中,不可用的页面事件标签情况。
| 未匹配或空白的页面事件标签 | 占指定组的比例 | 参与者 |
|---|---|---|
| 没有标签未匹配或为空的保留事件 | 23.9%此单元参与者少于 30 人 | 28此单元参与者少于 30 人 |
| 至少有 1 个标签未匹配或为空的保留事件 | 76.1% | 89 |
这 89 例占所选书未记录组的 76.1%。无法识别的事件可能与这条缺失联系有关,但其标签无法说明代表哪本书。它不是经过验证的产品查看事件,我们不会仅为了补全故事就将它填作所选书。
其余 28 例也值得分开保留,并标记为小样本。没有保留的无法识别事件,并不能证明捕获的历史包含此人做过的一切。从列表直接选择、未观察到的活动及研究任务设计,仍可能是解释。数据无法确定适用哪一种解释。
对代理机构或店主来说,这些类别支持针对现有证据提出不同问题。一类是已经存在、却无法匹配到产品的记录;另一类是其他记录均可识别,却没有所选产品。两者都不足以告诉客户某个产品页被跳过,或跟踪一定出了故障。
虚构手作商店示例:3 种记录,3 种解读
假设一位陶艺创作者销售马克杯、碗和花瓶。以下例子为解释比较方式而虚构,并非书店研究中的客户或结果。假设创作者已单独核实所选产品,并已界定待审核的事件时间范围。
第 1 个例子中,马克杯是首个记录产品,参与者也选择了马克杯。首个产品与选择一致。但仅凭这一点,仍无法解释选择原因:产品吸引力、更早的推荐或既有熟悉度,都需要其他证据。
第 2 个例子中,马克杯先出现,碗也出现在该时间范围内,而参与者选择了碗。首个产品不同,但所选产品有记录。仅把这称为一次失败的马克杯访问,会遗漏记录包含的信息;称马克杯有效地引导了碗的选择,则会添加一个尚未经此比较检验的因果故事。
第 3 个例子中,已映射记录里有马克杯和花瓶,报告选择的却是碗。所选产品不在已映射集合中。如果另有一个事件的产品标签不可用,就保留这一事实,不猜测产品身份。如果没有这类事件,则让这条缺失联系继续保持未明。
产品记录与选择结果的 3 种对应情况
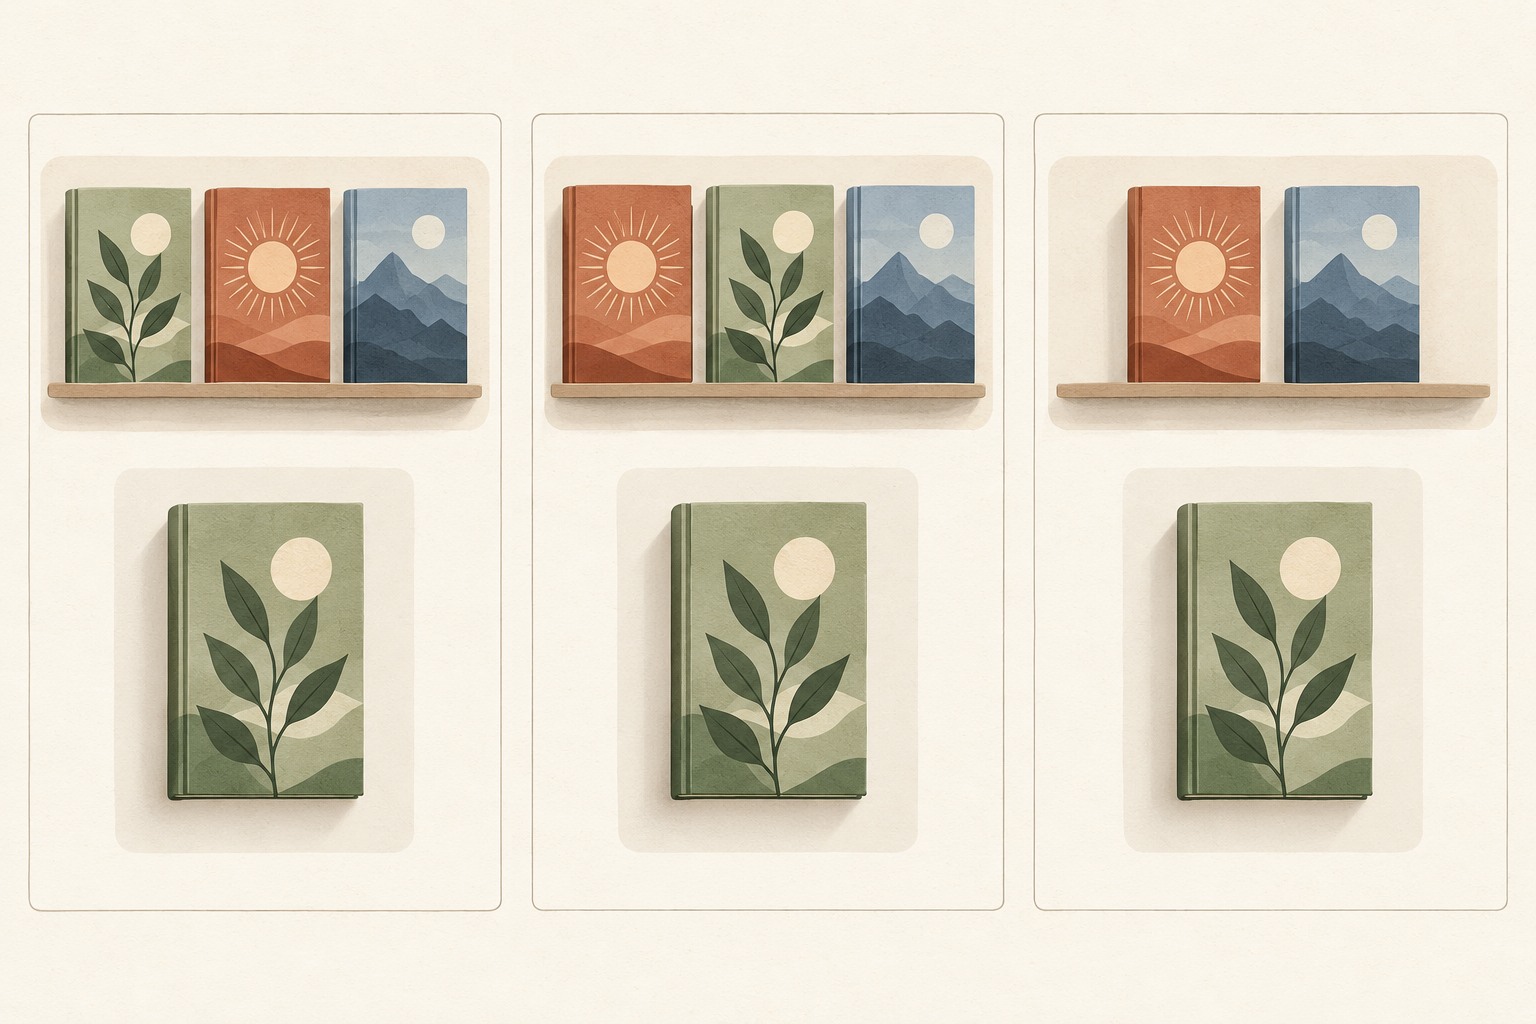
首个产品一致
首个记录产品与报告的选择指向同一件产品。
首个产品不同;所选产品有记录
所选产品出现在已映射记录中,但另一个产品先出现。
首个产品不同;所选产品无记录
已映射记录中找不到所选产品。没有记录本身不能说明原因。
实际要决定的是:在修改活动或产品页之前,需要索取什么证据。一致的情况可以直接描述;首个产品不同、但所选产品有记录的情况,应单列一类;所选产品无记录时,应先检查事件及选择的定义,再对客户行为下结论。这 3 个例子中的任何一个,都不能单独成为增加或削减活动预算的理由。
产品旅程报告应写明什么?
一份简要说明能让客户旅程讨论更准确。先明确业务问题:你是在检查历史中出现哪些产品、所选产品是否有记录,还是哪些活动发生在已验证购买之前?这些问题需要不同证据。将观察到的关联,与后来为解释它而设计的实验分开。
结果依据:写明用哪个事件或回答确定选择或购买。如果掌握的只是“报告的选择”,就这样写。做交易分析时,应说明如何处理取消、退款及重复交易记录,而非假定每个购买事件都是已履约订单。
观察时间范围:说明历史何时开始、何时结束、采用哪个时钟,以及是否排除了结果发生后的活动。如果没有经过验证的决策时间戳,就不要将该时间范围描述成通向该决定的路径。保留有歧义的同时间事件,不要编造顺序。
产品身份:说明如何跨记录识别同一产品,以及如何处理款式或规格变体。汇总时保留空白或无法匹配的标识符。无法映射到目录的记录行,与从未观察到的产品事件,是两回事。
分母:展示符合条件的组、首个产品一致状态,以及计算条件百分比所用的较小组。保留稀疏计数,并解释由定义决定的零值。这能让读者分清广泛模式与基于少量例外算出的百分比。
对于现代 GA4 实现,Google 文档分别定义了带有 items 数组的 view_item 和 purchase 事件。每件产品必须提供 item_id 或 item_name,Google 建议两者都提供。一致的产品标识符让产品层面的比较更容易解读。这是当前实现指南,与历史实验的自定义页面事件不同,也不是建议修改同意或归因设置。[5]
分析如何构建并核查?
我们使用了作者公开的复现数据,并固定到特定代码库修订版本。分析覆盖来源中 2022 年 5 月 19 日至 8 月 3 日的 2 轮实验,保留两轮之间的暂停期。我们在计算首个产品与所选书的组合之前,固定关联及覆盖规则;又在读取这些联合结果之前,固定结果分析方案。[3]
来源包含 24,930 行问卷记录,其中包括重复作答尝试。按预先指定规则排除预览、理解检查、来源日期及完成历史等情况后,剩余 18,373 次尝试可供关联。匹配规则选出了 12,813 次唯一关联的尝试,其中 11,606 次有可用的报告选书。再要求首个已映射产品没有歧义后,最终分析 11,460 名参与者。这些是不同阶段,不是可以互换的样本量。
关联使用优惠码、客户端标识符及问卷时间。共用或有歧义的匹配会被排除,不会因为后一次尝试的结果更方便,就用它替换前一次。产品比较只保留来源中精确命名为 Page View - Custom 的事件类型。如果最早事件的产品身份冲突,或无法识别的事件早于首个已映射产品、或与其同一时间,就无法确定首个产品,因此会被排除。[4]
所有估计都是对这一分析群体的未加权描述。对于自行选择参加研究任务的样本,我们不计算总体置信区间。参与者少于 30 人的单元会被标记;分母少于 30 人的条件百分比在下载文件中隐藏。由定义决定的零值会单独标明。
预先设定检查下的选择状态
按来源轮次、严格限定的优惠码标记无广告组,以及替代问卷时间边界分别报告的结果。
| 分析组或时间范围规则 | 首个产品与选择一致 | 首个产品不同;所选产品有记录 | 首个产品不同;所选产品无记录 | 组内人数 |
|---|---|---|---|---|
| 匹配的问卷时间范围:全部条件 | 72.4% | 26.6% | 1.0% | 11,460 |
| 第 1 轮 | 70.6% | 28.3% | 1.0% | 6,468 |
| 第 2 轮 | 74.6% | 24.3% | 1.0% | 4,992 |
| 以 0 开头的 7 字符优惠码 | 74.0% | 25.5% | 0.5%此单元参与者少于 30 人 | 192 |
| 时间范围两端各扩展 59 秒 | 72.4% | 26.6% | 1.0% | 11,437 |
| 时间范围两端各收缩 59 秒 | 72.0% | 26.9% | 1.1% | 11,292 |
表格分别报告了两轮实验、一个严格限定的优惠码标记无广告子组,以及 2 种替代时间范围定义。第 1 轮首个产品一致率为 70.6%,第 2 轮为 74.6%。优惠码子组有 192 人,仅 1 例所选书无记录。这个极少数例外不足以支持有关广告的实质性主张;优惠码识别的是预定条件,而非经过验证的广告接触。
将每个时间范围的两端各扩展 59 秒,或各收缩 59 秒,都会重新运行整个匹配过程。得到的群体分别有 11,437 和 11,292 人,首个产品一致率分别为 72.4% 和 72.0%。相近的汇总比例不能确定选择决定的时间;这些检查评估的是结果对所述时间边界的敏感性。
下载表格还保留了针对同一批基准参与者的比较、各时间范围规则下新增及排除的情况,以及完整联合计数。复现包包含代码、固定分析方案、来源清单、汇总输出及 README 说明,不含参与者标识符或原始个人记录。这些计算与解释由 Influence IQ 完成,并不取代原论文的广告分析。[6]
CSV 包含分母明确、带稀疏单元标记及结构性零值的汇总表。ZIP 包含代码、冻结的分析方案、数据来源记录、汇总结果、来源清单及 README 说明,不含原始参与者记录或标识符。CSV 数字字段使用小数点。来源数据:Morozov 与 Tuchman;计算由 Influence IQ 完成。
来源与注释
- Ilya Morozov 与 Anna Tuchman,“Where Does Advertising Content Lead You? We Created a Bookstore to Find Out”,《Marketing Science》43(5),2024 年,第 986–1001 页。原研究考察广告内容与搜索。Influence IQ 的记录状态分析合并实验条件,不提出处理效应主张。
- 作者手稿描述了美国 MTurk 招募、100 本电子书的商店、$3 预算及 50% 概率的履约抽奖。参与者必须先选书,再单独表达“书加剩余预算”或“现金”的偏好。我们的所选书变量仅来自问卷 q66 回答到目录的映射,不会将结算、履约、兑换或后续现金偏好当作可以互换的结果。
- 来源代码库修订版本 b9f5c0293fc516949e9e2d294caaab57885614c7,访问于 2026 年 10 月 18 日。规划时已知来源说明及原始发表结果;结果分析方案固定之前,已检查覆盖计数。这些方案是针对指定计算预先制定的,并非外部预注册,也不声称完全盲法。包中保留来源哈希及结构说明的先后顺序。
- 捕获事件标签 Page View - Custom 是操作性指标;公开文件不能证明页面已完整加载或获得关注。时间戳按文档中的来源时钟规则解释。产品身份使用所提供的 100 项目录,不猜测书名,也不根据结算记录替换。11,606 次有可用选择的关联尝试中,排除了 9 次无候选事件、80 次只有无法识别事件、53 次在首个已映射产品之前或同一时间有无法识别事件,以及 4 次不同产品并列最早的尝试。排除后剩余 11,460 次。
- Google Analytics,“Measure ecommerce”,核查于 2026 年 10 月 18 日。当前指南区分 view_item 与 purchase,并说明 items 数组中的 item_id 和 item_name。这个实现参考与来源实验在 2022 年的自定义事件数据不同。一致的标识符支持比较,但本身不能证明观察完整、订单已履约或存在因果归因。
- 作者复现资料的 README 欢迎在注明引用后将实验数据用于实证研究。数据复用许可来自这项声明;源代码则采用 GNU GPLv3 许可。可下载的 Influence IQ 包包含适用声明及获取固定输入文件的说明。它发布汇总结果,而非参与者级记录。额外计算、解释及插图由 Influence IQ 负责,不表示原研究者为其背书。
英文原版。所有语言版本描述的都是同一项 2022 年美国实验,并非不同国家的独立研究。分析、解释及翻译均由 Influence IQ 完成。