Aling mga komento sa recipe ang dapat basahin para sa feedback?
Maaaring magbago ang halo ng mga rating na makikita mo kapag ang binasa mo ay ang may pinakamaraming upvote o ang mga pinakabagong komento. Ipinapakita ng paghahambing ng tig-sasampung komento sa 100 piling talakayan tungkol sa recipe kung bakit dapat ibatay ang paraan ng pagpili sa tanong na gusto mong sagutin.
Pagsusuri ng 18,182 komento sa isang archive ng recipe na inilabas ng UCI noong 2023.
Buod
Kung ang layunin ay mailarawan ang halo ng mga rating sa isang talakayan tungkol sa recipe, mas malapit sa kabuuang halo sa average ang random na pagpili kaysa pagpili ng may pinakamaraming upvote o pinakabagong mga komento. Inihambing ng Influence IQ ang tig-sasampung komento sa 100 piling recipe na mataas ang rating, gamit ang archive ng 18,182 komento na inilabas ng UCI noong 2023. Ang average na inaasahang agwat sa halo ng mga rating ay 16.5 percentage point para sa random na pagpili, 18.7 para sa upvote at 20.3 para sa pinakabagong mga komento. [1][4]
Ang sinusukat ay ang halo ng mga komentong may isa hanggang limang bituin at walang rating, hindi kung gaano kapaki-pakinabang ang kanilang payo. Mas malapit kaysa random na pagpili ang pagpili ayon sa upvote para sa 46 recipe, at mas malayo para sa 54. Para sa mga food creator at community manager, mahalagang ihiwalay ang sample na ginagamit upang ibuod ang talakayan sa mga halimbawang ginagamit upang magplano ng sagot.
May recipe kang gustong pagandahin at mahabang talakayan sa ilalim nito. May oras kang bumasa ng ilang komento bago magpasya kung ano ang dapat linawin. Uunahin mo ba ang may pinakamaraming upvote, ang pinakabago o ang random na pinili mula sa talakayan?
Nangyayari ang pagpiling iyon bago mo pa unawain ang isang pangungusap. Dito nakasalalay kung aling mga tinig ang mapapasama sa brief na ibibigay mo sa creator, editor o katrabaho. Sinuri namin kung paano binago ng tatlong malinaw na tuntunin sa pagpili ang isang nasusukat na bahagi ng brief: ang balanse ng mga rating, kasama ang mga komentong walang ibinigay na rating.
Isang napiling bahagi ng mas malawak na talakayan
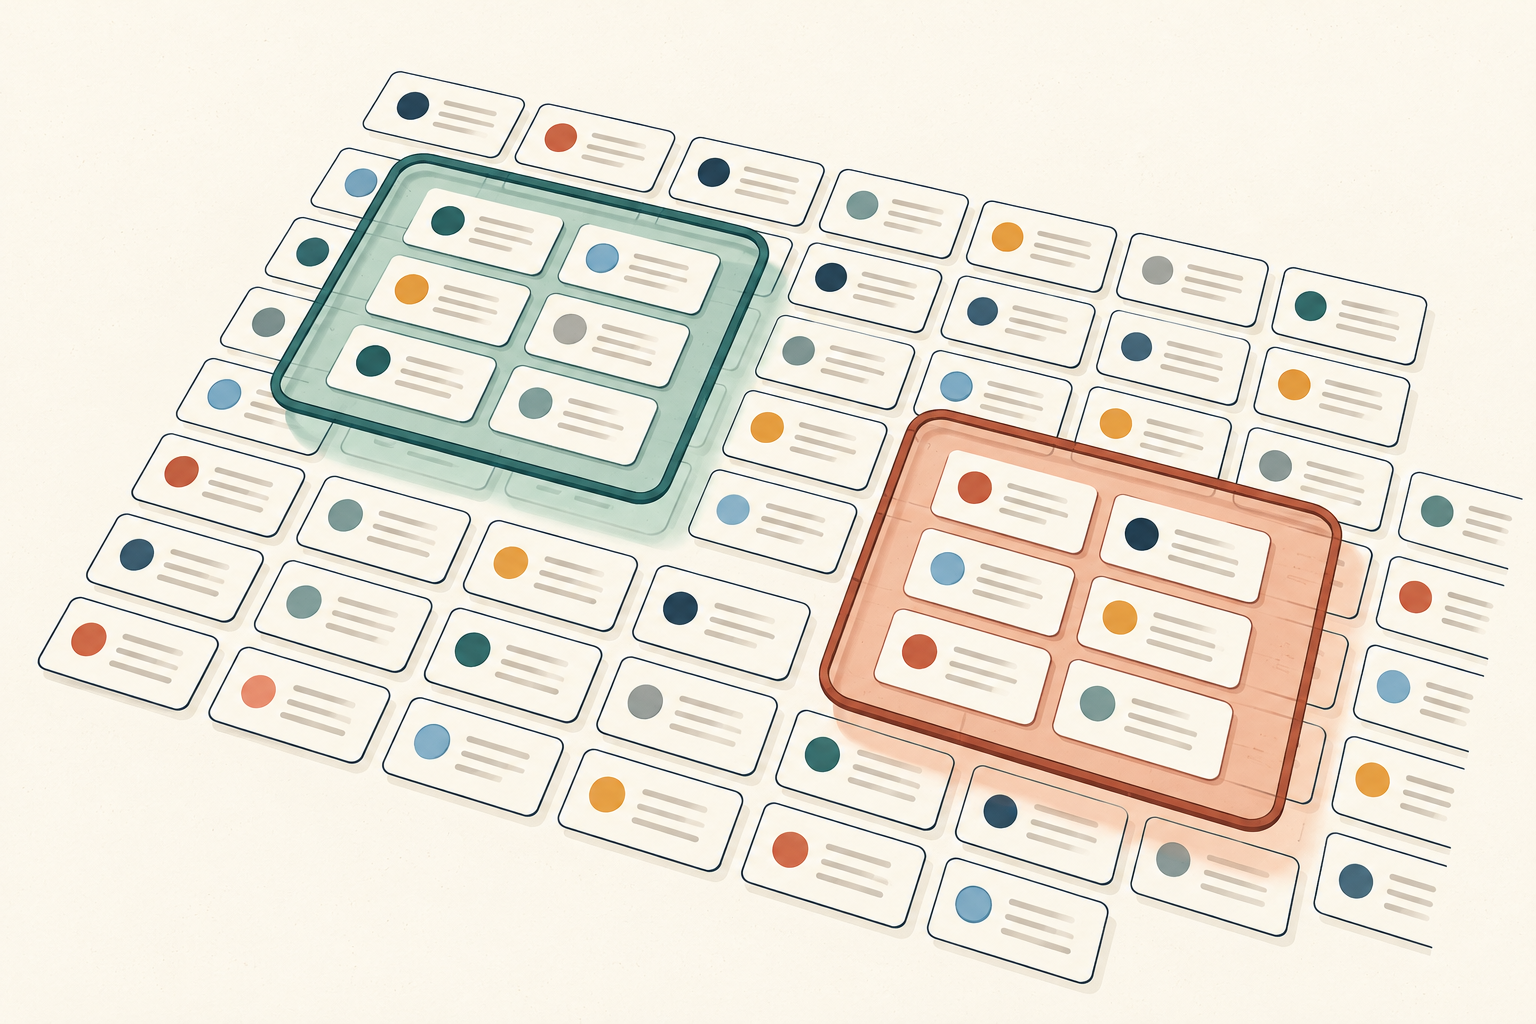
- Mga napiling komento
- Buong naka-archive na talakayan
Maaaring magbigay ng tatlong magkaibang pananaw ang sampung komento
Kailangang magpasya ng creator kung ano ang unang babasahin kapag naghahanda ng follow-up sa recipe. Maaaring mukhang magandang shortcut ang mga komentong may pinakamaraming upvote. Isa pang paraan ang pagbasa ng pinakabago. Parehong inuuna ng mga ito ang ilang komento, pero hindi awtomatikong inilalarawan ng alinman ang buong talakayan.
Sinuri namin ang tiyak na tanong na iyon gamit ang 18,182 naka-archive na komento sa 100 piling recipe ng Taste of Home na mataas ang rating, mula sa pampublikong dataset na inilabas sa UCI noong 2023. Sa bawat recipe, inihambing namin ang sampung komentong pinili ayon sa upvote, sampu ayon sa oras ng pagkakalikha at sampung pinili nang random. Ang batayan ay ang halo ng mga rating sa lahat ng naka-archive na komento sa recipe na iyon. [1]
Ang average na inaasahang agwat mula sa kabuuang halo ng mga rating ay 18.7 percentage point para sa pagpili ayon sa upvote, 20.3 para sa pinakabago at 16.5 para sa random na pagpili. Pantay ang ambag ng bawat recipe sa mga average na iyon, gaano man karami ang komento nito. [4]
Kung ihahambing sa random na pagpili, mas malaki nang 2.2 percentage point ang agwat para sa upvote at 3.8 point para sa pinakabagong mga komento. Tungkol ang mga pagkakaibang ito sa halo ng mga rating at komentong walang rating. Hindi namin sinukat kung aling mga komento ang may pinakamahusay na payo sa pagluluto, pinakamalinaw na paliwanag o pinakakapaki-pakinabang na ideya para sa negosyo.
Mahalaga ang pagkakaibang iyon para sa food creator o community manager. Maaaring sapat ang halaga ng isang komento upang maging paksa ng tutorial kahit hindi ito karaniwan sa talakayan. Iba ang paggamit dito bilang halimbawa sa paggamit ng maikling listahan bilang buod.
Average na agwat mula sa buong halo ng rating ng bawat recipe
Sampung komento bawat pagpili, mula sa 100 piling talakayan tungkol sa recipe sa archive ng UCI mula sa nakaraan. Mas maliit na agwat ang mas malapit na tugma sa komposisyon ng mga komentong may rating at walang rating.
| Paraan ng pagpili | Average na inaasahang agwat |
|---|---|
| Pinakamaraming upvote | 18.7 percentage point |
| Pinakabago ayon sa oras ng pagkakalikha | 20.3 percentage point |
| Random na pagpili | 16.5 percentage point |
Ano ang ibig sabihin ng agwat sa halo ng mga rating?
Isipin ang bawat talakayan tungkol sa recipe bilang halo ng anim na kategorya: isa hanggang limang bituin, at mga komentong walang rating. May sariling halo ang sample ng sampung komento. Sinukat namin ang layo ng mas maliit na halong iyon mula sa buong naka-archive na talakayan gamit ang sukatan na tinatawag na total variation distance.
Narito ang isang halimbawang gawa-gawa na may dalawang kategorya lamang. Ipagpalagay na apat na bituin ang ibinigay ng kalahati ng mga komento at limang bituin ang kalahati. Kung may pitong komentong apat na bituin at tatlong limang bituin sa sampung napili, ang halo nito ay 70% at 30%, sa halip na 50% at 50%. Ang distansiya ay 20 percentage point: kalahati ng pinagsamang dalawang absolutong pagkakaiba na tig-20 point.
Gumagana ang parehong pagkalkula para sa lahat ng anim na kategorya. Kapag mas maliit ang halaga, mas malapit ang tugma sa komposisyon ng mga rating sa archive. Hindi nito ibig sabihin na mas marami ang impormasyong ibinibigay ng teksto o mas makatotohanan ang mga komento. Hindi rin ibig sabihin ng resultang 18.7 point na mali ang 18.7% ng mga komento.
Isinama namin sa paghahambing ang mga komentong walang rating. Ayon sa UCI, ang zero sa field ng rating ay nangangahulugang walang rating, hindi markang mas mababa sa isang bituin. Magbabago ang talakayang ibinubuod kung aalisin ang mga komentong iyon. Hindi sapat ang numerong kategorya upang malaman kung tanong, papuri, problema o iba pa ang nilalaman ng isang komentong walang rating. [1]
Sa average, mas malapit ang random na pagpili, pero hindi sa bawat recipe
Walang paraang nanalo sa lahat ng recipe sa kabuuang paghahambing. Mas maliit kaysa random na pagpili ang inaasahang agwat ng pagpili ayon sa upvote para sa 46 sa 100 recipe, at mas malaki para sa 54. Mas malapit ang pinakabagong mga komento para sa 42 recipe at mas malayo para sa 58. Walang eksaktong tabla sa alinmang paghahambing. [4]
Inihahambing dito ang inaasahang agwat ng bawat paraan sa loob ng isang recipe. Hindi nito ibig sabihin na bawat posibleng random na bunot ay mas mahusay kaysa pagpili ayon sa upvote sa 54 na talakayang iyon. Maaaring malapit sa buong talakayan ang isang partikular na bunot ng sampung komento, o maaaring may mga bahagi itong hindi masaklaw.
Ang resulta para sa random na pagpili ay average ng lahat ng posibleng sample ng sampung komento, na may pantay na posibilidad ang bawat sample. Hindi ito bunga ng isang masuwerteng bunot o napiling random seed. Kinuha rin namin ang average ng mga posibleng pagpili kapag magkakapantay ang bilang ng upvote o timestamp ng mga komento sa hangganan ng pagpili.
Kinailangang kunin ang ganitong average dahil sa magkakapantay sa hangganan ng pagpili para sa 70 recipe sa paraang ayon sa upvote at apat sa paraang pinakabago. Hindi namin pinaboran ang isang kapantay na komento dahil sa may-akda, puwesto sa row o identifier nito. Sinusuri ng pagkalkula ang nangyayari sa ilalim ng isang malinaw na tuntunin sa pagpili, sa halip na ituring na ebidensiya ang isang arbitraryong pagkakasunod-sunod. [4]
Para sa creator, simple ngunit kapaki-pakinabang ang implikasyon: mga pamantayan sa pagpili ang upvote at pagiging bago. Kung ginagamit mo ang alinman upang ibuod ang talakayan, sabihin kung alin ang ginamit. Huwag ipagpalagay na napapanatili ng nakikitang maikling listahan ang balanse ng buong archive.
Nag-iiba ayon sa talakayan kung aling paraan ang mas malapit
Inihahambing ang bawat pagpiling ayon sa ranggo sa random na pagpili sa loob ng parehong recipe. Inaasahang mga agwat ang inihahambing, hindi mga resulta ng indibidwal na random na bunot.
| Paraan ng pagpili | Mas malapit kaysa random | Kapantay ng random | Mas malayo kaysa random |
|---|---|---|---|
| Pinakamaraming upvote laban sa random | 46 | 0 | 54 |
| Pinakabago laban sa random | 42 | 0 | 58 |
Unahin ang tanong bago pumili ng mga komento
Iba-iba ang gawain ng mga paraan ng pagkuha ng feedback mula sa customer. Maaaring nais ng negosyo na maunawaan ang pangkalahatang pattern, siyasatin ang isang problema o makahanap ng tanong para sa susunod na post. Isang bahagi lamang nito ang tinatalakay ng pag-aaral: kung napapanatili ng maliit na pagpili ang komposisyon ng mga rating sa talakayan. Hindi nito niraranggo ang lahat ng paraan ng pagkuha ng feedback.
Kung ang tanong mo ay “Ano ang pangkalahatang larawan ng talakayang ito?”, magsimula sa pagtukoy kung aling mga komento ang kasama. Ang random na pagpili mula sa kumpleto at naa-access na listahan ay hindi sadyang pumapabor sa mga boto o bagong oras ng pagkakalikha. Sa archive na ito, mas malapit ito sa kabuuang halo sa average, pero may nasusukat pa ring agwat ang maliit na random na sample. Sampu ang pinili naming bilang para sa paghahambing, hindi rekomendasyong sapat na ang sampung komento.
Kung ang tanong mo ay “Ano ang susunod kong sasagutin?”, maaaring karapat-dapat pagtuunan ang isang partikular na komento. Sapat na dahilan ang isang malinaw na tanong tungkol sa pamalit na sangkap upang suriin ang recipe at maghanda ng paliwanag. Hindi kailangang tawagin itong karaniwang tanong bago sumagot. Hiwalay na pagpapasya kung angkop ito sa susunod na content.
Kung tungkol sa mga kamakailang pagbabago ang tanong, maaaring gamitin ang oras ng pagkakalikha upang itakda ang panahong babasahin. Ilahad ang panahong iyon sa buod. Ang pinakabagong mga komento sa pag-aaral ay ang may pinakahuling timestamp sa naka-save na archive, hindi ang mga komento ngayon o ang pagkakasunod-sunod na kasalukuyang ipinapakita sa website.
Limitado pa rin ang buong archive bilang batayan. Naglalaman ito ng mga ambag ng mga taong kusang nagkomento, hindi ng lahat ng bumasa o sumubok ng recipe. Kung kailangan ng negosyo ang feedback ng mga taong hindi nagkokomento, kailangan nito ng hiwalay na paraan upang maabot sila. Hindi mapupunan ng mas malapit na tugma sa archive ang kakulangang iyon. Ihiwalay ang dagdag na feedback upang malinaw pa rin ang pinagmulan at paraan ng pagpili nito.
Magpanatili ng dalawang hiwalay na tala: isa para sa pagpiling ginamit upang ibuod ang talakayan, at isa para sa mga tanong na dapat siyasatin. Mungkahi ito sa pagpaplano, hindi prosesong sinubok sa pag-aaral na ito.
Isang gawa-gawang halimbawa: pagpaplano ng follow-up sa recipe
Isipin ang isang food creator na nagpaplano ng follow-up sa baking recipe. Nagtatanong ang isang komentong maraming upvote kung puwedeng gumamit ng ibang baking pan. Natutukso ang creator na simulan ang susunod na video sa “Lahat ay nahihirapan sa laki ng baking pan.” Gawa-gawang sitwasyon ito, hindi komento o recipe na pinili mula sa dataset.
Maaaring mahalagang sagutin ang tanong tungkol sa baking pan kahit hindi alam kung gaano ito karaniwan. Hindi pinatutunayan ng mga upvote kung sino ang sumubok ng recipe o nagkaroon ng parehong karanasan.
Mas tiyak ang ganitong brief: “May mambabasang nagtanong kung paano nakaaapekto ang pagpili ng baking pan sa recipe. Ipakita ang ginamit na pan, ipaliwanag ang sukat nito at tukuyin ang dapat suriin bago magrekomenda ng iba.” Maaari nang beripikahin ng creator ang mga detalye sa pagluluto. Ibinibigay ng komento ang panimulang tanong; hindi nito pinatutunayan ang sagot.
Kung nais ding ibuod ng creator ang talakayan, dapat may hiwalay na talang nagpapaliwanag kung ano ang binasa at paano pinili. Sa random na sample mula sa kumpletong listahang magagamit, dapat pantay ang pagkakataon ng bawat komento at walang komentong mapipili nang dalawang beses. Ang pag-scroll sa ilang madaling puntahan ay hindi ang random na pamamaraang sinuri rito.
Kung walang kumpletong listahan, ilarawan ang pagpiling kaya mong gawin. Mas malinaw ang “Binasa namin ang mga unang komentong ipinakita sa ilalim ng ganitong pagkakasunod-sunod” kaysa tawagin itong sample na kumakatawan sa lahat. Huwag gamitin ang mga numerong agwat mula sa aming archive para sa ibang prosesong iyon.
Dapat ipakita ng follow-up ang kagamitan at sagutin ang tanong na nasuri na. Itala ang nilinaw mo upang makatuon ang susunod na pagbasa sa mga tanong na wala pang sagot. Suriin ang paliwanag gamit ang feedback sa follow-up mismo.
Ihiwalay ang pagpili sa interpretasyon
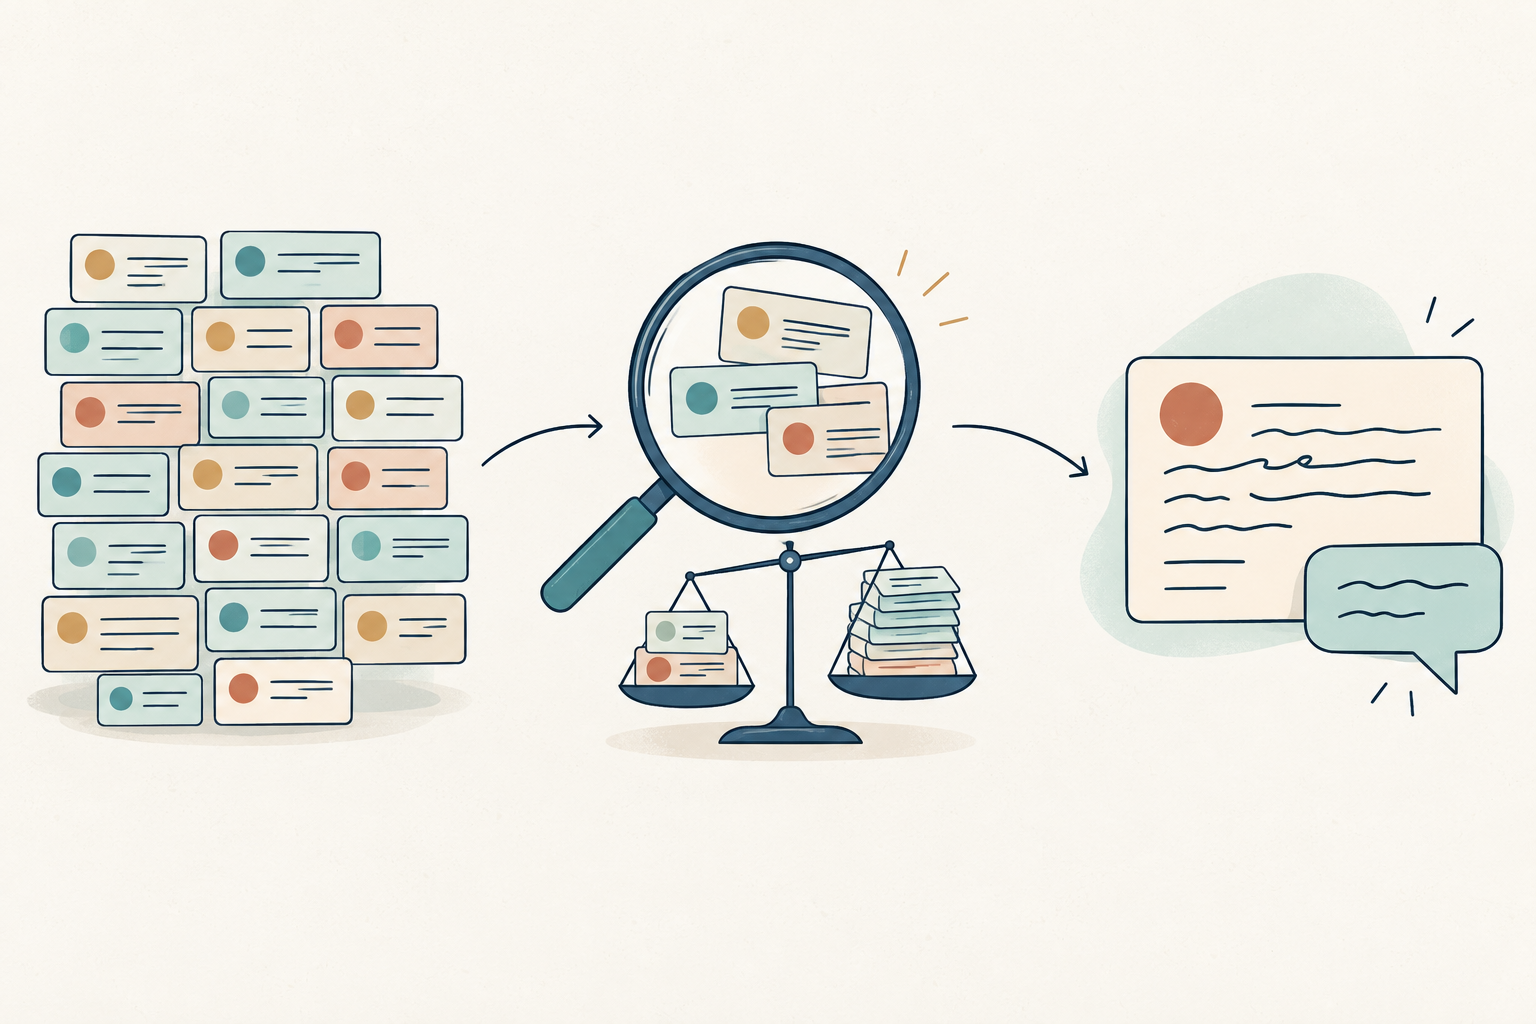
Tukuyin ang babasahin
Sabihin kung aling talakayan at tuntunin sa pagpili ang gagamitin bago bumasa.
Isaalang-alang ang saklaw ng napili
Ihiwalay ang napiling pananaw sa buong talakayan.
Basahin ang komento sa konteksto
Gamitin ang aktuwal na tanong upang magplano ng sagot at suriin ito.
Maikling gabay sa pagbasa ng talakayan tungkol sa recipe
Gamitin ang mga gabay na ito bago mag-atas sa creator o katrabaho na bumasa ng mga komento. Praktikal na tulong ang mga ito sa pagpaplano, hindi mga tanong mula sa dataset.
Pagpapasya: Ano ang paggagamitan ng babasahin? Tukuyin ang isang konkretong gawain, gaya ng paglilinaw ng hakbang sa recipe o pagpili ng paksa para sa follow-up. Ihiwalay ang paghahanap ng mga halimbawa sa paghingi ng paglalarawan ng buong talakayan.
Saklaw: Aling recipe, platform at panahon ang kasama? Sabihin kung kumpleto ang listahang magagamit. Bilangin ang mga komento bilang mga komento; huwag tawaging magkakaibang tao o beripikadong customer ang mga ito kung walang hiwalay na ebidensiya.
Pagpili: Paano mapapasama ang mga komento sa babasahin? Itala ang pagkakasunod-sunod o random na pamamaraan, bilang ng binasa at tuntunin kapag tabla. Isama ang mga komentong walang rating kung bahagi ang mga ito ng talakayang nais mong maunawaan.
Mga obserbasyon: Ano talaga ang sinabi ng mga napiling komento? Ihiwalay ang direktang tanong sa interpretasyon mo. Panatilihin ang sapat na konteksto upang maunawaan ang isyu, habang iniiwasang isama ang personal na impormasyon sa brief na ibabahagi.
Susunod na hakbang: Aling pahayag o detalye sa recipe ang kailangang suriin bago ilathala? Iatas ang pagsusuri sa taong makasasagot nito. Isulat ang planong paliwanag at kung saan ito ilalathala, nang hindi ginagawang walang-batayang pahayag tungkol sa pagkalaganap ang mga napiling halimbawa.
Paano namin inihambing ang tatlong paraan ng pagpili
Ang pinagmulan ay ang dataset na Recipe Reviews and User Feedback nina Ali, Matuszewski at Czupyt, na inilathala ng UCI noong 2023 sa ilalim ng CC BY 4.0. Naglalaman ito ng mga komento mula sa piling listahan ng 100 recipe ng Taste of Home na mataas ang rating. Hindi ipinapakita ng taon ng paglalabas ang eksaktong petsa ng pangangalap, at hindi pinatutunayan ng magagamit na materyal na nakolekta ang bawat orihinal na komento. Pagsusuri ito ng archive mula sa nakaraan, hindi kasalukuyang benchmark ng platform. [1][2][3]
Bineripika namin ang buong inilabas na archive: 18,182 magkakaibang identifier ng komento sa 100 puwesto ng recipe. Higit sa sampu ang komento ng bawat recipe, kaya kasama ang lahat ng 100 sa paghahambing. Nananatiling magkakahiwalay na komento ang paulit-ulit na ambag ng iisang tao. Hindi namin pinagsama ang mga ito ayon sa tao o sinuri ang teksto ng review, pangalan, reputasyon ng user o ranking score ng source.
Sa bawat recipe, pinili ng tuntuning ayon sa upvote ang sampung komento na may pinakamataas na naitalang bilang ng upvote. Ginamit ng tuntuning pinakabago ang sampung pinakahuling timestamp ng pagkakalikha. Kapag tabla sa hangganan, pantay ang posibilidad ng bawat paraan ng pagpuno sa natitirang puwesto mula sa magkakapantay. Sa random na pagpili, pantay ang posibilidad ng bawat subset ng sampung komento mula sa archive ng recipe.
Sa bawat posibleng pagpili, inihambing namin ang distribusyon ng anim na kategorya ng rating nito sa buong archive ng recipe, saka kinuha ang average ng distansiya ayon sa tuntunin ng pagpili. Eksaktong pagkalkula ng probabilidad ang nagbibigay ng inaasahang halagang iyon, nang walang simulation. Mahalagang i-average ang mga distansiya: ibang tanong ang masasagot at maaaring matakpan ang pagkakaiba-iba sa sampling kung kukunin lamang ang distansiya matapos i-average ang mga proporsiyon ng kategorya.
Pagkatapos, in-average namin ang inaasahang distansiya ng bawat recipe, na pantay ang bigat ng bawat isa. Kinalkula ang mga pagkakaiba bago i-round sa isang decimal place. Itinakda ang bilang na sampung komento, mga tuntunin sa pagiging kasama, paghahambing at plano ng pag-uulat bago tingnan ang target na mga resulta. Walang ibang bilang o paborableng subset ng mga recipe na pinili pagkatapos.
Inilalarawan ng mga resulta ang limitadong archive na ito at ang tinukoy na mga tuntunin sa pagpili, kaya hindi kami nag-uulat ng confidence interval para sa populasyon o sanhi-at-bungang epekto. Hindi ipinapakita ng pinagsama-samang upvote ang exposure o kasaysayan ng pagboto. Tungkol sa pag-uuri ng teksto ang orihinal na papel; sinusunod naman ng pagsusuring ito ang mga kategorya ng bituin na dokumentado ng UCI at sinusuri ang pagpili. Ipinapaliwanag ng teknikal na pamamaraan ang pagkakaiba ng mga field sa source. [1][2]
Kasama sa mga download ang pinagsama-samang resulta, numerong audit para sa bawat puwesto ng recipe at code para ulitin ang pagkalkula. Walang teksto ng komento, pangalan o identifier ng user ang mga ito. Hiwalay na makukuha sa UCI ang mga source record; ang pagkilala sa mga may-akda at repository ay hindi nangangahulugang sinusuportahan nila ang aming interpretasyon. [1][3]
- I-download ang pinagsama-samang resulta sa Tagalog (CSV)
- I-download ang pamamaraan at code para ulitin ang pagkalkula (ZIP, English)
Hindi kailangang mag-sign up. Kasama sa mga download ang pinagsama-samang paghahambing, numerong resulta ayon sa puwesto ng recipe at teknikal na pamamaraan sa English. Walang teksto ng komento, pangalan ng user o indibidwal na identifier ng komento. Hiwalay na makukuha sa UCI ang source dataset. [1]
Mga source at tala
- Ali, A., Matuszewski, S., at Czupyt, J. (2023). Recipe Reviews and User Feedback [Dataset]. UCI Machine Learning Repository. DOI: 10.24432/C5FG95. Nakatala sa UCI ang 18,182 komento at ang mga bituing 1–5, habang ang 0 ay walang rating. Ang inilabas na archive ang gamit sa mga pagkalkula ng Influence IQ, hindi kasalukuyang datos ng website.
- Inilalarawan ng papel ng mga gumawa ng dataset na “Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models” ang piniling source ng recipe at isang pag-aaral sa pag-uuri ng teksto. Salungat ang paglalarawan nito sa best_score sa field ng rating na dokumentado ng UCI. Ginagamit namin ang stars at hindi sinusuri ang best_score o teksto ng review. Hindi itinatatag ng magagamit na materyal ang eksaktong oras ng snapshot o kung kumpleto ang pangangalap.
- Lisensiyado ang dataset ng UCI sa ilalim ng Creative Commons Attribution 4.0. Gumawa ang Influence IQ ng mga bagong pinagsama-samang paghahambing mula rito. Ang pagkilala sa dataset ay hindi pag-endorso ng mga may-akda, UCI o Taste of Home. Hindi muling ipinapamahagi ng mga download ang indibidwal na mga komento o pagkakakilanlan ng user.
- Influence IQ (2026). Recipe feedback sampling: pamamaraan ng pagsusuri, pinagsama-samang resulta at code para ulitin ang pagkalkula. Itinatala ng package ang nakapirming paghahambing ng sampung komento, eksaktong pagkalkula ng inaasahang total variation, paghawak sa mga tabla at numerong resulta para sa lahat ng 100 puwesto ng recipe. Hiwalay na kinukuha sa UCI ang source data. Nasa English ang mga teknikal na file.
Makukuha sa sampung wika ang artikulo, gabay sa pagpaplano, mga label sa figure at CSV ng mga resulta. Nasa English ang teknikal na package para ulitin ang pagsusuri. Parehong archive ng recipe mula sa nakaraan at parehong pagsusuri ang inilalarawan ng bawat edisyon.