Sukatin ang tagal ng isinaling voice-over bago i-lock ang edit
Maaaring kasya sa eksena ang pagbasa sa Ingles pero lumampas ang isinaling rekording. Ipinapakita ng aming magkapares na pagsusuri sa 200 siping pananaliksik kung bakit dapat kasama ang oras ng multilingguwal na voice-over sa pagpapasa ng trabaho, bago itakda nang pinal ang mga larawan.
Deskriptibong pagsusuri sa tagal ng buong rekording ayon sa metadata para sa 200 isinaling sipi na nasa lahat ng 10 piniling test configuration ng FLEURS, mula sa balangkas na 350 siping Ingles. Mga pagbasa ito para sa pananaliksik, hindi komersyal na trabahong voice-over. Nakuha ang metadata noong Oktubre 24, 2026 (UTC).
Abstrak
Dapat bang i-lock ng negosyo ang isinaling video sa oras ng voice-over sa Ingles nito? Sukatin muna ang mga pagbasa ng salin. Inihambing namin ang tagal ng rekording ayon sa metadata para sa 200 siping nasa lahat ng 10 piniling test configuration ng FLEURS. Pantay ang bigat ng bawat sipi matapos kunin ang median ng mga paulit-ulit na pagbasa nito. Mula −6.1% para sa mga rekording sa Olandes hanggang +82.4% para sa Filipino ang median ng magkapares na pagbabago mula sa Ingles. Wala sa mga bilang na ito ang panlahatang dagdag-oras para sa produksyon sa isang wika.[1][2]
Ginagawang kongkreto ng nakapirming halimbawang 15 segundo ang pagpapasa ng trabaho. Sa 186 siping kasya ang median sa Ingles sa oras na iyon, lumampas ang 110 median sa Filipino. Sa mas mahigpit na tuntunin, kasya ang lahat ng naobserbahang take sa Ingles para sa 178 sipi, samantalang lumampas ang lahat ng naobserbahang take sa Filipino para sa 72. Hindi pa rin mapaghihiwalay ang epekto ng mga mambabasa, komposisyon ng kasarian, salin at paghinto. Ang ambag ay paghahambing ng oras ng rekording na maaaring siyasatin, kasama ang lahat ng 9 target na paghahambing at isang halimbawang pinili bago ang mga resulta sa oras, upang makatulong sa paghingi ng pagbasa na may sukat na tagal bago i-lock ang edit.
Handa na ang editor sa isang maikling video ng produkto. Kasya ang pagsasalaysay sa Ingles, lumilitaw ang produkto sa gustong frame at may puwang sa huling kuha para sa alok. Dumating ang salin ng script na may parehong mensahe. Madaling isiping huling file na lang ang rekording na ihuhulog sa tapos nang timeline.
Dito maaaring maging problema sa produksyon ang kulang na impormasyon: wala pang sumusukat sa tagal ng pagbasa ng salin. Hindi sinasabi ng script na aprubado ang kahulugan kung gaano katagal ang aktuwal na rekording nito. Kasama sa kapaki-pakinabang na pagpapasa ang aprubadong pananalita at ang oras ng rekording.
Sinuri namin ang pagkakaibang iyon sa FLEURS, isang corpus ng mga isinaling siping binasa para sa pananaliksik. Sa 200 magkatugmang sipi, nag-iba ang ugnayan ng tagal ng rekording sa pagitan ng mga configuration at sa pagitan ng mga pagbasa ng parehong sipi. Pinananatili ng mga talahanayan ang mga pagkakaibang iyon. Nagbibigay ang mga ito ng dahilan sa negosyo o creator na humingi ng sukat para sa aktuwal na produksyon, nang hindi ginagawang ipinangakong palugit ang average sa pananaliksik.
Bigyan ng sariling oras ang bawat bersyong nairekord
Ihambing ang parehong sipi bago humiram ng tuntunin sa oras
Inihahambing ng unang talahanayan ang bawat target na configuration sa Ingles ng Estados Unidos para sa parehong 200 siping pinagmulan. Para sa bawat sipi at configuration, kinuha namin ang median ng tagal ng mga rekording na mayroon. Hinati namin ang target na median sa median sa Ingles at ipinahayag bilang porsiyento ang kaibhan mula sa 1. Pagkatapos, binuod namin ang 200 magkapares na pagbabagong iyon. Kaya pantay ang bigat ng siping may 3 pagbasa at siping may 1.[2][4]
Para sa mga rekording sa Espanyol ng Latin America, +24.8% ang median ng magkapares na pagbabago. Mula +10.2% hanggang +47.0% ang gitnang kalahati ng pagbabago kada sipi. Para sa Hapones, +36.6% ang katumbas na median, at +17.8% hanggang +61.8% ang gitnang kalahati. Inilalarawan nito ang inilabas na mga rekording ng magkatugmang sipi; hindi nito itinatakda kung paano dapat bigkasin ang alinmang wika.
Iba ito sa paghahati ng 2 pangkalahatang median ng tagal. Sa parehong magkakatugmang sipi, 9.3 segundo ang median ng mga buod kada sipi sa Ingles at 11.6 segundo ang katumbas sa Espanyol. Hindi mabubuo muli ang magkapares na resultang +24.8% sa paghahati ng mga ipinakitang bilang. Itinugma muna namin ang bawat sipi, kaya ang maikling target na sipi ay katabi ng sarili nitong Ingles na batayan, hindi ng ibang siping malapit sa gitna ng distribusyon.
−6.1% ang median ng magkapares na pagbabago para sa Olandes at +82.4% para sa Filipino. Sa pagpapanatili sa dalawa sa talahanayan, nakikita ang lawak ng mga naobserbahang ugnayan. Naiiwasan ding ipahiwatig ng artikulo na mas mahaba ang bawat isinaling rekording. Sa magkakatugmang hanay, mas mahaba sa Ingles ang 71 median sa Olandes kada sipi, pantay ang 2 at mas maikli ang natitira.
Nakasunod ang mga hilera sa nakapirming ayos ng configuration sa pagsusuri, hindi sa resulta. Basahin ang hilerang may kaugnayan sa pinagmumulang paghahambing ng trabaho, at isama pa rin ang konteksto ng pananaliksik. Espanyol ng Latin America at Filipino ang saklaw ng mga pinagmulang datos. Hindi nagiging ebidensya tungkol sa ibang merkado ang mga rekording kapag inilathala ang artikulo sa ibang wika.
Magkapares na pagbabago sa tagal ng rekording mula sa Ingles ng Estados Unidos
Parehong 200 isinaling siping pinagmulan sa bawat hilera. Hinahati ang median ng target na tagal ng bawat sipi sa median sa Ingles nito; ipinapahayag na porsiyento ang kaibhan mula sa 1. Hangganan ng gitnang kalahati ng magkapares na pagbabagong iyon ang Q25 at Q75.
| Configuration ng target na rekording | Median ng relatibong pagbabago (%) | Pagbabago sa ika-25 percentile (%) | Pagbabago sa ika-75 percentile (%) |
|---|---|---|---|
| Espanyol ng Latin America | 24.8% | 10.2% | 47.0% |
| Pranses (Pransiya) | 5.7% | -10.0% | 29.1% |
| Aleman (Alemanya) | 31.4% | 0.0% | 62.4% |
| Olandes (Netherlands) | -6.1% | -21.6% | 8.9% |
| Indones (Indonesia) | 26.3% | 11.4% | 49.9% |
| Malay (Malaysia) | 11.3% | -1.2% | 29.1% |
| Filipino (Pilipinas) | 82.4% | 54.2% | 120.1% |
| Thai (Thailand) | 20.8% | 1.6% | 42.0% |
| Hapones (Hapon) | 36.6% | 17.8% | 61.8% |
Mahalaga ang lawak kapag nakapirmi ang oras ng trabaho
Pinagsasama ng median ang 200 ugnayan sa isang bilang. Kailangan pa ring magkasya ang isang partikular na pagbasa sa isang partikular na eksena. Ipinapakita ng mga kuwartil sa tabi ng bawat median kung bakit may mahalagang impormasyong mawawala kapag ang gitnang bilang lang ang dinala sa brief.
+5.7% ang median ng magkapares na pagbabago sa Pranses, pero −10.0% hanggang +29.1% ang gitnang kalahati. Kasabay ng maliit na gitnang kaibhan, may mga siping mas maikli at mas mahaba sa Ingles. +31.4% ang median sa Aleman, at mula humigit-kumulang 0.0% hanggang +62.4% ang gitnang kalahati. Naka-round ang ipinakitang 0.0%; bahagyang positibo ang hindi pa na-round na ibabang kuwartil.
Inilalarawan ng mga agwat na ito ang gitnang kalahati ng naobserbahang magkapares na pagbabago. Hindi sila confidence interval, hangganang pinakamababa hanggang pinakamataas o saklaw na tiyak na maglalaman ng isang susunod na komersyal na rekording. Iba ang pinagmumulang mga sipi, salin at pagbigkas sa bagong script ng produkto. Kahit kopyahin nang eksakto ang porsiyento ng median sa talahanayan, wala pa ring aktuwal na take ang production team na kailangan nitong i-edit.
Praktikal na binabago ng pagkakaibang ito ang tanong. Sa halip na itanong kung gaanong dagdag na oras ang palaging kailangan ng isang wika, maaaring itanong ng producer kung kasya sa balak na eksena ang aprubadong pagbasa ng salin. Ipinapaliwanag ng talahanayan kung bakit kapaki-pakinabang ang pagsusuri; ang rekording para sa trabaho ang nagbibigay ng sagot.
Maaaring may iba't ibang tagal ang mga rekording ng iisang sipi
Pinili ang pinagmulang sipi 1662 bilang pinakamababang ID na nasa lahat ng 10 configuration, bago namin ibuod ang oras. Kasama sa talahanayan nito ang bawat pagbasa na mayroon para sa siping iyon. Hindi kami naghanap ng kapansin-pansing halimbawa matapos makita ang tagal, at hindi namin inilalathala rito ang mga salita o audio ng sipi.[3][4]
Humigit-kumulang 8.4 at 11.2 segundo ang 2 file sa Ingles, kaya 9.8 segundo ang median. Mula 10.4 hanggang 23.5 segundo ang 3 file sa Aleman, na may median na 10.5. Mula 22.3 hanggang 24.9 segundo ang 2 file sa Filipino, na may median na 23.6. Oras ito ng buong file ayon sa pinagmulang metadata, na ni-round sa 1 decimal para ipakita.
Maaaring gitnang puntong aritmetiko ang median ng 2 pagbasa, sa halip na tagal ng isang file na aktuwal na nairekord. Ganoong buod ang ipinakitang 9.8 segundo sa Ingles. Kailangan pa rin ng editor na pumipili ng take ang sariling tagal ng napiling file. Ipinakikita ng bilang ng take at saklaw mula pinakamaikli hanggang pinakamahaba ang pagkakaibang iyon sa tabi ng median.
Nagbababala rin ang lawak sa Aleman laban sa pag-uugnay ng bawat segundo sa haba ng salin. Wala kaming speaker ID at hindi namin pinakinggan ang mga rekording o pinaghiwalay ang pagsasalita at paghinto. Hindi maihihiwalay rito ang paraan ng pagbasa, mga mambabasa at kondisyon ng pagrekord. Sinusuportahan ng halimbawa ang simpleng kahilingan sa produksyon: ipadala ang gagamiting take, o isang pagbasa ng gagamiting pananalita na may sukat na tagal, sa halip na tantiya lang para sa buong wika.
Sipi 1662: ilagay ang saklaw ng mga take sa tabi ng median
Pinakamababang source ID na may rekording sa lahat ng 10 configuration, pinili ayon sa pagkakaroon ng datos bago ang buod ng oras. Kasama ang lahat ng take na mayroon. Inilalarawan ng segundo ang buong file ayon sa pinagmulang metadata, nang hindi pinaghiwalay ang mga paghinto.
| Configuration ng rekording | Mga take na mayroon | Pinakamaikling file (segundo) | Median ng file (segundo) | Pinakamahabang file (segundo) |
|---|---|---|---|---|
| Ingles ng Estados Unidos | 2 | 8.4 | 9.8 | 11.2 |
| Espanyol ng Latin America | 3 | 8.8 | 9.5 | 9.5 |
| Pranses (Pransiya) | 2 | 6.4 | 6.8 | 7.1 |
| Aleman (Alemanya) | 3 | 10.4 | 10.5 | 23.5 |
| Olandes (Netherlands) | 1 | 7.9 | 7.9 | 7.9 |
| Indones (Indonesia) | 1 | 11.6 | 11.6 | 11.6 |
| Malay (Malaysia) | 2 | 8.0 | 8.6 | 9.1 |
| Filipino (Pilipinas) | 2 | 22.3 | 23.6 | 24.9 |
| Thai (Thailand) | 3 | 6.5 | 8.7 | 10.1 |
| Hapones (Hapon) | 2 | 12.1 | 13.3 | 14.6 |
Kailangan ng denominator ang halimbawang 15 segundo
Itinakda namin ang 15 segundo bilang halimbawang pagpaplano bago kalkulahin ang mga resulta. Hindi ito kahingian ng platform, inirerekomendang haba ng ad o ligtas na palugit sa produksyon. Ang tanong ay kung maaaring kasya ang buod ng rekording sa Ingles habang lumalampas ang katumbas na target na buod.
Sa 200 magkakatugmang sipi, 186 ang may median sa Ingles na hindi hihigit sa 15 segundo. Sa grupong iyon, lumampas sa 15 segundo ang target na median para sa 20 siping Espanyol ng Latin America, 39 Aleman, 9 Olandes, 110 Filipino at 37 Hapones. Pare-parehong 186 ang denominator ng bawat bilang; nasa download ang iba pang paghahambing.[6]
Gumamit din kami ng mas mahigpit na tuntunin para sa mga naobserbahang take. Kailangang kasya sa 15 segundo ang bawat pagbasa sa Ingles na mayroon, at lumampas naman ang bawat target na pagbasa na mayroon. May 178 siping Ingles na pasok sa batayan. Nangyari ito sa 11 siping Espanyol, 9 Aleman, 4 Olandes, 72 Filipino at 14 Hapones. Tungkol lang ang mga bilang sa inilabas na mga take, hindi sa bawat posibleng pagbigkas sa sipi.
Iniiwasan ng mas mahigpit na pagsusuri ang pag-asa sa gitnang puntong aritmetikong wala namang nagrekord. Hindi pa rin nito ipinapakitang hindi kayang basahin nang mas mabilis, i-edit nang iba o baguhin nang angkop ang sipi. Para sa team, mahalagang ihiwalay ang ebidensyang kasya ang isang partikular na ipinadalang rekording sa palagay na kasya ang ibang bersyon dahil kasya ang Ingles.
Ipinapakita ng kathang-isip na paglulunsad kung kailan magpapasa
Isipin ang isang kathang-isip na maliit na brand ng kagamitan sa kusina na kumukuha ng creator para sa 15 segundong video ng produkto. May demonstrasyon, alok at huling kuha ng produkto ang konsepto. Umaabot ng 11 segundo ang pagbasa sa Ingles. Aprubado ang kahulugan ng salin, pero 17 segundo ang unang pagbasa ng balak na narrator. Kathang-isip ang brand, script, oras at trabaho sa halimbawang ito; hindi sila obserbasyon mula sa FLEURS.
Kung na-lock na ng creator ang bawat kuha sa pagbasa sa Ingles, pipilitin ng 17 segundong file ang desisyon sa bandang huli ng pag-edit. Maaaring gawing malinaw ng namamahala sa kliyente ang pagpiling iyon sa paghingi ng pagbasa na may sukat na tagal habang sinusuri pa ang salin. Dapat tukuyin sa brief ang mensaheng kailangang manatiling tama, ang oras na mayroon ang eksena at kung sino ang maaaring mag-apruba ng pagbabago sa alinman.
Hindi kailangang awtomatikong pabilisin ang narrator. Maaaring magmungkahi ang tagasalin ng mas maikli at natural na pananalita na pinananatili ang alok. Maaaring pahabain ng editor ang demonstrasyon, ilipat ang pangalawang detalye sa kasamang teksto o gumawa ng hiwalay na edit kung pinapayagan ng napagkasunduang format. Mga pagpipilian ito na dapat pag-usapan, hindi mga pagpapahusay na napatunayan ng aming pagsusuri sa corpus.
Maaaring ganito ang kapaki-pakinabang na pagpapasa para sa kathang-isip na trabaho: “Target na bersyon: __. Aprubadong script: __. Gagamitin na take: __ segundo, sinukat sa ipinadalang file. Oras para sa eksena: __ segundo. Pananalita ng alok at kailangang paglalahad: __. Mag-aapruba ng pagbabago sa script: __. Mag-aapruba ng edit: __.” Ang aktuwal na team ang pupuno sa mga patlang; hindi kayang gawin iyon ng talahanayan ng pananaliksik.
Kung may ilang target na bersyon, maaaring maglaan ang namamahala sa kliyente ng isang hilera kada gagamiting take sa halip na markahang “aprubado ang salin” ang buong proyekto. Magkaibang tanong ang sinasagot ng pag-apruba sa pananalita at sa oras. Kung binago ng tagasalin ang pahayag tungkol sa produkto matapos ang pansamantalang pagbasa, dapat ipakita sa hilera ang pagbabago bago muling gamitin ng creator ang dating oras. Mungkahi ito sa pag-aayos ng kathang-isip na trabaho, hindi nasubukang pagbawas sa panganib ng proyekto.
Kapag naipadala na ang binagong take, maaaring suriin ng creator ang buong bersyon kasama ng responsable sa wika at kahulugan. Maaaring makaligtaan ang alanganing pagbigkas o hindi mabasang huling frame kung tagal lang ang batayan ng pagkakasya. Hindi sinukat ng pag-aaral ang kalidad o tugon ng audience. Ang ambag nito sa kathang-isip na trabaho ay mas maagang kaalaman sa oras ng rekording; ang mga gumagawa ng video pa rin ang responsable sa malikhaing pasya.
Panatilihing magkasama ang pananalita, take at larawan sa pagsusuri
Para sa pagsukat ng tagal ng multilingguwal na voice-over, kapaki-pakinabang ang dokumentong maikli lang at maipapasa kasama ng trabaho. Tinutukoy nito ang bersyon ng aprubadong script, ang gagamiting rekording at ang oras ng eksena. Kapag may nagbago, makikita ng susunod na tatanggap kung aling sukat ng oras ang naaangkop pa.
Maaaring maglantad ng hindi pagkakatugma ang pansamantalang pagbasa na may sukat na tagal habang may pagpipilian pa ang team. Dapat manatili ang tatak na pansamantala ito, hindi ebidensyang kapareho ang magiging tagal ng pinal na narrator. Kapag dumating ang gagamiting take, palitan ang palagay ng nasukat nitong oras at suriin ito sa aktuwal na edit.
Panatilihing buo ang isinaling bersyon sa pagsusuring iyon. Kailangang marinig ng nagsusuri ng kahulugan ang pagbigkas kasabay ng larawan, habang kailangang makita ng editor kung nagtutugma ang mga paghinto, paglitaw ng produkto at huling frame. Isang ebidensya lang ang pagkakasya ng file sa oras; hindi ito pag-apruba sa lahat ng nasa bersyon.
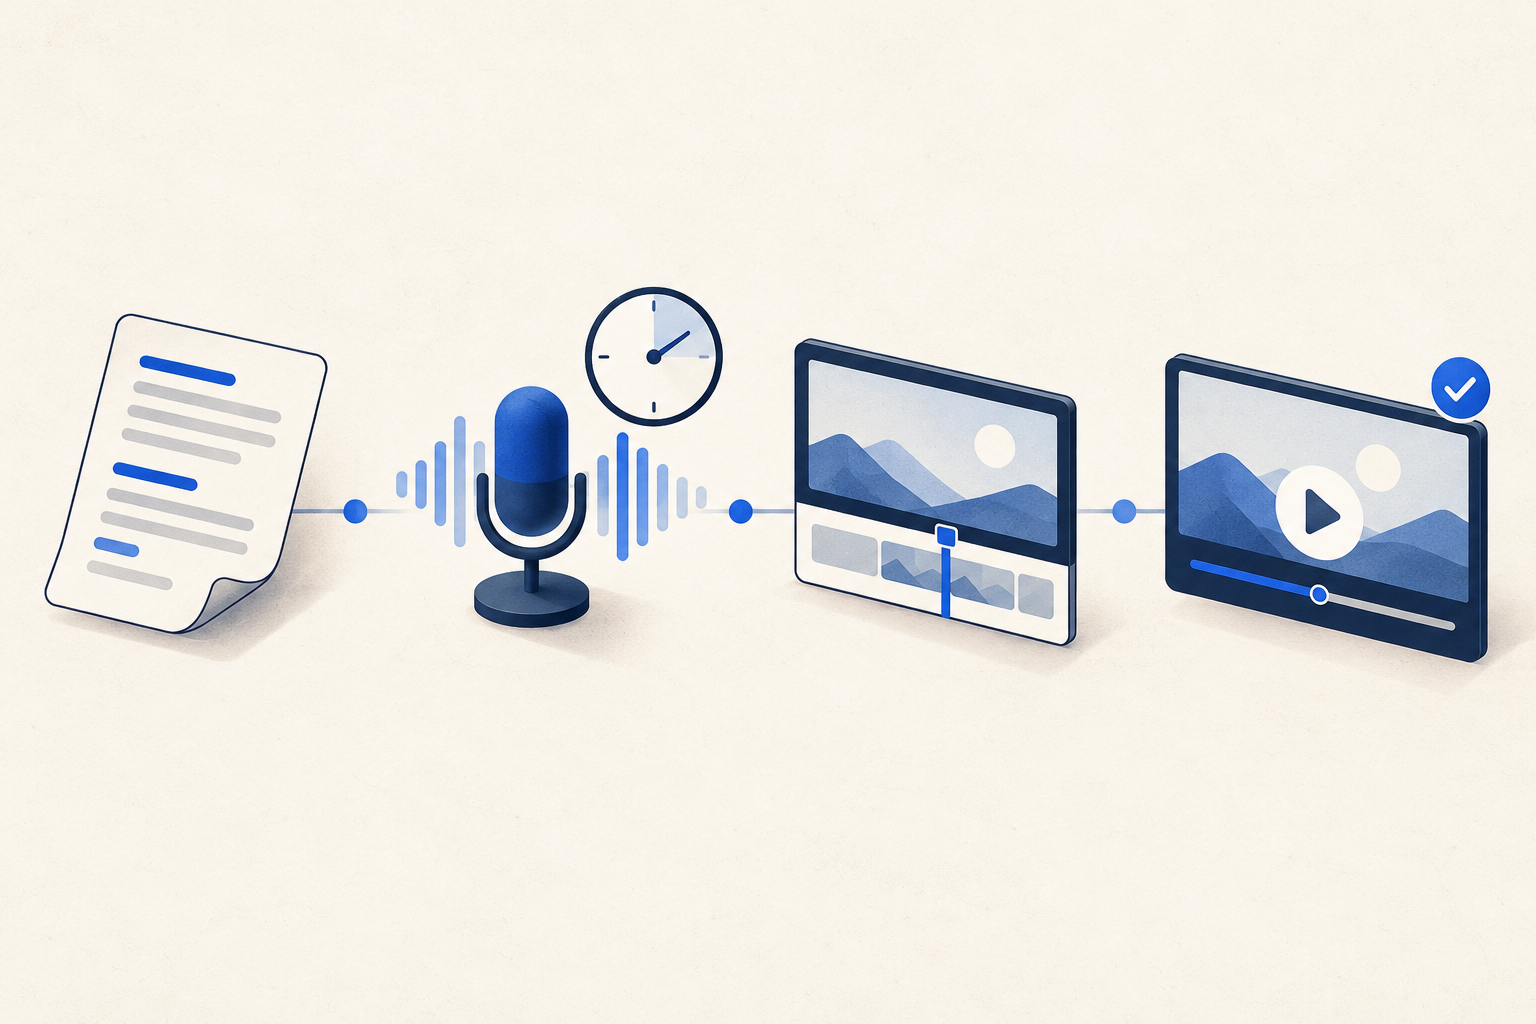
Mungkahing pagpapasa ang 4 hakbang sa ibaba, hindi prosesong sinubukan sa FLEURS. Inilalapat nila sa desisyon sa produksyon ang pagkakaiba ng pananalita at tagal ng rekording sa pag-aaral. Wala silang pangako tungkol sa abot, pagpapatuloy ng panonood, conversion o dami ng rebisyong kakailanganin ng proyekto.
Dalhin ang oras ng rekording sa 4 pagpapasa
Pagkasunduan ang pananalita
Tukuyin ang target na bersyon, aprubadong script at taong susuri ng kahulugan.
Sukatin ang gagamiting pagbasa
Ilakip ang nasukat na tagal ng take; markahang pansamantala ang pagsubok na pagbasa.
Ayusin ang pagkakasya
Pagkasunduan ang anumang pagbabago sa script o eksena bago i-lock ang edit.
Suriin ang buong bersyon
Suriin ang napiling take kasama ang larawan, alok at huling frame.
Ipakita pa rin ang magkatugmang hanay kapag muling gumamit ng bilang
Kasama sa magkakatugmang paghahambing ang 200 sa 350 siping Ingles sa test set. Sa natitirang 150, kulang ang kahit isang piniling configuration. Maaaring may pagpili sa pagkakaroon ng kumpletong datos, kaya hindi dapat ilarawan ang magkakatugmang hanay bilang random na sampol ng mga script, wika o trabahong voice-over.
Inulit namin ang bawat paghahambing ng Ingles at target gamit ang lahat ng magkatugmang pares na mayroon. Mula 251 para sa Olandes hanggang 349 para sa Filipino at Thai ang mga denominator. Inulit din namin ang paghahambing sa magkakatugmang hanay gamit lang ang siping may hindi bababa sa 2 pagbasa sa Ingles at 2 target na pagbasa; mula 66 hanggang 166 sipi ang mga subset na iyon. Nasa download ang lahat ng 9 magkapares na resulta at ang mga denominator.[4]
Nanatili sa mga subset na may paulit-ulit na pagbasa ang parehong direksyon ng median ng magkapares na pagbabago gaya ng pangunahing paghahambing sa bawat configuration. Kapaki-pakinabang itong pagsusuri sa partikular na paraang ito ng pagbubuod. Hindi nito kinokontrol ang mga mambabasa o ginagawang maihahambing na populasyon ang magkakaibang sampol ng pares. Hindi katumbas ng mga independiyenteng kalahok ang paulit-ulit na take.
Lahat ng nakuhang rekording sa Aleman, Olandes, Indones, Malay at Filipino ay may tatak na lalaki; lahat sa Thai ay may tatak na babae. Halo ang mga tatak sa Ingles, Espanyol, Pranses at Hapones. Dahil walang pagkakakilanlan ng speaker, hindi maihihiwalay sa pagsusuri ang configuration sa komposisyon ng mambabasa, pagbigkas, salin o pagpapanatili ng rekording. Basahin ang talahanayan bilang paglalarawan sa mga rekording na ito, at isama ang limitasyong iyon sa anumang bilang na gagamiting muli.[7]
Paano ginawa ang paghahambing ng oras ng rekording
Ang FLEURS ay corpus ng pananaliksik na ipinakilala noong 2022 gamit ang mga isinaling siping binasa. Tinutukoy ng gumawa at ng dokumentasyon ng TensorFlow Datasets ang iisang ID ng pinagmulang teksto sa iba't ibang wika at isang metadata field para sa kabuuang audio frame sa 16,000 Hz. Hinati namin ang field na iyon sa 16,000 upang makuha ang segundo ng buong file ayon sa metadata. Hindi kami nag-decode ng audio, nagsuri ng haba ng waveform o nagtanggal ng katahimikan.[1][2]
Nakuha namin ang 10 test metadata file sa nakapirming rebisyon ng gumawa na nakasaad sa mga tala noong Oktubre 24, 2026 (UTC). May 7,528 rekording sa mga siping mayroon. Ginamit ang source ID sa pagtutugma, hindi ang posisyon ng hilera. Itinakda ang 200 magkakatugmang sipi, mga tuntuning 15 segundo, pagsusuri sa paulit-ulit na pagbasa at halimbawang 1662 matapos malaman ang pagkakaroon ng datos at bago kalkulahin ang mga buod ng oras.[3][4]
Tinutukoy ng petsa ng pagkuha ang bersyon ng pinagmulang ginamit namin. Hindi nito ginagawang sarbey noong 2026 ng mga narrator o creator ang mga rekording na ipinakilala sa corpus ng pananaliksik noong 2022. Pinananatili ng pampublikong datos ang rebisyon ng pinagmulan upang maihiwalay ng susunod na mambabasa ang bagong pagsusuri ng dati nang materyal sa mga bagong kinolektang pagbigkas.
Sa naunang pagsubok sa pagiging posible gamit ang development split, 91 magkakatugmang sipi lang ang nakuha, mas mababa sa itinakdang 100, kaya isinantabi ito. Unang huminto ang pagkuha ng test data sa limitasyon ng laki ng Thai metadata; natapos ang parehong nakapirming test frame gamit ang nakatalang mas malaking limitasyon. Mga ibinunyag na pagbabago ito sa pagiging posible at pagkuha, hindi ebidensya ng prerehistradong pag-aaral na walang kaalaman sa mga resulta.
Eksaktong bilang ng frame at mga fraction ang ginamit sa lahat ng magkapares na kalkulasyon. Gumagamit ang mga kuwartil ng linear interpolation sa mga posisyong tinutukoy ng (n−1) × p. Ipinapakita ang mga porsiyento at segundo sa 1 decimal gamit ang half-up rounding; buumbilang ang dami ng take. Pinananatili ng pampublikong hinangong datos ang eksaktong buod kada sipi, resulta ng mga pares, pagsusuri sa sensitivity at kapwa depinisyon ng oras. Wala kaming kinalkulang confidence interval para sa populasyon o epektong sanhi at bunga.[4]
Matagal nang paksa ng pananaliksik ang mga limitasyon sa oras ng dubbing.[5] Nagdaragdag ang artikulong ito ng nauulit na paghahambing ng oras ng inilabas na mga file para sa nakapirming mga siping ito, kasama ang impormasyong kailangan upang siyasatin ang saklaw at mga paulit-ulit na take. Sinusuportahan nito ang paghingi ng ebidensya sa oras para sa isinaling produksyon bago i-lock ang edit; hindi ito nagbibigay ng pangkalahatang porsiyento ng paghaba.
- I-download ang 67 ipinakitang resulta (CSV)
- I-download ang lahat ng 350 sipi × 10 configuration at buod ng mga take (CSV)
- I-download ang lahat ng 9 magkapares na paghahambing, pagsusuri sa sensitivity at bilang ayon sa mga tuntunin sa oras (CSV)
- I-download ang mga pinagmulan, paraan at code para sa reproduksyon (ZIP)
Hindi kailangang mag-sign up. Pinananatili ng hinangong datos ang kulang na kombinasyon at aktuwal na denominator ng paghahambing. May dokumentasyon ng paraan sa Ingles, sanggunian at code para sa reproduksyon sa iisang package; hindi muling ipinamamahagi ang orihinal na transcript o audio. Inilalarawan ng bawat bersyon ng wika ang parehong nakapirming corpus.[8]
Mga tala sa pananaliksik
- Conneau at mga kasama, FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech (2022), seksyon 2.1–2.3. May mga isinaling siping binasa ang corpus, na may hanggang 3 napatunayang rekording kada pangungusap, na sinampol sa 16 kHz. Hindi itinatatag ng paraan ng pagkolekta at layunin ng pananaliksik ang pagiging kinatawan nito ng komersyal na produksyon ng voice-over. Nagmula sa FLORES ang mga sipi; hindi sila sampol ng script ng ad.
- Dokumentasyon ng mga feature at kaukulang parser ng TensorFlow Datasets, xtreme_s bersyon 2. Pareho ang source-text ID sa iba't ibang wika at maaari itong maulit sa maraming pagbasa; nakatala sa num_samples ang kabuuang audio frame. Idinedeklara ng audio feature ang 16,000 Hz. Kinokopya ng parser ang mga bilang sa metadata sa halip na ihambing sa na-decode na waveform. Ayon sa metadata ang aming segundo ng buong file, hindi nakahiwalay ang mga paghinto at walang kontrol sa pagkakakilanlan ng speaker.
- Google FLEURS metadata, nakapirming rebisyong ab93cf03f9d0cd083c853fad065a6377067408aa, test split, nakuha noong Oktubre 24, 2026 (UTC). Mga configuration: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th at ja_jp. Isa ang naka-link na TSV sa Ingles sa 10 pinagmulang file; nakatala sa package ang bawat eksaktong URL at SHA256. Latin American ang pinagmulang Espanyol at Filipino ang fil_ph.
- Mga kalkulasyon ng Influence IQ: isang median kada sipi sa bawat configuration; pantay na bigat ng sipi; magkapares na ratio ng target sa median sa Ingles at magkapares na kaibhan sa segundo. Pangunahing batayan ang 200 siping magkakatugma sa lahat ng 10 configuration, mula sa 350 siping Ingles. Gumagamit ang pangalawang paghahambing ng lahat ng Ingles–target na pares na mayroon at magkakatugmang siping may hindi bababa sa 2 take sa bawat panig. Itinakda ang paraan at pagpili ng halimbawa bago ang mga buod ng oras, matapos malaman ang pagkakaroon ng datos. Nakatala sa package para sa reproduksyon ang eksaktong fraction, interpolation, rounding at lahat ng denominator.
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing (2023). Sinusuri na ng naunang pag-aaral ang oras sa propesyonal na dubbing ng tao. Ang ambag namin ay ang may takdang saklaw na magkapares na talahanayan ng oras ng FLEURS file at ang interpretasyon nito para sa pagpapasa ng produksyon, hindi ang pagtuklas ng mga limitasyon sa oras ng dubbing o isang pamantayan para sa propesyonal na dubbing.
- Itinakda ang 15 segundong oras bilang halimbawang pagpaplano bago ang mga resulta. Tuntunin sa median: 186 magkakatugmang sipi ang may median sa Ingles na ≤15 segundo; bilangin ang target na median na >15. Tuntunin sa lahat ng naobserbahang take: 178 ang may bawat take sa Ingles na ≤15; bilangin ang siping may bawat naobserbahang target na take na >15. Kasya ang katumbas mismo ng hangganan. Deskriptibong resulta ng inilabas na mga rekording ang mga bilang, hindi gabay ng platform o pahayag tungkol sa bawat posibleng pagbasa.
- Walang speaker ID ang nakuhang metadata. Lahat ng rekording sa Aleman, Olandes, Indones, Malay at Filipino ay may tatak na lalaki; lahat sa Thai ay may tatak na babae. Dahil sa kulang na configuration, hindi kasama ang 150 sa 350 sipi sa Ingles sa magkakatugmang batayan. Inilalarawan ng pagsusuri sa mga pares at paulit-ulit na pagbasa ang magkakaibang may takdang saklaw na subset, at hindi nito inaalis ang magkakaugnay na epekto ng mambabasa, kasarian, pagbigkas, salin o pagpapanatili ng rekording. Walang iniulat na confidence interval, ranggo ng bilis ng wika, epektong sanhi at bunga o komersyal na pagtataya.
- Pinagmulan: Google FLEURS, inilaan sa ilalim ng CC BY 4.0. Ang pagpili, kalkulasyon, talahanayan, editoryal na interpretasyon at salin ay mga adaptasyon ng Influence IQ; walang ipinahihiwatig na pag-endorso ng mga may-akda ng dataset. Hinangong buod na numerikal at code ang muling ipinamamahagi ng pampublikong package, hindi orihinal na audio o teksto ng sipi. Hindi binabago ng pag-round sa display ang eksaktong pinagmulang bilang o ang parehong pangkat ng rekording na pinag-aralan.
Ang artikulong Ingles ang pinagmulan ng lahat ng bersyon sa ibang wika. Parehong nakapirming test recording at isinaling sipi ng FLEURS ang iniulat sa bawat bersyon; hindi lumilikha ng ebidensya tungkol sa bagong merkado ang wika ng artikulo. Responsable ang Influence IQ sa pagsusuri, interpretasyon at mga salin.