Ecommerce merchandising: subukan ang mga palagay mo tungkol sa puwesto ng produkto
Ipinapakita ng isang naunang eksperimento sa sampung aklat kung paano may mga bahagi ng pattern na hindi nasasaklaw ng simpleng adjustment sa puwesto, at kung paano susubukan ang palagay na iyon bago maghambing ng mga product card.
Orihinal na muling pagsusuri sa inilabas na eksperimento nina Compiani, Morozov at Seiler noong 2024 tungkol sa pagpili ng aklat.
Abstrak
Bago magpasiyang mas malakas ang isang alok kaysa sa iba, kailangang isaalang-alang ng negosyo kung saan ipinakita ang bawat isa. Gumamit kami ng inilabas na eksperimento noong 2024 na may sampung e-book upang subukan ang dalawang paraan ng pagsasaalang-alang sa puwesto. Mas mahusay sa kabuuan ang prediksiyon kapag may sariling adjustment ang bawat puwesto kaysa kapag pare-pareho ang adjustment sa bawat hakbang pababa sa listahan. Mas mababa ang katumpakan nito sa ilang puwesto, kaya mahalaga ang buong paghahambing.
Pareho ang impormasyong ginamit ng dalawang modelo tungkol sa aklat at presyo. Na-fit ang mga ito gamit ang 6,176 kalahok at sinuri ang mga prediksiyon sa 3,088 ibang kalahok. Hipotetikal ang mga pagpili, at kailangang pumili ng aklat ang lahat. Para sa mga negosyo at creator na naghahambing ng mga product card, ang aral ay subukan muna ang mga palagay tungkol sa pagkakapuwesto bago iugnay ang resulta sa alok. Hindi tinataya ng pag-aaral ang pagtaas ng benta o tinutukoy ang pinakamagandang pagkakasunod-sunod ng produkto.
Ipagpalagay na ang produktong nasa itaas ng pahina ang may pinakamaraming click. Mas malakas ba ang alok nito, o nakatulong ang puwesto sa listahan? Kailangan ng negosyo ng kapaki-pakinabang na sagot bago baguhin ang ibang card, magbigay ng diskuwento sa mga mukhang mas mahinang produkto, o palitan ang mga iniaalok nito.
Mukhang simple ang pagsasaalang-alang sa puwesto hanggang itanong kung paano. Dapat bang pareho ang adjustment sa bawat hakbang pababa sa listahan? Gumamit kami ng naunang eksperimento upang ihambing ang simpleng paraan sa mas flexible na paraan, saka sinubukan ang dalawa sa mga kalahok na hindi ginamit sa pag-fit ng modelo.
Parehong produkto, magkakaibang puwesto
Ano ang dapat mong malaman sa paghahambing ng puwesto ng produkto?
Dapat makatulong ang paghahambing ng mga product card na maihiwalay ang iniaalok na produkto sa paraan ng pagpapakita nito. Kung karaniwang una ang isang produkto at karaniwang huli ang isa, hindi sapat ang kabuuang resulta ng mga ito upang malaman kung may mas gustong alok ang mga mamimili.
Sa simpleng paraang sinusubukan namin, pareho ang adjustment sa pinagbabatayang preference score ng modelo sa bawat hakbang pababa sa listahan. Ang kapaki-pakinabang na tanong ay kung sapat ang husay nito sa paghula ng pagpili kumpara sa pagbibigay ng magkakaibang adjustment sa bawat puwesto.
Sinubukan namin ang dalawang paraan gamit ang inilabas na eksperimento sa pagpili ng aklat. May kaugnayan ang resulta sa mga negosyo at creator na naghahambing ng mga produkto sa collection page o digital na tindahan. Nagbibigay ito ng paraan upang suriin ang isang palagay sa pagsukat, hindi ng tuntunin kung saan ilalagay ang pinakamabentang produkto.
Mahalaga ito kapag nasa higit sa isang lugar ang isang alok. Maaaring itampok ng creator ang parehong download sa collection page at launch page. Maaaring baguhin ng retailer ang ayos ng isang kategorya. Maaaring sabay na magbago ang produkto, presyo, audience at presentasyon. Ang adjustment sa puwesto ay palagay tungkol sa isang bahagi ng paghahambing, kaya dapat din itong suriin.
Ano ang pinili ng mga kalahok sa eksperimento sa aklat?
Hiniling nina Giovanni Compiani, Ilya Morozov at Stephan Seiler sa mga kalahok mula sa Prolific na pumili nang hipotetikal mula sa sampung e-book, na may randomized na ayos at presyo. Kailangang pumili ng aklat; walang opsiyong walang bilhin. Ginamit namin ang unang gawain sa bawat pinanatiling pagsusumite, hindi ang sumunod na gawain kung saan inalis ang napiling aklat.[1]
Naiulat na ng mga orihinal na may-akda ang mga tugon sa puwesto at presyo. Pinag-aaralan ng kanilang mas malawak na pananaliksik kung paano nakatutulong ang teksto at larawan sa pagtataya ng pagpapalit ng produkto. Mas tiyak ang tanong namin: mas mahusay ba ang prediksiyon kapag pinalitan ang iisang position term, para sa mga kalahok na hindi ginamit ang mga pagpili sa pag-fit ng modelo?
Sa pagsunod sa orihinal na mga tuntunin ng pagiging kuwalipikado, 9,265 pagsusumite ang natira na may 9,264 magkakaibang Prolific participant ID. Dalawang beses lumitaw ang isang ID. Pinagsama namin ang dalawang pagsusumite nito at binigyan ang kalahok ng parehong kabuuang timbang gaya ng iba. Hindi awtomatikong ibang tao ang bawat pagsusumite, at hindi nangangahulugang unang karanasan ng taong iyon sa eksperimento ang unang gawain.[2][3]
Mula Hunyo 11 hanggang Hunyo 26, 2024 ang mga petsa sa pinanatiling source record. Hunyo 14–27 ang nakasaad sa manuskrito, kaya inilalahad namin ang pagkakaiba at walang inaalis batay sa petsa. Hindi natiyak sa mga sinuring materyal ang kuwalipikasyon ayon sa bansa at edad; hindi ito pagtataya para sa mga mamimili sa U.S. o ibang pambansang populasyon.[1][2]
Magkasama ang mga sagot ng kalahok sa buong paghahambing
Mga piniling pagsusumite ng unang gawain ayon sa orihinal na tuntunin ng may-akda; Hunyo 11–26, 2024 ang mga petsa sa pinanatiling source record.
| Grupo | Mga kalahok (ayon sa platform ID) | Pinanatiling pagsusumite |
|---|---|---|
| Lahat ng pinanatili | 9,264 | 9,265 |
| Training | 6,176 | 6,176 |
| Inilaan para sa pagsusuri | 3,088 | 3,089 |
Aling modelo ng puwesto ang mas mahusay humula sa mga pagpili ng test group?
Mas mahusay na nahulaan ng flexible na modelo ng puwesto ang mga pagpili ng test group ayon sa sukatan na itinakda bago ang pagsusuri. Parehong isinasaalang-alang ng dalawang modelo kung anong aklat ang inialok at ang presyong ipinakita. Nagkakaiba lamang ang mga ito sa paraan ng pagrepresenta ng puwesto.
Gumagamit ang baseline ng iisang coefficient para sa bawat hakbang pababa sa listahan. May magkakahiwalay na adjustment ang flexible na modelo para sa ikalawa hanggang ikasampung puwesto, kaugnay ng una. Nagbibigay ito ng mas maraming kalayaan, ngunit mas maraming parameter din ang kailangang tantiyahin. Hindi sapat ang mas mahusay na pag-fit sa sarili nitong training data upang mapagpasiyahan ang paghahambing.
Kaya na-fit namin ang dalawang modelo gamit ang 6,176 kalahok at sinuri ang mga ito sa 3,088 iba pa. Nananatili sa iisang panig ng hati ang lahat ng pagsusumite ng bawat kalahok. May 3,089 pagsusumite sa test group dahil kabilang dito ang umulit na kalahok.
Gumamit kami ng negative log score upang maghambing ng mga prediksiyon. Mas maliit ang parusa sa modelo kapag mas mataas ang ibinigay nitong posibilidad sa talagang pinili ng tao. Mas malaki ang parusa kapag napakaliit ng posibilidad na ibinigay nito sa napiling iyon. Mas mabuti ang mas mababang average na negative log score.
Sa test group, 2.2260 ang average ng baseline at 2.2154 ang sa flexible na modelo, sa natural-log units na tinatawag ding nats. Mga score ng prediksiyon ito, hindi porsiyento ng tamang sagot. Magkasamang ipinapakita ang training at test score upang hindi umasa ang paghahambing sa mas madaling gawaing ilarawan ang datos na nakita na ng modelo.
Dalawang modelo, sinuri sa parehong mga kalahok
Mga piniling sagot sa unang gawain ng sampung aklat noong 2024. Training: 6,176 kalahok at pagsusumite. Test: 3,088 kalahok at 3,089 pagsusumite.
| Modelo ng puwesto | Training score (nats) | Score sa test group (nats) |
|---|---|---|
| Isang linear na position term | 2.2046 | 2.2260 |
| Magkakahiwalay na position term | 2.1899 | 2.2154 |
Ang paired na pagbuti ay 0.0106 nats bawat kalahok, na may tinatayang 95% interval mula 0.0044 hanggang 0.0168. Dito, pabor sa flexible na modelo ang positibong pagbuti. Maliit ang resulta sa sukatang ito, ngunit nasa itaas ng zero ang buong interval.[4]
Itinuturing ng interval na ito na fixed ang dalawang na-fit na modelo at ipinapalagay na independent ang mga grupo ng kalahok. Hindi nito kasama ang kawalang-katiyakan kung ibang training sample ang ginamit sa pag-fit. Sinusuportahan ng natuklasan ang mas mahusay na prediksiyon sa piniling gawaing ito mula sa naunang eksperimento; hindi nito ginagawang pagtaas ng benta ang diperensiya ng score.
Pinabubuti ng flexible na modelo ang log score ng test group
Paired na paghahambing sa 3,088 test participant sa piniling naunang gawain na may sampung aklat.
| Paghahambing | Pagbuti (nats) | 95% interval: ibaba (nats) | 95% interval: itaas (nats) |
|---|---|---|---|
| Log score ng flexible na modelo bawas ang baseline | 0.0106 | 0.0044 | 0.0168 |
Saan lumihis ang dalawang modelo sa mga naobserbahang pagpili?
Ipinapakita ng buong paghahambing ng mga puwesto kung bakit kailangang may detalye ang pangkalahatang score. Sa bawat puwesto, inihahambing namin ang naobserbahang bahagi ng mga pagpili sa average na posibilidad na ibinigay ng bawat modelo. Pantay ang timbang ng bawat kalahok sa mga average ng test group na ito; hindi ito click-through rate.
Sa unang puwesto, 17.16% ang naobserbahang bahagi. 14.64% ang prediksiyon ng baseline, samantalang 17.73% ang sa flexible na modelo. Sa ikasampung puwesto, 9.18% ang naobserbahan, kumpara sa mga prediksiyong 6.37% at 8.74%. Mas malapit ang flexible na modelo sa magkabilang dulo ng partikular na listahang ito.
Naobserbahan at hinulaang pagpili sa lahat ng sampung puwesto
Test group: 3,088 kalahok at 3,089 pagsusumite ng unang gawain mula sa inilabas na eksperimento noong 2024.
| Puwesto | Naobserbahang bahagi ng pagpili | Average na posibilidad ng baseline | Average na posibilidad ng flexible na modelo | Mga pagsusumiteng pumili sa puwestong ito |
|---|---|---|---|---|
| Puwesto 1 | 17.16% | 14.64% | 17.73% | 530 |
| Puwesto 2 | 13.60% | 13.20% | 14.84% | 420 |
| Puwesto 3 | 9.91% | 12.06% | 9.74% | 306 |
| Puwesto 4 | 10.91% | 11.21% | 9.26% | 337 |
| Puwesto 5 | 9.20% | 10.09% | 8.94% | 284 |
| Puwesto 6 | 7.08% | 9.25% | 8.01% | 219 |
| Puwesto 7 | 8.00% | 8.44% | 7.57% | 247 |
| Puwesto 8 | 7.12% | 7.67% | 7.47% | 220 |
| Puwesto 9 | 7.84% | 7.08% | 7.69% | 242 |
| Puwesto 10 | 9.18% | 6.37% | 8.74% | 284 |
Hindi mas malapit ang flexible na modelo sa lahat ng puwesto. Sa ikaapat na puwesto, 10.91% ang naobserbahang bahagi. 11.21% ang prediksiyon ng baseline, samantalang 9.26% ang sa flexible na modelo. Pinabuti ng dagdag na flexibility ang pangkalahatang score sa test group, ngunit mas malaki ang naging diperensiya sa puwestong iyon.
Ipinapakita ng susunod na talahanayan ang naobserbahang bahagi bawas ang hinulaan. Ibig sabihin ng positibong agwat, mas kaunti kaysa sa aktuwal ang hinulaang pagpili sa puwestong iyon; mas marami naman kapag negatibo. Sa pagpapakita ng lahat ng sampung puwesto, hindi napapalitan ng magandang resulta sa isang dulo ang buong paghahambing.
Agwat ng dalawang modelo mula sa mga naobserbahang pagpili
Naobserbahang bahagi ng pagpili bawas ang average na hinulaang posibilidad sa bawat puwesto, gamit ang parehong 3,088 test participant.
| Puwesto | Naobserbahan bawas ang baseline | Naobserbahan bawas ang flexible na modelo |
|---|---|---|
| Puwesto 1 | 2.52 puntos-porsiyento | -0.57 puntos-porsiyento |
| Puwesto 2 | 0.41 puntos-porsiyento | -1.24 puntos-porsiyento |
| Puwesto 3 | -2.15 puntos-porsiyento | 0.17 puntos-porsiyento |
| Puwesto 4 | -0.29 puntos-porsiyento | 1.65 puntos-porsiyento |
| Puwesto 5 | -0.89 puntos-porsiyento | 0.26 puntos-porsiyento |
| Puwesto 6 | -2.17 puntos-porsiyento | -0.93 puntos-porsiyento |
| Puwesto 7 | -0.44 puntos-porsiyento | 0.43 puntos-porsiyento |
| Puwesto 8 | -0.55 puntos-porsiyento | -0.35 puntos-porsiyento |
| Puwesto 9 | 0.76 puntos-porsiyento | 0.14 puntos-porsiyento |
| Puwesto 10 | 2.81 puntos-porsiyento | 0.44 puntos-porsiyento |
Deskriptibo ang mga hanay na ito ng puwesto, at walang hiwalay na pahayag tungkol sa statistical significance. Hindi sinukat ng eksperimento ang galaw ng mata o atensiyon, at hindi tinutukoy ng pagsusuring ito kung bakit naiiba ang isang puwesto. Hindi rin sapat ang kurbadong pattern ng naobserbahang bahagi upang pabulaanan ang baseline: linear ang position term nito sa pinagbabatayang preference score ng modelo, hindi sa porsiyento ng pagpili.
Ibang tanong ang masasagot kung ibabawas lamang ang naobserbahang bahagi sa una at huling puwesto. Binubuod ng mga bahaging iyon ang pagpili sa iba't ibang produkto at presyo. Isinasaalang-alang ng dalawang modelo ang pagkakakilanlan ng aklat at presyo bago magtalaga ng posibilidad sa sampung opsiyon. Hindi sinasabi ng diperensiya ng mga dulo o ng paghahambing ng modelo kung ano ang mangyayari kapag inilipat mo ang isang produkto sa aktuwal na tindahan.
Template ng pagsukat ng puwesto ng produkto na maaari mong gamitin
Bago maghambing ng mga alok, sumulat ng maikling plano ng pagsukat. Maaaring gamitin ang sumusunod na template nang walang pagpaparehistro at bilang halimbawa lamang. Inilalapat nito ang aral ng pag-aaral tungkol sa pagsusuri ng mga palagay; hindi nito ipinapangakong babagay ang parehong modelo sa tindahan mo.
Desisyon: “Kailangan naming magpasya tungkol sa [paghahambing ng produkto o pagbabago sa presentasyon] para sa [pahina o campaign] sa [panahon].” Tukuyin ang desisyon bago pumili ng metrikong pabor sa iyo.
Resulta: “Susukatin namin ang [pagpili, click, pagdagdag sa cart o pagbili].” Piliin ang resultang talagang sinusuportahan ng mga record mo. Itabi rin ang mga inialok na alternatibo, pagkakasunod-sunod at ipinakitang presyo. Dapat manatiling hiwalay ang resulta ng sapilitang pagpili sa resulta ng pagbili.
Yunit: “Ang yunit namin ay [kalahok o ibang malinaw na tinukoy na yunit]. Hahawakan ang paulit-ulit na pagbisita o pagsusumite sa pamamagitan ng [tuntunin].” Pagsamahin ang mga obserbasyon mula sa iisang tao kapag sinusuri ang prediksiyon para sa mga bagong tao. Huwag ituring ang anonymous na session ID bilang patunay ng isang natatanging tao.
Paghahambing: “Pareho ang mga produkto, impormasyon sa presyo at kuwalipikadong obserbasyon na gagamitin ng dalawang modelo. Magkakaiba ang mga ito sa [palagay tungkol sa puwesto].” Tukuyin ang simpleng alternatibo pati ang mas flexible na alternatibo.
Pagsusuri: “Ilalaan namin ang [tinukoy na grupo] bago mag-fit at ihahambing ang [pinangalanang sukatan ng score]. Ipapakita namin ang lahat ng puwesto.” Magpasya kung paano iuulat ang hindi tiyak o mas mahinang resulta bago ito makita.
Paggamit: “Gagamitin ang resultang ito para sa [desisyon sa pagsukat]. Kailangan pa ng ebidensiya tungkol sa [komersiyal na resultang hindi sinukat dito] bago ang [desisyong pangnegosyo].” Pinipigilan ng huling pangungusap na ito ang hindi napapansing pagbabago ng pagsasanay sa prediksiyon tungo sa pagtataya ng kita.
Panatilihin ang iisang kalahok sa isang panig ng pagsusuri
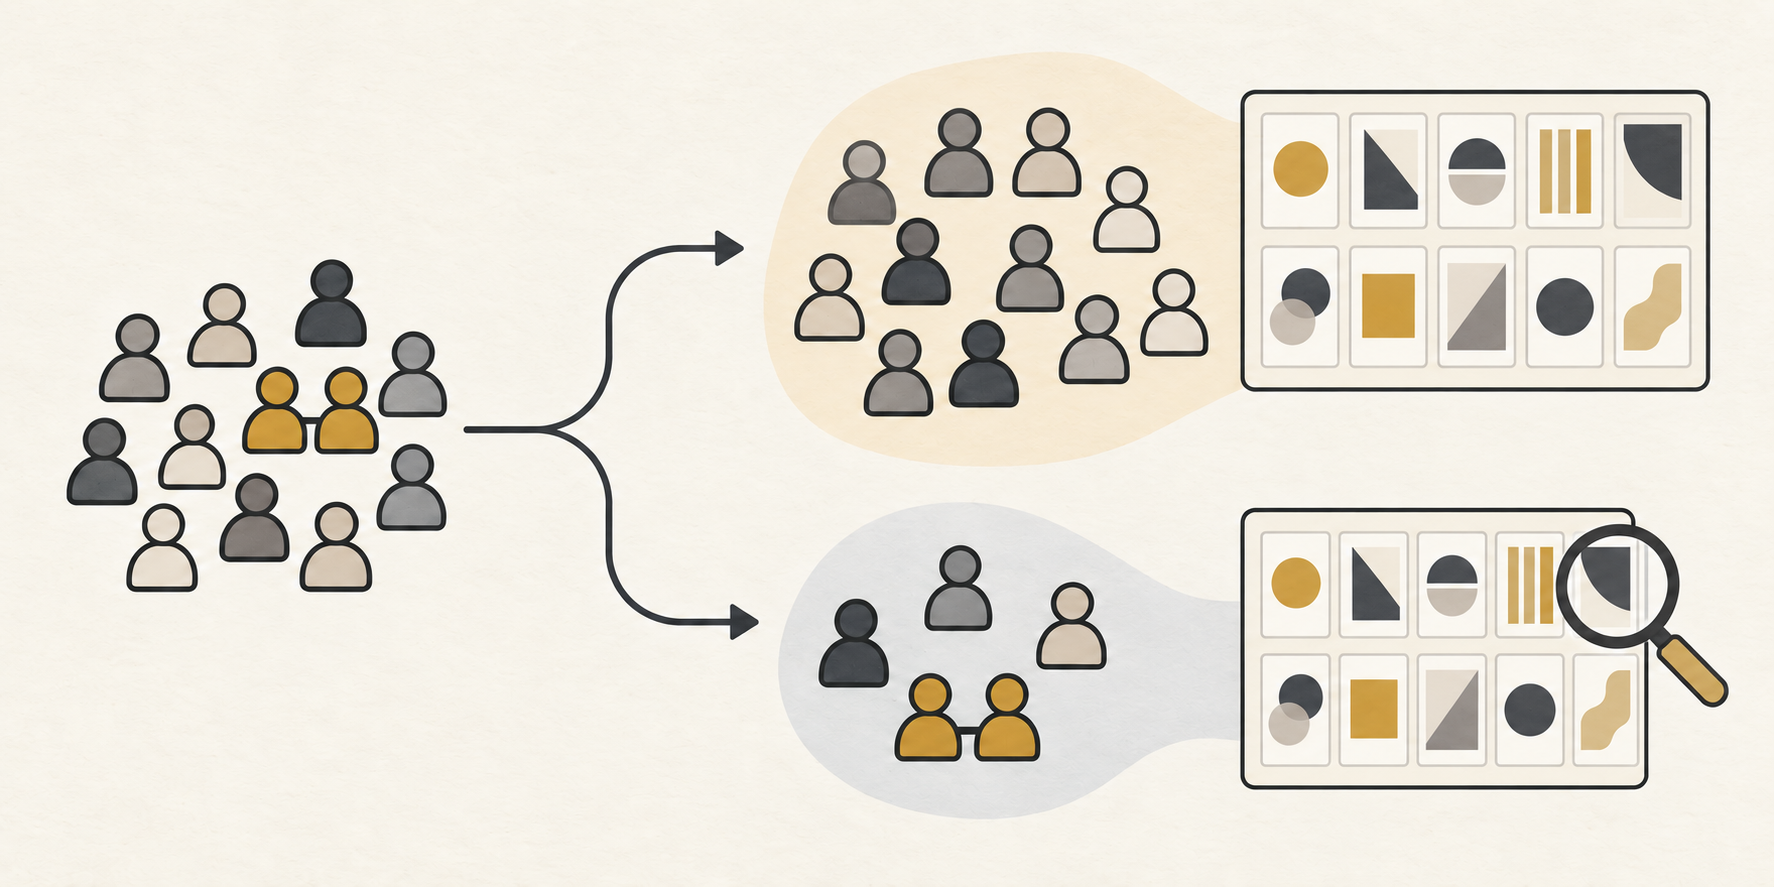
Tukuyin ang paghahambing
Pangalanan ang produkto, puwesto, resulta at yunit ng obserbasyon.
Maglaan ng grupong susuriin
Pagsamahin ang mga pagsusumite ng bawat kalahok.
Suriin ang buong resulta
Ihambing ang mga prediksiyon at ipakita ang bawat puwesto, pati ang mas mahinang mga resulta.
Halimbawa: isang creator na naghahambing ng mga digital na alok
Isipin ang isang kathang-isip na creator na nagbebenta ng writing workbook, workshop at bundle. Nasa itaas ng launch page ang bundle at ito ang may pinakamaraming click. Pinag-iisipan ng creator na baguhin ang mga paglalarawan ng ibang produkto.
Binabago ng plano ng pagsukat ang agarang tanong. Click ang naobserbahang resulta, hindi benta. Kailangang ipakita ng available na mga record kung anong alok ang ipinakita, sa anong pagkakasunod-sunod at presyo. Kung laging nasa unang puwesto ang bundle, hindi malinaw na maihihiwalay ng mga record ang bundle sa puwestong iyon.
Maaaring ganito ang kumpletong plano ng creator: “Gusto naming malaman kung nahuhulaan ng paraan namin ng pagsasaalang-alang sa puwesto ang mga click mula sa mga bagong bisita. Ihahambing namin ang parehong mga alok at impormasyon sa presyo, pagsasamahin ang paulit-ulit na obserbasyon, at iuulat ang buong paghahambing ng puwesto. Hindi kami magpapahayag tungkol sa mga pagbili batay sa mga click record.” Kathang-isip na halimbawa ito ng tanong sa pagsukat, hindi mungkahing resulta.
Makatuwirang susunod na hakbang ang magplano ng paghahambing na may sapat na pagkakaiba-iba upang maihiwalay ang produkto sa puwesto, habang pareho ang depinisyon ng resulta. Pagkatapos, maaaring ihambing ng creator ang simpleng adjustment sa puwesto sa mas flexible na paraan gamit ang nakalaang grupo. Bagong pag-aaral iyon tungkol sa pahinang iyon; walang ibinibigay na inaasahang click rate para rito ang eksperimento sa aklat.
Kung mas mahusay ang flexible na paraan sa prediksiyon para sa nakalaang grupo, may dahilan ang creator upang suriin muli kung paano isinasaalang-alang ng ulat ang pagkakapuwesto. Hindi pa rin nito ipinapakitang tataas ang kita kapag inilipat ang bundle. Kailangan ng ebidensiya tungkol sa aktuwal na pagbabago sa presentasyon at resultang mahalaga sa negosyo bago gumawa ng desisyong pangkomersiyo.
Kung hindi tiyak ang paghahambing, dapat itong sabihin ng creator. Hindi awtomatikong mas mahusay na kasangkapan sa negosyo ang dagdag na flexibility. Ang praktikal na pakinabang ay mas malinaw na pagkakasunod-sunod: unawain kung ano ang kayang paghiwalayin ng mga record, subukan ang palagay sa pagsukat, saka magpasya kung kailangan ng isa pang eksperimento.
Paano kinalkula ng Influence IQ ang paghahambing?
Ginamit namin ang datos ng mga sagot na na-edit at inilabas ng mga may-akda at ang orihinal na mga tuntunin sa pagpili. Inalis ang unang 553 pilot o test record batay sa nakatakdang puwesto ng mga ito sa file. May 10,775 pagsusumite sa natitirang hanay. Nag-iwan ang mga filter sa pag-unawa ng 9,344; nag-iwan ang filter sa pagkumpleto ng 9,265.[2]
Wala nang karagdagang pagsusumiteng inalis sa kani-kanilang hakbang ng consent, finished status at minimum na tagal na 60 segundo. Pagkatapos ng exposure inilalapat ang mga filter sa pagkumpleto at tagal, kaya isang piniling sample ang pinanatiling grupo.
Tinutukoy ng Prolific participant ID ang mga grupo. Isang deterministic na hash split ang naglalaan ng dalawang-katlo ng mga grupo sa training at ang natitira sa test, nang hindi ginagamit ang mga pagpili nila. Sa bawat grupo, pantay na hinahati ng lahat ng pinanatiling pagsusumite ng unang gawain ang kontribusyon ng kalahok. Pareho ang pagtitimbang sa pag-fit, pag-score at mga talahanayan ng puwesto.[3]
Parehong unpenalized multinomial logit ang mga modelo, na may siyam na indicator ng aklat at isang linear na price term. Nagdaragdag ang baseline ng isang linear na position term, kaya 11 ang parameter. Nagdaragdag ang flexible na modelo ng siyam na position indicator, kaya 19 ang parameter. Unang puwesto at pinakamaliit na numerikal na product ID ang mga reference category. Parehong sampung produkto ang laman ng lahat ng kuwalipikadong choice set, at sinuri kung tugma ang napiling ID, presyo at puwesto.
Pina-fit namin ang mga modelo sa training group, pinananatili ang mga na-fit na coefficient, saka binibigyan ng score ang mga pagpili sa test. Ginagamit ng interval ang standard deviation ng paired na diperensiya ng score ng kalahok, 3,088 yunit ng kalahok at 3,087 degrees of freedom. Tinatayang Student-t interval ito maliban kapag natutugunan ang eksaktong mga palagay nito tungkol sa normal na score. Deskriptibo pa rin ang lahat ng sampung paghahambing ng puwesto.[4]
Naglabas ng numerical warning ang pangunahing optimizer ng baseline. Natugunan pa rin nito ang lahat ng kondisyon ng katumpakan na itinakda bago mag-fit, kasama ang paghahambing sa ikalawang starting point. Pinanatili namin ang orihinal na fit; kasama ang detalyadong diagnostics sa mga materyal para sa reproduksiyon.[5]
Nasa mga download ang ipinakitang resulta, orihinal na analysis code at pinagsama-samang numerikal na output. Hindi kasama ang mga row ng source response, participant ID at artwork ng aklat. Kunin nang hiwalay ang source data mula sa release ng mga may-akda. Influence IQ ang responsable sa muling pagsusuring ito at sa interpretasyon nito.
- I-download ang mga ipinakitang resulta (CSV)
- I-download ang analysis code at gabay sa reproduksiyon (ZIP)
Ginagamit ng CSV ang wika ng pahinang ito. Nasa package ang orihinal na calculation code, dokumentasyon ng pamamaraan sa Ingles at pinagsama-samang resulta. Hindi kasama ang mga row ng source response at mga asset ng aklat; kunin nang hiwalay ang datos mula sa release ng mga may-akda.
Mga sanggunian at tala
- Compiani, Morozov at Seiler, Demand Estimation with Text and Image Data, bersiyon 4 ng manuskrito, Pebrero 17, 2026, Seksyon 3 at Apendise C. Pinag-aralan na ng mga may-akda ang mga tugon sa puwesto at presyo. Orihinal at mas tiyak na muling pagsusuri ang paghahambing namin sa nakalaang mga kalahok.
- DeepLogitReplication release ng mga may-akda sa commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Sinusunod namin ang orihinal na cutoff ng pilot batay sa puwesto sa na-edit na response file at ang mga tuntunin ng may-akda sa pagiging kuwalipikado. Hunyo 11–26, 2024 ang mga pinanatiling petsa sa source, na naiiba sa Hunyo 14–27 na nakasaad sa manuskrito; hindi petsa ang batayan ng pagsasama.
- Ibinubukod ng Prolific ang participant ID mula sa ID ng pag-aaral o pagsusumite. Pinananatili namin ang eksaktong participant ID sa pagpapangkat. Hindi hiwalay na pinatutunayan ng mga ID na ito na bawat ID ay ibang tao, o na ang pinanatiling pagsusumite ang unang exposure ng taong iyon.
- Sa paunang itinakdang paghahambing ng Influence IQ, kinukuha muna ang average ng log probability ng flexible na modelo bawas ang baseline sa bawat test participant, saka sa lahat ng kalahok. Ang 95% interval ay ang mean na dinagdagan o binawasan ng Student-t critical value, na minumultiply sa standard deviation ng mga kalahok at hinahati sa square root ng 3,088. Ipinapalagay nitong independent ang mga grupo ng kalahok at fixed ang mga training fit, at hindi kasama ang kawalang-katiyakan ng pag-fit; nangangailangan ang eksaktong resulta ng magkakaparehong normal na distribution ng mga diperensiya ng score ng bawat kalahok na may iisang variance.
- Naglabas ng precision warning ang baseline fit na nagsimula sa zero. Ang pinakamataas na absolute mean gradient nito ay 3.12×10⁻⁹, ang Newton decrement ay 2.50×10⁻⁸, at ang pinakamalaking diperensiya ng log probability sa dalawang starting point ay 7.46×10⁻⁸, mas mababa sa paunang itinakdang limitasyong 10⁻⁸, 10⁻⁶ at 10⁻⁷. Natugunan din ng parehong modelo ang mga kondisyon sa positive curvature at pagkakatugma ng objective value. Pinanatili ang pangunahing mga coefficient mula sa zero start.
Ang artikulo sa Ingles ang source version. Inilalarawan ng mga bersiyon sa ibang wika ang parehong naunang eksperimento; hindi ito mga pagtataya sa pamimili para sa partikular na bansa.