Varuexponering i e-handel: pröva dina antaganden om produktplacering
Ett historiskt experiment med 10 böcker visar hur en enkel justering för placering kan missa delar av mönstret och hur antagandet kan prövas innan produktkort jämförs.
Egen omanalys av det publicerade bokvalsexperimentet från 2024 av Compiani, Morozov och Seiler.
Sammanfattning
Innan ett företag drar slutsatsen att ett erbjudande är starkare än ett annat behöver det ta hänsyn till var de visades. Vi använde ett publicerat experiment med 10 e-böcker från 2024 för att pröva 2 sätt att ta hänsyn till placering. En egen justering för varje plats gav sammantaget bättre prediktioner av valen än samma justering för varje steg nedåt i listan. Den var mindre träffsäker på vissa enskilda platser, så den fullständiga jämförelsen är viktig.
Båda modellerna använde samma information om bok och pris. Vi anpassade dem med data från 6 176 deltagare och kontrollerade deras prediktioner på 3 088 andra deltagare. Valen var hypotetiska och alla var tvungna att välja en bok. För företag och kreatörer som jämför produktkort är lärdomen att pröva antaganden om placering innan resultat tillskrivs ett erbjudande. Studien skattar ingen försäljningsökning och identifierar inte den bästa produktordningen.
Anta att produkten överst på en sida får flest klick. Är det ett starkare erbjudande, eller hjälpte platsen i listan till? Ett företag behöver ett användbart svar innan det skriver om övriga kort, rabatterar varor som ser svagare ut eller ändrar sortimentet.
Att ta hänsyn till placering låter enkelt tills du börjar fråga hur det ska göras. Ska varje steg nedåt i listan få samma justering? Vi använde ett historiskt experiment för att jämföra det enkla tillvägagångssättet med ett mer flexibelt och prövade sedan båda på deltagare som inte användes vid modellanpassningen.
Samma produkter, olika placeringar
Vad bör en jämförelse av produktplacering berätta?
En jämförelse av produktkort bör hjälpa dig att skilja varan som erbjuds från hur den presenterades. Om en produkt oftast kommer först och en annan oftast sist kan totalsiffrorna ensamma inte avgöra om kunderna föredrar ett av erbjudandena.
Det enkla tillvägagångssättet som vi prövar ger varje steg nedåt i listan samma justering av modellens underliggande preferensvärde. Den användbara frågan är om det förutsäger val tillräckligt väl jämfört med att låta olika platser ha olika justeringar.
Vi prövade de 2 tillvägagångssätten med ett publicerat bokvalsexperiment. Resultatet är relevant för företag och kreatörer som jämför produkter på en samlingssida eller i en digital butik. Det ger ett sätt att undersöka ett mätantagande, inte en regel för var din bästsäljande vara ska placeras.
Det spelar roll när ett erbjudande visas på fler än 1 ställe. En kreatör kan lyfta fram samma nedladdning i en samling och på en lanseringssida. En återförsäljare kan ändra ordningen i en kategorilista. Vara, pris, målgrupp och presentation kan skilja sig åt samtidigt. En placeringsjustering är ett antagande om en del av den jämförelsen och behöver kontrolleras för sig.
Vad valde deltagarna i bokexperimentet?
Giovanni Compiani, Ilya Morozov och Stephan Seiler bad personer som rekryterats via Prolific göra hypotetiska val bland 10 e-böcker med slumpad ordning och slumpade priser. Deltagarna var tvungna att välja en bok. Det fanns inget alternativ att inte köpa något. Vi använder den första uppgiften i varje bevarat inskickat svar, inte den senare uppgiften där den valda boken togs bort.[1]
Författarna redovisar redan hur valen varierar med placering och pris. Deras bredare forskning studerar hur text och bilder hjälper till att skatta substitution mellan produkter. Vår fråga är snävare: förbättras prediktionen för deltagare vars val inte användes vid modellanpassningen om en enda placeringsterm ersätts?
Med de ursprungliga urvalsreglerna återstår 9 265 inskickade svar med 9 264 olika Prolific-deltagar-ID:n. 1 ID förekommer 2 gånger. Vi håller ihop båda svaren och ger den deltagaren samma totala vikt som varje annan deltagare. Ett inskickat svar är inte automatiskt en separat person, och en första uppgift är inte nödvändigtvis personens första exponering för experimentet.[2][3]
De bevarade källposterna är daterade från den 11 till den 26 juni 2024. Manuskriptet anger 14–27 juni, så vi redovisar skillnaden och utesluter inga poster utifrån datum. Krav på land och ålder fastställdes inte i det granskade materialet. Det här är inte skattningar för amerikanska konsumenter eller någon annan nationell population.[1][2]
Deltagarens svar hålls ihop genom hela jämförelsen
Selekterade svar från den första uppgiften efter författarnas ursprungliga urvalsregler. De bevarade källposterna är daterade 11–26 juni 2024.
| Grupp | Deltagare (efter plattformens ID) | Bevarade inskickade svar |
|---|---|---|
| Alla bevarade | 9 264 | 9 265 |
| Träning | 6 176 | 6 176 |
| Reserverade för utvärdering | 3 088 | 3 089 |
Vilken placeringsmodell förutsade testgruppens val bäst?
Den flexibla placeringsmodellen förutsade testgruppens val bättre enligt det förhandsbestämda poängmåttet. Båda modellerna tar hänsyn till vilken bok som erbjöds och dess visade pris. De skiljer sig bara åt i hur de representerar placering.
Basmodellen använder 1 koefficient för varje steg nedåt i listan. Den flexibla modellen använder separata justeringar för platserna 2 till 10 i förhållande till den första. Det ger större frihet men också fler parametrar att skatta. Bättre anpassning till modellens egna träningsdata skulle inte i sig avgöra jämförelsen.
Vi anpassade därför båda modellerna med data från 6 176 deltagare och utvärderade dem på de övriga 3 088 deltagarna. Alla svar från samma deltagare stannade på samma sida av uppdelningen. Testgruppen innehåller 3 089 inskickade svar eftersom den innehåller den återkommande deltagaren.
För att jämföra prediktionerna använde vi en negativ logaritmisk poäng. En modell får ett mindre straff när den tilldelar högre sannolikhet åt det val en person faktiskt gör. Den får ett större straff när den tilldelar det valet mycket låg sannolikhet. Lägre genomsnittlig negativ logaritmisk poäng är bättre.
Testgruppens medelvärde var 2,2260 för basmodellen och 2,2154 för den flexibla modellen, i enheter baserade på naturliga logaritmer, även kallade nats. Det är prediktionspoäng, inte procentandelar rätta svar. Poäng för träning och test visas tillsammans så att jämförelsen inte bygger på den lättare uppgiften att beskriva data som modellen redan har sett.
2 modeller, utvärderade på samma deltagare
Selekterade val från den första uppgiften med 10 böcker från 2024. Träning: 6 176 deltagare och inskickade svar. Test: 3 088 deltagare och 3 089 inskickade svar.
| Placeringsmodell | Träningspoäng (nats) | Testpoäng (nats) |
|---|---|---|
| 1 linjär placeringsterm | 2,2046 | 2,2260 |
| Separata placeringstermer | 2,1899 | 2,2154 |
Den parade förbättringen var 0,0106 nats per deltagare, med ett ungefärligt 95-procentigt intervall från 0,0044 till 0,0168. Här talar en positiv förbättring för den flexibla modellen. Resultatet är litet på den här poängskalan, men intervallet ligger över 0.[4]
Intervallet behandlar de 2 anpassade modellerna som fasta och förutsätter oberoende deltagargrupper. Det omfattar inte osäkerhet från att anpassa modellerna till ett annat träningsurval. Resultatet stöder en prediktionsförbättring i den här selekterade historiska uppgiften. Det gör inte poängskillnaden till en försäljningsökning.
Den flexibla modellen förbättrar testgruppens logaritmiska poäng
Parad jämförelse bland 3 088 testdeltagare i den selekterade historiska uppgiften med 10 böcker.
| Jämförelse | Förbättring (nats) | 95-procentigt intervall: nedre gräns (nats) | 95-procentigt intervall: övre gräns (nats) |
|---|---|---|---|
| Logaritmisk poäng: flexibel modell minus basmodell | 0,0106 | 0,0044 | 0,0168 |
Var avvek de 2 modellerna från de observerade valen?
Den fullständiga jämförelsen av placeringar visar varför den övergripande poängen bör redovisas med detaljer. För varje plats jämför vi den observerade andelen val med den genomsnittliga sannolikheten som varje modell tilldelar platsen. Det är medelvärden där varje deltagare i testgruppen väger lika, inte klickfrekvenser.
På plats 1 var den observerade andelen 17,16 %. Basmodellen förutsade 14,64 %, medan den flexibla modellen förutsade 17,73 %. På plats 10 var den observerade andelen 9,18 %, jämfört med prediktioner på 6,37 % och 8,74 %. Den flexibla modellen låg närmare i båda ändarna av just den här listan.
Observerade och predikterade val på alla 10 platser
Testgrupp: 3 088 deltagare och 3 089 svar från den första uppgiften i det publicerade experimentet från 2024.
| Placering | Observerad andel val | Basmodellens genomsnittliga sannolikhet | Den flexibla modellens genomsnittliga sannolikhet | Inskickade svar där platsen valdes |
|---|---|---|---|---|
| Plats 1 | 17,16 % | 14,64 % | 17,73 % | 530 |
| Plats 2 | 13,60 % | 13,20 % | 14,84 % | 420 |
| Plats 3 | 9,91 % | 12,06 % | 9,74 % | 306 |
| Plats 4 | 10,91 % | 11,21 % | 9,26 % | 337 |
| Plats 5 | 9,20 % | 10,09 % | 8,94 % | 284 |
| Plats 6 | 7,08 % | 9,25 % | 8,01 % | 219 |
| Plats 7 | 8,00 % | 8,44 % | 7,57 % | 247 |
| Plats 8 | 7,12 % | 7,67 % | 7,47 % | 220 |
| Plats 9 | 7,84 % | 7,08 % | 7,69 % | 242 |
| Plats 10 | 9,18 % | 6,37 % | 8,74 % | 284 |
Den flexibla modellen låg inte närmare överallt. På plats 4 var den observerade andelen 10,91 %. Basmodellen förutsade 11,21 %, medan den flexibla modellen förutsade 9,26 %. Den extra flexibiliteten förbättrade den övergripande poängen för testgruppen men gav en större avvikelse på den platsen.
Nästa tabell visar observerade andelar minus predikterade andelar. Ett positivt gap betyder att modellen förutsade för få val på den platsen. Ett negativt gap betyder att den förutsade för många. Genom att visa alla 10 platser undviker vi att en tilltalande ändpunkt får representera hela jämförelsen.
Båda modellernas avvikelser från de observerade valen
Observerad andel val minus genomsnittlig predikterad sannolikhet för var och en av de 10 platserna, med samma 3 088 testdeltagare.
| Placering | Observerat minus basmodell | Observerat minus flexibel modell |
|---|---|---|
| Plats 1 | 2,52 procentenheter | −0,57 procentenheter |
| Plats 2 | 0,41 procentenheter | −1,24 procentenheter |
| Plats 3 | −2,15 procentenheter | 0,17 procentenheter |
| Plats 4 | −0,29 procentenheter | 1,65 procentenheter |
| Plats 5 | −0,89 procentenheter | 0,26 procentenheter |
| Plats 6 | −2,17 procentenheter | −0,93 procentenheter |
| Plats 7 | −0,44 procentenheter | 0,43 procentenheter |
| Plats 8 | −0,55 procentenheter | −0,35 procentenheter |
| Plats 9 | 0,76 procentenheter | 0,14 procentenheter |
| Plats 10 | 2,81 procentenheter | 0,44 procentenheter |
Raderna för de olika platserna är beskrivande, utan separata påståenden om statistisk signifikans. Experimentet mätte inte ögonrörelser eller uppmärksamhet, och analysen identifierar inte varför en plats skiljer sig åt. Ett böjt mönster i de observerade andelarna motbevisar inte heller i sig basmodellen: dess placeringsterm är linjär i modellens underliggande preferensvärde, inte i procentandelarna för val.
Att bara subtrahera den första och sista observerade andelen skulle besvara en annan fråga. Andelarna sammanfattar val över olika produkter och priser. Båda anpassade modellerna tar hänsyn till bokidentitet och pris innan de tilldelar sannolikheter bland de 10 alternativen. Varken skillnaden mellan ändpunkterna eller modelljämförelsen berättar vad som skulle hända om du flyttade en viss produkt i en butik i drift.
En mätmall för produktplacering som du kan använda
Skriv ett kort mätunderlag innan du jämför erbjudanden. Följande mall är fritt tillgänglig och illustrativ. Den tillämpar studiens lärdom om att kontrollera antaganden. Den lovar inte att samma modell passar din butik.
Beslut: ”Vi behöver besluta om [produktjämförelse eller presentationsändring] för [sida eller kampanj] under [period].” Ange beslutet innan du väljer ett fördelaktigt mätvärde.
Utfall: ”Vi kommer att mäta [val, klick, tillägg i varukorg eller köp].” Välj det utfall som dina poster faktiskt stöder. Bevara de erbjudna alternativen, deras ordning och visade priser tillsammans med utfallet. Ett resultat där deltagarna måste välja ett alternativ ska hållas åtskilt från ett köpresultat.
Enhet: ”Vår enhet är [deltagare eller en annan tydligt definierad enhet]. Återbesök eller inskickade svar kommer att hanteras enligt [regel].” Håll ihop observationer från samma person när du utvärderar prediktioner för nya personer. Behandla inte en anonym sessionsidentifierare som bevis på en unik person.
Jämförelse: ”Båda modellerna kommer att använda samma produkter, prisinformation och observationer som uppfyller kraven. De kommer att skilja sig åt i [antagandet om placering].” Ange det enkla alternativet liksom det mer flexibla.
Utvärdering: ”Vi kommer att reservera [en definierad grupp] före anpassningen och jämföra [ett namngivet poängmått]. Vi kommer att visa alla platser.” Bestäm hur ett oklart eller sämre resultat ska redovisas innan du ser det.
Användning: ”Det här resultatet ska ligga till grund för [mätbeslut]. Belägg om [kommersiellt utfall som inte mäts här] behövs fortfarande före [kommersiellt beslut].” Den sista meningen hindrar en prediktionsövning från att i tysthet bli en intäktsprognos.
Håll samma deltagares svar på samma sida av uppdelningen
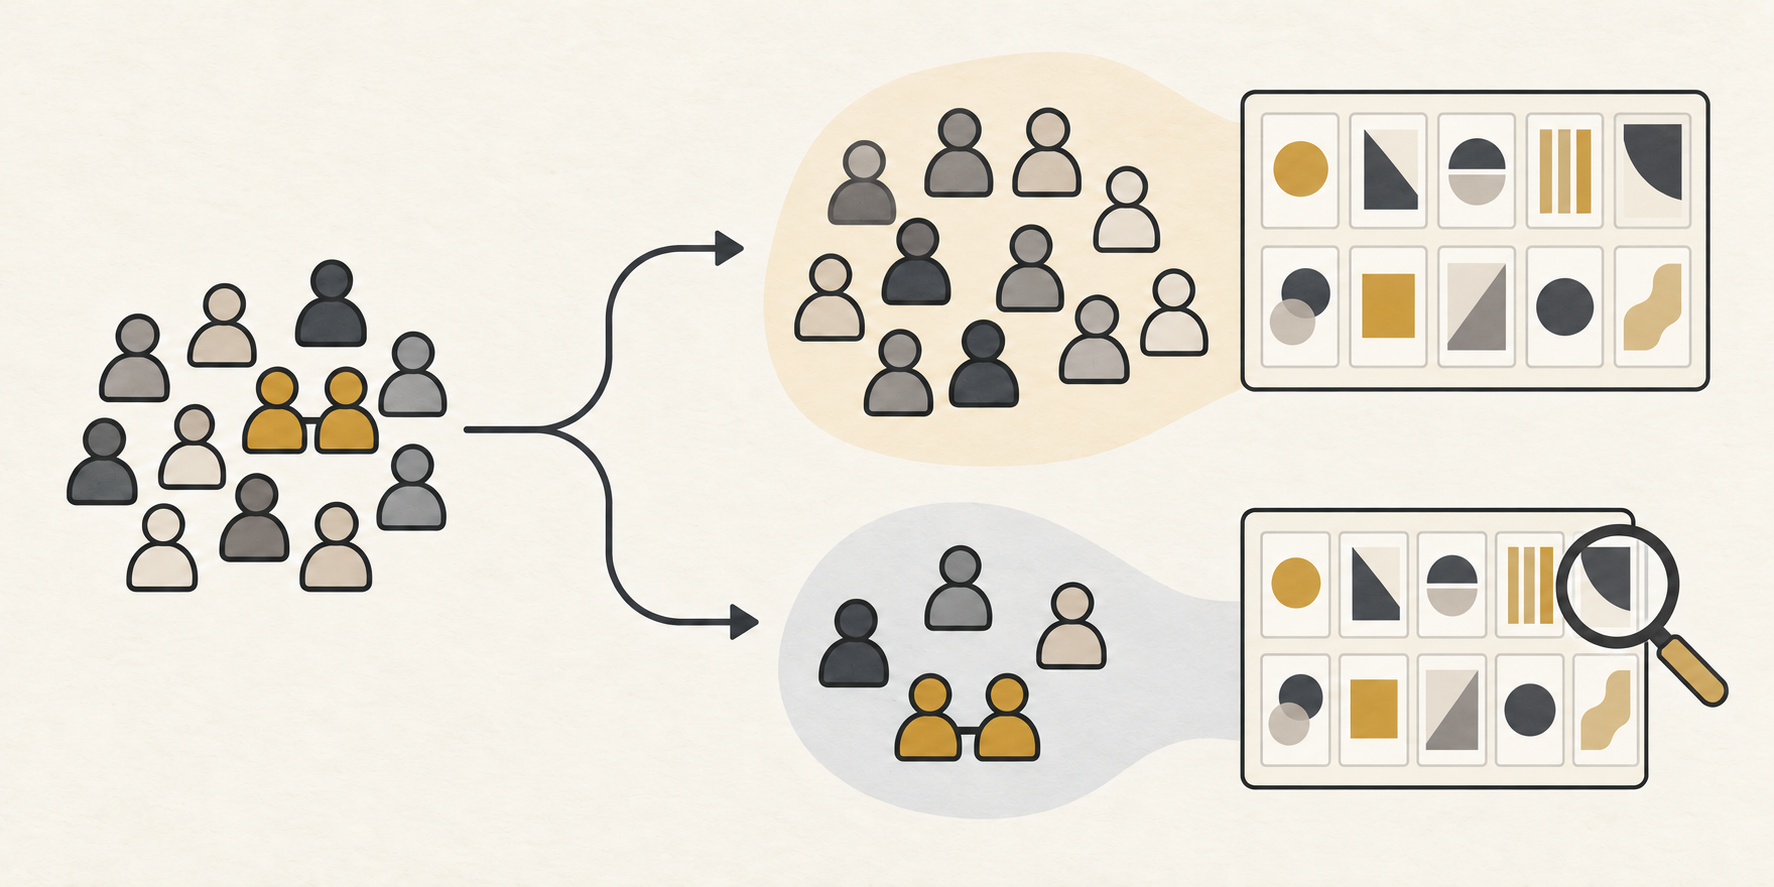
Definiera jämförelsen
Ange produkt, placering, utfall och observationsenhet.
Reservera utvärderingsgruppen
Håll ihop varje deltagares inskickade svar.
Kontrollera hela resultatet
Jämför prediktioner och visa varje plats, inklusive sämre resultat.
Ett illustrativt exempel: en kreatör jämför digitala erbjudanden
Tänk dig en påhittad kreatör som säljer en arbetsbok i skrivande, en workshop och ett paket. Paketet visas överst på en lanseringssida och får flest klick. Kreatören överväger att skriva om de andra produktbeskrivningarna.
Mätunderlaget förändrar den omedelbara frågan. Det observerade utfallet är ett klick, inte en försäljning. De tillgängliga posterna behöver visa vilka erbjudanden som visades, i vilken ordning och till vilka priser. Om paketet alltid ligger först kan posterna inte tydligt skilja just paketet från den platsen.
Kreatörens ifyllda underlag skulle kunna lyda: ”Vi vill veta om vårt sätt att ta hänsyn till placering förutsäger klick från nya besökare. Vi kommer att jämföra samma erbjudanden och prisinformation, hålla ihop upprepade observationer och redovisa den fullständiga jämförelsen av placeringar. Vi kommer inte att dra slutsatser om köp från klickposter.” Det här är ett påhittat exempel på en mätfråga, inte ett föreslaget resultat.
Ett rimligt nästa steg är att planera en jämförelse med tillräcklig variation för att skilja produkt från placering och samtidigt behålla samma utfallsdefinition. Kreatören skulle sedan kunna jämföra en enkel placeringsjustering med en mer flexibel på en reserverad grupp. Det skulle vara en ny studie av den sidan. Bokexperimentet ger ingen förväntad klickfrekvens för den.
Om det flexibla tillvägagångssättet förutsäger den reserverade gruppens utfall bättre har kreatören skäl att ompröva hur rapporten tar hänsyn till placering. Det visar fortfarande inte att intäkterna ökar om paketet flyttas. Ett kommersiellt beslut skulle kräva belägg om den faktiska presentationsändringen och det utfall som spelar roll för verksamheten.
Om jämförelsen är oklar bör kreatören säga det. Större flexibilitet är inte automatiskt ett bättre verktyg för verksamheten. Den praktiska vinsten är en tydligare ordning: förstå vad posterna kan skilja åt, pröva mätantagandet och avgör sedan om ett nytt experiment behövs.
Hur beräknade Influence IQ jämförelsen?
Vi använde författarnas publicerade redigerade svar och ursprungliga urvalsregler. De första 553 pilot- eller testposterna utesluts utifrån sin fasta position i filen. Den återstående ramen innehåller 10 775 inskickade svar. Kontrollerna av förståelse lämnar 9 344 och slutförandefiltret lämnar 9 265.[2]
Samtycke, status för slutförande och minimiregeln om 60 sekunders varaktighet tar inte bort några ytterligare svar i sina respektive steg. Slutförande och varaktighet är filter efter exponering, så den bevarade gruppen är ett selekterat urval.
Prolific-deltagar-ID:n definierar grupperna. En deterministisk uppdelning med hashvärden placerar 2/3 av grupperna i träning och resten i test utan att använda deras val. Inom varje grupp delas deltagarens bidrag lika mellan alla bevarade svar från den första uppgiften. Samma viktning används för anpassning, poängberäkning och tabellerna för placering.[3]
Båda modellerna är multinomiala logitmodeller utan straffterm, med 9 bokindikatorer och 1 linjär pristerm. Basmodellen lägger till 1 linjär placeringsterm, vilket ger 11 parametrar. Den flexibla modellen lägger till 9 indikatorer för placering, vilket ger 19. Plats 1 och det numeriskt minsta produkt-ID:t utgör referenskategorier. Alla valmängder som uppfyller kraven innehåller samma 10 produkter, och valt ID, pris och placering kontrolleras för överensstämmelse.
Vi anpassar modellerna med träningsgruppen, behåller de anpassade koefficienterna och beräknar sedan poäng för testvalen. Intervallet använder standardavvikelsen för de parade skillnaderna i deltagarpoäng, 3 088 deltagarenheter och 3 087 frihetsgrader. Det är ett ungefärligt intervall baserat på Students t-fördelning. Exakthet förutsätter att dess antaganden om normalfördelade poäng är uppfyllda. Alla 10 jämförelser av placering förblir beskrivande.[4]
Basmodellens primära optimerare gav en numerisk varning. Modellen uppfyllde ändå samtliga noggrannhetsvillkor som angetts före anpassningen, inklusive en jämförelse med en andra startpunkt. Vi behöll den ursprungliga anpassningen. De detaljerade diagnostiska uppgifterna ingår i reproduktionsmaterialet.[5]
Nedladdningarna innehåller de visade resultaten, den ursprungliga analyskoden och aggregerade numeriska utdata. De innehåller inte källans svarsrader, deltagar-ID:n eller bokbilder. Hämta källdata separat från författarnas publicerade material. Influence IQ ansvarar för den här omanalysen och dess tolkning.
CSV-filen använder den här sidans språk. Paketet innehåller ursprunglig beräkningskod, översatt metoddokumentation och aggregerade resultat. Källans svarsrader och bokmaterial ingår inte. Hämta data separat från författarnas publicerade material.
Källor och noter
- Compiani, Morozov och Seiler, Demand Estimation with Text and Image Data, manuskriptversion 4, 17 februari 2026, avsnitt 3 och bilaga C. Författarna studerar redan reaktioner på placering och pris. Vår jämförelse av deltagare i en separat testgrupp är en egen, snävare omanalys.
- Författarnas DeepLogitReplication-utgåva vid commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Vi följer den redigerade svarsfilens ursprungliga positionsgräns för pilotposter och författarnas urvalsregler. De bevarade källposterna är daterade 11–26 juni 2024, vilket skiljer sig från manuskriptets beskrivning 14–27 juni. Datum avgör inte vilka poster som ingår.
- Prolific skiljer ett deltagar-ID från en studie- eller svarsidentifierare. Vi bevarar de exakta deltagar-ID:na för gruppering. Dessa ID:n verifierar inte oberoende att varje ID representerar en egen person och fastställer inte att ett bevarat svar var den personens första exponering.
- Influence IQ:s förhandsbestämda jämförelse beräknar medelvärdet av den flexibla modellens logaritmerade sannolikhet minus basmodellens inom varje testdeltagare och sedan över deltagare. Det 95-procentiga intervallet är medelvärdet plus eller minus det kritiska värdet från Students t-fördelning gånger standardavvikelsen mellan deltagare, dividerat med kvadratroten ur 3 088. Det förutsätter oberoende deltagargrupper, är villkorat på fasta anpassningar från träningsdata och utesluter osäkerhet i träningsanpassningen. Exakthet kräver likafördelade normalfördelade deltagarskillnader med gemensam varians.
- Basmodellens anpassning med nollstart gav en precisionsvarning. Det största absolutvärdet i den genomsnittliga gradienten var 3,12 × 10⁻⁹, Newtons dekrement 2,50 × 10⁻⁸ och den största skillnaden i logaritmerad sannolikhet mellan 2 startpunkter 7,46 × 10⁻⁸, under de förhandsbestämda gränserna 10⁻⁸, 10⁻⁶ och 10⁻⁷. Båda modellerna uppfyllde också villkoren för positiv krökning och överensstämmelse i målfunktionens värde. De primära koefficienterna från anpassningen med nollstart behölls.
Den engelska artikeln är källversionen. Språkversionerna beskriver samma historiska experiment. De är inte landsspecifika skattningar av köpbeteende.