Multivariata tester: vad ett test av ditt material kan visa
Att ändra rubrik och bild samtidigt kan hjälpa dig att välja en färdig innehållsvariant. Att lära sig om varje del kräver en annan jämförelse. Historiska testupplägg från Upworthy visar hur mycket som kan vara möjligt även när vissa kombinationer saknas.
Influence IQ:s analys av den explorativa delmängden i Upworthy Research Archive, som omfattar webbplatsexperiment från början av 2013 till april 2015. Huvudjämförelsen innehåller 188 tester som varierade både rubriktext och bild-ID:n. Det här är en kartläggning av testupplägg, inte en analys av klick eller kampanjresultat.
Sammanfattning
Ett ofullständigt multivariat testupplägg kan ändå ge möjlighet till separata jämförelser av rubriker eller bilder. Av 188 Upworthy-tester som uppfyllde villkoren och varierade både rubriktext och bild-ID:n innehöll 31 alla kombinationer. Av de övriga 157 innehöll 150 minst 1 jämförelse där antingen rubriken eller bilden hölls konstant; 75 innehöll båda typerna. Antalen beskriver vilka kombinationer som fanns, inte om testerna gav tillförlitliga eller användbara resultat om prestanda. [1]
Studien använder en historisk explorativ delmängd av webbplatsexperiment från början av 2013 till april 2015, håller utdragstexten konstant och utesluter en dokumenterad period med möjliga problem i tilldelningen från huvudanalysen. När den perioden tas med blir den övergripande lärdomen densamma: 180 av 199 ofullständiga upplägg behåller minst 1 sådan jämförelse. För företag och kreatörer är det praktiska valet att anpassa kombinationerna till frågan: välja en hel innehållsvariant, jämföra 1 del eller undersöka hur 2 delar samverkar.
Ditt team har 2 versioner av en kampanj klara. Den ena kombinerar en produktbild med en rak rubrik; den andra använder en annan bild och en mer samtalsnära rubrik. Om den ena fungerar bättre, vad har ni då lärt er?
En väl genomförd jämförelse kan hjälpa dig att välja mellan de färdiga versionerna. Den visar i sig inte vilken ändring som gjorde skillnaden. Multivariata tester varierar fler än 1 del i en uppsättning kombinationer. Den användbara startfrågan är vilket beslut du vill att kombinationerna ska hjälpa dig att fatta.
Antalet versioner besvarar inte frågan i sig. 4 rubrikversioner tillsammans med 1 bild låter teamet jämföra rubriker i det sammanhanget. 2 rubriker tillsammans med 2 bilder ger också 4 paket när varje kombination ingår, men de möjliggör andra jämförelser. Genom att skriva ned kombinationerna blir skillnaden synlig innan testet börjar.
En färdig innehållsvariant rymmer flera val
Ofullständiga upplägg behöll ofta en användbar jämförelse
Vi undersökte kombinationerna av rubriker och bilder inom enskilda webbplatstester hos Upworthy. Av 3 212 tester som uppfyllde huvudanalysens avgränsningar varierade 188 båda delarna. De flesta övriga tester varierade bara 1 av dem. Vi höll varje test separat och räknade det 1 gång, oavsett hur många personer som kan ha sett det. [2]
Bara 31 av de 188 innehöll varje kombination av sina observerade rubriker och bild-ID:n. De övriga 157 var ofullständiga rutnät. Det låter begränsande tills man frågar vilka jämförelser som fanns kvar i rutnäten. Av dessa 157 upplägg hade 75 både en rubrikjämförelse med samma bild och en bildjämförelse med samma rubrik. Ytterligare 30 hade bara den första typen och 45 bara den andra. 7 hade ingen av typerna.
Sammantaget behöll 150 av de 157 ofullständiga uppläggen, eller 95,5 %, minst 1 möjlighet att jämföra en del medan den andra hölls konstant. Det bevisar inte att någon jämförelse hade tillräcklig trafik, korrekt tilldelning eller ett meningsfullt resultat. Det visar däremot varför ”alla kombinationer testades inte” är ett alltför brett skäl att avfärda ett upplägg.
Tabellen visar fullständiga och ofullständiga upplägg tillsammans. Av alla 188 innehöll 106 båda jämförelsetyperna, 30 bara rubrikjämförelser, 45 bara bildjämförelser och 7 ingen av typerna. ”Båda” betyder minst 1 av varje. Det betyder inte att varje rubrik eller bild kan jämföras på lika villkor.
Den ursprungliga arkivartikeln förklarar redan att redaktörer ofta valde paket utan att testa varje möjlig kombination. Vårt bidrag är den här kartläggningen av de jämförelser som valen lämnade tillgängliga. Vi kan inte återskapa varje redaktörs mål eller bedöma om ett upplägg uppfyllde det. [1]
De flesta upplägg som ändrade båda delarna behöll en jämförelse av en del
188 historiska Upworthy-tester som uppfyller villkoren och varierar rubriktext och bild-ID:n, med konstant utdragstext och den angivna datumbegränsningen. Varje test har samma vikt.
| Jämförelser som finns i upplägget | Tester | Andel av 188 tester |
|---|---|---|
| Rubrik- och bildjämförelser | 106 | 56,4 % |
| Bara rubrikjämförelse | 30 | 16,0 % |
| Bara bildjämförelse | 45 | 23,9 % |
| Ingen jämförelse av enskilda delar | 7 | 3,7 % |
3 upplägg besvarar olika frågor
Tänk dig en keramikstudio som marknadsför en helgworkshop. Den har 2 rubriker: A, ”Gör din första keramikskål”, och B, ”Tillbringa lördagen vid drejskivan”. Bild 1 visar en färdig skål; bild 2 visar drejskivan. Valen är exempel, inte Upworthy-material eller uppmätta kampanjresultat. Låt erbjudandet och övrig visad text vara desamma när du överväger 3 möjliga upplägg.
Först innehåller det fullständiga rutnätet A med bild 1, A med bild 2, B med bild 1 och B med bild 2. Teamet kan jämföra rubrikerna medan bild 1 hålls konstant och sedan göra samma rubrikjämförelse med bild 2. Det kan också jämföra bilderna under varje rubrik. 4 celler ger de möjligheterna; de fastställer inte hur mycket evidens som kommer att samlas in i varje cell.
Det andra, partiella rutnätet innehåller A med bild 1, B med bild 1 och B med bild 2. A med bild 2 saknas. Teamet kan jämföra A och B med bild 1 konstant. Det kan separat jämföra bilderna medan rubrik B hålls konstant. Den saknade cellen tar inte bort dessa 2 jämförelser.
Men det partiella rutnätet lämnar en annan fråga obesvarad av en direkt jämförelse med 4 celler: skulle skillnaden mellan A och B se likadan ut med bild 2? Det finns inget resultat för A med bild 2 att använda. Teamet kan inte heller identifiera det bästa av alla 4 möjliga paket bara genom att välja bland de 3 som observerats. Det otestade paketet kan fungera annorlunda.
Det tredje, diagonala upplägget innehåller bara A med bild 1 och B med bild 2. Ingen del hålls konstant mellan de 2 paketen. Ett giltigt test skulle fortfarande kunna ge stöd för att välja mellan de 2 färdiga versionerna. Det skulle inte separat identifiera rubrikens eller bildens bidrag utifrån enbart den jämförelsen.
Inget av uppläggen är alltid bäst. Om studion måste välja mellan 2 godkända koncept för en viss lansering kan en jämförelse av paketen passa uppgiften. Om den vill återanvända en rubrik med olika bilder behöver den evidens som är relevant för det bredare valet. Ytterligare kombinationer är motiverade när de besvarar en fråga som teamet faktiskt har. [3]
3 illustrativa upplägg innehåller olika kombinationer
Ett fiktivt exempel från en keramikstudio med 2 rubriker, A och B, och 2 bilder, 1 och 2. Cellerna illustrerar testupplägg och är inte observationer från arkivet.
| Kombination av rubrik och bild | Fullständigt rutnät | Partiellt rutnät | Diagonalt upplägg |
|---|---|---|---|
| Rubrik A + bild 1 | 1 | 1 | 1 |
| Rubrik A + bild 2 | 1 | 0 | 0 |
| Rubrik B + bild 1 | 1 | 1 | 0 |
| Rubrik B + bild 2 | 1 | 1 | 1 |
En jämförelse i varje riktning är inte ett fullständigt 2×2-test
Arkivet gör skillnaden konkret. Av de 106 upplägg som innehöll båda jämförelsetyperna innehöll 74 inte ens 1 fullständig rektangel med 2 rubriker och 2 bilder. Ett upplägg kan alltså erbjuda en rubrikjämförelse på ett ställe och en bildjämförelse på ett annat utan att innehålla de 4 celler som behövs för att direkt jämföra deras skillnader.
Titta åter på studions partiella rutnät. Att jämföra A och B med bild 1 besvarar 1 fråga. Att jämföra bild 1 och bild 2 under B besvarar en annan. Ingen av jämförelserna visar om själva rubrikskillnaden ändras när bilden ändras. Den tredje frågan gäller en interaktion: om sambandet mellan 1 del och responsen beror på den andra delen.
I gruppen med 188 upplägg innehöll 32 minst 1 fullständig rektangel. Det omfattar alla 31 fullständiga rutnät och 1 större ofullständigt rutnät. En sådan rektangel ger en möjlighet att bilda en direkt interaktionskontrast. Den visar inte att det finns en interaktion och är inte den enda möjliga grunden för att studera interaktioner med andra upplägg eller modellantaganden.
För ett kampanjteam hör skillnaden hemma i underlaget innan den hör hemma i en statistisk modell. ”Jämför de här 2 rubrikerna med den här bilden” är en snävare begäran än ”hitta en rubrik som fungerar med våra bilder”. Ett resultat som besvarar den första frågan får inte utan vidare bli svaret på den andra.
Det bredare datumintervallet ger samma lärdom för planeringen
Huvudkartläggningen utesluter tester vars intervall av skapandedatum berör perioden från den 25 juni 2013 till och med den 10 januari 2014. Arkivets forskare identifierade möjliga problem i tilldelningen under den perioden. Problemen är viktiga för forskning om orsak och verkan; de gör inte kombinationsuppgifterna oanvändbara för en strukturell kartläggning. Därför upprepade vi också jämförelsen med perioden inkluderad. [4]
Den bredare avgränsningen innehåller 239 tester som varierar båda delarna. 40 innehåller varje kombination, medan 199 är ofullständiga. Bland dessa ofullständiga upplägg behåller 180, eller 90,5 %, minst 1 jämförelse där 1 del hålls konstant, och 93, eller 46,7 %, behåller båda typerna. Motsvarande siffror för huvudanalysen är 95,5 % och 47,8 %. De exakta andelarna ändras, men ofullständiga upplägg behåller fortfarande ofta en specifik jämförelse.
Vi kontrollerade också ett val i texthanteringen. Huvudanalysen jämför strängarna för rubrik och utdrag exakt. När blanktecken i början och slutet tas bort och upprepade blanktecken slås ihop blir det 189 tester som varierar båda delarna, med 31 fullständiga rutnät, 108 som innehåller båda jämförelsetyperna och 32 som innehåller en fullständig rektangel. Kontrollen ändrar vilka upplägg som uppfyller villkoren, så antalen visas med en egen nämnare. [5]
Mediantäckningen är 50 % i alla 3 avgränsningar. Täckning är antalet observerade kombinationer av rubrik och bild delat med antalet möjliga kombinationer utifrån testets observerade rubriker och bild-ID:n. Medianen är en beskrivning, inte ett kvalitetsmått. En saknad kombination kan ha varit irrelevant, olämplig eller utanför redaktörens avsedda jämförelse; arkivet avgör inte varför den utelämnades.
En ändrad avgränsning bevarar skillnaden mellan täckning och jämförelser
Alla kolumner räknar tester, och varje rad använder sin egen nämnare för tester som varierar båda delarna. Texthanteringskontrollen behåller huvudanalysens datumbegränsning; kontrollen med alla perioder behåller exakt texthantering.
| Analysens avgränsning | Tester som ändrar båda delarna | Fullständiga rutnät | Båda jämförelsetyperna | Minst 1 fullständigt 2×2-upplägg |
|---|---|---|---|---|
| Huvudavgränsning: exakt text, datumbegränsning | 188 | 31 | 106 | 32 |
| Text med normaliserade blanktecken, datumbegränsning | 189 | 31 | 108 | 32 |
| Exakt text, alla perioder inkluderade | 239 | 40 | 133 | 42 |
Utgå från beslutet när du skriver underlaget för nästa test
För keramikstudion börjar planeringen med att bestämma vad som ska hända efter testet. Ska teamet välja 1 färdigt paket för att marknadsföra workshopen, behålla 1 bild och ändra rubriken eller använda en rubrik i flera framtida upplägg? Varje beslut kräver olika jämförelser. Ett större rutnät innebär inte automatiskt att teamets arbete används bättre.
Om beslutet gäller färdiga paket ska du lista dem utan att utlova en förklaring av varje del. Om beslutet gäller en rubrik ska du ange vilken bild som ska hållas konstant. Om teamet behöver undersöka om en rubrikskillnad ändras mellan 2 bilder ska de relevanta 4 kombinationerna ingå, eller ett motiverat alternativt upplägg tas fram. Håll detta separat från beslut om responsmått, tilldelning och observationsperiod.
Kontrollera att de föreslagna kombinationerna är rimliga innan du lägger till dem. En rubrik för ett visst erbjudande kanske bara passar ihop med 1 produktbild. Att skapa en olämplig kombination bara för att fylla ett rutnät skulle ändra uppgiften. Teamet kan i stället snäva in frågan eller ta fram versioner som rimligen kan kombineras. Ett fullständigt rutnät är användbart när jämförelserna hjälper beslutet, inte för att en ifylld tabell ser mer grundlig ut.
Använd följande fält som ett kort planeringsunderlag. Texten inom hakparenteser gäller din egen kampanj och är inte ett resultat från studien.
Beslut efter testet: [välj ett färdigt paket; jämför en namngiven del i ett angivet sammanhang; undersök en angiven kombination av delar].
Delar och versioner: [exakta rubriktexter; bildfiler eller stabila ID:n; annat innehåll som ändras].
Paket som ingår: [de kombinationer av rubrik och bild som faktiskt ska visas].
Jämförelser som behövs: [vilka par håller en del konstant; vilka 4 celler stöder interaktionsfrågan, om den är relevant].
Plan för evidens: [responsmått; målgrupp och tilldelning; exponeringsförhållanden; planerad observation och granskningsregel].
Gräns för slutsatser: [vad upplägget kan ge stöd för; vilka otestade kombinationer eller sammanhang som ligger utanför beslutet].
En studio som använder det partiella upplägget med 3 celler kan till exempel skriva: ”Vi jämför rubrikerna med bild 1 och jämför bilderna med rubrik B. Vi testar inte rubrik A med bild 2.” Meningen gör både de 2 användbara frågorna och den saknade jämförelsen synliga utan att slå fast att upplägget är otillräckligt.
En kreatör som förbereder material åt en kund kan använda samma uppdelning i samtal om en ändrad miniatyrbild och titel. Frågan är vilken version eller del kunden vill välja. Våra antal kommer dock från en publicists webbplats och visar inte hur en nutida social plattform tilldelar eller mäter innehållsvarianter.
Ha frågan intill kombinationerna
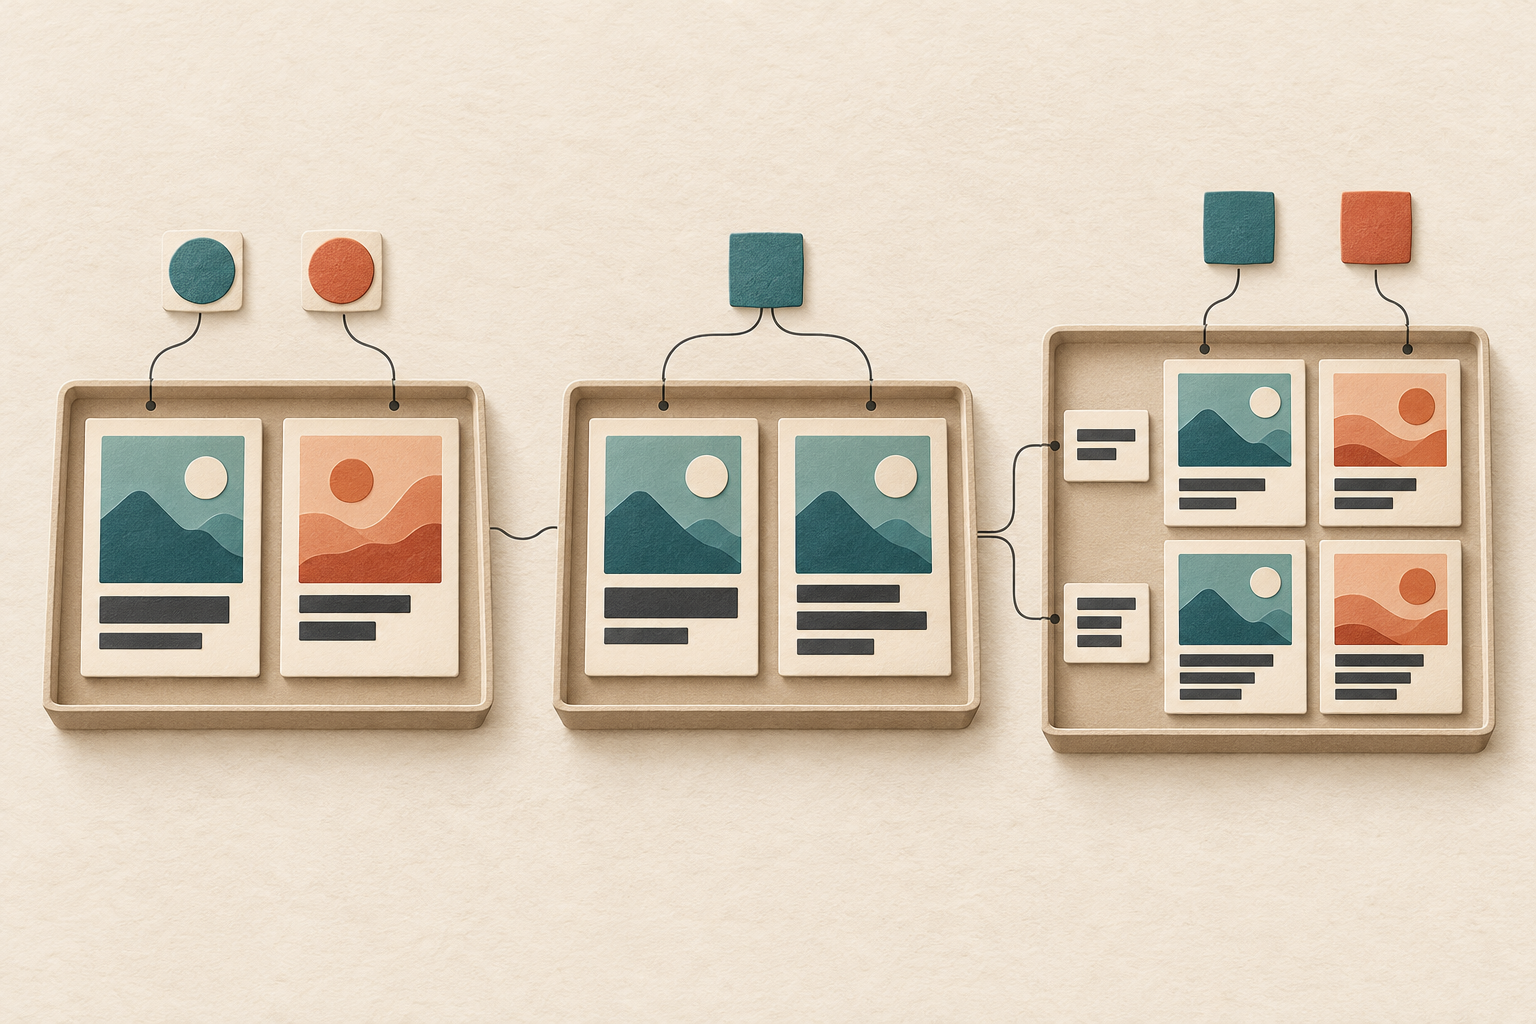
Välj en färdig innehållsvariant
Jämför de paket som kan bli aktuella för beslutet.
Jämför 1 del
Håll den andra delen konstant i den jämförelse du behöver.
Undersök kombinationen
Ta med de kombinationer som behövs för att fråga om en rubrikskillnad ändras mellan bilder.
Så byggdes kartläggningen av testupplägg
Källan är den offentligt publicerade explorativa filen från Upworthy Research Archive, beskriven av J. Nathan Matias, Kevin Munger, Marianne Aubin Le Quere och Charles Ebersole. Den innehåller 22 666 paketrader fördelade på 4 873 tester från det historiska arkivet för 2013–2015. Vi använde rubrik, bildidentifierare, utdrag, testidentifierare, tidsstämpel för skapande och arkivets radindex. Klick, visningar och redaktionella urval användes inte. [1] [6]
En kontroll av den strukturella genomförbarheten gjordes före den slutliga planen för granskningen av testuppläggen och påverkade dess frågeställning. Granskningen är därför en explorativ omanalys, inte en förregistrerad konfirmerande studie. De angivna reglerna behåller tester med användbara strukturfält, tillämpar huvudanalysens datumbegränsning och kräver identisk utdragstext i alla paket inom varje test. Kravet på samma utdrag är ett försiktigt val eftersom artikeln och arkivdokumentationen motsäger varandra om huruvida fältet visades. [6]
Urvalstabellen visar uteslutningar i följd och därefter en uppdelning av testerna som uppfyller villkoren. 5 tester saknar rubrik eller bild-ID; därefter faller 1 050 bort på grund av datumregeln och 606 har varierande utdrag. De 3 212 behållna testerna omfattar 1 624 som bara varierar rubriker, 1 078 som bara varierar bild-ID:n, 188 som varierar båda och 322 med 1 enda observerad kombination. Den sista kategorin kan fortfarande innehålla flera källrader.
Inom ett test räknas upprepade identiska par av rubrik och bild som 1 cell i upplägget. 5 av de 188 tester som varierar båda delarna innehåller upprepade celler. Ett fullständigt rutnät innehåller varje kombination av de rubriksträngar och bild-ID:n som observerats i testet. Olika strängar behöver inte uttrycka olika idéer och olika bild-ID:n behöver inte avse synligt olika bilder; bildfilerna är inte tillgängliga.
I resultaten räknas testuppläggen med lika vikt, inte personer, visningar eller företag. De fastställer inte nutida marknadsföringspraxis, prestanda eller statistisk styrka. Nedladdningarna innehåller de aggregerade resultaten och metoden för att återskapa analysen, inklusive båda kontrollerna av avgränsningen, så att läsare kan granska skillnaden mellan en observerad kombination och en slutsats som dras från den. [7]
Huvudjämförelsen börjar med 188 av 3 212 tester som uppfyller villkoren
Urval från de 4 873 testerna i den offentliga explorativa filen. Uteslutningarna sker i den ordning som visas. De 4 slutliga kategorierna av upplägg delar upp de 3 212 tester som uppfyller villkoren.
Visa urvalsstegen och alla kategorier som uppfyller villkoren
| Urvalssteg eller kategori bland upplägg som uppfyller villkoren | Tester |
|---|---|
| Explorativa tester i utgångsläget | 4 873 |
| Uteslutna: rubrik eller bild-ID saknas | 5 |
| Uteslutna: angivet intervall för skapandedatum | 1 050 |
| Därefter uteslutna: varierande utdragstext | 606 |
| Uppfyller villkoren efter uteslutningar | 3 212 |
| Uppfyller villkoren: rubriken varierar, bilden är konstant | 1 624 |
| Uppfyller villkoren: bilden varierar, rubriken är konstant | 1 078 |
| Uppfyller villkoren: både rubrik och bild varierar | 188 |
| Uppfyller villkoren: 1 observerad kombination | 322 |
- Ladda ner figurvärden och etiketter för avgränsningar (CSV)
- Ladda ner resultat, poster om testernas struktur och analyskod (ZIP)
CSV-filen innehåller 41 värden från de 4 figurerna, med illustrativa celler i försöksupplägget märkta separat från observerade antal och andelar. ZIP-filen innehåller aggregerade resultat, poster om testernas struktur och analyskod. Översatta reproduktionsinstruktioner ingår; ladda ner det ursprungliga offentliga arkivet separat. Inga utfall för klick eller visningar ingår.
Källor och noter
- Matias, J. Nathan; Munger, Kevin; Aubin Le Quere, Marianne; and Ebersole, Charles (2021), The Upworthy Research Archive, a time series of 32,487 experiments in U.S. media, Scientific Data 8, 195. DOI: 10.1038/s41597-021-00934-7. Influence IQ:s analys använder den explorativa delmängden och den rättade källbeskrivningen. Den ursprungliga artikeln förklarar kvalitativt att redaktörer ofta inte testade alla kombinationer av rubrik och bild.
- Nämnare för huvudanalysens tester som varierar båda delarna: 188 tester. Fullständiga rutnät: 31; ofullständiga: 157. Den ofullständiga gruppen innehåller 75 med båda jämförelsetyperna, 30 med bara rubrikjämförelser, 45 med bara bildjämförelser och 7 med ingen av typerna. Alltså behåller 150/157 = 95,5 % minst 1 typ. ”Jämförelse” betecknar en strukturell möjlighet, inte en skattad effekt eller ett verifierat giltigt experiment.
- Studions 3 upplägg är exempel. Ett fullständigt upplägg med 2 faktorer och 2 nivåer innehåller alla 4 kombinationer. Det partiella exemplet utelämnar A med bild 2; det diagonala behåller bara A med bild 1 och B med bild 2. Ett upplägg med 4 celler fastställer inte i sig tilldelningens kvalitet, tillräcklig urvalsstorlek eller en meningsfull interaktion. NIST:s handbok förklarar fullständiga faktoriella försöksupplägg och deras kombinationer.
- Arkivets rättelse från juni 2024 identifierar möjliga randomiseringsproblem från den 25 juni 2013 till och med den 10 januari 2014 och avråder från kausal forskning med den perioden. Rättelsen bevarar uttryckligen möjligheten att använda materialet för annan forskning. Vår huvudanalys utesluter varje test vars intervall av skapandedatum överlappar perioden; tidsstämplar bevisar inte exponeringsdatum och deras tidszon är okänd. Den strukturella kontrollen av hela perioden behåller dessa poster.
- Känslighetskontrollen för blanktecken tar bort blanktecken i början och slutet och slår ihop upprepade interna blanktecken i rubrik- och utdragstext, med skiftläge och skiljetecken bevarade. 8 tester börjar uppfylla villkoren; 1 gemensamt test som uppfyller villkoren byter strukturell klassificering. Nämnarna beräknas om i stället för att hållas på 188. Huvudavgränsningen, blankteckenkontrollen och avgränsningen med alla perioder innehåller 188, 189 respektive 239 tester som varierar båda delarna.
- Den låsta explorativa CSV-filen är upworthy-archive-exploratory-packages-03.12.2020.csv, OSF-filversion 1, 14 260 949 byte. Dess SHA-256 är 8368313b060f4015a0c6fb34e6d788163cee29554144aba9390b14922eb9d8ce. Filen saknar en uppdaterad problemflagga, så datumbegränsningen härleds separat. Artikeln beskriver utdragstext som visad; arkivdokumentationen listar den bland fälten som inte tros ha visats. Genom att hålla utdraget konstant undviker vi att tillskriva det omtvistade fältet skillnader.
- Cornell University publicerar Upworthy Research Archive samt tillhörande kod och dokumentation under Creative Commons Attribution 4.0 International. Influence IQ står för denna härledda strukturanalys; detta innebär inte att Upworthy eller arkivets författare står bakom analysen. Analyspaketet innehåller aggregerade utdata, poster om testernas struktur, kod och översatta reproduktionsinstruktioner. Hämta de ursprungliga offentliga uppgifterna separat från arkivet.
Den engelska artikeln är källutgåvan. Varje språkversion beskriver samma historiska explorativa delmängd från Upworthy och samma illustrativa upplägg. En översättning gör inte resultaten till ett riktmärke för en lokal marknad eller en nutida plattform.