Hvilke oppskriftskommentarer bør du lese for å få tilbakemeldinger?
Å lese kommentarene med flest oppstemmer eller de nyeste kommentarene kan endre fordelingen av vurderinger du ser. En sammenligning av utvalg på 10 kommentarer fra 100 utvalgte oppskriftsdiskusjoner viser hvorfor lesemetoden bør følge spørsmålet du vil besvare.
En analyse av 18 182 kommentarer i et oppskriftsarkiv utgitt av UCI i 2023.
Sammendrag
Når målet var å gjenspeile fordelingen av vurderinger i en oppskriftsdiskusjon, var tilfeldig utvalg nærmere i gjennomsnitt enn kommentarene med flest oppstemmer eller de nyeste kommentarene. Influence IQ sammenlignet utvalg på 10 kommentarer for 100 utvalgte oppskrifter med høye vurderinger i et historisk arkiv med 18 182 kommentarer utgitt av UCI i 2023. Gjennomsnittlige forventede avvik i vurderingsfordelingen var 16,5 prosentpoeng for tilfeldig utvalg, 18,7 for oppstemmer og 20,3 for de nyeste kommentarene. [1][4]
Resultatet måler fordelingen mellom kommentarer med 1–5 stjerner og kommentarer uten vurdering, ikke hvor nyttige rådene er. Utvalg etter oppstemmer var nærmere enn tilfeldig utvalg for 46 oppskrifter og lenger unna for 54. For innholdsskapere innen mat og ansvarlige for nettsamfunn betyr det å skille mellom et utvalg som oppsummerer en diskusjon, og eksempler som brukes til å planlegge et svar.
Du har en oppskrift du vil forbedre, og en lang diskusjon under den. Du rekker å lese et lite utvalg kommentarer før du bestemmer hva som må forklares. Begynner du med kommentarene som fikk flest stemmer, de nyeste eller et tilfeldig utvalg fra diskusjonen?
Du tar det valget før du tolker en eneste setning. Det avgjør hvilke stemmer som kommer med i oppdragsbeskrivelsen du gir til en innholdsskaper, redaktør eller kollega. Vi undersøkte hvordan 3 tydelige utvalgsregler endret 1 målbar egenskap ved beskrivelsen: balansen mellom vurderinger, også kommentarer der forfatteren ikke la igjen noen vurdering.
Et utvalgt utsnitt av en større diskusjon
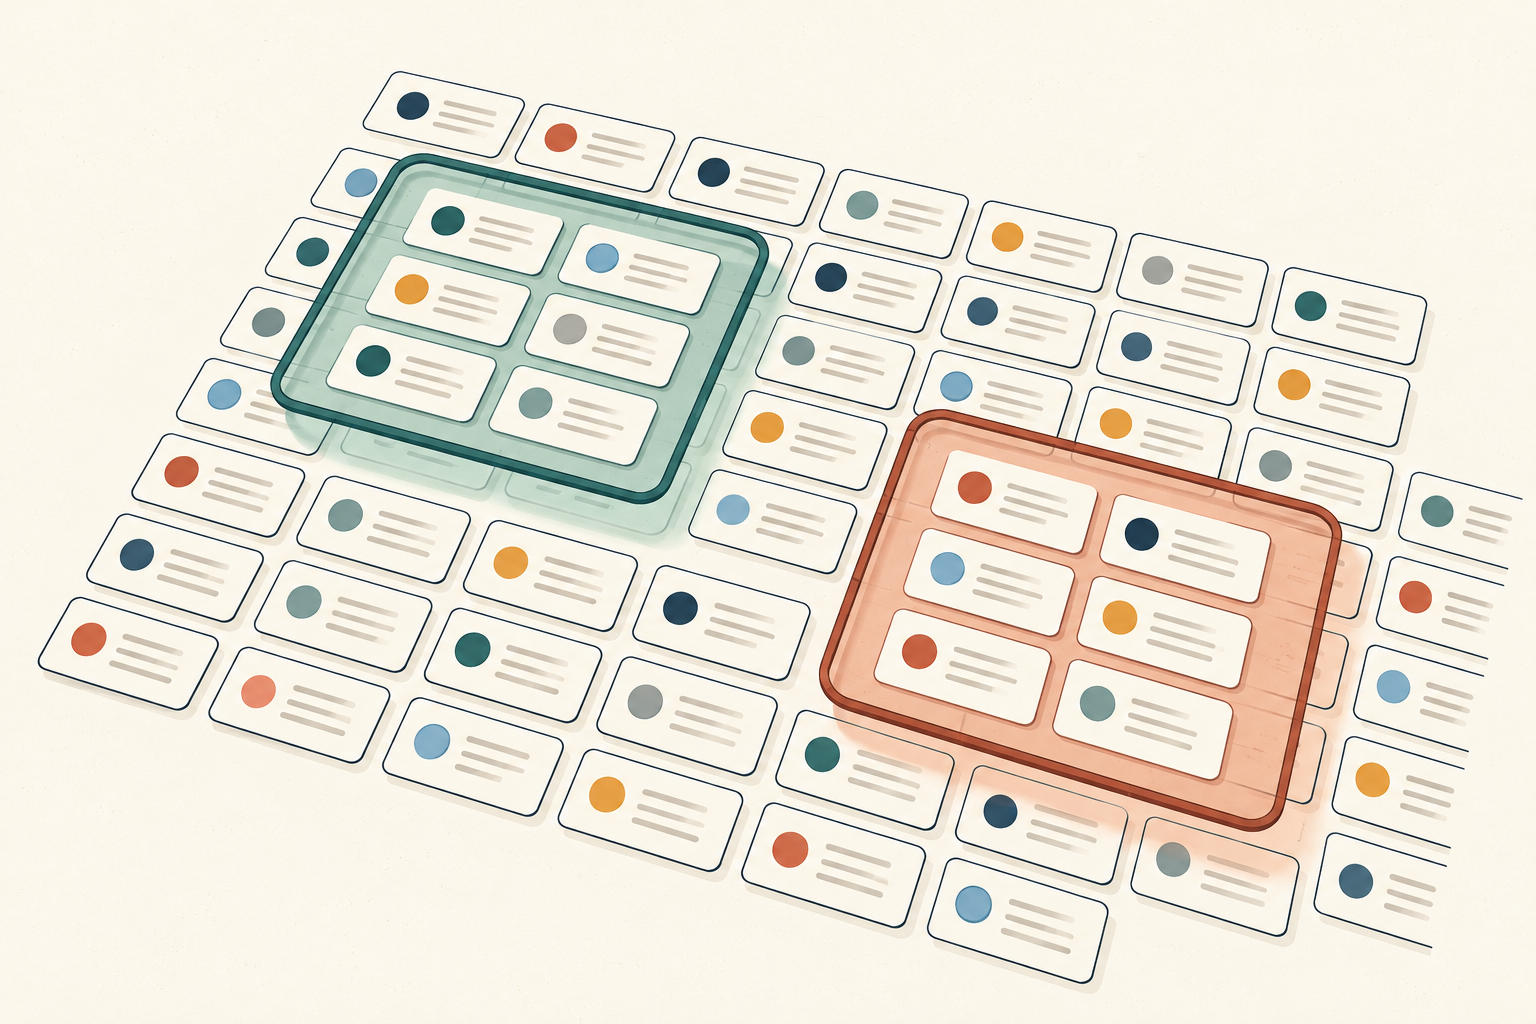
- Valgte kommentarer
- Hele den arkiverte diskusjonen
10 kommentarer kan gi 3 ulike bilder
En oppskriftsskaper som planlegger en oppfølging, må bestemme hva som skal leses først. Kommentarene med flest oppstemmer kan virke som en nyttig snarvei. De nyeste kommentarene gir en annen inngang til diskusjonen. Begge prioriterer noen kommentarer foran andre, men ingen av utvalgene beskriver automatisk hele diskusjonen.
Vi undersøkte dette avgrensede spørsmålet med 18 182 arkiverte kommentarer til 100 utvalgte Taste of Home-oppskrifter med høye vurderinger fra et offentlig datasett utgitt gjennom UCI i 2023. For hver oppskrift sammenlignet vi 10 kommentarer valgt etter oppstemmer, 10 etter opprettelsestidspunkt og 10 valgt tilfeldig. Referansen var fordelingen av vurderinger i alle arkiverte kommentarer til den oppskriften. [1]
Det gjennomsnittlige forventede avviket fra hele vurderingsfordelingen var 18,7 prosentpoeng for utvalg etter oppstemmer, 20,3 for de nyeste kommentarene og 16,5 for tilfeldig utvalg. Hver oppskrift veide like mye i gjennomsnittene, uansett hvor mange kommentarer den hadde. [4]
Sammenlignet med tilfeldig utvalg var avviket 2,2 prosentpoeng større for oppstemmer og 3,8 prosentpoeng større for de nyeste kommentarene. Forskjellene gjelder fordelingen av vurderinger og kommentarer uten vurdering. Vi målte ikke hvilke kommentarer som ga de beste matlagingstipsene, den tydeligste forklaringen eller den nyttigste forretningsideen.
Dette skillet er viktig for innholdsskapere innen mat og ansvarlige for nettsamfunn. En kommentar kan være verdifull nok til å gi en idé til en veiledning uten å være typisk for diskusjonen. Å bruke den som eksempel er et annet valg enn å behandle et kort utvalg som en oppsummering.
Gjennomsnittlig avvik fra hele vurderingsfordelingen til hver oppskrift
10 kommentarer per utvalg i 100 utvalgte oppskriftsdiskusjoner fra det historiske UCI-arkivet. Et mindre avvik betyr at fordelingen mellom vurderinger og manglende vurdering ligner mer på arkivet.
| Utvalgsmetode | Gjennomsnittlig forventet avvik |
|---|---|
| Flest oppstemmer | 18,7 prosentpoeng |
| Nyest etter opprettelsestidspunkt | 20,3 prosentpoeng |
| Tilfeldig utvalg | 16,5 prosentpoeng |
Hva betyr et avvik i vurderingsfordelingen?
Tenk på hver oppskriftsdiskusjon som en blanding av 6 kategorier: 1 til 5 stjerner og kommentarer uten vurdering. Et utvalg på 10 kommentarer har sin egen fordeling. Vi målte hvor langt den mindre fordelingen lå fra hele den arkiverte diskusjonen, med et mål som kalles totalvariasjonsavstand.
Her er et hypotetisk eksempel med bare 2 kategorier. Anta at halvparten av kommentarene gir 4 stjerner og halvparten 5 stjerner. Hvis et utvalg på 10 kommentarer har 7 med 4 stjerner og 3 med 5 stjerner, er fordelingen 70 % mot 30 %, ikke 50 % mot 50 %. Avstanden er 20 prosentpoeng: halvparten av de 2 absolutte forskjellene på 20 prosentpoeng.
Den samme beregningen fungerer for alle 6 kategorier. En lavere verdi betyr at fordelingen ligner mer på vurderingsfordelingen i arkivet. Det betyr ikke at teksten er mer informativ eller at kommentarene er mer sannferdige. Et resultat på 18,7 prosentpoeng betyr heller ikke at 18,7 % av kommentarene er feil.
Vi beholdt kommentarene uten vurdering i sammenligningen. UCI definerer 0 i vurderingsfeltet som ingen vurdering, ikke en poengsum under 1 stjerne. Hvis de ble fjernet, ville diskusjonen som oppsummeres, bli en annen. Tallkategorien alene forteller ikke om en kommentar uten vurdering inneholder et spørsmål, ros, et problem eller noe annet. [1]
Tilfeldig utvalg var nærmere i gjennomsnitt, men ikke for hver oppskrift
Den samlede sammenligningen gir ingen universell vinner. Utvalg etter oppstemmer hadde et mindre forventet avvik enn tilfeldig utvalg for 46 av de 100 oppskriftene og et større avvik for 54. Utvalg av de nyeste var nærmere for 42 oppskrifter og lenger unna for 58. Ingen av sammenligningene endte helt likt. [4]
Dette sammenligner metodenes forventede avvik innenfor hver oppskrift. Det betyr ikke at alle mulige tilfeldige trekk slår utvalget etter oppstemmer i disse 54 diskusjonene. Et bestemt trekk på 10 kommentarer kan tilfeldigvis ligne mye på hele diskusjonen eller gå glipp av deler av den.
Det tilfeldige resultatet er et gjennomsnitt over alle mulige utvalg på 10 kommentarer, der hvert utvalg er like sannsynlig. Det skyldes ikke 1 heldig trekning eller en valgt startverdi for en tilfeldig tallgenerator. Vi tok også gjennomsnittet over mulige utvalg når flere kommentarer hadde samme antall oppstemmer eller tidsstempel ved grensen for utvalget.
Likhet ved grensen krevde gjennomsnittsberegning for 70 oppskrifter ved utvalg etter oppstemmer og 4 ved utvalg av de nyeste. Vi foretrakk ikke en av kommentarene med lik verdi på grunn av forfatter, radplassering eller identifikator. Beregningen undersøker hva som skjer med en oppgitt utvalgsregel, fremfor å behandle en vilkårlig rekkefølge som belegg. [4]
For en innholdsskaper er den praktiske lærdommen beskjeden, men nyttig: Oppstemmer og hvor nye kommentarene er, er utvalgskriterier. Hvis du bruker et av dem til å oppsummere en diskusjon, må du oppgi valget. Ikke anta at et synlig, kort utvalg bevarer balansen i hele arkivet.
Metoden som var nærmest, varierte mellom oppskriftsdiskusjonene
Hvert rangert utvalg sammenlignes med tilfeldig utvalg innenfor samme oppskrift. Dette er sammenligninger av forventede avvik, ikke resultater fra enkelte tilfeldige trekk.
| Utvalgsmetode | Nærmere enn tilfeldig utvalg | Likt tilfeldig utvalg | Lenger unna enn tilfeldig utvalg |
|---|---|---|---|
| Flest oppstemmer mot tilfeldig utvalg | 46 | 0 | 54 |
| Nyeste mot tilfeldig utvalg | 42 | 0 | 58 |
Velg spørsmålet før du velger kommentarene
Metoder for kundetilbakemeldinger har ulike formål. En virksomhet kan ønske å forstå et overordnet mønster, undersøke et bestemt problem eller finne et spørsmål til neste innlegg. Studien tar for seg én del av dette: om et lite utvalg bevarer vurderingsfordelingen i en diskusjon. Den rangerer ikke alle måter å samle tilbakemeldinger på.
Hvis spørsmålet er «Hvordan ser denne diskusjonen ut samlet sett?», må du først definere hvilke kommentarer som hører til. Et tilfeldig utvalg fra en tilgjengelig, fullstendig liste unngår bevisst å favorisere stemmer eller nylige opprettelsestidspunkter. I dette arkivet var det nærmere i gjennomsnitt, men et lite tilfeldig utvalg hadde fortsatt et målbart avvik. 10 var vårt valgte antall for sammenligningen, ikke en anbefaling om at 10 kommentarer er nok.
Hvis spørsmålet er «Hva bør jeg svare på neste gang?», kan en bestemt kommentar fortjene oppmerksomhet alene. Et tydelig spørsmål om å bytte en ingrediens kan gi grunn til å kontrollere oppskriften og lage en forklaring. Du trenger ikke kalle spørsmålet vanlig før du svarer. Om det er relevant for neste innhold, er en egen vurdering.
Hvis spørsmålet gjelder nylige endringer, kan opprettelsestidspunktet avgrense en relevant periode å lese fra. Gjør perioden tydelig i oppsummeringen. De nyeste kommentarene i studien var dem med de siste opprettelsestidsstemplene i det lagrede arkivet, ikke kommentarer som kommer i dag eller rekkefølgen som nå vises på nettstedet.
Selv hele kommentararkivet er et begrenset sammenligningsgrunnlag. Det inneholder bidrag fra dem som valgte å kommentere, ikke alle som leste eller prøvde en oppskrift. Trenger virksomheten tilbakemeldinger fra dem som aldri kommenterer, må den finne en annen måte å nå dem på. En nærmere likhet med kommentararkivet kan ikke fylle dette hullet. Hold slik ekstra tilbakemelding adskilt, slik at kilden og utvalget fortsatt er forståelige.
Før 2 separate notater: Det ene beskriver utvalget som brukes til å oppsummere diskusjonen, og det andre lister spørsmål det er verdt å undersøke. Dette er et forslag til planlegging, ikke en arbeidsflyt som er testet i studien.
Et fiktivt eksempel: planlegg en oppfølging av en oppskrift
Se for deg en innholdsskaper innen mat som planlegger å følge opp en bakeoppskrift. En kommentar med mange oppstemmer spør om en annen form vil fungere. Innholdsskaperen fristes til å åpne neste video med «Alle sliter med størrelsen på formen.» Dette er en fiktiv situasjon, ikke en kommentar eller oppskrift hentet fra datasettet.
Spørsmålet om formen kan være verdt å svare på uten at det viser hvor vanlig det er. Oppstemmer fastslår ikke hvem som prøvde oppskriften eller hadde den samme erfaringen.
En mer presis oppdragsbeskrivelse ville være: «En leser spurte hvordan valget av form påvirker denne oppskriften. Vis formen som ble brukt, forklar målene og pek på hva som må sjekkes før du anbefaler en annen.» Innholdsskaperen kan deretter kontrollere detaljene om matlagingen. Kommentaren gir spørsmålet å starte med; den fastslår ikke svaret.
Hvis innholdsskaperen også vil oppsummere diskusjonen, bør et eget notat forklare hva som ble lest og hvordan det ble valgt. Et tilfeldig utvalg fra en fullstendig, tilgjengelig liste skal gi hver kommentar lik sjanse uten å velge samme kommentar 2 ganger. Å bla til noen praktiske steder er ikke den tilfeldige fremgangsmåten som ble undersøkt her.
Når en fullstendig liste ikke er tilgjengelig, må du beskrive utvalget du faktisk kan gjøre. «Vi gikk gjennom de første kommentarene som ble vist med denne sorteringen» er mer opplysende enn å kalle det et representativt utvalg. Ikke knytt arkivets tallfestede avvik til denne andre prosessen.
Oppfølgingen bør vise utstyret og svare på det kontrollerte spørsmålet. Noter hva du har forklart, slik at neste gjennomgang kan rette seg mot ubesvarte spørsmål. Vurder forklaringen ut fra tilbakemeldinger på selve oppfølgingen.
Hold utvalg og tolkning adskilt
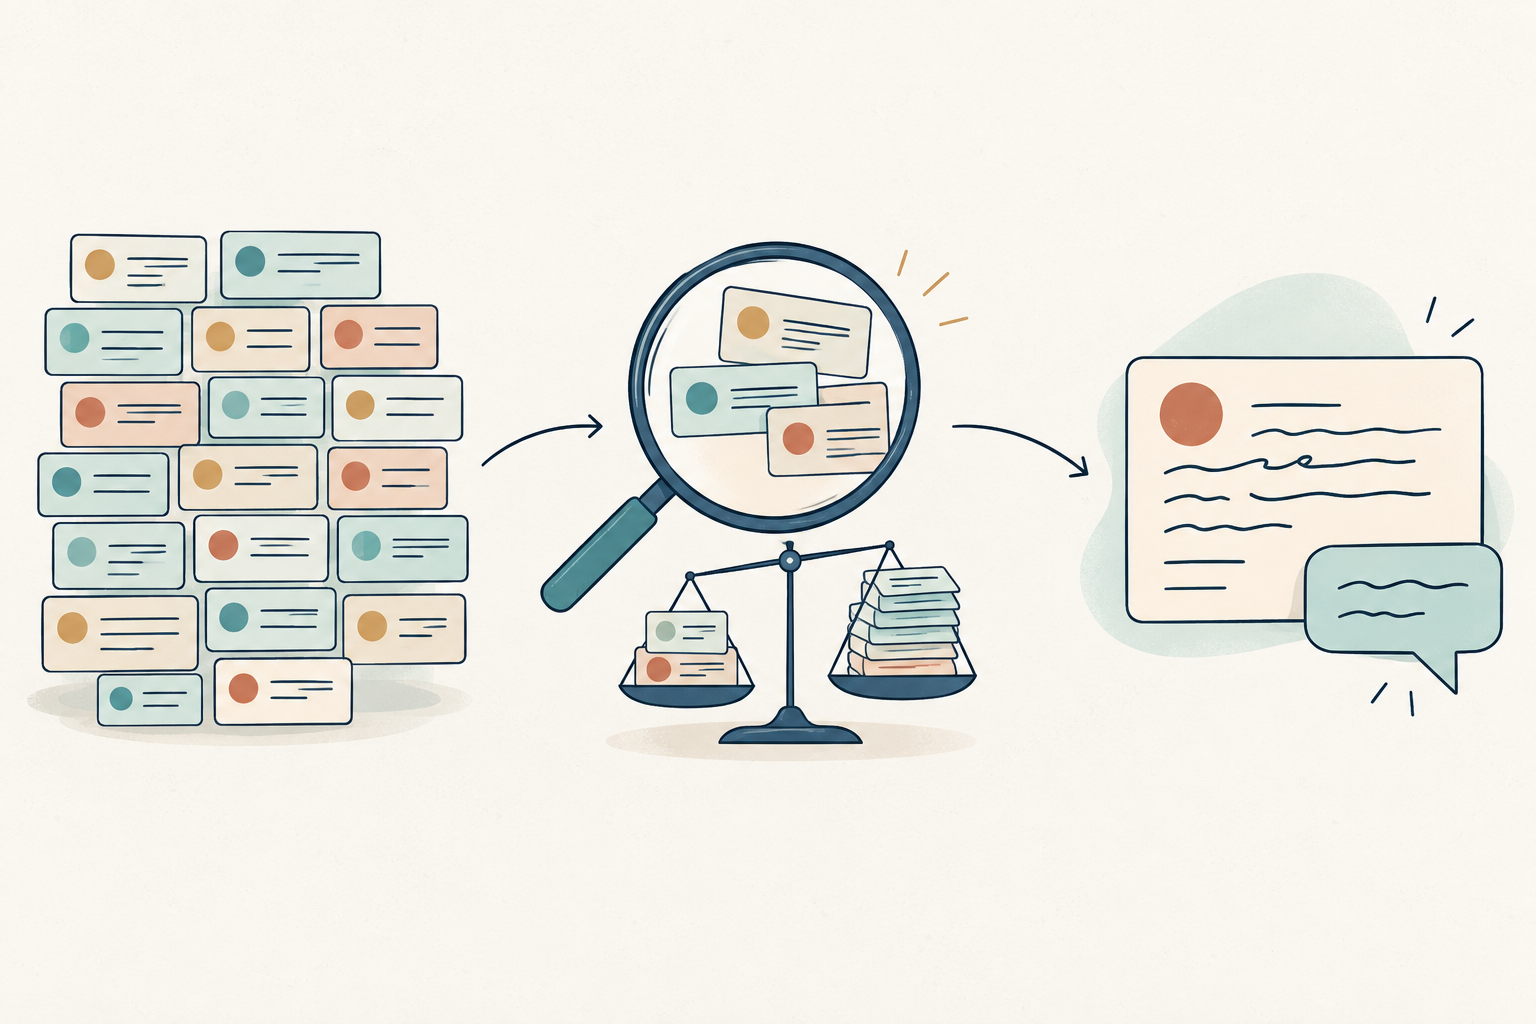
Definer kommentarene som skal leses
Oppgi diskusjonen og utvalgsregelen før du leser.
Vurder hva utvalget dekker
Hold det valgte utsnittet adskilt fra hele diskusjonen.
Les kommentaren i sammenheng
Bruk det faktiske spørsmålet til å planlegge et svar, og kontroller svaret.
En kort oppdragsbeskrivelse for å lese en oppskriftsdiskusjon
Bruk disse spørsmålene før du gir en innholdsskaper eller kollega i oppdrag å gå gjennom kommentarer. De er praktisk hjelp til planlegging, ikke spørsmål fra kildedatasettet.
Beslutning: Hva skal lesingen gi grunnlag for? Oppgi en konkret oppgave, som å forklare et trinn i oppskriften eller velge tema for oppfølgingen. Skill en forespørsel om eksempler fra en forespørsel om å beskrive hele diskusjonen.
Omfang: Hvilken oppskrift, plattform og periode inngår? Oppgi om listen du har tilgang til, er fullstendig. Tell kommentarer som kommentarer; ikke kall dem unike personer eller verifiserte kunder uten eget belegg.
Utvalg: Hvordan skal kommentarene komme med i lesingen? Noter sorteringen eller den tilfeldige fremgangsmåten, antallet som leses og en eventuell regel for like verdier. Behold kommentarer uten vurdering når de inngår i diskusjonen du vil forstå.
Observasjoner: Hva sa de valgte kommentarene faktisk? Skill et direkte spørsmål fra din tolkning av det. Behold nok sammenheng til å forstå saken, men hold personopplysninger utenfor en delt oppdragsbeskrivelse.
Neste handling: Hvilken påstand eller detalj i oppskriften må sjekkes før publisering? Gi kontrollen til noen som kan svare. Skriv den foreslåtte forklaringen og hvor den skal publiseres, uten å gjøre de valgte eksemplene til en udokumentert påstand om utbredelse.
Slik sammenlignet vi de 3 utvalgsmetodene
Kilden er datasettet Recipe Reviews and User Feedback av Ali, Matuszewski og Czupyt, utgitt av UCI i 2023 under CC BY 4.0. Det inneholder kommentarer fra en utvalgt liste med 100 Taste of Home-oppskrifter med høye vurderinger. Utgivelsesåret fastslår ikke en nøyaktig innsamlingsdato, og det tilgjengelige kildematerialet fastslår ikke at alle opprinnelige kommentarer ble samlet inn. Dette er en analyse av et historisk arkiv, ikke en målestokk for dagens plattform. [1][2][3]
Vi validerte hele det utgitte arkivet: 18 182 ulike kommentaridentifikatorer fordelt på 100 oppskriftsposisjoner. Hver oppskrift hadde mer enn 10 kommentarer, så alle 100 ble med i sammenligningen. Flere kommentarer fra samme person forblir flere kommentarer. Vi fjernet ikke dubletter på personnivå og analyserte ikke vurderingstekst, navn, brukeromdømme eller kildens rangeringspoeng.
For hver oppskrift valgte oppstemmeregelen de 10 kommentarene med høyest observert antall oppstemmer. Regelen for nyeste kommentarer brukte de 10 siste opprettelsestidsstemplene. Når grenseverdien var lik, var hver mulig måte å fylle de resterende plassene fra denne gruppen på like sannsynlig. Tilfeldig utvalg ga hvert delsett på 10 kommentarer i oppskriftens arkiv lik sannsynlighet.
For hvert mulig utvalg sammenlignet vi vurderingsfordelingen i de 6 kategoriene med hele oppskriftsarkivet og tok deretter gjennomsnittet av avstanden under utvalgsregelen. Eksakte sannsynlighetsberegninger gir denne forventningen uten simulering. Det er viktig å ta gjennomsnittet av avstandene: Å beregne en avstand først etter at kategoriandelene er gjennomsnittsberegnet, ville besvare et annet spørsmål og kunne skjule utvalgsvariasjon.
Deretter tok vi gjennomsnittet av de forventede avstandene for hver oppskrift, med lik vekt for alle oppskrifter. Forskjellene ble beregnet før avrunding til 1 desimal. Antallet på 10 kommentarer, vilkårene for å bli tatt med, sammenligningene og rapporteringsplanen var fastsatt før vi undersøkte målresultatene. Vi valgte ikke et annet antall eller en fordelaktig undergruppe av oppskrifter etterpå.
Resultatene beskriver dette avgrensede arkivet og de angitte utvalgsreglene. Derfor rapporterer vi ikke noe konfidensintervall for en større populasjon eller noen årsakseffekt. Samlede oppstemmer viser ikke eksponering eller stemmehistorikk. Den opprinnelige forskningsartikkelen undersøker tekstklassifisering; denne analysen følger i stedet UCIs dokumenterte stjernekategorier og undersøker utvalg. Den tekniske metoden forklarer skillet mellom kildefeltene. [1][2]
Nedlastingene inneholder de aggregerte resultatene, en tallkontroll for hver oppskriftsposisjon og kode for å gjenskape analysen. De inneholder ikke kommentartekst, navn eller brukeridentifikatorer. Kildedata er tilgjengelige separat fra UCI. Kildehenvisning til forfatterne og dataarkivet betyr ikke at de støtter vår fortolkning. [1][3]
Ingen registrering kreves. Nedlastingene inneholder aggregerte sammenligninger, numeriske resultater per oppskriftsposisjon og oversatte metodeforklaringer. Ingen kommentartekst, brukernavn eller individuelle kommentaridentifikatorer er inkludert. Kildedatasettet er tilgjengelig separat fra UCI. [1]
Kilder og merknader
- Ali, A., Matuszewski, S. og Czupyt, J. (2023). Recipe Reviews and User Feedback [Datasett]. UCI Machine Learning Repository. DOI: 10.24432/C5FG95. UCI dokumenterer 18 182 kommentarer og definerer stjerner fra 1–5, der 0 betyr ingen vurdering. Influence IQ bruker det utgitte arkivet i beregningene, ikke dagens nettstedsdata.
- Kildens forskningsartikkel, «Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models», beskriver de utvalgte oppskriftenes kilde og en studie av tekstklassifisering. Beskrivelsen av best_score er i konflikt med UCIs dokumenterte vurderingsfelt. Vi bruker stars og analyserer ikke best_score eller vurderingstekst. Det tilgjengelige materialet fastslår verken nøyaktig tidspunkt for øyeblikksbildet eller full dekning av innsamlingen.
- UCI-datasettet er lisensiert under Creative Commons Attribution 4.0. Influence IQ har beregnet nye aggregerte sammenligninger fra det. Henvisning til datasettet betyr ikke at forfatterne, UCI eller Taste of Home støtter analysen. Nedlastingene videreformidler ikke enkeltkommentarer eller brukeridentiteter.
- Influence IQ (2026). Utvalg av tilbakemeldinger på oppskrifter: analysemetode, aggregerte resultater og kode for å reprodusere analysen. Pakken dokumenterer den fastlagte sammenligningen av 10 kommentarer, nøyaktige beregninger av forventet totalvariasjon, håndteringen av uavgjorte verdier og numeriske resultater for alle 100 oppskriftsposisjonene. Kildedataene hentes separat fra UCI. Oversatte forklaringer følger med de opprinnelige tekniske filene.
Artikkelen, planleggingsbriefen, figuretikettene og CSV-filen med resultatene finnes på alle artikkelspråk. Den tekniske pakken for å reprodusere analysen inneholder oversatte forklaringer. Alle utgaver beskriver det samme historiske oppskriftsarkivet og den samme analysen.