편집을 확정하기 전에 번역 내레이션의 길이를 재세요
영어 낭독본은 장면 길이에 맞아도 번역한 녹음은 그 시간을 넘길 수 있습니다. 연구용 지문 200개를 짝지어 비교한 이번 연구는 화면 편집을 확정하기 전에 제작 인계에 다국어 내레이션의 길이 정보가 필요한 이유를 보여 줍니다.
영어 지문 350개를 기준으로, FLEURS 테스트 분할의 10개 구성에 공통으로 있는 번역 지문 200개의 메타데이터상 녹음 길이를 기술통계로 분석했습니다. 상업용 내레이션 작업이 아닌 연구용 낭독 지문입니다. 메타데이터는 2026년 10월 24일(UTC)에 확보했습니다.
초록
현지화한 영상의 길이를 영어 내레이션에 맞춰 확정해도 될까요? 먼저 번역본을 읽는 데 걸리는 시간을 재세요. 선택한 FLEURS 테스트 구성 10개에 모두 있는 지문 200개의 메타데이터상 녹음 길이를 비교했습니다. 반복 낭독의 길이를 지문별 중앙값으로 요약한 뒤 각 지문에 같은 가중치를 부여했습니다. 영어 대비 짝지은 길이 변화의 중앙값은 네덜란드어 녹음의 −6.1%에서 필리핀어 녹음의 +82.4%까지였으며, 어느 값도 해당 언어 전체에 적용할 제작 여유분을 뜻하지 않습니다.[1][2]
15초로 고정한 예시는 인계에 필요한 정보를 구체적으로 보여 줍니다. 영어 녹음 중앙값이 15초 이내인 지문 186개 중 필리핀어 녹음 중앙값이 15초를 넘은 지문은 110개였습니다. 더 엄격한 기준을 적용했을 때는 관측된 모든 영어 녹음 테이크가 15초 이내인 지문이 178개였으며, 관측된 모든 필리핀어 테이크가 15초를 넘은 지문은 72개였습니다. 낭독자 차이, 성별 구성, 번역, 쉼의 영향은 여전히 뒤섞여 있습니다. 이 연구는 대상 구성 9개의 비교와 시간 분석 결과를 보기 전에 고른 예시 1개를 모두 공개해 녹음 길이를 검토할 수 있게 했습니다. 팀이 편집을 확정하기 전에 실제로 시간을 재며 읽어 달라고 요청하는 데 참고할 수 있습니다.
편집자가 짧은 제품 영상을 준비해 두었습니다. 영어 내레이션은 길이에 맞고, 제품이 의도한 프레임에서 등장하며, 마지막 장면에는 제안 내용을 넣을 여유가 있습니다. 같은 메시지를 담은 번역 대본이 도착합니다. 녹음만 이미 완성된 타임라인에 마지막으로 얹으면 된다고 생각하기 쉽습니다.
이때 빠진 정보 하나가 제작 문제로 이어질 수 있습니다. 번역본을 읽는 데 걸리는 시간을 아무도 재지 않았다는 점입니다. 뜻이 맞다고 승인한 대본만으로는 실제 녹음이 얼마나 길어질지 편집자가 알 수 없습니다. 유용한 인계에는 승인된 문구와 녹음 길이가 모두 포함됩니다.
이 차이를 번역 낭독 지문으로 이루어진 연구 말뭉치 FLEURS에서 살펴봤습니다. 서로 대응하는 지문 200개에서 녹음 길이의 관계는 구성 간에도, 같은 지문을 읽은 녹음 간에도 달랐습니다. 아래 표는 그 차이를 그대로 보여 줍니다. 기업이나 창작자가 실제 제작물의 길이 정보를 요청할 이유를 제시하되, 연구 평균을 보장된 시간 여유로 바꾸지는 않습니다.
녹음 버전마다 길이를 따로 확인하세요
길이 기준을 가져다 쓰기 전에 같은 지문끼리 비교하세요
첫 번째 표는 같은 원문 지문 200개에 대해 각 대상 구성을 미국 영어와 비교한 결과입니다. 지문과 구성별로 이용 가능한 녹음 길이의 중앙값을 구했습니다. 그런 다음 대상 구성의 중앙값을 영어 중앙값으로 나누고, 1에서 얼마나 차이 나는지를 백분율로 나타냈습니다. 마지막으로 이렇게 짝지은 변화 200개를 요약했습니다. 따라서 녹음이 3개인 지문도 녹음이 1개인 지문과 같은 가중치를 받았습니다.[2][4]
라틴 아메리카 스페인어 녹음에서 짝지은 변화의 중앙값은 +24.8%였습니다. 지문별 변화의 가운데 절반은 +10.2%에서 +47.0% 사이였습니다. 일본어 녹음의 해당 중앙값은 +36.6%였고, 가운데 절반은 +17.8%에서 +61.8% 사이였습니다. 이는 서로 대응하는 지문의 공개된 녹음을 설명하는 값이며, 두 언어를 어떻게 낭독해야 하는지 정하는 기준은 아닙니다.
이는 녹음 길이 전체를 요약한 중앙값 2개를 나누는 것과 다릅니다. 같은 공통 지문에서 영어의 지문별 요약값 중앙값은 9.3초였고, 스페인어는 11.6초였습니다. 표시된 두 수를 나눠도 짝지은 비교의 +24.8%라는 결과는 재현되지 않습니다. 먼저 지문별로 짝을 맞췄기 때문에, 짧은 대상 지문은 분포의 중간쯤에 있는 다른 지문이 아니라 그 지문 자체의 영어 녹음과 비교됩니다.
네덜란드어 녹음의 짝지은 변화 중앙값은 −6.1%였고, 필리핀어 녹음은 +82.4%였습니다. 두 결과를 표에 함께 남겨 관측된 관계의 폭을 보여 줍니다. 이로써 모든 번역 녹음이 더 길었다고 읽힐 가능성도 피했습니다. 공통 지문 중 네덜란드어 중앙값이 영어보다 긴 지문은 71개, 같은 지문은 2개였으며, 나머지는 더 짧았습니다.
행은 결과순으로 정렬하지 않고 분석에서 사용한 고정 구성 순서를 따릅니다. 비교하려는 원문에 해당하는 행을 읽되, 그 결과가 나온 연구 조건도 함께 보세요. 라틴 아메리카 스페인어와 필리핀어는 이 데이터셋 원자료의 범위입니다. 이 글을 다른 언어로 게시한다고 그 녹음이 해당 시장에 관한 근거로 바뀌지는 않습니다.
미국 영어 대비 짝지은 녹음 길이 변화
모든 행은 같은 번역 원문 지문 200개를 비교합니다. 각 지문에서 대상 녹음 길이 중앙값을 영어 중앙값으로 나눈 뒤 1 대비 변화를 백분율로 표시했습니다. Q25와 Q75는 이렇게 짝지은 변화의 가운데 절반이 놓이는 경계입니다.
| 대상 녹음 구성 | 상대 변화 중앙값(%) | 상대 변화의 25백분위수(%) | 상대 변화의 75백분위수(%) |
|---|---|---|---|
| 라틴 아메리카 스페인어 | 24.8% | 10.2% | 47.0% |
| 프랑스어(프랑스) | 5.7% | -10.0% | 29.1% |
| 독일어(독일) | 31.4% | 0.0% | 62.4% |
| 네덜란드어(네덜란드) | -6.1% | -21.6% | 8.9% |
| 인도네시아어(인도네시아) | 26.3% | 11.4% | 49.9% |
| 말레이어(말레이시아) | 11.3% | -1.2% | 29.1% |
| 필리핀어(필리핀) | 82.4% | 54.2% | 120.1% |
| 태국어(태국) | 20.8% | 1.6% | 42.0% |
| 일본어(일본) | 36.6% | 17.8% | 61.8% |
길이가 고정된 작업에서는 분포도 중요합니다
중앙값은 200개의 관계를 1개의 수치로 압축합니다. 하지만 각 장면에는 그 장면에 쓸 낭독본이 들어가야 합니다. 중앙값 옆의 사분위수를 보면 중간값만 브리프에 옮겼을 때 그 결정에 필요한 정보가 빠지는 이유를 알 수 있습니다.
프랑스어 녹음의 짝지은 변화 중앙값은 +5.7%였지만, 가운데 절반은 −10.0%에서 +29.1%까지 이어졌습니다. 중앙의 차이는 작아도 영어 녹음보다 짧거나 긴 지문이 함께 있었습니다. 독일어 녹음의 변화 중앙값은 +31.4%였고, 가운데 절반은 약 0.0%에서 +62.4% 사이였습니다. 표시된 0.0%는 반올림한 값이며, 반올림 전 하위 사분위수는 0보다 조금 컸습니다.
이 구간은 관측된 짝지은 변화의 가운데 절반을 나타냅니다. 신뢰구간이나 최솟값부터 최댓값까지의 한계가 아니며, 향후 상업용 녹음이 들어올 범위도 아닙니다. 원자료의 지문, 번역, 낭독 방식은 새 제품 대본과 다릅니다. 표에 나온 중앙값 백분율을 그대로 적용하더라도 제작팀에는 편집에 필요한 실제 녹음 테이크가 여전히 없습니다.
이 구분은 실무에서 던질 질문을 바꿉니다. 제작자는 어떤 언어에 항상 시간이 얼마나 더 필요한지 묻는 대신, 승인된 번역본을 읽은 녹음이 의도한 장면 길이에 맞는지 물을 수 있습니다. 표는 그 확인이 유용한 이유를 설명하고, 실제 작업에 쓸 녹음은 그 질문의 답을 줍니다.
같은 지문도 녹음에 따라 길이가 달라질 수 있습니다
원자료 지문 1662는 녹음 길이를 요약하기 전에, 10개 구성 모두에 녹음이 있는 ID 중 가장 작은 값으로 선정했습니다. 해당 표에는 이 지문의 이용 가능한 낭독 녹음을 모두 포함했습니다. 길이를 본 뒤 눈에 띄는 예시를 찾아 고른 것이 아니며, 지문의 문구나 오디오는 이곳에 재현하지 않았습니다.[3][4]
영어 파일 2개는 길이가 약 8.4초와 11.2초였고, 중앙값은 9.8초였습니다. 독일어 파일 3개는 10.4초에서 23.5초 사이였으며 중앙값은 10.5초였습니다. 필리핀어 파일 2개는 22.3초에서 24.9초 사이였고 중앙값은 23.6초였습니다. 이는 원자료 메타데이터에 기록된 파일 전체의 길이이며, 표시를 위해 소수점 1자리로 반올림했습니다.
낭독 녹음 2개의 중앙값은 실제로 녹음된 파일의 길이가 아니라 두 값의 산술적 중간값일 수 있습니다. 영어의 9.8초라는 표시값이 그런 요약값입니다. 편집자가 테이크를 선택한다면 선택한 파일 자체의 길이를 사용해야 합니다. 테이크 수와 최솟값부터 최댓값까지의 범위를 중앙값 옆에 두면 이 차이를 확인할 수 있습니다.
독일어 녹음의 분포를 봐도 길이의 차이를 전부 번역 분량 탓으로 돌려서는 안 됩니다. 낭독자 ID가 없고, 녹음을 듣거나 말소리와 쉼을 분리하지도 않았습니다. 이 자료에서는 낭독 방식, 낭독자, 녹음 조건의 영향을 나눠 볼 수 없습니다. 이 예시가 뒷받침하는 제작 요청은 간단합니다. 언어 차원의 추정치만 보내기보다 실제 사용할 테이크나 사용할 문구를 시간을 재며 읽은 녹음을 보내 달라는 것입니다.
지문 1662: 중앙값 옆에 테이크 길이 범위도 남겨 두세요
10개 구성 모두에 녹음이 있는 원문 ID 중 가장 작은 값으로, 시간 요약값을 계산하기 전에 가용성을 기준으로 선정했습니다. 이용 가능한 테이크를 모두 포함했습니다. 초 단위 값은 원자료 메타데이터에 기록된 파일 전체 길이이며 쉼을 분리하지 않았습니다.
| 녹음 구성 | 이용 가능한 테이크 수 | 최단 파일 길이(초) | 파일 길이 중앙값(초) | 최장 파일 길이(초) |
|---|---|---|---|---|
| 미국 영어 | 2 | 8.4 | 9.8 | 11.2 |
| 라틴 아메리카 스페인어 | 3 | 8.8 | 9.5 | 9.5 |
| 프랑스어(프랑스) | 2 | 6.4 | 6.8 | 7.1 |
| 독일어(독일) | 3 | 10.4 | 10.5 | 23.5 |
| 네덜란드어(네덜란드) | 1 | 7.9 | 7.9 | 7.9 |
| 인도네시아어(인도네시아) | 1 | 11.6 | 11.6 | 11.6 |
| 말레이어(말레이시아) | 2 | 8.0 | 8.6 | 9.1 |
| 필리핀어(필리핀) | 2 | 22.3 | 23.6 | 24.9 |
| 태국어(태국) | 3 | 6.5 | 8.7 | 10.1 |
| 일본어(일본) | 2 | 12.1 | 13.3 | 14.6 |
15초 예시를 읽을 때는 분모도 함께 봐야 합니다
결과를 계산하기 전에 계획용 예시의 길이를 15초로 정했습니다. 플랫폼 요건이나 권장 광고 길이, 안전하게 확보할 제작 여유가 아닙니다. 영어 녹음 요약값은 그 시간 안에 들어가는데 대응하는 대상 녹음 요약값은 초과하는 경우가 있는지 살펴봤습니다.
공통 지문 200개 중 영어 중앙값이 15초 이하인 지문은 186개였습니다. 이 기준에 맞는 집합에서 대상 중앙값이 15초를 넘은 지문은 라틴 아메리카 스페인어 20개, 독일어 39개, 네덜란드어 9개, 필리핀어 110개, 일본어 37개였습니다. 각 수치의 분모는 모두 186개이며, 나머지 비교 결과는 다운로드 자료에 남겨 두었습니다.[6]
관측된 테이크에 더 엄격한 기준도 적용했습니다. 이용 가능한 모든 영어 낭독은 15초 이내여야 하고, 이용 가능한 모든 대상 낭독은 15초를 넘어야 했습니다. 관측된 모든 영어 테이크가 15초 이내인 지문은 178개였습니다. 해당 조건을 충족한 지문은 스페인어 11개, 독일어 9개, 네덜란드어 4개, 필리핀어 72개, 일본어 14개였습니다. 이 수치는 공개된 테이크에만 해당하며, 그 지문을 읽을 수 있는 모든 방식에 관한 결과는 아닙니다.
더 엄격한 확인은 실제로 녹음되지 않은 산술적 중간값에 의존하지 않게 해 줍니다. 그렇더라도 지문을 더 빨리 읽거나 다르게 편집하거나 적절히 고쳐 쓸 수 없다는 뜻은 아닙니다. 팀이 구분해야 할 것은 제공된 특정 녹음이 길이에 맞는다는 근거와, 영어가 맞았으니 다른 버전도 맞을 것이라는 가정입니다.
가상의 출시 사례로 인계 시점을 살펴봅니다
가상의 작은 주방용품 브랜드가 창작자에게 15초짜리 제품 영상을 의뢰했다고 가정해 보겠습니다. 구성에는 시연, 제안 내용, 마지막 제품 장면이 포함됩니다. 영어 낭독은 11초가 걸립니다. 번역 초안은 의미상 승인을 받았지만, 녹음할 내레이터가 처음 읽어 보니 17초가 걸립니다. 이 사례의 브랜드, 대본, 시간, 의뢰는 모두 가상이며 FLEURS 관측값이 아닙니다.
창작자가 이미 모든 장면을 영어 낭독에 맞춰 확정했다면 17초짜리 파일을 받고 편집 막바지에 결정을 내려야 합니다. 고객 담당자는 번역 문구를 검토하는 동안 시간을 재며 읽어 달라고 요청해, 그 선택을 명시적으로 논의할 수 있습니다. 브리프에는 정확히 유지해야 할 메시지, 장면에 쓸 수 있는 시간, 두 항목의 변경을 승인할 사람을 밝혀야 합니다.
해결책이 반드시 내레이터를 더 빨리 읽게 하는 것일 필요는 없습니다. 번역자는 제안 내용을 유지하면서 더 짧고 자연스러운 표현을 제시할 수 있습니다. 편집자는 합의한 형식이 허용하는 경우 시연에 시간을 더 주거나, 부수적인 내용을 함께 게시할 문구로 옮기거나, 별도 편집본을 준비할 수 있습니다. 이는 제작 과정에서 논의할 선택지이며, 이번 말뭉치 분석으로 개선 효과가 입증된 방법은 아닙니다.
이 가상 작업의 인계 내용은 다음처럼 작성할 수 있습니다. “대상 버전: __. 승인된 대본: __. 사용할 테이크: 제공된 파일에서 측정한 __초. 장면에 배정한 시간: __초. 제안 문구와 필수 고지 내용: __. 대본 변경 승인자: __. 편집 승인자: __.” 빈칸은 실제 팀이 채워야 하며 연구 표로 대신 채울 수 없습니다.
대상 버전이 여러 개라면 고객 담당자는 프로젝트 전체를 “번역 승인됨”으로 표시하는 대신 사용할 테이크마다 행을 나눠 관리할 수 있습니다. 문구 승인과 길이 승인은 서로 다른 질문에 답합니다. 임시 낭독 후 번역자가 제품에 관한 주장을 바꾸었다면 창작자가 앞서 잰 시간을 재사용하기 전에 그 변경을 행에 표시해야 합니다. 이는 가상 의뢰를 정리하는 방법의 제안이며, 프로젝트 위험을 줄이는 효과를 검증한 것은 아닙니다.
수정한 테이크가 도착하면 창작자는 언어와 의미를 책임지는 사람과 완성된 버전 전체를 검토할 수 있습니다. 길이에 맞는지만 보면 부자연스러운 낭독이나 읽기 어려운 마지막 프레임을 놓칠 수 있습니다. 이번 연구에서는 품질이나 시청자 반응을 측정하지 않았습니다. 이 가상 의뢰에 참고할 수 있는 점은 녹음 길이를 더 일찍 안다는 것이며, 창의적인 선택의 책임은 여전히 영상을 만드는 사람들에게 있습니다.
검토할 때 문구·녹음 테이크·영상을 함께 보세요
다국어 내레이션의 길이를 확인할 때는 작업물과 함께 넘길 수 있을 만큼 짧은 문서가 유용합니다. 승인된 대본 버전, 사용할 녹음, 장면에 배정한 시간을 적습니다. 이 중 하나가 바뀌면 다음 인계를 받는 사람이 어떤 길이 정보가 여전히 적용되는지 알 수 있습니다.
시간을 잰 임시 낭독은 팀에 선택지가 남아 있을 때 충돌을 드러낼 수 있습니다. 최종 내레이터도 같은 길이로 읽을 것이라는 근거로 삼지 말고, 계속 임시 낭독이라고 표시해야 합니다. 사용할 테이크가 도착하면 가정 대신 그 녹음에서 측정한 길이를 적용하고 실제 편집본에서 검토하세요.
이 검토에서는 번역한 버전 전체를 유지하세요. 의미를 확인하는 사람은 영상과 함께 낭독을 들어야 하고, 편집자는 쉼, 제품 등장, 마지막 프레임이 서로 어울리는지 봐야 합니다. 파일 길이가 맞는다는 것은 근거의 일부일 뿐, 그 버전의 모든 요소를 승인했다는 뜻은 아닙니다.
아래 4단계는 제안하는 인계 방법이며 FLEURS에서 시험한 작업 절차가 아닙니다. 문구와 녹음 길이를 구분한 이번 연구의 관점을 제작 결정에 적용한 것입니다. 도달, 시청 유지, 전환, 프로젝트에 필요한 수정 횟수에 관한 성과를 보장하지 않습니다.
4단계 인계 과정에서 녹음 길이를 함께 전달하세요
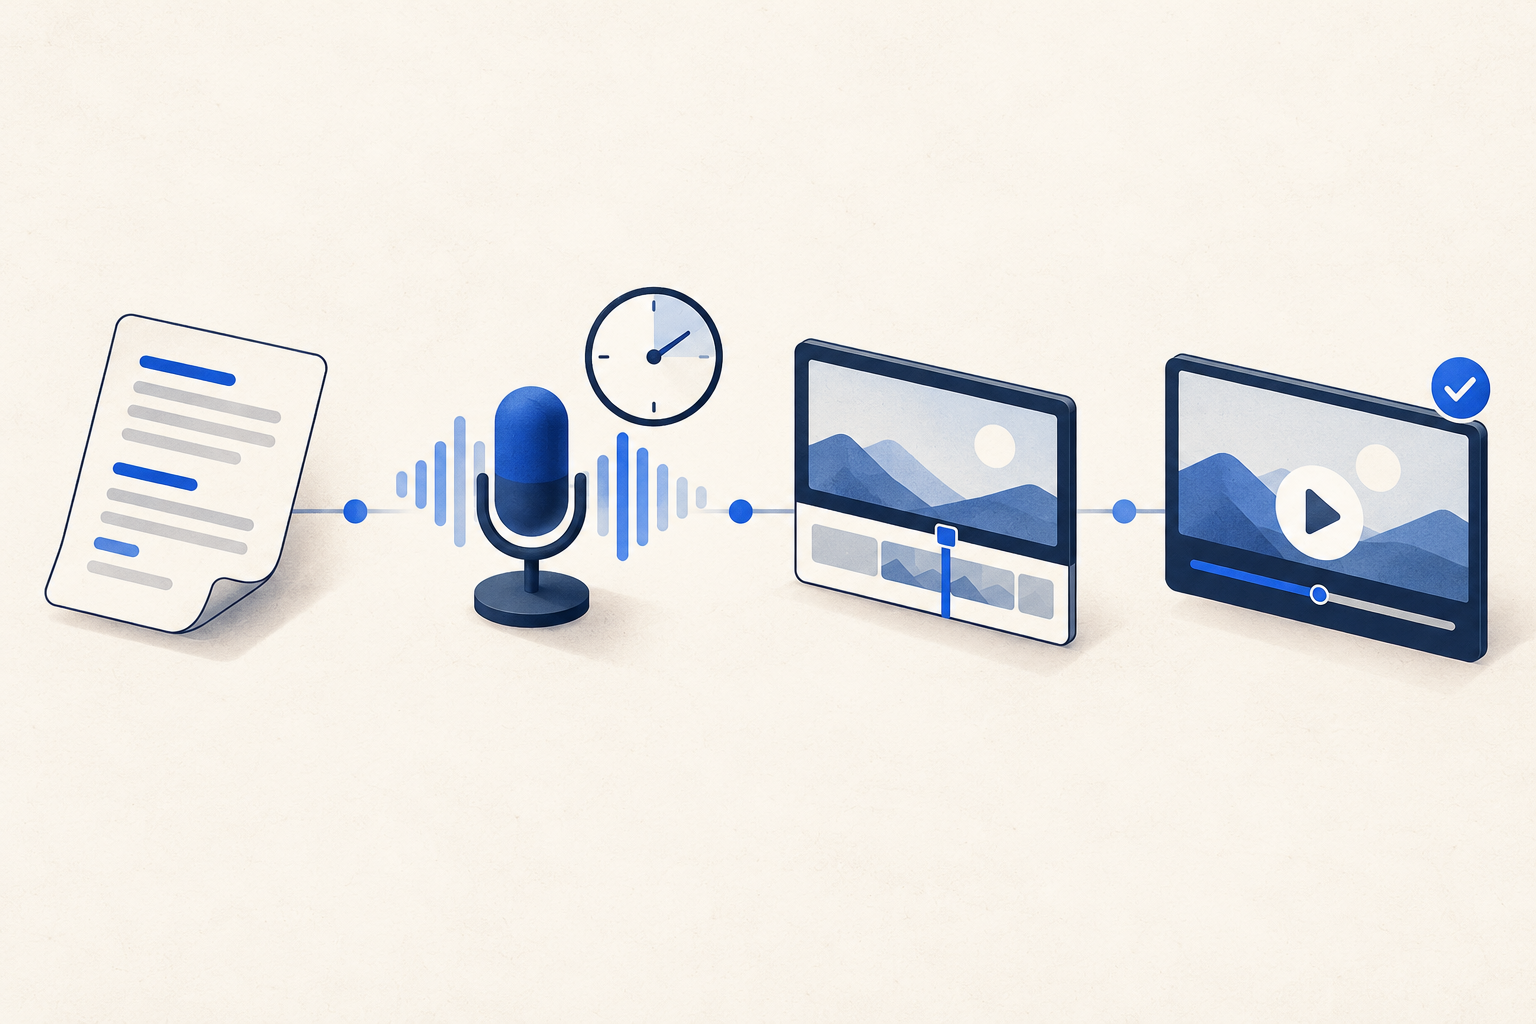
문구 합의
대상 버전, 승인된 대본, 의미를 검토할 사람을 명시하세요.
사용할 낭독의 길이 측정
테이크에서 측정한 길이를 함께 전달하고, 임시 낭독은 잠정 자료라고 표시하세요.
길이 조정 협의
편집을 확정하기 전에 대본이나 장면의 변경 사항에 합의하세요.
버전 전체 검토
선택한 테이크를 영상, 제안 내용, 마지막 프레임과 함께 확인하세요.
수치를 재사용할 때는 짝지은 지문 집합도 함께 밝히세요
공통 비교에는 영어 테스트 지문 350개 중 200개가 포함되었습니다. 나머지 150개는 선택한 구성 중 적어도 1개에서 녹음이 없었습니다. 모든 구성에서 자료를 확보할 수 있는 지문 자체에 선택 편향이 있을 수 있으므로, 이 공통 집합을 대본·언어·내레이션 작업의 무작위 표본으로 설명해서는 안 됩니다.
이용 가능한 모든 대응 쌍을 사용해 영어와 각 대상 구성의 비교를 반복했습니다. 그 분모는 네덜란드어 251개에서 필리핀어·태국어 349개까지였습니다. 공통 집합에서도 영어 녹음이 2개 이상이고 대상 녹음도 2개 이상인 지문만으로 비교를 반복했으며, 이 부분집합은 66개에서 166개 지문으로 이루어졌습니다. 짝지은 비교 9개의 결과와 각각의 분모는 모두 다운로드 자료에 있습니다.[4]
반복 낭독 부분집합에서는 모든 구성의 짝지은 변화 중앙값이 주 비교와 같은 방향을 유지했습니다. 이 특정 요약 방식을 확인하는 데 유용한 결과입니다. 하지만 낭독자를 통제하거나 서로 다른 대응 표본을 비교 가능한 모집단으로 만들어 주지는 않습니다. 반복 테이크는 서로 독립된 참여자가 아닙니다.
확보한 독일어, 네덜란드어, 인도네시아어, 말레이어, 필리핀어 녹음은 모두 남성으로 표시되어 있었고, 태국어 녹음은 모두 여성으로 표시되어 있었습니다. 영어, 스페인어, 프랑스어, 일본어에는 남성·여성 표시가 섞여 있었습니다. 낭독자 식별 정보가 없어 구성의 영향과 낭독자 구성, 낭독 방식, 번역, 자료 보존 여부의 영향을 분리할 수 없습니다. 표는 이 녹음 자료에 대한 설명으로 읽고, 수치를 재사용할 때도 이 한계를 함께 밝혀야 합니다.[7]
녹음 길이는 이렇게 비교했습니다
FLEURS는 번역한 낭독 지문을 사용해 2022년에 소개된 연구 말뭉치입니다. 제작자와 TensorFlow Datasets 문서에는 언어 간 공통 원문 ID와, 16,000 Hz 기준의 총 오디오 프레임 수를 담은 메타데이터 필드가 명시되어 있습니다. 이 필드 값을 16,000으로 나누어 메타데이터상 파일 전체 길이를 초 단위로 구했습니다. 오디오를 디코딩하거나 파형 길이를 검증하거나 무음을 제거하지 않았습니다.[1][2]
2026년 10월 24일(UTC)에 주석에 명시한 제작자의 고정 리비전에서 테스트 메타데이터 파일 10개를 확보했습니다. 이 파일에는 이용 가능한 지문 전반에 걸친 녹음 7,528개가 들어 있습니다. 대응 관계는 행 순서가 아니라 원문 ID로 정했습니다. 지문 200개의 공통 집합, 15초 기준, 반복 낭독 점검, 예시 1662는 자료 가용성을 확인한 뒤 녹음 길이 요약값을 계산하기 전에 정했습니다.[3][4]
확보일은 어떤 원자료 스냅샷을 사용했는지 알려 줍니다. 2022년 연구 말뭉치와 함께 소개된 녹음이 2026년 내레이터나 창작자 설문조사로 바뀌는 것은 아닙니다. 공개 데이터에 원자료 리비전을 남겨, 이후 독자가 기존 자료를 새로 분석한 것과 새 낭독을 수집한 것을 구분할 수 있게 했습니다.
앞서 개발 분할로 실행 가능성을 확인했을 때는 공통 지문이 91개뿐이어서 기준인 100개에 못 미쳤고, 해당 시도는 보류했습니다. 테스트 자료 확보도 처음에는 태국어 메타데이터의 크기 제한 때문에 멈췄지만, 기록에 남긴 더 큰 한도를 적용해 같은 고정 테스트 범위를 완성했습니다. 이는 실행 가능성과 접근 과정에서 바뀐 내용을 공개한 것이며, 결과를 모른 채 사전등록한 연구라는 근거는 아닙니다.
짝지은 계산에는 모두 정확한 프레임 수와 분수를 사용했습니다. 사분위수는 (n−1) × p로 정한 위치에서 선형 보간해 구했습니다. 표의 백분율과 초 단위 값은 사사오입 방식으로 소수점 1자리까지 표시하고, 테이크 수는 정수로 유지했습니다. 공개된 파생 데이터에는 정확한 지문별 요약값, 대응 쌍별 결과, 민감도 점검, 두 가지 시간 기준 정의가 남아 있습니다. 모집단 신뢰구간이나 인과 효과는 계산하지 않았습니다.[4]
더빙의 시간 제약은 이미 확립된 연구 주제입니다.[5] 이 글에서는 고정된 지문의 공개 파일 길이를 재현 가능한 방식으로 비교하고, 포함 범위와 반복 테이크를 살펴보는 데 필요한 정보를 추가했습니다. 편집을 확정하기 전에 번역 제작물의 실제 길이 정보를 요청하는 데 근거를 제공하지만, 어디에나 적용할 시간 증가율을 제시하지는 않습니다.
- 표에 표시한 결과 67개 다운로드(CSV)
- 지문 350개 × 구성 10개의 전체 조합과 테이크 요약 다운로드(CSV)
- 짝지은 비교 9개 전체·민감도 점검·시간 기준별 집계 다운로드(CSV)
- 출처·연구 방법·재현 코드 다운로드(ZIP)
가입하지 않아도 됩니다. 파생 데이터에는 누락된 조합과 실제 비교 분모가 그대로 남아 있습니다. 공통 패키지에는 영어로 된 연구 방법 문서, 출처 참고 자료, 재현 코드가 들어 있으며, 원본 지문 텍스트나 오디오는 재배포하지 않습니다. 모든 언어판은 같은 고정 말뭉치를 설명합니다.[8]
연구 주석
- Conneau 외, FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech(2022), 2.1–2.3절. 번역한 지문을 읽은 말뭉치이며, 문장마다 검증된 녹음이 최대 3개 있고 샘플링 주파수는 16 kHz입니다. 자료의 수집 방식과 연구 목적만으로 상업용 내레이션 제작을 대표한다고 볼 수는 없습니다. 원문 지문은 FLORES에서 왔으며 광고 대본 표본이 아닙니다.
- TensorFlow Datasets의 xtreme_s 버전 2 특성 문서와 해당 파서. 원문 ID는 언어 간에 같고 낭독 녹음에 따라 반복될 수 있으며, num_samples는 총 오디오 프레임 수를 기록합니다. 오디오 특성에는 16,000 Hz가 명시되어 있습니다. 파서는 디코딩한 파형과 대조하지 않고 메타데이터의 수를 복사합니다. 여기서 초 단위 값은 메타데이터상 파일 전체의 길이이며, 쉼을 분리하거나 낭독자 신원을 통제하지 않았습니다.
- Google FLEURS 메타데이터, 고정 리비전 ab93cf03f9d0cd083c853fad065a6377067408aa의 테스트 분할이며, 2026년 10월 24일(UTC)에 확보했습니다. 구성: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th, ja_jp. 링크된 영어 TSV는 원자료 파일 10개 중 1개이며, 패키지에 각 파일의 정확한 원본 URL과 SHA256을 기록했습니다. 원자료의 스페인어는 라틴 아메리카 스페인어이고 fil_ph는 필리핀어입니다.
- Influence IQ의 계산: 구성별 지문 내 중앙값, 지문별 동일 가중치, 짝지은 대상 대 영어 중앙값의 비율과 초 단위 차이입니다. 주 비교는 영어 지문 350개 중 10개 구성에 모두 있는 지문 200개를 사용했습니다. 보조 비교는 이용 가능한 모든 영어–대상 쌍과, 양쪽 모두 테이크가 2개 이상인 공통 지문을 사용했습니다. 연구 방법과 예시 선정은 가용성을 확인한 뒤 시간 요약값을 계산하기 전에 정했습니다. 정확한 분수, 보간, 반올림, 모든 분모는 재현 패키지에 문서화했습니다.
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing(2023). 사람이 수행하는 전문 더빙의 시간 조정은 이미 선행 연구에서 다루고 있습니다. 이 글의 기여는 한정된 FLEURS 파일 길이의 대응 비교표와 제작 인계에 재사용할 수 있는 해석이며, 더빙의 시간 제약을 처음 발견했거나 전문 더빙의 벤치마크를 마련했다는 데 있지 않습니다.
- 15초 기준은 결과를 보기 전에 계획용 예시로 정했습니다. 중앙값 기준에서는 영어 중앙값이 15초 이하인 공통 지문 186개를 대상으로, 대상 중앙값이 15초를 넘는 경우를 집계했습니다. 관측된 모든 테이크 기준에서는 영어 테이크가 모두 15초 이하인 지문 178개를 대상으로, 관측된 대상 테이크가 모두 15초를 넘는 지문을 셌습니다. 경계값과 같으면 시간 안에 들어간 것으로 봅니다. 이 수치는 공개된 녹음에 관한 기술통계 결과이며, 플랫폼 지침이나 가능한 모든 낭독에 대한 주장이 아닙니다.
- 확보한 메타데이터에는 낭독자 ID가 없습니다. 독일어, 네덜란드어, 인도네시아어, 말레이어, 필리핀어 녹음은 모두 남성으로 표시되어 있고, 태국어 녹음은 모두 여성으로 표시되어 있습니다. 구성별 자료가 빠져 영어 지문 350개 중 150개가 공통 비교에서 제외되었습니다. 대응 쌍별 점검과 반복 낭독 점검은 서로 다른 유한 부분집합을 설명하며, 낭독자, 성별, 낭독 방식, 번역, 자료 보존 여부의 교란을 없애지 못합니다. 신뢰구간, 언어 속도 순위, 인과 효과, 상업적 예측은 제시하지 않았습니다.
- 출처는 CC BY 4.0으로 제공되는 Google FLEURS입니다. 자료 선정, 계산, 표, 편집적 해석, 번역은 Influence IQ가 가공한 것이며 데이터셋 저자의 지지를 뜻하지 않습니다. 공개 패키지는 원본 오디오나 지문 텍스트 대신 파생된 수치 요약과 코드를 재배포합니다. 표시를 위한 반올림은 정확한 원자료 수나 공통 녹음 집합을 바꾸지 않습니다.
모든 언어판은 영어 원문을 바탕으로 합니다. 각 언어판은 같은 고정 FLEURS 테스트 녹음과 번역 지문을 보고하며, 글의 언어가 달라져도 새로운 시장에 대한 근거가 생기지는 않습니다. 분석, 해석, 번역의 책임은 Influence IQ에 있습니다.