Quali commenti sulle ricette leggere per raccogliere feedback?
Leggere i commenti con più voti positivi o quelli più recenti può cambiare la distribuzione delle valutazioni che vedi. Un confronto di selezioni da 10 commenti su 100 discussioni scelte mostra perché il metodo di lettura deve seguire la domanda a cui vuoi rispondere.
Un’analisi di 18.182 commenti in un archivio di ricette pubblicato da UCI nel 2023.
Sintesi
Quando l’obiettivo era riflettere la distribuzione delle valutazioni in una discussione su una ricetta, la selezione casuale era in media più vicina rispetto ai commenti con più voti positivi o ai più recenti. Influence IQ ha confrontato selezioni da 10 commenti su un insieme scelto di 100 ricette molto apprezzate, in un archivio storico di 18.182 commenti pubblicato da UCI nel 2023. Gli scarti medi attesi nella distribuzione delle valutazioni erano di 16,5 punti percentuali per la selezione casuale, 18,7 per i voti positivi e 20,3 per i commenti più recenti. [1][4]
Il risultato misura la composizione dei commenti con valutazioni da 1 a 5 stelle e di quelli senza valutazione, non l’utilità dei consigli. La selezione per voti positivi era più vicina di quella casuale per 46 ricette e più lontana per 54. Per i creator di contenuti culinari e chi gestisce una community, il punto è distinguere il campione usato per riassumere una discussione dagli esempi scelti per preparare una risposta.
Hai una ricetta da migliorare e una lunga discussione sotto il contenuto. Puoi leggere un piccolo gruppo di commenti prima di decidere che cosa chiarire. Da dove inizi: dai commenti che hanno ricevuto più voti positivi, dai più recenti o da una selezione casuale della discussione?
La scelta precede l’interpretazione di qualsiasi frase. Decide quali voci entreranno nel brief da affidare a un creator, a chi si occupa della revisione o a un collega. Abbiamo esaminato come 3 regole esplicite di selezione cambiassero una caratteristica misurabile del brief: l’equilibrio delle valutazioni, compresi i commenti i cui autori non avevano lasciato alcun punteggio.
Una vista selezionata di una discussione più ampia
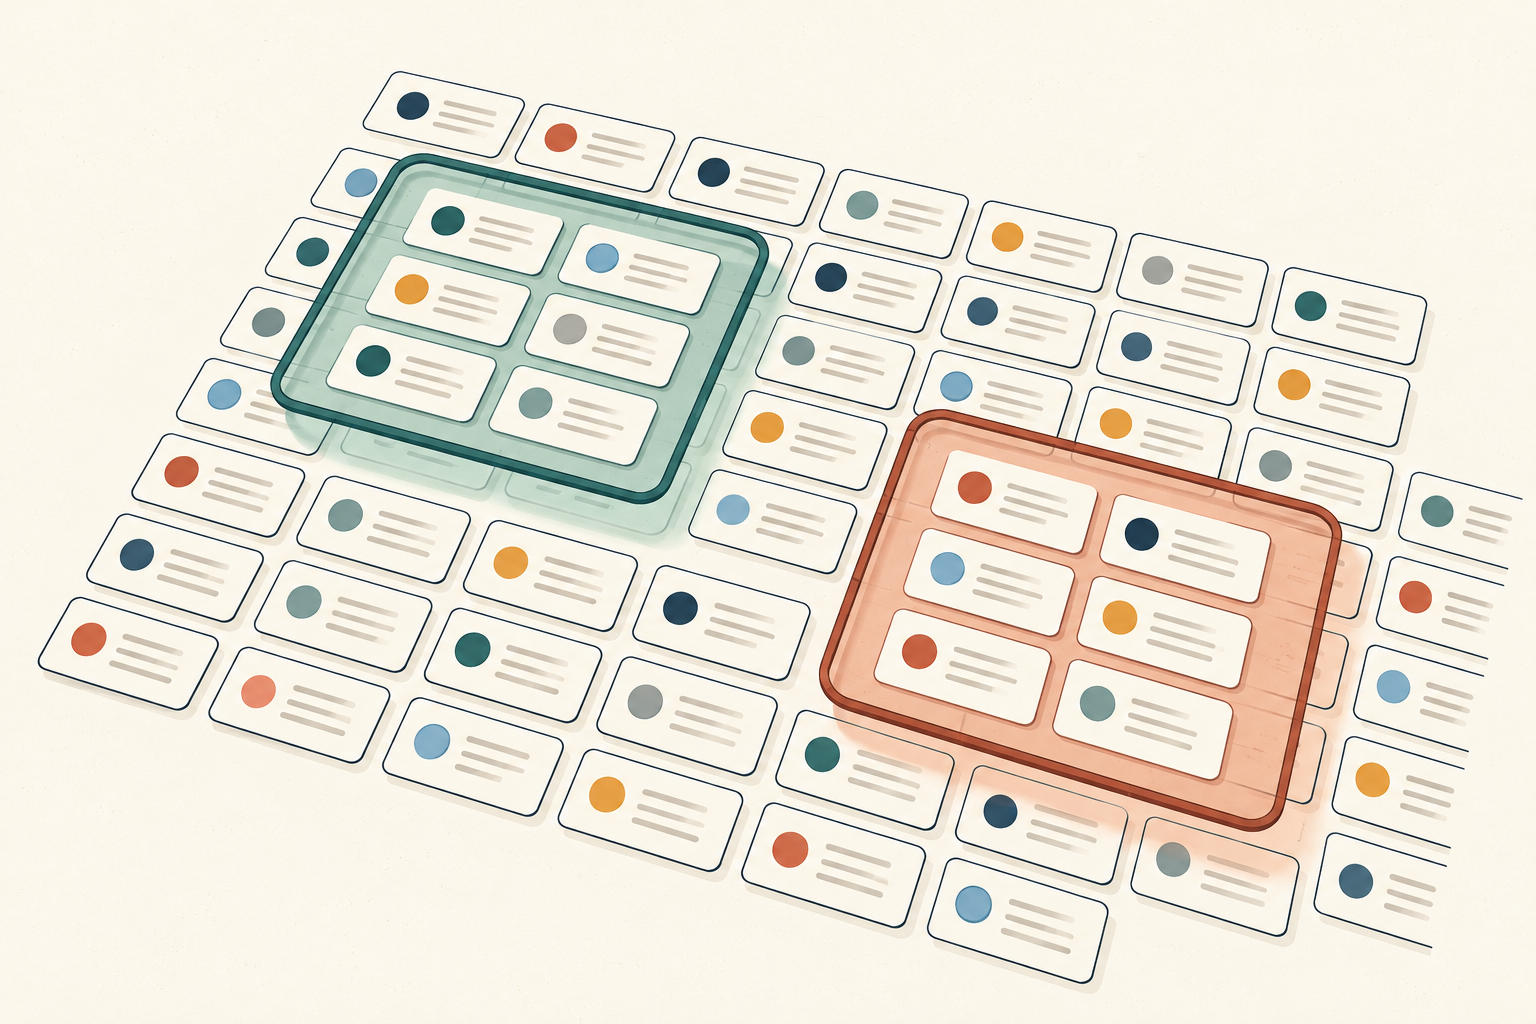
- Commenti selezionati
- Intera discussione archiviata
10 commenti possono dare 3 prospettive diverse
Un creator che prepara un approfondimento su una ricetta deve decidere che cosa leggere prima. I commenti con più voti positivi possono sembrare una scorciatoia utile. Quelli più recenti offrono un’altra via per entrare nella discussione. Entrambi i criteri mettono alcuni commenti davanti ad altri, ma nessuna delle 2 selezioni descrive automaticamente l’intera discussione.
Abbiamo verificato questa domanda circoscritta con 18.182 commenti archiviati su 100 ricette Taste of Home selezionate e molto apprezzate, in un dataset pubblico diffuso da UCI nel 2023. Per ogni ricetta abbiamo confrontato 10 commenti scelti per voti positivi, 10 per data di creazione e 10 a caso. Il riferimento era la distribuzione delle valutazioni di tutti i commenti archiviati per quella ricetta. [1]
Lo scarto medio atteso rispetto alla distribuzione completa era di 18,7 punti percentuali per la selezione per voti positivi, 20,3 per i più recenti e 16,5 per quella casuale. Ogni ricetta contribuiva allo stesso modo alle medie, indipendentemente dal numero di commenti. [4]
Rispetto alla selezione casuale, lo scarto era maggiore di 2,2 punti percentuali usando i voti positivi e di 3,8 punti usando i più recenti. Le differenze riguardano la composizione delle valutazioni e dei commenti senza punteggio. Non abbiamo misurato quali commenti offrissero i consigli di cucina migliori, la spiegazione più chiara o l’idea più utile per un’attività.
Per un creator di cucina o chi gestisce una community, la distinzione conta. Un commento può essere abbastanza utile da ispirare un tutorial senza essere tipico della discussione. Usarlo come esempio è una scelta diversa dall’usare un elenco ristretto come riepilogo.
Scarto medio dalla distribuzione completa delle valutazioni di ogni ricetta
10 commenti per selezione, in 100 discussioni scelte dall’archivio storico UCI. Uno scarto minore indica una composizione più vicina tra valutazioni e assenza di valutazione.
| Metodo di selezione | Scarto medio atteso |
|---|---|
| Commenti con più voti positivi | 18,7 punti percentuali |
| Più recenti per data di creazione | 20,3 punti percentuali |
| Selezione casuale | 16,5 punti percentuali |
Che cosa indica lo scarto nella distribuzione delle valutazioni?
Considera ogni discussione su una ricetta come una combinazione di 6 categorie: da 1 a 5 stelle, più i commenti senza valutazione. Anche un campione di 10 commenti ha la propria composizione. Abbiamo misurato quanto si discostasse dall’intera discussione archiviata usando una misura chiamata distanza in variazione totale.
Ecco un esempio ipotetico con sole 2 categorie. Supponi che metà dei commenti dia 4 stelle e metà 5 stelle. Se una selezione di 10 commenti contiene 7 valutazioni da 4 stelle e 3 da 5 stelle, la sua composizione è 70% contro 30%, anziché 50% contro 50%. La distanza è di 20 punti percentuali: metà della somma delle 2 differenze assolute, entrambe di 20 punti.
Lo stesso calcolo vale per tutte le 6 categorie. Un valore più piccolo indica una corrispondenza più stretta con la composizione delle valutazioni nell’archivio. Non significa che il testo sia più informativo o che i commenti siano più veritieri. Un risultato di 18,7 punti non significa nemmeno che il 18,7% dei commenti sia sbagliato.
Abbiamo mantenuto nel confronto i commenti senza valutazione. UCI definisce lo 0 nel campo del punteggio come assenza di valutazione, non come un voto inferiore a 1 stella. Eliminarli cambierebbe la discussione da riassumere. La sola categoria numerica non permette di sapere se un commento senza punteggio contenga una domanda, un apprezzamento, un problema o altro. [1]
La selezione casuale era più vicina in media, non per ogni ricetta
Il confronto complessivo non individua un vincitore universale. La selezione per voti positivi aveva uno scarto atteso minore di quella casuale per 46 delle 100 ricette e maggiore per 54. La selezione dei più recenti era più vicina per 42 ricette e più lontana per 58. Nessuno dei 2 confronti aveva una parità esatta. [4]
Si confronta lo scarto atteso di ciascun metodo all’interno di una ricetta. Non significa che ogni possibile estrazione casuale superi la selezione per voti positivi in quelle 54 discussioni. Un’estrazione specifica di 10 commenti può assomigliare molto alla discussione completa oppure non coglierne alcune parti.
Il risultato casuale è una media su tutti i possibili campioni di 10 commenti, ciascuno con la stessa probabilità. Non deriva da un’estrazione fortunata né dalla scelta di un valore iniziale del generatore casuale. Abbiamo fatto la media anche sulle possibili selezioni per risolvere le parità quando più commenti avevano lo stesso numero di voti o la stessa data e ora di creazione alla soglia.
Le parità alla soglia hanno richiesto una media per 70 ricette con selezione per voti positivi e per 4 con selezione dei più recenti. Non abbiamo preferito un commento a pari merito per autore, posizione della riga o identificativo. Il calcolo esamina che cosa accade con una regola dichiarata, senza trattare un ordinamento arbitrario come prova. [4]
Per un creator, la conseguenza pratica è circoscritta ma utile: voti positivi e recenza sono criteri di selezione. Se li usi per riassumere una discussione, indica la scelta. Non presumere che un elenco visibile conservi l’equilibrio dell’intero archivio.
Il metodo più vicino cambiava tra le discussioni sulle ricette
Ogni selezione ordinata è confrontata con quella casuale per la stessa ricetta. Si confrontano scarti attesi, non esiti di singole estrazioni casuali.
| Metodo di selezione | Scarto minore rispetto alla selezione casuale | Scarto uguale a quello della selezione casuale | Scarto maggiore rispetto alla selezione casuale |
|---|---|---|---|
| Selezione per voti positivi rispetto a quella casuale | 46 | 0 | 54 |
| Selezione dei più recenti rispetto a quella casuale | 42 | 0 | 58 |
Scegli la domanda prima dei commenti
I metodi per leggere i feedback servono a compiti diversi. Un’impresa può voler capire un andamento generale, indagare un problema specifico o trovare una domanda per il prossimo post. Questo studio riguarda una parte del lavoro: se una piccola selezione conserva la composizione delle valutazioni di una discussione. Non mette in classifica tutti i modi di raccogliere feedback.
Se la domanda è «Qual è il quadro generale di questa discussione?», definisci prima quali commenti ne fanno parte. Una selezione casuale da un elenco completo e accessibile evita di privilegiare deliberatamente voti positivi o date di creazione recenti. In questo archivio era più vicina in media, ma anche un piccolo campione casuale presentava uno scarto misurabile. 10 era il limite scelto per il confronto, non una raccomandazione che 10 commenti bastino.
Se la domanda è «A che cosa devo rispondere adesso?», un commento specifico può meritare attenzione da solo. Una domanda chiara sulla sostituzione di un ingrediente può giustificare la verifica della ricetta e una spiegazione. Non devi definirla una domanda comune prima di rispondere. La rilevanza per il prossimo contenuto è una valutazione separata.
Se la domanda riguarda cambiamenti recenti, la data di creazione può definire un periodo di lettura pertinente. Indica quel periodo nel riepilogo. Nel nostro studio, «più recenti» significava le date e ore di creazione più tarde nell’archivio salvato, non i commenti arrivati oggi o l’ordine attualmente mostrato dal sito.
Anche l’archivio completo dei commenti è un riferimento limitato. Contiene i contributi di chi ha scelto di commentare, non di tutte le persone che hanno letto o provato una ricetta. Per raccogliere feedback da chi non commenta, un’impresa deve trovare un modo separato di raggiungerlo. Una maggiore somiglianza con l’archivio non colma questa lacuna. Mantieni distinti i feedback aggiuntivi, così restano chiari la fonte e il criterio di selezione.
Tieni 2 note separate: una descrive la selezione usata per riassumere la discussione; l’altra elenca le domande da approfondire. È un approccio di pianificazione suggerito, non un processo verificato in questo studio.
Un esempio immaginario: preparare un approfondimento sulla ricetta
Immagina un creator di cucina che prepara un approfondimento su una ricetta da forno. Un commento con molti voti positivi chiede se si possa usare una teglia diversa. Il creator è tentato di aprire il prossimo video con «Tutti hanno difficoltà con le dimensioni della teglia». È uno scenario immaginario, non un commento o una ricetta scelti dal dataset.
La domanda sulla teglia può meritare una risposta senza dimostrare quanto sia diffusa. I voti positivi non stabiliscono chi abbia provato la ricetta o vissuto la stessa esperienza.
Un brief più preciso direbbe: «Una persona ha chiesto come la scelta della teglia influisca su questa ricetta. Mostra quella usata, spiega le dimensioni e indica che cosa verificare prima di consigliarne un’altra». Il creator può quindi controllare i dettagli di cucina. Il commento offre la domanda iniziale, non ne stabilisce la risposta.
Se il creator vuole anche riassumere la discussione, deve tenere una nota separata su che cosa ha letto e come l’ha scelto. Un campione casuale da un elenco completo disponibile deve dare a ogni commento la stessa probabilità, senza selezionare 2 volte lo stesso commento. Scorrere fino ad alcuni punti comodi non è la procedura casuale valutata qui.
Quando l’elenco completo non è disponibile, descrivi la selezione che puoi fare davvero. «Abbiamo letto i primi commenti mostrati con questo ordinamento» informa più di un’etichetta come «campione rappresentativo». Non attribuire gli scarti numerici del nostro archivio a quel processo diverso.
L’approfondimento deve mostrare l’attrezzatura e rispondere alla domanda verificata. Registra ciò che hai chiarito, così la revisione successiva potrà concentrarsi sui punti ancora aperti. Valuta la spiegazione usando i feedback sull’approfondimento stesso.
Tieni separate selezione e interpretazione
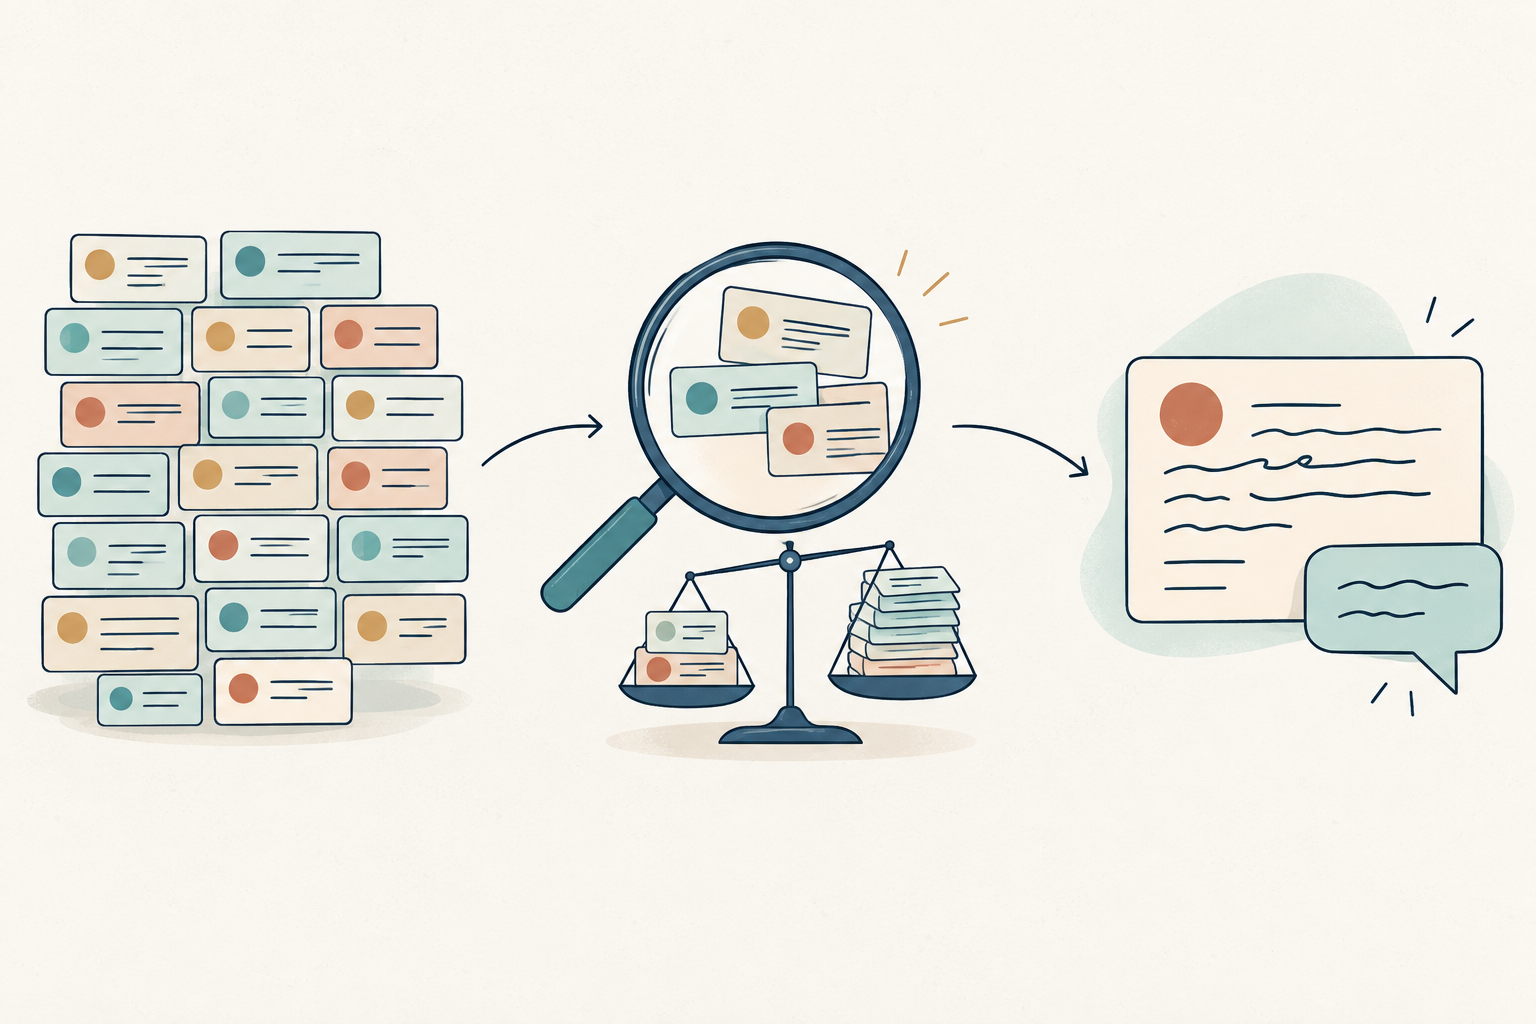
Definisci il gruppo da leggere
Indica la discussione e la regola di selezione prima di leggere.
Considera che cosa copre la selezione
Mantieni la vista selezionata distinta dalla discussione completa.
Leggi il commento nel suo contesto
Usa la domanda effettiva per preparare una risposta e verificarla.
Un brief sintetico per leggere una discussione su una ricetta
Usa queste domande prima di incaricare un creator o un collega di esaminare i commenti. Sono un aiuto pratico alla pianificazione, non domande del dataset originale.
Decisione: A che cosa servirà la lettura? Indica un compito concreto, come chiarire un passaggio della ricetta o scegliere il tema di un approfondimento. Separa la richiesta di esempi da quella di descrivere l’intera discussione.
Ambito: Quale ricetta, quale piattaforma e quale periodo sono inclusi? Indica se l’elenco disponibile è completo. Conta i commenti come commenti; senza prove separate, non chiamarli persone distinte o clienti verificati.
Selezione: Come entreranno i commenti nel gruppo da leggere? Registra l’ordinamento o la procedura casuale, il numero letto e l’eventuale regola per le parità. Includi i commenti senza valutazione quando fanno parte della discussione che vuoi capire.
Osservazioni: Che cosa dicevano davvero i commenti selezionati? Distingui una domanda diretta dalla tua interpretazione. Conserva il contesto necessario a capire il problema, senza inserire informazioni personali nel brief condiviso.
Prossima azione: Quale affermazione o dettaglio della ricetta va verificato prima della pubblicazione? Assegna la verifica a chi sa rispondere. Scrivi la spiegazione e la destinazione proposte, senza trasformare gli esempi scelti in un’affermazione non supportata su quanto siano diffusi.
Come abbiamo confrontato i 3 metodi di selezione
La fonte è il dataset Recipe Reviews and User Feedback di Ali, Matuszewski e Czupyt, pubblicato da UCI nel 2023 con licenza CC BY 4.0. Contiene commenti di un elenco selezionato di 100 ricette Taste of Home molto apprezzate. L’anno di pubblicazione non stabilisce una data esatta di raccolta e il materiale disponibile non dimostra che ogni commento originale sia stato acquisito. È un’analisi di un archivio storico, non un confronto delle prestazioni attuali della piattaforma. [1][2][3]
Abbiamo verificato l’intero archivio pubblicato: 18.182 identificativi distinti di commento su 100 posizioni nell’elenco delle ricette. Ogni ricetta aveva più di 10 commenti, quindi tutte le 100 sono entrate nel confronto. Chi aveva commentato più volte resta conteggiato con più commenti. Non abbiamo eliminato i duplicati per persona né analizzato testo, nomi, reputazione degli utenti o punteggio di ordinamento della fonte.
Per ogni ricetta, la regola dei voti positivi selezionava i 10 commenti con i conteggi osservati più alti. Quella dei più recenti usava le 10 date e ore di creazione più tarde. In caso di parità alla soglia, ogni possibile modo di occupare i posti restanti scegliendo tra quei commenti aveva la stessa probabilità. La selezione casuale assegnava pari probabilità a ogni sottoinsieme di 10 commenti dell’archivio della ricetta.
Per ogni selezione possibile abbiamo confrontato la distribuzione delle valutazioni nelle 6 categorie con l’archivio completo della ricetta, poi calcolato la media della distanza secondo la regola di selezione. Calcoli di probabilità esatti danno questo valore atteso senza simulazione. Fare la media delle distanze conta: calcolare la distanza solo dopo aver mediato le quote delle categorie risponderebbe a una domanda diversa e potrebbe nascondere la variabilità del campionamento.
Abbiamo poi fatto la media delle distanze attese delle singole ricette, assegnando a ciascuna lo stesso peso. Le differenze sono state calcolate prima dell’arrotondamento a 1 decimale. Il limite di 10 commenti, le regole di ammissibilità, i confronti e il piano di presentazione erano fissati prima di esaminare i risultati oggetto dell’analisi. Non abbiamo scelto in seguito un altro limite o un sottoinsieme favorevole di ricette.
I risultati descrivono questo archivio finito e le regole specificate, quindi non presentiamo intervalli di confidenza per una popolazione o effetti causali. I voti positivi cumulativi non rivelano l’esposizione dei commenti né la storia dei voti. L’articolo dei produttori della fonte studia la classificazione dei testi; questa analisi segue invece le categorie di stelle documentate da UCI ed esamina la selezione. Il metodo tecnico spiega la distinzione tra i campi della fonte. [1][2]
I download forniscono risultati aggregati, una verifica numerica per ogni posizione nell’elenco delle ricette e codice per riprodurre l’analisi. Non contengono testi dei commenti, nomi o identificativi degli utenti. I record originali sono disponibili separatamente presso UCI; citare autori e repository non implica che approvino la nostra interpretazione. [1][3]
Non serve registrarsi. I download contengono confronti aggregati, risultati numerici per posizione nell’elenco delle ricette e spiegazioni tradotte del metodo. Non includono testi dei commenti, nomi degli utenti o identificativi dei singoli commenti. Il dataset originale è disponibile separatamente presso UCI. [1]
Fonti e note
- Ali, A., Matuszewski, S. e Czupyt, J. (2023). Recipe Reviews and User Feedback [Dataset]. UCI Machine Learning Repository. DOI: 10.24432/C5FG95. UCI documenta 18.182 commenti e definisce le stelle da 1 a 5, con 0 a indicare nessuna valutazione. I calcoli di Influence IQ usano l’archivio pubblicato, non i dati attuali del sito.
- L’articolo dei produttori, «Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models», descrive la fonte delle ricette selezionate e uno studio di classificazione dei testi. La sua descrizione di best_score è in conflitto con il campo delle valutazioni documentato da UCI. Usiamo stars e non analizziamo best_score o il testo delle recensioni. Il materiale disponibile non stabilisce il momento esatto della raccolta o la sua copertura completa.
- Il dataset UCI è sotto licenza Creative Commons Attribuzione 4.0. Influence IQ ha calcolato nuovi confronti aggregati a partire dai dati. L’attribuzione non implica l’approvazione degli autori, di UCI o di Taste of Home. I download non ridistribuiscono commenti individuali o identità degli utenti.
- Influence IQ (2026). Recipe feedback sampling: analysis method, aggregate results & reproduction code. Il pacchetto documenta il confronto fisso da 10 commenti, i calcoli esatti del valore atteso della distanza in variazione totale, la gestione delle parità e i risultati numerici per tutte le 100 posizioni nell’elenco delle ricette. I dati originali si ottengono separatamente da UCI. Spiegazioni tradotte accompagnano i file tecnici originali.
Articolo, brief di pianificazione, etichette delle figure e CSV dei risultati sono disponibili in ogni lingua dell’articolo. Il pacchetto tecnico per riprodurre l’analisi include spiegazioni tradotte. Ogni edizione descrive lo stesso archivio storico di ricette e la stessa analisi.