Merchandising e-commerce: verifica le ipotesi sulla posizione dei prodotti
Un esperimento storico con 10 libri mostra come un semplice aggiustamento per la posizione possa non cogliere parti della relazione e come verificare l’ipotesi prima di confrontare le schede prodotto.
Rianalisi originale dell’esperimento pubblicato del 2024 sulla scelta di libri di Compiani, Morozov e Seiler.
Sintesi
Prima di decidere che un’offerta sia più forte di un’altra, un’impresa deve considerare dove sia apparsa ciascuna. Abbiamo usato un esperimento pubblicato del 2024 con 10 ebook per verificare 2 modi di tenere conto della posizione. Consentire un aggiustamento proprio per ogni posizione prevedeva meglio le scelte nel complesso rispetto allo stesso aggiustamento per ogni passo verso il basso nella lista. Era meno accurato in alcune posizioni singole, quindi conta il confronto completo.
Entrambi i modelli usavano le stesse informazioni su libri e prezzi. Li abbiamo stimati su 6.176 partecipanti e verificato le previsioni su altri 3.088. Le scelte erano ipotetiche e tutti dovevano selezionare un libro. Per imprese e creator che confrontano schede prodotto, la lezione è verificare le ipotesi sulla posizione prima di attribuire i risultati a un’offerta. Lo studio non stima un aumento delle vendite né identifica l’ordine migliore dei prodotti.
Supponiamo che il prodotto in cima a una pagina riceva più clic. È un’offerta più forte o la posizione nella lista ha aiutato? Un’impresa ha bisogno di una risposta utile prima di riscrivere le altre schede, scontare gli articoli apparentemente più deboli o cambiare l’assortimento.
Tenere conto della posizione sembra semplice finché non si chiede come. Ogni spostamento verso il basso dovrebbe ricevere lo stesso aggiustamento? Abbiamo usato un esperimento storico per confrontare l’approccio semplice con uno più flessibile, poi verificato entrambi su partecipanti non usati per stimare i modelli.
Gli stessi prodotti, posizioni diverse
Che cosa dovrebbe dirti un confronto delle posizioni dei prodotti?
Un confronto delle schede prodotto dovrebbe aiutarti a separare l’articolo offerto dal modo in cui viene presentato. Se un prodotto appare di solito per primo e un altro per ultimo, i soli totali non dicono se gli acquirenti preferiscano un’offerta.
L’approccio semplice che verifichiamo assegna a ogni passo verso il basso nella lista lo stesso aggiustamento al punteggio di preferenza sottostante del modello. La domanda utile è se preveda le scelte abbastanza bene rispetto al consentire aggiustamenti diversi per posizioni diverse.
Abbiamo verificato i 2 approcci con un esperimento pubblicato sulla scelta di libri. Il risultato è pertinente per imprese e creator che confrontano prodotti su una pagina di raccolta o in una vetrina digitale. Fornisce un modo di esaminare un’ipotesi di misurazione, anziché una regola su dove mettere l’articolo più venduto.
Questo conta quando un’offerta appare in più luoghi. Un creator potrebbe mettere in evidenza lo stesso download in una raccolta e in una pagina di lancio. Un rivenditore potrebbe cambiare l’ordine di una lista di categoria. Articolo, prezzo, pubblico e presentazione possono differire insieme. Un aggiustamento per la posizione è un’ipotesi su una parte del confronto e merita una verifica propria.
Che cosa hanno scelto le persone nell’esperimento sui libri?
Giovanni Compiani, Ilya Morozov e Stephan Seiler hanno chiesto a persone reclutate su Prolific di fare scelte ipotetiche tra 10 ebook, con ordine e prezzi randomizzati. I partecipanti dovevano scegliere un libro; non c’era l’opzione di non comprare nulla. Usiamo la prima attività di ogni compilazione mantenuta, non quella successiva che rimuoveva il libro scelto.[1]
Gli autori riportano già le risposte a posizione e prezzo. La ricerca più ampia studia come testo e immagini aiutino a stimare la sostituzione tra prodotti. La nostra domanda è più circoscritta: sostituire un unico termine di posizione migliora la previsione per partecipanti le cui scelte non sono state usate per stimare il modello?
Seguire le regole originali di ammissibilità lascia 9.265 compilazioni con 9.264 ID distinti di partecipanti Prolific. 1 ID compare 2 volte. Manteniamo insieme entrambe le compilazioni e diamo a quel partecipante lo stesso peso totale di ogni altro. Una compilazione non è automaticamente una persona separata e una prima attività non è necessariamente la prima esposizione della persona all’esperimento.[2][3]
Le date della fonte mantenute vanno dall’11 al 26 giugno 2024. Il manoscritto descrive il 14–27 giugno, quindi rendiamo esplicita la differenza e non applichiamo esclusioni per data. L’ammissibilità per paese ed età non era stabilita nei materiali esaminati; non sono stime per gli acquirenti statunitensi o un’altra popolazione nazionale.[1][2]
Le compilazioni dello stesso partecipante restano insieme per tutto il confronto
Compilazioni selezionate della prima attività dopo le regole originali di ammissibilità degli autori; date nei record mantenuti della fonte 11–26 giugno 2024.
| Gruppo | Partecipanti (per ID della piattaforma) | Compilazioni mantenute |
|---|---|---|
| Tutti i mantenuti | 9264 | 9265 |
| Addestramento | 6176 | 6176 |
| Riservati alla valutazione | 3088 | 3089 |
Quale modello di posizione ha previsto meglio le scelte riservate alla valutazione?
Il modello flessibile di posizione prevedeva meglio le scelte riservate alla valutazione sulla misura di punteggio prestabilita. Entrambi i modelli tengono conto del libro offerto e del prezzo mostrato. Differiscono soltanto nel modo in cui rappresentano la posizione.
Il modello di base usa 1 coefficiente per ogni passo verso il basso nella lista. Quello flessibile usa aggiustamenti separati per le posizioni dalla 2 alla 10 rispetto alla prima. Ha così più libertà, ma anche più parametri da stimare. Un migliore adattamento ai propri dati di addestramento non basterebbe da solo a risolvere il confronto.
Abbiamo quindi stimato entrambi i modelli con 6.176 partecipanti e li abbiamo valutati sugli altri 3.088. Ogni compilazione di una persona restava dalla stessa parte della divisione. Il gruppo di test contiene 3.089 compilazioni perché include il partecipante ripetuto.
Per confrontare le previsioni abbiamo usato un punteggio logaritmico negativo. Un modello riceve una penalità minore quando assegna più probabilità alla scelta effettiva di una persona. Riceve una penalità maggiore quando assegna pochissima probabilità a quella scelta. Punteggi logaritmici negativi medi inferiori sono migliori.
La media sui dati di valutazione era 2,2260 per il modello di base e 2,2154 per quello flessibile, in unità di logaritmo naturale, dette anche nat. Sono punteggi di previsione, non percentuali di risposte corrette. I punteggi di addestramento e test sono mostrati insieme, così il confronto non si basa sul compito più facile di descrivere dati già visti dal modello.
2 modelli valutati sugli stessi partecipanti
Scelte selezionate della prima attività con 10 libri nel 2024. Addestramento: 6.176 partecipanti e compilazioni. Test: 3.088 partecipanti e 3.089 compilazioni.
| Modello di posizione | Punteggio di addestramento (nat) | Punteggio sui dati di valutazione (nat) |
|---|---|---|
| 1 termine lineare di posizione | 2,2046 | 2,2260 |
| Termini separati di posizione | 2,1899 | 2,2154 |
Il miglioramento abbinato era di 0,0106 nat per partecipante, con un intervallo approssimativo al 95% da 0,0044 a 0,0168. Qui un miglioramento positivo favorisce il modello flessibile. Il risultato è piccolo su questa scala, ma l’intervallo è sopra 0.[4]
L’intervallo tratta i 2 modelli stimati come fissi e presume gruppi di partecipanti indipendenti. Non include l’incertezza derivante dalla stima dei modelli su un altro campione di addestramento. Il risultato sostiene un miglioramento predittivo in questa attività storica selezionata; non trasforma la differenza di punteggio in un aumento delle vendite.
Il modello flessibile migliora il punteggio logaritmico sui dati di valutazione
Confronto abbinato tra 3.088 partecipanti di test nell’attività storica selezionata con 10 libri.
| Confronto | Miglioramento (nat) | Intervallo al 95%: limite inferiore (nat) | Intervallo al 95%: limite superiore (nat) |
|---|---|---|---|
| Punteggio logaritmico flessibile meno quello di base | 0,0106 | 0,0044 | 0,0168 |
Dove i 2 modelli si discostavano dalle scelte osservate?
Il confronto completo per posizione mostra perché il punteggio generale debba essere accompagnato dai dettagli. Per ogni posizione, confrontiamo la quota osservata di scelta con la probabilità media assegnata da ogni modello. Sono medie con uguale peso per partecipante nel gruppo riservato alla valutazione, non tassi di clic.
Alla posizione 1, la quota osservata era il 17,16%. Il modello di base prevedeva il 14,64%, mentre quello flessibile il 17,73%. Alla posizione 10, la quota osservata era il 9,18%, contro previsioni del 6,37% e dell’8,74%. Il modello flessibile era più vicino a entrambe le estremità di questa particolare lista.
Scelte osservate e previste in tutte e 10 le posizioni
Gruppo riservato: 3.088 partecipanti e 3.089 compilazioni della prima attività dell’esperimento pubblicato del 2024.
| Posizione | Quota osservata di scelta | Probabilità media del modello di base | Probabilità media del modello flessibile | Compilazioni che scelgono la posizione |
|---|---|---|---|---|
| Posizione 1 | 17,16% | 14,64% | 17,73% | 530 |
| Posizione 2 | 13,60% | 13,20% | 14,84% | 420 |
| Posizione 3 | 9,91% | 12,06% | 9,74% | 306 |
| Posizione 4 | 10,91% | 11,21% | 9,26% | 337 |
| Posizione 5 | 9,20% | 10,09% | 8,94% | 284 |
| Posizione 6 | 7,08% | 9,25% | 8,01% | 219 |
| Posizione 7 | 8,00% | 8,44% | 7,57% | 247 |
| Posizione 8 | 7,12% | 7,67% | 7,47% | 220 |
| Posizione 9 | 7,84% | 7,08% | 7,69% | 242 |
| Posizione 10 | 9,18% | 6,37% | 8,74% | 284 |
Il modello flessibile non era più vicino ovunque. Alla posizione 4, la quota osservata era il 10,91%. Il modello di base prevedeva l’11,21%, mentre quello flessibile il 9,26%. La flessibilità aggiuntiva migliorava il punteggio complessivo sui dati di valutazione, lasciando però una discrepanza maggiore in quella posizione.
La tabella successiva mostra le quote osservate meno quelle previste. Una differenza positiva significa che il modello prevedeva troppo poche scelte in quella posizione; una negativa troppe. Mantenere visibili tutte e 10 le posizioni impedisce che un’estremità favorevole rappresenti l’intero confronto.
Scostamenti di entrambi i modelli dalle scelte osservate
Quota osservata di scelta meno probabilità media prevista per ognuna delle 10 posizioni, con gli stessi 3.088 partecipanti di test.
| Posizione | Osservato meno modello di base | Osservato meno modello flessibile |
|---|---|---|
| Posizione 1 | 2,52 punti percentuali | -0,57 punti percentuali |
| Posizione 2 | 0,41 punti percentuali | -1,24 punti percentuali |
| Posizione 3 | -2,15 punti percentuali | 0,17 punti percentuali |
| Posizione 4 | -0,29 punti percentuali | 1,65 punti percentuali |
| Posizione 5 | -0,89 punti percentuali | 0,26 punti percentuali |
| Posizione 6 | -2,17 punti percentuali | -0,93 punti percentuali |
| Posizione 7 | -0,44 punti percentuali | 0,43 punti percentuali |
| Posizione 8 | -0,55 punti percentuali | -0,35 punti percentuali |
| Posizione 9 | 0,76 punti percentuali | 0,14 punti percentuali |
| Posizione 10 | 2,81 punti percentuali | 0,44 punti percentuali |
Queste righe per posizione sono descrittive, senza affermazioni separate di significatività. L’esperimento non misurava movimenti oculari o attenzione e l’analisi non identifica perché una posizione differisca. Una curva nelle quote osservate non smentisce neppure da sola il modello di base: il termine di posizione è lineare nel punteggio di preferenza sottostante, non nelle percentuali di scelta.
Sottrarre semplicemente la prima e l’ultima quota osservata risponderebbe a una domanda diversa. Quelle quote riassumono scelte tra prodotti e prezzi. Entrambi i modelli stimati tengono conto dell’identità del libro e del prezzo prima di assegnare probabilità tra le 10 opzioni. Né la differenza tra estremità né il confronto dei modelli dicono che cosa succederebbe spostando un particolare prodotto in un negozio reale.
Un modello di misurazione della posizione dei prodotti da usare
Prima di confrontare offerte, scrivi un brief essenziale di misurazione. Il modello seguente è accessibile senza registrazione e illustrativo. Applica la lezione dello studio sulla verifica delle ipotesi; non promette che lo stesso modello sia adatto alla tua vetrina.
Decisione: «Dobbiamo decidere [quale confronto di prodotti o modifica della presentazione] per [pagina o campagna] durante [periodo]». Indica la decisione prima di scegliere una metrica favorevole.
Esito: «Misureremo [scelta, clic, aggiunta al carrello o acquisto]». Seleziona l’esito che i dati supportano davvero. Conserva insieme le alternative offerte, il loro ordine e i prezzi mostrati. Un risultato di scelta obbligata deve restare separato da uno di acquisto.
Unità: «La nostra unità è [partecipante o un’altra unità chiaramente definita]. Le visite o compilazioni ripetute saranno gestite con [regola]». Mantieni insieme le osservazioni della stessa persona quando valuti la previsione per persone nuove. Non trattare un identificatore di sessione anonimo come prova di una persona unica.
Confronto: «Entrambi i modelli useranno gli stessi prodotti, informazioni sui prezzi e osservazioni ammissibili. Differiranno per [l’ipotesi sulla posizione]». Specifica sia l’alternativa semplice sia quella più flessibile.
Valutazione: «Riserveremo [un gruppo definito] prima della stima e confronteremo [una misura di punteggio indicata]. Mostreremo tutte le posizioni». Decidi come riportare un risultato irrisolto o peggiore prima di vederlo.
Uso: «Il risultato contribuirà a [decisione di misurazione]. Servono ancora prove su [esito commerciale non misurato qui] prima di [decisione commerciale]». L’ultima frase impedisce che un esercizio di previsione diventi tacitamente una previsione dei ricavi.
Mantieni lo stesso partecipante da una sola parte del test
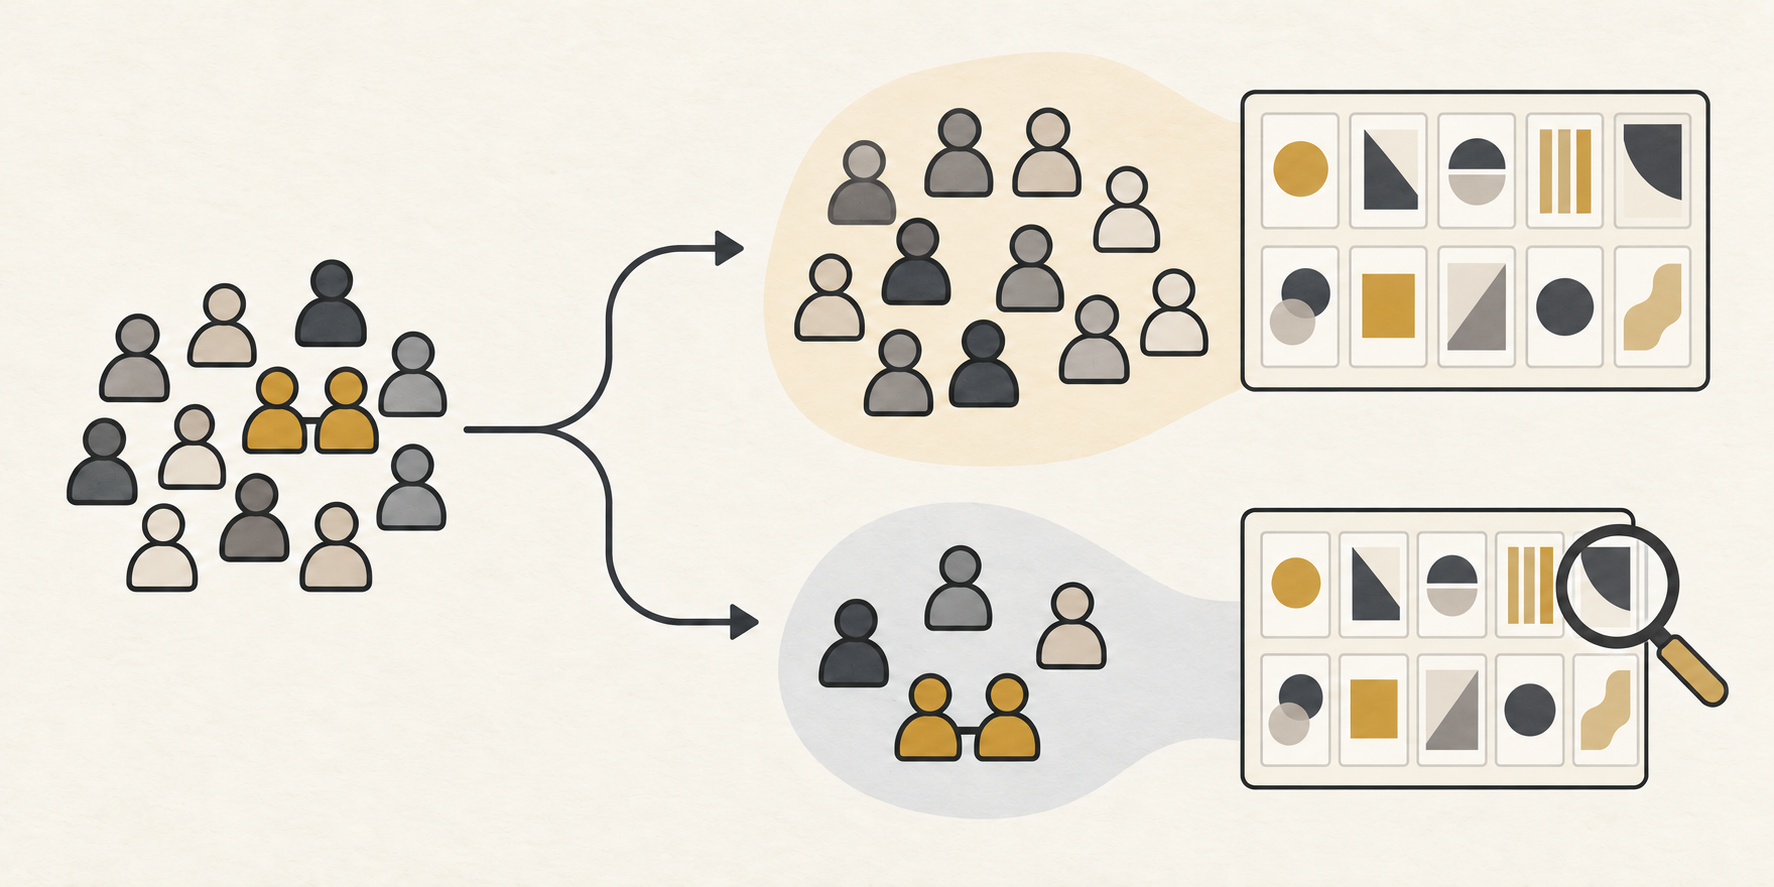
Definisci il confronto
Indica prodotto, posizione, esito e unità di osservazione.
Riserva il gruppo di valutazione
Mantieni insieme le compilazioni di ogni partecipante.
Verifica il risultato completo
Confronta le previsioni e mostra ogni posizione, compresi i risultati peggiori.
Un esempio svolto: un creator confronta offerte digitali
Considera un creator fittizio che vende un quaderno di esercizi di scrittura, un workshop e un pacchetto. Il pacchetto appare in cima alla pagina di lancio e riceve più clic. Il creator valuta di riscrivere le altre descrizioni dei prodotti.
Il brief di misurazione cambia la domanda immediata. L’esito osservato è un clic, non una vendita. I dati disponibili devono mostrare quali offerte fossero presentate, in quale ordine e a quali prezzi. Se il pacchetto occupa sempre il primo posto, quei dati non possono separarlo chiaramente da quella posizione.
Il brief compilato potrebbe dire: «Vogliamo sapere se il nostro modo di tenere conto della posizione preveda i clic di nuovi visitatori. Confronteremo le stesse offerte e informazioni sui prezzi, manterremo insieme le osservazioni ripetute e riporteremo il confronto completo per posizione. Non faremo affermazioni sugli acquisti a partire dai dati dei clic». È un esempio fittizio di domanda di misurazione, non un risultato proposto.
Un passo successivo ragionevole è pianificare un confronto con variazione sufficiente a distinguere prodotto e posizione, mantenendo la stessa definizione dell’esito. Il creator potrebbe poi confrontare un aggiustamento semplice per la posizione con uno più flessibile su un gruppo riservato. Sarebbe un nuovo studio di quella pagina; l’esperimento dei libri non fornisce un tasso di clic atteso.
Se l’approccio flessibile prevede meglio il gruppo riservato, il creator ha un motivo per rivedere come il rapporto tenga conto della posizione. Non mostra comunque che spostare il pacchetto aumenterà i ricavi. Una decisione commerciale richiederebbe prove sulla modifica effettiva della presentazione e sull’esito importante per l’impresa.
Se il confronto resta irrisolto, il creator dovrebbe dirlo. Una flessibilità aggiuntiva non è automaticamente uno strumento aziendale migliore. Il vantaggio pratico è una sequenza più chiara: capire che cosa i dati possano distinguere, verificare l’ipotesi di misurazione, poi decidere se serva un altro esperimento.
Come ha calcolato il confronto Influence IQ?
Abbiamo usato la pubblicazione delle risposte corrette degli autori e le regole originali di selezione. I primi 553 record pilota o di test sono esclusi in base alla posizione fissa nel file. Il quadro rimanente contiene 10.775 compilazioni. I filtri di comprensione ne lasciano 9.344; quello di completamento 9.265.[2]
Consenso, stato di completamento e regola della durata minima di 60 secondi non rimuovono altre compilazioni nei rispettivi passaggi. Completamento e durata sono filtri successivi all’esposizione, quindi il gruppo mantenuto è un campione selezionato.
Gli ID dei partecipanti Prolific definiscono i gruppi. Una divisione deterministica basata su hash assegna 2/3 dei gruppi all’addestramento e il resto al test, senza usare le scelte. In ogni gruppo, tutte le compilazioni mantenute della prima attività condividono equamente il contributo del partecipante. La stessa ponderazione si applica a stima, punteggi e tabelle per posizione.[3]
Entrambi i modelli sono logit multinomiali non penalizzati con 9 indicatori dei libri e 1 termine lineare di prezzo. Il modello di base aggiunge 1 termine lineare di posizione, per 11 parametri. Quello flessibile aggiunge 9 indicatori di posizione, per 19. La posizione 1 e l’ID prodotto numericamente più piccolo forniscono le categorie di riferimento. Tutti gli insiemi di scelta ammissibili contengono gli stessi 10 prodotti, con verifica della concordanza di ID scelto, prezzo e posizione.
Stimiamo i modelli sul gruppo di addestramento, conserviamo i coefficienti stimati e poi calcoliamo i punteggi delle scelte di test. L’intervallo usa la deviazione standard delle differenze abbinate dei punteggi dei partecipanti, 3.088 unità di partecipanti e 3.087 gradi di libertà. È un intervallo t di Student approssimativo, salvo le ipotesi esatte di normalità dei punteggi. Tutti e 10 i confronti per posizione restano descrittivi.[4]
L’ottimizzatore principale del modello di base ha restituito un avviso numerico. Soddisfaceva comunque ogni condizione di accuratezza specificata prima della stima, compreso un confronto da un secondo punto iniziale. Abbiamo mantenuto la stima originale; i controlli diagnostici dettagliati sono inclusi nei materiali di riproduzione.[5]
I download forniscono i risultati mostrati, il codice di analisi originale e gli output numerici aggregati. Escludono righe delle risposte originali, ID dei partecipanti e immagini dei libri. Ottieni i dati separatamente dalla pubblicazione degli autori. Influence IQ è responsabile della rianalisi e della sua interpretazione.
Il CSV usa la lingua di questa pagina. Il pacchetto contiene codice di calcolo originale, documentazione del metodo tradotta e risultati aggregati. Righe delle risposte originali e risorse dei libri non sono incluse; ottieni i dati separatamente dalla pubblicazione degli autori.
Fonti e note
- Compiani, Morozov e Seiler, Demand Estimation with Text and Image Data, versione 4 del manoscritto, 17 febbraio 2026, sezione 3 e appendice C. Gli autori studiano già le risposte a posizione e prezzo. Il nostro confronto sui partecipanti riservati alla valutazione è una rianalisi originale più circoscritta.
- Pubblicazione DeepLogitReplication degli autori al commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Seguiamo la soglia pilota originale basata sulla posizione nel file delle risposte corrette e le regole di ammissibilità degli autori. Le date della fonte mantenute sono 11–26 giugno 2024, diverse dal 14–27 giugno descritto nel manoscritto; le date non determinano l’inclusione.
- Prolific distingue l’ID di un partecipante da un identificatore dello studio o della compilazione. Conserviamo gli ID esatti dei partecipanti per il raggruppamento. Gli ID non verificano indipendentemente che ognuno rappresenti una persona diversa né stabiliscono che una compilazione mantenuta fosse la prima esposizione della persona.
- Il confronto prestabilito di Influence IQ fa la media della differenza tra le log-probabilità del modello flessibile e di base in ogni partecipante di test, poi tra i partecipanti. L’intervallo al 95% è la media più o meno il valore critico t di Student per la deviazione standard dei partecipanti divisa per la radice quadrata di 3.088. Presume gruppi indipendenti, condiziona su stime fisse di addestramento ed esclude la loro incertezza; l’esattezza richiede differenze tra partecipanti normali e identicamente distribuite con varianza comune.
- La stima di base con punto iniziale zero ha restituito un avviso di precisione. Il massimo gradiente medio assoluto era 3.12×10⁻⁹, il decremento di Newton 2.50×10⁻⁸ e la massima differenza di log-probabilità tra 2 punti iniziali 7.46×10⁻⁸, sotto i limiti prestabiliti 10⁻⁸, 10⁻⁶ e 10⁻⁷. Entrambi i modelli soddisfacevano anche le condizioni di curvatura positiva e concordanza della funzione obiettivo. Sono stati conservati i coefficienti principali con punto iniziale zero.
L’articolo in inglese è la versione di riferimento. Le versioni linguistiche descrivono lo stesso esperimento storico; non sono stime degli acquisti specifiche per paese.