ई-कॉमर्स मर्चेंडाइज़िंग: उत्पाद की जगह को लेकर अपनी धारणाएँ जाँचें
10-किताबों का ऐतिहासिक प्रयोग दिखाता है कि जगह का सरल समायोजन पैटर्न का कुछ हिस्सा कैसे छोड़ सकता है और उत्पाद कार्ड की तुलना से पहले उस धारणा को कैसे जाँचें.
Compiani, Morozov और Seiler के जारी 2024 किताब चयन प्रयोग का मौलिक पुनर्विश्लेषण.
सार
एक ऑफ़र को दूसरे से बेहतर मानने से पहले कारोबार को देखना चाहिए कि दोनों कहाँ दिखे. हमने 10 ई-बुक वाले जारी 2024 प्रयोग से जगह का हिसाब रखने के 2 तरीके जाँचे. हर जगह को अपना समायोजन देने से कुल मिलाकर चुनाव का पूर्वानुमान सूची में हर कदम नीचे जाने पर एक ही समायोजन लगाने से बेहतर था. कुछ अलग जगहों पर यह कम सटीक था, इसलिए पूरी तुलना मायने रखती है.
दोनों मॉडलों में किताब और कीमत की एक ही जानकारी थी. हमने उन्हें 6,176 प्रतिभागियों पर फ़िट किया और दूसरे 3,088 पर उनके पूर्वानुमान जाँचे. चुनाव काल्पनिक थे और सबको किताब चुननी थी. उत्पाद कार्ड की तुलना करते कारोबारों और क्रिएटरों के लिए सीख है कि परिणाम ऑफ़र के नाम करने से पहले जगह की धारणाएँ जाँचें. अध्ययन न बिक्री में बढ़ोतरी का अनुमान लगाता है, न उत्पादों का सबसे अच्छा क्रम पहचानता है.
मान लें पेज पर सबसे ऊपर वाले उत्पाद को सबसे ज़्यादा क्लिक मिलते हैं. क्या ऑफ़र बेहतर है या सूची में उसकी जगह ने मदद की? दूसरे कार्ड फिर लिखने, कमज़ोर दिखती चीज़ों पर डिस्काउंट देने या उत्पादों का चयन बदलने से पहले कारोबार को उपयोगी जवाब चाहिए.
जगह का हिसाब रखना तब तक सरल लगता है जब तक तरीका न पूछें. क्या सूची में हर कदम नीचे जाने पर एक ही समायोजन हो? हमने ऐतिहासिक प्रयोग में इस सरल तरीके की तुलना अधिक लचीले तरीके से की, फिर मॉडल फ़िट करने से बाहर रखे प्रतिभागियों पर दोनों परखे.
वही उत्पाद, अलग जगहें
उत्पाद की जगह की तुलना से क्या पता चलना चाहिए?
उत्पाद कार्ड की तुलना में दी गई चीज़ को उसकी प्रस्तुति से अलग समझने में मदद मिलनी चाहिए. एक उत्पाद आम तौर पर पहले और दूसरा आखिरी हो, तो उनके कुल अकेले नहीं बताते कि खरीदार कोई ऑफ़र अधिक पसंद करते हैं या नहीं.
हम जिस सरल तरीके को परखते हैं, वह सूची में हर कदम नीचे जाने पर मॉडल के मूल पसंद स्कोर में एक जैसा समायोजन देता है. उपयोगी सवाल है कि अलग जगहों को अलग समायोजन देने की तुलना में क्या उससे पर्याप्त अच्छे चुनाव पूर्वानुमान मिलते हैं.
हमने जारी किताब चयन प्रयोग से वे 2 तरीके जाँचे. परिणाम कलेक्शन पेज या डिजिटल स्टोर पर उत्पादों की तुलना करते कारोबारों और क्रिएटरों के लिए प्रासंगिक है. वह मापन की धारणा जाँचने का तरीका देता है, सबसे अधिक बिकती चीज़ कहाँ रखें, उसका नियम नहीं.
ऑफ़र 1 से अधिक जगह दिखे, तो यह मायने रखता है. क्रिएटर वही डाउनलोड कलेक्शन और लॉन्च पेज में दिखा सकता है. खुदरा विक्रेता श्रेणी सूची का क्रम बदल सकता है. चीज़, कीमत, दर्शक और प्रस्तुति साथ बदल सकते हैं. जगह का समायोजन उस तुलना के एक हिस्से की धारणा है और उसे अलग जाँचना चाहिए.
किताब के प्रयोग में लोगों ने क्या चुना?
Giovanni Compiani, Ilya Morozov और Stephan Seiler ने Prolific से भर्ती लोगों को यादृच्छिक क्रम और कीमतों वाली 10 ई-बुक में काल्पनिक चुनाव करने को कहा. प्रतिभागियों को किताब चुननी थी; कुछ न खरीदने का विकल्प नहीं था. हम रखे गए हर सबमिशन का पहला काम लेते हैं, बाद का वह काम नहीं जिसमें चुनी किताब हटाई गई.[1]
लेखक क्रम और कीमत के प्रति प्रतिक्रियाएँ पहले से बताते हैं. उनका व्यापक शोध पाठ और छवियों से उत्पाद की जगह दूसरा उत्पाद चुनने का अनुमान लगाने की विधि देखता है. हमारा सवाल सीमित है: क्या जगह के 1 पद को बदलने से उन प्रतिभागियों के चुनावों का पूर्वानुमान बेहतर होता है जिनके चुनाव मॉडल फ़िटिंग से बाहर रखे गए थे?
मूल पात्रता नियमों से 9,265 सबमिशन बचते हैं, जिनमें 9,264 अलग Prolific प्रतिभागी ID हैं. 1 ID 2 बार आता है. हम दोनों सबमिशन साथ रखते हैं और उस व्यक्ति को हर दूसरे प्रतिभागी जितना कुल भार देते हैं. सबमिशन अपने आप अलग व्यक्ति नहीं और पहला काम ज़रूरी नहीं कि उस व्यक्ति का प्रयोग से पहला परिचय हो.[2][3]
रखे स्रोत की तारीख़ें 11 जून से 26 जून 2024 हैं. पांडुलिपि में 14–27 जून है, इसलिए हम फ़र्क बताते हैं और तारीख़ के आधार पर किसी को नहीं हटाते. जाँची सामग्री में देश और आयु की पात्रता स्थापित नहीं थी; ये अमेरिकी खरीदारों या दूसरी राष्ट्रीय आबादी के अनुमान नहीं.[1][2]
पूरी तुलना में एक प्रतिभागी के जवाब साथ रहते हैं
लेखकों के मूल पात्रता नियमों के बाद पहले काम के चुने सबमिशन; रखे स्रोत रिकॉर्ड की तारीख़ें 11–26 जून 2024.
| समूह | प्रतिभागी (प्लेटफ़ॉर्म ID से) | रखे गए सबमिशन |
|---|---|---|
| सभी रखे गए | 9,264 | 9,265 |
| ट्रेनिंग | 6,176 | 6,176 |
| मूल्यांकन के लिए अलग रखे | 3,088 | 3,089 |
स्थान के किस मॉडल ने अलग रखे समूह के चुनाव बेहतर बताए?
जगह के लचीले मॉडल ने पहले से तय स्कोर माप पर अलग रखे समूह के चुनाव बेहतर बताए. दोनों मॉडल दी गई किताब और दिखाई कीमत का हिसाब रखते हैं. फ़र्क केवल जगह दर्शाने के तरीके में है.
मूल मॉडल सूची में हर कदम नीचे जाने के लिए 1 ही गुणांक इस्तेमाल करता है. लचीले मॉडल में पहले स्थान के मुकाबले 2 से 10 तक हर जगह का अलग समायोजन है. इससे अधिक स्वतंत्रता, लेकिन अनुमान लगाने के लिए अधिक पैरामीटर भी मिलते हैं. अपने ट्रेनिंग डेटा पर बेहतर फ़िट अकेले तुलना तय नहीं करेगा.
इसलिए हमने 6,176 प्रतिभागियों से दोनों मॉडल फ़िट किए और बाकी 3,088 पर परखे. किसी प्रतिभागी के सभी सबमिशन बँटवारे के एक ही तरफ़ रहे. दोहराए प्रतिभागी के कारण टेस्ट समूह में 3,089 सबमिशन हैं.
पूर्वानुमान तुलना के लिए हमने ऋणात्मक लॉग स्कोर लिया. व्यक्ति के वास्तविक चुनाव को अधिक संभावना देने पर मॉडल को कम दंड मिलता है. उस चुनाव को बहुत कम संभावना देने पर अधिक दंड मिलता है. औसत ऋणात्मक लॉग स्कोर कम हो तो बेहतर है.
अलग रखे समूह का औसत मूल मॉडल में 2.2260 और लचीले मॉडल में 2.2154 था, प्राकृतिक लॉग इकाइयों में जिन्हें nats भी कहते हैं. ये पूर्वानुमान स्कोर हैं, सही जवाबों के प्रतिशत नहीं. ट्रेनिंग और टेस्ट स्कोर साथ हैं ताकि तुलना केवल मॉडल के पहले से देखे डेटा का वर्णन करने के आसान काम पर निर्भर न हो.
2 मॉडल, उन्हीं प्रतिभागियों पर मूल्यांकन
2024 के 10 किताबों वाले प्रयोग के पहले काम के वे चुनाव जो विश्लेषण में रखे गए. ट्रेनिंग: 6,176 प्रतिभागी और उतने ही सबमिशन. टेस्ट: 3,088 प्रतिभागी और 3,089 सबमिशन.
| जगह का मॉडल | ट्रेनिंग स्कोर (nats) | अलग रखे समूह का स्कोर (nats) |
|---|---|---|
| स्थान का 1 रैखिक पद | 2.2046 | 2.2260 |
| हर जगह के अलग पद | 2.1899 | 2.2154 |
हर प्रतिभागी के लिए दोनों मॉडलों के स्कोर का अंतर निकालने पर औसत सुधार 0.0106 nats था, जिसका लगभग 95% अंतराल 0.0044 से 0.0168 था. यहाँ धनात्मक सुधार लचीले मॉडल के पक्ष में है. इस स्कोर पैमाने पर परिणाम छोटा है, लेकिन अंतराल 0 से ऊपर है.[4]
यह अंतराल फ़िट किए गए 2 मॉडलों को स्थिर मानता है और स्वतंत्र प्रतिभागी समूहों की धारणा लेता है. दूसरे ट्रेनिंग नमूने पर मॉडल फ़िट करने की अनिश्चितता उसमें नहीं है. निष्कर्ष इस चुने ऐतिहासिक काम में बेहतर पूर्वानुमान का आधार देता है; स्कोर का अंतर बिक्री बढ़ने का आँकड़ा नहीं बनता.
लचीला मॉडल अलग रखे समूह का लॉग स्कोर सुधारता है
ऐतिहासिक प्रयोग के 10 किताबों वाले काम के 3,088 चयनित टेस्ट प्रतिभागियों में हर प्रतिभागी के लिए दोनों मॉडलों के स्कोर की तुलना.
| तुलना | सुधार (nats) | 95% अंतराल: निचला (nats) | 95% अंतराल: ऊपरी (nats) |
|---|---|---|---|
| लचीले मॉडल का लॉग स्कोर − मूल मॉडल का लॉग स्कोर | 0.0106 | 0.0044 | 0.0168 |
2 मॉडल देखे गए चुनावों से कहाँ चूके?
स्थानों की पूरी तुलना दिखाती है कि कुल स्कोर के साथ विवरण क्यों चाहिए. हर स्थान का देखा चुनाव हिस्सा दोनों मॉडलों की दी औसत संभावना से मिलाते हैं. ये अलग रखे समूह के समान प्रतिभागी भार वाले औसत हैं, क्लिक दरें नहीं.
स्थान 1 पर देखा हिस्सा 17.16% था. मूल मॉडल ने 14.64% और लचीले ने 17.73% बताया. स्थान 10 पर देखा हिस्सा 9.18% था, जबकि पूर्वानुमान 6.37% और 8.74% थे. इस खास सूची के दोनों सिरों पर लचीला मॉडल अधिक पास था.
सभी 10 जगहों के देखे और पूर्वानुमानित चुनाव
जारी 2024 प्रयोग का अलग रखा समूह: 3,088 प्रतिभागी और पहले काम के 3,089 सबमिशन.
| जगह | देखा गया चुनाव हिस्सा | मूल मॉडल की औसत संभावना | लचीले मॉडल की औसत संभावना | इस जगह का उत्पाद चुनने वाले सबमिशन |
|---|---|---|---|---|
| स्थान 1 | 17.16% | 14.64% | 17.73% | 530 |
| स्थान 2 | 13.60% | 13.20% | 14.84% | 420 |
| स्थान 3 | 9.91% | 12.06% | 9.74% | 306 |
| स्थान 4 | 10.91% | 11.21% | 9.26% | 337 |
| स्थान 5 | 9.20% | 10.09% | 8.94% | 284 |
| स्थान 6 | 7.08% | 9.25% | 8.01% | 219 |
| स्थान 7 | 8.00% | 8.44% | 7.57% | 247 |
| स्थान 8 | 7.12% | 7.67% | 7.47% | 220 |
| स्थान 9 | 7.84% | 7.08% | 7.69% | 242 |
| स्थान 10 | 9.18% | 6.37% | 8.74% | 284 |
लचीला मॉडल हर जगह अधिक पास नहीं था. स्थान 4 पर देखा हिस्सा 10.91% था. मूल मॉडल ने 11.21% और लचीले ने 9.26% बताया. अधिक लचीलेपन ने अलग रखे समूह का कुल स्कोर सुधारा, लेकिन उस जगह बड़ा फ़र्क छोड़ा.
अगली तालिका में देखे हिस्से में से पूर्वानुमानित हिस्सा घटाने पर मिला अंतर है. धनात्मक अंतर का मतलब है कि उस स्थान के लिए मॉडल का पूर्वानुमानित हिस्सा देखे गए हिस्से से कम था; ऋणात्मक अंतर का मतलब है कि पूर्वानुमानित हिस्सा देखे गए हिस्से से अधिक था. सभी 10 स्थान दिखते रहने से अच्छा दिखता एक सिरा पूरी तुलना की जगह नहीं लेता.
देखे चुनावों से दोनों मॉडलों के अंतर
उन्हीं 3,088 टेस्ट प्रतिभागियों के आधार पर, सभी 10 स्थानों के लिए देखे गए चुनाव के हिस्से में से औसत पूर्वानुमानित संभावना घटाकर निकाला गया अंतर.
| जगह | देखा हिस्सा − मूल मॉडल का पूर्वानुमान | देखा हिस्सा − लचीले मॉडल का पूर्वानुमान |
|---|---|---|
| स्थान 1 | 2.52 प्रतिशत अंक | -0.57 प्रतिशत अंक |
| स्थान 2 | 0.41 प्रतिशत अंक | -1.24 प्रतिशत अंक |
| स्थान 3 | -2.15 प्रतिशत अंक | 0.17 प्रतिशत अंक |
| स्थान 4 | -0.29 प्रतिशत अंक | 1.65 प्रतिशत अंक |
| स्थान 5 | -0.89 प्रतिशत अंक | 0.26 प्रतिशत अंक |
| स्थान 6 | -2.17 प्रतिशत अंक | -0.93 प्रतिशत अंक |
| स्थान 7 | -0.44 प्रतिशत अंक | 0.43 प्रतिशत अंक |
| स्थान 8 | -0.55 प्रतिशत अंक | -0.35 प्रतिशत अंक |
| स्थान 9 | 0.76 प्रतिशत अंक | 0.14 प्रतिशत अंक |
| स्थान 10 | 2.81 प्रतिशत अंक | 0.44 प्रतिशत अंक |
ये जगह की पंक्तियाँ वर्णनात्मक हैं, अलग सांख्यिकीय महत्व के दावे नहीं. प्रयोग ने आँखों की हरकत या ध्यान नहीं मापा और विश्लेषण नहीं पहचानता कि किसी जगह का परिणाम अलग क्यों है. देखे हिस्सों का घुमावदार पैटर्न अकेले मूल मॉडल को गलत भी नहीं साबित करता: मूल मॉडल में जगह का पद उसके मूल पसंद स्कोर में रैखिक है, चुनाव प्रतिशत में नहीं.
पहले और आखिरी देखे हिस्से केवल घटाने से अलग सवाल का जवाब मिलेगा. वे उत्पादों और कीमतों में चुनाव का सार हैं. दोनों फ़िट मॉडल 10 विकल्पों की संभावनाएँ देने से पहले किताब की पहचान और कीमत का हिसाब रखते हैं. न सिरों का अंतर, न मॉडल तुलना बताती है कि लाइव स्टोर में खास उत्पाद की जगह बदलने पर क्या होगा.
उत्पाद की जगह मापने का उपयोगी टेम्प्लेट
ऑफ़र की तुलना से पहले छोटा मापन ब्रीफ़ लिखें. नीचे का टेम्प्लेट बिना पंजीकरण है और समझाने के लिए है. वह धारणाएँ जाँचने की सीख लागू करता है; वही मॉडल आपके स्टोर के लिए सही होगा, यह वादा नहीं.
निर्णय: “हमें [पेज या अभियान] के लिए [अवधि] में [कौन-सी उत्पाद तुलना या प्रस्तुति में कौन-सा बदलाव] तय करना है.” सुविधाजनक माप चुनने से पहले निर्णय का नाम दें.
नतीजा: “हम [चयन, क्लिक, कार्ट में जोड़ना या खरीद] मापेंगे.” वही नतीजा चुनें जिसका रिकॉर्ड वास्तव में आधार देता है. दिए विकल्प, उनका क्रम और दिखाई कीमतें साथ रखें. चुनना अनिवार्य होने का परिणाम खरीद के परिणाम से अलग रहे.
इकाई: “हमारी इकाई [प्रतिभागी या दूसरी साफ़ परिभाषित इकाई] है. दोहराई विज़िट या सबमिशन [नियम] से सँभाले जाएँगे.” नए लोगों के पूर्वानुमान जाँचते समय एक ही व्यक्ति के अवलोकन साथ रखें. अनाम सेशन पहचानकर्ता को अलग व्यक्ति का प्रमाण न मानें.
तुलना: “दोनों मॉडलों में वही उत्पाद, कीमत की जानकारी और पात्र अवलोकन होंगे. फ़र्क [जगह की धारणा] में होगा.” सरल और अधिक लचीला, दोनों विकल्प बताएँ.
मूल्यांकन: “फ़िट करने से पहले [तय समूह] अलग रखेंगे और [नामित स्कोर माप] की तुलना करेंगे. सभी जगहें दिखाएँगे.” अनसुलझा या खराब परिणाम कैसे बताएँगे, यह उसे देखने से पहले तय करें.
इस्तेमाल: “यह परिणाम [मापन निर्णय] लेने में मदद करेगा. [व्यावसायिक निर्णय] से पहले [यहाँ न मापे गए व्यावसायिक नतीजे] का प्रमाण अब भी चाहिए.” अंतिम वाक्य पूर्वानुमान अभ्यास को चुपचाप राजस्व का पूर्वानुमान बनने से रोकता है.
एक ही प्रतिभागी को टेस्ट की 1 तरफ़ रखें
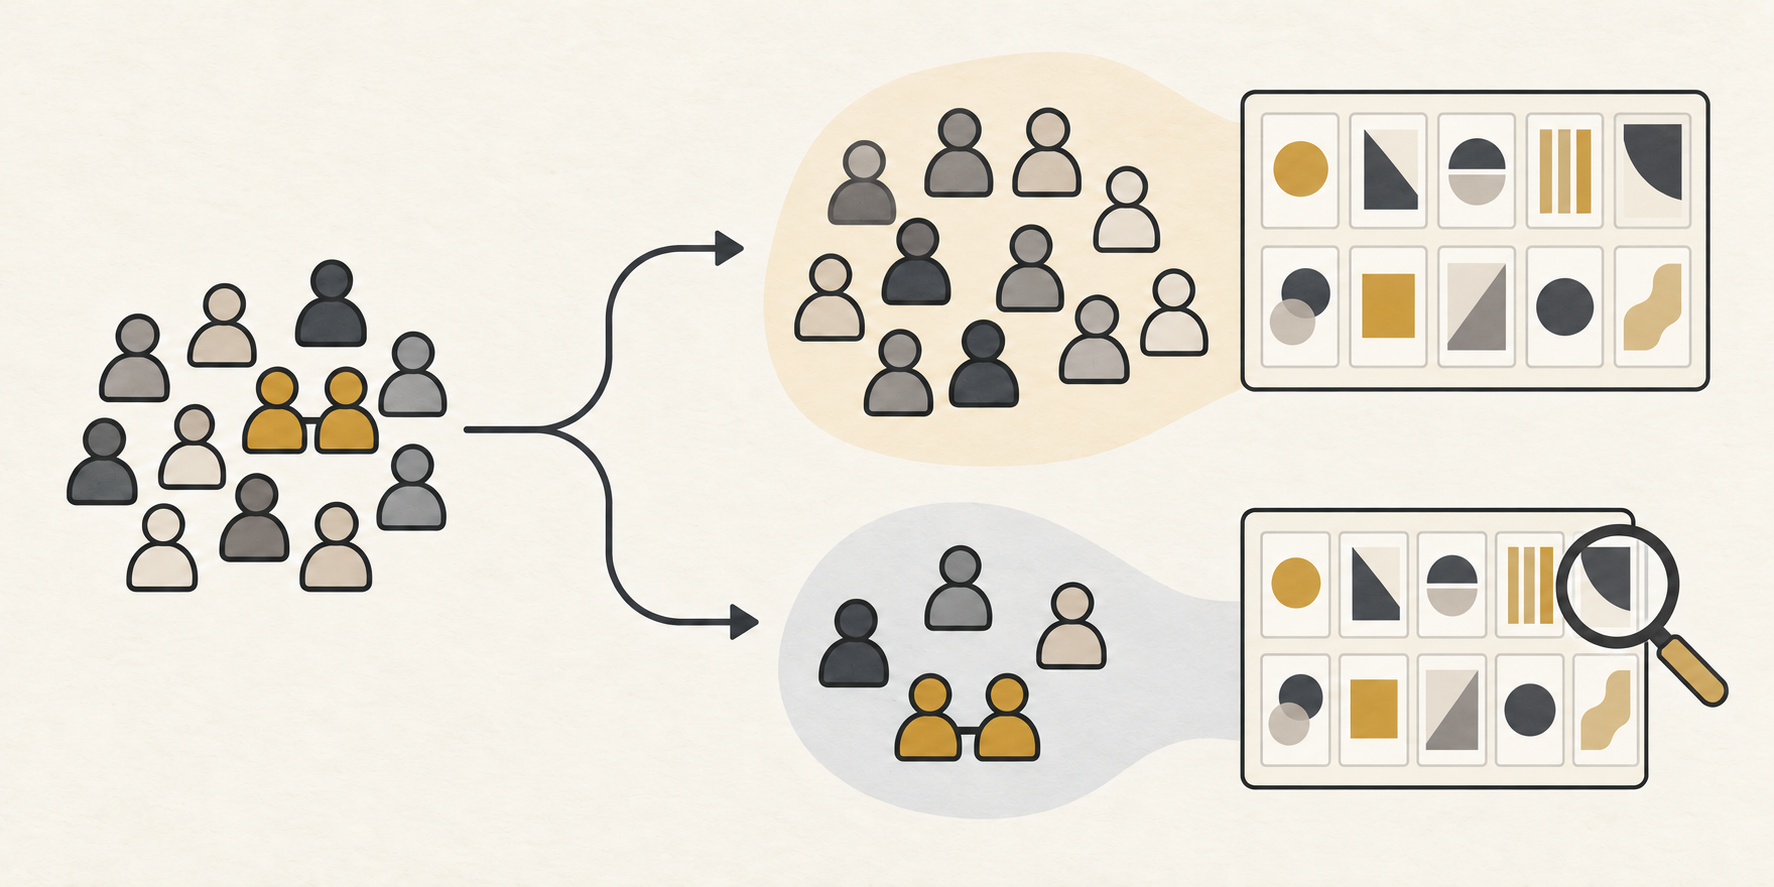
तुलना परिभाषित करें
उत्पाद, जगह, नतीजा और अवलोकन इकाई बताएँ.
मूल्यांकन समूह अलग रखें
हर प्रतिभागी के सबमिशन साथ रखें.
पूरा नतीजा जाँचें
पूर्वानुमानों की तुलना करें और हर जगह का नतीजा दिखाएँ, खराब नतीजों सहित.
समझाया गया उदाहरण: डिजिटल ऑफ़र की तुलना करता क्रिएटर
लेखन वर्कबुक, वर्कशॉप और बंडल बेचने वाला काल्पनिक क्रिएटर लें. बंडल लॉन्च पेज पर सबसे ऊपर है और सबसे अधिक क्लिक पाता है. क्रिएटर दूसरे उत्पादों के विवरण फिर लिखने पर विचार कर रहा है.
मापन ब्रीफ़ तत्काल सवाल बदलता है. देखा नतीजा क्लिक है, बिक्री नहीं. उपलब्ध रिकॉर्ड में कौन-से ऑफ़र, किस क्रम और किन कीमतों पर दिखे, यह होना चाहिए. बंडल हमेशा पहली जगह हो, तो रिकॉर्ड उस बंडल को उसकी जगह से साफ़ अलग नहीं कर सकते.
क्रिएटर का पूरा ब्रीफ़ कह सकता है: “हम जानना चाहते हैं कि जगह का हिसाब रखने का हमारा तरीका नए आगंतुकों के क्लिक का पूर्वानुमान लगाता है या नहीं. हम वही ऑफ़र और कीमत की जानकारी लेकर तुलना करेंगे, दोहराए अवलोकन साथ रखेंगे और सभी स्थानों की पूरी तुलना बताएँगे. क्लिक रिकॉर्ड से खरीद का दावा नहीं करेंगे.” यह मापन सवाल का काल्पनिक उदाहरण है, प्रस्तावित नतीजा नहीं.
अगला समझदारी भरा कदम ऐसी तुलना की योजना बनाना है जिसमें उत्पाद और उसकी जगह को अलग-अलग समझने के लिए पर्याप्त विविधता हो और नतीजे की परिभाषा वही रहे. फिर क्रिएटर अलग रखे समूह में जगह के सरल समायोजन की तुलना अधिक लचीले समायोजन से कर सकता है. यह उस पेज का नया अध्ययन होगा; किताब का प्रयोग उसकी अपेक्षित क्लिक दर नहीं देता.
लचीला तरीका अलग रखे समूह के क्लिक का बेहतर पूर्वानुमान लगाए, तो क्रिएटर को रिपोर्ट में जगह का हिसाब फिर देखने का कारण मिलता है. इससे फिर भी बंडल खिसकाने पर राजस्व बढ़ना नहीं दिखता. व्यावसायिक निर्णय के लिए वास्तविक प्रस्तुति बदलाव और कारोबार के ज़रूरी नतीजे का प्रमाण चाहिए.
तुलना अनसुलझी हो, तो क्रिएटर यही बताए. अधिक लचीलापन अपने आप बेहतर व्यावसायिक उपकरण नहीं. व्यावहारिक लाभ अधिक साफ़ क्रम है: समझें कि रिकॉर्ड क्या अलग कर सकते हैं, मापन की धारणा जाँचें, फिर तय करें कि दूसरा प्रयोग चाहिए या नहीं.
Influence IQ ने तुलना कैसे निकाली?
हमने लेखकों की संपादित जवाब रिलीज़ और मूल चयन नियम लिए. शुरुआती 553 पायलट या टेस्ट रिकॉर्ड फ़ाइल की तय जगह के आधार पर बाहर हैं. बाकी दायरे में 10,775 सबमिशन हैं. समझ की जाँच वाले फ़िल्टर से 9,344 और पूरा करने के फ़िल्टर से 9,265 बचते हैं.[2]
सहमति, पूरा होने की स्थिति और कम से कम 60-सेकंड की अवधि के नियम अपने-अपने कदम पर कोई और सबमिशन नहीं हटाते. पूरा होने और अवधि के फ़िल्टर प्रयोग देखने के बाद के हैं, इसलिए बचा समूह चुना नमूना है.
Prolific प्रतिभागी ID समूह तय करते हैं. निश्चित हैश बँटवारा चुनावों का इस्तेमाल किए बिना 2/3 समूह ट्रेनिंग और बाकी टेस्ट को देता है. हर समूह के भीतर पहले काम के सभी रखे सबमिशन उस व्यक्ति के योगदान में बराबर हिस्सा लेते हैं. फ़िटिंग, स्कोर और स्थान की तालिकाओं में यही भार हैं.[3]
दोनों मॉडल बिना पेनल्टी के बहुश्रेणी लॉजिट हैं, जिनमें किताबों के 9 संकेतक और कीमत का 1 रैखिक पद शामिल हैं. मूल मॉडल जगह का 1 रैखिक पद जोड़ता है, जिससे कुल 11 पैरामीटर होते हैं. लचीला मॉडल स्थान के 9 संकेतक जोड़ता है, जिससे कुल 19 पैरामीटर होते हैं. स्थान 1 और संख्यात्मक रूप से सबसे छोटा उत्पाद ID संदर्भ श्रेणियाँ हैं. सभी पात्र चुनाव सेट में वही 10 उत्पाद हैं और चुना ID, कीमत तथा जगह मिलाकर जाँचे गए हैं.
हम ट्रेनिंग समूह में मॉडल फ़िट करते हैं, फ़िट गुणांक रखते हैं, फिर टेस्ट चुनावों को स्कोर देते हैं. अंतराल हर प्रतिभागी के लिए दोनों मॉडलों के स्कोर का अंतर लेकर निकाला जाता है. इसमें इन अंतरों का मानक विचलन, 3,088 प्रतिभागी इकाइयाँ और स्वतंत्रता की 3,087 डिग्रियाँ इस्तेमाल होती हैं. यह लगभग Student-t अंतराल है; केवल उसकी सटीक नॉर्मल-स्कोर धारणाओं पर ही सटीक है. सभी 10 जगह की तुलनाएँ वर्णनात्मक रहती हैं.[4]
मूल मॉडल के मुख्य ऑप्टिमाइज़र ने संख्यात्मक चेतावनी दी. फिर भी उसने फ़िटिंग से पहले तय हर सटीकता शर्त पूरी की, जिसमें दूसरी शुरुआती स्थिति से तुलना भी है. हमने वही मूल फ़िट रखा; पुनर्गणना सामग्री में विस्तृत जाँच विवरण हैं.[5]
डाउनलोड में दिखाए परिणाम, मूल विश्लेषण कोड और समेकित संख्यात्मक आउटपुट हैं. स्रोत की जवाब पंक्तियाँ, प्रतिभागी ID और किताब के चित्र शामिल नहीं. स्रोत डेटा लेखकों की रिलीज़ से अलग लें. इस पुनर्विश्लेषण और उसकी व्याख्या की ज़िम्मेदारी Influence IQ की है.
CSV इस पेज की भाषा में है. पैकेज में मूल गणना कोड, विधि के अनुवादित दस्तावेज़ और समेकित परिणाम हैं. स्रोत की जवाब पंक्तियाँ और किताब के एसेट शामिल नहीं हैं; डेटा लेखकों की रिलीज़ से अलग लें.
स्रोत और नोट्स
- Compiani, Morozov और Seiler, Demand Estimation with Text and Image Data, पांडुलिपि संस्करण 4, 17 फ़रवरी 2026, खंड 3 और परिशिष्ट C. लेखक क्रम और कीमत के प्रति प्रतिक्रियाएँ पहले से देखते हैं. हमारी अलग रखे प्रतिभागियों की तुलना मौलिक और अधिक सीमित पुनर्विश्लेषण है.
- लेखकों की DeepLogitReplication रिलीज़, कमिट 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec पर. हम संपादित जवाब फ़ाइल के पायलट रिकॉर्ड के मूल क्रम वाले कटऑफ़ और लेखकों के पात्रता नियम लेते हैं. रखे स्रोत की तारीख़ें 11–26 जून 2024 हैं, पांडुलिपि के 14–27 जून विवरण से अलग; तारीख़ें शामिल करना तय नहीं करतीं.
- Prolific प्रतिभागी ID को अध्ययन या सबमिशन पहचानकर्ता से अलग रखता है. समूहों के लिए हम सटीक प्रतिभागी ID रखते हैं. ये ID अलग से हर ID का अलग व्यक्ति होना या रखे सबमिशन का उस व्यक्ति के लिए पहला परिचय होना सत्यापित नहीं करते.
- Influence IQ की पहले से तय तुलना हर टेस्ट प्रतिभागी के भीतर लचीले मॉडल की लॉग संभावना में से मूल मॉडल की लॉग संभावना घटाने का औसत, फिर प्रतिभागियों के बीच औसत निकालती है. 95% अंतराल के लिए प्रतिभागी मानक विचलन को 3,088 के वर्गमूल से भाग देकर Student-t क्रिटिकल मान से गुणा किया जाता है, फिर वह मान औसत में जोड़ा और घटाया जाता है. वह स्वतंत्र प्रतिभागी समूह मानता है, स्थिर ट्रेनिंग फ़िट की शर्त लेता है और ट्रेनिंग-फ़िट अनिश्चितता छोड़ता है; सटीकता के लिए समान वितरण, नॉर्मल प्रतिभागी अंतर और समान विचरण ज़रूरी हैं.
- मूल मॉडल को 0 से शुरू करके फ़िट करने पर सटीकता की चेतावनी मिली. अधिकतम निरपेक्ष औसत ग्रेडिएंट 3.12×10⁻⁹, Newton decrement 2.50×10⁻⁸ और 2 शुरुआती स्थितियों की लॉग-सम्भावनाओं का अधिकतम फ़र्क 7.46×10⁻⁸ था, जो तय सीमाओं 10⁻⁸, 10⁻⁶ और 10⁻⁷ से नीचे हैं. दोनों मॉडलों ने धनात्मक वक्रता और उद्देश्य मान के मेल की शर्तें भी पूरी कीं. 0 से शुरू किए गए मुख्य फ़िट के गुणांक रखे गए.
मूल लेख अंग्रेज़ी में है. हर भाषा का संस्करण उसी ऐतिहासिक प्रयोग का है; ये देश-विशेष खरीदारी के अनुमान नहीं.