पहले उत्पाद से आगे ई-कॉमर्स ग्राहक यात्रा को पढ़ना
किताबों के ऑनलाइन स्टोर का ऐतिहासिक प्रयोग दिखाता है कि पहला उत्पाद अलग होने और चुने उत्पाद का रिकॉर्ड न होने की अलग व्याख्या क्यों चाहिए.
Ilya Morozov और Anna Tuchman के 2022 के अमेरिकी MTurk किताब स्टोर प्रयोग के सार्वजनिक डेटा का मौलिक विश्लेषण. किताब चुनने के बताए जवाब, पूरी हुई खरीद नहीं.
सार
पहला दर्ज उत्पाद चुनी चीज़ से अलग हो, तो भी घटना इतिहास में दोनों हो सकते हैं. 2022 के प्रोत्साहन वाले किताब स्टोर प्रयोग के हमारे विश्लेषण में, जिन 3,165 प्रतिभागियों का पहला दर्ज उत्पाद उनके बताए किताब चयन से अलग था, उनमें से 3,048 के मैप किए पेज इवेंट में चुनी किताब कहीं मौजूद थी: 96.3%. सभी 11,460 विश्लेषित प्रतिभागियों में 72.4% का पहला उत्पाद मेल खाता था, 26.6% का पहला उत्पाद अलग था लेकिन चुनी किताब दर्ज थी और 1.0% की चुनी किताब का मैप किया रिकॉर्ड नहीं था.
प्रयोग में अमेरिकी MTurk प्रतिभागी 100 ई-बुक में से चुनते थे. पहला दर्ज इवेंट इस बात का प्रमाण नहीं है कि उसी उत्पाद पर सबसे पहले ध्यान गया था या वह घटना चयन से पहले हुई थी; और बताया गया चयन पूरी हुई खरीद नहीं है. यह परिणाम कारोबार और क्रिएटर को ग्राहक के चुनाव का कारण समझाने से पहले उत्पाद इतिहास में दर्ज जानकारी पहचानने में मदद करता है. यह रिकॉर्ड अधिक सटीक पढ़ने का आधार है, स्टोर का कन्वर्ज़न मानक या विज्ञापन प्रभाव का अनुमान नहीं.
ग्राहक यात्रा रिपोर्ट पहले एक उत्पाद और चयन में दूसरा बताती है. उस जोड़ी से पूरी कहानी बना लेना आसान है: पहले उत्पाद ने बिक्री खोई, बेहतर विकल्प दिखाया या गलत व्यक्ति को स्टोर तक लाया. अकेली जोड़ी इनमें से कोई व्याख्या तय नहीं कर सकती.
पहले अधिक सरल सवाल है: विश्लेषित उत्पाद रिकॉर्ड में चुनी चीज़ कहीं आती है या नहीं? इससे दोनों उत्पाद वाले इतिहास और चयन का पहचाने जाने योग्य रिकॉर्ड न होने वाले इतिहास अलग होते हैं. यह फ़र्क बड़े कैटलॉग वाले कारोबार और कुछ उत्पाद बेचने वाले क्रिएटर, दोनों के लिए उपयोगी है.
हमने असामान्य रूप से विस्तृत सार्वजनिक किताब स्टोर डेटासेट में यह सवाल जाँचा. मुख्य निष्कर्ष है कि पहले उत्पाद के ज़्यादातर बेमेल मामलों में चुनी किताब का पहचाने जाने योग्य रिकॉर्ड अब भी है. उस रिकॉर्ड के बिना छोटे समूह को अलग व्याख्या चाहिए और डेटा उसका कुछ हिस्सा खुला छोड़ता है.
उत्पाद रिकॉर्ड और चुनी किताब अलग प्रमाण हैं
- रिकॉर्ड में मौजूद उत्पाद
- जिस किताब का चयन बताया गया
यह ई-कॉमर्स ग्राहक यात्रा अध्ययन क्या मापता है?
यह प्रतिभागी के रिकॉर्ड किए गए पेज इवेंट में पहले पहचाने जाने योग्य उत्पाद और उसके बताए किताब चयन का संबंध मापता है. हमने Ilya Morozov और Anna Tuchman के 2022 प्रयोग के 11,460 पात्र प्रतिभागियों का विश्लेषण किया. उनके ऑनलाइन किताब स्टोर में 100 ई-बुक थीं. प्रतिभागी अमेरिका में रहते थे और Amazon Mechanical Turk से भर्ती हुए थे.[1]
यह प्रोत्साहन वाला शोध काम था. प्रतिभागियों को किताब का $3 बजट मिला और किताब चुनना ज़रूरी था. स्टोर का काम पूरा करने के बाद उन्होंने अलग से अपनी पसंद बताई: यदि वे चुना गया विकल्प पाने की लॉटरी जीतें, तो उन्हें किताब के साथ बचा हुआ बजट चाहिए या पूरे $3 नकद. लॉटरी हर प्रतिभागी को पूर्ति का 50% मौका देती थी. हमारा परिणाम सर्वेक्षण में बताई किताब है, उस अलग पसंद या पूर्ति की जानकारी इस्तेमाल करने से पहले.[2]
हम उस बताए चयन को मेल की गई सर्वेक्षण अवधि में रिकॉर्ड किए उत्पाद पेज इवेंट से जोड़ते हैं. मैप किया इवेंट वह है जिसका लेबल प्रयोग के कैटलॉग की किताब से मिल सके. “पहला” उस अवधि का पहला स्पष्ट रिकॉर्ड किया उत्पाद इवेंट है. उससे सबसे पहले ध्यान में आए उत्पाद, जीवन में पहली बार देखने या निर्णय से पहले की घटना की पुष्टि नहीं होती. अवधि में चयन के बाद की घटनाएँ भी हो सकती हैं.
मूल पेपर ने विज्ञापन सामग्री और खोज का अध्ययन किया. हम प्रयोग की स्थितियाँ जोड़कर अलग वर्णनात्मक सवाल देखते हैं: पहला उत्पाद और चुनी किताब अलग हों, तो क्या किताब दर्ज रिकॉर्ड में कहीं और है? यह तुलना विज्ञापन प्रभाव नहीं आँकती या सामान्य स्टोर की कन्वर्ज़न दर नहीं बताती.
पहला उत्पाद और चयन साथ पढ़ने से क्या बदलता है?
विश्लेषित प्रतिभागियों में 72.4% का पहला उत्पाद मेल खाता है, लेकिन बाकी मामले 2 अलग स्थितियाँ बताते हैं. 26.6% में दूसरा उत्पाद पहले आता है और चुनी किताब भी मैप किए रिकॉर्ड में कहीं है. 1.0% में दूसरा उत्पाद पहले आता है और चुनी किताब उन रिकॉर्ड में नहीं है.
विश्लेषित किताब स्टोर प्रतिभागियों की 3 स्थितियाँ
पहला मैप किया उत्पाद बताए चयन से मिलता है या नहीं और चुनी किताब मैप किए रिकॉर्ड में कहीं है या नहीं.
| दर्ज चयन स्थिति | बताए समूह का हिस्सा | प्रतिभागी |
|---|---|---|
| पहला उत्पाद चुनी किताब से मेल खाता है | 72.4% | 8,295 |
| पहला उत्पाद अलग; चुनी किताब दर्ज है | 26.6% | 3,048 |
| पहला उत्पाद अलग; चुनी किताब दर्ज नहीं | 1.0% | 117 |
तालिका हर प्रतिभागी को 1 बार गिनती है. उसकी 3 पंक्तियों में क्रमशः 8,295, 3,048 और 117 लोग हैं और सभी पंक्तियों का हर समान है: 11,460. पहली 2 पंक्तियों में चुनी किताब का रिकॉर्ड है. फ़र्क केवल यह है कि क्या वह किताब पहला पहचाना उत्पाद भी है.
उत्पाद ट्रैफ़िक की समीक्षा करने वाले कारोबार के लिए फ़र्क अगला सवाल बदलता है. पहला उत्पाद अलग होने से अकेले अंतिम चयन का घटना इतिहास में गायब होना नहीं साबित होता. इसी तरह, मेल होने से यह नहीं दिखता कि पहला उत्पाद उस चुनाव का कारण था. व्यावसायिक व्याख्या जोड़ने से पहले तुलना बताती है कि जानकारी के 2 हिस्से कैसे मिलते हैं.
कई उत्पाद बेचने वाला क्रिएटर भी यही व्याख्या समस्या पाता है. व्यक्ति अभियान में एक चीज़ देखकर दूसरी चुन सकता है. उपयोगी रिपोर्ट संबंधित उत्पाद पहचान रखती है. हर बेमेल को खास निष्कर्ष के प्रमाण के बिना विफल उत्पाद पेज, सहायक बिक्री या खोया ग्राहक नहीं बनाना चाहिए.
क्या पहला उत्पाद अलग होने का मतलब आम तौर पर चुनी किताब का रिकॉर्ड न होना है?
नहीं. पहला दर्ज उत्पाद बताए चयन से अलग होने वाले 3,165 प्रतिभागियों में 3,048 के मैप किए पेज इवेंट में चुनी किताब कहीं थी. यह बेमेल समूह का 96.3% है. बाकी 117 प्रतिभागी समूह का 3.7% हैं.
अलग पहले उत्पाद के मामलों में 96.3% में चयन अब भी है
पहला उत्पाद बताए चयन से अलग होने वाले प्रतिभागियों के मैप किए रिकॉर्ड में चुनी किताब की मौजूदगी.
| मैप किए रिकॉर्ड में चुनी किताब | बताए समूह का हिस्सा | प्रतिभागी |
|---|---|---|
| चुनी किताब मैप किए रिकॉर्ड में है | 96.3% | 3,048 |
| चुनी किताब मैप किए रिकॉर्ड में नहीं है | 3.7% | 117 |
यह हर पिछली तालिका से छोटा है. 96.3% का आँकड़ा उन प्रतिभागियों के बारे में है जिनके पहले और चुने उत्पाद अलग हैं; यह सभी प्रतिभागियों, आगंतुकों या खरीदारों का प्रतिशत नहीं. इससे यह भी नहीं कहा जाता कि 96.3% ने दूसरा उत्पाद देखने के बाद खरीद पूरी की.
चुनी किताब की मौजूदगी रिकॉर्ड का उपयोगी प्रमाण है, भले निर्णय के मुकाबले उसका समय अनसुलझा हो. इससे पता चलता है कि इतिहास को पहले उत्पाद तक समेटने पर ज़्यादातर बेमेल मामलों में चयन से पहचाना संबंध छूटता है. अधिक पूरा रिकॉर्ड उस स्थिति को ऐसा संबंध न दिखने वाली स्थिति से अलग कर सकता है.
इससे विश्लेषण में दूसरा खाना रखने का कारण मिलता है: तय घटना अवधि में चुनी चीज़ कहीं है या नहीं. इससे पहले के उत्पादों को राजस्व का श्रेय देने का कारण नहीं मिलता. भरोसेमंद लेन-देन समय वाला स्टोर खरीद से पहले की घटनाओं का अलग सवाल पूछ सकता है, लेकिन इस प्रयोग की मिली सर्वेक्षण अवधियाँ वह सत्यापित कटऑफ़ नहीं देतीं.
दर्ज उत्पादों की संख्या तस्वीर क्यों बदलती है?
कुल पहले-उत्पाद मेल में 2 बहुत अलग रिकॉर्ड इतिहास जुड़े हैं. 1 अलग मैप किए उत्पाद वाले 7,656 प्रतिभागियों में 99.5% ने वही उत्पाद चुनना बताया. 2 या अधिक अलग मैप किए उत्पाद वाले 3,804 में 17.8% ने पहले दर्ज उत्पाद को चुना.
मैप किए उत्पादों की संख्या के अनुसार पहले उत्पाद का मेल अलग है
1 अलग मैप किया उत्पाद या 2 या अधिक वाले इतिहास में चयन की 3 स्थितियाँ.
| अलग मैप किए उत्पाद | पहला उत्पाद चयन से मेल खाता है | पहला उत्पाद अलग; चयन दर्ज है | पहला उत्पाद अलग; चयन दर्ज नहीं | समूह का आकार |
|---|---|---|---|---|
| 1 मैप किया उत्पाद | 99.5% | 0.0%इस खाने में 30 से कम प्रतिभागीपरिभाषाओं से अनिवार्य 0 | 0.5% | 7,656 |
| 2 या अधिक मैप किए उत्पाद | 17.8% | 80.1% | 2.1% | 3,804 |
1-उत्पाद समूह सावधानी से समझें. उसका इकलौता मैप किया उत्पाद चयन से अलग हो, तो चयन उसी मैप किए समूह में भी नहीं हो सकता. इसलिए बीच का खाना परिभाषा से ठीक 0 है. यह उस समूह के लोगों का विकल्पों पर कभी विचार न करना साबित नहीं करता और ऊँची मेल दर निर्णायक खरीदारों की अलग खोज नहीं है.
2 या अधिक मैप किए उत्पाद वाले समूह के 80.1% का पहला उत्पाद अलग है, जबकि चुनी किताब रिकॉर्ड में कहीं और है. अन्य 2.1% की चुनी किताब का मैप किया इवेंट नहीं है. ये हिस्से समूह में दर्ज उत्पादों की पहचान बताते हैं, ब्राउज़िंग से खरीद का क्रम नहीं.
रिपोर्ट की सीख है कि मुख्य मेल दर के साथ उत्पादों की विविधता भी दिखाएँ. 1-उत्पाद इतिहास से भरी रिपोर्ट कई उत्पाद इतिहास वाली रिपोर्ट से अलग वर्णनात्मक सवाल का जवाब देती है. इस अध्ययन में विविधता अवलोकन पर है और कुछ हिस्सा परिभाषाओं से ही जुड़ा है. अधिक उत्पाद दर्ज होने को व्यक्ति का चयन बदलने का कारण नहीं कह सकते.
चुनी किताब के गायब रिकॉर्ड को कैसे समझें?
चुनी किताब का मैप किया रिकॉर्ड न होने वाले 117 प्रतिभागी पूरी तरह समझी जा चुकी एक ही श्रेणी नहीं बनाते. उनमें से 89 की अवधि में कम से कम 1 ऐसा पेज इवेंट भी है जिसका लेबल खाली था या जिसे किसी उत्पाद से नहीं मिलाया जा सका था. बाकी 28 का ऐसा रखा हुआ इवेंट नहीं है.
ज़्यादातर गायब चयन के साथ अज्ञात इवेंट भी है
चुनी किताब का मैप किया रिकॉर्ड न होने वाले प्रतिभागियों के इस्तेमाल न हो सकने वाले पेज इवेंट लेबल.
| उत्पाद से न मिल सकने वाले या खाली पेज इवेंट लेबल | बताए समूह का हिस्सा | प्रतिभागी |
|---|---|---|
| उत्पाद से न मिल सकने वाले या खाली लेबल वाला कोई बचा इवेंट नहीं | 23.9%इस खाने में 30 से कम प्रतिभागी | 28इस खाने में 30 से कम प्रतिभागी |
| उत्पाद से न मिल सकने वाले या खाली लेबल वाला कम से कम 1 बचा इवेंट | 76.1% | 89 |
वे 89 मामले चयन दर्ज न होने वाले समूह के 76.1% हैं. अज्ञात इवेंट गायब संबंध के लिए मायने रख सकता है, लेकिन उसका लेबल नहीं बताता कि वह कौन-सी किताब है. वह सत्यापित उत्पाद व्यू नहीं और केवल कहानी पूरी करने के लिए हम उसमें चुनी किताब नहीं भरते.
बाकी 28 मामले भी कम गिनती के फ़्लैग के साथ अलग रखना उपयोगी है. विश्लेषण में कोई अज्ञात इवेंट न बचना यह साबित नहीं करता कि दर्ज इतिहास में व्यक्ति की हर गतिविधि है. सूची से चयन, न देखी गतिविधि और शोध काम का डिज़ाइन संभव कारण रहते हैं. डेटा नहीं तय करता कि कौन-सा लागू है.
एजेंसी या स्टोर मालिक के लिए ये श्रेणियाँ उपलब्ध प्रमाण के अलग सवाल देती हैं. एक मौजूद लेकिन उत्पाद से न मिल सकने वाले रिकॉर्ड का है. दूसरा बाकी तरह से पहचाने रिकॉर्ड से गायब चुनी चीज़ का. कोई भी क्लाइंट से यह कहने का आधार नहीं कि खास उत्पाद पेज छोड़ा गया या ट्रैकिंग निश्चित रूप से विफल हुई.
हस्तशिल्पकार के काल्पनिक स्टोर का उदाहरण: 3 रिकॉर्ड, 3 व्याख्याएँ
कल्पना करें कि सिरेमिक क्रिएटर मग, कटोरा और फूलदान बेचता है. नीचे के उदाहरण तुलना समझाने के लिए गढ़े हैं; किताब स्टोर अध्ययन के ग्राहक या नतीजे नहीं. मान लें निर्माता ने चुना उत्पाद अलग से सत्यापित किया है और समीक्षा की घटना अवधि तय की है.
पहले उदाहरण में मग पहला दर्ज उत्पाद है और व्यक्ति मग चुनता है. पहला उत्पाद और चयन मेल खाते हैं. सिर्फ़ इस मेल से चुनाव का कारण तय नहीं होता: उत्पाद का आकर्षण, पिछली सिफ़ारिश और पुरानी जानकारी, सबको दूसरे प्रमाण चाहिए.
दूसरे उदाहरण में मग पहले आता है, कटोरा भी अवधि में आता है और व्यक्ति कटोरा चुनता है. पहला उत्पाद अलग है, लेकिन चुनी चीज़ मौजूद है. इसे केवल मग की विफल विज़िट कहना रिकॉर्ड की जानकारी छोड़ देगा. मग को कटोरे का प्रभावी परिचय कहना ऐसा कारण जोड़ देगा जो तुलना ने जाँचा नहीं.
तीसरे उदाहरण में मग और फूलदान मैप किए रिकॉर्ड में हैं, लेकिन बताया चयन कटोरा है. चयन मैप किए समूह से गायब है. किसी और इवेंट का उत्पाद लेबल इस्तेमाल योग्य न हो, तो पहचान का अनुमान लगाए बिना वह तथ्य रखें. ऐसा इवेंट नहीं है, तो गायब संबंध अनसुलझा छोड़ें.
उत्पाद रिकॉर्ड और चयन के मेल की 3 स्थितियाँ
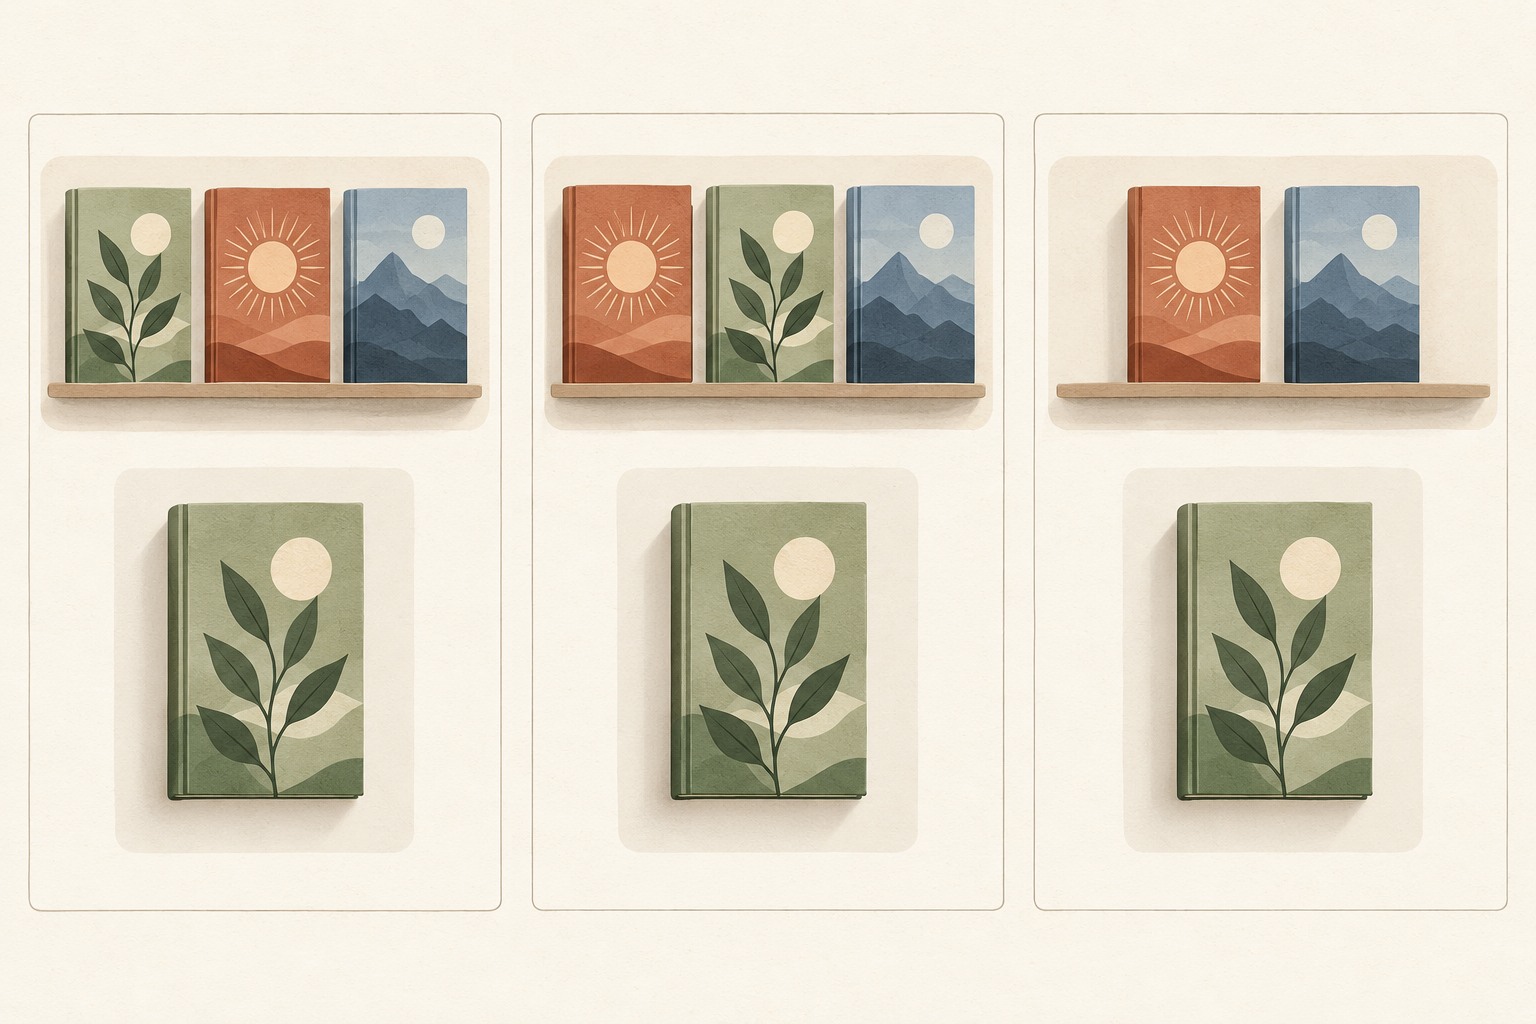
पहला उत्पाद मेल खाता है
पहला दर्ज उत्पाद और बताया चयन एक ही चीज़ हैं.
पहला उत्पाद अलग; चयन दर्ज है
चुनी चीज़ मैप किए रिकॉर्ड में है, हालाँकि दूसरा उत्पाद पहले है.
पहला उत्पाद अलग; चयन गायब है
चुनी चीज़ मैप किए रिकॉर्ड में नहीं मिलती. उसका न होना कारण नहीं बताता.
व्यावहारिक निर्णय यह है कि अभियान या उत्पाद पेज बदलने से पहले कौन-सा प्रमाण माँगें. मेल सीधे बताया जा सकता है. अलग पहले उत्पाद के साथ चयन मौजूद होने की अलग श्रेणी हो. चुनी चीज़ का रिकॉर्ड गायब हो, तो ग्राहक व्यवहार पर निष्कर्ष से पहले घटना और चयन की परिभाषा जाँचें. 3 में से कोई उदाहरण अकेले अभियान बजट बढ़ाने या घटाने का कारण नहीं देता.
उत्पाद यात्रा रिपोर्ट में क्या स्पष्ट होना चाहिए?
छोटा ब्रीफ़ ग्राहक यात्रा की चर्चा अधिक सटीक कर सकता है. व्यावसायिक सवाल से शुरू करें: इतिहास में कौन-से उत्पाद हैं, चुनी चीज़ मौजूद है या सत्यापित खरीद से पहले क्या हुआ, इनमें से क्या जाँच रहे हैं? इन सवालों को अलग प्रमाण चाहिए. देखे संबंध को बाद में उसे समझाने के प्रयोग से अलग रखें.
नतीजा: चयन या खरीद स्थापित करने वाली घटना या जवाब बताएँ. जानकारी वही हो, तो “बताया चयन” लिखें. लेन-देन विश्लेषण में हर खरीद इवेंट पूरा ऑर्डर मानने के बजाय बताएँ कि रद्दीकरण, रिफ़ंड और दोहराए लेन-देन रिकॉर्ड कैसे सँभालते हैं.
अवलोकन अवधि: इतिहास की शुरुआत और अंत, उसकी घड़ी और नतीजे के बाद गतिविधि हटती है या नहीं, बताएँ. निर्णय का सत्यापित समय न हो, तो अवधि को उस निर्णय तक का रास्ता न कहें. क्रम गढ़ने के बजाय एक ही समय वाले अस्पष्ट इवेंट रखें.
उत्पाद पहचान: बताएँ कि रिकॉर्ड में वही उत्पाद कैसे पहचानते हैं और वेरिएंट कैसे सँभालते हैं. खाली या उत्पाद से न मिल सकने वाले पहचानकर्ता हिसाब में दिखते रहें. कैटलॉग से न मिल सकने वाली पंक्ति कभी न देखे गए उत्पाद इवेंट से अलग है.
हर: पात्र समूह, पहले-उत्पाद मेल की स्थितियाँ और किसी शर्त-आधारित प्रतिशत का छोटा समूह दिखाएँ. कम गिनती रखें और परिभाषा से अनिवार्य शून्य समझाएँ. इससे पाठक बड़े पैटर्न और छोटे अपवाद के प्रतिशत में फ़र्क कर सकता है.
आधुनिक GA4 कार्यान्वयन के लिए Google items ऐरे के साथ अलग view_item और purchase इवेंट बताता है. हर आइटम में item_id या item_name ज़रूरी है; Google दोनों सुझाता है. एक जैसे उत्पाद पहचानकर्ता आइटम स्तर की तुलना समझना आसान करते हैं. यह मौजूदा कार्यान्वयन मार्गदर्शन है, ऐतिहासिक प्रयोग के कस्टम पेज इवेंट से अलग, और सहमति या श्रेय-निर्धारण सेटिंग बदलने की सिफ़ारिश नहीं.[5]
विश्लेषण कैसे बनाया और जाँचा गया?
हमने खास रिपॉज़िटरी संशोधन पर स्थिर लेखकों का सार्वजनिक पुनर्गणना डेटा इस्तेमाल किया. विश्लेषण 19 मई से 3 अगस्त 2022 के स्रोत के 2 चरणों का है और उनके बीच का विराम रखता है. हमने पहले-उत्पाद और चुनी-किताब के संयोजन निकालने से पहले जोड़ने और कवरेज के नियम तय किए, फिर संयुक्त परिणाम पढ़ने से पहले नतीजे का प्रोटोकॉल तय किया.[3]
स्रोत में दोहराई कोशिशों सहित 24,930 सर्वेक्षण पंक्तियाँ हैं. प्रीव्यू, समझ, स्रोत तारीख़ और पूरा करने के इतिहास के तय बहिष्कार के बाद जोड़ने के लिए 18,373 कोशिशें बचीं. मिलान नियमों ने केवल एक संभव मिलान वाली 12,813 कोशिशें चुनीं; 11,606 में किताब के चयन का इस्तेमाल योग्य जवाब था. स्पष्ट पहला मैप किया उत्पाद ज़रूरी करने पर 11,460 विश्लेषित प्रतिभागी बचे. ये अलग चरण हैं, एक-दूसरे की जगह लेने वाले नमूना आकार नहीं.
जोड़ने में कूपन कोड, क्लाइंट पहचानकर्ता और सर्वेक्षण समय लगते हैं. साझा या अस्पष्ट मिलान बाहर हैं और बाद की कोशिश केवल सुविधाजनक नतीजे के कारण नहीं ली जाती. उत्पाद तुलना में हम केवल स्रोत का सटीक Page View - Custom इवेंट प्रकार रखते हैं. सबसे शुरुआती इवेंट में उत्पादों की पहचान आपस में टकराए, या पहले मैप किए उत्पाद से पहले या उसी समय अज्ञात इवेंट हों, तो पहला उत्पाद तय नहीं हो सकता; ऐसे मामले बाहर रखे जाते हैं.[4]
सभी अनुमान इस विश्लेषित समूह का बिना भार का वर्णन हैं. इस शोध काम में स्वेच्छा से भाग लेने वालों के नमूने के लिए हम आबादी के विश्वास अंतराल नहीं निकालते. 30 से कम प्रतिभागियों वाले खानों को फ़्लैग किया गया है; डाउनलोड में 30 से छोटे हर वाले शर्त-आधारित प्रतिशत छिपाए गए हैं. परिभाषा से बना शून्य अलग पहचाना गया है.
पहले से तय जाँच में चयन स्थितियाँ
स्रोत चरण, कूपन से पहचाने सीमित बिना-विज्ञापन समूह और सर्वेक्षण अवधि की वैकल्पिक सीमाओं के अलग परिणाम.
| विश्लेषण समूह या अवधि नियम | पहला उत्पाद चयन से मेल खाता है | पहला उत्पाद अलग; चयन दर्ज है | पहला उत्पाद अलग; चयन दर्ज नहीं | समूह का आकार |
|---|---|---|---|---|
| मेल की गई सर्वेक्षण अवधि: सभी स्थितियाँ | 72.4% | 26.6% | 1.0% | 11,460 |
| चरण 1 | 70.6% | 28.3% | 1.0% | 6,468 |
| चरण 2 | 74.6% | 24.3% | 1.0% | 4,992 |
| 0 से शुरू होने वाला 7-कैरेक्टर का कूपन | 74.0% | 25.5% | 0.5%इस खाने में 30 से कम प्रतिभागी | 192 |
| दोनों सिरों पर 59 सेकंड बढ़ाई अवधि | 72.4% | 26.6% | 1.0% | 11,437 |
| दोनों सिरों पर 59 सेकंड घटाई अवधि | 72.0% | 26.9% | 1.1% | 11,292 |
तालिका दोनों चरण, कूपन से पहचाना सीमित बिना-विज्ञापन उपसमूह और 2 वैकल्पिक अवधि परिभाषाएँ बताती है. पहले-उत्पाद का मेल चरण 1 में 70.6% और चरण 2 में 74.6% है. कूपन उपसमूह में 192 प्रतिभागी हैं और चयन दर्ज न होने का केवल 1 मामला है. उसका छोटा अपवाद विज्ञापन के बारे में किसी ठोस दावे का आधार नहीं बन सकता और कोड प्रयोग के लिए तय की गई स्थिति बताता है, विज्ञापन देखे जाने की पुष्टि नहीं करता.
हर अवधि को दोनों सिरों पर 59 सेकंड बढ़ाने और 59 सेकंड घटाने पर पूरी मिलान प्रक्रिया फिर चलती है. नए समूहों में 11,437 और 11,292 प्रतिभागी हैं. उनके पहले-उत्पाद मेल क्रमशः 72.4% और 72.0% हैं. मिलते कुल हिस्से चयन निर्णय का समय स्थापित नहीं करते; ये जाँचें बताई अवधि सीमाओं की संवेदनशीलता परखती हैं.
डाउनलोड तालिकाएँ उसी मूल समूह के प्रतिभागियों पर तुलना, हर अवधि नियम के तहत जोड़े और हटाए लोग तथा पूरी संयुक्त गिनती भी रखती हैं. पुनर्गणना पैकेज में कोड, तय प्रोटोकॉल, स्रोत सूची, समेकित आउटपुट और README निर्देश हैं. प्रतिभागी पहचानकर्ता या कच्चे रिकॉर्ड नहीं हैं. गणना और व्याख्या Influence IQ की हैं; वे मूल पेपर के विज्ञापन विश्लेषण की जगह नहीं लेतीं.[6]
- चयन की स्थितियाँ, गिनती और संवेदनशीलता तालिकाएँ डाउनलोड करें (CSV)
- कोड, प्रोटोकॉल और पुनर्गणना निर्देश डाउनलोड करें (ZIP)
CSV में स्पष्ट हर, कम गिनती के फ़्लैग और परिभाषा से बने शून्य वाली समेकित तालिकाएँ हैं. ZIP में कोड, स्थिर प्रोटोकॉल, उत्पत्ति विवरण, समेकित परिणाम, स्रोत सूची और README निर्देश हैं. कच्चे प्रतिभागी रिकॉर्ड या पहचानकर्ता नहीं हैं. CSV के संख्यात्मक खाने दशमलव बिंदु लेते हैं. स्रोत डेटा: Morozov और Tuchman; गणना Influence IQ की.
स्रोत और नोट्स
- Ilya Morozov और Anna Tuchman, “Where Does Advertising Content Lead You? We Created a Bookstore to Find Out,” Marketing Science 43(5), 2024, पृष्ठ 986–1001. मूल अध्ययन विज्ञापन सामग्री और खोज देखता है. Influence IQ का रिकॉर्ड-स्थिति विश्लेषण प्रयोग की स्थितियाँ जोड़ता है और हस्तक्षेप प्रभाव का दावा नहीं करता.
- लेखकों की पांडुलिपि अमेरिकी MTurk भर्ती, 100-ई-बुक स्टोर, $3 बजट और 50% पूर्ति लॉटरी बताती है. प्रतिभागियों को किताब और बचा बजट बनाम नकद की अलग पसंद बताने से पहले किताब चुननी थी. हमारा चुनी-किताब चर केवल कैटलॉग से मिले सर्वेक्षण q66 जवाब से है. उसमें चेकआउट, पूर्ति, रिडेम्प्शन या बाद की नकद पसंद को एक ही नतीजा नहीं माना गया है.
- स्रोत रिपॉज़िटरी संशोधन b9f5c0293fc516949e9e2d294caaab57885614c7, 18 अक्टूबर 2026 को देखा गया. योजना में स्रोत विवरण और मूल प्रकाशित निष्कर्ष पहले से ज्ञात थे; नतीजे का प्रोटोकॉल तय करने से पहले कवरेज गिनती देखी गई. प्रोटोकॉल तय गणनाओं से पहले के हैं, बाहरी पूर्व-पंजीकरण या पूरी तरह जानकारी छिपी होने का दावा नहीं. पैकेज स्रोत हैश और स्कीमा स्पष्टीकरण का क्रम रखता है.
- दर्ज किया गया इवेंट लेबल Page View - Custom परिचालन माप है; सार्वजनिक फ़ाइलें पूरा पेज खुलना या ध्यान साबित नहीं करतीं. समय चिह्न दस्तावेज़ के स्रोत-घड़ी नियमों से समझे जाते हैं. उत्पाद पहचान दिए 100-आइटम कैटलॉग से है, नाम के अनुमान या चेकआउट के आधार पर बदलाव से नहीं. इस्तेमाल योग्य चयन वाली 11,606 जुड़ी कोशिशों में से 9 कोशिशों में कोई संभावित इवेंट नहीं था, 80 कोशिशों में केवल अज्ञात इवेंट थे, 53 कोशिशों में पहले मैप किए उत्पाद से पहले या उसी समय अज्ञात इवेंट था और 4 कोशिशों में सबसे पहले एक ही समय पर अलग उत्पाद दर्ज थे. इन कोशिशों को बाहर रखने पर 11,460 बचते हैं.
- Google Analytics, “Measure ecommerce,” 18 अक्टूबर 2026 को जाँचा. मौजूदा गाइड view_item और purchase अलग रखती है तथा items ऐरे में item_id और item_name बताती है. यह कार्यान्वयन संदर्भ स्रोत प्रयोग के 2022 कस्टम इवेंट डेटा से अलग है. समान पहचानकर्ता तुलना संभव करते हैं लेकिन अकेले संपूर्ण अवलोकन, पूर्ति या कारणात्मक श्रेय स्थापित नहीं करते.
- लेखकों का पुनर्गणना README उद्धरण के साथ अनुभवजन्य शोध के लिए प्रयोग के डेटा के पुनः इस्तेमाल का स्वागत करता है. यह कथन डेटा दोबारा इस्तेमाल की अनुमति देता है; स्रोत कोड GNU GPLv3 के तहत है. डाउनलोड होने वाला Influence IQ पैकेज लागू नोटिस और स्थिर इनपुट लेने के निर्देश देता है. वह प्रतिभागी स्तर के रिकॉर्ड के बजाय समेकित आँकड़े प्रकाशित करता है. अतिरिक्त गणना, व्याख्या और चित्र Influence IQ की ज़िम्मेदारी हैं; मूल शोधकर्ताओं के समर्थन का संकेत नहीं है.
मूल संस्करण अंग्रेज़ी में है. हर भाषा का संस्करण उसी 2022 अमेरिकी प्रयोग का है; ये अलग राष्ट्रीय अध्ययन नहीं हैं. विश्लेषण, व्याख्या और अनुवाद Influence IQ के हैं.