מדדו את משך הקריינות המתורגמת לפני נעילת העריכה
הקראה באנגלית יכולה להתאים למשך הסצנה, בעוד שהקלטת התרגום חורגת ממנו. ההשוואה המזווגת שערכנו ל-200 קטעי קריאה ממאגר מחקרי ממחישה מדוע צריך לצרף את משך הקריינות בשפות הנדרשות כשמעבירים את חומרי ההפקה, לפני נעילת התמונה.
ניתוח תיאורי של אורכי הקלטות שדווחו במטא-נתונים עבור 200 קטעים מתורגמים המשותפים ל-10 תצורות בקבוצת הבדיקה של FLEURS, מתוך מסגרת של 350 קטעים באנגלית. אלה קטעי הקראה למחקר, ולא עבודות קריינות מסחריות. המטא-נתונים התקבלו ב-24 באוקטובר 2026 (UTC).
תקציר
האם עסק צריך לנעול סרטון שהותאם לשפה אחרת לפי משך הקריינות באנגלית? מדדו קודם את ההקראות המתורגמות. השווינו אורכי הקלטות שדווחו במטא-נתונים עבור 200 קטעים הזמינים בכל 10 תצורות הבדיקה של FLEURS שנבחרו. כל קטע קיבל משקל שווה לאחר שההקראות החוזרות סוכמו לחציון בתוך הקטע. חציון השינוי בהשוואות המזווגות לאנגלית נע בין −6.1% בהקלטות בהולנדית לבין +82.4% בהקלטות בפיליפינית; אף אחד מהנתונים אינו כלל להקצאת זמן בהפקה שאפשר להחיל על שפה שלמה.[1][2]
דוגמה קבועה של 15 שניות הופכת את העברת העבודה לקונקרטית. מתוך 186 קטעים שהחציון שלהם באנגלית התאים למסגרת הזמן הזאת, 110 חציונים בפיליפינית חרגו ממנה. לפי כלל מחמיר יותר, כל הטייקים באנגלית שנצפו התאימו ב-178 קטעים, ואילו כל הטייקים בפיליפינית שנצפו חרגו ב-72. אי אפשר להפריד כאן בין מקריאים שונים, הרכב מגדרי, תרגום והפסקות. התרומה היא השוואת משכי הקלטות שאפשר לבדוק, עם כל 9 השוואות היעד ודוגמה אחת שנבחרה לפני שחושבו סיכומי משכי ההקלטות, כדי לסייע לצוותים לבקש הקראה שמדדו את משכה לפני שמתחייבים לעריכה.
לעורך יש סרטון מוצר קצר מוכן. הקריינות באנגלית מתאימה, חשיפת המוצר מופיעה בפריים המיועד ובשוט הסיום יש מקום להצעה. מגיע תסריט מתורגם עם אותו מסר. מפתה להתייחס להקלטה כאל הפריט האחרון שרק צריך להוסיף לציר זמן שכבר הושלם.
כאן פרט מידע חסר עלול להפוך לבעיית הפקה: איש לא מדד את משך ההקראה המתורגמת. תסריט שאושר מבחינת המשמעות אינו אומר לעורך כמה זמן יתפוס הביצוע המוקלט שלו. בהעברת חומרי העבודה צריך לכלול גם את הנוסח המאושר וגם את משך ההקלטה.
בדקנו את ההבחנה הזאת ב-FLEURS, קורפוס מחקרי של קטעי הקראה מתורגמים. ב-200 קטעי מקור תואמים, היחסים בין משכי ההקלטות השתנו גם בין תצורות וגם בין הקראות של אותו קטע. הטבלאות שלהלן משמרות את ההבדלים. הן נותנות לעסק או ליוצר תוכן סיבה לבקש נתוני משך מההפקה בפועל, בלי להפוך ממוצע מחקרי למרווח זמן מובטח.
תנו לכל גרסה מוקלטת משך משלה
השוו את אותו קטע לפני שתאמצו כלל למשך ההקלטה
הטבלה הראשונה משווה כל תצורת יעד לאנגלית אמריקאית באותם 200 קטעי מקור. לכל קטע ותצורה לקחנו את חציון אורכי ההקלטות הזמינות. לאחר מכן חילקנו את חציון היעד בחציון באנגלית והצגנו את ההפרש מ-1 באחוזים. לבסוף סיכמנו את 200 השינויים המזווגים. לכן כל קטע קיבל אותו משקל, בין אם היו לו 3 הקראות ובין אם 1.[2][4]
בהקלטות בספרדית לטינו-אמריקאית, חציון השינוי המזווג היה +24.8%. המחצית האמצעית של השינויים ברמת הקטע נעה מ-+10.2% עד +47.0%. ביפנית, החציון המקביל היה +36.6%, והמחצית האמצעית נעה מ-+17.8% עד +61.8%. אלה תיאורים של ההקלטות שפורסמו עבור קטעים תואמים; הם אינם קובעים איך צריך לבצע אף אחת מהשפות.
הדבר שונה מחלוקת 2 חציוני משך כוללים. באותם קטעים משותפים, חציון סיכומי הקטעים באנגלית היה 9.3 שניות, והנתון המקביל בספרדית היה 11.6 שניות. חלוקת המספרים המוצגים האלה לא תשחזר את התוצאה המזווגת +24.8%. התאמנו קודם כל קטע למקבילו, כך שההשוואה מצמידה קטע יעד קצר לנקודת הייחוס שלו באנגלית, ולא לקטע אחר שנמצא קרוב לאמצע ההתפלגות.
להקלטות בהולנדית היה חציון שינוי מזווג של −6.1%, ואילו להקלטות בפיליפינית היה +82.4%. השארת שני הנתונים בטבלה מבליטה את טווח היחסים שנצפו. היא גם מונעת מהמאמר לרמוז שכל הקלטה מתורגמת הייתה ארוכה יותר. בקבוצה המשותפת, 71 חציוני קטעים בהולנדית היו ארוכים מהמקבילים באנגלית, 2 היו שווים והשאר היו קצרים יותר.
השורות מופיעות בסדר התצורות הקבוע ששימש בניתוח, ולא לפי מיון התוצאה. קראו את השורה הרלוונטית להשוואת המקור שלכם, ושמרו איתה את ההקשר המחקרי. ספרדית לטינו-אמריקאית ופיליפינית הן הגדרות המקור של מערך הנתונים; פרסום המאמר בשפה אחרת אינו הופך את ההקלטות לראיות לגבי אותו שוק.
שינוי מזווג באורך ההקלטה ביחס לאנגלית אמריקאית
אותם 200 קטעי מקור מתורגמים בכל שורה. חציון משך ההקלטה של כל קטע בגרסת היעד מחולק בחציון שלו באנגלית; השינוי מ-1 מוצג באחוזים. Q25 ו-Q75 תוחמים את המחצית האמצעית של השינויים המזווגים האלה.
| תצורת הקלטה בגרסת היעד | חציון השינוי היחסי (%) | אחוזון ה-25 של השינוי (%) | אחוזון ה-75 של השינוי (%) |
|---|---|---|---|
| ספרדית לטינו-אמריקאית | 24.8% | 10.2% | 47.0% |
| צרפתית (צרפת) | 5.7% | -10.0% | 29.1% |
| גרמנית (גרמניה) | 31.4% | 0.0% | 62.4% |
| הולנדית (הולנד) | -6.1% | -21.6% | 8.9% |
| אינדונזית (אינדונזיה) | 26.3% | 11.4% | 49.9% |
| מלאית (מלזיה) | 11.3% | -1.2% | 29.1% |
| פיליפינית (הפיליפינים) | 82.4% | 54.2% | 120.1% |
| תאית (תאילנד) | 20.8% | 1.6% | 42.0% |
| יפנית (יפן) | 36.6% | 17.8% | 61.8% |
הפיזור חשוב כשיש למשימה מסגרת זמן אחת קבועה
חציון מצמצם 200 יחסים למספר אחד. סצנה מסוימת עדיין צריכה להכיל הקראה מסוימת. גבולות המחצית האמצעית שלצד כל חציון מראים מדוע העברת הערך האמצעי בלבד לבריף משמיטה מידע שרלוונטי להחלטה הזאת.
בהקלטות בצרפתית היה חציון שינוי מזווג של +5.7%, אך המחצית האמצעית נעה בין −10.0% לבין +29.1%. לצד הבדל מרכזי מתון היו קטעים משני צדי משך ההקראה באנגלית. בהקלטות בגרמנית היה חציון שינוי של +31.4%, עם מחצית אמצעית שנעה בין 0.0% בקירוב לבין +62.4%. הערך המוצג 0.0% מעוגל; הגבול התחתון לפני העיגול היה חיובי במקצת.
הטווחים האלה מתארים את המחצית האמצעית של השינויים המזווגים שנצפו. הם אינם רווחי סמך, גבולות מינימום–מקסימום או טווח שמובטח שיכיל הקלטה מסחרית עתידית. הקטעים, התרגומים והביצועים שבבסיסם שונים מתסריט מוצר חדש. גם העתקה מדויקת של אחוז החציון מהטבלה תשאיר את צוות ההפקה בלי הטייק בפועל שדרוש לעריכה.
ההבחנה משנה את השאלה באופן מעשי. במקום לשאול כמה זמן נוסף שפה תמיד דורשת, מפיק יכול לשאול אם ההקראה המתורגמת שאושרה מתאימה למשך הסצנה המיועדת. הטבלה מסבירה מדוע הבדיקה מועילה; ההקלטה של המשימה מספקת את התשובה.
קטע אחד יכול להגיע עם כמה משכי הקלטה
קטע המקור 1662 נבחר כמזהה הקטן ביותר שזמין בכל 10 התצורות, לפני שסיכמנו את משכי ההקלטות. הטבלה שלו כוללת כל הקראה זמינה של הקטע. לא חיפשנו דוגמה דרמטית אחרי שראינו את המשכים, ומילות הקטע או האודיו שלו אינם מובאים כאן.[3][4]
אורכם של 2 הקבצים באנגלית היה כ-8.4 וכ-11.2 שניות, והחציון היה 9.8 שניות. אורכי 3 הקבצים בגרמנית נעו בין 10.4 ל-23.5 שניות, עם חציון של 10.5. אורכי 2 הקבצים בפיליפינית נעו בין 22.3 ל-24.9 שניות, עם חציון של 23.6. אלה משכי הקבצים המלאים כפי שדווחו במטא-נתוני המקור, שעוגלו לספרה ה-1 אחרי הנקודה העשרונית לצורך התצוגה.
חציון של 2 הקראות יכול להיות הממוצע החשבוני שלהן, ולא משך קובץ שמישהו הקליט בפועל. התצוגה של 9.8 שניות באנגלית היא סיכום כזה. עורך שבוחר טייק עדיין צריך לעבוד לפי משך הקובץ שנבחר. מספר הטייקים והטווח מהקצר ביותר לארוך ביותר מבהירים את ההבחנה לצד החציון.
הפיזור בגרמנית גם מזהיר מפני ייחוס כל שנייה לאורך התרגום. אין לנו מזהי דוברים, ולא האזנו להקלטות או הפרדנו דיבור מהפסקות. אי אפשר להפריד כאן בין אופן ההקראה, המקריאים ותנאי ההקלטה. הדוגמה תומכת בבקשת הפקה פשוטה: שלחו את הטייק המיועד, או הקראה של הנוסח המיועד שמדדו את משכה, במקום אומדן ברמת השפה בלבד.
קטע 1662: השאירו את טווח הטייקים לצד החציון
מזהה המקור הקטן ביותר עם הקלטות בכל 10 התצורות, שנבחר לפי זמינות לפני סיכומי משכי ההקלטות. כל הטייקים הזמינים נכללים. השניות מתארות קבצים מלאים במטא-נתוני המקור, ללא הפרדה של הפסקות.
| תצורת הקלטה | טייקים זמינים | הקובץ הקצר ביותר (שניות) | חציון משך הקובץ (שניות) | הקובץ הארוך ביותר (שניות) |
|---|---|---|---|---|
| אנגלית אמריקאית | 2 | 8.4 | 9.8 | 11.2 |
| ספרדית לטינו-אמריקאית | 3 | 8.8 | 9.5 | 9.5 |
| צרפתית (צרפת) | 2 | 6.4 | 6.8 | 7.1 |
| גרמנית (גרמניה) | 3 | 10.4 | 10.5 | 23.5 |
| הולנדית (הולנד) | 1 | 7.9 | 7.9 | 7.9 |
| אינדונזית (אינדונזיה) | 1 | 11.6 | 11.6 | 11.6 |
| מלאית (מלזיה) | 2 | 8.0 | 8.6 | 9.1 |
| פיליפינית (הפיליפינים) | 2 | 22.3 | 23.6 | 24.9 |
| תאית (תאילנד) | 3 | 6.5 | 8.7 | 10.1 |
| יפנית (יפן) | 2 | 12.1 | 13.3 | 14.6 |
דוגמה של 15 שניות דורשת מכנה מפורש
קבענו 15 שניות כהמחשה לתכנון לפני חישוב התוצאות. זו אינה דרישת פלטפורמה, אורך מודעה מומלץ או מרווח זמן בטוח להפקה. השאלה הייתה אם סיכום הקלטה באנגלית יכול להיכנס למסגרת הזאת בזמן שסיכום היעד המקביל חורג ממנה.
מתוך 200 הקטעים המשותפים, ב-186 היה חציון באנגלית שאינו עולה על 15 שניות. בתוך הקבוצה הזאת, חציון היעד עלה על 15 שניות ב-20 קטעים בספרדית לטינו-אמריקאית, ב-39 בגרמנית, ב-9 בהולנדית, ב-110 בפיליפינית וב-37 ביפנית. לכל מניין אותו מכנה, 186; שאר ההשוואות נשמרות בקובץ ההורדה.[6]
השתמשנו גם בכלל מחמיר יותר של הטייקים שנצפו. כל הקראה זמינה באנגלית הייתה צריכה להיכנס ל-15 שניות, וכל הקראה זמינה בגרסת היעד הייתה צריכה לחרוג מהן. 178 קטעים באנגלית עמדו בתנאי. הדבר התקיים ב-11 קטעים בספרדית, ב-9 בגרמנית, ב-4 בהולנדית, ב-72 בפיליפינית וב-14 ביפנית. המניינים מתייחסים רק לטייקים שפורסמו, ולא לכל ביצוע אפשרי של הקטע.
הבדיקה המחמירה יותר נמנעת מהסתמכות על ממוצע חשבוני שאיש לא הקליט. היא עדיין אינה מראה שאי אפשר להקריא קטע מהר יותר, לערוך אותו אחרת או לנסח אותו מחדש בצורה מתאימה. ההבחנה המועילה לצוות היא בין נתון שמראה שהקלטה מסוימת שסופקה מתאימה, לבין הנחה שגרסה אחרת תתאים מפני שהגרסה באנגלית התאימה.
השקה בדיונית ממחישה מתי צריך להעביר את חומרי העבודה
נבחן מותג קטן ובדיוני לכלי מטבח שמזמין מיוצר תוכן סרטון מוצר בן 15 שניות. הרעיון כולל הדגמה, הצעה ושוט סיום של המוצר. ההקראה באנגלית נמשכת 11 שניות. טיוטה מתורגמת אושרה מבחינת המשמעות, אך ההקראה הראשונה של הקריין המיועד נמשכת 17 שניות. המותג, התסריט, המשכים והמשימה בדוגמה הזאת בדיוניים; הם אינם תצפיות מ-FLEURS.
אם היוצר כבר נעל כל שוט לפי ההקראה באנגלית, הקובץ בן 17 השניות מצריך החלטה בשלב מאוחר של העריכה. במקום להשאיר את הבחירה לא מפורשת, מנהל הלקוח יכול לבקש הקראה שמדדו את משכה כשהנוסח המתורגם עדיין בבדיקה. הבריף צריך לציין איזה מסר חייב להישאר מדויק, כמה זמן זמין בסצנה ומי יכול לאשר שינוי בכל אחד מהם.
התגובה אינה חייבת להיות האצה אוטומטית של הקריין. המתרגם יכול להציע ניסוח טבעי וקצר יותר ששומר על ההצעה. העורך יכול לתת להדגמה יותר זמן, להעביר פרט משני לטקסט נלווה או להכין גרסת עריכה נפרדת אם הפורמט שסוכם מאפשר זאת. אלה אפשרויות הפקה לדיון, ולא שיפורים שהוכחו בניתוח הקורפוס שלנו.
העברה מועילה של חומרי העבודה במשימה הבדיונית הזאת יכולה להיראות כך: ״גרסת יעד: __. תסריט מאושר: __. הטייק המיועד: __ שניות, לפי מדידה של הקובץ שסופק. הזמן שהוקצה לסצנה: __ שניות. נוסח ההצעה וגילויי הנאות הנדרשים: __. מי שמאשר שינויים בתסריט: __. מי שמאשר את העריכה: __.״ את החסר ממלא הצוות בפועל; טבלת המחקר אינה יכולה למלא אותו.
כשיש כמה גרסאות יעד, מנהל הלקוח יכול לשמור שורה לכל טייק מיועד במקום לסמן את הפרויקט כולו כ״התרגום אושר״. אישור הנוסח ואישור משך ההקלטה עונים על שאלות שונות. אם המתרגם משנה טענה לגבי המוצר אחרי הקראת הניסיון, השורה צריכה לציין את השינוי לפני שהיוצר מסתמך שוב על משך ההקלטה הקודם. זו הצעה לארגון המשימה הבדיונית; השפעתה על הפחתת סיכון לפרויקט לא נבחנה.
לאחר שמתקבל טייק מתוקן, היוצר יכול לבדוק את הגרסה המלאה עם מי שאחראי לשפה ולמשמעות. בדיקה שמסתמכת רק על משך ההקלטה עלולה לפספס הקראה מסורבלת או פריים סיום שאינו קריא. המחקר לא מדד איכות או תגובת קהל. תרומתו למשימה הבדיונית היא ידיעה מוקדמת יותר של משך ההקלטה, והאחראים להכנת הסרטון ממשיכים לשאת באחריות לבחירה היצירתית.
השאירו את הנוסח, הטייק והתמונה יחד לאורך הבדיקה
מסמך שמרכז את נתוני משך הקריינות בכמה שפות מועיל כשהוא קצר מספיק כדי ללוות את העבודה. הוא מזהה את גרסת התסריט המאושרת, את ההקלטה המיועדת ואת הזמן של הסצנה. אם אחד מהם משתנה, מי שמקבל את החומרים בשלב הבא יכול לראות באילו נתוני משך עדיין אפשר להשתמש.
הקראת ניסיון שמדדו את משכה יכולה לחשוף אי-התאמה כשעדיין יש לצוות אפשרויות בחירה. היא צריכה להישאר מסומנת כהקראת ניסיון, ולא כהוכחה שמשך ההקראה של הקריין הסופי יהיה זהה. כשהטייק המיועד מגיע, החליפו את ההנחה במשך שנמדד ובדקו אותו בעריכה עצמה.
השאירו את הגרסה המתורגמת שלמה במהלך הבדיקה. מי שבודק את המשמעות צריך לשמוע את ההקראה עם התמונה, והעורך צריך לראות אם ההפסקות, חשיפות המוצר ופריים הסיום משתלבים זה בזה. העובדה שקובץ מתאים למסגרת זמן היא ראיה אחת; היא אינה אישור לכל מה שנכלל בגרסה.
4 השלבים שלהלן הם הצעה להעברת העבודה, ולא תהליך עבודה שנבחן ב-FLEURS. הם מיישמים את ההבחנה בין נוסח למשך מוקלט על החלטת הפקה. אין בהם הבטחה לגבי חשיפה, שימור צופים, המרות או מספר סבבי התיקונים שיידרשו לפרויקט.
העבירו את משך ההקלטה לאורך 4 שלבי מסירה
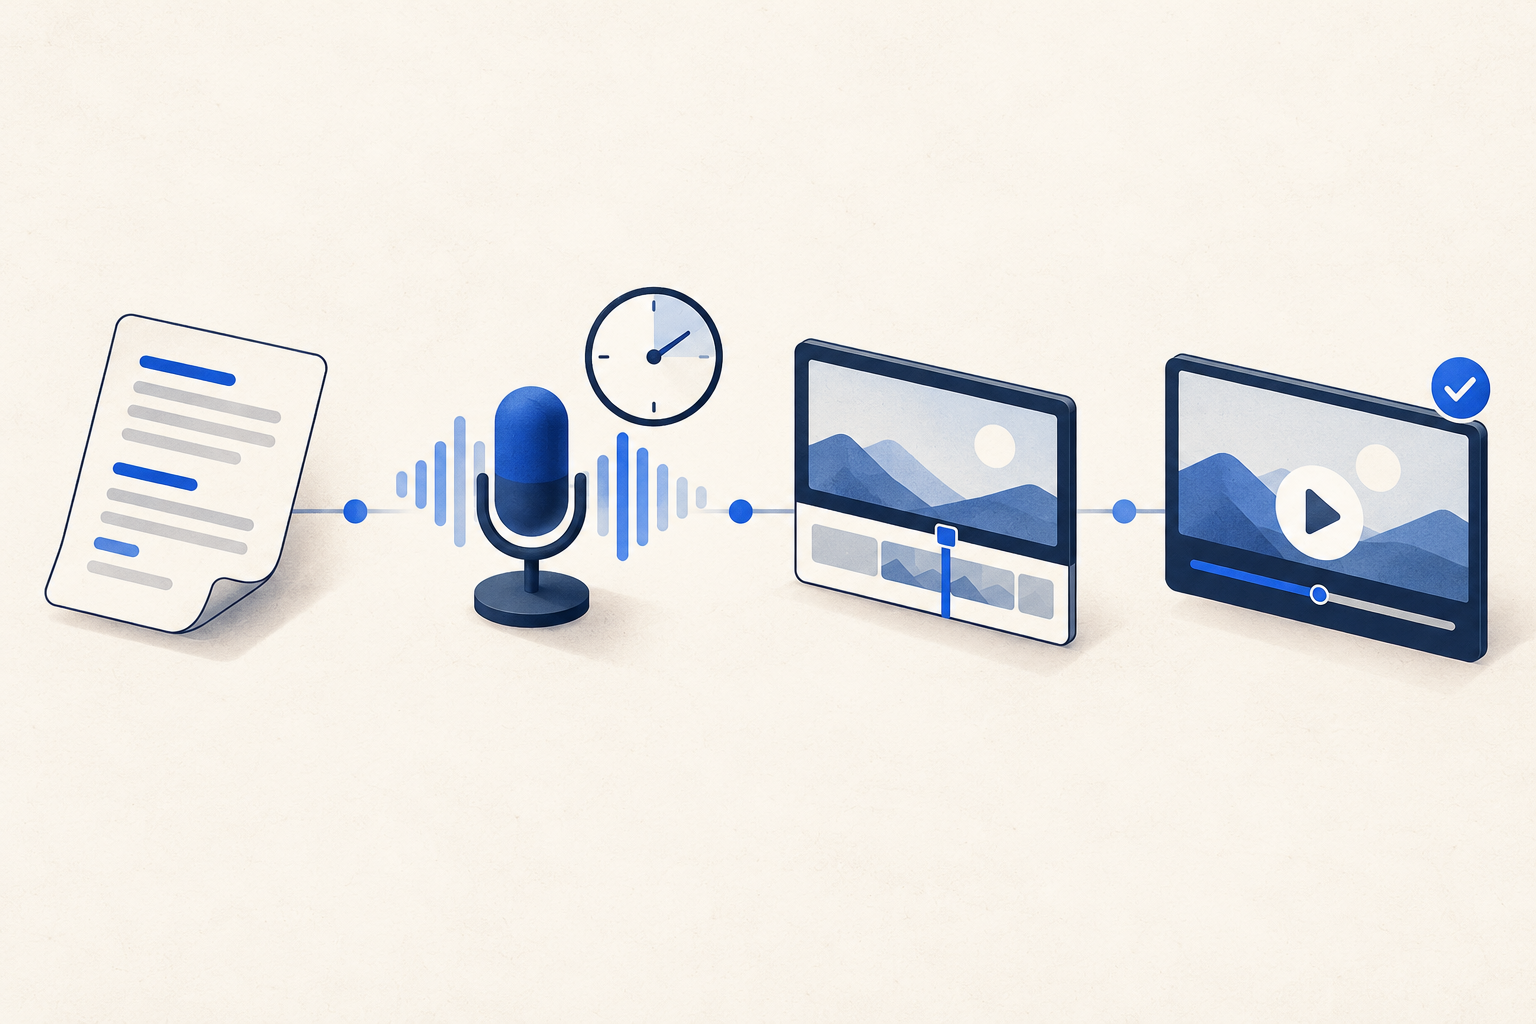
סכמו את הנוסח
ציינו את גרסת היעד, התסריט המאושר ומי שבודק את המשמעות.
מדדו את משך ההקראה המיועדת
צרפו לטייק את משך ההקלטה שנמדד; סמנו הקראת ניסיון כזמנית.
פתרו את אי-ההתאמה
סכמו כל שינוי בתסריט או בסצנה לפני שמתחייבים לעריכה.
בדקו את הגרסה כולה
בדקו את הטייק שנבחר עם התמונה, פרטי ההצעה ופריים הסיום.
שמרו על ציון הקבוצה המותאמת כשאתם משתמשים שוב בנתון
ההשוואה המשותפת כוללת 200 מתוך 350 קטעי הבדיקה באנגלית. ב-150 הנותרים הייתה חסרה לפחות תצורה אחת שנבחרה. זמינות מלאה עשויה להיות סלקטיבית, ולכן אין לתאר את הקבוצה המשותפת כמדגם אקראי של תסריטים, שפות או עבודות קריינות.
חזרנו על כל השוואת אנגלית–יעד באמצעות כל זוג תואם שהיה זמין. המכנים נעו מ-251 בהולנדית עד 349 בפיליפינית ובתאית. חזרנו גם על ההשוואות בקבוצה המשותפת תוך שימוש רק בקטעים עם לפחות 2 הקראות באנגלית ו-2 הקראות בגרסת היעד; תת-הקבוצות האלה כללו בין 66 ל-166 קטעים. כל 9 התוצאות המזווגות והמכנים שלהן נמצאים בקובץ ההורדה.[4]
תת-הקבוצות עם הקראות חוזרות שמרו בכל תצורה על אותו כיוון של חציון השינוי המזווג כמו בהשוואה הראשית. זו בדיקה מועילה של בחירת הסיכום המסוימת הזאת. אין בה בקרה על זהות המקריאים, והיא אינה הופכת את המדגמים השונים של השוואות הזוגות לאוכלוסיות בנות-השוואה. טייקים חוזרים אינם משתתפים עצמאיים.
ההקלטות שהתקבלו בגרמנית, בהולנדית, באינדונזית, במלאית ובפיליפינית נשאו כולן סימון ״גבר״; ההקלטות בתאית נשאו כולן סימון ״אישה״. בהקלטות באנגלית, בספרדית, בצרפתית וביפנית היו סימונים משני המגדרים. ללא מזהי דוברים, הניתוח אינו יכול להפריד בין התצורה לבין הרכב המקריאים, הביצוע, התרגום או הישארות ההקלטות במאגר. קראו את הטבלה כתיאור של ההקלטות האלה, והשאירו את המגבלה הזאת לצד כל נתון שתשתמשו בו שוב.[7]
איך נערכה השוואת משכי ההקלטות
FLEURS הוא קורפוס מחקרי שהוצג ב-2022 ומשתמש בקטעי הקראה מתורגמים. תיעוד מפרסם הנתונים ותיעוד TensorFlow Datasets מציינים מזהה טקסט מקור משותף בין שפות ושדה מטא-נתונים למספר הכולל של דגימות האודיו בקצב של 16,000 הרץ. חילקנו את השדה הזה ב-16,000 כדי לקבל משך קובץ מלא בשניות לפי המטא-נתונים. לא פענחנו אודיו, לא אימתנו אורכי גלי קול ולא הסרנו שתיקה.[1][2]
קיבלנו את 10 קובצי המטא-נתונים של קבוצת הבדיקה בגרסת מפרסם הנתונים הקבועה שמתועדת בהערות, ב-24 באוקטובר 2026 (UTC). הם מכילים 7,528 הקלטות בקטעים הזמינים. ההתאמה השתמשה במזהי מקור, ולעולם לא במיקום השורה. הקבוצה המשותפת של 200 קטעים, כללי 15 השניות, בדיקת ההקראות החוזרות ודוגמה 1662 נקבעו אחרי שהזמינות הייתה ידועה ולפני שחושבו סיכומי משכי ההקלטות.[3][4]
מועד קבלת הנתונים מזהה את תמונת המקור שבה השתמשנו. הוא אינו הופך הקלטות שהוצגו עם קורפוס מחקרי מ-2022 לסקר מ-2026 של קריינים או יוצרים. הנתונים הציבוריים שומרים את גרסת המקור כדי שקורא מאוחר יותר יוכל להבחין בין ניתוח חדש של חומר קיים לבין ביצועים שנאספו מחדש.
ניסיון היתכנות מוקדם יותר בקבוצת הפיתוח הניב רק 91 קטעים משותפים, מתחת לסף שלו של 100 קטעים, והונח בצד. קבלת נתוני הבדיקה נעצרה בתחילה בגלל מגבלת גודל למטא-נתונים בתאית; הגדלה מתועדת של המגבלה אפשרה להשלים את אותה מסגרת בדיקה קבועה. אלה שינויים גלויים בהיתכנות ובגישה, ולא ראיה למחקר שנרשם מראש בלי חשיפה לתוצאות.
כל החישובים המזווגים השתמשו במספרי דגימות ובשברים מדויקים. גבולות המחצית האמצעית חושבו באינטרפולציה ליניארית במיקומים שמוגדרים לפי (n−1) × p. הטבלאות מציגות אחוזים ושניות עד לספרה ה-1 אחרי הנקודה העשרונית, בעיגול לערך הקרוב ביותר; במקרה של שוויון, נבחר הערך הרחוק יותר מאפס. מספרי הטייקים נשארים שלמים. הנתונים הנגזרים הציבוריים משמרים את סיכומי הקטעים המדויקים, את תוצאות ההשוואות הזוגיות, את בדיקות הרגישות ואת שתי הגדרות מסגרת הזמן. לא חישבנו רווחי סמך לאוכלוסייה או השפעות סיבתיות.[4]
אילוצי משך בדיבוב הם כבר נושא מחקר מבוסס.[5] המאמר הזה מוסיף השוואה שאפשר לשחזר של משכי הקבצים שפורסמו עבור הקטעים הקבועים האלה, ואת המידע הדרוש לבדיקת התחולה והטייקים החוזרים. הוא תומך בבקשת נתוני משך להפקה מתורגמת לפני נעילת העריכה; הוא אינו מספק אחוז הארכה אוניברסלי.
- הורדת 67 הממצאים המוצגים (CSV)
- הורדת כל 350 הקטעים × 10 התצורות וסיכומי הטייקים (CSV)
- הורדת כל 9 ההשוואות המזווגות, בדיקות הרגישות והמניינים לפי כללי הזמן (CSV)
- הורדת המקורות, השיטה והקוד לשחזור (ZIP)
אין צורך בהרשמה. הנתונים הנגזרים משמרים צירופים חסרים ואת מכני ההשוואה בפועל. החבילה המשותפת מכילה תיעוד שיטה באנגלית, הפניות למקורות וקוד לשחזור; אין בה הפצה מחדש של תמלילים מקוריים או אודיו. כל גרסת שפה מתארת את אותו קורפוס קבוע.[8]
הערות מחקר
- Conneau ועמיתיו, FLEURS: הערכת למידה ממעט דוגמאות של ייצוגי דיבור אוניברסליים (2022), סעיפים 2.1–2.3. הקורפוס מכיל קטעי הקראה מתורגמים עם עד 3 הקלטות מאומתות לכל משפט, שנדגמו ב-16 קילוהרץ. האופן שבו נאסף וייעודו המחקרי אינם מוכיחים ייצוגיות להפקת קריינות מסחרית. קטעי המקור מגיעים מ-FLORES; הם אינם מדגם תסריטים לפרסום.
- TensorFlow Datasets, תיעוד התכונות והמפרש של xtreme_s בגרסה 2. מזהה טקסט המקור עקבי בין השפות ועשוי לחזור בהקראות שונות; num_samples מתעד את המספר הכולל של דגימות האודיו. תכונת האודיו מצהירה על 16,000 הרץ. המפרש מעתיק את המניינים מהמטא-נתונים, במקום לבדוק אותם מול גלי קול שפוענחו. השניות שלנו הן משכי קבצים מלאים המדווחים במטא-נתונים, ללא הפרדה של הפסקות וללא בקרה על זהות הדובר.
- מטא-נתונים של Google FLEURS, גרסה קבועה ab93cf03f9d0cd083c853fad065a6377067408aa, קבוצת בדיקה, התקבלו ב-24 באוקטובר 2026 (UTC). התצורות: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th ו-ja_jp. קובץ ה-TSV המקושר באנגלית הוא אחד מ-10 קובצי המקור; החבילה מתעדת כל כתובת מקור מדויקת ואת ה-SHA256 שלה. הספרדית במקור היא לטינו-אמריקאית, ו-fil_ph הוא פיליפינית.
- חישובי Influence IQ: חציון בתוך כל קטע לכל תצורה; משקל שווה לקטעים; יחס מזווג בין חציון היעד לחציון באנגלית והפרש מזווג בשניות. בסיס ההשוואה הראשי הוא 200 הקטעים המשותפים לכל 10 התצורות, מתוך 350 קטעים באנגלית. ההשוואות המשניות משתמשות בכל זוגות האנגלית–יעד הזמינים ובקטעים משותפים עם לפחות 2 טייקים בכל צד. השיטה ובחירת הדוגמה נקבעו לפני סיכומי משכי ההקלטות, לאחר בירור הזמינות. שברים מדויקים, אינטרפולציה, עיגול וכל המכנים מתועדים בחבילת השחזור.
- דיבוב בפועל: מחקר רחב היקף של התאמה אנושית לשפות עם תובנות לדיבוב אוטומטי (2023). עבודה קודמת כבר בוחנת תזמון בדיבוב אנושי מקצועי. התרומה שלנו היא טבלה מזווגת של משכי קובצי FLEURS בקבוצה המוגדרת הזאת, והפרשנות שאפשר להשתמש בה שוב להעברת העבודה בהפקה; זו אינה תגלית של אילוצי משך בדיבוב או אמת מידה לדיבוב מקצועי.
- מסגרת הזמן של 15 שניות נקבעה כהמחשה לתכנון לפני התוצאות. כלל החציון: ב-186 קטעים משותפים החציון באנגלית הוא ≤15 שניות; נספרים חציוני יעד שהם >15. כלל כל הטייקים שנצפו: ב-178 כל טייק באנגלית הוא ≤15; נספרים קטעים שבהם כל טייק יעד שנצפה הוא >15. שוויון לגבול מתאים למסגרת הזמן. המניינים הם תוצאות תיאוריות של הקלטות שפורסמו, ולא הנחיות פלטפורמה או טענה על כל הקראה אפשרית.
- במטא-נתונים שהתקבלו אין מזהי דוברים. ההקלטות בגרמנית, בהולנדית, באינדונזית, במלאית ובפיליפינית נשאו כולן סימון ״גבר״; ההקלטות בתאית נשאו כולן סימון ״אישה״. תצורות חסרות מוציאות 150 מתוך 350 קטעים באנגלית מהקבוצה המשותפת. בדיקות הזוגות וההקראות החוזרות מתארות תת-קבוצות סופיות שונות, ואינן מסלקות את הערבוב בין מקריאים, מגדר, אופן הקראה, תרגום והישארות במאגר. לא מדווחים רווחי סמך, דירוג מהירות שפות, השפעה סיבתית או תחזית מסחרית.
- מקור: Google FLEURS, המסופק תחת CC BY 4.0. הבחירה, החישובים, הטבלאות, הפרשנות העריכתית והתרגומים הם עיבודים של Influence IQ; אין בכך הבעת תמיכה מצד מחברי מערך הנתונים. החבילה הציבורית מפיצה מחדש סיכומים מספריים נגזרים וקוד, ולא אודיו מקורי או טקסט של קטעים. עיגול התצוגה אינו משנה את מספרי המקור המדויקים או את אוכלוסיית ההקלטות המשותפת.
המאמר באנגלית הוא המקור לכל גרסאות השפה. כל מהדורה מדווחת על אותן הקלטות בדיקה קבועות וקטעים מתורגמים של FLEURS; שפת המאמר אינה יוצרת ראיות לגבי שוק חדש. Influence IQ אחראי לניתוח, לפרשנות ולתרגומים.