Varepræsentation i e-handel: test dine antagelser om produktplacering
Et historisk eksperiment med 10 bøger viser, hvordan en enkel placeringsjustering kan overse dele af mønstret, og hvordan antagelsen kan testes, før produktkort sammenlignes.
Original genanalyse af det offentliggjorte bogvalgseksperiment fra 2024 af Compiani, Morozov og Seiler.
Resumé
Før en virksomhed beslutter, at ét tilbud er stærkere end et andet, skal den overveje, hvor hvert tilbud blev vist. Vi brugte et offentliggjort eksperiment fra 2024 med 10 e-bøger til at teste 2 måder at tage højde for placering på. At give hver placering sin egen justering forudsagde samlet set valg bedre end at anvende samme justering for hvert trin ned ad listen. Det var mindre præcist ved nogle enkelte placeringer, så den fulde sammenligning er vigtig.
Begge modeller brugte samme bog- og prisoplysninger. Vi tilpassede dem på 6.176 deltagere og kontrollerede deres forudsigelser på 3.088 andre deltagere. Valgene var hypotetiske, og alle skulle vælge en bog. For virksomheder og indholdsskabere, der sammenligner produktkort, er læren at teste placeringsantagelser, før resultater tilskrives et tilbud. Undersøgelsen estimerer ikke en salgsstigning og identificerer ikke den bedste produktrækkefølge.
Antag, at produktet øverst på en side får flest klik. Er det et stærkere tilbud, eller hjalp placeringen på listen? En virksomhed har brug for et brugbart svar, før den omskriver de andre kort, giver rabat på de tilsyneladende svagere varer eller ændrer sortimentet.
At tage højde for placering lyder ligetil, indtil man spørger hvordan. Skal hvert trin ned ad listen have samme justering? Vi brugte et historisk eksperiment til at sammenligne den enkle tilgang med en mere fleksibel og testede derefter begge på deltagere, som blev holdt ude af modeltilpasningen.
Samme produkter, forskellige placeringer
Hvad skal en sammenligning af produktplacering fortælle dig?
En sammenligning af produktkort bør hjælpe dig med at adskille den tilbudte vare fra måden, den blev præsenteret på. Hvis ét produkt sædvanligvis står først og et andet sidst, besvarer deres totaler alene ikke, om kunder foretrækker det ene tilbud.
Den enkle tilgang, vi tester, giver hvert trin ned ad listen samme justering af modellens underliggende præferencescore. Det nyttige spørgsmål er, om den forudsiger valg godt nok sammenlignet med at lade forskellige placeringer have forskellige justeringer.
Vi testede de 2 tilgange med et offentliggjort bogvalgseksperiment. Resultatet er relevant for virksomheder og indholdsskabere, der sammenligner produkter på en samlingsside eller i en digital butik. Det giver en måde at undersøge en måleantagelse på frem for en regel om, hvor din bedst sælgende vare skal stå.
Det er vigtigt, når et tilbud optræder mere end 1 sted. En indholdsskaber kan fremhæve samme download i en samling og på en lanceringsside. En forhandler kan ændre rækkefølgen i en kategoriliste. Varen, prisen, målgruppen og præsentationen kan variere sammen. En placeringsjustering er en antagelse om en del af sammenligningen og fortjener sin egen kontrol.
Hvad valgte folk i bogeksperimentet?
Giovanni Compiani, Ilya Morozov og Stephan Seiler bad deltagere rekrutteret gennem Prolific om hypotetiske valg mellem 10 e-bøger med randomiseret rækkefølge og priser. Deltagerne skulle vælge en bog; der var ingen mulighed for ikke at købe noget. Vi bruger første opgave i hver bevaret besvarelse, ikke den senere opgave, der fjernede den valgte bog.[1]
Forfatterne rapporterer allerede reaktioner på placering og pris. Deres bredere forskning undersøger, hvordan tekst og billeder hjælper med at estimere produktsubstitution. Vores spørgsmål er snævrere: Forbedrer udskiftning af ét enkelt placeringsled forudsigelsen for deltagere, hvis valg blev holdt ude af modeltilpasningen?
De oprindelige kriterier efterlader 9.265 besvarelser med 9.264 forskellige Prolific-deltager-id'er. 1 id optræder 2 gange. Vi holder begge besvarelser samlet og giver den deltager samme samlede vægt som enhver anden. En besvarelse er ikke automatisk en særskilt person, og en første opgave er ikke nødvendigvis personens første eksponering for eksperimentet.[2][3]
De bevarede kildedatoer går fra 11. til 26. juni 2024. Manuskriptet beskriver 14.–27. juni, så vi oplyser forskellen og anvender ingen datobaseret udeladelse. Kriterier for land og alder blev ikke fastslået i det gennemgåede materiale; det er ikke estimater for amerikanske kunder eller en anden national population.[1][2]
Deltageren holdes samlet gennem hele sammenligningen
Udvalgte besvarelser af første opgave efter forfatternes oprindelige kriterier; datoer i bevarede kilderegistreringer 11.–26. juni 2024.
| Gruppe | Deltagere (efter platform-id) | Bevarede besvarelser |
|---|---|---|
| Alle bevarede | 9.264 | 9.265 |
| Træning | 6.176 | 6.176 |
| Reserveret til evaluering | 3.088 | 3.089 |
Hvilken placeringsmodel forudsagde testgruppens valg bedst?
Den fleksible placeringsmodel forudsagde testgruppens valg bedre på det på forhånd specificerede scoremål. Begge modeller tager højde for, hvilken bog der blev tilbudt, og dens viste pris. De adskiller sig kun ved, hvordan de repræsenterer placering.
Baselinemodellen bruger 1 koefficient for hvert trin ned ad listen. Den fleksible model bruger særskilte justeringer for placering 2 til og med 10 i forhold til den første. Det giver mere frihed, men også flere parametre at estimere. Bedre tilpasning til egne træningsdata ville ikke i sig selv afgøre sammenligningen.
Vi tilpassede derfor begge modeller på 6.176 deltagere og evaluerede dem på de øvrige 3.088 deltagere. Hver besvarelse fra en deltager forblev på samme side af opdelingen. Testgruppen indeholder 3.089 besvarelser, fordi den omfatter den gentagne deltager.
Til at sammenligne forudsigelser brugte vi en negativ logscore. En model får en mindre straf, når den tildeler større sandsynlighed til det valg, en person faktisk træffer. Den får en større straf, når den tildeler meget lille sandsynlighed til valget. Lavere gennemsnitlige negative logscores er bedre.
Gennemsnittet for testgruppen var 2,2260 for baselinemodellen og 2,2154 for den fleksible model i naturlige logaritmeenheder, også kaldet nats. Det er forudsigelsesscorer, ikke procentdele korrekte svar. Trænings- og testscorer vises sammen, så sammenligningen ikke bygger på den lettere opgave at beskrive data, modellen allerede har set.
2 modeller evalueret på de samme deltagere
Udvalgte valg i første opgave med 10 bøger fra 2024. Træning: 6.176 deltagere og besvarelser. Test: 3.088 deltagere og 3.089 besvarelser.
| Placeringsmodel | Træningsscore (nats) | Testgruppescore (nats) |
|---|---|---|
| 1 lineært placeringsled | 2,2046 | 2,2260 |
| Særskilte placeringsled | 2,1899 | 2,2154 |
Den parrede forbedring var 0,0106 nats pr. deltager med et omtrentligt 95 %-interval fra 0,0044 til 0,0168. Her favoriserer en positiv forbedring den fleksible model. Resultatet er lille på denne scoreskala, men intervallet ligger over 0.[4]
Intervallet behandler de 2 tilpassede modeller som faste og antager uafhængige deltagergrupper. Det omfatter ikke usikkerhed fra tilpasning af modellerne på en anden træningsstikprøve. Resultatet understøtter en forbedret forudsigelse i denne udvalgte historiske opgave; det gør ikke scoreforskellen til en salgsstigning.
Den fleksible model forbedrer testgruppens logscore
Parret sammenligning blandt 3.088 testdeltagere i den udvalgte historiske opgave med 10 bøger.
| Sammenligning | Forbedring (nats) | 95 %-interval: nedre grænse (nats) | 95 %-interval: øvre grænse (nats) |
|---|---|---|---|
| Fleksibel minus baseline-logscore | 0,0106 | 0,0044 | 0,0168 |
Hvor ramte de 2 modeller ved siden af de observerede valg?
Den fulde placeringssammenligning viser, hvorfor den samlede score bør ledsages af detaljer. For hver placering sammenligner vi dens observerede valgandel med den gennemsnitlige sandsynlighed, hver model tildeler den. Det er gennemsnit med lige vægt til hver deltager i testgruppen, ikke klikrater.
Ved placering 1 var den observerede andel 17,16 %. Baselinemodellen forudsagde 14,64 %, mens den fleksible model forudsagde 17,73 %. Ved placering 10 var den observerede andel 9,18 % mod forudsigelser på 6,37 % og 8,74 %. Den fleksible model var tættere ved begge ender af netop denne liste.
Observerede og forudsagte valg ved alle 10 placeringer
Testgruppe: 3.088 deltagere og 3.089 besvarelser af første opgave fra det offentliggjorte eksperiment fra 2024.
| Placering | Observeret valgandel | Baselinemodellens gennemsnitlige sandsynlighed | Fleksibel models gennemsnitlige sandsynlighed | Besvarelser med den valgte bog på placeringen |
|---|---|---|---|---|
| Placering 1 | 17,16 % | 14,64 % | 17,73 % | 530 |
| Placering 2 | 13,60 % | 13,20 % | 14,84 % | 420 |
| Placering 3 | 9,91 % | 12,06 % | 9,74 % | 306 |
| Placering 4 | 10,91 % | 11,21 % | 9,26 % | 337 |
| Placering 5 | 9,20 % | 10,09 % | 8,94 % | 284 |
| Placering 6 | 7,08 % | 9,25 % | 8,01 % | 219 |
| Placering 7 | 8,00 % | 8,44 % | 7,57 % | 247 |
| Placering 8 | 7,12 % | 7,67 % | 7,47 % | 220 |
| Placering 9 | 7,84 % | 7,08 % | 7,69 % | 242 |
| Placering 10 | 9,18 % | 6,37 % | 8,74 % | 284 |
Den fleksible model var ikke tættere overalt. Ved placering 4 var den observerede andel 10,91 %. Baselinemodellen forudsagde 11,21 %, mens den fleksible model forudsagde 9,26 %. Den ekstra fleksibilitet forbedrede den samlede score for testgruppen, men efterlod en større afvigelse ved den placering.
Næste tabel viser observerede minus forudsagte andele. En positiv forskel betyder, at modellen forudsagde for få valg ved placeringen; en negativ forskel betyder for mange. At holde alle 10 placeringer synlige forhindrer, at et pænt endepunkt kommer til at repræsentere hele sammenligningen.
Begge modellers forskelle fra de observerede valg
Observeret valgandel minus gennemsnitlig forudsagt sandsynlighed for hver af de 10 placeringer med de samme 3.088 testdeltagere.
| Placering | Observeret minus baseline | Observeret minus fleksibel |
|---|---|---|
| Placering 1 | 2,52 procentpoint | -0,57 procentpoint |
| Placering 2 | 0,41 procentpoint | -1,24 procentpoint |
| Placering 3 | -2,15 procentpoint | 0,17 procentpoint |
| Placering 4 | -0,29 procentpoint | 1,65 procentpoint |
| Placering 5 | -0,89 procentpoint | 0,26 procentpoint |
| Placering 6 | -2,17 procentpoint | -0,93 procentpoint |
| Placering 7 | -0,44 procentpoint | 0,43 procentpoint |
| Placering 8 | -0,55 procentpoint | -0,35 procentpoint |
| Placering 9 | 0,76 procentpoint | 0,14 procentpoint |
| Placering 10 | 2,81 procentpoint | 0,44 procentpoint |
Placeringsrækkerne er beskrivende uden særskilte signifikanspåstande. Eksperimentet målte ikke øjenbevægelser eller opmærksomhed, og analysen identificerer ikke, hvorfor en placering adskiller sig. Et buet mønster i observerede andele modbeviser heller ikke i sig selv baselinemodellen: Dens placeringsled er lineært i modellens underliggende præferencescore, ikke i valgprocentdele.
Blot at trække første og sidste observerede andel fra hinanden ville besvare et andet spørgsmål. De andele opsummerer valg på tværs af produkter og priser. Begge tilpassede modeller tager højde for bogidentitet og pris, før de tildeler sandsynligheder til de 10 muligheder. Hverken forskellen mellem endepunkterne eller modelsammenligningen fortæller, hvad der ville ske, hvis du flyttede et bestemt produkt i en rigtig butik.
En måleskabelon til produktplacering, du kan bruge
Skriv en kort målebrief, før tilbud sammenlignes. Følgende skabelon er frit tilgængelig og illustrativ. Den anvender undersøgelsens lære om at kontrollere antagelser; den lover ikke, at samme model passer til din butik.
Beslutning: ”Vi skal beslutte [hvilken produktsammenligning eller præsentationsændring] for [side eller kampagne] i [periode].” Angiv beslutningen, før et fordelagtigt mål vælges.
Udfald: ”Vi måler [valg, klik, tilføjelse til kurv eller køb].” Vælg det udfald, dine registreringer faktisk understøtter. Behold de tilbudte alternativer, deres rækkefølge og viste priser sammen med det. Et resultat fra tvunget valg bør holdes adskilt fra et købsresultat.
Enhed: ”Vores enhed er [deltager eller anden klart defineret enhed]. Gentagne besøg eller besvarelser håndteres ved [regel].” Hold samme persons observationer samlet, når forudsigelse for nye personer evalueres. Behandl ikke en anonym sessionsidentifikator som bevis for en entydig person.
Sammenligning: ”Begge modeller bruger samme produkter, prisoplysninger og observationer, der opfylder kriterierne. De adskiller sig i [placeringsantagelsen].” Specificér det enkle alternativ såvel som det mere fleksible.
Evaluering: ”Vi reserverer [en defineret gruppe] før tilpasning og sammenligner [et navngivet scoremål]. Vi viser alle placeringer.” Beslut, hvordan et uafklaret eller dårligere resultat skal rapporteres, før det ses.
Brug: ”Dette resultat skal kvalificere [målebeslutning]. Evidens om [kommercielt udfald, som ikke måles her] er stadig nødvendig før [kommerciel beslutning].” Den sidste sætning forhindrer, at en forudsigelsesøvelse stiltiende bliver en omsætningsprognose.
Hold samme deltager på 1 side af testen
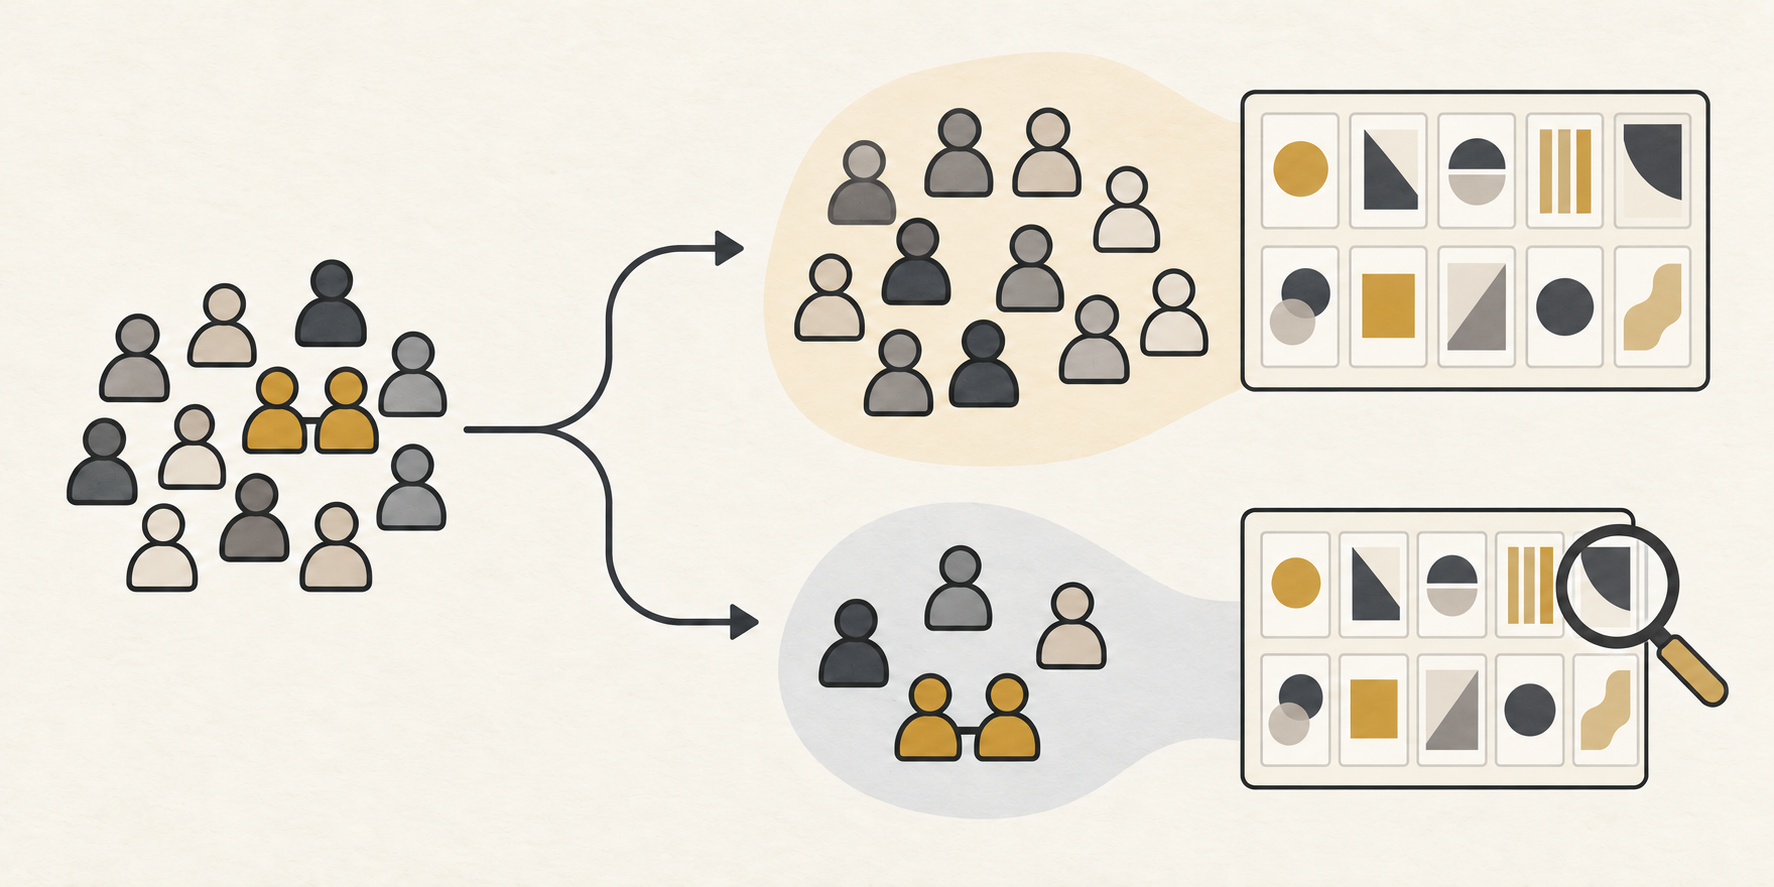
Definér sammenligningen
Angiv produkt, placering, udfald og observationsenhed.
Reservér evalueringsgruppen
Hold hver deltagers besvarelser samlet.
Kontrollér hele resultatet
Sammenlign forudsigelser, og vis hver placering, også dårligere resultater.
Et gennemarbejdet eksempel: en indholdsskaber sammenligner digitale tilbud
Overvej en fiktiv indholdsskaber, der sælger et skrivearbejdshæfte, en workshop og en samlet pakke. Pakken står øverst på en lanceringsside og får flest klik. Indholdsskaberen overvejer at omskrive de øvrige produktbeskrivelser.
Målebriefen ændrer det umiddelbare spørgsmål. Det observerede udfald er et klik, ikke et salg. De tilgængelige registreringer skal vise, hvilke tilbud der blev vist, i hvilken rækkefølge og til hvilke priser. Hvis pakken altid står først, kan registreringerne ikke tydeligt adskille pakken fra den placering.
Indholdsskaberens udfyldte brief kunne sige: ”Vi vil vide, om vores måde at tage højde for placering på forudsiger klik fra nye besøgende. Vi sammenligner samme tilbud og prisoplysninger, holder gentagne observationer samlet og rapporterer den fulde placeringssammenligning. Vi fremsætter ingen købspåstande ud fra klikregistreringer.” Det er et fiktivt eksempel på et målespørgsmål, ikke et foreslået resultat.
Et fornuftigt næste skridt er at planlægge en sammenligning med tilstrækkelig variation til at skelne produkt og placering, mens samme udfaldsdefinition bevares. Indholdsskaberen kunne så sammenligne en enkel placeringsjustering med en mere fleksibel på en reserveret gruppe. Det ville være en ny undersøgelse af siden; bogeksperimentet giver ingen forventet klikrate for den.
Hvis den fleksible tilgang forudsiger klikkene i den reserverede gruppe bedre, har indholdsskaberen en grund til at genoverveje, hvordan rapporten tager højde for placering. Det viser stadig ikke, at flytning af pakken øger omsætningen. En kommerciel beslutning ville kræve evidens om den faktiske præsentationsændring og det udfald, der er vigtigt for virksomheden.
Hvis sammenligningen er uafklaret, bør indholdsskaberen sige det. Ekstra fleksibilitet er ikke automatisk et bedre forretningsværktøj. Den praktiske gevinst er en klarere rækkefølge: Forstå, hvad registreringerne kan adskille, test måleantagelsen, og afgør så, om der kræves et andet eksperiment.
Hvordan beregnede Influence IQ sammenligningen?
Vi brugte forfatternes redigerede svarudgivelse og oprindelige udvælgelsesregler. De første 553 pilot- eller testregistreringer udelades efter deres faste placering i filen. Den resterende ramme indeholder 10.775 besvarelser. Forståelsesfiltrene efterlader 9.344; gennemførelsesfilteret efterlader 9.265.[2]
Samtykke, færdigstatus og reglen om mindst 60 sekunders varighed fjerner ingen yderligere besvarelser på deres respektive trin. Gennemførelse og varighed er filtre efter eksponering, så den bevarede gruppe er en udvalgt stikprøve.
Prolific-deltager-id'er definerer grupperne. En deterministisk hashopdeling tildeler 2/3 af grupperne til træning og resten til test uden at bruge deres valg. I hver gruppe deler alle bevarede besvarelser af første opgave deltagerens bidrag ligeligt. Samme vægtning gælder tilpasning, scoring og placeringstabellerne.[3]
Begge modeller er multinomiale logitmodeller uden regularisering med 9 bogindikatorer og 1 lineært prisled. Baselinemodellen tilføjer 1 lineært placeringsled og har 11 parametre. Den fleksible model tilføjer 9 placeringsindikatorer og har 19. Placering 1 og det numerisk mindste produkt-id udgør referencekategorierne. Alle valgsæt, der opfylder kriterierne, indeholder samme 10 produkter, med valgt id, pris og placering kontrolleret for overensstemmelse.
Vi tilpasser modellerne på træningsgruppen, bevarer de tilpassede koefficienter og scorer derefter testvalgene. Intervallet bruger standardafvigelsen af de parrede deltagerscoreforskelle, 3.088 deltagerenheder og 3.087 frihedsgrader. Det er et omtrentligt Student-t-interval undtagen under dets præcise antagelser om normale scorer. Alle 10 placeringssammenligninger forbliver beskrivende.[4]
Baselinemodellens primære optimeringsalgoritme gav en numerisk advarsel. Den opfyldte stadig alle præcisionsbetingelser specificeret før tilpasning, herunder en sammenligning med en anden start. Vi beholdt den oprindelige tilpasning; de detaljerede diagnostiske kontroller følger med reproduktionsmaterialet.[5]
Downloadmaterialet giver de viste resultater, original analysekode og aggregeret numerisk output. Det udelader kildens svarrækker, deltager-id'er og bogillustrationer. Hent kildedataene særskilt fra forfatternes udgivelse. Influence IQ har ansvar for denne genanalyse og dens fortolkning.
CSV-filen bruger denne sides sprog. Pakken indeholder original beregningskode, oversat metodedokumentation og aggregerede resultater. Kildens svarrækker og bogmaterialer er ikke med; hent dataene særskilt fra forfatternes udgivelse.
Kilder og noter
- Compiani, Morozov og Seiler, Demand Estimation with Text and Image Data, manuskriptversion 4, 17. februar 2026, Section 3 og Appendix C. Forfatterne undersøger allerede reaktioner på placering og pris. Vores sammenligning af deltagere reserveret til evaluering er en original, snævrere genanalyse.
- Forfatternes DeepLogitReplication-udgivelse ved commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Vi følger den redigerede svarfils oprindelige positionsbaserede pilotgrænse og forfatternes kriterier. Bevarede kildedatoer er 11.–26. juni 2024, forskelligt fra manuskriptets beskrivelse af 14.–27. juni; datoer afgør ikke medtagelse.
- Prolific skelner mellem et deltager-id og en undersøgelses- eller besvarelsesidentifikator. Vi bevarer de præcise deltager-id'er til gruppering. Disse id'er verificerer ikke uafhængigt, at hvert id repræsenterer en forskellig person, og fastslår ikke, at en bevaret besvarelse var personens første eksponering.
- Influence IQ’s på forhånd specificerede sammenligning tager gennemsnittet af fleksibel minus baseline-log-sandsynlighed inden for hver testdeltager og derefter på tværs af deltagere. 95 %-intervallet er gennemsnittet plus eller minus den kritiske Student-t-værdi gange deltagerstandardafvigelsen divideret med kvadratroden af 3.088. Det antager uafhængige deltagergrupper, er betinget af faste træningstilpasninger og udelader usikkerhed fra træningstilpasning; et eksakt interval kræver identisk fordelte normale deltagerforskelle med fælles varians.
- Baselinetilpasningen med nulstart gav en præcisionsadvarsel. Dens maksimale absolutte gennemsnitsgradient var 3,12×10⁻⁹, Newton-dekrementet 2,50×10⁻⁸ og den maksimale log-sandsynlighedsforskel med 2 starter 7,46×10⁻⁸, under de på forhånd specificerede grænser 10⁻⁸, 10⁻⁶ og 10⁻⁷. Begge modeller opfyldte også betingelserne om positiv krumning og overensstemmelse mellem målfunktionsværdier. De primære nulstartskoefficienter blev bevaret.
Den engelske artikel er kildeversionen. Sprogversionerne beskriver samme historiske eksperiment; de er ikke landespecifikke købsestimater.