Multivariate test: Hvad du kan lære af at teste kampagnemateriale
At ændre en overskrift og et billede sammen kan hjælpe dig med at vælge en færdig indholdsversion. At lære noget om hvert element kræver en anden sammenligning. Historiske Upworthy-design viser, hvor meget der stadig kan være muligt, selv når nogle kombinationer mangler.
Influence IQ-analyse af Upworthy Research Archives eksplorative delmængde med websiteforsøg fra begyndelsen af 2013 til april 2015. Hovedsammenligningen indeholder 188 test, der varierede både overskriftstekst og billed-ID’er. Det er en opgørelse over design, ikke en analyse af klik eller kampagneresultater.
Resumé
Et ufuldstændigt multivariat design kan stadig bevare særskilte sammenligninger af overskrifter eller billeder. Blandt 188 Upworthy-test, der opfyldte kriterierne og varierede både overskriftstekst og billed-ID’er, indeholdt 31 alle kombinationer. Af de øvrige 157 indeholdt 150 mindst 1 sammenligning, hvor enten overskriften eller billedet blev holdt fast. 75 indeholdt begge slags. Antallene beskriver de tilstedeværende kombinationer, ikke om testene gav pålidelige eller nyttige resultater for indholdet. [1]
Undersøgelsen bruger en historisk eksplorativ delmængde af websiteforsøg fra begyndelsen af 2013 til april 2015, holder uddragsteksten konstant og udelader en dokumenteret periode med mulige problemer med fordelingen fra hovedafgrænsningen. Medtages perioden, fås den samme overordnede pointe: 180 af 199 ufuldstændige design bevarer mindst 1 sådan sammenligning. For virksomheder og indholdsskabere er det praktiske valg at tilpasse kombinationerne til spørgsmålet: at vælge en hel indholdsversion, sammenligne 1 element eller undersøge, hvordan 2 elementer virker sammen.
Dit team har 2 versioner af en kampagne klar. Den ene kombinerer et produktbillede med en direkte overskrift. Den anden bruger et andet billede og en mere samtalende overskrift. Hvis 1 version klarer sig bedre, hvad har du så lært?
En velgennemført sammenligning kan hjælpe dig med at vælge mellem de færdige versioner. Den viser ikke i sig selv, hvilken ændring der gjorde forskellen. Multivariate test varierer mere end 1 element på tværs af et sæt kombinationer. Det nyttige indledende spørgsmål er, hvad kombinationerne skal hjælpe dig med at beslutte.
Antallet af versioner alene besvarer ikke spørgsmålet. 4 overskriftsversioner kombineret med 1 billede lader teamet sammenligne overskrifter i den situation. 2 overskrifter kombineret med 2 billeder giver også 4 indholdsversioner, når alle par medtages, men muliggør andre sammenligninger. At skrive kombinationerne ned gør forskellen synlig, før testen starter.
En færdig indholdsversion rummer flere valg
Ufuldstændige design bevarede ofte en nyttig sammenligning
Vi undersøgte kombinationerne af overskrifter og billeder i de enkelte Upworthy-websitetest. Af 3.212 test, der opfyldte reglerne for hovedafgrænsningen, varierede 188 begge elementer. De fleste af de øvrige varierede kun 1 af dem. Vi holdt hver test særskilt og talte den 1 gang, uanset hvor mange personer der måtte have set den. [2]
Kun 31 af de 188 indeholdt alle kombinationer af deres observerede overskrifter og billed-ID’er. De øvrige 157 var ufuldstændige gitre. Det lyder begrænsende, indtil man spørger, hvilke sammenligninger der stadig var mulige i gitrene. Af de 157 design havde 75 både en overskriftssammenligning med samme billede og en billedsammenligning med samme overskrift. Yderligere 30 havde kun den første slags, og 45 havde kun den anden. 7 havde ingen af dem.
Tilsammen bevarede 150 af de 157 ufuldstændige design, svarende til 95,5 %, mindst 1 måde at sammenligne et element på, mens det andet blev holdt fast. Det beviser ikke, at nogen sammenligning havde tilstrækkelig trafik, en forsvarlig fordeling eller et meningsfuldt resultat. Det viser dog, hvorfor ”ikke alle kombinationer blev testet” er en for bred grund til at afvise et design.
Tabellen viser komplette og ufuldstændige design sammen. Blandt alle 188 indeholdt 106 begge sammenligningstyper, 30 kun overskriftssammenligninger, 45 kun billedsammenligninger og 7 ingen af delene. ”Begge” betyder mindst 1 af hver. Det betyder ikke, at hver overskrift eller hvert billede kan sammenlignes på lige vilkår.
Den oprindelige arkivartikel forklarer allerede, at redaktører ofte valgte indholdsversioner uden at teste alle mulige kombinationer. Vores bidrag er denne opgørelse over de sammenligninger, valgene efterlod som muligheder. Vi kan ikke rekonstruere hver redaktørs mål eller vurdere, om et design opfyldte det. [1]
De fleste design, der ændrede begge elementer, bevarede en sammenligning af en komponent
188 historiske Upworthy-test, der opfylder kriterierne og varierer overskriftstekst og billed-ID’er, med konstant uddragstekst og den angivne datorestriktion. Hver test har samme vægt.
| Sammenligninger i designet | Test | Andel af 188 test |
|---|---|---|
| Sammenligninger af overskrifter og billeder | 106 | 56,4 % |
| Kun sammenligning af overskrifter | 30 | 16,0 % |
| Kun sammenligning af billeder | 45 | 23,9 % |
| Ingen sammenligning af komponenter | 7 | 3,7 % |
3 design besvarer forskellige spørgsmål
Forestil dig et keramikværksted, der markedsfører et weekendkursus. Det har 2 overskrifter: A, ”Lav din første keramikskål”, og B, ”Tilbring lørdagen ved drejeskiven”. Billede 1 viser en færdig skål, og billede 2 viser drejeskiven. Det er illustrative valg, ikke Upworthy-eksempler eller målte kampagneresultater. Hold tilbuddet og den øvrige viste tekst ens, mens du overvejer 3 mulige design.
Det første design er et fuldt gitter: A med billede 1, A med billede 2, B med billede 1 og B med billede 2. Teamet kan sammenligne overskrifterne, mens billede 1 holdes fast, og derefter foretage den samme overskriftssammenligning med billede 2. Det kan også sammenligne billederne under hver overskrift. 4 celler giver disse muligheder. De fastslår ikke, hvor meget evidens der bliver indsamlet i hver celle.
Det andet design er et delvist gitter: A med billede 1, B med billede 1 og B med billede 2. A med billede 2 mangler. Teamet kan sammenligne A og B, mens billede 1 holdes fast. Det kan særskilt sammenligne billederne, mens overskrift B holdes fast. Den manglende celle fjerner ikke de 2 sammenligninger.
Men det delvise gitter lader et andet spørgsmål stå ubesvaret af en direkte sammenligning med 4 celler: Ville forskellen mellem A og B se ens ud med billede 2? Der er intet resultat for A med billede 2 at bruge. Teamet kan heller ikke identificere den bedste af alle 4 mulige indholdsversioner ved blot at vælge blandt de 3 observerede. Den uprøvede version kunne opføre sig anderledes.
Det tredje design er diagonalt og indeholder kun A med billede 1 og B med billede 2. Ingen af elementerne holdes fast mellem de 2 indholdsversioner. En gyldig test kunne stadig understøtte valget mellem de 2 færdige versioner. Den ville ikke særskilt identificere et bidrag fra overskriften eller billedet ud fra den sammenligning alene.
Ingen af disse design er universelt bedst. Hvis værkstedet skal vælge mellem 2 godkendte koncepter til en bestemt lancering, kan en sammenligning af indholdsversionerne passe til opgaven. Hvis det vil genbruge en overskrift på tværs af billeder, har det brug for evidens, der er relevant for det bredere valg. Yderligere kombinationer fortjener deres plads ved at besvare et spørgsmål, teamet faktisk har. [3]
3 illustrative design indeholder forskellige kombinationer
Et fiktivt eksempel med et keramikværksted med 2 overskrifter, A og B, og 2 billeder, 1 og 2. Cellerne illustrerer design og er ikke observationer fra arkivet.
| Kombination af overskrift og billede | Fuldt gitter | Delvist gitter | Diagonalt design |
|---|---|---|---|
| Overskrift A + billede 1 | 1 | 1 | 1 |
| Overskrift A + billede 2 | 1 | 0 | 0 |
| Overskrift B + billede 1 | 1 | 1 | 0 |
| Overskrift B + billede 2 | 1 | 1 | 1 |
En sammenligning i hver retning er ikke en fuld 2×2-test
Arkivet gør forskellen konkret. Af de 106 design med begge sammenligningstyper indeholdt 74 ikke engang 1 komplet rektangel med 2 overskrifter og 2 billeder. Et design kan derfor give en overskriftssammenligning ét sted og en billedsammenligning et andet sted uden at levere de 4 celler, der kræves for en direkte sammenligning af forskellene.
Se igen på værkstedets delvise gitter. At sammenligne A og B med billede 1 stiller 1 spørgsmål. At sammenligne billede 1 og billede 2 under B stiller et andet. Ingen af delene fortæller os, om selve forskellen mellem overskrifterne ændres, når billedet ændres. Det tredje spørgsmål handler om en interaktion: om sammenhængen mellem 1 element og responsen afhænger af det andet element.
I sættet med 188 design indeholdt 32 mindst 1 komplet rektangel. Det omfatter alle 31 komplette gitre og 1 større, ufuldstændigt gitter. Et sådant rektangel giver et sted at danne en direkte interaktionskontrast. Det viser ikke, at der findes en interaktion, og det er ikke det eneste mulige grundlag for at undersøge interaktioner med andre design eller modelantagelser.
For et kampagneteam hører forskellen hjemme i briefen, før den hører hjemme i en statistisk model. ”Sammenlign de 2 overskrifter med dette billede” er en snævrere anmodning end ”find en overskrift, der virker på tværs af vores billeder”. Et resultat, der besvarer det første spørgsmål, bør ikke ubemærket blive svaret på det andet.
Det bredere datointerval giver samme pointe for planlægningen
Hovedopgørelsen udelader test, hvis spænd af oprettelsesdatoer berører perioden fra 25. juni 2013 til 10. januar 2014. Arkivets forskere identificerede mulige problemer med fordelingen i perioden. Det er relevant for forskning i årsag og virkning, men gør ikke kombinationsposterne ubrugelige til en strukturel opgørelse. Vi gentog derfor også sammenligningen med perioden medtaget. [4]
Den bredere afgrænsning indeholder 239 test, der varierer begge elementer. 40 indeholder alle kombinationer, mens 199 er ufuldstændige. Blandt de ufuldstændige design bevarer 180, svarende til 90,5 %, mindst 1 sammenligning, der holder 1 element fast. 93, svarende til 46,7 %, bevarer begge slags. De tilsvarende tal i hovedafgrænsningen er 95,5 % og 47,8 %. De præcise andele ændres, men ufuldstændige design bevarer stadig ofte en konkret sammenligning.
Vi kontrollerede også et valg i tekstbehandlingen. Hovedanalysen sammenligner overskrifts- og uddragstekst nøjagtigt. Fjernelse af blanktegn ved kanterne og sammentrækning af gentagne blanktegn giver 189 test, der varierer begge elementer, med 31 komplette gitre, 108 med begge sammenligningstyper og 32 med et komplet rektangel. Kontrollen ændrer, hvilke design der opfylder kriterierne, så antallene vises med deres egen nævner. [5]
Medianen for dækningen er 50 % i alle 3 afgrænsninger. Dækningen er antallet af observerede kombinationer af overskrift og billede divideret med antallet af mulige kombinationer ud fra testens observerede overskrifter og billed-ID’er. Medianen er en beskrivelse, ikke en kvalitetsscore. En manglende kombination kan have været irrelevant, uegnet eller uden for redaktørens tilsigtede sammenligning. Arkivet afgør ikke, hvorfor den blev udeladt.
Ændret afgrænsning bevarer forskellen mellem dækning og sammenligninger
Alle kolonner tæller test, og hver række bruger sin egen nævner for test, der varierer begge elementer. Kontrollen af tekstbehandling beholder hovedafgrænsningens datorestriktion. Kontrollen med alle perioder beholder den nøjagtige tekstbehandling.
| Analyseafgrænsning | Test, der ændrer begge elementer | Komplette gitre | Begge sammenligningstyper | Mindst 1 komplet 2×2 |
|---|---|---|---|---|
| Hovedafgrænsning: nøjagtig tekst, datorestriktion | 188 | 31 | 106 | 32 |
| Tekst med normaliserede blanktegn, datorestriktion | 189 | 31 | 108 | 32 |
| Nøjagtig tekst, alle perioder medtaget | 239 | 40 | 133 | 42 |
Skriv den næste testbrief med udgangspunkt i beslutningen
For keramikværkstedet bør du begynde med at beslutte, hvad der skal ske efter testen. Skal teamet vælge 1 færdig version af markedsføringen for kurset, beholde 1 billede og ændre overskriften eller tage en overskrift med i flere fremtidige design? Hver beslutning kræver sit eget sæt sammenligninger. Et større gitter er ikke automatisk en bedre brug af teamets indsats.
Hvis beslutningen vedrører færdige indholdsversioner, så angiv dem uden at love en forklaring på hver del. Hvis beslutningen vedrører en overskrift, så angiv det billede, der holdes fast. Hvis teamet skal undersøge, om en forskel mellem overskrifter ændres på tværs af 2 billeder, så medtag de relevante 4 kombinationer eller få et begrundet alternativt design. Hold det adskilt fra beslutningen om responsmål, fordeling og observationsperiode.
Kontrollér, om de foreslåede kombinationer giver mening, før de tilføjes. En overskrift om et bestemt tilbud kan høre sammen med kun 1 produktbillede. At lave en uegnet kombination bare for at udfylde et gitter ville ændre opgaven. Teamet kan i stedet indsnævre spørgsmålet eller udvikle versioner, der giver mening sammen. Et fuldt gitter er nyttigt, når sammenligningerne tjener beslutningen, ikke fordi en udfyldt tabel ser mere grundig ud.
Brug følgende felter som en kort planlægningsbrief. Teksten i kantede parenteser er til din egen kampagne, ikke et resultat fra denne undersøgelse.
Beslutning efter testen: [vælg en færdig indholdsversion; sammenlign et navngivet element i en bestemt situation; undersøg en bestemt kombination af elementer].
Elementer og versioner: [præcise overskriftstekster; billedfiler eller stabile ID’er; andet indhold, der ændres].
Medtagne indholdsversioner: [de par af overskrift og billede, som faktisk bliver vist].
Nødvendige sammenligninger: [hvilke par der holder et element fast; hvilke 4 celler der understøtter spørgsmålet om interaktion, hvis det er relevant].
Evidensplan: [responsmål; målgruppe og fordeling; eksponeringsbetingelser; planlagt observation og regel for gennemgang].
Grænse for konklusionen: [hvad designet kunne understøtte; hvilke uprøvede kombinationer eller situationer der ligger uden for beslutningen].
Et værksted med det delvise design på 3 celler kan for eksempel skrive: ”Vi vil sammenligne overskrifterne med billede 1 og sammenligne billederne med overskrift B. Vi tester ikke overskrift A med billede 2.” Sætningen holder 2 nyttige spørgsmål og den manglende sammenligning synlige uden at erklære designet utilstrækkeligt.
En indholdsskaber, der laver arbejde for en kunde, kan bruge samme skelnen, når et ændret miniaturebillede og en ændret titel drøftes. Spørgsmålet er, hvilken version eller hvilket element kunden vil vælge. Vores optællinger stammer dog fra en udgivers website og fastslår ikke, hvordan en aktuel social platform fordeler eller måler indholdsvarianter.
Hold spørgsmålet ved siden af kombinationerne
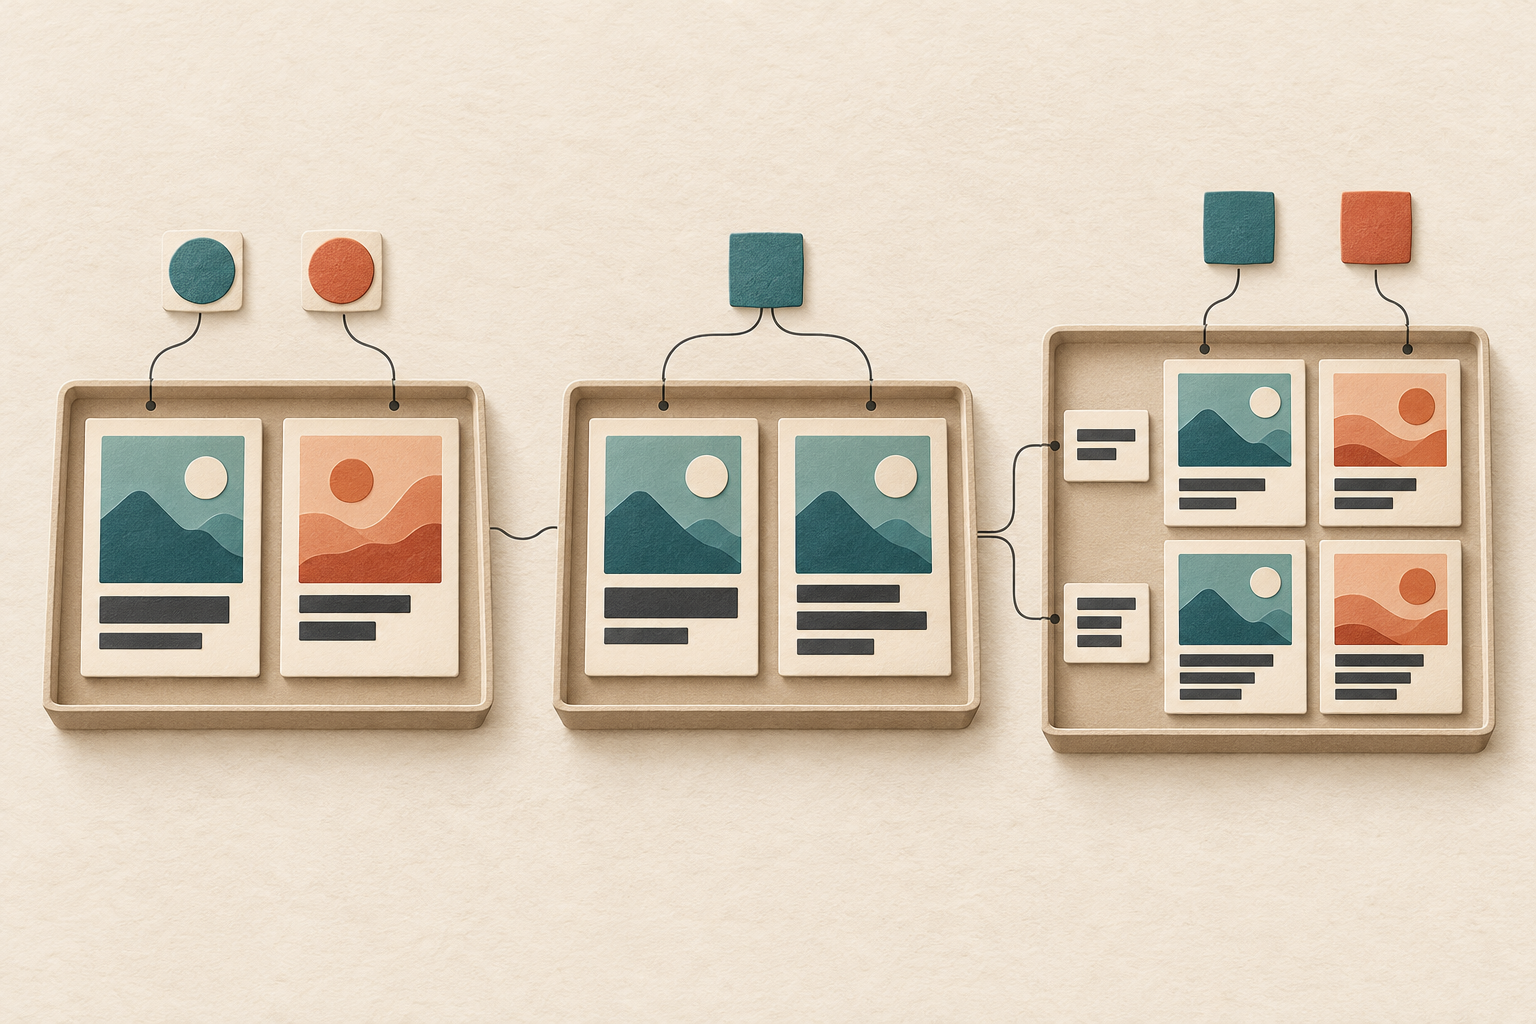
Vælg en færdig indholdsversion
Sammenlign de indholdsversioner, der er kandidater til beslutningen.
Sammenlign 1 element
Hold det andet element fast i den sammenligning, du har brug for.
Undersøg kombinationen
Medtag de kombinationer, der kræves for at undersøge, om en forskel mellem overskrifter ændres på tværs af billeder.
Sådan blev opgørelsen over design lavet
Kilden er den offentligt udgivne eksplorative fil fra Upworthy Research Archive, beskrevet af J. Nathan Matias, Kevin Munger, Marianne Aubin Le Quere og Charles Ebersole. Den indeholder 22.666 rækker med indholdsversioner grupperet i 4.873 test fra det historiske arkiv fra 2013–2015. Vi brugte overskrift, billedidentifikator, uddrag, testidentifikator, oprettelsestidsstempel og arkivets rækkeindeks. Klik, visninger og redaktionelle valg blev ikke brugt. [1] [6]
En strukturel gennemførlighedskontrol kom før den endelige plan for designgennemgangen og var med til at forme spørgsmålet. Gennemgangen er derfor en eksplorativ genanalyse, ikke en forhåndsregistreret bekræftende undersøgelse. De angivne regler beholder test med brugbare strukturelle felter, anvender hovedafgrænsningens datorestriktion og kræver identisk uddragstekst på tværs af deres indholdsversioner. Kravet om ens uddrag er konservativt, fordi artiklen og arkivdokumentationen er uenige om, hvorvidt feltet blev vist. [6]
Udvælgelsestabellen viser successive udelukkelser efterfulgt af en opdeling af testene, der opfylder kriterierne. 5 test mangler en overskrift eller et billed-ID. Derefter opfylder 1.050 ikke datoreglen, og 606 har varierende uddrag. De 3.212 medtagne test omfatter 1.624, der kun varierer overskrifter, 1.078, der kun varierer billed-ID’er, 188, der varierer begge, og 322 med 1 observeret kombination. Den sidste kategori kan stadig indeholde flere kilderækker.
Inden for en test tæller gentagne identiske par af overskrift og billede 1 gang som designceller. 5 af de 188 test, der varierer begge elementer, indeholder gentagne celler. Et fuldt gitter indeholder alle parringer af de overskriftstekster og billed-ID’er, der er observeret i testen. Forskellige tekststrenge behøver ikke at udtrykke forskellige idéer, og forskellige billed-ID’er behøver ikke at repræsentere synligt forskellige billeder. Billedfilerne er ikke tilgængelige.
Resultaterne vægter design lige, ikke personer, visninger eller virksomheder. De fastslår ikke nutidig markedsføringspraksis, indholdets resultater eller statistisk styrke. Downloadfilerne indeholder de aggregerede resultater og reproduktionsmetoden, herunder begge afgrænsningskontroller, så læserne kan undersøge forskellen mellem en observeret kombination og en konklusion, der drages ud fra den. [7]
Hovedsammenligningen begynder med 188 af 3.212 test, der opfylder kriterierne
Udvælgelse fra de 4.873 test i den offentlige eksplorative fil. Udelukkelserne anvendes i den viste rækkefølge. De 4 endelige designkategorier opdeler de 3.212 test, der opfylder kriterierne.
Se udvælgelsestrinnene og alle kategorier, der opfylder kriterierne
| Udvælgelsestrin eller designkategori, der opfylder kriterierne | Test |
|---|---|
| Oprindelige eksplorative test | 4.873 |
| Udeladt: manglende overskrift eller billed-ID | 5 |
| Udeladt: angivet interval for oprettelsesdatoer | 1.050 |
| Derefter udeladt: varierende uddragstekst | 606 |
| Opfylder kriterierne efter udelukkelser | 3.212 |
| Opfylder kriterierne: overskrift varierer, billede holdes fast | 1.624 |
| Opfylder kriterierne: billede varierer, overskrift holdes fast | 1.078 |
| Opfylder kriterierne: både overskrift og billede varierer | 188 |
| Opfylder kriterierne: 1 observeret kombination | 322 |
- Download figurværdier og labels for afgrænsning (CSV)
- Download resultater, strukturelle testposter og analysekode (ZIP)
CSV-filen indeholder 41 værdier fra de 4 figurer med illustrative designceller mærket særskilt fra observerede antal og andele. ZIP-filen indeholder aggregerede resultater, strukturelle testposter og analysekode. Oversat vejledning til genskabelse medfølger. Download det oprindelige offentlige arkiv særskilt. Ingen klik- eller visningsresultater er medtaget.
Kilder og noter
- Matias, J. Nathan; Munger, Kevin; Aubin Le Quere, Marianne; og Ebersole, Charles (2021), The Upworthy Research Archive, a time series of 32,487 experiments in U.S. media, Scientific Data 8, 195. DOI: 10.1038/s41597-021-00934-7. Analysen fra Influence IQ bruger den eksplorative delmængde og den rettede kildebeskrivelse. Den oprindelige artikel forklarer kvalitativt, at redaktører ofte ikke testede alle kombinationer af overskrift og billede.
- Hovednævner for test, der varierer begge elementer: 188 test. Komplette gitre: 31. Ufuldstændige: 157. Den ufuldstændige gruppe indeholder 75 med begge sammenligningstyper, 30 med kun overskriftssammenligninger, 45 med kun billedsammenligninger og 7 med ingen af delene. Derfor bevarer 150/157 = 95,5 % mindst 1 type. ”Sammenligning” identificerer en strukturel mulighed, ikke en estimeret effekt eller et bekræftet gyldigt forsøg.
- De 3 værkstedsdesign er illustrative. Et fuldt design med 2 faktorer og 2 niveauer indeholder alle 4 kombinationer. Det delvise eksempel udelader A med billede 2. Det diagonale eksempel beholder kun A med billede 1 og B med billede 2. Et design med 4 celler alene fastslår ikke fordelingens kvalitet, en tilstrækkelig stikprøvestørrelse eller en meningsfuld interaktion. NIST-håndbogen forklarer fuldfaktorielle forsøgsdesign og deres kombinationer.
- Arkivets rettelse fra juni 2024 identificerer mulige randomiseringsproblemer fra 25. juni 2013 til 10. januar 2014 og fraråder forskning i årsagsvirkninger med den periode. Den fastholder udtrykkeligt andre forskningsanvendelser. Vores hovedanalyse udelader enhver test, hvis spænd af oprettelsesdatoer overlapper intervallet. Tidsstemplerne beviser ikke eksponeringsdatoer, og deres tidszone er ukendt. Den strukturelle kontrol for alle perioder beholder de poster.
- Følsomhedskontrollen for blanktegn fjerner indledende og afsluttende blanktegn og sammentrækker interne blanktegn i overskrifts- og uddragstekst, mens store og små bogstaver samt tegnsætning bevares. 8 test bliver kvalificerede. 1 fælles kvalificeret test ændrer strukturel klassifikation. Nævnerne genberegnes frem for at holdes på 188. Hovedafgrænsningen, blanktegnsafgrænsningen og afgrænsningen med alle perioder indeholder henholdsvis 188, 189 og 239 test, der varierer begge elementer.
- Den fastlåste eksplorative CSV-fil er upworthy-archive-exploratory-packages-03.12.2020.csv, OSF-filversion 1, 14.260.949 bytes. Dens SHA-256 er 8368313b060f4015a0c6fb34e6d788163cee29554144aba9390b14922eb9d8ce. Filen har ingen opdateret problemmarkering, så datorestriktionen udledes særskilt. Artiklen beskriver uddragstekst som vist, mens arkivdokumentationen opregner den blandt felter, der ikke menes at være vist. At holde uddraget konstant undgår at tilskrive forskelle på tværs af det omstridte felt.
- Cornell University udgiver Upworthy Research Archive med tilknyttet kode og dokumentation under Creative Commons Attribution 4.0 International. Influence IQ leverer denne afledte strukturelle analyse. Det indebærer ingen anbefaling fra Upworthy eller arkivets forfattere. Analysepakken indeholder aggregerede resultater, strukturelle testposter, kode og oversat vejledning til genskabelse. Hent de oprindelige offentlige data særskilt fra arkivet.
Den engelske artikel er kildeudgaven. Hver sprogudgave beskriver den samme historiske eksplorative delmængde fra Upworthy og de samme illustrative design. Oversættelse gør ikke resultaterne til et benchmark for et lokalt marked eller en aktuel platform.