Prezentace produktů v e-shopu: otestujte předpoklady o jejich pozici
Historický experiment s 10 knihami ukazuje, jak jednoduchá úprava podle umístění může přehlédnout části vzorce a jak tento předpoklad otestovat před porovnáním produktových karet.
Původní reanalýza zveřejněného experimentu s výběrem knih z roku 2024 od autorů Compiani, Morozov a Seiler.
Abstrakt
Než podnik rozhodne, že je jedna nabídka silnější než jiná, musí zvážit, kde se každá objevila. Pomocí zveřejněného experimentu z roku 2024 s 10 e-knihami jsme otestovali 2 způsoby zohlednění pozice. Samostatná úprava pro každou pozici předpovídala volby celkově lépe než stejná úprava pro každý krok dolů v seznamu. Na některých jednotlivých pozicích byla méně přesná, takže záleží na úplném porovnání.
Oba modely používaly stejné informace o knize a ceně. Odhadli jsme je na 6 176 účastnících a jejich predikce ověřili na dalších 3 088. Volby byly hypotetické a každý musel vybrat knihu. Pro podniky a tvůrce porovnávající produktové karty z toho plyne testovat předpoklady o umístění před připsáním výsledků nabídce. Studie neodhaduje zvýšení prodejů ani neurčuje nejlepší pořadí produktů.
Předpokládejme, že produkt nahoře na stránce získá nejvíce kliknutí. Je silnější nabídkou, nebo mu pomohlo místo v seznamu? Podnik potřebuje užitečnou odpověď před přepsáním ostatních karet, zlevněním zdánlivě slabších položek či změnou sortimentu.
Zohlednění pozice zní přímočaře, dokud se nezeptáte jak. Má každý posun dolů v seznamu dostat stejnou úpravu? Pomocí historického experimentu jsme tento jednoduchý přístup porovnali s pružnějším a potom oba otestovali na účastnících nepoužitých pro odhad modelu.
Stejné produkty, různé pozice
Co vám má porovnání pozice produktů říct?
Porovnání produktových karet má pomoci oddělit nabízenou položku od způsobu prezentace. Pokud je jeden produkt obvykle první a jiný poslední, jejich samotné součty neodpovídají, zda nakupující upřednostňují jednu nabídku.
Jednoduchý testovaný přístup dává každému kroku dolů v seznamu stejnou úpravu vnitřního skóre preference modelu. Užitečnou otázkou je, zda předpovídá volby dostatečně dobře oproti povolení různých úprav pro různé pozice.
Tyto 2 přístupy jsme otestovali pomocí zveřejněného experimentu s výběrem knih. Výsledek je relevantní pro podniky a tvůrce porovnávající produkty na stránce kolekce či v digitální výloze. Dodává způsob zkoumání předpokladu měření, nikoli pravidlo pro umístění nejprodávanější položky.
To je důležité, když se nabídka objevuje na více místech. Tvůrce může stejný soubor ke stažení představit v kolekci i na stránce uvedení produktu. Prodejce může změnit pořadí seznamu kategorie. Položka, cena, publikum a prezentace se mohou lišit současně. Úprava podle pozice je předpokladem o části porovnání a zaslouží si vlastní kontrolu.
Co lidé v experimentu s knihami vybrali?
Giovanni Compiani, Ilya Morozov a Stephan Seiler požádali účastníky získané přes Prolific o hypotetické volby z 10 e-knih s náhodným pořadím a cenami. Účastníci museli vybrat knihu; možnost nekoupit nic nebyla. Používáme první úkol v každém ponechaném podání, nikoli pozdější úkol odstraňující vybranou knihu.[1]
Autoři už uvádějí reakce na pořadí a cenu. Jejich širší výzkum zkoumá, jak text a obrázky pomáhají odhadovat nahrazování produktů. Naše otázka je užší: zlepší náhrada jediného členu pozice predikci pro účastníky, jejichž volby nebyly použity k odhadu modelu?
Po použití původních pravidel způsobilosti zbývá 9 265 podání s 9 264 odlišnými ID účastníků Prolific. 1 ID se objevuje dvakrát. Obě podání ponecháváme společně a tomuto účastníkovi dáváme stejnou celkovou váhu jako každému jinému. Podání není automaticky samostatnou osobou a první úkol není nutně prvním setkáním tohoto člověka s experimentem.[2][3]
Ponechaná zdrojová data sahají od 11. do 26. června 2024. Rukopis uvádí 14.–27. června, proto rozdíl zveřejňujeme a podle data nic nevylučujeme. Způsobilost podle země a věku nebyla v prostudovaných materiálech doložena; nejde o odhady pro americké nakupující ani jinou národní populaci.[1][2]
Podání téhož účastníka zůstávají společně po celé porovnání
Vybraná podání prvního úkolu podle původních pravidel způsobilosti autorů; data v ponechaných zdrojových záznamech 11.–26. června 2024.
| Skupina | Účastníci (podle ID platformy) | Ponechaná podání |
|---|---|---|
| Všichni ponechaní | 9 264 | 9 265 |
| Trénování | 6 176 | 6 176 |
| Vyčleněno pro vyhodnocení | 3 088 | 3 089 |
Který model pozice lépe předpovídal volby vyčleněné skupiny?
Pružný model pozice předpovídal volby vyčleněné skupiny lépe podle předem stanoveného měřítka skóre. Oba modely zohledňují nabízenou knihu a zobrazenou cenu. Liší se pouze způsobem zachycení pozice.
Výchozí model používá 1 koeficient pro každý krok dolů v seznamu. Pružný model používá samostatné úpravy pro pozice 2 až 10 vůči první. To mu dává více volnosti, ale také více parametrů k odhadu. Lepší shoda s vlastními trénovacími daty by sama porovnání nevyřešila.
Proto jsme oba modely odhadli pomocí 6 176 účastníků a vyhodnotili na ostatních 3 088. Každé podání téhož účastníka zůstalo na stejné straně rozdělení. Testovací skupina obsahuje 3 089 podání, protože zahrnuje opakovaného účastníka.
Pro porovnání predikcí jsme použili záporné logaritmické skóre. Model dostane menší penalizaci, když přidělí vyšší pravděpodobnost volbě, kterou člověk skutečně udělá. Větší penalizaci dostane při velmi malé pravděpodobnosti této volby. Nižší průměrné záporné logaritmické skóre je lepší.
Průměr vyčleněné skupiny byl 2,2260 pro výchozí a 2,2154 pro pružný model v jednotkách přirozeného logaritmu zvaných nats. Jde o skóre predikcí, nikoli procenta správných odpovědí. Trénovací a testovací skóre jsou uvedena společně, aby se porovnání neopíralo o snazší úkol popisu dat, která model už viděl.
2 modely vyhodnocené na stejných účastnících
Vybrané volby prvního úkolu s 10 knihami z roku 2024. Trénování: 6 176 účastníků i podání. Test: 3 088 účastníků a 3 089 podání.
| Model pozice | Trénovací skóre (nats) | Skóre vyčleněné skupiny (nats) |
|---|---|---|
| 1 lineární člen pozice | 2,2046 | 2,2260 |
| Samostatné členy pozice | 2,1899 | 2,2154 |
Párové zlepšení činilo 0,0106 nats na účastníka s přibližným 95% intervalem od 0,0044 do 0,0168. Kladné zlepšení zde zvýhodňuje pružný model. Výsledek je na této škále skóre malý, ale interval leží nad nulou.[4]
Tento interval považuje 2 odhadnuté modely za pevné a předpokládá nezávislé skupiny účastníků. Nezahrnuje nejistotu odhadu modelů na jiném trénovacím vzorku. Zjištění podporuje zlepšení predikcí v tomto vybraném historickém úkolu; nedělá z rozdílu skóre nárůst prodejů.
Pružný model zlepšuje logaritmické skóre vyčleněné skupiny
Párové porovnání mezi 3 088 testovacími účastníky ve vybraném historickém úkolu s 10 knihami.
| Porovnání | Zlepšení (nats) | 95% interval: dolní mez (nats) | 95% interval: horní mez (nats) |
|---|---|---|---|
| Logaritmické skóre pružného minus výchozího modelu | 0,0106 | 0,0044 | 0,0168 |
Kde se 2 modely odchýlily od pozorovaných voleb?
Úplné porovnání pozic ukazuje, proč celkové skóre potřebuje podrobnosti. Pro každou pozici porovnáváme pozorovaný podíl voleb s průměrnou pravděpodobností přidělenou každým modelem. Jde o průměry se stejnou vahou účastníků ve vyčleněné skupině, nikoli míry prokliku.
Na pozici 1 činil pozorovaný podíl 17,16 %. Výchozí model předpověděl 14,64 %, pružný 17,73 %. Na pozici 10 byl pozorovaný podíl 9,18 % oproti predikcím 6,37 % a 8,74 %. Pružný model byl blíže na obou koncích tohoto konkrétního seznamu.
Pozorované a předpovězené volby na všech 10 pozicích
Vyčleněná skupina: 3 088 účastníků a 3 089 podání prvního úkolu ze zveřejněného experimentu 2024.
| Pozice | Pozorovaný podíl voleb | Průměrná pravděpodobnost výchozího modelu | Průměrná pravděpodobnost pružného modelu | Podání s danou volbou |
|---|---|---|---|---|
| Pozice 1 | 17,16 % | 14,64 % | 17,73 % | 530 |
| Pozice 2 | 13,60 % | 13,20 % | 14,84 % | 420 |
| Pozice 3 | 9,91 % | 12,06 % | 9,74 % | 306 |
| Pozice 4 | 10,91 % | 11,21 % | 9,26 % | 337 |
| Pozice 5 | 9,20 % | 10,09 % | 8,94 % | 284 |
| Pozice 6 | 7,08 % | 9,25 % | 8,01 % | 219 |
| Pozice 7 | 8,00 % | 8,44 % | 7,57 % | 247 |
| Pozice 8 | 7,12 % | 7,67 % | 7,47 % | 220 |
| Pozice 9 | 7,84 % | 7,08 % | 7,69 % | 242 |
| Pozice 10 | 9,18 % | 6,37 % | 8,74 % | 284 |
Pružný model nebyl blíže všude. Na pozici 4 byl pozorovaný podíl 10,91 %. Výchozí model předpověděl 11,21 %, pružný 9,26 %. Dodatečná pružnost zlepšila celkové skóre vyčleněné skupiny, ale na této pozici ponechala větší odchylku.
Další tabulka ukazuje pozorované minus předpovězené podíly. Kladný rozdíl znamená, že model předpověděl příliš málo voleb na této pozici; záporný příliš mnoho. Zachování všech 10 pozic brání tomu, aby příznivě vypadající konec zastupoval celé porovnání.
Odchylky obou modelů od pozorovaných voleb
Pozorovaný podíl voleb minus průměrná předpovězená pravděpodobnost pro každou z 10 pozic se stejnými 3 088 testovacími účastníky.
| Pozice | Pozorované minus výchozí model | Pozorované minus pružný model |
|---|---|---|
| Pozice 1 | 2,52 procentní body | -0,57 procentní body |
| Pozice 2 | 0,41 procentní body | -1,24 procentní body |
| Pozice 3 | -2,15 procentní body | 0,17 procentní body |
| Pozice 4 | -0,29 procentní body | 1,65 procentní body |
| Pozice 5 | -0,89 procentní body | 0,26 procentní body |
| Pozice 6 | -2,17 procentní body | -0,93 procentní body |
| Pozice 7 | -0,44 procentní body | 0,43 procentní body |
| Pozice 8 | -0,55 procentní body | -0,35 procentní body |
| Pozice 9 | 0,76 procentní body | 0,14 procentní body |
| Pozice 10 | 2,81 procentní body | 0,44 procentní body |
Tyto řádky pozic jsou popisné bez samostatných tvrzení o významnosti. Experiment neměřil pohyby očí ani pozornost a analýza neurčuje důvod rozdílu pozice. Ani zakřivený vzorec pozorovaných podílů sám o sobě nevyvrací výchozí model: jeho člen pozice je lineární ve vnitřním skóre preference modelu, nikoli v procentech voleb.
Prosté odečtení prvního a posledního pozorovaného podílu by odpovídalo na jinou otázku. Tyto podíly shrnují volby napříč produkty a cenami. Oba odhadnuté modely zohledňují identitu a cenu knihy před přidělením pravděpodobností 10 možnostem. Ani rozdíl konců, ani porovnání modelů neříká, co by se stalo při přesunu konkrétního produktu ve skutečném obchodě.
Použitelná šablona měření pozice produktu
Před porovnáním nabídek napište stručné zadání měření. Následující šablona je volně dostupná a ilustrativní. Používá poučení studie o kontrole předpokladů; neslibuje, že stejný model vyhoví vašemu obchodu.
Rozhodnutí: „Potřebujeme rozhodnout o [porovnání produktů či změně prezentace] pro [stránku či kampaň] během [období].“ Pojmenujte rozhodnutí před výběrem příznivého měřítka.
Výsledek: „Budeme měřit [volbu, kliknutí, přidání do košíku či nákup].“ Vyberte výsledek skutečně podložený záznamy. Ponechte u něj nabízené alternativy, jejich pořadí a zobrazené ceny. Výsledek vynucené volby má zůstat oddělený od výsledku nákupu.
Jednotka: „Naší jednotkou je [účastník či jiná jasně vymezená jednotka]. Opakované návštěvy či podání vyřešíme podle [pravidla].“ Pozorování stejného člověka ponechte společně při hodnocení predikcí pro nové lidi. Nepovažujte anonymní identifikátor relace za důkaz jedinečné osoby.
Porovnání: „Oba modely použijí stejné produkty, cenové informace a způsobilá pozorování. Budou se lišit v [předpokladu pozice].“ Určete jednoduchou alternativu i pružnější variantu.
Vyhodnocení: „Před odhadem vyčleníme [vymezenou skupinu] a porovnáme [pojmenované měřítko skóre]. Ukážeme všechny pozice.“ Před zhlédnutím výsledku rozhodněte, jak uvedete nevyřešený či horší výsledek.
Použití: „Tento výsledek pomůže při [rozhodnutí o měření]. Před [obchodním rozhodnutím] stále potřebujeme důkazy o [zde neměřeném obchodním výsledku].“ Poslední věta brání nenápadné změně predikčního cvičení na předpověď tržeb.
Ponechte stejného účastníka na jedné straně testu
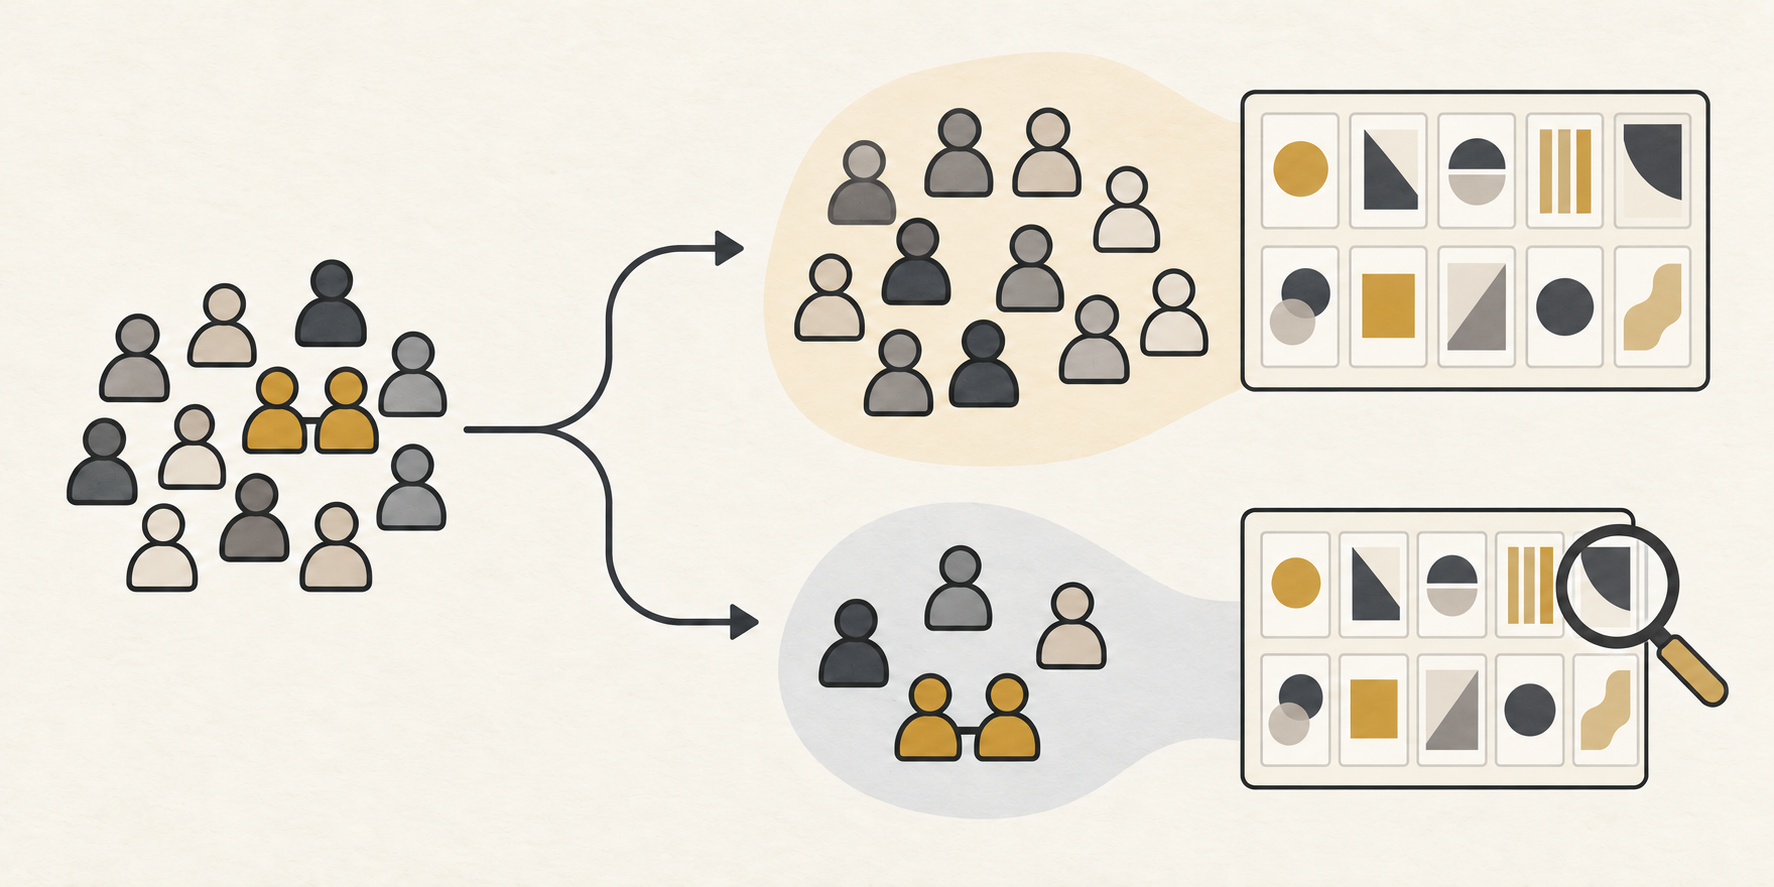
Vymezte porovnání
Pojmenujte produkt, pozici, výsledek a jednotku pozorování.
Vyčleňte hodnoticí skupinu
Podání každého účastníka ponechte společně.
Zkontrolujte úplný výsledek
Porovnejte predikce a ukažte každou pozici včetně horších výsledků.
Názorný příklad: tvůrce porovnává digitální nabídky
Zvažme fiktivního tvůrce prodávajícího pracovní sešit k psaní, seminář a balíček. Balíček se objevuje nahoře na stránce uvedení a dostává nejvíce kliknutí. Tvůrce zvažuje přepsání ostatních produktových popisů.
Zadání měření mění bezprostřední otázku. Pozorovaným výsledkem je kliknutí, nikoli prodej. Dostupné záznamy musí ukazovat zobrazené nabídky, pořadí a ceny. Pokud balíček vždy zaujímá první místo, záznamy nedokážou čistě oddělit tento balíček od této pozice.
Vyplněné zadání tvůrce by mohlo znít: „Chceme vědět, zda náš způsob zohlednění pozice předpovídá kliknutí nových návštěvníků. Porovnáme stejné nabídky a cenové informace, ponecháme opakovaná pozorování společně a uvedeme úplné porovnání pozic. Ze záznamů kliknutí nebudeme vyvozovat tvrzení o nákupech.“ Jde o fiktivní příklad otázky měření, nikoli navržený výsledek.
Rozumným dalším krokem je naplánovat porovnání s dostatečnou proměnlivostí k rozlišení produktu a pozice při zachování stejné definice výsledku. Tvůrce pak může na vyčleněné skupině porovnat jednoduchou úpravu pozice s pružnější. Šlo by o novou studii této stránky; experiment s knihami jí nedává očekávanou míru kliknutí.
Pokud pružnější přístup předpovídá vyčleněnou skupinu lépe, má tvůrce důvod znovu posoudit zohlednění umístění ve zprávě. To stále neukazuje, že přesun balíčku zvýší tržby. Obchodní rozhodnutí by vyžadovalo důkazy o skutečné změně prezentace a výsledku důležitém pro podnik.
Pokud porovnání zůstane nevyřešené, má to tvůrce říct. Dodatečná pružnost není automaticky lepším obchodním nástrojem. Praktickým přínosem je jasnější posloupnost: pochopit, co záznamy dokážou oddělit, otestovat předpoklad měření a potom rozhodnout, zda je potřeba další experiment.
Jak jsme porovnání vypočítali?
Použili jsme upravené vydání odpovědí autorů a původní pravidla výběru. Prvních 553 pilotních či testovacích záznamů je vyloučeno podle pevné pozice v souboru. Zbývající rámec obsahuje 10 775 podání. Filtry porozumění ponechávají 9 344; filtr dokončení 9 265.[2]
Souhlas, stav dokončení a pravidlo minimální délky 60 sekund neodstraňují v příslušných krocích žádná další podání. Dokončení a délka jsou filtry po kontaktu s experimentem, takže ponechaná skupina je vybraným vzorkem.
ID účastníků Prolific vymezují skupiny. Deterministické rozdělení podle hashe přiděluje dvě třetiny skupin k trénování a zbytek k testu bez použití jejich voleb. V každé skupině sdílí každé ponechané podání prvního úkolu příspěvek účastníka rovnoměrně. Stejné vážení platí pro odhad, skórování i tabulky pozic.[3]
Oba modely jsou nepenalizované multinomické logity s 9 indikátory knih a 1 lineárním členem ceny. Výchozí model přidává 1 lineární člen pozice, celkem má 11 parametrů. Pružný model přidává 9 indikátorů pozice, celkem 19. Pozice 1 a číselně nejmenší ID produktu jsou referenční kategorie. Všechny způsobilé sady voleb obsahují stejných 10 produktů s ověřenou shodou vybraného ID, ceny a pozice.
Modely odhadujeme na trénovací skupině, ponecháme odhadnuté koeficienty a potom skórujeme testovací volby. Interval používá směrodatnou odchylku párových rozdílů skóre účastníků, 3 088 jednotek účastníků a 3 087 stupňů volnosti. Studentův t-interval je přibližný; přesný je jen při splnění příslušných předpokladů normálního rozdělení skóre. Všech 10 porovnání pozic zůstává popisných.[4]
Primární optimalizátor výchozího modelu vrátil číselné varování. Přesto splnil každou podmínku přesnosti určenou před odhadem včetně porovnání z druhého počátečního bodu. Ponechali jsme tento původní odhad; podrobná diagnostika je u materiálů pro reprodukci.[5]
Soubory ke stažení poskytují zobrazené výsledky, původní analytický kód a souhrnný číselný výstup. Nezahrnují zdrojové řádky odpovědí, ID účastníků ani knižní ilustrace. Zdrojová data získejte samostatně z vydání autorů. Influence IQ odpovídá za tuto novou analýzu a její interpretaci.
CSV používá jazyk této stránky. Balíček obsahuje původní výpočetní kód, přeloženou dokumentaci metody a souhrnné výsledky. Zdrojové řádky odpovědí a knižní podklady nejsou zahrnuty; data získejte samostatně z vydání autorů.
Zdroje a poznámky
- Compiani, Morozov a Seiler, Demand Estimation with Text and Image Data, verze rukopisu 4, 17. února 2026, oddíl 3 a příloha C. Autoři už zkoumají reakce na pořadí a cenu. Naše porovnání vyčleněných účastníků je původní užší novou analýzou.
- Vydání DeepLogitReplication autorů v commitu 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Sledujeme původní poziční hranici pilotu v upraveném souboru odpovědí a pravidla způsobilosti autorů. Data uvedená v ponechaných zdrojových záznamech jsou 11.–26. června 2024 a liší se od popisu 14.–27. června v rukopisu; data neurčují zahrnutí.
- Prolific rozlišuje ID účastníka od identifikátoru studie či podání. Přesná ID účastníků zachováváme pro seskupování. Tato ID nezávisle neověřují, že každé zastupuje jiného člověka, ani nedokládají, že ponechané podání bylo jeho prvním setkáním s experimentem.
- Předem stanovené porovnání Influence IQ průměruje logaritmus pravděpodobnosti pružného minus výchozího modelu uvnitř každého testovacího účastníka a potom mezi účastníky. 95% interval je průměr plus nebo minus kritická hodnota Studentova t-rozdělení násobená směrodatnou odchylkou účastníků dělenou odmocninou z 3 088. Předpokládá nezávislé skupiny účastníků, podmiňuje pevnými trénovacími odhady a vylučuje jejich nejistotu; přesnost vyžaduje stejně rozdělené normální rozdíly účastníků se společným rozptylem.
- Odhad výchozího modelu z nulového počátečního bodu vrátil varování o přesnosti. Jeho maximální absolutní průměrný gradient byl 3.12×10⁻⁹, Newtonův dekrement 2.50×10⁻⁸ a maximální rozdíl logaritmu pravděpodobnosti ze 2 počátečních bodů 7.46×10⁻⁸, pod předem stanovenými limity 10⁻⁸, 10⁻⁶ a 10⁻⁷. Oba modely splnily také podmínky kladné křivosti a shody účelové funkce. Primární koeficienty z nulového počátečního bodu byly ponechány.
Zdrojovou verzí tohoto článku je anglické vydání. Jazykové verze popisují stejný historický experiment; nejde o odhady nakupování pro jednotlivé země.