2 種內容審核標籤可能來自不同審核者
留言審核的交接紀錄可能列出 2 種標籤,卻沒說明各由誰選取。Wikipedia 的歷史判斷資料顯示,下一位接手個案的人為何需要這項資訊。
Influence IQ 原創分析,採用歷史 Wikipedia Detox 人身攻擊資料集中的入選判斷紀錄。分析於 2026 年 10 月 25 日(UTC)完成。
摘要
在 13,824 段入選的 Wikipedia 歷史討論摘錄中,有 155 段的 10 份個別判斷紀錄內,曾出現「引用/轉述」與「針對接收者的攻擊」這 2 種標籤。其中 98 段至少有 1 位審核者選取全部 2 種標籤;其餘 57 段,也就是 36.8%,則只有不同審核者分別提供這些標籤。這個百分比的分母是上述 155 段,而非全部 13,824 段。[1][4]
對管理社群媒體留言的企業與創作者而言,實務重點在於交接:每位審核者的觀察,都應連同該人的評估一起保留。2 種標籤一起出現,不代表有人同時選取全部 2 種。本研究描述的是對歷史討論摘錄所做的主觀判斷,不是內容審核錯誤,也不是刪除留言的規則。下方提供可複製的工作表,協助把這項差別記錄在實際審核紀錄中。
想像一位創作者請同事查看一則難以處理的留言。交接紀錄帶著 2 種標籤:有人正在引用或轉述攻擊,也有人正對接收者發動攻擊。決定如何處理前,同事還需要知道:這 2 項觀察是否出自同一位審核者?
摘要確實可能遺漏這項差別。可能是同一個人選取全部 2 個選項,也可能是 2 個人各自注意到同一段文字的不同面向。只列標籤,無法讓下一位審核者知道實際是哪種情況,也可能看不出每個人指的是哪些字句。
我們使用既有研究資料集中的個別判斷,探討這個問題。原始材料來自 Wikipedia 討論頁;此處藉由這些資料,呈現標籤與審核者之間的關係,再協助企業或創作者思考,自家交接紀錄需要保留哪些資訊。
讓每項觀察都能追溯到審核者
先了解每個標籤實際描述什麼
第 1 個選項詢問,文字是否引用或轉述了另一則留言中的人身攻擊。第 2 個選項則關於針對接收者的人身攻擊。審核者可以複選。這些是對眼前文字所做的判斷,不是隱藏內容的決定,也不是已違反政策的證據。[2]
只要 10 位審核者中至少有 1 人選取某個標籤,我們就視為該標籤存在。這是「任一審核者曾選取」的比較;我們不要求多數人同意,不把標籤稱為共識,也未檢驗其正確性。
13,824 段入選摘錄中,有 12,025 段沒有這 2 種標籤;另有 406 段僅有「引用/轉述」標籤,沒有「針對接收者」標籤,1,238 段則相反。其餘 155 段的判斷紀錄內,曾出現全部 2 種標籤。
這些描述只涉及這 2 個選項。沒有「針對接收者」標籤的摘錄,仍可能有其他攻擊標籤;「引用/轉述」標籤也不保證文字無害。精確保留名稱,才能避免把有用的分類,不知不覺擴張成更廣泛的結論。
13,824 段入選摘錄的標籤分類
10 位審核者中,只要至少有 1 人選取,就視為有該標籤。這 5 類只涉及 2 個特定選項;「皆無」不表示摘錄完全沒有任何攻擊標籤。
| 引用/轉述與針對接收者的標籤 | 摘錄數 |
|---|---|
| 這 2 種標籤皆無 | 12,025 |
| 有引用/轉述標籤,無針對接收者標籤 | 406 |
| 有針對接收者標籤,無引用/轉述標籤 | 1,238 |
| 2 種標籤皆有,且至少有 1 人選取全部 2 種 | 98 |
| 2 種標籤皆有,但僅由不同審核者提供 | 57 |
57 段摘錄有 2 種標籤,卻無任何人選取全部 2 種
在這 155 段摘錄中,我們追查了每個標籤背後的個別回答。98 段至少有 1 人對同一段摘錄選取全部 2 個選項;57 段的「引用/轉述」與「針對接收者」選取結果,則僅來自不同的人。這 57 段之中,沒有任何一份個別回答包含這組選項。
在這個範圍明確的 155 段集合中,63.2% 有同一人選取成對標籤,36.8% 的標籤則只由不同的人提供。也要保留 13,824 段入選摘錄的整體範圍,才能看清條件式比較的起點。[4]
這項差別會改變摘要能支持的說法。知道 2 種標籤都曾出現,只能說每種標籤都曾在整組審核紀錄中被選取;僅憑這點,不能說有某位審核者同時用這 2 種方式描述該段文字。
即使標籤來自同一位審核者,也不能據此斷定字句的意思。原始摘錄可能合併了某次 Wikipedia 修訂中新增的內容,包含不只 1 則貼文。某人選取 2 個選項,不代表被引用的那段文字本身,就是針對接收者的攻擊。我們沒有逐段檢視摘錄,以解釋其判斷結果。[2][6]
155 段摘錄中,57 段沒有同一人選取成對標籤
這項比較只包含 155 段入選摘錄;每段的 10 份判斷中,都曾出現 2 種標籤。分析採任一審核者的選取結果,不是多數同意,也不是經確認的內容審核處置結果。
| 2 種標籤由誰提供 | 摘錄數 | 占 155 段摘錄的比例 |
|---|---|---|
| 至少有 1 位審核者選取全部 2 種 | 98 | 63.2% |
| 標籤僅來自不同審核者 | 57 | 36.8% |
把標籤背後的觀察交給下一位審核者
企業內部可能由查看留言的人,交接給社群帳號負責人;創作者則可能由助理交接給本人。下一位接手者需要先了解觀察到了什麼,再決定要回覆、補查脈絡,或依照該社群帳號現行政策處理。
每位審核者的回答都應分開保存、各自完整。1 人選取 2 項時,保留為該人的成對評估;2 人各選不同項目時,就保留 2 份回答。個案可以存在多種看法,不必合成從未由任何人提出的判斷。
接著簡短說明相關段落。在自己的流程中,標出哪些內容看來是引用、似乎對誰說,以及哪則前後回覆有助於理解這段互動。若現有脈絡無法回答,就讓不確定性留在紀錄中。這些只是實務建議,資料集並未檢驗它們會如何影響決策。
簡短註記就可能足夠。目的是讓接手者理解前一人的推理,不必從頭重做整項審核。團隊若在輪班時,或在品牌與創作者之間移交個案,就應一併交出原始觀察,以及附在觀察上的分類。
標籤總數相同的虛構範例
想像 2 個各有 10 人的小組,各自審核 1 段虛構文字。這些安排只是計數示例,不含資料集中的真實人物、原文或個案。2 組彙整結果都各有 1 次「引用/轉述」與 1 次「針對接收者」選擇。[8]
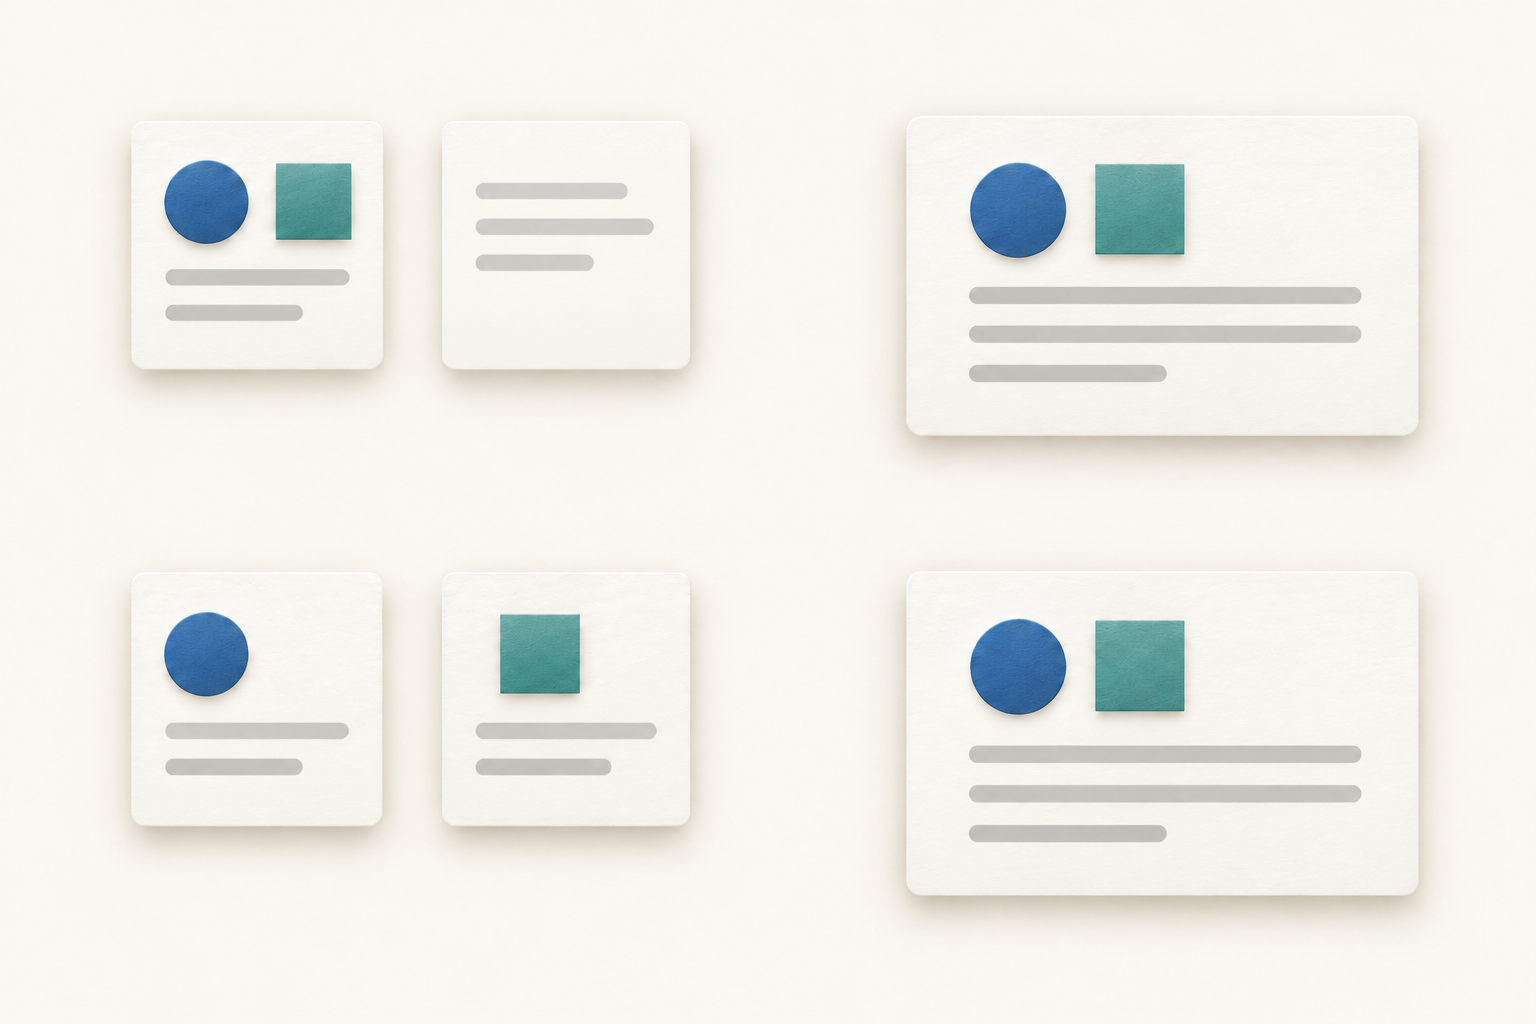
第 1 組中,審核者 A 選取 2 個選項,其餘 9 人沒有選取其中任何一項。因此,有 1 人的回答包含這組選項。交接時可以如實保留這份合併評估,並把最後的處理行動留待另行決定。
第 2 組中,審核者 A 選取「引用/轉述」,審核者 B 選取「針對接收者的攻擊」,其餘 8 人沒有選取任何一項。欄位加總仍是各 1 次,但沒有人選取全部 2 種。若稱為某個人的合併評估,就會加上一種個別回答中不存在的關係。
這個例子也說明,我們為何計算摘錄數,而不是把每位符合條件的人都加總。假如第 1 組有 2 人各自選取全部 2 種標籤,該摘錄仍只在「同一人選取」組計入 1 次。分類問的是這種配對是否存在,而非有多少人提供這種配對。
第 2 組可以使用這段簡短的虛構交接註記:「尚未決定處理方式。審核者 A 注意到引用/轉述;審核者 B 注意到針對接收者的字句。請將 2 份註記連同摘錄及先前回覆一併保留。社群帳號負責人會先確認每人指的是哪段文字,再選擇處理方式。」這段紀錄傳遞的是尚未解決的問題,不會把 2 人的回答改寫成同一人的結論。
真正交接時,請保留第 2 組那樣的 2 份獨立註記。下一位審核者可將註記與文字對照,詢問每個人的意思,再依社群帳號政策做決定。本研究不能判定哪位審核者正確,也不能決定這個虛構個案該採取何種行動。
相同的標籤總數,可能來自不同審核模式
1 位審核者選取全部 2 種
第 1 個虛構小組有 1 人選取 2 種標籤,9 人未選取這 2 個選項中的任何一項。
2 位審核者各選 1 種
第 2 組有 1 人選取「引用/轉述」,另 1 人選取「針對接收者的攻擊」,其餘 8 人沒有選取任何一項。
把依政策做出的決定與內容描述分開記錄
描述留言中出現什麼,與決定如何處理留言,目的並不相同。審核者可能注意到引用字句,但社群帳號負責人仍須考量前後互動及適用政策。將這些步驟分開保留,日後閱讀紀錄的人才能看出決定是如何做成的。
企業與創作者合作時,應在棘手互動發生前,先說好由誰做決定。了解產品抱怨的人,不一定有權變更社群帳號的內容審核方式。清楚的交接可以列出這 2 種角色,卻不必假設每個個案都需要多位審核者。
若創作者獨立作業,也能在同一份註記中區分:注意到什麼、查過哪些脈絡,以及最後決定了什麼。同一人可以完成多個步驟,同時保持各步驟的目的清楚。資料集並未顯示,增派人手或多加一層審核就能改善結果。
在了解彼此關係前,先把不同觀察分開保留。選取結果不同,可能只是注意的面向不同,不一定互相矛盾。「引用/轉述」不會自動免除處置,「針對接收者」也不是本研究測得的刪除建議。下一步應根據實際互動及社群帳號規則決定,不能從本研究的歷史百分比直接推導行動。
可複製的留言審核工作表
將下列欄位複製到現有審核文件或交接紀錄中。只使用團隊需要的資訊,並依對話內容設定合適的存取權限。這份工作表不需註冊即可取得;它是實務指引,不是研究中觀察到的流程。[8]
個案:[連結或內部參考編號。] 社群帳號/管道:[互動出現的位置。] 查核時間:[日期與時間。] 保持參考資訊穩定,讓接手者找得到同一份材料。
目的:[哪個問題需要決定?] 負責人:[由誰決定?] 接手者:[若需要交接,要交給誰?]
待審文字:[正在審核的段落,保留於經核准使用的工作區。] 前後脈絡:[相關的先前或後續回覆。] 缺少的脈絡:[無法查核的內容。]
審核者:[姓名或內部審核者編號。] 評估時間:[日期與時間。] 即使多人使用相同標籤,也要分開保留每個人的紀錄。
引用/轉述觀察:[是、否或不確定。] 依據:[哪些段落看起來在引用或轉述他人的攻擊?] 不要用此欄位判定文字是否無害。
針對接收者的觀察:[是、否或不確定。] 依據:[哪些段落看起來針對接收者,為什麼?] 此答案應獨立於引用/轉述的觀察。
其他相關觀察:[社群帳號政策要求考量的其他問題。] 不要把缺少研究中某個標籤,當成對整段互動的完整描述。
審核結果的關係:[同一人選取全部 2 種、不同人各選不同選項,或不確定。] 若審核者的選取結果不同,先保留各自的註記,再摘要個案。
政策依據:[適用的規則或指引。] 決定:[實際選擇的行動,或尚未解決的問題。] 理由:[觀察與脈絡如何支持這項決定。]
後續處理:[若有需要,接著由誰做什麼?] 交接時間:[何時交給對方。] 結果:[若已查核,決定後實際發生了什麼。] 不要把預定行動標記為已完成。
再次審核的時機:[若需重看,請填具體事件或缺少的脈絡。] 工作表不要求每案反覆審核,請依實際情況列出理由。
排除特定年份後,仍是相同的 155 段摘錄
計算標籤配對前,我們先訂下 2 項輔助檢查。第 1 項排除標記為 2016 年的摘錄,因為釋出檔案的年份範圍,超出了來源概述與原始論文所述期間。排除後,隨機樣本剩下 13,809 段合格摘錄;帶有 2 種標籤的仍是相同的 155 段,98/57 的分組也未改變。[5]
另 1 項檢查使用資料集在封鎖事件前後另行抽取的材料。採用同樣的「恰有 10 份判斷」規則後,這組共有 42,383 段摘錄。其中 2,457 段曾出現 2 種標籤,1,354 段有同一人選取成對標籤,1,103 段則只有不同人分別提供標籤,分別占 55.1% 與 44.9%。
封鎖事件加強取樣組的抽樣目的不同,因此我們將它分開處理。它的百分比不能取代主要結果,也不能用來推論目前的品牌留言。年份檢查處理的是記錄日期範圍;無論哪項檢查,都仍須把這些結果視為對入選歷史摘錄的主觀判斷。
2 項預先指定檢查的比較
各列每段摘錄都恰有 10 份完整判斷。封鎖事件加強樣本有不同的取樣目的;排除 2016 年,則是為了處理釋出年份範圍與來源描述之間的差異。
| 預先指定的比較 | 合格摘錄數 | 曾出現 2 種標籤的摘錄數 | 有同一人選取 2 種標籤 | 僅由不同人提供 2 種標籤 | 具備 2 種標籤的摘錄中,僅由不同人提供標籤的比例 |
|---|---|---|---|---|---|
| 隨機樣本,每段恰有 10 份判斷 | 13,824 | 155 | 98 | 57 | 36.8% |
| 封鎖事件加強樣本,分開處理 | 42,383 | 2,457 | 1,354 | 1,103 | 44.9% |
| 排除 2016 年的隨機樣本 | 13,809 | 155 | 98 | 57 | 36.8% |
我們如何把標籤追溯到個別判斷
我們使用 Wikipedia Detox 計畫的公開資料集 Wikipedia Talk Labels: Personal Attacks 第 6 版。釋出檔案的文字取自歷史討論頁修訂,每段摘錄都有多位群眾工作者的判斷。本分析採用個別回答,沒有產生新判斷,也未評估任何內容審核系統。[1][2]
主要比較從釋出資料的隨機取樣組開始,只保留恰有 10 份來自不同人的完整判斷之摘錄。固定為 10 份,可讓每段摘錄有相同次數的機會獲得成對選取。這也表示,37,492 段釋出隨機樣本中只選入 13,824 段,結果並不描述整個取樣組。[3]
每段入選摘錄計入 1 次。我們先檢查任一標籤是否曾出現,再檢查是否有人在針對同一摘錄的單份回答中選取全部 2 種。5 個分類互斥,加總為 13,824 段。155 段的分母來自具備 2 種標籤的那 2 類,而不是全部判斷紀錄或所有來源摘錄。[4]
查看配對前,我們已固定取樣組、涵蓋規則、年份檢查,以及主要條件式比較至少需有 100 段摘錄的門檻。實際觀察到的 155 段符合要求。我們未設定必要百分比,未為偏好某個結果而改規則,也未合併封鎖事件加強樣本與隨機樣本。
原始研究已使用個別判斷,後續研究則對每個攻擊欄位分別採多數決彙整。我們的貢獻較窄:在判斷份數固定的集合中,描述這 2 個選項由誰提供。這不是對那些研究方法的修正。下載內容提供彙整結果、方法,以及使用另行取得之公開來源檔案的重現步驟。[6][7]
讓下一次審核更容易理解
社群媒體內容審核交接時,有用的問題是:每項觀察由誰提出,描述的又是什麼?在這項入選歷史資料比較中,155 段具有 2 種標籤的摘錄裡,有 57 段沒有任何審核者選取成對標籤。若摘要只保留 2 個標籤名稱,這項關係就會遺失。
把個人的觀察、相關脈絡及最後決定連結起來。企業或創作者便能說清楚個案包含什麼,以及為何選擇該行動,而不必要求單一分類標籤代替整項審核。
無須註冊。資料包包含匿名彙整結果、方法、重現步驟,以及可重複使用的工作表;不含原始討論文字、修訂 ID、工作者 ID 或人口統計資料。原始公開來源檔案,需另至所連結的釋出頁取得。
來源與註釋
- 來源:Wikipedia Talk Labels: Personal Attacks,Figshare 第 6 版,DOI 10.6084/m9.figshare.4054689.v6,於 2017 年 2 月依 CC0 釋出。我們使用 attack_annotated_comments.tsv(檔案 7554634)與 attack_annotations.tsv(檔案 7554637),並核對製作者提供的 MD5 及自行計算的 SHA-256。Influence IQ 於 2026 年 10 月 25 日(UTC)完成篩選、計算與詮釋。本研究未蒐集新留言、建立新標註,亦未測量正在運作的社群平台。
- 製作者將 quoting_attack 定義為工作者認為文字引用或轉述另一則留言的攻擊,recipient_attack 則指針對接收者的攻擊。介面允許複選。「一般攻擊」是來源中另設的一項回答,不是本分析將子類別以 OR 運算重建而成。釋出文字串接了某次修訂中新增的內容;它不是編輯摘要,也不一定是完整的 1 則貼文或整段對話。討論命名空間、取樣組與模型 train/dev/test 分組,均保留原文件定義。
- 完整檔案含 115,864 段不重複摘錄、1,365,217 組不重複的修訂/工作者判斷配對,以及 4,053 位工作者。結構檢查未發現重複配對、無法對應的關聯資料、格式錯誤列,或缺漏/無效的標記值。納入條件為:每段在全部 5 個來源標記上,恰有 10 份完整且來自不同人的判斷,涵蓋文件所述的 2 種討論命名空間及所有模型分組,且每段等權計數 1 次。主要隨機組從 37,492 段保留 13,824 段;另行選取的封鎖事件加強組,從 78,372 段保留 42,383 段。同一工作者在不同摘錄中重複出現仍屬有效紀錄;本分析未合併相同文字,未因標記間不一致而刪除紀錄,也未重編「一般攻擊」。
- 對合格摘錄,以 Q 表示任一「引用/轉述」選取,R 表示任一「針對接收者」選取。「2 種皆曾出現」表示 10 份判斷中某處至少有 1 個 Q 及 1 個 R;「同一人選取」還要求 Q 與 R 出現在同一組修訂/工作者回答中;「僅不同人選取」則不存在這樣的回答。主要條件式分母為 98 + 57 = 155,精確分數 98/155 與 57/155 分別顯示為 63.2% 與 36.8%。百分比以精確有理數計算,再四捨五入至小數點後 1 位。計算配對前,我們要求主要條件式比較至少有 100 段具備 2 種標籤的摘錄,但未設定有利結果的百分比門檻。本研究未估計母體信賴區間、進行顯著性檢定、主張獨立性,或估計準確率。
- 事先指定的封鎖事件加強敏感度檢查,採用同樣恰有 10 份判斷的規則,並與主要隨機組分開。其 5 類計數依序為:2 種皆無 20,911 段、引用/轉述有而針對接收者無 959 段、針對接收者有而引用/轉述無 18,056 段、同一人選取全部 2 種 1,354 段、僅不同人提供全部 2 種 1,103 段;總數 42,383,條件式分母 2,457。主要隨機組排除 2016 年後剩 13,809 段,同序 5 類為 12,012 / 406 / 1,236 / 98 / 57。其 155 段條件式摘錄及 98/57 配對分組皆未改變。這些是描述性檢查,不是獨立的母體重複研究,也不是 2 組抽樣目的相同、可直接比較的證據。
- Wulczyn、Thain 與 Dixon 在 2017 年發表的《Ex Machina: Personal Attacks Seen at Scale》,奠定了這項群眾標註與建模工作。Cécillon 等人的 2020 年 WAC 論文,保留「工作者 × 欄位」矩陣,並對攻擊欄位各自以多數決彙整。這些是既有方法,不是本研究證實的錯誤。我們比較的是 10 人中任一人曾選取的標籤,以及同份回答中的配對,而非多數決標籤的表現。Influence IQ 計算每段入選摘錄中的 2 個選項,是由同一人提供,還是僅由不同人提供。
- 來源概述描述的期間為 2001–2015 年,原始論文為 2004–2015 年,但鎖定的第 6 版檔案含有 2001–2016 年的年份值。製作者的登入狀態結構說明寫 0/1,釋出檔案則用 False/True;二元標記字串是 0.0/1.0。我們保留文件與實際資料之間的差異,沒有歸因。解析器接受釋出檔案的精確字面值,不四捨五入或強制轉換標籤值。資料包記錄來源版本、篩選規則,以及使用公開檔案重現分析的步驟。
- 2 個各有 10 人的審核小組、審核者 A/B 的回答及交接選擇,都是虛構教學範例,不含資料集原始討論文字或識別資訊。2 組都各有 1 次「引用/轉述」與 1 次「針對接收者」選取,但只有第 1 組有同一人配對。工作表及概念插圖只是實務說明,不是觀察到的原始流程、經測試的審核政策,也不保證決策會更好。
各語言版本皆直接由英文原文翻譯。每個版本描述的,都是同一份歷史英文 Wikipedia 資料集與入選判斷;翻譯不會產生在地市場研究結果。Influence IQ 對分析、詮釋及翻譯負責。