電商商品陳列:檢查您對商品位置的假設
一項含 10 本書的歷史實驗顯示,簡單的位置調整為何可能漏掉部分模式,以及比較商品卡片前,可以如何檢查這項假設。
原創重新分析 Compiani、Morozov 與 Seiler 發布的 2024 年選書實驗。
摘要
企業在判定某項商品服務比另一項更有吸引力前,需要考慮各自出現的位置。我們使用已發布的 2024 年實驗,以 10 本電子書檢查 2 種納入位置的方式。整體而言,讓每個位置各有調整值,比每往下移一位都套用相同調整,更能預測選擇。但部分個別位置的預測較不準確,因此必須看完整比較。
兩個模型使用相同書籍與價格資訊。我們以 6,176 名參與者配適模型,再以另外 3,088 人檢查預測。選擇是假設性的,而且每人都必須選 1 本書。對比較商品卡片的企業與創作者來說,啟示是在將結果歸因於商品服務前,先檢查陳列位置假設。研究未估計銷售增幅,也未找出最佳商品順序。
假設頁面最上方的商品獲得最多點擊。是它更有吸引力,還是列表位置幫了忙?企業在重寫其他卡片、替表現看似較弱的商品降價,或調整品項組合前,需要實用答案。
納入位置聽來很直接,直到開始問該怎麼做。列表每往下移一位,都應有相同調整嗎?我們用歷史實驗,比較這個簡單方法與較彈性的方法,再以未參與模型配適的人檢查兩者。
相同商品,不同位置
商品位置比較應告訴您什麼?
商品卡片比較,應協助分清商品本身與呈現方式。如果某商品通常排第一,另一項通常排最後,光看總數,無法回答購物者是否比較偏好其中一項。
我們檢查的簡單方法,是列表每往下移一位,就對模型底層偏好分數套用相同調整。實用問題是:與允許不同位置各有不同調整相比,它的選擇預測是否已經足夠好?
我們以已發布的選書實驗檢查這 2 種方法。結果與在系列頁面或數位商店比較商品的企業及創作者相關。它提供檢查衡量假設的方式,而非暢銷品應放在哪裡的規則。
商品服務出現在多處時,這點很重要。創作者可能在系列頁與新品上市頁主打同一份下載資源;零售商可能調整分類列表順序。商品、價格、受眾與呈現方式,可能同時不同。位置調整是這項比較中某一部分的假設,也值得獨立檢查。
選書實驗中的人選了什麼?
Giovanni Compiani、Ilya Morozov 與 Stephan Seiler,請透過 Prolific 招募的人,從 10 本電子書中作出假設性選擇,書籍順序與價格均隨機安排。參與者必須選 1 本書,沒有不買的選項。我們使用每份保留提交紀錄的第一項任務,而非移除已選書籍後的後續任務。[1]
作者已報告對排序與價格的反應。他們更廣泛的研究探討文字與圖片如何協助估計商品替代。我們的問題較狹窄:替換單一位置項,是否能改善對未參與模型配適者的選擇預測?
依原始納入規則,留下 9,265 份提交紀錄,對應 9,264 個不同 Prolific 參與者 ID。有 1 個 ID 出現 2 次。我們將兩份提交紀錄保留在同一組,讓該參與者總權重與其他人相同。一份提交紀錄不一定就是另一個人,第一項任務也不一定是該人首次接觸實驗。[2][3]
保留來源日期為 2024 年 6 月 11 日至 6 月 26 日;手稿描述為 6 月 14–27 日,因此我們揭露差異,並不依日期排除資料。所檢視資料未確立國家與年齡納入條件;這些不是美國購物者或其他國家母體的估計值。[1][2]
整項比較都將同一參與者保留在一起
依原作者納入規則篩選的第一項任務提交紀錄;保留來源紀錄日期為 2024 年 6 月 11–26 日。
| 群體 | 參與者數(依平台 ID) | 保留提交紀錄數 |
|---|---|---|
| 全部保留對象 | 9,264 | 9,265 |
| 訓練組 | 6,176 | 6,176 |
| 保留供評估的群體 | 3,088 | 3,089 |
哪個位置模型更能預測保留組選擇?
依預先指定的評分指標,彈性位置模型更能預測保留組選擇。兩個模型都納入所提供書籍及其顯示價格,差別只在如何表示位置。
基準模型對列表每往下移一位,使用 1 個係數。彈性模型則以第一位為參考,讓第 2 至第 10 位各有獨立調整。這給它更大自由,也增加待估參數。光是在自身訓練資料上配適得更好,還不足以定論。
因此,我們以 6,176 名參與者配適兩個模型,再用另外 3,088 人評估。每位參與者的所有提交紀錄,始終位於同一分組。測試組包含重複參與者,因此有 3,089 份提交紀錄。
我們用負對數分數比較預測。模型若給對方實際選擇較高機率,懲罰就較小;若給該選擇極低機率,懲罰就較大。平均負對數分數越低越好。
保留組平均分數為:基準模型 2.2260,彈性模型 2.2154,單位為自然對數單位,也稱 nats。這些是預測分數,並非答對百分比。訓練與測試分數一併呈現,避免比較只依賴較容易的任務,也就是描述模型已看過的資料。
2 個模型,以相同參與者評估
2024 年、含 10 本書實驗中,經篩選的第一項任務選擇。訓練:6,176 名參與者與等量提交紀錄。測試:3,088 名參與者、3,089 份提交紀錄。
| 位置模型 | 訓練分數(nats) | 保留組分數(nats) |
|---|---|---|
| 1 個線性位置項 | 2.2046 | 2.2260 |
| 各位置獨立項 | 2.1899 | 2.2154 |
每位參與者的配對改善幅度為 0.0106 nats,近似 95% 區間為 0.0044 至 0.0168。此處正值有利於彈性模型。在這個評分尺度上,結果幅度小,但區間高於 0。[4]
此區間將 2 個已配適模型視為固定,並假設參與者群組彼此獨立。它不含改用另一訓練樣本配適模型的不確定性。結果支持在此篩選後的歷史任務中,預測有所改善,但不會讓分數差異變成銷售增幅。
彈性模型改善了保留組對數分數
歷史 10 本書任務中,3,088 名經篩選測試參與者的配對比較。
| 比較項目 | 改善幅度(nats) | 95% 區間:下限(nats) | 95% 區間:上限(nats) |
|---|---|---|---|
| 彈性模型減基準模型的對數分數 | 0.0106 | 0.0044 | 0.0168 |
2 個模型在哪些位置偏離觀察選擇?
完整位置比較顯示,整體分數為何應附細節。我們對各位置,比較觀察選擇占比與各模型給予的平均機率。這些是保留組中,每位參與者等權重的平均值,並非點擊率。
第 1 位的觀察占比為 17.16%,基準模型預測 14.64%,彈性模型預測 17.73%。第 10 位的觀察占比為 9.18%,兩個預測分別為 6.37% 與 8.74%。在這份特定列表的兩端,彈性模型都較接近。
全部 10 個位置的觀察與預測選擇
保留組:2024 年已發布實驗中的 3,088 名參與者,以及 3,089 份第一項任務提交紀錄。
| 位置 | 觀察選擇占比 | 基準模型平均機率 | 彈性模型平均機率 | 選中該位置的提交紀錄數 |
|---|---|---|---|---|
| 第 1 位 | 17.16% | 14.64% | 17.73% | 530 |
| 第 2 位 | 13.60% | 13.20% | 14.84% | 420 |
| 第 3 位 | 9.91% | 12.06% | 9.74% | 306 |
| 第 4 位 | 10.91% | 11.21% | 9.26% | 337 |
| 第 5 位 | 9.20% | 10.09% | 8.94% | 284 |
| 第 6 位 | 7.08% | 9.25% | 8.01% | 219 |
| 第 7 位 | 8.00% | 8.44% | 7.57% | 247 |
| 第 8 位 | 7.12% | 7.67% | 7.47% | 220 |
| 第 9 位 | 7.84% | 7.08% | 7.69% | 242 |
| 第 10 位 | 9.18% | 6.37% | 8.74% | 284 |
彈性模型並非處處較接近。第 4 位的觀察占比為 10.91%,基準模型預測 11.21%,彈性模型則預測 9.26%。額外彈性改善了整體保留組分數,卻在該位置留下較大差距。
下一張表顯示觀察占比減去預測占比。正差距表示模型低估該位置的選擇,負差距表示高估。保留全部 10 個位置,避免看似漂亮的端點取代整體比較。
兩個模型與觀察選擇的差距
在全部 10 個位置,觀察選擇占比減去平均預測機率,使用相同的 3,088 名測試參與者。
| 位置 | 觀察值減基準模型 | 觀察值減彈性模型 |
|---|---|---|
| 第 1 位 | 2.52 百分點 | -0.57 百分點 |
| 第 2 位 | 0.41 百分點 | -1.24 百分點 |
| 第 3 位 | -2.15 百分點 | 0.17 百分點 |
| 第 4 位 | -0.29 百分點 | 1.65 百分點 |
| 第 5 位 | -0.89 百分點 | 0.26 百分點 |
| 第 6 位 | -2.17 百分點 | -0.93 百分點 |
| 第 7 位 | -0.44 百分點 | 0.43 百分點 |
| 第 8 位 | -0.55 百分點 | -0.35 百分點 |
| 第 9 位 | 0.76 百分點 | 0.14 百分點 |
| 第 10 位 | 2.81 百分點 | 0.44 百分點 |
這些位置資料列屬描述性結果,未各自宣稱統計顯著。實驗未測量眼球移動或注意力,本分析也未辨識位置不同的原因。觀察占比呈彎曲模式,本身也不足以推翻基準模型:其位置項在線性關係上對應的是模型底層偏好分數,而非選擇百分比。
直接將第一與最後位置的觀察占比相減,回答的是不同問題。這些占比彙總了不同商品與價格下的選擇。兩個配適模型都先納入書籍身分與價格,再對 10 個選項分配機率。端點差異與模型比較,都無法告訴您,在實際商店移動某項商品會發生什麼。
可直接使用的商品位置衡量範本
比較商品服務前,先寫簡短衡量簡報。下列範本無須註冊,僅作示例。它應用研究關於檢查假設的啟示,不承諾同一模型適合您的商店。
決策:「我們需要在 [期間],針對 [頁面或行銷活動] 決定 [哪項商品比較或呈現變更]。」先指明決策,再選擇看起來有利的指標。
結果:「我們將測量 [選擇、點擊、加入購物車或購買]。」選用紀錄實際支持的結果,一併保留提供的替代選項、順序與顯示價格。強制選擇結果,應與購買結果分開。
單位:「我們的單位為 [參與者或其他明確定義單位]。重複造訪或提交紀錄將依 [規則] 處理。」評估對新對象的預測時,將同一人的觀察保留在一起。不要將匿名工作階段識別碼視為不同個人的證明。
比較:「兩個模型將使用相同商品、價格資訊與符合條件的觀察,差別在於 [位置假設]。」同時指明簡單與較彈性的替代方法。
評估:「我們將在配適前保留 [明確定義群體],並比較 [具名評分指標]。我們會呈現全部位置。」看到結果前,先決定如何報告尚無定論或較差的結果。
用途:「此結果將用於 [衡量決策]。在 [商業決策] 前,仍需要 [本文未測量的商業成果] 相關證據。」最後這句,避免預測練習悄悄變成營收預測。
讓同一參與者的紀錄始終留在同一組
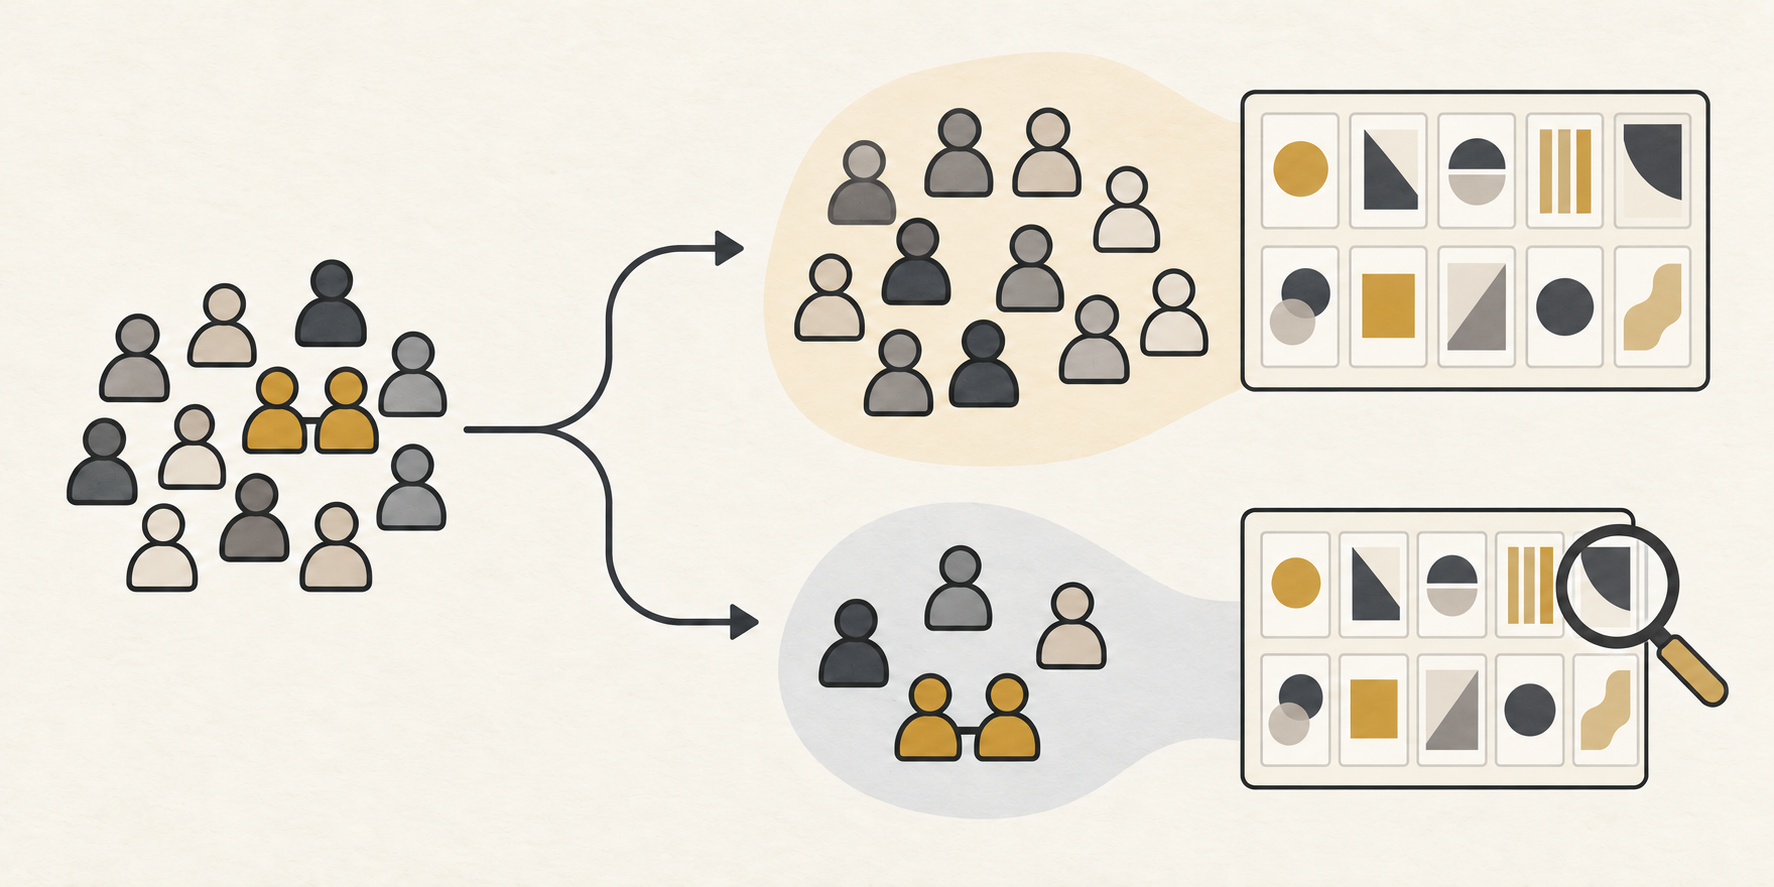
定義比較
指明商品、位置、結果與觀察單位。
保留評估組
將每位參與者的提交紀錄保留在一起。
檢查完整結果
比較預測並呈現每個位置,包括較差結果。
實作範例:創作者比較數位商品服務
假設一位虛構創作者銷售寫作練習手冊、工作坊與組合包。組合包出現在新品上市頁最上方,獲得最多點擊。創作者正考慮重寫其他商品說明。
衡量簡報改變了眼前問題。觀察結果是點擊,不是銷售。現有紀錄須呈現展示了哪些商品服務、順序為何,以及價格多少。如果組合包永遠在第一格,這些紀錄就無法清楚分開組合包與該位置。
創作者填妥的簡報可以寫:「我們想知道,現行納入位置的方式能否預測新訪客點擊。我們將比較相同商品服務與價格資訊,將重複觀察保留在一起,並報告完整位置比較。我們不會從點擊紀錄推論購買。」這是衡量問題的虛構範例,不是預定結果。
合理的下一步,是在保留相同結果定義的同時,規劃有足夠變化、能區分商品與位置的比較。創作者接著可在保留組中,比較簡單位置調整與較彈性的方式。這會是針對該頁面的新研究;選書實驗未提供它的預期點擊率。
若彈性方式更能預測保留組,創作者有理由重新檢視報告如何納入陳列位置。但這仍不代表移動組合包會提高營收。商業決策需要針對實際呈現變更,以及企業在意的結果取得證據。
若比較尚無定論,創作者應如實說明。增加彈性,不會自動成為更好的商業工具。實用收穫是更清楚的順序:了解紀錄能區分什麼、檢查衡量假設,再決定是否需要另一項實驗。
Influence IQ 如何計算這項比較?
我們使用作者編修後發布的回答與原始篩選規則。前 553 筆先導或測試紀錄,依固定檔案位置排除。其餘範圍包含 10,775 份提交紀錄;理解測驗篩選後留下 9,344 份,完成狀態篩選後留下 9,265 份。[2]
同意、已完成狀態,以及至少 60 秒的時長規則,在各自步驟中都未再移除提交紀錄。完成與時長是在曝光後篩選,因此保留群體是經篩選的樣本。
以 Prolific 參與者 ID 定義群組。確定性的雜湊分組,將 2/3 群組分配至訓練,其餘至測試,不使用選擇結果。各組內,每份保留的第一任務提交紀錄,均分該參與者的貢獻。配適、評分與位置表使用相同權重。[3]
兩個模型都是無懲罰項的多項羅吉特模型,含 9 個書籍指標與 1 個線性價格項。基準模型加上 1 個線性位置項,共 11 個參數;彈性模型加上 9 個位置指標,共 19 個參數。第 1 位與數值最小的商品 ID 為參考類別。全部符合條件的選擇集合都包含相同 10 項商品,且已核對選定 ID、價格與位置一致。
我們在訓練組配適模型,保留配適係數,再對測試選擇評分。區間使用參與者配對分數差的標準差、3,088 個參與者單位與 3,087 個自由度。除非符合其精確的常態分數假設,否則屬近似 Student-t 區間。全部 10 個位置比較均維持描述性。[4]
基準模型的主要最佳化器回傳數值警告,但仍符合配適前指定的全部準確度條件,包括第二起始點比較。我們保留原始配適,詳細診斷包含在重現資料中。[5]
下載檔提供顯示結果、原創分析程式碼與彙總數值輸出,不含來源回答資料列、參與者 ID 與書籍插圖。請另行取得作者發布的來源資料。Influence IQ 負責此重新分析與詮釋。
CSV 使用本頁語言。套件包含原創計算程式碼、翻譯後的方法文件與彙總結果,不含來源回答資料列與書籍素材;請另行取得作者發布的資料。
來源與註解
- Compiani、Morozov 與 Seiler,Demand Estimation with Text and Image Data,手稿第 4 版,2026 年 2 月 17 日,第 3 節與附錄 C。作者已研究對排序與價格的反應。我們對保留參與者的比較,是原創且範圍較窄的重新分析。
- 作者的 DeepLogitReplication 發布資料,提交為 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec。我們遵循編修回答檔原始的位置式先導資料截止點與作者納入規則。保留來源日期為 2024 年 6 月 11–26 日,與手稿所述 6 月 14–27 日不同;日期不決定是否納入。
- Prolific 區分參與者 ID 與研究或提交紀錄識別碼。我們保留確切參與者 ID 供分組使用。這些 ID 無法獨立證明每個 ID 都代表不同個人,也無法確立某份保留提交紀錄是該人首次接觸實驗。
- Influence IQ 預先指定的比較,先在每名測試參與者內平均「彈性模型減基準模型」的對數機率,再跨參與者平均。95% 區間為平均值加減 Student-t 臨界值,乘以參與者標準差,再除以 3,088 的平方根。它假設參與者群組獨立,以固定訓練配適結果為條件,排除訓練配適不確定性;精確成立須有同分布、常態且共同變異數的參與者差值。
- 基準模型從零起始的配適回傳精確度警告。其平均梯度最大絕對值為 3.12×10⁻⁹、牛頓遞減量為 2.50×10⁻⁸,2 個起始點的最大對數機率差為 7.46×10⁻⁸,低於預先指定上限 10⁻⁸、10⁻⁶ 與 10⁻⁷。兩個模型也都符合正曲率與目標函數一致條件。主要零起始係數予以保留。
這篇英文文章是來源版本。各語言版本描述同一項歷史實驗,並非各國購物情況的估計值。