想了解反馈,该读哪些食谱评论?
只读获赞最多或最新的评论,可能改变你看到的评分构成。我们在 100 份选定食谱的讨论中,比较每次选取 10 条评论的结果,说明阅读方法为什么应随问题而定。
本分析采用 UCI 于 2023 年发布的食谱存档,共有 18,182 条评论。
摘要
若目标是反映食谱讨论的评分构成,平均而言,随机取样比选取获赞最多或最新的评论更接近整体。Influence IQ 针对 100 份选定高评分食谱的讨论,比较了 3 种评论选法,每次选取 10 条;数据来自 UCI 于 2023 年发布、共含 18,182 条评论的历史存档。期望差距的均值,随机取样为 16.5 个百分点,按获赞数选取为 18.7 个百分点,选最新评论为 20.3 个百分点。[1][4]
结果衡量的是 1–5 星与未评分评论的构成,不是建议是否有用。在 46 份食谱中,按获赞数选取比随机取样更接近整体;另外 54 份则更远。对美食创作者与社区管理者,重点是分清:用样本概括讨论,与挑选例子来安排回应,是不同的任务。
你想改进一份食谱,下面却有很长的讨论。在决定解释什么前,只够读少量评论。该从获赞最多的开始、先看最新的,还是从讨论中随机选取?
在理解任何一句评论前,你已先作了这个选择。它决定哪些声音,会进入交给创作者、编辑或同事的任务说明。我们比较 3 条明确的选取规则,如何改变其中 1 个可衡量特征:评分的构成,包括作者未留评分的评论。
入选评论,只是更大讨论的一部分
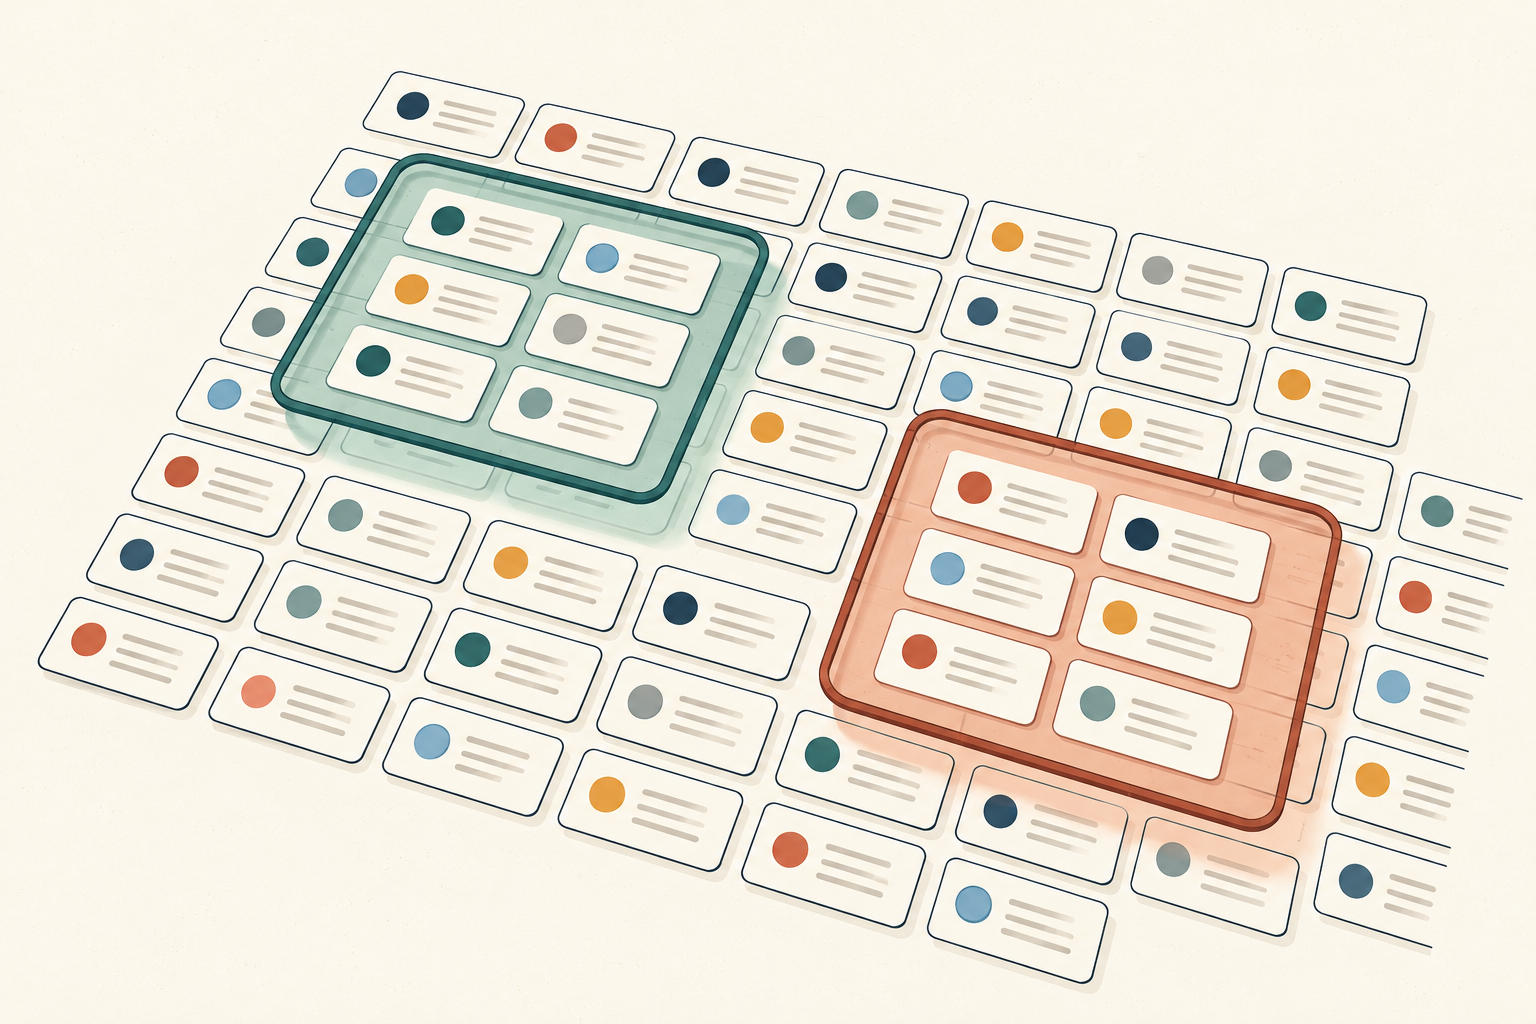
- 入选评论
- 该讨论的全部存档评论
10 条评论、3 种选法,看到的构成可能不同
为食谱准备后续内容时,创作者得先决定读什么。获赞最多的评论,看起来像个捷径;最新评论则提供另一种切入点。两种方式都让某些评论排在前面,但都不能自动概括整段讨论。
我们用历史存档,研究了这个具体问题:UCI 于 2023 年发布的公开数据中,有 100 份选定的高评分 Taste of Home 食谱,共 18,182 条评论。每份食谱分别按获赞数、创建时间和随机规则选取 10 条,再与该食谱全部存档评论的评分构成比较。[1]
相对完整评分构成,期望差距平均为:按获赞数选取 18.7 个百分点,选最新的 20.3 个百分点,随机取样 16.5 个百分点。无论评论多少,每份食谱在这些均值中的权重都相同。[4]
与随机取样相比,按获赞数选取的差距大 2.2 个百分点,选最新的大 3.8 个百分点。这些差异只涉及评分与未评分评论的构成。我们没有衡量,哪些评论提供最好的烹饪建议、最清楚的解释,或最有用的经营想法。
这对美食创作者和社区管理者很重要:一条评论可以值得用来启发教程,却未必是讨论中的典型意见。把它当成例子,与把一组入选评论当成整体概括,是不同的决定。
与各食谱完整评分构成的平均差距
比较涵盖 UCI 历史存档中 100 份选定食谱的讨论,每组选中的评论均为 10 条。差距越小,表示评分与未评分评论的构成越接近。
| 选取方法 | 期望差距的均值 |
|---|---|
| 获赞最多 | 18.7 个百分点 |
| 创建时间最新 | 20.3 个百分点 |
| 随机取样 | 16.5 个百分点 |
评分构成差距是什么意思?
把每份食谱讨论看成 6 类评论的组合:1–5 星,加上未评分。10 条评论样本也有自己的构成。我们用“总变差距离”(total variation distance),衡量这组较小样本与完整存档讨论相差多少。
先看只有 2 类的假设例子:一半评论给 4 星,一半给 5 星。若选出的 10 条中,有 7 条 4 星、3 条 5 星,构成便是 70% 对 30%,不是 50% 对 50%。距离为 20 个百分点:把 2 项各 20 个百分点的绝对差相加,再取一半。
相同计算也适用于全部 6 类。值越小,表示越接近存档的评分构成;不代表文字更有信息量,也不代表评论更真实。18.7 个百分点的结果,也不表示 18.7% 的评论是错的。
未评分评论仍在比较内。UCI 将评分字段的 0 定义为未评分,不是低于 1 星的分数。移除它们,就会改变要概括的讨论。仅凭这一数值类别,也不能判断评论包含提问、赞扬、问题,还是其他内容。[1]
随机取样平均更接近,但并非每份食谱如此
整体比较并没有产生通用赢家。100 份食谱中,按获赞数选取的期望差距,有 46 份小于随机取样,54 份更大;按最新时间选取,则有 42 份更近,58 份更远。两项比较都没有完全相等的情况。[4]
这里比较的是每份食谱内,各方法的期望差距;并不表示那 54 份食谱的讨论中,每种可能的随机选取都比获赞选法更接近整体。某一次抽出的 10 条评论,可能恰好很像全体,也可能漏掉部分构成。
随机结果,对每种可能的 10 条评论样本求平均,每个样本机会相等;不是靠 1 次幸运抽取,也不是选定某个随机种子的结果。若多条评论在入选边界有相同获赞数或时间戳,我们也对可能的并列处理结果求平均。
按获赞数选取时,70 份食谱在入选边界出现并列,需要求平均;按最新时间选取时,有 4 份。我们没有按作者、行位置或标识符偏选某条并列评论。计算回答的是明确规则下会怎样,而不是把任意排序当成证据。[4]
对创作者,实际启示很具体:获赞数与创建时间,都是选取标准。用其中一种来概括讨论时,应说明自己的选择,不要假定眼前这组评论保留了整个存档的构成。
相对随机取样的远近,随食谱讨论而变
每种排序选法,都在同一份食谱内与随机取样比较。这里比较的是期望差距,不是某一次随机抽取的结果。
| 选取方法 | 比随机取样更近 | 与随机取样相等 | 比随机取样更远 |
|---|---|---|---|
| 获赞最多与随机取样比较 | 46 | 0 | 54 |
| 创建时间最新与随机取样比较 | 42 | 0 | 58 |
先确定问题,再选评论
了解客户反馈,可以是为了看总体模式、调查具体问题,或为下一条帖子找选题。本研究只处理其中一部分:少量入选评论,是否保留讨论的评分构成;它没有给所有收集反馈的方法排名。
如果问的是“这段讨论整体如何?”,先定义哪些评论属于讨论。从可访问的完整列表随机选取,能避免刻意偏向高赞或新评论。在这份存档中,它平均更接近整体,但小样本仍有可测差距。10 条只是本次比较选的数量,不是“读 10 条就够”的建议。
如果问的是“接下来该回答什么?”,一条具体评论本身就可能值得关注。有人清楚询问食材能否替换,就足以成为核查食谱、准备解释的理由,不必先称这个问题很普遍。它是否适合下一条内容,要另作判断。
若关心近期变化,可以用创建时间划出相关的阅读窗口,并在总结中写清。研究里的“最新”,指保存的存档中最晚的创建时间戳,不是今天新增的评论,也不是网站当前显示的顺序。
即使完整评论存档,也只是有限的参照:它来自愿意留言的人,不包括所有看过或试过食谱的人。若企业需要从不留言者的反馈,就要另找接触方式;更贴近评论存档,填不了这个缺口。新增反馈应分开保留,让来源与选取方式仍可理解。
分别保留 2 份记录:一份说明概括讨论所用的选法,另一份列出值得调查的问题。这是建议的规划方式,不是本研究测试过的流程。
虚构示例:规划食谱后续内容
设想一位美食创作者,正准备烘焙食谱的后续内容。一条高赞评论问,换一种烤盘是否可行。创作者很想在下一条视频开头说:“大家都被烤盘尺寸难住了。”这是虚构场景,不是数据集中选出的评论或食谱。
烤盘问题可以值得回答,却不说明它有多普遍。获赞数不能证明谁试过这份食谱,也不能证明谁有同样经历。
更准确的任务说明可以这样写:“有读者问,烤盘选择会怎样影响这份食谱。展示实际用的烤盘,解释尺寸,并说明推荐另一种之前,还需核查什么。”创作者随后可以验证烹饪细节。评论给出了起始问题,并没有证明答案。
若还要概括讨论,另留一份记录,说明读了什么、怎样选的。从完整可用列表随机取样,应让每条评论有同等机会,而且不重复选择同一条。随意滚动到几个方便的位置,不是这里评估的随机程序。
没有完整列表时,就描述实际能作的选择。“我们阅读了这种排序下最先显示的评论”,比称它为代表性样本更清楚。不要把本存档测得的数值差距,套到这个不同流程上。
后续内容应展示器具,并回答核查过的问题。记录已解释了什么,让下一次检查能集中在尚未回答的问题上;再根据后续内容自身收到的反馈,判断解释是否合适。
分清选取与解读
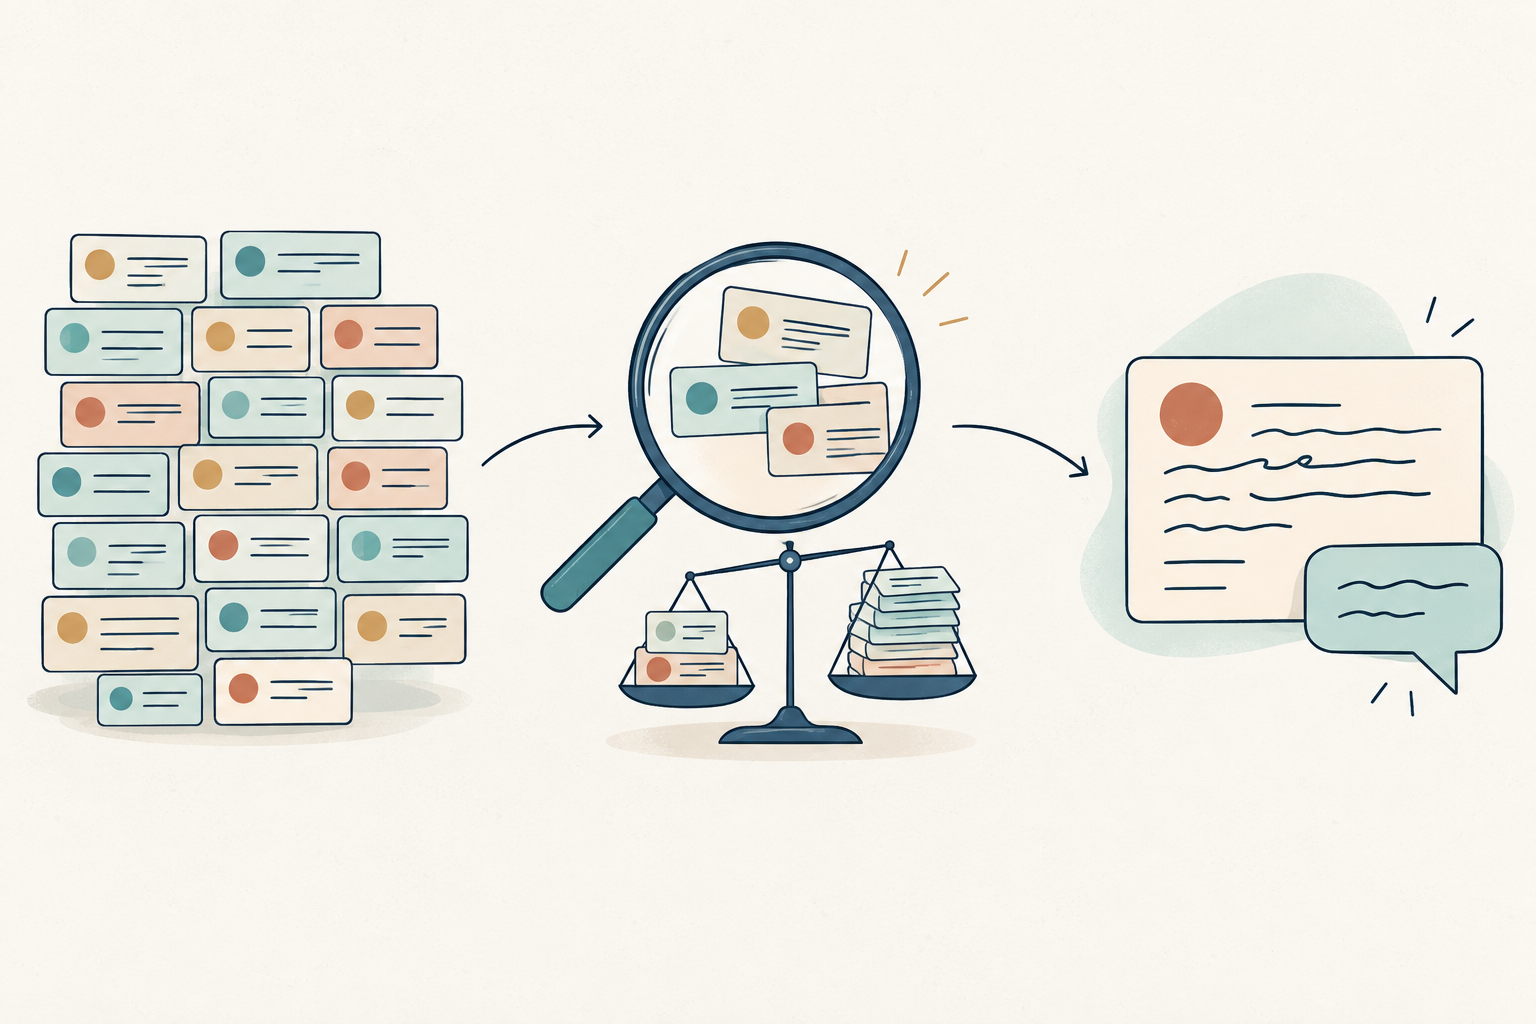
明确要读哪些评论
阅读前,写清讨论范围与选取规则。
想清入选评论覆盖了什么
把入选评论与完整讨论分开看。
结合上下文读评论
从实际问题出发,安排回应并核查答案。
阅读食谱讨论的简短任务说明
把评论阅读任务交给创作者或同事前,可先用这些问题规划。它们是实用提示,不是源数据集里的问题。
决定:这次阅读要支持什么任务?说清具体目的,例如澄清食谱步骤,或选择后续内容主题。索取例子,与要求概括整段讨论,应分开。
范围:包括哪份食谱、哪个平台、哪个时期?说明可用列表是否完整。评论就按评论计数;没有另外的证据,不要把它们称为独立人数或已验证客户。
选取:评论怎样进入阅读组?记录排序或随机程序、阅读条数与并列规则。若未评分评论属于你想了解的讨论,就把它们保留在范围内。
观察:入选评论实际说了什么?把直接提问与你的解读分开。保留理解问题所需的上下文,同时不要把个人信息写进共享任务说明。
下一步:哪些说法或食谱细节,发布前需要核查?交给能回答的人处理。写清拟解释的内容与发布去处,不要把挑出的例子变成没有依据的普遍性断言。
我们如何比较 3 种选取方法
来源是 Ali、Matuszewski 与 Czupyt 的 Recipe Reviews and User Feedback(食谱评论与用户反馈)数据集,UCI 于 2023 年按 CC BY 4.0 发布。其中的评论来自 100 份选定的高评分 Taste of Home 食谱。发布年份不能确定准确采集日期,现有材料也不能证明原网站的每条评论都已收集。这是历史存档分析,不是当前平台基准。[1][2][3]
我们检查了完整的已发布存档:100 个食谱位置编号下,共有 18,182 个不同的评论标识符。每份食谱都超过 10 条评论,因此全部 100 份进入比较。同一人多次留言,仍按多条评论保留;没有按人去重,也没有分析评论文本、姓名、用户声誉或来源排名分数。
每份食谱中,获赞规则选观察到获赞数最高的 10 条;最新规则选创建时间戳最晚的 10 条。入选边界并列时,从并列评论中补足剩余名额的每种可能方式,机会都相等。随机规则则让该食谱存档中,每个 10 条评论的子集都有相同概率。
对每种可能的选取结果,我们先比较它的 6 类评分分布与该食谱完整存档,再按选取规则对距离求平均。精确概率计算可直接得到这个期望,无需模拟。先平均距离很重要:若先平均类别比例,再只计算一次距离,回答的就是另一个问题,还可能掩盖取样变动。
随后,对各食谱的期望距离作等权平均。差值在舍入到小数点后 1 位之前计算。10 条评论的预算、纳入规则、比较方式与报告计划,都在查看目标结果前固定;之后没有改选预算,也没有挑有利的食谱子集。
结果描述这个有限存档及指定选取规则,因此不报告总体置信区间或因果效应。累计获赞数,不说明曝光或投票历史。原数据生产者的论文研究文本分类;本分析则遵循 UCI 记录的星级类别,研究选取过程。技术方法说明了来源字段的区别。[1][2]
下载内容提供汇总结果、每个食谱位置编号的数值核查,以及复现代码,不含评论文本、姓名或用户标识符。来源记录另由 UCI 提供。给数据集作者与资料库署名,不代表他们认可我们的解读。[1][3]
无需注册。下载包含汇总比较、按食谱位置列出的数值结果及方法说明译文,不含评论文本、用户名或个人评论标识符。来源数据集可另从 UCI 获取。[1]
来源与注释
- Ali, A.、Matuszewski, S.、Czupyt, J.(2023)。Recipe Reviews and User Feedback(食谱评论与用户反馈)[数据集]。UCI Machine Learning Repository。DOI:10.24432/C5FG95。UCI 记录共 18,182 条评论;stars 字段的 1–5 表示对应星级,0 表示未评分。Influence IQ 计算使用已发布存档,不是当前网站数据。
- 来源论文 Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models(《文字味蕾:通过 BERT 与 AttBiRNN 模型深入探索食谱情绪识别》),介绍所选食谱来源及文本分类研究。它对 best_score 的描述,与 UCI 记录的评分字段有冲突。我们使用 stars,不分析 best_score 或评论文本;现有材料不能确定准确快照时间或完整采集覆盖范围。
- UCI 数据集采用 Creative Commons Attribution 4.0 许可。Influence IQ 据此计算新的汇总比较。向作者、UCI 与 Taste of Home 署名,不表示他们认可本研究。下载不重新分发单条评论或用户身份信息。
- Influence IQ(2026)。食谱反馈抽样:分析方法、汇总结果与复现代码。包内记录了固定的 10 条评论比较、精确的总变差期望值计算、并列情况处理,以及全部 100 个食谱位置的数值结果。来源数据需另从 UCI 获取。原始技术文件附有说明译文。
文章、规划简报、图表标签及结果 CSV 均提供所有语言版本。技术复现包附有说明译文。每个版本描述的都是同一份历史食谱档案及同一项分析。