多地点营销:网站与社交链接如何关联
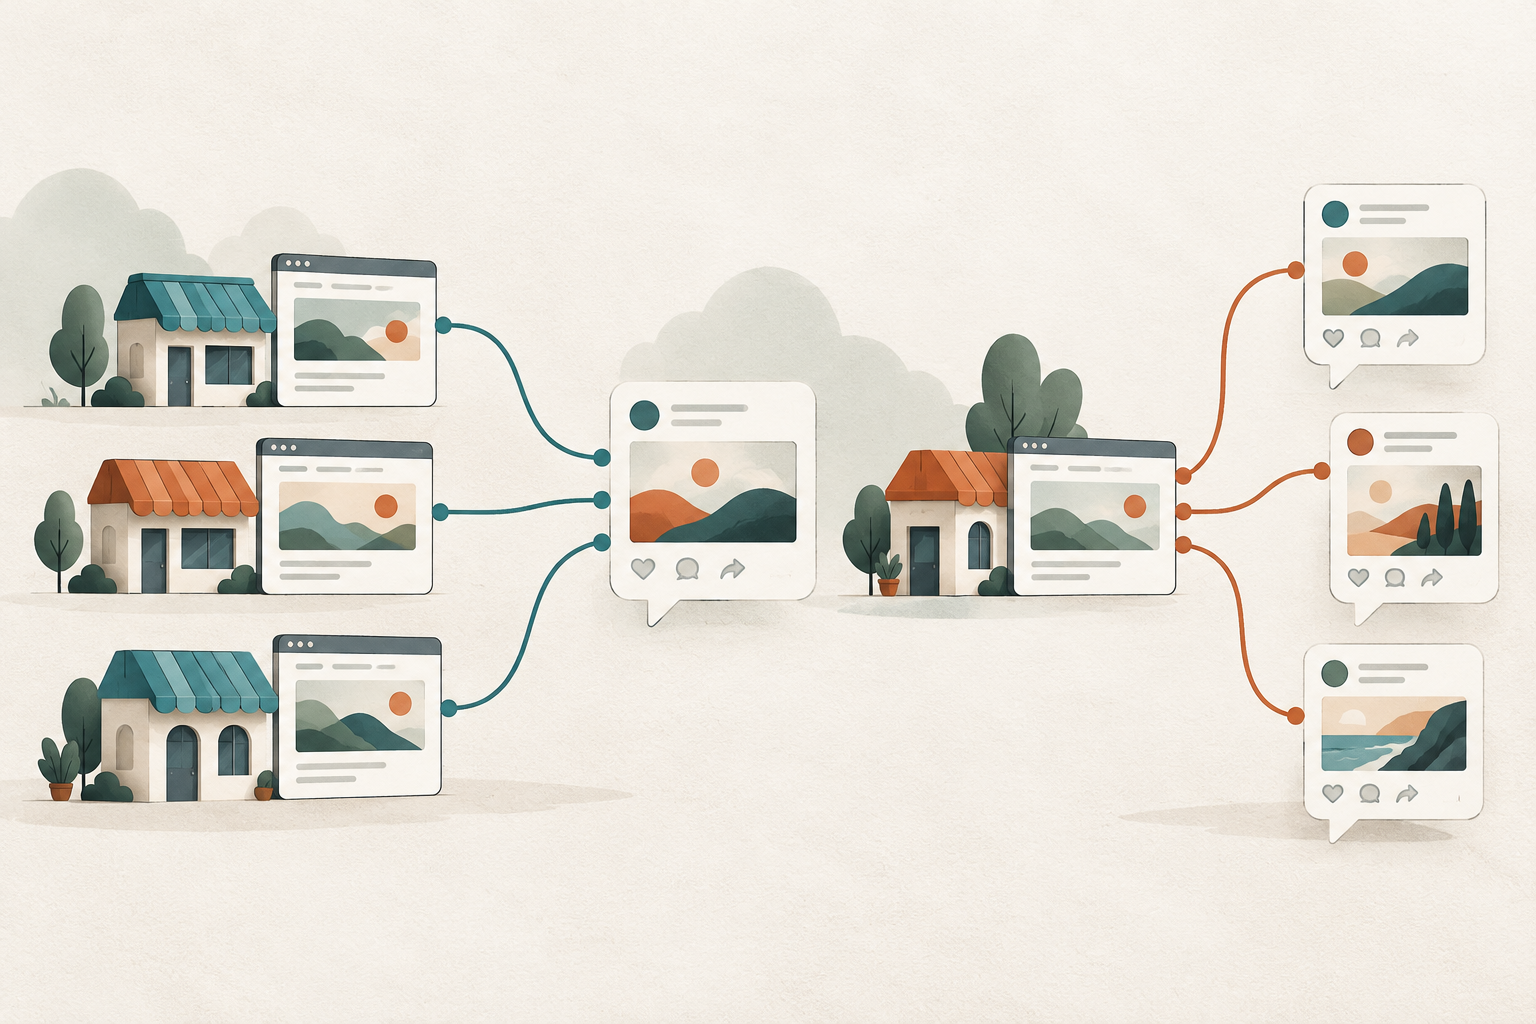
多个网站选项可能共用一个社交链接,反过来也一样。我们比较了 10 份地点数据导出文件,说明活动简报为何应保留每条记录与两类目的地的关联。
Influence IQ 分析了 2026年10月10–13日采集的 10 份选定 AllThePlaces 数据采集器导出文件。基于 URL 的比较涵盖同时具有网站与 Facebook 链接的 3,843 条记录;来源标识是导出记录的标识符,并非经过验证的实体地点。
摘要
多地点活动应保留每条记录与网站、社交链接的关联,即使链接重复也一样。我们比较了 2026年10月10–13日采集的 10 份选定 AllThePlaces 数据采集器导出文件中,同一来源标识下提供的链接。在同时有网站与 Facebook URL 的 3,843 条记录中,Staples 导出文件的 1 个 Facebook URL 对应 1,758 个不同网站 URL。Lush 则呈反向关系:13 个网站 URL 对应 408 个不同 Facebook URL。7 个采集器的配对记录始终呈一对一关系。[1]
比较对象是所提供的字符串和导出标识,而不是经过验证的页面、账号或实体地点。这些文件中,只有 Facebook 存在 URL 配对;Instagram 和 Twitter 的原样字符串另行报告。10 份导出文件共有 15,797 条已确定来源标识的记录,因此覆盖表也保留了不完整的配对。实际审批目的地时,即使链接只存 1 份,也应保留每个标识的网站/社交关联及活动预期覆盖范围。
创作者已有本地销售方案、素材和链接清单,但帖子获批之前,仍需有人把目标地点与清单中的正确条目对上。如果多条记录共用一个社交链接,是否就应该共用网站目的地?
这些链接的分组并不总是一致。有些导出记录在两边都有独立链接;有些共用 Facebook 链接,却保留不同网站 URL;还有些网站相同,Facebook URL 却不同。把这些关联摆清楚,准备简报的人才能更明确地作选择。
关联可以沿两个方向展开
先看同时包含两类链接的记录
比较从来源标识开始,也就是导出记录所附的标识符。我们将它与提供该记录的数据采集器一起保留。采集器是 AllThePlaces 的数据收集程序,不一定对应单个品牌。例如,Bravo 导出文件可能包含多个品牌,OZK 则包括银行与 ATM 记录。[1]
10 份导出文件共有 3,843 条记录,同时包含可用网站 URL 和可用 Facebook URL。我们在各采集器内部,对同一批记录的这 2 个字段进行比较。其他社交字段提供的是原样字符串而非 URL,其结果稍后另列。
表格显示,两类链接的关系可能差别很大。Arcaplanet 的 484 条配对记录包含 484 个不同网站 URL 和 484 个不同 Facebook URL,AutoZone 各项均为 692。Bravo、J.Crew、Madewell、PetSuites 和 Coffee Bean 的每条配对记录,也都各有独立的网站与 Facebook URL。
因此,10 个采集器中的 7 个,在本次比较中呈现直接的一对一关系。团队保留原配对后,就能把这种关系带入简报,无需另行假设分组。这些情况与 Staples、Lush、OZK 更集中的模式,共同构成研究发现。
这里的“不同”,是指所提供的 URL 字符串在保守比较规则下不同。我们保留路径、查询参数和片段;没有访问目的地,也没有因链接可能打开同一页面而将它们合并。计数描述的是链接清单,不是已验证的不同页面或账号。[2]
10 份导出文件中,网站与 Facebook 链接的分组方式不同
AllThePlaces 文件采集于 2026年10月10–13日。每行仅统计同时提供网站 URL 与 Facebook URL 的记录。链接是否不同,依据固定比较规则下的源 URL 字符串判断。
| 采集器导出文件 | 两种 URL 都有的记录 | 不同网站 URL | 不同 Facebook URL |
|---|---|---|---|
| Arcaplanet | 484 | 484 | 484 |
| AutoZone | 692 | 692 | 692 |
| Bravo | 7 | 7 | 7 |
| J.Crew | 69 | 69 | 69 |
| Lush | 408 | 13 | 408 |
| Madewell | 24 | 24 | 24 |
| OZK | 242 | 2 | 242 |
| PetSuites | 93 | 93 | 93 |
| Staples | 1,804 | 1,804 | 47 |
| The Coffee Bean & Tea Leaf | 20 | 20 | 20 |
别忽略不完整记录
这 3,843 条配对来自 15,797 条已确定来源标识的记录。配对比较只回答同时含有两类字段的记录问题,不能完整概括导出文件的全部内容。10 个文件中,9,174 条只有网站 URL、没有 Facebook URL,8 条只有 Facebook、没有网站,2,772 条两者都没有。[4]
覆盖率差别很大。PetSuites 的 94 条记录中,93 条提供两种 URL;AutoZone 的 7,400 条记录全部有网站 URL,但这 7,400 条中仅 692 条两者齐全。Staples 共 5,425 条记录,其中 1,804 条两种 URL 齐全,另有 2,727 条记录未提供这 2 个字段。把来源总数放在配对总数旁,才能看清这些差异。
下表统计含有各字段的记录数,因此网站与 Facebook 两列有重叠。它们不是不同目的地的数量,不能当作互不相交的组相加。前面的映射表,则只在配对记录中统计不同链接。
源数据字段缺失,是需要跟进的事项,不能证明企业没有网站或社交页面。采集过程会影响导出文件保留哪些内容。当前 AutoZone 代码会移除部分社交值,后续补充步骤也可能填入缺值。现有代码说明了为何要谨慎处理来源缺失,但我们无法确定每个历史字段由哪个代码版本生成。[5]
在活动工作表中,把不完整记录放入单独的待核查队列,并保留其来源标识。记录哪个字段待检查、由谁解决。这样,准备候选清单时就不会悄悄漏掉不完整配对,而最终目的地仍由当前核查决定。
配对比较只覆盖各来源导出文件的一部分
2026年10月10–13日采集的 10 份选定 AllThePlaces 导出文件中的记录。每个字段都以该采集器全部已确定来源标识为基数,包括无法进入网站/Facebook 配对比较的记录。
| 采集器导出文件 | 全部已确定来源标识的记录 | 有网站 URL 的记录 | 有 Facebook URL 的记录 | 两种 URL 都有的记录 |
|---|---|---|---|---|
| Arcaplanet | 626 | 626 | 484 | 484 |
| AutoZone | 7,400 | 7,400 | 692 | 692 |
| Bravo | 250 | 241 | 7 | 7 |
| J.Crew | 693 | 658 | 76 | 69 |
| Lush | 678 | 676 | 408 | 408 |
| Madewell | 162 | 159 | 25 | 24 |
| OZK | 275 | 274 | 242 | 242 |
| PetSuites | 94 | 94 | 93 | 93 |
| Staples | 5,425 | 2,698 | 1,804 | 1,804 |
| The Coffee Bean & Tea Leaf | 194 | 191 | 20 | 20 |
把像账号名的值与 URL 分开保留
Instagram 和 Twitter 字段需要另一种读法。在这 10 份导出文件中,可用的非空值都是原样字符串,而非完整 URL。有些看起来像账号名,但分析并未核实,也没有据此拼接链接。我们保留拼写、大小写和开头的 @(如有),并单独比较这些字符串。[6]
同时具备网站 URL 的记录中,Instagram 字符串记录有 3,711 条,Twitter 为 3,501 条。两组可能包含相同来源标识,不能相加后当作不同地点数。表格保留每个采集器与平台组合,包括配对记录为 0 的情况。
字符串结果也说明交接前为何要检查格式。Staples 有 2,697 条 Instagram 字符串配对,网站 URL 为 2,697 个,原样字符串却只有 2 个;J.Crew 有 658 条 Instagram 配对、655 个网站 URL 和 3 个字符串;PetSuites 则有 86 条配对、86 个网站 URL 和 86 个字符串。在核查实际去向之前,源数据提供的关系就已不同。
原样字符串可以是有用的来源资料,却未必能直接粘贴到活动目的地字段。应保留原值,注明平台,把之后验证过的 URL 另存一个字段,并记录由谁、何时核实。这样才能区分导出数据写了什么,与活动团队批准了什么。
这张表检查的是表示形式,不是给平台排名,也不统计经过验证的账号。报告中应将 URL 与字符串结果分开,工作简报里也应让这 2 种形式可区分。
原样社交字符串应作为清单中的独立部分保留
全部 10 份选定 AllThePlaces 采集器导出文件,采集于 2026年10月10–13日。每行将网站 URL 与指定社交字段的原样字符串配对。这些文件未出现 Instagram 或 Twitter 的 URL 配对。
查看全部 20 个采集器/平台组合行
| 采集器导出文件与社交字段 | 有网站 URL 和原样字符串的记录 | 不同网站 URL | 不同原样字符串 |
|---|---|---|---|
| Arcaplanet · Twitter 字段 | 0 | 0 | 0 |
| Arcaplanet · Instagram 字段 | 0 | 0 | 0 |
| AutoZone · Twitter 字段 | 0 | 0 | 0 |
| AutoZone · Instagram 字段 | 0 | 0 | 0 |
| Bravo · Twitter 字段 | 1 | 1 | 1 |
| Bravo · Instagram 字段 | 7 | 7 | 7 |
| J.Crew · Twitter 字段 | 647 | 644 | 2 |
| J.Crew · Instagram 字段 | 658 | 655 | 3 |
| Lush · Twitter 字段 | 0 | 0 | 0 |
| Lush · Instagram 字段 | 2 | 1 | 1 |
| Madewell · Twitter 字段 | 153 | 153 | 1 |
| Madewell · Instagram 字段 | 159 | 159 | 1 |
| OZK · Twitter 字段 | 2 | 1 | 1 |
| OZK · Instagram 字段 | 0 | 0 | 0 |
| PetSuites · Twitter 字段 | 0 | 0 | 0 |
| PetSuites · Instagram 字段 | 86 | 86 | 86 |
| Staples · Twitter 字段 | 2,698 | 2,698 | 3 |
| Staples · Instagram 字段 | 2,697 | 2,697 | 2 |
| The Coffee Bean & Tea Leaf · Twitter 字段 | 0 | 0 | 0 |
| The Coffee Bean & Tea Leaf · Instagram 字段 | 102 | 102 | 1 |
围绕预期受众编写待批准的简报
设想创作者为一家咖啡集团的 3 家分店准备周末推广。活动面向 Riverside 和 Station 分店附近的顾客,Hill 分店不在简报范围内。协调者的清单为每家分店列了不同网站链接,3 行却提供了相同社交链接。这是虚构示例,并非数据集中观察到的活动。
如果扁平文件只列出 3 个网站链接和 1 个社交链接,创作者就得自行判断每个网站属于哪家分店、推广涵盖哪些分店。保留来源标识的简报,可以只存 1 份社交目的地,关联其 3 个成员,再明确 Riverside 和 Station 为预期活动范围。
协调者随后可为每条获批帖子选定网站目的地,或要求分别制作本地版本。复用社交链接,不能替代这一选择,也不能说明活动只能触达预期受众;分发设置和实际发帖计划仍需单独批准。
再设想相反清单:3 家分店的来源标识都配 1 个共用网站链接,社交链接却不同。批准网站后,创作者仍面对多个社交目的地。简报应明确每条计划帖子对应哪个来源标识、哪个社交去向,不能依靠网站分组自动得出答案。
根据团队自己的清单填写这些字段:
活动与预期范围:[活动;涵盖的地点或受众]。
来源与纳入的标识:[系统;导出日期;采集器;记录标识符]。
每个标识的链接:[完整网站 URL;社交平台;完整社交 URL 或未验证字符串]。
拟议配对与成员:[每组网站/社交组合由哪些来源标识使用]。
已批准的选择:[选定目的地及理由;审核者;核查日期]。
待解决事项:[缺失或不确定的值;负责人;下一步行动]。
标识清单让范围可核查,批准记录则说明最终决定。目的地变更后,团队能看到它关联过哪些标识,并重新检查相应条目;若有意复用链接,也可继续分组而不丢失成员关系。简短简报因此能保留这些联系,无需复制整份来源导出文件。
把每组关联保留在活动工作表中
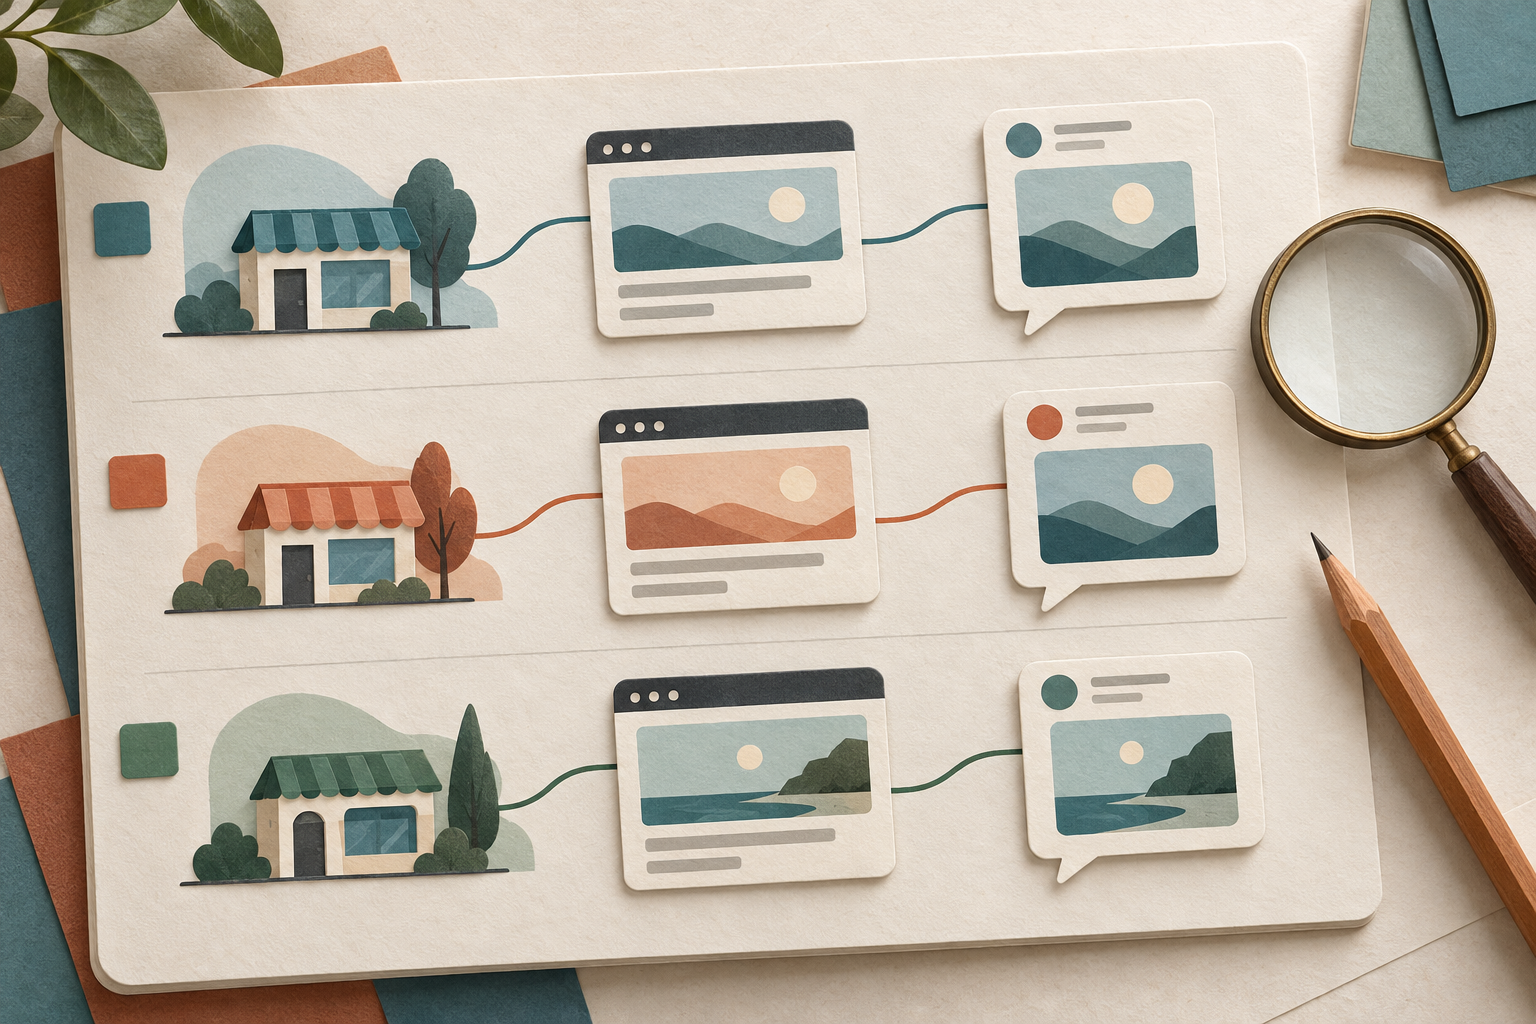
保留来源标识
在条目中保留来源标识及活动预期范围。
关联两类目的地
标明每个来源标识对应的网站与社交值,包括共用值。
记录获批选择
将当前核查、选定目的地和未决事项一并保留在简报中。
我们如何比较所提供的链接
我们从 AllThePlaces 标为 2026年10月10日的批次中,选取了 10 份导出文件;文件的采集时间戳跨 10月10–13日。在查看目的地结果之前,就按固定的一组基于 Yext 的采集器及源代码规则完成选择。这只是对这些导出文件的有限比较,不是具有代表性的企业样本。[1]
一条记录由采集器和来源标识共同确定。分析前,我们已规定如何处理缺少标识、标识重复和目的地值冲突。实际文件中的 15,797 个要素,全部对应到 15,797 个来源标识,没有缺失或无效标识、标识组冲突或重复多余记录。之后,才分别评估网站和社交字段质量。
URL 必须符合可用的 HTTP 或 HTTPS 语法,社交字段还须使用对应平台允许的主机名。我们将协议和主机名转为小写,保留路径、查询字符串、片段及其他差异;不跟随重定向,也不假设不同写法代表不同真实账号。全部观测目的地值均按固定规则归为 URL、原样字符串或缺失,没有未能分类的目的地值。[2]
完整输出保留每个采集器和平台,包括配对为 0 的情况。分组始终在采集器内部进行,复用也只在同一配对记录集中判断。7 张汇总表保留了完整的双向组大小分布及配对缺失情况核算;独立复现来源数据后,全部 7 张表的结果一致。下载包提供方法和可移植分析代码,原始来源文件需另行下载。[7]
图表 CSV 含 170 个计数值,每条数据行 1 个,来自 4 张图表中的 50 行。ZIP 保留全部 7 张汇总表,包括完整配对覆盖和组大小分布;不含记录级来源标识或目的地字符串。附有说明译文;复现需要另行下载公开原始来源文件。
来源与注释
- 来源:AllThePlaces 贡献者。固定批次标记为 2026-10-10-13-32-41,选定的 10 个文件报告的采集时间戳为 2026年10月10–13日。筛选依据是固定在修订 e4264a6b9586fccd8815fe1796981e0ffce51e5f 的当前 Yext 采集器源代码,以及带日期的采集器清单。这不能确定每个文件实际使用的历史代码版本。采集器名称标识导出文件;Bravo 可能含多个品牌,OZK 含银行/ATM 记录。
- 比较仅在去除规则允许的首尾空白后,将 URL 协议与主机名转为小写。HTTP/HTTPS 差异、端口写法、路径、查询字符串、片段,以及空查询或空片段的分隔符均保留。社交 URL 必须使用为其字段声明的主机名。我们没有检查重定向、页面内容或账号身份;不同的源字符串仍可能指向同一个真实目的地。
- Facebook URL 配对共 3,843 条。固定的 4 类复用状态分别为:两者都重复 0 条、仅 Facebook 重复 1,758 条、仅网站重复 649 条、两者都不重复 1,436 条。复用只在各采集器配对集内定义。全部 1,758 条仅 Facebook 重复记录来自 Staples;649 条仅网站重复记录中,Lush 为 408 条,OZK 为 241 条。完整组大小分布保留在研究包中。
- 在 15,797 个已确定的来源标识中,Facebook 覆盖情况为:网站与 Facebook URL 都有的 3,843 条、仅网站 9,174 条、仅 Facebook 8 条、两者都无 2,772 条。其中,8 条仅 Facebook 记录分别来自 J.Crew 7 条和 Madewell 1 条。这 4 类覆盖状态划分了全部来源标识,而单独的“有网站”和“有 Facebook”两列则有重叠。
- 当前源代码含字段移除与补充步骤。AutoZone 通过共用管道移除 Twitter,并在自身采集逻辑中移除 Instagram 和 2 个特定 Facebook 值;Coffee Bean 也移除 Twitter。之后的 Name Suggestion Index 补充步骤可能填入缺失字段。但这些当前机制,不能证明某个历史导出值或缺失项的具体来源。
- 社交字段字符串指符合固定保守字符规则的非 URL 字符串。其拼写、大小写和开头的 @(如有)均保留;不将字符串等同于 URL,也不验证其是否为账号。与网站配对的字符串集中,Instagram 有 3,711 条记录,Twitter 有 3,501 条,同一来源标识可进入两组。0 配对行继续显示。
- AllThePlaces 以 CC0 提供其生成的数据。Influence IQ 据此形成汇总比较和分析代码,结果不表示来源项目或具名采集器为其背书。研究包包含全部 7 张汇总表及复现说明译文,不含记录级标识或目的地字符串;复现分析需另行下载公开原始来源文件。
本文的英文版为源版本。所有语言版本描述的都是 2026年10月10–13日采集的同一批 10 份选定 AllThePlaces 导出文件。翻译不会使这些发现变成本地市场或当前企业的基准。