2 个审核标签可能来自不同审核者
评论审核的交接记录可能列出 2 个标签,却没有说明是谁选择的。历史维基百科判读记录显示,这个缺失细节为何会影响下一位审核者理解案例。
Influence IQ 对 Wikipedia Detox 历史人身攻击数据集中选定判读的原创分析。分析于 2026 年 10 月 25 日(UTC)完成。
摘要
在选定的 13,824 个维基百科历史讨论片段中,有 155 个在各自的 10 份个体判读里,同时出现过“引用或转述”标签和“针对接收者的人身攻击”标签。其中 98 个片段至少有 1 名审核者同时选择两项;其余 57 个的两个标签仅由不同审核者提供,占 36.8%。这个百分比描述的是这 155 个片段,而不是全部 13,824 个。[1][4]
对管理社交媒体评论的企业和创作者来说,实际启示在于交接:每位审核者的观察,应与其本人的判读一同保留。2 个标签一起出现,并不能证明同一人选择了两项。本研究描述历史讨论片段的主观判读,不是在认定审核错误,也不是删除评论的规则。下方可复制的工作表,将这种区分落实为审核记录。
设想一位创作者请同事查看一条难以判断的评论。交接记录有 2 个标签:有人在引用或转述一段攻击性言论,也有人在向接收者发起人身攻击。作决定前,同事还需要知道:这两项观察是否来自同一名审核者?
汇总记录很容易丢失这个区别。可能是 1 人同时选了两项,也可能是 2 人关注了同一文本的不同方面。单看标签列表,下一位审核者无法判断是哪一种情况,也可能看不清每个人指的是哪些文字。
我们利用一个既有研究数据集中的个体判读,研究了这个问题。原始材料来自维基百科讨论页。在这里,我们用它说明标签与审核者之间的对应关系,再帮助企业或创作者思考自己的交接应保留哪些信息。
让每条观察与作出观察的审核者保持对应
先弄清每个标签描述的是什么
第 1 项询问:文本是否引用或转述了另一条评论中的人身攻击。第 2 项关注:文本是否有人身攻击直接针对接收者。审核者可以多选。这些是对呈现文本的判读,并非隐藏文本的决定,也不能证明有人违反了规则。[2]
只要 10 名审核者中至少有 1 人选中某个标签,我们就将该标签记为出现。这比较的是任一审核者是否作过选择,不要求多数,也不把标签称为共识或检验其是否正确。
13,824 个选定片段中,12,025 个没有出现这 2 个标签;406 个出现了“引用或转述”,但没有“针对接收者”;1,238 个出现了“针对接收者”,但没有“引用或转述”。剩下的 155 个,在各自的判读记录里出现过两项标签。
这些描述只涉及这 2 个选项。没有“针对接收者”标签的片段,仍可能有其他类型的攻击标签;“引用或转述”标签也不能证明文本无害。名称越准确,越不容易把一个有用类别悄悄扩大成更宽泛的结论。
13,824 个选定片段的标签分布
只要 10 名审核者中至少有 1 人选中某标签,就记为该标签出现。这 5 类仅涉及 2 个特定选项;“两项均未出现”不代表片段没有任何类型的人身攻击标签。
| “引用或转述”和“针对接收者”标签 | 片段数 |
|---|---|
| 这 2 项标签均未出现 | 12,025 |
| 有引用或转述标签,无针对接收者标签 | 406 |
| 有针对接收者标签,无引用或转述标签 | 1,238 |
| 两项标签均出现,且至少 1 名审核者同时选择两项 | 98 |
| 两项标签均出现,仅由不同审核者分别选择 | 57 |
57 个片段有两项标签,却没有审核者同时选择两项
在这 155 个片段内,我们追查了每个标签对应的个体回答。98 个至少有 1 人对同一片段同时选择两项。另 57 个的“引用或转述”和“针对接收者”选择,仅来自不同的人;其中没有任何一份个体回答包含这对选项。
63.2% 的片段至少有 1 名审核者同时选中两项,36.8% 的两项标签仅由不同审核者提供。两组都属于同一个严格界定的 155 个片段集合。13,824 个片段的较大筛选范围仍然重要,因为它说明了这项条件比较从何而来。[4]
这个区别决定了可以如何描述汇总结果。知道两项标签都出现过,只能说明判读记录里有人选过每一项;单凭这一点,不能说某位审核者同时用这两种方式描述了文本。
同一审核者同时选择两项,也不能确定文字究竟是什么意思。原始片段可能拼接了维基百科 1 次修订中新增的内容,其中可包含不止 1 条帖子。某人两项都选,并不能说明被引用的那一段本身就是针对接收者的攻击。我们没有查看具体片段来解释审核者的判读。[2][6]
155 个片段中,57 个没有审核者同时选择两项
本比较只纳入 155 个选定片段,它们的 10 份判读记录中两项标签均曾出现。这里使用任一审核者的选择,不是多数共识,也不是经核实的审核结果。
| 两项标签由谁选择 | 片段数 | 占 155 个片段的比例 |
|---|---|---|
| 至少 1 名审核者同时选择两项 | 98 | 63.2% |
| 两项标签仅由不同审核者分别选择 | 57 | 36.8% |
把标签背后的观察交给下一位审核者
在企业里,案例可能从看评论的人转给账号负责人;对创作者而言,可能从助理转给创作者本人。接手者需要先了解前一个人注意到了什么,再决定回复、补充背景信息,还是按账号现有规则处理。
把每个人的选择保留在一起。某位审核者两项都选,就保留为其本人的判读;2 名审核者分别选择不同选项,就保留各自的回答。一个案例可以容纳多种理解,不必把它们拼成一个从未有人作出的判断。
再简短说明相关段落。在自己的流程中,指出哪些内容似乎是引用、似乎在对谁说话,以及哪条前后回复有助于理解对话。现有背景无法回答的地方,应保留不确定性。这些是实际工作建议;数据集没有测试它们会怎样影响决定。
一条简短记录就可能够用。目的是让接手者理解前一位的思路,而不必重做整次审核。团队换班,或品牌与创作者之间交接时,应同时传递原观察及其对应类别。
标签总数相同的虚构示例
设想 2 个虚构审核小组,每组有 10 人评估 1 个虚构片段。它们只用来说明计数方式,不是数据集中的真实人物、原文引述或案例。两组汇总都显示:1 次“引用或转述”选择和 1 次“针对接收者”选择。[8]
第 1 组中,审核者 A 选择两项,另外 9 人两项都没有选。有 1 人的回答同时包含这对选项。交接时可以准确保留此人的组合判读,同时把最终处理行动留作另行决定。
第 2 组中,审核者 A 选择“引用或转述”,审核者 B 选择“针对接收者的人身攻击”,其余 8 人两项都未选。字段总数仍各为 1 次,但没有人同时选两项。若把它称为某个人的组合判读,就会添加个体回答中并不存在的关系。
这也说明了为何我们按片段计数,而不累加所有符合条件的人。如果第 1 组有 2 人各自同时选中两个标签,该片段仍只在“存在同一审核者同时选中两项”的类别中计 1 次。分类问的是这种组合是否存在,而不是有多少人提供了它。
第 2 组的简短虚构交接记录可以这样写:“尚未作决定。审核者 A 观察到引用或转述;审核者 B 观察到针对接收者的文字。请将 2 份记录与片段及之前的回复一同保留。账号负责人会先确认各审核者指的是哪一段,再选择处理行动。”这传递的是一个尚未解决的问题,没有把 2 人的回答改写成 1 人的结论。
实际交接时,应保留第 2 组中那 2 份独立说明。接手者可以结合文本阅读、询问每个人的意思,再依据账号规则作决定。本研究并未证明哪位审核者是对的,也未确定这个虚构案例应如何处理。
相同的标签总数,可能来自不同判读组合
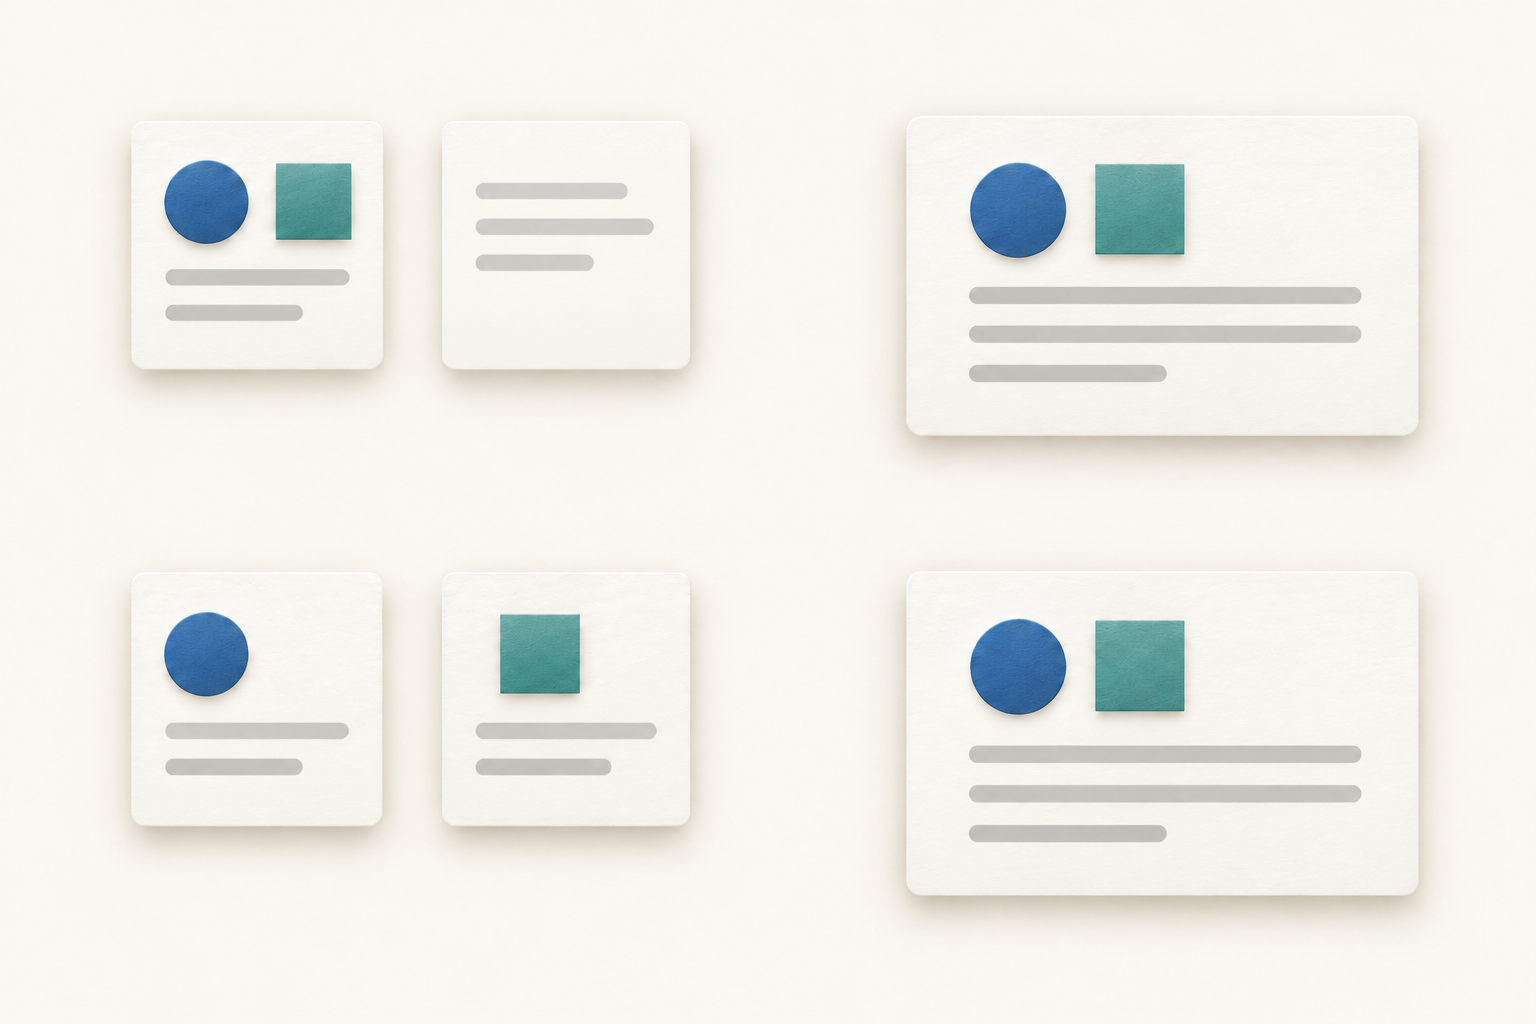
1 名审核者同时选择两项
第 1 个虚构小组中,1 人同时选择两项标签,9 人两项都未选。
2 名审核者各选择 1 项
第 2 组中,1 人选择“引用或转述”,另 1 人选择“针对接收者的人身攻击”,其余 8 人两项都未选。
把内容描述与依据规则作出的决定分开
描述评论里出现了什么,与决定如何处理,目的不同。审核者可能注意到引用内容,而账号负责人仍需考虑前后交流和适用规则。分开保留这些步骤,后来读记录的人才看得清决定是如何作出的。
企业与创作者合作时,应在遇到棘手对话前约定谁来作决定。了解产品投诉的人,未必有权调整账号的评论审核方式。清楚的交接可以列明这 2 种角色,而不假定每个案例都需要多名审核者。
独自工作的创作者,也可以在一条记录中作同样区分:注意到了什么、检查了哪些背景,以及作出了什么决定。1 个人可以完成多个步骤,同时写清各自目的。数据集并未表明增加人手或再加一层审核能改善结果。
在理解各项观察的关系前,先分别保留。不同选择可能反映关注点不同,不一定是说法矛盾。“引用或转述”不是自动豁免,“针对接收者”也不能当成本研究支持的删除建议。下一步应依据实际交流及账号规则,而不是从这些历史样本百分比推断处理行动。
可复制的评论审核工作表
把以下字段复制到现有审核文档或交接记录中。只使用团队所需的信息,按对话的性质限定访问范围。这里的工作表无需注册即可使用;它是实际工作建议,并非研究观察到的原有流程。[8]
案例:[链接或内部参考信息]。账号/渠道:[对话出现的位置]。检查时间:[日期和时间]。请保持引用信息稳定,方便接手者找到同一份材料。
目的:[需要作决定的问题]。负责人:[由谁作决定]。接手人:[如需交接,应交给谁]。
待审文本:[保留在获准使用的工作区内的审核段落]。前后文:[相关的较早或较晚回复]。缺失背景:[无法检查的内容]。
审核者:[姓名或内部审核者标识]。判读时间:[日期和时间]。即使多人使用相同标签,每个人的记录也应分开保留。
引用或转述观察:[是、否或不明确]。依据:[哪段文字似乎在引用或转述他人的人身攻击?]。不能用这项记录判定文本无害。
针对接收者的观察:[是、否或不明确]。依据:[哪段文字似乎指向接收者,为什么?]。这项判断应单独作出,不要由“引用或转述”观察代替。
其他相关观察:[账号规则还需考虑的其他问题]。不能把这 2 个研究标签中某一项缺失,当作对整个交流的完整描述。
判读之间的关系:[至少 1 名审核者同时选择两项、不同审核者各选不同项,或不明确]。若审核者选择不同,应先保留每人的说明,再汇总案例。
规则依据:[适用规则或指引]。决定:[实际选定的行动,或尚待解答的问题]。理由:[观察和前后文如何支持这一决定]。
后续处理:[如有需要,下一步由谁做什么]。交接时间:[何时转交给此人]。结果:[如已核查,作决定后发生了什么]。不能把计划中的行动记为已完成。
再次审核的条件:[如果需要重看,写明具体事件或缺失的背景]。工作表不要求每个案例反复审核;应按具体情况写出再次查看的理由。
年份检查保留了同一批 155 个片段
计算标签组合前,我们预先规定了 2 项辅助检查。第 1 项排除记录年份为 2016 的片段,因为发布文件的年份范围超出了来源概览和原始论文所述时期。这样剩下 13,809 个合格的随机抽样组片段;两项标签都出现的仍是同样的 155 个,98/57 的划分也不变。[5]
另一项检查采用数据集中围绕封禁事件另行抽样的材料。沿用恰有 10 份判读的规则后,得到 42,383 个片段。其中 2,457 个出现过两项标签:1,354 个至少有 1 名审核者同时选中两项,1,103 个的两个标签仅来自不同的人,分别占 55.1% 和 44.9%。
封禁事件富集样本的抽样目的不同,因此单独保留。它的百分比不替代主结果,也不能作为当前品牌评论的证据。年份检查回应的是记录中的日期范围;两项检查都不改变这些结果源自选定历史片段主观判读的性质。
2 项预先选定检查的比较
各行均要求每个片段恰有 10 份完整判读记录。封禁事件富集样本另有抽样目的。排除 2016 年,是为检查发布文件的年份范围与来源说明之间的差异。
| 预先选定的比较 | 合格片段数 | 两项标签均曾出现的片段数 | 至少有 1 名审核者同时选择两项的片段数 | 两项仅由不同审核者分别选择的片段数 | 两项标签均出现的片段中,仅由不同审核者分别选择的占比 |
|---|---|---|---|---|---|
| 随机抽样组,恰好 10 份判读记录 | 13,824 | 155 | 98 | 57 | 36.8% |
| 封禁事件富集样本,单独处理 | 42,383 | 2,457 | 1,354 | 1,103 | 44.9% |
| 排除 2016 年的随机抽样组 | 13,809 | 155 | 98 | 57 | 36.8% |
我们如何将标签追溯到个体判读
我们使用 Wikipedia Detox 项目公开数据集 Wikipedia Talk Labels: Personal Attacks 的第 6 版。发布文件含有从历史讨论页修订记录提取的文本,以及每个片段对应的多份众包标注者判读。本分析使用这些个体回答,没有生成新判读,也没有评估审核系统。[1][2]
主比较从发布数据的随机抽样组出发,只保留恰有 10 份完整且互不重复的判读记录的片段。固定为 10 份,让每个片段获得成对选择的机会数相同。但这也意味着,发布的 37,492 个随机抽样组片段中仅有 13,824 个入选,结果不代表整个原组。[3]
每个选定片段贡献 1 次计数。我们先检查两项标签是否各自出现过,再检查是否有人对同一片段在一份回答中同时选择两项。5 个类别互斥,合计 13,824 个。155 这个分母来自两项标签均出现的 2 个类别,不是所有判读或全部来源片段。[4]
查看配对情况前,我们固定了抽样组、覆盖规则、年份检查,并要求主条件比较至少包含 100 个片段。实际观察到的 155 个达到要求。我们没有设定必须达到的百分比,没有为得到某种结果更改规则,也没有把封禁事件富集材料与随机组混合。
原研究已经使用个体判读,后续工作则按各攻击字段分别取多数结果。我们更窄的贡献,是在固定的一组判读中,描述这 2 个选项由谁提供;并非在纠正那些研究的方法。下载包提供汇总结果、方法和复现说明,复现所需的公开来源文件须另行取得。[6][7]
让下一位审核者更容易看懂
社交媒体评论审核交接中,真正有用的问题是:每项观察是谁作出的,描述的又是什么。在这项选定历史资料的比较里,两项标签都出现的 155 个片段中,有 57 个没有任何审核者同时选择两项。若汇总只留下标签名称,这个关系就会丢失。
把个人观察、相关背景和最终决定联系起来。企业或创作者就能说明案例包含什么、所选行动为何由此而来,而不必让一个类别标签代替整次审核。
无需注册。资料包包括匿名汇总结果、方法、复现说明和可复用工作表,不含原始讨论文本、修订记录 ID、众包标注者 ID 或人口统计资料。原始公开来源文件可从所链接的发布页另行取得。
来源与注释
- 来源:Wikipedia Talk Labels: Personal Attacks,Figshare 第 6 版,DOI 10.6084/m9.figshare.4054689.v6,于 2017 年 2 月以 CC0 发布。我们使用 attack_annotated_comments.tsv(文件 7554634)和 attack_annotations.tsv(文件 7554637),检查了发布方 MD5 及独立计算的 SHA-256。Influence IQ 于 2026 年 10 月 25 日(UTC)完成筛选、计算和解读。研究未收集新评论、生成新标注或测量实时社交平台。
- 发布方将 quoting_attack 定义为标注者认为文本在引用或转述另一条评论中的攻击,将 recipient_attack 定义为针对接收者的人身攻击。界面允许多选。总体攻击判断是来源中单独的回答项,本分析没有对各子类型作 OR 运算来重建它。发布文本拼接了某次修订新增的内容;它不是编辑摘要,也不一定是 1 条完整帖子或一段完整对话。讨论命名空间、抽样组与模型数据划分(train/dev/test,即训练/开发/测试),均沿用来源文档的含义。
- 完整文件包含 115,864 个唯一片段、1,365,217 个唯一的“修订记录/标注者”判读对,以及 4,053 名标注者。结构检查未发现重复配对、无对应记录的关联、格式错误行,或缺失、无效的标记值。纳入条件是恰有 10 份完整且互不重复的判读记录,5 个来源标记都完整,并覆盖文档列明的 2 种讨论命名空间和全部模型数据划分;每个片段按相同权重计 1 次。主要随机抽样组保留了 37,492 个中的 13,824 个片段;另行选取的封禁事件富集组保留了 78,372 个中的 42,383 个。标注者可在不同片段中重复出现;我们没有合并相同文本、因跨标记一致性而删记录,或重编码总体攻击判断。
- 对合格片段,用 Q 表示出现过“引用或转述”选择,用 R 表示出现过“针对接收者”选择。两项出现,要求 10 份判读中至少某处有 1 次 Q、某处有 1 次 R;同一审核者组合还要求同一条“修订记录/标注者”回答同时包含 Q 和 R。仅由不同审核者提供的情况,则没有这样的回答。主要条件分母为 98 + 57 = 155;精确分数 98/155 和 57/155 分别显示为 63.2% 与 36.8%。百分比按精确有理数计算,并以四舍五入保留 1 位小数。配对计算前,我们要求主条件比较至少有 100 个两项标签均出现的片段,没有设置有利百分比门槛。研究未给出总体置信区间、未作显著性检验,也未提出独立性主张或准确率估计。
- 预先规定的封禁事件富集敏感性检查,沿用恰有 10 份判读的规则,并与主要随机组分开。其 5 类计数依次为:两项均无 20,911 个;有“引用或转述”、无“针对接收者”959 个;有“针对接收者”、无“引用或转述”18,056 个;同一审核者同时选两项 1,354 个;仅不同审核者提供两项 1,103 个。总数 42,383,条件分母 2,457。随机主样本排除 2016 后剩下 13,809 个,同序的 5 类计数为 12,012 / 406 / 1,236 / 98 / 57。条件集合仍为同样的 155 个,98/57 的划分不变。这些只是描述性检查,不是独立总体重复验证,也不能证明两种抽样组可比。
- Wulczyn、Thain 与 Dixon 于 2017 年发表的《Ex Machina: Personal Attacks Seen at Scale》,奠定了底层众包与建模工作。Cécillon 及其合作者的 2020 年 WAC 论文保留了“标注者—字段”矩阵,并对各攻击字段分别按多数汇总。这些是既有方法,本研究并未证明它们有误。我们的比较使用 10 人中任一人选择即记为出现,以及同一回答内的配对,不是检验多数标签的表现。Influence IQ 比较的是:每个选定片段中的这 2 项,由同一审核者提供,还是仅由不同审核者提供。
- 来源概览写的是 2001–2015 年,原始论文写的是 2004–2015 年,而固定的第 6 版文件含有 2001–2016 年的年份值。发布方的登录状态字段说明写为 0/1,实际文件使用 False/True;二元标记的字符串则为 0.0/1.0。我们保留这些文档与实际观察的差异,没有推定原因。解析器接受发布文件中的精确字面值,不对标签值作舍入或强制转换。资料包记录了来源版本、筛选规则,以及利用公开文件复现分析的步骤。
- 这 2 个各有 10 人的审核小组、审核者 A/B 的回答和交接选择,都是虚构教学示例,不含数据集中的原讨论文本或标识符。两组都各有 1 次“引用或转述”选择和 1 次“针对接收者”选择,但只有第 1 组存在同一人的组合选择。工作表和概念插图仅用于实际说明,并非观察到的来源流程、经过测试的审核政策,或能作出更好决定的保证。
各语言版本均直接从英文源文翻译。所有版本描述的是同一套历史英语维基百科数据集和选定判读,翻译不会生成其他本地市场的发现。Influence IQ 对分析、解读和翻译负责。