Trưng bày sản phẩm thương mại điện tử: kiểm tra giả định về vị trí
Thí nghiệm 10 sách trong quá khứ cho thấy điều chỉnh vị trí đơn giản có thể bỏ sót phần nào của mẫu hình và cách kiểm tra giả định trước khi so thẻ sản phẩm.
Phân tích lại gốc thí nghiệm chọn sách 2024 đã công bố của Compiani, Morozov và Seiler.
Tóm tắt
Trước khi quyết định sản phẩm chào bán này hấp dẫn hơn sản phẩm khác, doanh nghiệp cần xét mỗi sản phẩm xuất hiện ở đâu. Chúng tôi dùng thí nghiệm 2024 đã công bố với 10 sách điện tử để kiểm tra 2 cách tính đến vị trí. Cho mỗi vị trí điều chỉnh riêng dự đoán lựa chọn tốt hơn tổng thể so với cùng điều chỉnh cho mỗi bước xuống danh sách. Nó kém chính xác hơn ở một số vị trí, nên so sánh đầy đủ quan trọng.
Cả hai mô hình dùng cùng thông tin sách và giá. Chúng tôi ước lượng từ 6.176 người và kiểm tra dự đoán trên 3.088 người khác. Lựa chọn giả định và ai cũng phải chọn một sách. Với doanh nghiệp, nhà sáng tạo so thẻ sản phẩm, bài học là kiểm tra giả định vị trí trước khi quy kết quả cho đề nghị. Nghiên cứu không ước tính tăng doanh số hay xác định thứ tự sản phẩm tốt nhất.
Giả sử sản phẩm đầu trang nhận nhiều lượt nhấp nhất. Sản phẩm chào bán hấp dẫn hơn hay vị trí trong danh sách giúp ích? Doanh nghiệp cần câu trả lời hữu ích trước khi viết lại thẻ khác, giảm giá món có vẻ yếu hoặc đổi danh mục.
Tính đến vị trí nghe đơn giản đến khi hỏi bằng cách nào. Mỗi bước xuống danh sách có nên cùng mức điều chỉnh? Chúng tôi dùng thí nghiệm quá khứ so cách đơn giản đó với cách linh hoạt hơn, rồi kiểm tra cả hai trên người không dùng để ước lượng mô hình.
Cùng sản phẩm, vị trí khác
So sánh vị trí sản phẩm nên cho biết gì?
So thẻ sản phẩm nên giúp tách món chào bán khỏi cách trình bày. Nếu sản phẩm này thường đầu và sản phẩm kia thường cuối, chỉ tổng số không trả lời người mua thích sản phẩm chào bán nào hơn.
Cách đơn giản được kiểm tra cho mỗi bước xuống danh sách cùng điều chỉnh vào điểm sở thích nền của mô hình. Câu hỏi hữu ích là nó dự đoán đủ tốt không so với cho vị trí khác có điều chỉnh khác.
Chúng tôi kiểm tra 2 cách bằng thí nghiệm chọn sách đã công bố. Kết quả liên quan doanh nghiệp, nhà sáng tạo so sản phẩm trên trang bộ sưu tập hoặc cửa hàng số. Nó cho cách xem giả định đo lường, không phải quy tắc đặt món bán chạy nhất ở đâu.
Điều này quan trọng khi sản phẩm chào bán xuất hiện ở nhiều hơn 1 vị trí. Nhà sáng tạo có thể giới thiệu cùng bản tải trong bộ sưu tập và trang ra mắt. Nhà bán lẻ có thể đổi thứ tự danh mục. Món, giá, đối tượng và trình bày có thể cùng khác. Điều chỉnh vị trí là giả định về một phần so sánh và cần kiểm tra riêng.
Mọi người chọn gì trong thí nghiệm sách?
Giovanni Compiani, Ilya Morozov và Stephan Seiler yêu cầu người tham gia được tuyển qua Prolific chọn giả định từ 10 sách điện tử, với thứ tự và giá ngẫu nhiên. Người tham gia phải chọn sách; không có phương án không mua gì. Chúng tôi dùng tác vụ đầu trong mỗi lượt nộp giữ lại, không dùng tác vụ sau bỏ sách đã chọn.[1]
Tác giả đã báo cáo phản ứng với vị trí và giá. Nghiên cứu rộng hơn xem văn bản và hình ảnh giúp ước lượng thay thế sản phẩm ra sao. Câu hỏi chúng tôi hẹp hơn: thay một thành phần vị trí duy nhất có cải thiện dự đoán cho người có lựa chọn được giữ ngoài quá trình ước lượng không?
Theo quy tắc điều kiện gốc còn 9.265 lượt nộp với 9.264 mã người tham gia Prolific riêng biệt. 1 mã xuất hiện 2 lần. Chúng tôi giữ cả hai cùng nhau và cho người đó tổng trọng số như mọi người khác. Lượt nộp không tự động là người riêng, và tác vụ đầu không nhất thiết lần đầu người đó tiếp xúc thí nghiệm.[2][3]
Ngày nguồn giữ lại từ 11/6 đến 26/6/2024. Bản thảo mô tả 14–27/6, nên chúng tôi công bố khác biệt và không loại theo ngày. Điều kiện quốc gia, tuổi chưa xác lập trong tư liệu đã xem; đây không phải ước lượng cho người mua Mỹ hay quần thể quốc gia khác.[1][2]
Giữ các lượt nộp của mỗi người cùng nhau suốt phép so sánh
Lượt tác vụ đầu được chọn sau quy tắc điều kiện gốc của tác giả; ngày nguồn giữ lại 11–26/6/2024.
| Nhóm | Người tham gia (theo mã nền tảng) | Lượt nộp giữ lại |
|---|---|---|
| Toàn bộ giữ lại | 9.264 | 9.265 |
| Huấn luyện | 6.176 | 6.176 |
| Giữ riêng để đánh giá | 3.088 | 3.089 |
Mô hình vị trí nào dự đoán lựa chọn nhóm giữ riêng tốt hơn?
Mô hình vị trí linh hoạt dự đoán lựa chọn nhóm giữ riêng tốt hơn theo thước đo điểm định trước. Cả hai tính đến sách được chào và giá hiển thị. Chỉ khác cách biểu diễn vị trí.
Mô hình cơ sở dùng 1 hệ số cho mỗi bước xuống danh sách. Mô hình linh hoạt dùng điều chỉnh riêng cho vị trí 2 đến 10 so với đầu tiên. Nó có thêm tự do nhưng cũng nhiều tham số cần ước lượng. Khớp dữ liệu huấn luyện tốt hơn tự nó không giải quyết so sánh.
Vì vậy, chúng tôi ước lượng cả hai bằng 6.176 người và đánh giá trên 3.088 người còn lại. Mọi lượt nộp của một người ở cùng phía phân chia. Nhóm kiểm tra có 3.089 lượt nộp vì gồm người lặp.
Để so dự đoán, chúng tôi dùng điểm log âm. Mô hình chịu phạt nhỏ hơn khi gán nhiều xác suất cho lựa chọn người thực sự đưa ra. Phạt lớn hơn khi gán rất ít xác suất cho lựa chọn đó. Điểm log âm trung bình thấp hơn tốt hơn.
Trung bình trên nhóm giữ riêng là 2,2260 cho mô hình cơ sở và 2,2154 cho mô hình linh hoạt, theo đơn vị log tự nhiên, còn gọi là nat. Đây là điểm dự đoán, không phải phần trăm câu đúng. Điểm huấn luyện và kiểm tra cùng hiển thị để so sánh không dựa vào việc dễ hơn là mô tả dữ liệu mô hình đã thấy.
2 mô hình, đánh giá trên cùng người
Lựa chọn tác vụ đầu 10 sách năm 2024 được chọn. Huấn luyện: 6.176 người và lượt nộp. Kiểm tra: 3.088 người, 3.089 lượt nộp.
| Mô hình vị trí | Điểm huấn luyện (nat) | Điểm nhóm giữ riêng (nat) |
|---|---|---|
| 1 thành phần vị trí tuyến tính | 2,2046 | 2,2260 |
| Thành phần vị trí riêng | 2,1899 | 2,2154 |
Mức cải thiện ghép cặp là 0,0106 nat mỗi người, với khoảng 95% xấp xỉ từ 0,0044 đến 0,0168. Ở đây, cải thiện dương ủng hộ mô hình linh hoạt. Kết quả nhỏ trên thang điểm này, nhưng khoảng nằm trên 0.[4]
Khoảng này coi 2 mô hình đã ước lượng là cố định và giả định các nhóm người độc lập. Không gồm độ bất định do ước lượng trên mẫu huấn luyện khác. Kết quả hỗ trợ cải thiện dự đoán trong tác vụ quá khứ được chọn; không biến chênh điểm thành tăng doanh số.
Mô hình linh hoạt cải thiện điểm log trên nhóm giữ riêng
So sánh ghép cặp trong 3.088 người tham gia thuộc nhóm kiểm tra của tác vụ 10 sách quá khứ được chọn.
| So sánh | Cải thiện (nat) | Khoảng 95%: cận dưới (nat) | Khoảng 95%: cận trên (nat) |
|---|---|---|---|
| Điểm log linh hoạt trừ cơ sở | 0,0106 | 0,0044 | 0,0168 |
2 mô hình lệch lựa chọn quan sát ở đâu?
So sánh đầy đủ theo vị trí cho thấy vì sao điểm tổng thể cần chi tiết đi kèm. Với mỗi vị trí, chúng tôi so tỷ lệ chọn quan sát với xác suất trung bình mỗi mô hình gán. Đây là trung bình có trọng số bằng nhau cho từng người ở nhóm giữ riêng, không phải tỷ lệ nhấp.
Ở vị trí 1, tỷ lệ quan sát là 17,16%. Mô hình cơ sở dự đoán 14,64%, linh hoạt 17,73%. Ở vị trí 10, quan sát 9,18%, so dự đoán 6,37% và 8,74%. Mô hình linh hoạt gần hơn ở hai đầu danh sách cụ thể này.
Lựa chọn quan sát và dự đoán ở cả 10 vị trí
Nhóm giữ riêng: 3.088 người, 3.089 lượt nộp tác vụ đầu từ thí nghiệm 2024 công bố.
| Vị trí | Tỷ lệ chọn quan sát | Xác suất trung bình cơ sở | Xác suất trung bình linh hoạt | Lượt nộp có lựa chọn ở vị trí này |
|---|---|---|---|---|
| Vị trí 1 | 17,16% | 14,64% | 17,73% | 530 |
| Vị trí 2 | 13,60% | 13,20% | 14,84% | 420 |
| Vị trí 3 | 9,91% | 12,06% | 9,74% | 306 |
| Vị trí 4 | 10,91% | 11,21% | 9,26% | 337 |
| Vị trí 5 | 9,20% | 10,09% | 8,94% | 284 |
| Vị trí 6 | 7,08% | 9,25% | 8,01% | 219 |
| Vị trí 7 | 8,00% | 8,44% | 7,57% | 247 |
| Vị trí 8 | 7,12% | 7,67% | 7,47% | 220 |
| Vị trí 9 | 7,84% | 7,08% | 7,69% | 242 |
| Vị trí 10 | 9,18% | 6,37% | 8,74% | 284 |
Mô hình linh hoạt không gần hơn mọi nơi. Ở vị trí 4, quan sát 10,91%. Cơ sở dự đoán 11,21%, linh hoạt 9,26%. Thêm linh hoạt cải thiện điểm giữ riêng tổng thể nhưng để sai lệch lớn hơn tại vị trí đó.
Bảng tiếp cho tỷ lệ quan sát trừ dự đoán. Chênh dương nghĩa là mô hình dự đoán quá ít lựa chọn ở vị trí; chênh âm là quá nhiều. Giữ cả 10 vị trí tránh lấy một đầu có vẻ tốt đại diện toàn phép so.
Chênh lệch của cả hai mô hình với lựa chọn quan sát
Tỷ lệ chọn quan sát trừ xác suất dự đoán trung bình cho mỗi vị trí trong 10 vị trí, dùng cùng 3.088 người tham gia thuộc nhóm kiểm tra.
| Vị trí | Quan sát trừ cơ sở | Quan sát trừ linh hoạt |
|---|---|---|
| Vị trí 1 | 2,52 điểm phần trăm | -0,57 điểm phần trăm |
| Vị trí 2 | 0,41 điểm phần trăm | -1,24 điểm phần trăm |
| Vị trí 3 | -2,15 điểm phần trăm | 0,17 điểm phần trăm |
| Vị trí 4 | -0,29 điểm phần trăm | 1,65 điểm phần trăm |
| Vị trí 5 | -0,89 điểm phần trăm | 0,26 điểm phần trăm |
| Vị trí 6 | -2,17 điểm phần trăm | -0,93 điểm phần trăm |
| Vị trí 7 | -0,44 điểm phần trăm | 0,43 điểm phần trăm |
| Vị trí 8 | -0,55 điểm phần trăm | -0,35 điểm phần trăm |
| Vị trí 9 | 0,76 điểm phần trăm | 0,14 điểm phần trăm |
| Vị trí 10 | 2,81 điểm phần trăm | 0,44 điểm phần trăm |
Các hàng vị trí mang tính mô tả, không có khẳng định ý nghĩa thống kê riêng. Thí nghiệm không đo chuyển động mắt hay chú ý, và phân tích không xác định vì sao vị trí khác. Mẫu hình tỷ lệ cong tự nó cũng không bác bỏ mô hình cơ sở: thành phần vị trí tuyến tính trong điểm sở thích nền, không phải trong phần trăm chọn.
Chỉ lấy tỷ lệ đầu trừ cuối sẽ trả lời câu khác. Các tỷ lệ tổng hợp lựa chọn qua sản phẩm và giá. Cả hai mô hình đã ước lượng tính đến danh tính sách và giá trước khi gán xác suất cho 10 phương án. Chênh hai đầu hay so mô hình đều không cho biết điều xảy ra nếu chuyển sản phẩm cụ thể trên cửa hàng đang hoạt động.
Mẫu đo lường vị trí sản phẩm có thể dùng
Trước khi so sánh các sản phẩm chào bán, viết bản yêu cầu đo lường ngắn. Mẫu sau không cần đăng ký và mang tính minh họa. Nó áp dụng bài học kiểm tra giả định; không hứa cùng mô hình hợp cửa hàng của bạn.
Quyết định: “Chúng tôi cần quyết định [so sánh sản phẩm hoặc thay đổi trình bày nào] cho [trang hoặc chiến dịch] trong [giai đoạn].” Nêu quyết định trước khi chọn chỉ số có lợi.
Kết quả: “Chúng tôi sẽ đo [lựa chọn, nhấp, thêm vào giỏ hoặc mua].” Chọn kết quả bản ghi thực hỗ trợ. Giữ các phương án được đưa ra, thứ tự và giá hiển thị cùng kết quả. Kết quả bắt buộc chọn nên tách kết quả mua.
Đơn vị: “Đơn vị là [người tham gia hoặc đơn vị khác định nghĩa rõ]. Lượt truy cập hoặc nộp lặp được xử lý bằng [quy tắc].” Giữ quan sát cùng người cùng nhau khi đánh giá dự đoán cho người mới. Đừng coi mã phiên ẩn danh là bằng chứng người duy nhất.
So sánh: “Cả hai mô hình dùng cùng sản phẩm, thông tin giá và quan sát đủ điều kiện. Chỉ khác [giả định vị trí].” Nêu phương án đơn giản cũng như linh hoạt hơn.
Đánh giá: “Chúng tôi dành riêng [nhóm xác định] trước khi ước lượng và so [thước đo điểm có tên]. Sẽ hiển thị mọi vị trí.” Quyết định cách báo cáo kết quả chưa rõ hoặc kém hơn trước khi thấy.
Sử dụng: “Kết quả sẽ hỗ trợ [quyết định đo lường]. Vẫn cần bằng chứng về [kết quả thương mại chưa đo ở đây] trước [quyết định thương mại].” Câu cuối giữ bài tập dự đoán khỏi âm thầm thành dự báo doanh thu.
Giữ các lượt nộp của mỗi người ở cùng 1 phía của phép kiểm tra
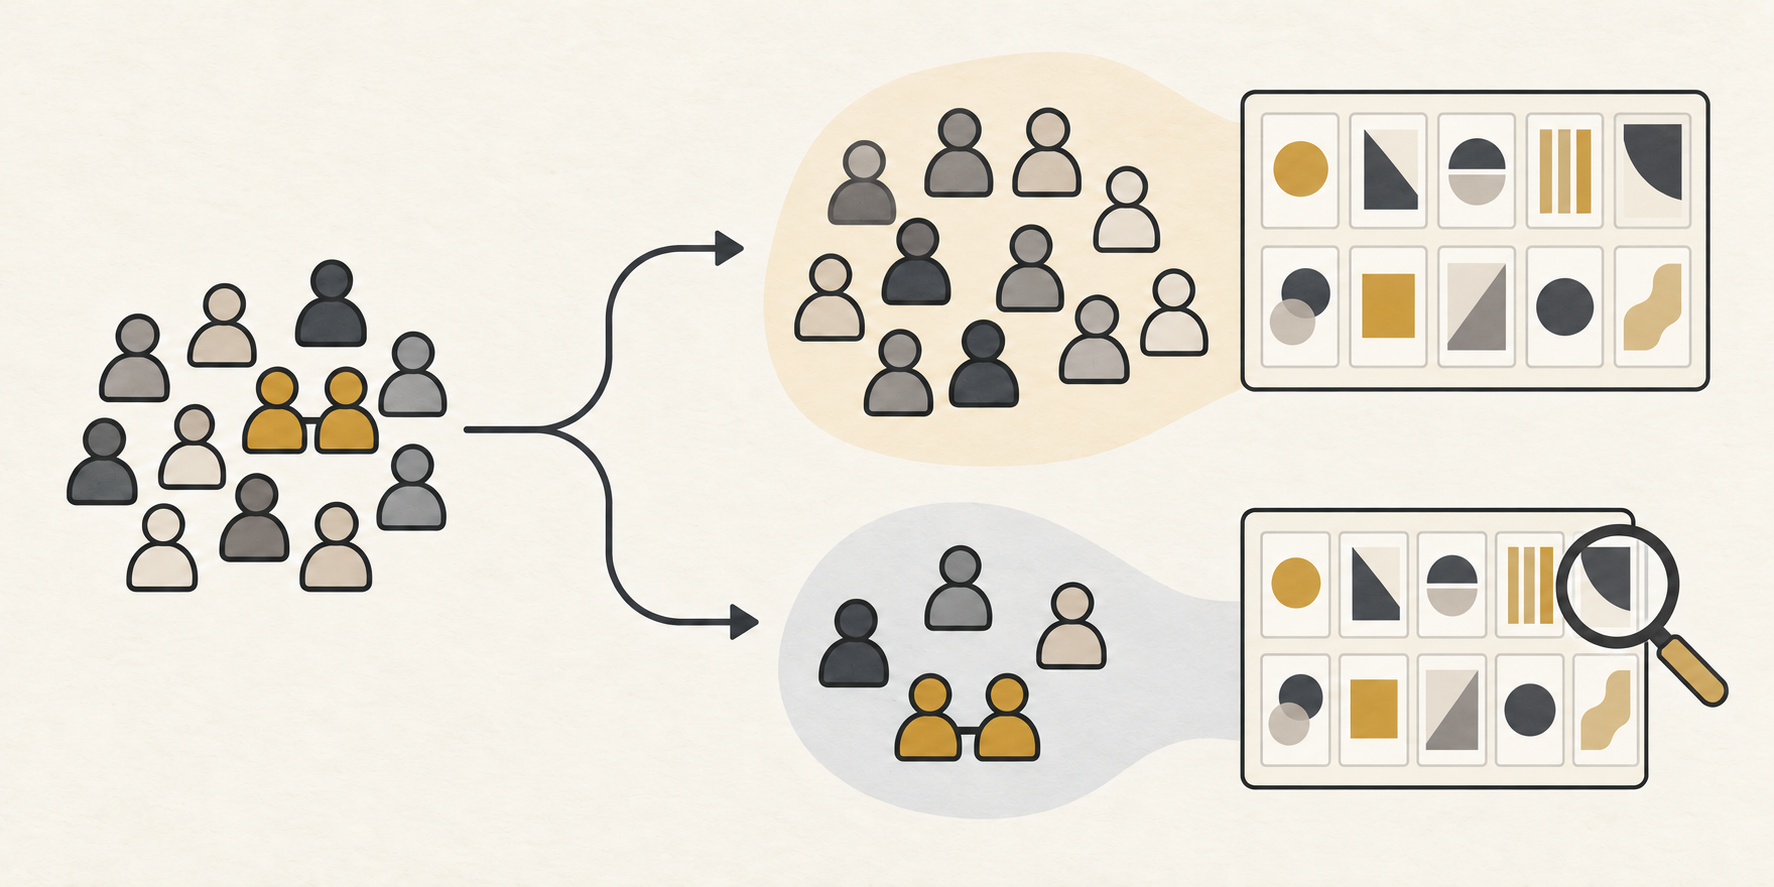
Định nghĩa phép so
Nêu sản phẩm, vị trí, kết quả và đơn vị quan sát.
Dành riêng nhóm đánh giá
Giữ các lượt nộp của mỗi người cùng nhau.
Kiểm tra kết quả đầy đủ
So dự đoán và hiển thị mọi vị trí, kể cả kết quả kém hơn.
Ví dụ thực hành: nhà sáng tạo so sánh các sản phẩm số được chào bán
Xét nhà sáng tạo giả định bán tài liệu bài tập viết, buổi học và gói kết hợp. Gói ở đầu trang ra mắt và nhận nhiều nhấp nhất. Nhà sáng tạo cân nhắc viết lại mô tả sản phẩm khác.
Bản yêu cầu đo đổi câu hỏi trước mắt. Kết quả quan sát là nhấp, không phải bán. Bản ghi cần cho biết sản phẩm chào bán nào được hiển thị, thứ tự và giá. Nếu gói luôn ở vị trí đầu, bản ghi không tách rõ gói khỏi vị trí đó.
Bản yêu cầu hoàn chỉnh có thể ghi: “Chúng tôi muốn biết cách tính đến vị trí có dự đoán nhấp từ khách mới không. Sẽ so sánh cùng các sản phẩm chào bán và thông tin giá, giữ quan sát lặp cùng nhau, báo cáo so vị trí đầy đủ. Không khẳng định mua từ bản ghi nhấp.” Đây là ví dụ giả định về câu hỏi đo lường, không phải kết quả đề xuất.
Bước hợp lý tiếp là lập phép so có đủ biến thiên tách sản phẩm và vị trí, vẫn giữ định nghĩa kết quả. Sau đó có thể so điều chỉnh đơn giản với linh hoạt hơn trên nhóm dành riêng. Đó là nghiên cứu mới của trang; thí nghiệm sách không cho tỷ lệ nhấp kỳ vọng.
Nếu cách linh hoạt dự đoán nhóm giữ riêng tốt hơn, nhà sáng tạo có lý do xem lại cách báo cáo tính vị trí. Vẫn không cho thấy chuyển gói sẽ tăng doanh thu. Quyết định thương mại cần bằng chứng về thay đổi trình bày thực và kết quả quan trọng với doanh nghiệp.
Nếu so sánh chưa rõ, nên nói như vậy. Thêm linh hoạt không tự động là công cụ kinh doanh tốt hơn. Lợi ích thực là trình tự rõ: hiểu bản ghi tách được gì, kiểm tra giả định đo rồi quyết định cần thí nghiệm khác không.
Influence IQ tính phép so sánh thế nào?
Chúng tôi dùng bản câu trả lời đã biên tập của tác giả và quy tắc chọn gốc. 553 bản ghi thí điểm hoặc thử đầu bị loại theo vị trí tệp cố định. Khung còn 10.775 lượt nộp. Bộ lọc hiểu nội dung còn 9.344; bộ lọc hoàn tất còn 9.265.[2]
Quy tắc đồng ý, trạng thái hoàn tất và tối thiểu 60 giây không loại thêm lượt ở bước tương ứng. Hoàn tất và thời lượng là bộ lọc sau tiếp xúc, nên nhóm giữ lại là mẫu được chọn.
Mã người Prolific xác định nhóm. Phân chia bằng mã băm xác định gán 2/3 số nhóm cho huấn luyện, còn lại kiểm tra, không dùng lựa chọn của họ. Trong mỗi nhóm, các lượt tác vụ đầu giữ lại chia đều đóng góp của người đó. Cùng trọng số áp dụng cho ước lượng, chấm điểm và bảng vị trí.[3]
Cả hai là mô hình logit đa thức không có thành phần phạt, với 9 biến chỉ báo sách và 1 thành phần giá tuyến tính. Cơ sở thêm 1 thành phần vị trí tuyến tính, tổng 11 tham số. Linh hoạt thêm 9 biến vị trí, tổng 19. Vị trí 1 và mã sản phẩm nhỏ nhất về số là nhóm tham chiếu. Mọi tập lựa chọn đủ điều kiện có cùng 10 sản phẩm, với mã chọn, giá và vị trí được kiểm tra khớp.
Chúng tôi ước lượng trên nhóm huấn luyện, giữ hệ số rồi chấm lựa chọn kiểm tra. Khoảng dùng độ lệch chuẩn chênh điểm ghép cặp từng người, 3.088 đơn vị người và 3.087 bậc tự do. Đây là khoảng Student-t xấp xỉ; khoảng chỉ chính xác khi đáp ứng các giả định cần thiết về phân phối chuẩn của chênh lệch điểm số. Cả 10 so sánh vị trí vẫn mô tả.[4]
Bộ tối ưu chính của mô hình cơ sở trả cảnh báo số học. Nó vẫn đạt mọi điều kiện độ chính xác định trước khi ước lượng, gồm so lần khởi tạo thứ hai. Chúng tôi giữ ước lượng gốc; chẩn đoán chi tiết có trong tư liệu tái lập.[5]
Bản tải cung cấp kết quả hiển thị, mã phân tích gốc và đầu ra số tổng hợp. Không có hàng trả lời nguồn, mã người hay tranh bìa sách. Lấy dữ liệu nguồn riêng từ bản tác giả. Influence IQ chịu trách nhiệm phân tích lại và diễn giải.
CSV dùng ngôn ngữ trang này. Gói có mã tính gốc, tài liệu phương pháp đã dịch và kết quả tổng hợp. Không có hàng trả lời nguồn hay tài nguyên sách; lấy dữ liệu riêng từ bản tác giả.
Nguồn và ghi chú
- Compiani, Morozov và Seiler, Demand Estimation with Text and Image Data, bản thảo phiên bản 4, ngày 17/2/2026, Phần 3 và Phụ lục C. Tác giả đã nghiên cứu phản ứng với thứ hạng và giá. So sánh người giữ riêng của chúng tôi là phân tích lại gốc, hẹp hơn.
- Bản DeepLogitReplication của tác giả tại commit 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Chúng tôi theo ngưỡng thí điểm theo vị trí gốc trong tệp đã biên tập và quy tắc điều kiện tác giả. Ngày nguồn giữ lại 11–26/6/2024, khác mô tả 14–27/6 của bản thảo; ngày không quyết định đưa vào.
- Prolific phân biệt mã người tham gia với mã nghiên cứu hoặc lượt nộp. Chúng tôi giữ mã người chính xác để phân nhóm. Mã không độc lập xác minh mỗi mã là người khác hay lượt giữ lại là lần đầu người đó tiếp xúc.
- So sánh định trước của Influence IQ lấy trung bình log xác suất của mô hình linh hoạt trừ mô hình cơ sở trong từng người tham gia thuộc nhóm kiểm tra, rồi lấy trung bình trên toàn bộ người tham gia trong nhóm kiểm tra. Khoảng 95% bằng trung bình cộng hoặc trừ giá trị tới hạn Student-t nhân với độ lệch chuẩn của chênh lệch điểm số theo người tham gia, chia cho căn bậc hai của 3.088. Khoảng này giả định các nhóm theo người tham gia độc lập, lấy các mô hình đã ước lượng trên tập huấn luyện làm cố định và không tính độ bất định từ việc ước lượng đó; để khoảng chính xác, các chênh lệch theo người tham gia phải có cùng phân phối chuẩn với phương sai chung.
- Ước lượng cơ sở khởi tạo từ 0 trả cảnh báo độ chính xác. Gradient trung bình tuyệt đối lớn nhất là 3,12×10⁻⁹, Newton decrement 2,50×10⁻⁸ và chênh log xác suất lớn nhất giữa 2 lần khởi tạo là 7,46×10⁻⁸, dưới giới hạn định trước 10⁻⁸, 10⁻⁶ và 10⁻⁷. Cả hai mô hình cũng đạt điều kiện độ cong dương và khớp hàm mục tiêu. Hệ số chính khởi tạo từ 0 được giữ.
Bản tiếng Anh của bài viết này là bản nguồn. Mọi ngôn ngữ mô tả cùng thí nghiệm quá khứ; không phải ước lượng mua sắm riêng từng quốc gia.