E-ticarette ürün sunumu: ürün konumu varsayımlarınızı sınayın
10 kitaplı tarihsel bir deney, basit bir yerleşim düzeltmesinin örüntünün bazı bölümlerini nasıl kaçırabildiğini ve ürün kartlarını karşılaştırmadan önce bu varsayımı nasıl sınayabileceğinizi gösteriyor.
Compiani, Morozov ve Seiler’in yayımladığı 2024 tarihli kitap seçimi deneyinin özgün yeniden analizi.
Özet
Bir teklifin diğerinden güçlü olduğuna karar vermeden önce işletmenin her birinin nerede göründüğünü düşünmesi gerekir. 10 e-kitaplı, yayımlanmış bir 2024 deneyiyle konumu hesaba katmanın 2 yolunu sınadık. Her konuma kendi düzeltmesini vermek, listede aşağı inilen her basamağa aynı düzeltmeyi uygulamaktan genel olarak daha iyi seçim tahminleri verdi. Bazı tekil konumlarda ise daha az doğruydu; bu yüzden karşılaştırmanın tamamı önemli.
Her iki model aynı kitap ve fiyat bilgisini kullandı. Modelleri 6.176 katılımcıyla eğittik, tahminlerini başka 3.088 katılımcıda kontrol ettik. Seçimler varsayımsaldı ve herkes bir kitap seçmek zorundaydı. Ürün kartlarını karşılaştıran işletmeler ve içerik üreticileri için çıkarım, sonuçları bir teklife bağlamadan önce yerleşim varsayımlarını sınamak. Çalışma satış artışı tahmin etmiyor veya en iyi ürün sırasını belirlemiyor.
Sayfanın en üstündeki ürünün en çok tıklamayı aldığını düşünün. Teklif daha mı güçlü, yoksa listedeki yeri mi yardımcı oldu? İşletme diğer kartları yeniden yazmadan, zayıf görünen ürünlerde indirim yapmadan veya ürün çeşitlerini değiştirmeden önce yararlı bir yanıta ihtiyaç duyar.
Konumu hesaba katmak, nasıl yapılacağını sorana kadar basit görünebilir. Listede her aşağı basamağa aynı düzeltme mi verilmeli? Tarihsel deneyde bu basit yaklaşımı daha esnek bir yaklaşımla karşılaştırdık; sonra her ikisini de model eğitiminden ayrı tutulan katılımcılarda sınadık.
Aynı ürünler, farklı konumlar
Ürün konumu karşılaştırması size ne söylemeli?
Ürün kartı karşılaştırması, sunulan ürünü sunuluş biçiminden ayırmanıza yardımcı olmalı. Bir ürün genellikle ilk, diğeri genellikle son sıradaysa yalnızca toplamları, müşterilerin tekliflerden birini tercih edip etmediğini yanıtlamaz.
Sınadığımız basit yaklaşım, listede aşağı inilen her basamak için modelin altta yatan tercih skoruna aynı düzeltmeyi veriyor. Yararlı soru, farklı konumların farklı düzeltmelere sahip olmasına izin veren yaklaşıma kıyasla seçimleri yeterince iyi tahmin edip etmediği.
Bu 2 yaklaşımı yayımlanmış bir kitap seçimi deneyiyle sınadık. Sonuç, koleksiyon sayfası veya dijital mağazada ürün karşılaştıran işletmeler ve içerik üreticileriyle ilgili. En çok satan ürünün nereye konulacağına dair kural yerine, bir ölçüm varsayımını inceleme yolu sunuyor.
Teklif 1’den fazla yerde göründüğünde bu önem taşır. İçerik üreticisi aynı indirmeyi koleksiyonda ve lansman sayfasında öne çıkarabilir. Perakendeci kategori listesinin sırasını değiştirebilir. Ürün, fiyat, kitle ve sunum birlikte farklılaşabilir. Konum düzeltmesi bu karşılaştırmanın bir parçasına ilişkin varsayım; ayrıca kontrol edilmeyi hak ediyor.
Kitap deneyinde insanlar ne seçti?
Giovanni Compiani, Ilya Morozov ve Stephan Seiler, Prolific üzerinden bulunan katılımcılardan sırası ve fiyatları rastgele belirlenen 10 e-kitap arasından varsayımsal seçimler yapmalarını istedi. Katılımcılar bir kitap seçmek zorundaydı; hiçbirini almama seçeneği yoktu. Tutulan her gönderimdeki ilk görevi kullanıyoruz; seçilen kitabın çıkarıldığı sonraki görevi değil.[1]
Yazarlar sıra ve fiyata verilen tepkileri zaten raporluyor. Daha geniş araştırmaları, metin ve görsellerin ürünler arası ikameyi tahmin etmeye nasıl yardımcı olduğunu inceliyor. Bizim sorumuz daha dar: Tek bir konum terimini değiştirmek, seçimleri model eğitiminden ayrı tutulan katılımcılarda tahmini iyileştiriyor mu?
Özgün uygunluk kuralları uygulandığında, 9.264 farklı Prolific katılımcı kimliğine ait 9.265 gönderim kalıyor. 1 kimlik 2 kez görünüyor. Her iki gönderimi birlikte tutuyor ve bu katılımcıya diğer herkesle aynı toplam ağırlığı veriyoruz. Gönderim otomatik olarak ayrı bir kişi demek değil; ilk görev de o kişinin deneyle ilk karşılaşması olmayabilir.[2][3]
Tutulan kaynak tarihleri 11–26 Haziran 2024 arasında. Makale 14–27 Haziran diyor; bu farkı açıklıyor ve tarihe göre dışlama yapmıyoruz. İncelenen materyallerde ülke ve yaş uygunluğu belirlenmedi; bunlar ABD’deki alışveriş yapanlar veya başka bir ülke nüfusu için tahminler değil.[1][2]
Aynı katılımcının gönderimleri karşılaştırma boyunca birlikte tutuluyor
Özgün yazar uygunluk kurallarından sonra seçilmiş ilk görev gönderimleri; tutulan kaynak kayıtlarının tarihleri 11–26 Haziran 2024.
| Grup | Katılımcılar (platform kimliğine göre) | Tutulan gönderimler |
|---|---|---|
| Tutulanların tamamı | 9.264 | 9.265 |
| Eğitim | 6.176 | 6.176 |
| Değerlendirme için ayrı tutulanlar | 3.088 | 3.089 |
Ayrı tutulan seçimleri hangi konum modeli daha iyi tahmin etti?
Esnek konum modeli, önceden belirlenen puanlama ölçüsünde ayrı tutulan seçimleri daha iyi tahmin etti. Her iki model hangi kitabın sunulduğunu ve gösterilen fiyatını hesaba katıyor. Yalnızca konumu nasıl temsil ettikleri farklı.
Temel model, listede aşağı inilen her basamak için 1 katsayı kullanıyor. Esnek model, ilk konuma göre 2’den 10’a kadar konumlar için ayrı düzeltmeler kullanıyor. Bu daha fazla serbestlik, ama tahmin edilecek daha fazla parametre demek. Kendi eğitim verisine daha iyi uyum göstermesi, tek başına karşılaştırmayı sonuçlandırmaz.
Bu nedenle her iki modeli 6.176 katılımcıyla eğittik ve diğer 3.088 katılımcıda değerlendirdik. Aynı katılımcının bütün gönderimleri bu bölmenin aynı tarafında kaldı. Tekrarlanan katılımcıyı içerdiği için test grubunda 3.089 gönderim var.
Tahminleri karşılaştırmak için negatif logaritmik skor kullandık. Model, kişinin gerçekten yaptığı seçime daha çok olasılık verdiğinde daha küçük ceza alır. O seçime çok az olasılık verdiğinde daha büyük ceza alır. Ortalama negatif logaritmik skorun daha düşük olması daha iyidir.
Ayrı tutulan grupta ortalama, temel modelde 2,2260, esnek modelde 2,2154’tü; birim, nats da denilen doğal logaritma birimi. Bunlar doğru yanıt yüzdeleri değil, tahmin skorları. Karşılaştırma yalnızca modelin zaten gördüğü veriyi anlatmak gibi daha kolay bir işe dayanmasın diye eğitim ve test skorlarını birlikte gösteriyoruz.
Aynı katılımcılarda değerlendirilen 2 model
Seçilmiş 2024 deneyinde 10 kitap arasından ilk görev seçimleri. Eğitim: 6.176 katılımcı ve gönderim. Test: 3.088 katılımcı ve 3.089 gönderim.
| Konum modeli | Eğitim skoru (nats) | Ayrı tutulan grubun skoru (nats) |
|---|---|---|
| 1 doğrusal konum terimi | 2,2046 | 2,2260 |
| Ayrı konum terimleri | 2,1899 | 2,2154 |
Eşleştirilmiş iyileşme katılımcı başına 0,0106 nats; yaklaşık %95 aralığı 0,0044–0,0168. Burada pozitif iyileşme esnek modelin lehine. Sonuç bu skor ölçeğinde küçük, ancak aralık 0’ın üzerinde.[4]
Bu aralık, eğitilmiş 2 modeli sabit kabul ediyor ve katılımcı gruplarının bağımsız olduğunu varsayıyor. Modelleri başka bir eğitim örnekleminde eğitmekten doğan belirsizliği içermiyor. Bulgu, bu seçilmiş tarihsel görevde tahmin iyileşmesini destekliyor; skor farkını satış artışına dönüştürmüyor.
Esnek model ayrı tutulan grubun log skorunu iyileştiriyor
Seçilmiş tarihsel 10 kitap görevinde 3.088 test katılımcısı arasındaki eşleştirilmiş karşılaştırma.
| Karşılaştırma | İyileşme (nats) | %95 aralığının alt ucu (nats) | %95 aralığının üst ucu (nats) |
|---|---|---|---|
| Esnek eksi temel model log skoru | 0,0106 | 0,0044 | 0,0168 |
2 model gözlenen seçimleri nerelerde kaçırdı?
Konum karşılaştırmasının tamamı, genel skorun yanında neden ayrıntı gerektiğini gösteriyor. Her konumun gözlenen seçim payını, her modelin o konuma verdiği ortalama olasılıkla karşılaştırıyoruz. Bunlar ayrı tutulan grupta katılımcılara eşit ağırlık veren ortalamalar; tıklama oranları değil.
1. konumda gözlenen pay %17,16’ydı. Temel model %14,64, esnek model %17,73 tahmin etti. 10. konumda gözlenen pay %9,18, tahminler ise %6,37 ve %8,74’tü. Esnek model bu belirli listenin her iki ucunda daha yakındı.
10 konumun tamamında gözlenen ve tahmin edilen seçimler
Ayrı tutulan grup: Yayımlanan 2024 deneyinden 3.088 katılımcı ve 3.089 ilk görev gönderimi.
| Konum | Gözlenen seçim payı | Temel model ortalama olasılığı | Esnek model ortalama olasılığı | Seçimin bu konumda olduğu gönderimler |
|---|---|---|---|---|
| Konum 1 | %17,16 | %14,64 | %17,73 | 530 |
| Konum 2 | %13,60 | %13,20 | %14,84 | 420 |
| Konum 3 | %9,91 | %12,06 | %9,74 | 306 |
| Konum 4 | %10,91 | %11,21 | %9,26 | 337 |
| Konum 5 | %9,20 | %10,09 | %8,94 | 284 |
| Konum 6 | %7,08 | %9,25 | %8,01 | 219 |
| Konum 7 | %8,00 | %8,44 | %7,57 | 247 |
| Konum 8 | %7,12 | %7,67 | %7,47 | 220 |
| Konum 9 | %7,84 | %7,08 | %7,69 | 242 |
| Konum 10 | %9,18 | %6,37 | %8,74 | 284 |
Esnek model her yerde daha yakın değildi. 4. konumda gözlenen pay %10,91’di. Temel model %11,21, esnek model %9,26 tahmin etti. Ek esneklik, ayrı tutulan grubun genel skorunu iyileştirirken o konumda daha büyük bir uyumsuzluk bıraktı.
Sonraki tablo, gözlenen pay eksi tahmin edilen payı gösteriyor. Pozitif fark, modelin o konumda seçilmeyi az; negatif fark, fazla tahmin ettiği anlamına geliyor. 10 konumun tamamını görünür tutmak, iyi görünen bir ucun bütün karşılaştırmanın yerine geçmesini önlüyor.
Her iki modelin gözlenen seçimlerden farkları
Aynı 3.088 test katılımcısı kullanılarak, 10 konumun her biri için gözlenen seçim payı eksi ortalama tahmin olasılığı.
| Konum | Gözlenen eksi temel model | Gözlenen eksi esnek model |
|---|---|---|
| Konum 1 | 2,52 yüzde puanı | -0,57 yüzde puanı |
| Konum 2 | 0,41 yüzde puanı | -1,24 yüzde puanı |
| Konum 3 | -2,15 yüzde puanı | 0,17 yüzde puanı |
| Konum 4 | -0,29 yüzde puanı | 1,65 yüzde puanı |
| Konum 5 | -0,89 yüzde puanı | 0,26 yüzde puanı |
| Konum 6 | -2,17 yüzde puanı | -0,93 yüzde puanı |
| Konum 7 | -0,44 yüzde puanı | 0,43 yüzde puanı |
| Konum 8 | -0,55 yüzde puanı | -0,35 yüzde puanı |
| Konum 9 | 0,76 yüzde puanı | 0,14 yüzde puanı |
| Konum 10 | 2,81 yüzde puanı | 0,44 yüzde puanı |
Bu konum satırları betimsel; ayrı anlamlılık iddiaları yok. Deney göz hareketlerini veya dikkati ölçmedi, analiz de bir konumun neden farklı olduğunu belirlemiyor. Gözlenen paylardaki eğri örüntü tek başına temel modeli çürütmez: Konum terimi seçim yüzdelerinde değil, modelin altta yatan tercih skorunda doğrusal.
İlk ve son gözlenen payı doğrudan çıkarmak başka bir soruyu yanıtlar. Bu paylar, ürünler ve fiyatlar genelindeki seçimleri özetliyor. Eğitilmiş her iki model, 10 seçeneğe olasılık vermeden önce kitap kimliğini ve fiyatı hesaba katıyor. Ne uçlar arasındaki fark ne model karşılaştırması, gerçek bir mağazada belirli bir ürün taşınsa ne olacağını söylüyor.
Kullanabileceğiniz bir ürün konumu ölçüm şablonu
Teklifleri karşılaştırmadan önce kısa bir ölçüm planı yazın. Aşağıdaki şablon herkese açık ve örnek amaçlı. Çalışmanın varsayımları kontrol etme dersini uyguluyor; aynı modelin mağazanıza uyacağını vadetmiyor.
Karar: “[period] boyunca [page or campaign] için [which product comparison or presentation change] kararını vermemiz gerekiyor.” Olumlu bir ölçü seçmeden önce kararı adlandırın.
Sonuç: “[choice, click, add-to-cart or purchase] ölçeceğiz.” Kayıtlarınızın gerçekten desteklediği sonucu seçin. Sunulan alternatifleri, sıralarını ve gösterilen fiyatları yanında tutun. Zorunlu seçim sonucu, satın alım sonucundan ayrı kalmalı.
Birim: “Birimimiz [participant or another clearly defined unit]. Tekrar ziyaretleri veya gönderimleri [rule] ile ele alacağız.” Yeni kişiler için tahmini değerlendirirken aynı kişinin gözlemlerini birlikte tutun. Anonim oturum tanımlayıcısını tekil kişi kanıtı saymayın.
Karşılaştırma: “Her iki model aynı ürünleri, fiyat bilgisini ve uygun gözlemleri kullanacak. Farkları [the position assumption] olacak.” Daha esnek alternatifin yanında basit alternatifi de belirtin.
Değerlendirme: “Eğitimden önce [a defined group] ayıracak ve karşılaştırmayı [a named scoring measure] ile yapacağız. Bütün konumları göstereceğiz.” Belirsiz veya daha kötü bir sonucu nasıl raporlayacağınıza onu görmeden karar verin.
Kullanım: “Bu sonuç [measurement decision] kararına bilgi sağlayacak. [commercial decision] öncesinde [commercial outcome not measured here] hakkında kanıt hâlâ gerekli.” Bu son cümle, tahmin alıştırmasının sessizce gelir öngörüsüne dönüşmesini önlüyor.
Aynı katılımcıyı test bölmesinin 1 tarafında tutun
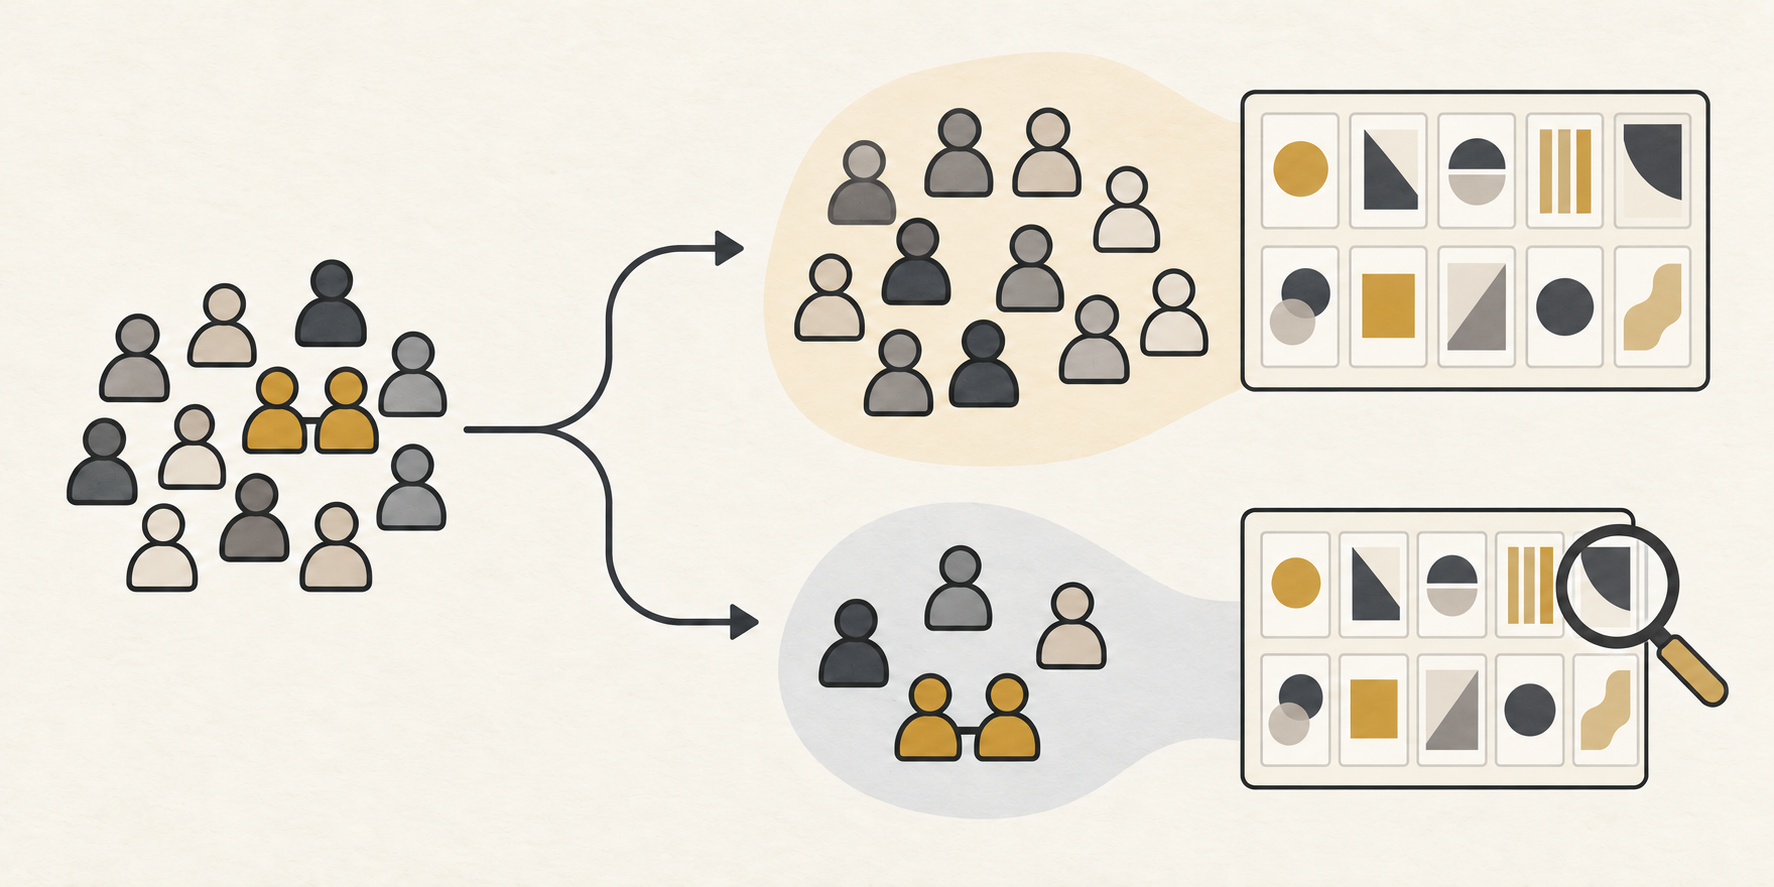
Karşılaştırmayı tanımlayın
Ürünü, konumu, sonucu ve gözlem birimini adlandırın.
Değerlendirme grubunu ayırın
Her katılımcının gönderimlerini birlikte tutun.
Sonucun tamamını kontrol edin
Tahminleri karşılaştırın; daha kötü sonuçlar dâhil her konumu gösterin.
Uygulamalı örnek: dijital teklifleri karşılaştıran bir içerik üreticisi
Yazma çalışma kitabı, atölye ve paket satan kurmaca bir içerik üreticisini ele alalım. Paket, lansman sayfasının en üstünde görünüyor ve en çok tıklamayı alıyor. Üretici diğer ürün açıklamalarını yeniden yazmayı düşünüyor.
Ölçüm planı, doğrudan sorulacak soruyu değiştiriyor. Gözlenen sonuç tıklama, satış değil. Mevcut kayıtlar hangi tekliflerin hangi sırada ve hangi fiyatlarla gösterildiğini belirtmeli. Paket hep ilk sıradaysa bu kayıtlar paketi konumundan net biçimde ayıramaz.
Üreticinin tamamlanmış planı şöyle olabilir: “Konumu hesaba katma biçimimizin yeni ziyaretçilerin tıklamalarını tahmin edip etmediğini bilmek istiyoruz. Aynı teklifleri ve fiyat bilgisini karşılaştıracak, tekrarlanan gözlemleri birlikte tutacak ve konum karşılaştırmasının tamamını raporlayacağız. Tıklama kayıtlarından satın alım iddiası çıkarmayacağız.” Bu, bir ölçüm sorusunun kurmaca örneği; önerilen bir sonuç değil.
Makul sonraki adım, aynı sonuç tanımını koruyarak ürünü konumdan ayıracak yeterli değişkenliğe sahip bir karşılaştırma planlamak. Üretici sonra, ayrılmış bir grupta basit konum düzeltmesini daha esnek olanla karşılaştırabilir. Bu, o sayfanın yeni bir çalışması olur; kitap deneyi onun için beklenen tıklama oranı sağlamaz.
Esnek yaklaşım ayrılan grubu daha iyi tahmin ederse üreticinin rapordaki yerleşim hesabını yeniden incelemek için nedeni olur. Bu yine de paketi taşımanın geliri artıracağını göstermiyor. Ticari karar, gerçek sunum değişikliği ve işletme için önemli sonuç hakkında kanıt gerektirir.
Karşılaştırma belirsiz kalırsa üretici bunu söylemeli. Ek esneklik kendiliğinden daha iyi bir iş aracı değil. Pratik kazanım daha açık bir sıra: Kayıtların neyi ayırabildiğini anlayın, ölçüm varsayımını sınayın, sonra başka bir deneye gerek olup olmadığına karar verin.
Influence IQ karşılaştırmayı nasıl hesapladı?
Yazarların düzenlenmiş yanıt yayımını ve özgün seçim kurallarını kullandık. İlk 553 pilot veya test kaydı, dosyadaki sabit konumlarına göre dışarıda bırakılıyor. Kalan çerçeve 10.775 gönderim içeriyor. Kavrama filtreleri 9.344, tamamlama filtresi 9.265 gönderim bırakıyor.[2]
Rıza, bitirme durumu ve en az 60 saniye süre kuralı kendi adımlarında ek gönderim çıkarmıyor. Tamamlama ve süre, içeriğe maruz kalma sonrası filtreler olduğu için tutulan grup seçilmiş bir örneklem.
Grupları Prolific katılımcı kimlikleri tanımlıyor. Deterministik özet değere dayalı bölme, seçimleri kullanmadan grupların üçte ikisini eğitime, kalanını teste atıyor. Her grupta tutulan ilk görev gönderimlerinin her biri katılımcının katkısını eşit paylaşıyor. Aynı ağırlıklandırma eğitimde, puanlamada ve konum tablolarında uygulanıyor.[3]
Her iki model, 9 kitap göstergesi ve 1 doğrusal fiyat terimi içeren, ceza terimi olmayan çok terimli logit modeli. Temel model 1 doğrusal konum terimi ekliyor; toplam 11 parametre. Esnek model 9 konum göstergesi ekliyor; toplam 19. Referans kategorileri 1. konum ve sayısal olarak en küçük ürün kimliği. Uygun seçim kümelerinin tamamı aynı 10 ürünü içeriyor; seçilen kimliğin, fiyatın ve konumun uyumu kontrol ediliyor.
Modelleri eğitim grubunda eğitiyor, katsayılarını koruyor ve ardından test seçimlerini puanlıyoruz. Aralık, eşleştirilmiş katılımcı skor farklarının standart sapmasını, 3.088 katılımcı birimini ve 3.087 serbestlik derecesini kullanıyor. Tam normal-skor varsayımları dışında yaklaşık bir Student-t aralığı. 10 konum karşılaştırmasının tamamı betimsel kalıyor.[4]
Temel modelin birincil optimizasyon algoritması sayısal uyarı verdi. Buna rağmen, ikinci başlangıç karşılaştırması dâhil eğitimden önce belirlenen sayısal hassasiyet koşullarının tamamını sağladı. Özgün uyumu koruduk; ayrıntılı tanılamalar yeniden üretim materyallerinde yer alıyor.[5]
İndirmeler gösterilen sonuçları, özgün analiz kodunu ve toplulaştırılmış sayısal çıktıyı sunuyor. Kaynak yanıt satırlarını, katılımcı kimliklerini ve kitap görsellerini dışarıda bırakıyor. Kaynak veriyi yazarların yayımından ayrıca edinin. Bu yeniden analizden ve yorumundan Influence IQ sorumlu.
CSV bu sayfanın dilini kullanır. Paket, özgün hesaplama kodunu, çevrilmiş yöntem belgelerini ve toplulaştırılmış sonuçları içerir. Kaynak yanıt satırları ve kitap materyalleri dahil değildir; verileri yazarların yayımladığı dosyalardan ayrıca edinin.
Kaynaklar ve notlar
- Compiani, Morozov ve Seiler, Demand Estimation with Text and Image Data, makale taslağı sürüm 4, 17 Şubat 2026, Bölüm 3 ve Ek C. Yazarlar sıra ve fiyata verilen tepkileri zaten inceliyor. Ayrı tutulan katılımcılarla karşılaştırmamız, özgün ve daha dar bir yeniden analiz.
- Yazarların DeepLogitReplication yayımı, 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec commit’i. Düzenlenmiş yanıt dosyasındaki özgün konumsal pilot sınırını ve yazarların uygunluk kurallarını izliyoruz. Tutulan kaynak tarihleri 11–26 Haziran 2024; makaledeki 14–27 Haziran açıklamasından farklı. Tarihler dâhil edilmeyi belirlemiyor.
- Prolific, katılımcı kimliğini çalışma veya gönderim tanımlayıcısından ayırıyor. Gruplama için tam katılımcı kimliklerini koruyoruz. Bu kimlikler, her birinin farklı kişiyi temsil ettiğini bağımsız olarak doğrulamıyor veya tutulan gönderimin o kişinin ilk karşılaşması olduğunu ortaya koymuyor.
- Influence IQ’nun önceden belirlenmiş karşılaştırması, esnek modelin logaritmik olasılığından temel modelinkini çıkararak bulunan farkı önce her test katılımcısı içinde, sonra katılımcılar arasında ortalıyor. %95 aralığı, ortalama artı/eksi (Student-t kritik değeri × katılımcı standart sapması / 3.088’in karekökü) ile hesaplanıyor. Bağımsız katılımcı grupları ve sabit eğitim uyumlarına koşullu; eğitim uyumu belirsizliğini dışlıyor. Tam geçerlilik, ortak varyanslı ve aynı dağılımlı normal katılımcı farkları gerektiriyor.
- Temel modelin sıfır başlangıçlı uyumu hassasiyet uyarısı verdi. En büyük mutlak ortalama gradyanı 3,12×10⁻⁹, Newton azalış ölçüsü 2,50×10⁻⁸ ve 2 başlangıç arasındaki en büyük logaritmik olasılık farkı 7,46×10⁻⁸’di; önceden belirlenen 10⁻⁸, 10⁻⁶ ve 10⁻⁷ sınırlarının altında. Her iki model pozitif eğrilik ve amaç değeri uyumu koşullarını da sağladı. Birincil sıfır başlangıç katsayıları korundu.
Bu makalenin kaynak sürümü İngilizce. Dil sürümleri aynı tarihsel deneyi anlatıyor; ülkelere özel alışveriş tahminleri değil.