Vilka receptkommentarer ska du läsa för att få återkoppling?
Att läsa kommentarerna med flest positiva röster eller de senast skapade kan ändra betygsfördelningen du ser. En jämförelse av urval med 10 kommentarer i 100 utvalda receptdiskussioner visar varför läsmetoden bör följa frågan du vill besvara.
En analys av 18 182 kommentarer i ett receptarkiv som UCI publicerade 2023.
Sammanfattning
När målet var att återspegla betygsfördelningen i en receptdiskussion låg slumpmässiga urval närmare i genomsnitt än urval av kommentarerna med flest positiva röster eller de senast skapade. Influence IQ jämförde urval med 10 kommentarer i en utvald grupp av 100 högt betygsatta recept i ett historiskt arkiv med 18 182 kommentarer som UCI publicerade 2023. Den genomsnittliga förväntade avvikelsen i betygsfördelningen var 16,5 procentenheter för slumpurval, 18,7 för positiva röster och 20,3 för de senaste kommentarerna. [1][4]
Resultatet mäter fördelningen mellan kommentarer med 1–5 stjärnor och kommentarer utan betyg, inte hur användbara råden är. Urval efter positiva röster låg närmare än slumpurval för 46 recept och längre ifrån för 54. För matkreatörer och communityansvariga är slutsatsen att skilja mellan ett urval som sammanfattar en diskussion och exempel som används för att planera ett svar.
Du har ett recept att förbättra och en lång diskussion under det. Det finns tid att läsa ett mindre urval av kommentarer innan du bestämmer vad som ska förtydligas. Börjar du med kommentarerna som fått flest röster, de senast tillkomna eller ett slumpmässigt urval från diskussionen?
Valet sker innan du tolkar en enda mening. Det avgör vilka röster som kommer med i underlaget du lämnar till en kreatör, redaktör eller kollega. Vi undersökte hur 3 uttryckliga urvalsregler ändrade 1 mätbar egenskap hos underlaget: betygsfördelningen, inklusive kommentarer där skribenten inte lämnat något betyg.
Ett urval ur en större diskussion
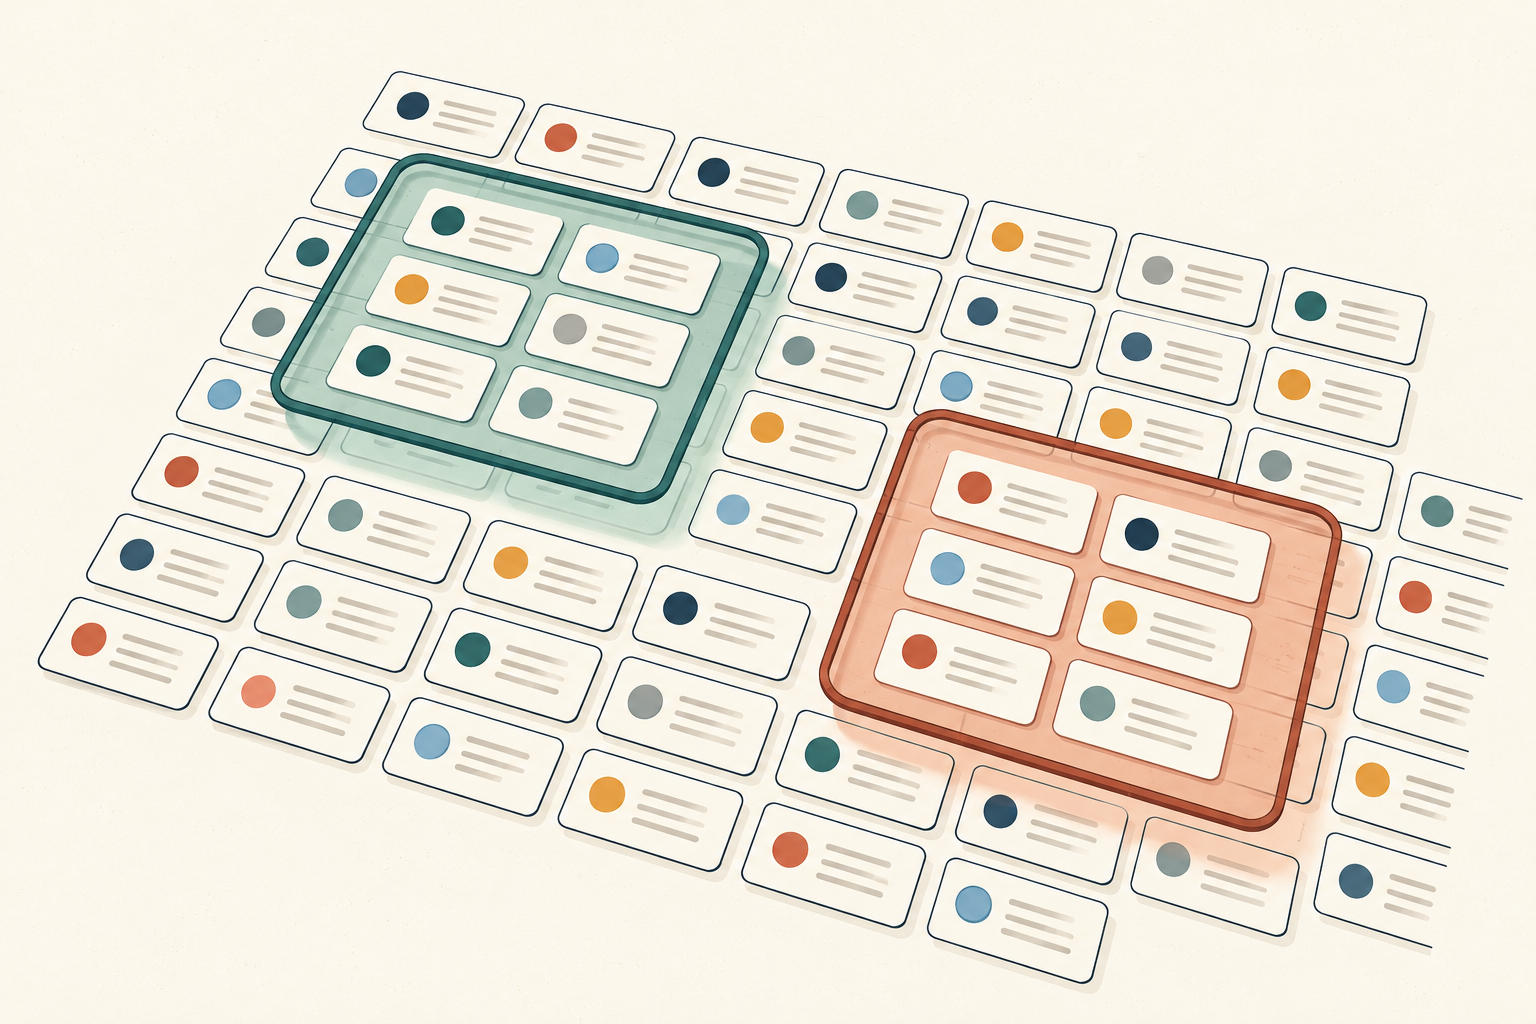
- Valda kommentarer
- Hela den arkiverade diskussionen
10 kommentarer kan ge 3 olika perspektiv
En receptkreatör som förbereder en uppföljning behöver bestämma vad som ska läsas först. Kommentarerna med flest positiva röster kan verka som en användbar genväg. De senaste kommentarerna är en annan väg in i diskussionen. Båda sätter vissa kommentarer före andra, men inget av urvalen beskriver automatiskt hela diskussionen.
Vi undersökte den avgränsade frågan med 18 182 arkiverade kommentarer till 100 utvalda, högt betygsatta recept från Taste of Home i ett offentligt datamaterial som publicerades via UCI 2023. För varje recept jämförde vi 10 kommentarer valda efter positiva röster, 10 efter skapandetid och 10 valda slumpmässigt. Referensen var betygsfördelningen i alla arkiverade kommentarer till det receptet. [1]
Den genomsnittliga förväntade avvikelsen från den fullständiga betygsfördelningen var 18,7 procentenheter för urval efter positiva röster, 20,3 för de senaste kommentarerna och 16,5 för slumpurval. Varje recept bidrog lika mycket till genomsnitten, oavsett hur många kommentarer det hade. [4]
Jämfört med slumpurval var avvikelsen 2,2 procentenheter större för positiva röster och 3,8 enheter större för de senaste kommentarerna. Skillnaderna gäller fördelningen mellan betyg och kommentarer utan betyg. Vi mätte inte vilka kommentarer som gav de bästa matlagningsråden, den tydligaste förklaringen eller den mest användbara affärsidén.
Skillnaden spelar roll för en matkreatör eller communityansvarig. En kommentar kan vara värdefull nog att inspirera en instruktion utan att vara typisk för diskussionen. Att behandla den som ett exempel är ett annat beslut än att behandla ett urval som en sammanfattning.
Genomsnittlig avvikelse från varje recepts fullständiga betygsfördelning
10 kommentarer per urval i 100 utvalda receptdiskussioner i det historiska UCI-arkivet. En mindre avvikelse betyder en närmare överensstämmelse i fördelningen mellan betyg och avsaknad av betyg.
| Urvalsmetod | Genomsnittlig förväntad avvikelse |
|---|---|
| Flest positiva röster | 18,7 procentenheter |
| Senast skapade | 20,3 procentenheter |
| Slumpmässigt urval | 16,5 procentenheter |
Vad betyder en avvikelse i betygsfördelningen?
Tänk på varje receptdiskussion som en blandning av 6 kategorier: 1 till 5 stjärnor samt kommentarer utan betyg. Ett urval med 10 kommentarer har sin egen fördelning. Vi mätte hur långt den mindre fördelningen låg från hela den arkiverade diskussionen med ett mått som kallas totalvariationsavstånd.
Här är ett hypotetiskt exempel med bara 2 kategorier. Anta att hälften av kommentarerna ger 4 stjärnor och hälften 5 stjärnor. Om ett urval med 10 kommentarer innehåller 7 med 4 stjärnor och 3 med 5 stjärnor blir fördelningen 70 % mot 30 %, i stället för 50 % mot 50 %. Avståndet är 20 procentenheter: hälften av de 2 absoluta skillnaderna på 20 enheter.
Samma beräkning fungerar för alla 6 kategorier. Ett mindre värde betyder en närmare överensstämmelse med arkivets betygsfördelning. Det betyder inte att texten är mer informativ eller att kommentarerna är sanningsenligare. Ett resultat på 18,7 procentenheter betyder inte heller att 18,7 % av kommentarerna är felaktiga.
Vi behöll kommentarer utan betyg i jämförelsen. UCI definierar 0 i betygsfältet som inget betyg, inte som ett värde under 1 stjärna. Att ta bort de kommentarerna skulle ändra diskussionen som sammanfattas. Enbart den numeriska kategorin kan inte tala om ifall en kommentar utan betyg innehåller en fråga, beröm, ett problem eller något annat. [1]
Slumpurval låg närmare i genomsnitt, men inte för varje recept
Den övergripande jämförelsen ger ingen universell vinnare. Urval efter positiva röster hade en mindre förväntad avvikelse än slumpurval för 46 av de 100 recepten och en större för 54. Urval av de senaste kommentarerna låg närmare för 42 recept och längre ifrån för 58. Ingen av jämförelserna gav exakt lika värden. [4]
Det här är jämförelser mellan varje metods förväntade avvikelse inom ett recept. De betyder inte att varje möjligt slumpurval slår urvalet efter positiva röster i dessa 54 diskussioner. Ett enskilt urval med 10 kommentarer kan råka likna hela diskussionen väl eller missa delar av den.
Slumpresultatet är ett genomsnitt över alla möjliga urval med 10 kommentarer, där varje urval är lika sannolikt. Det är inte resultatet av 1 lyckosam dragning eller ett valt slumpfrö. Vi tog också genomsnitt över möjliga urval när flera kommentarer hade samma antal positiva röster eller tidsstämpel vid urvalsgränsen.
Lika värden vid urvalsgränsen krävde att genomsnitt togs för 70 recept vid urval efter positiva röster och 4 vid urval av de senaste kommentarerna. Vi föredrog inte en kommentar med samma värde på grund av dess författare, radposition eller identifierare. Beräkningen frågar vad som händer med en angiven urvalsregel, i stället för att behandla en godtycklig ordning som underlag. [4]
För en kreatör är den praktiska slutsatsen begränsad men användbar: positiva röster och hur nyligen en kommentar skapats är urvalskriterier. Om du använder något av dem för att sammanfatta en diskussion, ange det valet. Anta inte att ett synligt urval bevarar balansen i hela arkivet.
Vilken metod som låg närmast varierade mellan receptdiskussionerna
Varje rangordnat urval jämförs med slumpurval inom samma recept. Det är jämförelser av förväntade avvikelser, inga utfall från enskilda slumpdragningar.
| Urvalsmetod | Närmare än slumpurval | Lika nära som slumpurval | Längre ifrån än slumpurval |
|---|---|---|---|
| Flest positiva röster jämfört med slumpurval | 46 | 0 | 54 |
| Senast skapade jämfört med slumpurval | 42 | 0 | 58 |
Välj frågan innan du väljer kommentarerna
Metoder för kundåterkoppling fyller olika uppgifter. Ett företag kan vilja förstå ett brett mönster, undersöka ett specifikt problem eller hitta en fråga till nästa inlägg. Den här studien gäller en del av arbetet: om ett litet urval bevarar betygsfördelningen i en diskussion. Den rangordnar inte alla sätt att samla in återkoppling.
Om frågan är ”Hur ser den här diskussionen ut som helhet?”, börja med att definiera vilka kommentarer som hör till diskussionen. Ett slumpmässigt urval från en tillgänglig, fullständig lista undviker att avsiktligt gynna kommentarer med många röster eller som skapats nyligen. I det här arkivet låg det närmare i genomsnitt, men även ett litet slumpurval hade en mätbar avvikelse. 10 var vår valda ram för jämförelsen, ingen rekommendation om att 10 kommentarer räcker.
Om frågan är ”Vad ska jag svara på härnäst?”, kan en enskild kommentar förtjäna uppmärksamhet i sig. En tydlig fråga om att byta ut en ingrediens kan motivera att du kontrollerar receptet och förbereder en förklaring. Du behöver inte kalla frågan vanlig innan du svarar på den. Om den är relevant för nästa innehåll är en separat bedömning.
Om frågan gäller nya förändringar kan skapandetiden avgränsa en relevant period för läsningen. Låt perioden framgå i sammanfattningen. De senaste kommentarerna i vår studie betydde de senaste skapandetidsstämplarna i det sparade arkivet, inte kommentarer som kommer in i dag eller den ordning som webbplatsen visar nu.
Även hela kommentararkivet är en begränsad referens. Det innehåller bidrag från personer som valde att kommentera, inte från alla som läste eller provade ett recept. Om ett företag behöver återkoppling från personer som aldrig kommenterar behöver det nå dem på ett annat sätt. En närmare överensstämmelse med kommentararkivet fyller inte den luckan. Håll sådan ytterligare återkoppling åtskild så att dess källa och urval förblir begripliga.
Spara 2 separata anteckningar: en beskriver urvalet som användes för att sammanfatta diskussionen; den andra listar frågor att undersöka. Det är ett föreslaget sätt att planera, inget arbetsflöde som testades i studien.
Ett fiktivt exempel: planera en receptuppföljning
Tänk dig en matkreatör som planerar en uppföljning av ett bakrecept. En kommentar med många positiva röster frågar om en annan bakform fungerar. Kreatören lockas att börja nästa video med ”Alla har problem med formens storlek”. Situationen är fiktiv, ingen kommentar och inget recept som valts ur datamaterialet.
Frågan om bakformen kan vara värd att besvara utan att visa hur vanlig den är. Positiva röster fastställer inte vilka som provade receptet eller hade samma erfarenhet.
Ett mer precist underlag skulle säga: ”En läsare frågade hur valet av bakform påverkar receptet. Visa formen som användes, förklara måtten och ange vad som behöver kontrolleras innan en annan rekommenderas.” Kreatören kan sedan verifiera matlagningsdetaljerna. Kommentaren ger utgångsfrågan; den fastställer inte svaret.
Om kreatören också vill sammanfatta diskussionen bör en separat anteckning förklara vad som lästes och hur det valdes. Ett slumpurval från en fullständig tillgänglig lista ska ge varje kommentar samma chans utan att välja samma kommentar två gånger. Att bläddra till några bekväma ställen är inte det slumpförfarande som utvärderades här.
När en fullständig lista saknas, beskriv det urval du faktiskt kan göra. ”Vi granskade de första kommentarerna som visades med den här sorteringsordningen” säger mer än att kalla det ett representativt urval. Koppla inte vårt arkivs numeriska avvikelser till den annorlunda processen.
Uppföljningen ska visa utrustningen och besvara den kontrollerade frågan. Dokumentera vad du förtydligade så att nästa granskning kan fokusera på obesvarade frågor. Bedöm förklaringen med hjälp av återkoppling på själva uppföljningen.
Håll urval och tolkning isär
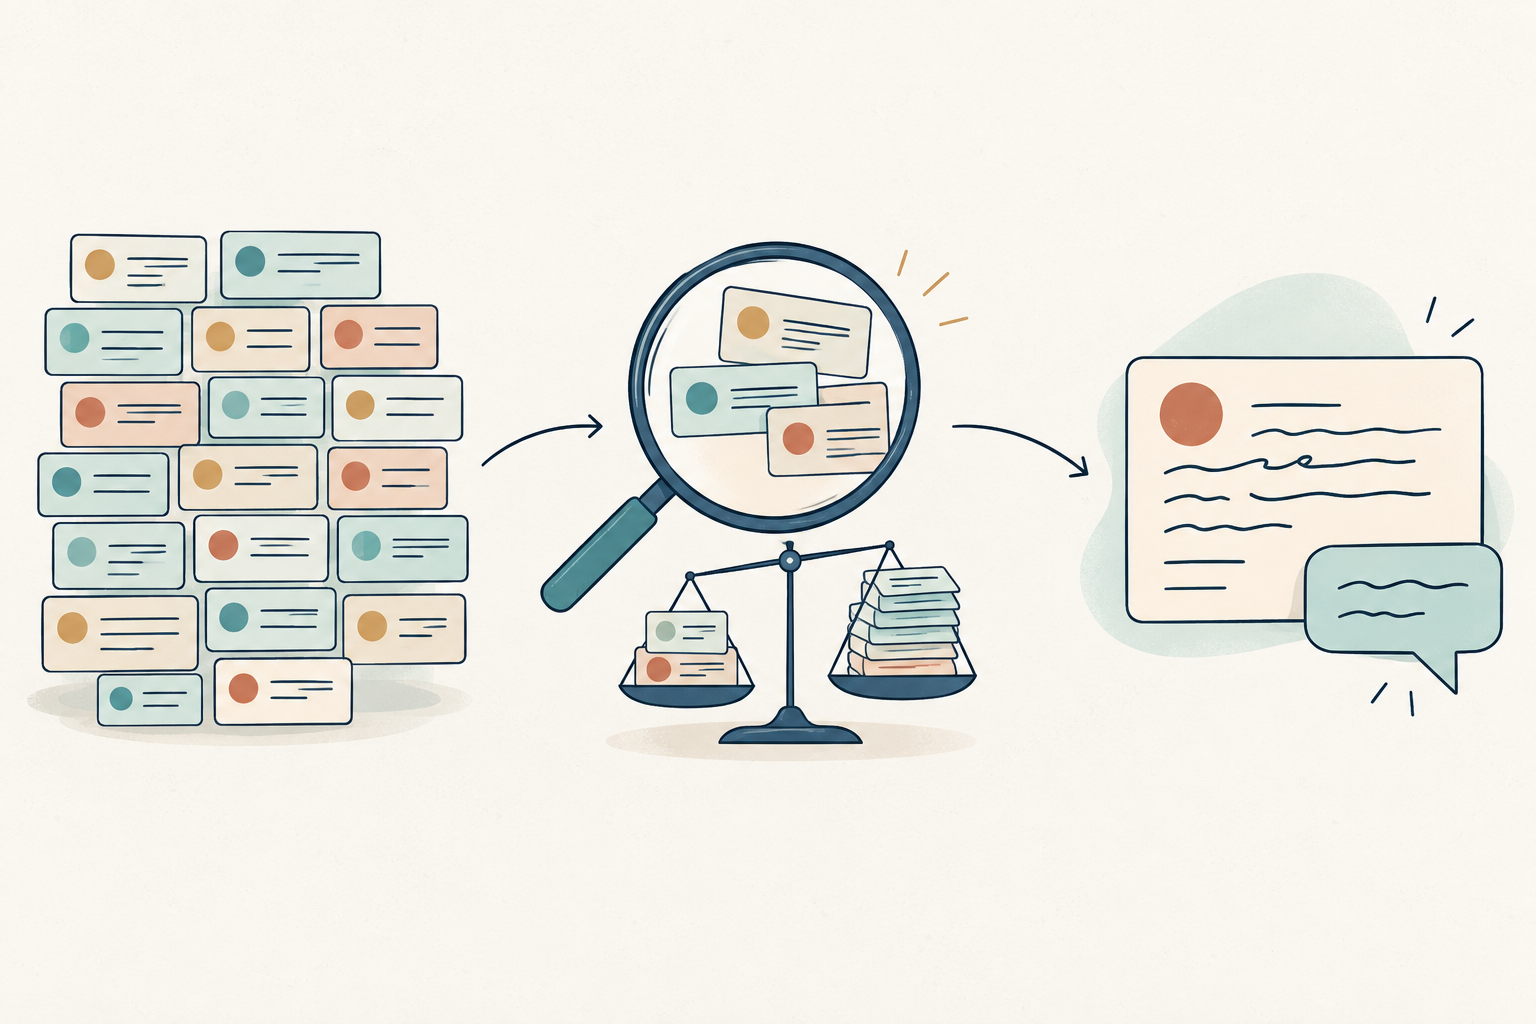
Definiera vilka kommentarer som ska läsas
Ange diskussionen och urvalsregeln innan du läser.
Tänk igenom vad urvalet täcker
Skilj det valda perspektivet från hela diskussionen.
Läs kommentaren i sitt sammanhang
Utgå från den faktiska frågan när du planerar ett svar och kontrollera svaret.
Ett kort underlag för att läsa en receptdiskussion
Använd de här frågorna innan du ber en kreatör eller kollega att granska kommentarer. De är ett praktiskt planeringsstöd, inga frågor från källdatamaterialet.
Beslut: Vad ska läsningen ge underlag för? Ange en konkret uppgift, som att förtydliga ett receptsteg eller välja ämne för en uppföljning. Skilj mellan att be om exempel och att be om en beskrivning av hela diskussionen.
Avgränsning: Vilket recept, vilken plattform och vilken period ingår? Ange om den tillgängliga listan är fullständig. Räkna kommentarer som kommentarer; kalla dem inte unika personer eller verifierade kunder utan separat underlag.
Urval: Hur ska kommentarerna väljas ut för läsning? Dokumentera sorteringsordningen eller slumpförfarandet, antalet lästa kommentarer och eventuell regel för lika värden. Ta med kommentarer utan betyg när de hör till diskussionen du vill förstå.
Observationer: Vad sade de valda kommentarerna faktiskt? Skilj en direkt fråga från din tolkning av den. Behåll tillräckligt sammanhang för att förstå problemet, men lämna personuppgifter utanför ett underlag som delas.
Nästa åtgärd: Vilket påstående eller vilken receptdetalj behöver kontrolleras före publicering? Ge uppgiften till någon som kan besvara frågan. Skriv den föreslagna förklaringen och var den ska publiceras, utan att göra de valda exemplen till ett obelagt påstående om hur vanligt något är.
Så jämförde vi de 3 urvalsmetoderna
Källan är Ali, Matuszewski och Czupyts datamaterial Recipe Reviews and User Feedback, publicerat av UCI 2023 under CC BY 4.0. Det innehåller kommentarer från en utvald lista med 100 högt betygsatta recept från Taste of Home. Publiceringsåret fastställer inget exakt insamlingsdatum, och det tillgängliga källmaterialet fastställer inte att varje ursprunglig kommentar samlades in. Det här är en analys av ett historiskt arkiv, inget aktuellt jämförelsemått för plattformen. [1][2][3]
Vi validerade hela det publicerade arkivet: 18 182 unika kommentaridentifierare fördelade på 100 receptpositioner. Varje recept hade fler än 10 kommentarer, så alla 100 ingick i jämförelsen. Personer som kommenterat flera gånger finns kvar som flera kommentarer. Vi tog inte bort dubbletter per person och analyserade inte recensionstext, namn, användarrykte eller källans rangordningspoäng.
För varje recept valde regeln för positiva röster de 10 kommentarer som hade flest observerade positiva röster. Regeln för de senaste kommentarerna använde de 10 senaste skapandetidsstämplarna. Vid lika värden vid urvalsgränsen var varje möjligt sätt att fylla de återstående platserna från den gruppen lika sannolikt. Slumpurval gav varje delmängd med 10 kommentarer i receptets arkiv samma sannolikhet.
För varje möjligt urval jämförde vi dess fördelning över 6 kategorier med fördelningen i hela receptarkivet och tog sedan genomsnittet av avståndet enligt urvalsregeln. Exakta sannolikhetsberäkningar ger det förväntade värdet utan simulering. Att ta genomsnittet av avstånden är viktigt: att beräkna ett avstånd först efter att ha tagit genomsnittet av kategoriandelarna skulle besvara en annan fråga och kunna dölja urvalsvariationen.
Sedan tog vi genomsnittet av de receptspecifika förväntade avstånden med samma vikt för varje recept. Skillnaderna beräknades före avrundning till 1 decimal. Ramen på 10 kommentarer, urvalsvillkoren, jämförelserna och rapporteringsplanen fastställdes innan målresultaten granskades. Inget annat antal kommentarer och ingen fördelaktig delmängd av recept valdes i efterhand.
Resultaten beskriver det här ändliga arkivet och de angivna urvalsreglerna, så vi redovisar inget konfidensintervall för populationen och ingen kausal effekt. Ackumulerade positiva röster visar inte exponerings- eller röstningshistorik. Den ursprungliga producentartikeln studerar textklassificering; den här analysen följer i stället UCI:s dokumenterade stjärnkategorier och undersöker urval. Den tekniska metoden förklarar skillnaden mellan källfälten. [1][2]
Nedladdningarna innehåller aggregerade resultat, en numerisk kontroll för varje receptposition och reproduktionskod. De innehåller ingen kommentarstext, inga namn och inga användaridentifierare. Källposterna finns separat från UCI; källangivelsen till datamaterialets författare och arkivet innebär inget stöd för vår tolkning. [1][3]
Ingen registrering krävs. Nedladdningarna innehåller aggregerade jämförelser, numeriska resultat per receptposition och översatta metodförklaringar. Ingen kommentarstext, inga användarnamn eller identifierare för enskilda kommentarer ingår. Källdatasetet finns tillgängligt separat från UCI. [1]
Källor och noter
- Ali, A., Matuszewski, S., och Czupyt, J. (2023). Recipe Reviews and User Feedback [Dataset]. UCI Machine Learning Repository. DOI: 10.24432/C5FG95. UCI dokumenterar 18 182 kommentarer och definierar fältet stars som 1–5, med 0 som inget betyg. Influence IQ:s beräkningar använder det publicerade arkivet, inte aktuella webbplatsdata.
- Producentartikeln ”Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models” beskriver den utvalda receptkällan och en studie av textklassificering. Dess beskrivning av best_score strider mot UCI:s dokumenterade betygsfält. Vi använder stars och analyserar inte best_score eller recensionstext. Det tillgängliga materialet fastställer inte exakt tidpunkt för den sparade ögonblicksbilden eller att insamlingen är fullständig.
- UCI:s datamaterial har licensen Creative Commons Attribution 4.0. Influence IQ har beräknat nya aggregerade jämförelser utifrån det. Källangivelsen innebär inget stöd från författarna, UCI eller Taste of Home. Nedladdningarna sprider inte enskilda kommentarer eller användaridentiteter.
- Influence IQ (2026). Urval av receptkommentarer: analysmetod, aggregerade resultat och reproduktionskod. Paketet dokumenterar den förutbestämda jämförelsen med 10 kommentarer, exakta beräkningar av förväntad totalvariation, regler för lika värden och numeriska resultat för samtliga 100 receptpositioner. Källdata hämtas separat från UCI. Översatta förklaringar medföljer de ursprungliga tekniska filerna.
Artikeln, planeringsunderlaget, figuretiketterna och resultatens CSV-fil finns på artikelns alla språk. Det tekniska reproduktionspaketet innehåller översatta förklaringar. Varje version beskriver samma historiska receptarkiv och analys.