Мерчандайзинг интернет-магазина: проверьте предположения о позиции товара
Исторический эксперимент с 10 книгами показывает, какие части картины может упустить простая поправка на место в списке и как проверить это предположение до сравнения карточек товаров.
Собственный повторный анализ опубликованного эксперимента выбора книг 2024 года авторов Compiani, Morozov и Seiler.
Аннотация
Прежде чем считать одно предложение сильнее другого, компании нужно учитывать место показа каждого. Мы использовали опубликованный эксперимент 2024 года с 10 электронными книгами и проверили 2 способа учёта позиции. Отдельная поправка для каждого места в целом лучше предсказывала выбор, чем одинаковая поправка на каждый шаг вниз по списку. На отдельных позициях она была менее точной, поэтому важно полное сравнение.
Обе модели использовали одни и те же сведения о книгах и ценах. Мы обучили их на 6 176 участниках и проверили прогнозы на других 3 088. Выбор был гипотетическим, и каждый должен был выбрать книгу. Компаниям и авторам, сравнивающим карточки товаров, стоит проверить предположения о размещении, прежде чем связывать результаты с самим предложением. Исследование не оценивает рост продаж и не определяет лучший порядок товаров.
Допустим, товар наверху страницы получает больше всего кликов. Предложение сильнее или помогло место в списке? Компании нужен ответ, прежде чем переписывать другие карточки, делать скидки на товары, которые кажутся менее привлекательными, или менять ассортимент.
Учесть позицию кажется простой задачей, пока не возникает вопрос, как именно это сделать. Нужна ли одинаковая поправка на каждый шаг вниз по списку? На историческом эксперименте мы сравнили этот простой подход с более гибким, затем проверили оба на участниках, не использованных для обучения.
Те же товары на разных позициях
Что должно показать сравнение позиций товаров?
Сравнение карточек должно помогать отделить сам товар от способа его показа. Если один товар обычно появляется первым, а другой — последним, одних суммарных результатов недостаточно, чтобы понять, какое предложение предпочитают покупатели.
Проверяемый простой подход даёт каждому шагу вниз одинаковую поправку к внутренней оценке предпочтения модели. Важно понять, достаточно ли хорошо он предсказывает выбор по сравнению с разными поправками для разных мест.
Мы проверили 2 подхода на опубликованном эксперименте выбора книг. Результат полезен компаниям и авторам, сравнивающим товары на странице коллекции или цифровой витрине. Он позволяет проверить предположение, лежащее в основе измерения, но не задаёт место для самого продаваемого товара.
Это важно, когда предложение появляется более чем в 1 месте. Автор может показать тот же файл для скачивания в коллекции и на странице запуска. Продавец может менять порядок товаров в категории. Товар, цена, аудитория и способ показа способны меняться вместе. Поправка на позицию — предположение об одном из аспектов сравнения, и его нужно проверить отдельно.
Что выбирали участники книжного эксперимента?
Giovanni Compiani, Ilya Morozov и Stephan Seiler предложили участникам Prolific гипотетический выбор из 10 электронных книг со случайным порядком и ценами. Нужно было выбрать книгу; варианта не покупать ничего не было. Мы используем первое задание каждой сохранённой отправки ответов, а не более позднее задание с удалением выбранной книги.[1]
Авторы уже сообщают о реакции на место в списке и цену. Их более широкая работа изучает, как текст и изображения помогают оценивать замещение товаров. Мы рассматриваем более узкий вопрос: улучшает ли замена общей поправки на позицию прогноз для участников, чей выбор не использовался при обучении?
После исходных правил отбора остаются 9 265 отправок ответов с 9 264 различными ID участников Prolific. 1 ID встречается 2 раза. Мы сохраняем обе отправки вместе и даём этому участнику такой же суммарный вес, как остальным. Отправка не равнозначна отдельному человеку, а первое задание не обязательно было первым знакомством человека с экспериментом.[2][3]
Даты сохранённых исходных записей — с 11 по 26 июня 2024 года. Рукопись описывает 14–27 июня, поэтому мы раскрываем разницу и не исключаем записи по дате. Требования к стране и возрасту не установлены по изученным материалам; это не оценки для покупателей США или другой национальной совокупности.[1][2]
Все отправки участника остаются вместе на протяжении сравнения
Отправки первого задания, отобранные по исходным правилам допуска авторов; даты сохранённых записей источника — 11–26 июня 2024 года.
| Группа | Участники (по ID платформы) | Сохранённые отправки |
|---|---|---|
| Вся сохранённая выборка | 9 264 | 9 265 |
| Обучение | 6 176 | 6 176 |
| Отложенная группа для оценки | 3 088 | 3 089 |
Какая модель позиции лучше предсказывала выбор в отложенной группе?
Гибкая модель позиции лучше предсказывала выбор в отложенной группе по заранее заданному показателю. Обе модели учитывают предложенную книгу и показанную цену и различаются только представлением позиции.
Базовая модель использует 1 коэффициент на каждый шаг вниз. Гибкая — отдельные поправки для позиций со 2 по 10 относительно первой. Это даёт больше свободы, но и больше оцениваемых параметров. Лучшего соответствия собственным обучающим данным недостаточно для вывода.
Поэтому обе модели обучили на 6 176 участниках и оценили на остальных 3 088. Все отправки одного участника оставались на одной стороне разбиения. В тестовой группе 3 089 отправок, поскольку в неё попал повторный участник.
Для сравнения прогнозов использовали отрицательную логарифмическую оценку. Штраф меньше, когда модель приписывает большую вероятность выбору, который человек действительно делает, и больше, когда приписывает ему очень малую вероятность. Чем ниже средняя отрицательная логарифмическая оценка, тем лучше.
Средняя оценка на отложенной группе — 2,2260 у базовой и 2,2154 у гибкой модели, в единицах натурального логарифма — натах. Это оценки прогноза, а не проценты правильных ответов. Обучающие и тестовые значения показаны вместе, чтобы не опираться на более простую задачу описания уже виденных данных.
2 модели на одних и тех же участниках
Выбор в первом задании с 10 книгами в отобранной выборке 2024 года. Обучение: 6 176 участников и отправок. Тест: 3 088 участников и 3 089 отправок.
| Модель позиции | Оценка на обучении (наты) | Оценка на отложенной группе (наты) |
|---|---|---|
| 1 линейный член позиции | 2,2046 | 2,2260 |
| Отдельные члены для позиций | 2,1899 | 2,2154 |
Парное улучшение составило 0,0106 ната на участника с приблизительным 95-процентным интервалом 0,0044–0,0168. Здесь положительное улучшение в пользу гибкой модели. На этой шкале результат мал, но интервал лежит выше 0.[4]
При расчёте интервала 2 обученные модели считаются фиксированными и предполагается независимость групп участников. Интервал не включает неопределённость обучения на другой выборке. Результат свидетельствует об улучшении прогноза в выбранном историческом задании, но не превращает разницу оценок в рост продаж.
Гибкая модель улучшает логарифмическую оценку на отложенной группе
Парное сравнение для 3 088 участников тестовой группы в отобранном историческом задании с 10 книгами.
| Сравнение | Улучшение (наты) | 95%-й интервал: нижняя граница (наты) | 95%-й интервал: верхняя граница (наты) |
|---|---|---|---|
| Логарифм вероятности: гибкая минус базовая | 0,0106 | 0,0044 | 0,0168 |
Где 2 модели расходились с наблюдаемым выбором?
Полное сравнение позиций показывает, почему общую оценку нужно дополнять подробностями. Для каждого места мы сравниваем наблюдаемую долю выбора со средней вероятностью каждой модели. Это средние с равным весом участников отложенной группы, а не показатели кликабельности.
На позиции 1 наблюдаемая доля — 17,16 %. Базовая модель предсказывала 14,64 %, гибкая — 17,73 %. На позиции 10 наблюдалось 9,18 % при прогнозах 6,37 % и 8,74 %. Гибкая модель была ближе на обоих концах именно этого списка.
Наблюдаемый и предсказанный выбор на всех 10 позициях
Отложенная группа: 3 088 участников и 3 089 отправок первого задания из опубликованного эксперимента 2024 года.
| Позиция | Наблюдаемая доля выбора | Средняя вероятность базовой модели | Средняя вероятность гибкой модели | Отправки с выбором этой позиции |
|---|---|---|---|---|
| Позиция 1 | 17,16 % | 14,64 % | 17,73 % | 530 |
| Позиция 2 | 13,60 % | 13,20 % | 14,84 % | 420 |
| Позиция 3 | 9,91 % | 12,06 % | 9,74 % | 306 |
| Позиция 4 | 10,91 % | 11,21 % | 9,26 % | 337 |
| Позиция 5 | 9,20 % | 10,09 % | 8,94 % | 284 |
| Позиция 6 | 7,08 % | 9,25 % | 8,01 % | 219 |
| Позиция 7 | 8,00 % | 8,44 % | 7,57 % | 247 |
| Позиция 8 | 7,12 % | 7,67 % | 7,47 % | 220 |
| Позиция 9 | 7,84 % | 7,08 % | 7,69 % | 242 |
| Позиция 10 | 9,18 % | 6,37 % | 8,74 % | 284 |
Гибкая модель была ближе не везде. На позиции 4 наблюдалось 10,91 %. Базовая предсказывала 11,21 %, а гибкая — 9,26 %. Дополнительная гибкость улучшила общую оценку отложенной группы, но оставила большее расхождение в этой позиции.
Следующая таблица показывает наблюдаемую долю минус предсказанную. Положительное отклонение означает, что модель занизила долю выбора на этой позиции, отрицательное — завысила. Все 10 позиций остаются видимыми, чтобы удачный результат на краю списка не заменял всё сравнение.
Отклонения обеих моделей от наблюдаемого выбора
Наблюдаемая доля выбора минус средняя предсказанная вероятность для каждой из 10 позиций на тех же 3 088 участниках тестовой группы.
| Позиция | Наблюдаемая доля минус базовая модель | Наблюдаемая доля минус гибкая модель |
|---|---|---|
| Позиция 1 | 2,52 п. п. | -0,57 п. п. |
| Позиция 2 | 0,41 п. п. | -1,24 п. п. |
| Позиция 3 | -2,15 п. п. | 0,17 п. п. |
| Позиция 4 | -0,29 п. п. | 1,65 п. п. |
| Позиция 5 | -0,89 п. п. | 0,26 п. п. |
| Позиция 6 | -2,17 п. п. | -0,93 п. п. |
| Позиция 7 | -0,44 п. п. | 0,43 п. п. |
| Позиция 8 | -0,55 п. п. | -0,35 п. п. |
| Позиция 9 | 0,76 п. п. | 0,14 п. п. |
| Позиция 10 | 2,81 п. п. | 0,44 п. п. |
Результаты по позициям носят описательный характер; отдельные утверждения о статистической значимости не делаются. Эксперимент не измерял движения глаз или внимание, а анализ не устанавливает причины различий между позициями. Криволинейная картина наблюдаемых долей сама по себе также не опровергает базовую модель: линейность члена позиции относится к внутренней оценке предпочтения модели, а не к процентам выбора.
Простая разность наблюдаемых долей на первой и последней позициях отвечала бы на другой вопрос. Эти доли обобщают выбор разных товаров при разных ценах. Обе обученные модели учитывают конкретную книгу и цену до распределения вероятностей между 10 вариантами. Ни разность между крайними позициями, ни сравнение моделей не показывают последствий перемещения конкретного товара в работающем магазине.
Шаблон измерений для сравнения позиций товаров
Перед сравнением предложений составьте краткий план измерений. Шаблон ниже доступен без регистрации и служит иллюстрацией. Он применяет вывод о проверке предположений, но не обещает, что та же модель подойдёт вашей витрине.
Решение: «Нам нужно принять решение о [сравнении товаров или изменении способа показа] для [страницы или кампании] в течение [периода]». Определите решение, прежде чем выбирать показатель с выгодным результатом.
Исход: «Мы измерим [выбор, клик, добавление в корзину или покупку]». Выберите исход, действительно подтверждаемый записями. Сохраняйте рядом предложенные варианты, их порядок и показанные цены. Результат обязательного выбора нужно отделять от результата покупки.
Единица: «Наша единица — [участник или другая ясно определённая единица]. Повторные посещения или отправки учитываются по [правилу]». При проверке прогноза для новых людей сохраняйте наблюдения одного человека вместе. Анонимный идентификатор сеанса не подтверждает, что за ним стоит отдельный человек.
Сравнение: «Обе модели будут использовать те же товары, сведения о ценах и подходящие наблюдения. Они будут различаться [предположением о позиции]». Задайте и простую, и более гибкую альтернативу.
Оценка: «До обучения мы выделим [заданную группу] для оценки и сравним [названный показатель прогноза]. Мы покажем все позиции». Заранее решите, как сообщить о неопределённом или худшем результате.
Применение: «Результат поможет принять [решение об измерении]. До [коммерческого решения] ещё нужны данные о [не измеренном здесь коммерческом исходе]». Последняя фраза не позволяет незаметно превратить проверку прогноза в прогноз выручки.
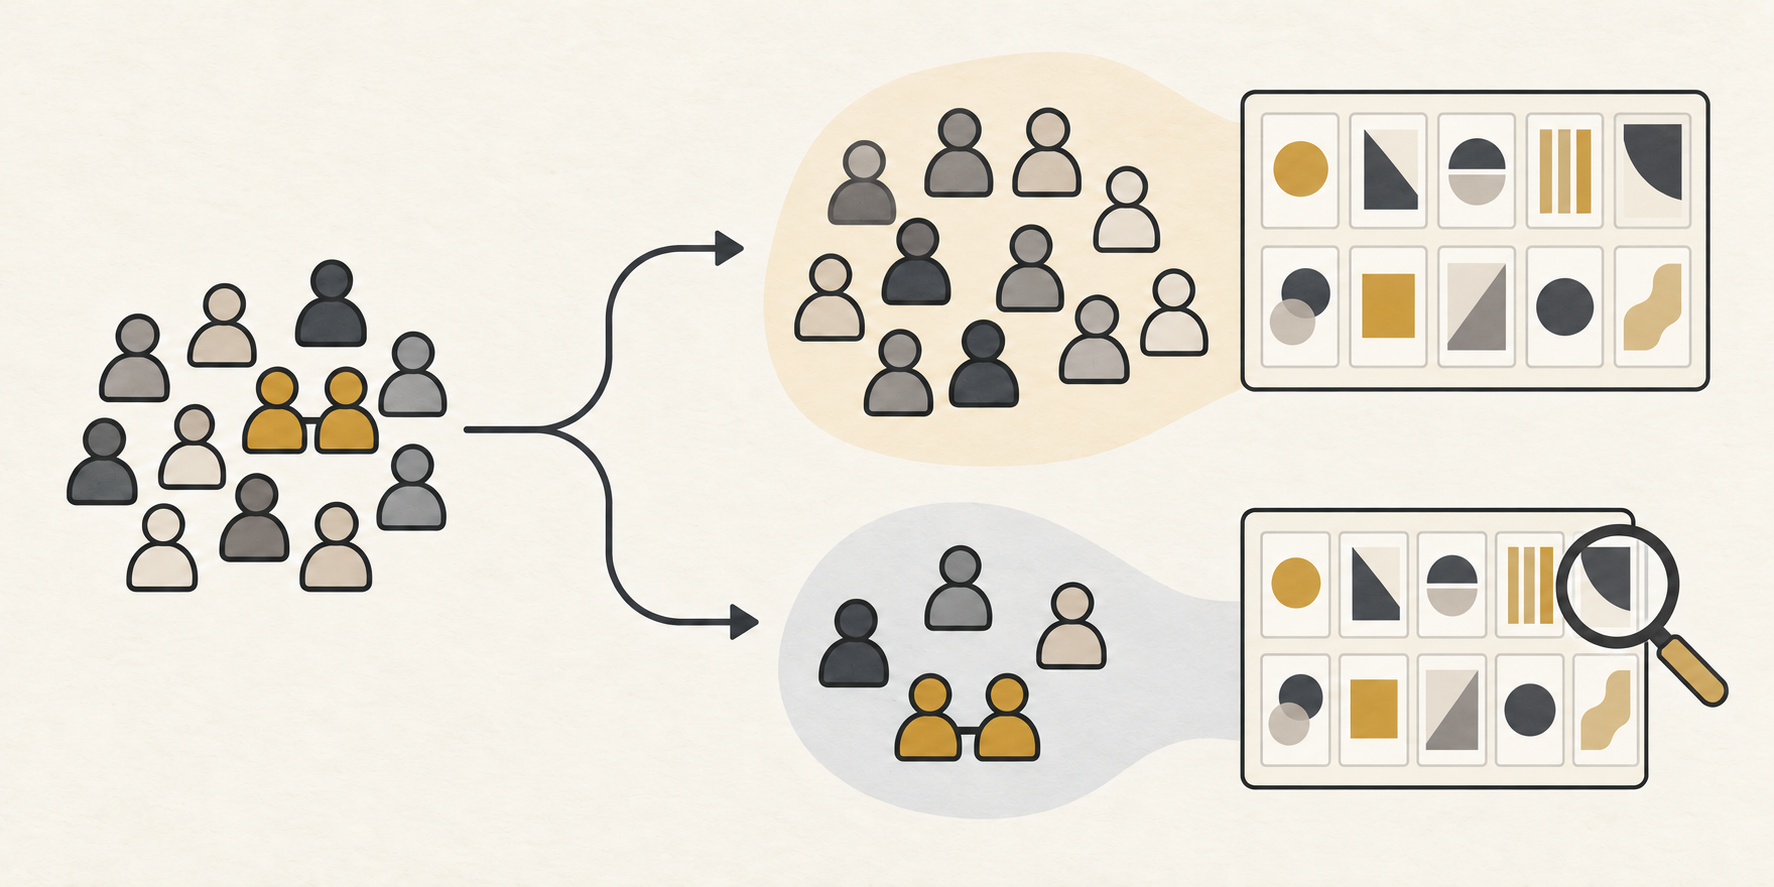
Относите все ответы участника к одной группе
Определите сравнение
Укажите товар, позицию, результат и единицу наблюдения.
Выделите группу для оценки
Сохраняйте все отправки одного участника в одной группе.
Проверьте полный результат
Сравните прогнозы и покажите все позиции, в том числе те, где результат хуже.
Разобранный пример: автор сравнивает цифровые предложения
Рассмотрим вымышленного автора, продающего тетрадь для письменной практики, практикум и комплект. Комплект стоит наверху страницы запуска и получает больше всего кликов. Автор думает переписать описания других продуктов.
План измерений меняет вопрос, на который нужно ответить сейчас. Наблюдаемый исход — клик, а не продажа. Записи должны показывать, какие предложения были показаны, в каком порядке и по каким ценам. Если комплект всегда занимает первое место, данные не позволяют однозначно отделить этот комплект от этой позиции.
Заполненный план автора мог бы звучать так: «Мы хотим знать, предсказывает ли наш способ учёта позиции клики новых посетителей. Мы сравним те же предложения и сведения о ценах, сохраним повторные наблюдения вместе и покажем полное сравнение позиций. Мы не будем делать выводы о покупках по данным о кликах». Это вымышленный пример вопроса измерения, а не предполагаемый результат.
Разумный следующий шаг — спланировать сравнение с достаточным разнообразием сочетаний товара и позиции, чтобы учитывать их отдельно, сохранив прежнее определение исхода. Затем автор мог бы сравнить простую и более гибкую поправки на отложенной группе. Это было бы новое исследование этой страницы; книжный эксперимент не задаёт для неё ожидаемую кликабельность.
Если гибкий подход лучше предсказывает отложенную группу, есть основание пересмотреть учёт размещения в отчёте. Но это не показывает, что перенос комплекта увеличит выручку. Для коммерческого решения нужны данные о реальном изменении представления и значимом для компании исходе.
Если сравнение не даёт ответа, автору следует так и сказать. Дополнительная гибкость не делает инструмент автоматически полезнее для бизнеса. Практическая польза — ясная последовательность: понять, какие различия позволяют выявить данные, проверить предположение, лежащее в основе измерения, и затем решить, нужен ли другой эксперимент.
Как Influence IQ выполнил расчёты для сравнения?
Мы использовали отредактированный выпуск ответов авторов и исходные правила отбора. Первые 553 пилотные или тестовые записи исключены по фиксированной позиции в файле. Осталось 10 775 отправок. Фильтры понимания задания оставляют 9 344, фильтр завершения — 9 265.[2]
Проверки согласия, статуса завершения и минимальной длительности 60 секунд на соответствующих этапах не исключают дополнительных отправок. Завершение и длительность — фильтры после воздействия, поэтому сохранённая группа является отобранной выборкой.
Группы определяют ID участников Prolific. Детерминированное разбиение по хешу относит 2/3 групп к обучению, остальные — к тесту без использования их выбора. Внутри каждой группы вклад участника поровну распределён между его сохранёнными отправками первого задания. Те же веса применяются к обучению, оценке и таблицам позиций.[3]
Обе модели — мультиномиальные логит-модели без регуляризации с 9 индикаторами книг и 1 линейным членом по цене. Базовая добавляет 1 линейный член позиции — всего 11 параметров. Гибкая добавляет 9 индикаторов позиций — всего 19. Позиция 1 и наименьший числовой ID товара задают опорные категории. Все допустимые наборы выбора содержат те же 10 товаров; выбранный ID, цена и позиция проверены на согласованность.
Мы обучили модели на обучающей группе, сохранили коэффициенты и затем рассчитали оценки для выбора в тестовой группе. Для интервала используются стандартное отклонение парных разностей оценок участников, 3 088 участников как единиц наблюдения и 3 087 степеней свободы. Интервал Стьюдента приблизителен, кроме случая выполнения предположений о нормальности оценок, при которых он точен. Все 10 сравнений позиций остаются описательными.[4]
Основной оптимизатор базовой модели вернул численное предупреждение. При этом модель выполнила все условия точности, заданные до обучения, включая сравнение с другим стартом. Мы сохранили исходную оценку; подробная диагностика включена в материалы воспроизведения.[5]
Материалы для скачивания включают показанные результаты, исходный код анализа и сводные результаты расчётов. Исходные записи ответов, ID участников и оформление книг исключены. Данные нужно получить отдельно из выпуска авторов. За повторный анализ и его интерпретацию отвечает Influence IQ.
Язык CSV совпадает с языком страницы. Пакет содержит исходный код расчётов, переведённые методические материалы и сводные результаты. Исходные записи ответов и материалы книг не включены; данные нужно получить отдельно из выпуска авторов.
Источники и примечания
- Compiani, Morozov и Seiler, Demand Estimation with Text and Image Data, версия рукописи 4 от 17 февраля 2026 года, раздел 3 и приложение C. Авторы уже исследуют реакцию на место в списке и цену. Наше сравнение на отложенной группе участников — самостоятельный повторный анализ более узкого вопроса.
- Выпуск DeepLogitReplication авторов, коммит 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Мы используем исходную границу пилотных записей по их месту в отредактированном файле ответов и правила допуска авторов. Даты сохранённых записей источника — 11–26 июня 2024 года; в рукописи указан период 14–27 июня. Даты не определяют включение в анализ.
- В Prolific ID участника отличается от идентификатора исследования или отправки. Для группировки мы сохраняем точные ID участников. Эти ID сами по себе не подтверждают, что за каждым стоит отдельный человек, и не устанавливают, что сохранённая отправка была его первым знакомством с заданием.
- В сравнении Influence IQ, заданном до анализа, разность логарифмов вероятности «гибкая минус базовая» сначала усредняется внутри каждого участника тестовой группы, затем между участниками. 95%-й интервал равен среднему плюс-минус критическое значение распределения Стьюдента, умноженное на стандартное отклонение парных разностей оценок участников и делённое на квадратный корень из 3 088. Он предполагает независимость групп участников, обусловлен фиксированными результатами обучения и не учитывает неопределённость их оценки. Для точности интервала нужны одинаково распределённые нормальные разности участников с общей дисперсией.
- Оценка базовой модели с нулевого старта вернула предупреждение о точности. Максимальное абсолютное значение среднего градиента составило 3,12×10⁻⁹, декремент Ньютона — 2,50×10⁻⁸, максимальная разность логарифмов вероятности между 2 стартами — 7,46×10⁻⁸. Эти значения ниже заранее заданных пределов 10⁻⁸, 10⁻⁶ и 10⁻⁷. Обе модели также выполнили условия положительной кривизны и согласованности значений целевой функции. Сохранены коэффициенты основного расчёта с нулевого старта.
Исходная версия статьи подготовлена на английском. Все языковые версии описывают один и тот же исторический эксперимент; это не оценки покупательского поведения для отдельных стран.