2 etichete de moderare pot proveni de la evaluatori diferiți
Predarea unui caz de evaluare a comentariilor poate arăta 2 etichete fără să arate cine le-a ales. Evaluările istorice din Wikipedia arată de ce acest detaliu lipsă contează pentru următoarea persoană care citește cazul.
Analiză originală Influence IQ a unor evaluări selectate din setul istoric de date Wikipedia Detox despre atacuri personale. Analiză finalizată la 25 octombrie 2026 (UTC).
Rezumat
Dintre 13.824 de fragmente istorice selectate din discuții Wikipedia, 155 au primit atât o etichetă de citare/relatare, cât și una de atac la adresa destinatarului, undeva în cele 10 evaluări individuale. În 98 dintre cele 155 de fragmente, cel puțin 1 evaluator a selectat ambele etichete. În celelalte 57, adică 36,8 %, etichetele au provenit numai de la evaluatori diferiți. Procentul descrie acele 155 de fragmente, nu toate cele 13.824.[1][4]
Pentru afaceri și creatori care gestionează comentarii pe rețelele sociale, lecția practică privește predarea cazului: păstrează observațiile fiecărui evaluator legate de evaluarea acelei persoane. Apariția împreună a 2 etichete nu dovedește că 1 persoană le-a ales pe amândouă. Studiul descrie evaluări subiective ale unor fragmente istorice de discuție, nu erori de moderare sau o regulă de eliminare a unui comentariu. Fișa de mai jos, pe care o poți copia, transformă distincția într-o înregistrare practică a evaluării.
Imaginează-ți că un creator îi cere unui coleg să examineze un comentariu dificil. Cazul predat are 2 etichete: cineva citează sau relatează un atac, iar cineva îndreaptă un atac spre destinatar. Înainte să decidă ce face, colegul mai are nevoie de un detaliu: același evaluator a făcut ambele observații?
Este o distincție reală pe care o sinteză o poate pierde. 1 persoană poate să fi selectat ambele opțiuni sau 2 persoane se pot fi concentrat pe aspecte diferite ale aceluiași text. O simplă listă de etichete nu îi poate spune următorului evaluator ce tipar a apărut. Poate lăsa neclar și ce cuvinte descria fiecare persoană.
Am explorat întrebarea folosind evaluări individuale dintr-un set de date de cercetare consacrat. Materialul original provenea din pagini de discuții Wikipedia. Rolul lui aici este să facă vizibilă relația dintre etichete și evaluatori, apoi să ajute o afacere sau un creator să se gândească la informațiile de păstrat când predă propriul caz.
Păstrează fiecare observație legată de evaluatorul ei
Începe cu ce descrie de fapt fiecare etichetă
Prima opțiune întreba dacă textul cita sau relata un atac personal provenit din alt comentariu. A doua privea un atac personal la adresa destinatarului. Evaluatorii puteau selecta mai multe opțiuni. Erau evaluări ale textului prezentat, nu decizii de a-l ascunde sau dovezi că fusese încălcată o politică.[2]
Am considerat o etichetă prezentă când cel puțin 1 dintre cei 10 evaluatori o selectase. Comparația lua în calcul selecția oricărui evaluator. Nu am cerut o majoritate, nu am descris etichetele drept consens și nu am testat dacă erau corecte.
Dintre cele 13.824 de fragmente selectate, 12.025 nu aveau niciuna dintre aceste 2 etichete. Alte 406 aveau eticheta de citare/relatare fără cea de atac la adresa destinatarului, iar 1.238 aveau eticheta de atac la adresa destinatarului fără cea de citare/relatare. Rămâneau astfel 155 cu ambele etichete undeva în evaluările lor.
Aceste descrieri privesc doar cele 2 opțiuni. Un fragment fără eticheta de atac la adresa destinatarului putea avea totuși alt tip de etichetă de atac. Eticheta de citare/relatare nu certifică faptul că textul era inofensiv. Păstrarea unor denumiri precise împiedică transformarea discretă a unei categorii utile într-o concluzie mai largă.
Cum au fost etichetate cele 13.824 de fragmente selectate
O etichetă era prezentă dacă cel puțin 1 dintre cei 10 evaluatori o selectase. Aceste 5 categorii privesc 2 opțiuni precise; „niciuna” nu înseamnă că fragmentul nu avea niciun tip de etichetă de atac.
| Etichete de citare/relatare și de atac la adresa destinatarului | Fragmente |
|---|---|
| Niciuna dintre aceste 2 etichete | 12.025 |
| Etichetă de citare/relatare, fără etichetă de atac la adresa destinatarului | 406 |
| Etichetă de atac la adresa destinatarului, fără etichetă de citare/relatare | 1.238 |
| Ambele etichete, cu cel puțin 1 pereche de la același evaluator | 98 |
| Ambele etichete, furnizate numai de evaluatori diferiți | 57 |
57 de fragmente aveau ambele etichete, dar niciun evaluator nu le alesese pe amândouă
În cele 155 de fragmente, am verificat răspunsul individual din spatele fiecărei etichete. În 98, cel puțin 1 persoană selectase ambele opțiuni pentru același fragment. În 57, selecțiile de citare/relatare și de atac la adresa destinatarului proveneau numai de la persoane diferite. Niciun răspuns individual din acele 57 nu conținea perechea.
Împărțirea era de 63,2 % cu o pereche de etichete de la același evaluator și 36,8 % cu etichetele furnizate numai de evaluatori diferiți. Ambele grupuri aparțineau aceluiași set strict delimitat de 155 de fragmente. Cadrul mai larg de 13.824 de fragmente rămâne important, pentru că arată de unde a pornit comparația condiționată.[4]
Distincția schimbă afirmația pe care o poți face pornind de la o sinteză. Faptul că au apărut ambele etichete susține afirmația că fiecare a fost selectată undeva în setul de evaluări. Nu susține, de unul singur, afirmația că un evaluator individual a descris textul în ambele moduri.
Nici tiparul cu același evaluator nu lămurește ce însemnau cuvintele. Un fragment sursă putea combina adăugiri făcute într-o revizie Wikipedia, inclusiv mai multe postări. Faptul că un evaluator selectează ambele opțiuni nu arată că pasajul citat era el însuși atacul la adresa destinatarului. Nu am inspectat fragmente individuale ca să le explicăm evaluările.[2][6]
57 dintre cele 155 de fragmente nu aveau o pereche de la același evaluator
Comparația include doar cele 155 de fragmente selectate cu ambele etichete undeva în cele 10 evaluări ale lor. Ține cont de prezența fiecărei etichete la cel puțin 1 evaluator, nu de acordul majoritar sau de rezultate de moderare verificate.
| Cine a furnizat cele 2 etichete | Fragmente | Procentul celor 155 de fragmente |
|---|---|---|
| Cel puțin 1 evaluator a selectat ambele etichete | 98 | 63,2 % |
| Etichetele au provenit numai de la evaluatori diferiți | 57 | 36,8 % |
Oferă-i următorului evaluator observația din spatele etichetei
Într-o afacere, cazul poate trece de la persoana care urmărește comentariile la cea responsabilă de cont. Pentru un creator, poate trece de la un asistent la creator. Următoarea persoană trebuie să înțeleagă ce s-a observat înainte să decidă dacă răspunde, caută mai mult context sau aplică politica existentă a contului.
Păstrează împreună selecțiile fiecărei persoane. Dacă un evaluator selectează ambele opțiuni, păstrează perechea ca provenind din evaluarea acelei persoane. Dacă 2 evaluatori aleg opțiuni diferite, păstrează răspunsurile separate. Un caz poate conține mai multe interpretări fără să le transforme într-o evaluare pe care nimeni nu a făcut-o de fapt.
Adaugă apoi o scurtă explicație a pasajului relevant. În propriul flux de lucru, identifică ce pare citat, cui pare să i se adreseze textul și ce răspuns din jur ajută la explicarea schimbului. Lasă incertitudinea vizibilă când contextul disponibil nu răspunde întrebării. Sunt sugestii practice; setul de date nu le-a testat efectul asupra deciziilor.
Poate fi suficientă o notă scurtă. Scopul este ca următoarea persoană să poată urmări raționamentul primei persoane fără să refacă întreaga evaluare. Pentru o echipă care transmite cazuri între ture sau între un brand și un creator, asta înseamnă să predea observația originală împreună cu categoria asociată ei.
Un exemplu fictiv cu totaluri identice ale etichetelor
Ia în considerare 2 grupuri inventate de evaluatori, fiecare cu 10 persoane care evaluează 1 fragment fictiv. Grupurile ilustrează aritmetica; nu sunt persoane, citate sau cazuri reale din setul de date. Ambele sinteze arată 1 selecție de citare/relatare și 1 selecție de atac la adresa destinatarului.[8]
În primul grup, evaluatorul A selectează ambele opțiuni. Celelalte 9 persoane nu selectează niciuna dintre aceste 2 opțiuni. Există 1 persoană al cărei răspuns conține perechea. La predarea cazului se poate păstra fidel evaluarea combinată a acelei persoane, lăsând acțiunea finală pentru o decizie separată.
În al doilea grup, evaluatorul A selectează citarea/relatarea, iar evaluatorul B selectează atacul la adresa destinatarului. Celelalte 8 persoane nu selectează niciuna dintre opțiuni. Totalurile câmpurilor rămân 1 și 1, dar nicio persoană nu le-a selectat pe amândouă. Numirea acestei situații drept evaluarea combinată a unei persoane ar adăuga o relație pe care răspunsurile individuale nu o conțin.
Exemplul explică și de ce am numărat fragmente, nu am cumulat numărul tuturor persoanelor care se potriveau criteriului. Dacă 2 persoane din primul grup ar fi ales fiecare ambele etichete, fragmentul ar fi intrat tot 1 dată în categoria în care același evaluator a selectat ambele etichete. Clasificarea întreabă dacă a existat o astfel de pereche, nu câte persoane au furnizat-o.
Pentru al doilea grup, o notă fictivă scurtă de predare ar putea suna așa: „Decizia rămâne deschisă. Evaluatorul A a identificat citare/relatare; evaluatorul B a identificat limbaj adresat destinatarului. Păstrează ambele note lângă fragment și răspunsul anterior. Responsabilul contului va verifica la ce pasaj se referea fiecare evaluator înainte să aleagă acțiunea.” Nota transmite mai departe o întrebare nerezolvată fără să rescrie răspunsurile a 2 persoane drept concluzia uneia singure.
Într-o predare reală a cazului, păstrează cele 2 note separate din al doilea grup. Următorul evaluator le poate citi alături de text, poate întreba ce a vrut să spună fiecare persoană și poate lua decizia conform politicii contului. Studiul nu stabilește dacă vreun evaluator a avut dreptate sau ce acțiune ar trebui aplicată acelui caz fictiv.
Aceleași totaluri ale etichetelor pot proveni din tipare diferite de evaluare
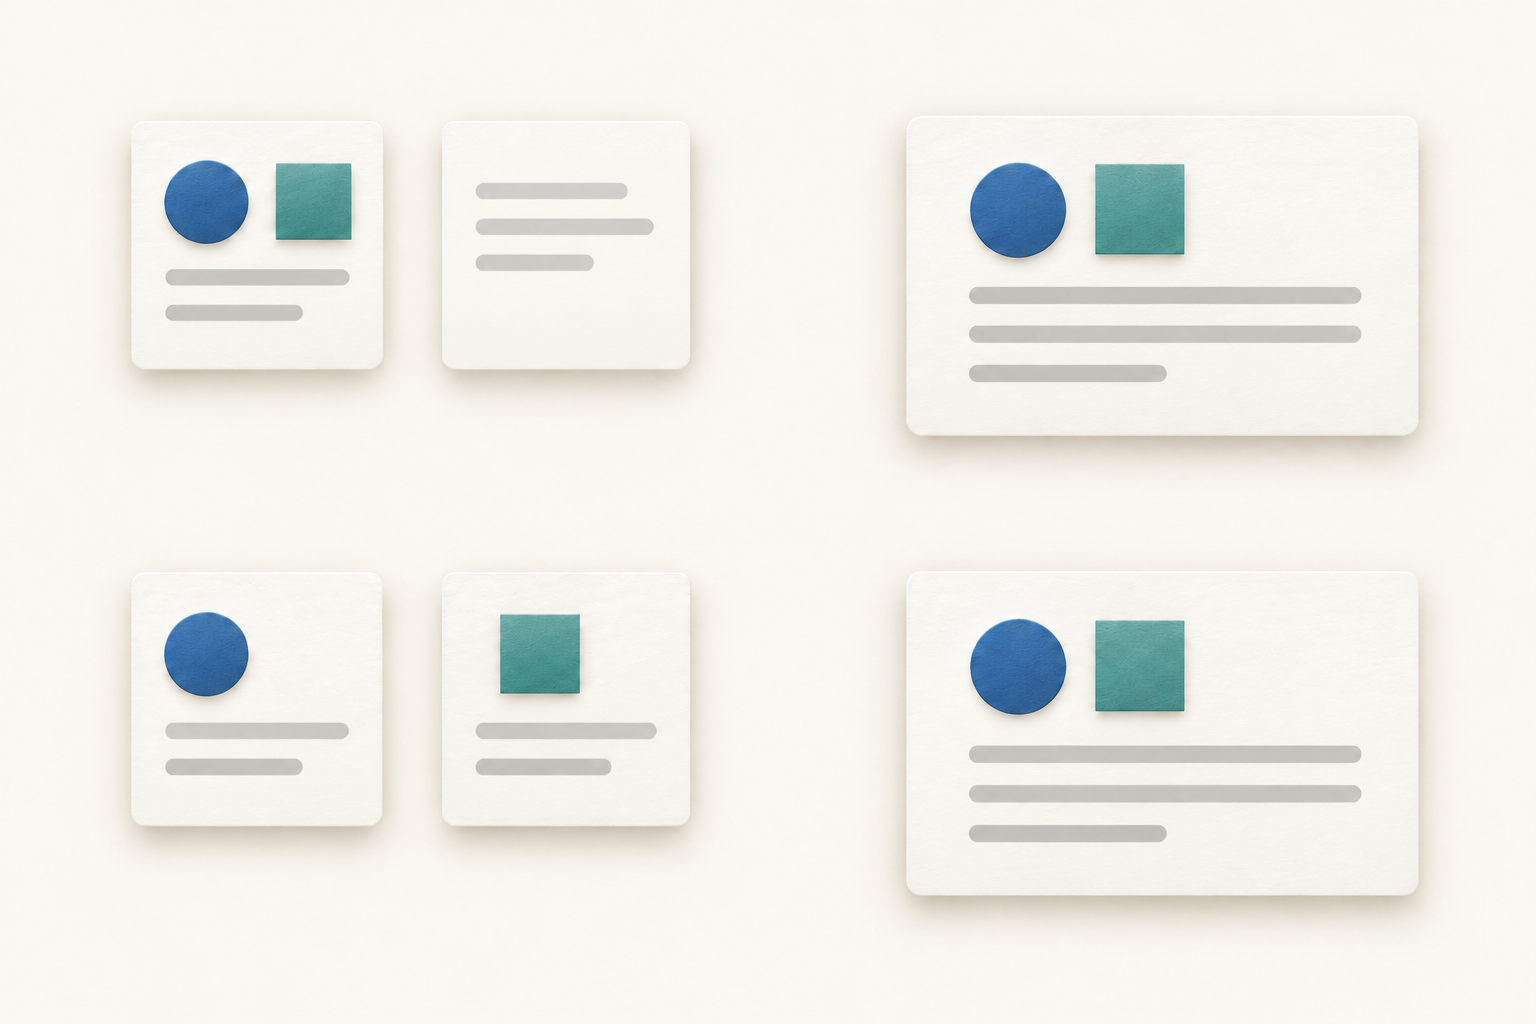
1 evaluator selectează ambele etichete
Primul grup inventat are 1 persoană care alege ambele etichete și 9 care nu aleg niciuna dintre aceste 2 opțiuni.
2 evaluatori selectează câte 1 etichetă
Al doilea are 1 persoană care alege citarea/relatarea și alta care alege atacul la adresa destinatarului. Celelalte 8 nu aleg niciuna dintre opțiuni.
Păstrează decizia privind politica separată de descriere
Descrierea a ceea ce pare să apară într-un comentariu și decizia privind ce faci cu el au scopuri diferite. Un evaluator poate observa limbaj citat, în timp ce responsabilul contului trebuie încă să ia în calcul schimbul din jur și politica aplicabilă. Păstrează acești pași separați, astfel încât cineva care citește ulterior să vadă cum s-a ajuns la decizie.
Dacă reprezinți o afacere care lucrează cu un creator, stabilește împreună cu creatorul cine ia acea decizie înainte să apară un schimb dificil. Persoana care înțelege o reclamație despre produs poate să nu fie cea autorizată să schimbe abordarea contului privind moderarea. O predare clară a cazului poate numi ambele roluri fără să presupună că fiecare caz are nevoie de mai mulți evaluatori.
Dacă ești un creator care lucrează singur, aceeași distincție poate exista în 1 notă: ce ai observat, ce context ai verificat și ce ai decis. 1 persoană poate parcurge mai mulți pași păstrând clare scopurile lor. Setul de date nu arată că adăugarea de personal sau a unui nivel suplimentar de evaluare îmbunătățește rezultatele.
Păstrează observațiile separate până când le înțelegi relația. Selecțiile diferite pot reflecta puncte de interes diferite, nu neapărat relatări contradictorii. Selectarea citării/relatării nu oferă o excepție automată, iar selectarea atacului la adresa destinatarului nu este o recomandare de ștergere bazată pe măsurători. Următoarea acțiune utilă este cea susținută de schimbul real și de regulile contului, nu o acțiune dedusă din procentele arhivei noastre.
O fișă de evaluare a comentariilor pe care o poți copia
Copiază aceste câmpuri în documentul tău existent de evaluare sau de predare a cazului. Folosește doar informațiile de care echipa are nevoie, cu acces potrivit conversației. Fișa este disponibilă aici fără înregistrare; este îndrumare practică, nu un proces observat în studiu.[8]
Caz: [Link sau referință internă.] Cont/canal: [Unde apare schimbul de mesaje.] Verificat la: [Data și ora.] Păstrează referința stabilă, astfel încât următoarea persoană să găsească același material.
Scop: [Ce întrebare cere o decizie?] Responsabil: [Cine va decide?] Următoarea persoană: [Cine are nevoie să primească cazul, dacă este cazul?]
Text prezentat: [Pasajul evaluat, păstrat în spațiul tău de lucru aprobat.] Context din jur: [Răspunsuri anterioare sau ulterioare relevante.] Context lipsă: [Ce nu a putut fi verificat.]
Evaluator: [Nume sau referință internă pentru evaluator.] Momentul evaluării: [Data și ora.] Păstrează separată înregistrarea fiecărei persoane, chiar dacă mai multe persoane folosesc aceleași etichete.
Observație de citare/relatare: [Da, nu sau neclar.] Bază: [Ce pasaj pare să citeze sau să relateze atacul altei persoane?] Nu folosi acest câmp ca să decizi că textul este inofensiv.
Observație privind atacul la adresa destinatarului: [Da, nu sau neclar.] Bază: [Ce pasaj pare adresat destinatarului și de ce?] Păstrează acest răspuns independent de observația de citare/relatare.
Alte observații relevante: [Orice altă problemă care trebuie luată în calcul conform politicii contului.] Nu trata absența uneia dintre cele 2 etichete din studiu ca pe o descriere completă a schimbului.
Relația dintre evaluări: [O persoană a selectat ambele, persoane diferite au selectat opțiuni diferite sau este neclar.] Dacă evaluatorii diferă, păstrează notele lor individuale înainte să sintetizezi cazul.
Referință privind politica: [Regula sau îndrumarea aplicabilă.] Decizie: [Acțiunea aleasă efectiv sau întrebarea nerezolvată.] Motiv: [Cum susțin observația și contextul acea decizie.]
Urmărire: [Cine face ce în continuare, dacă este cazul?] Momentul predării: [Când cazul trece la acea persoană.] Rezultat: [Ce s-a întâmplat după decizie, dacă s-a verificat.] Nu marca o acțiune intenționată drept finalizată.
Reevaluează când: [Un eveniment concret sau o informație lipsă din context, dacă mai este nevoie de o examinare.] Fișa nu cere evaluarea repetată a fiecărui caz; folosește un motiv potrivit situației.
Verificarea anului a păstrat aceleași 155 de fragmente
Am stabilit 2 verificări de sprijin înainte să calculăm perechile de etichete. Prima a omis fragmentele datate 2016, deoarece intervalul de ani din fișierele publicate se extindea dincolo de perioadele descrise în prezentarea sursei și în lucrarea originală. Au rămas 13.809 fragmente eligibile din eșantionul aleatoriu. Aceleași 155 aveau ambele etichete, cu aceeași împărțire 98/57.[5]
Cealaltă verificare a folosit materialul eșantionat separat din jurul evenimentelor de blocare. Cu aceeași regulă de exact 10 evaluări, conținea 42.383 de fragmente. Dintre cele 2.457 cu ambele etichete undeva în evaluări, 1.354 aveau o pereche de la același evaluator, iar 1.103 aveau etichetele furnizate numai de persoane diferite: 55,1 % și, respectiv, 44,9 %.
Grupul îmbogățit cu material din jurul blocărilor are alt scop de eșantionare, așa că l-am păstrat separat. Procentele lui nu înlocuiesc rezultatul principal și nu devin dovezi despre comentarii actuale ale brandurilor. Verificarea anului privește intervalul de date înregistrat; niciuna dintre verificări nu elimină necesitatea de a interpreta rezultatele ca evaluări subiective ale unor fragmente istorice selectate.
Cum s-au comparat cele 2 verificări prestabilite
Fiecare rând folosește exact 10 evaluări complete pentru fiecare fragment. Eșantionul îmbogățit cu material din jurul blocărilor are un scop separat de eșantionare. Excluderea anului 2016 abordează o diferență între intervalul de ani publicat și descrierile sursei.
| Comparație prestabilită | Fragmente eligibile | Fragmente cu ambele etichete undeva în evaluări | Cu o pereche de la același evaluator | Numai de la evaluatori diferiți | Procentul fragmentelor cu etichete numai de la evaluatori diferiți, dintre cele cu ambele etichete |
|---|---|---|---|---|---|
| Eșantion aleatoriu, exact 10 evaluări | 13.824 | 155 | 98 | 57 | 36,8 % |
| Eșantion îmbogățit cu material din jurul blocărilor, păstrat separat | 42.383 | 2.457 | 1.354 | 1.103 | 44,9 % |
| Eșantion aleatoriu fără anul 2016 | 13.809 | 155 | 98 | 57 | 36,8 % |
Cum am urmărit etichetele până la evaluările individuale
Am folosit versiunea 6 a Wikipedia Talk Labels: Personal Attacks, un set de date public din proiectul Wikipedia Detox. Fișierele publicate conțin text derivat din revizii istorice ale paginilor de discuții și mai multe evaluări prin crowdsourcing pentru fiecare fragment. Analiza a folosit răspunsurile individuale; nu a creat evaluări noi și nu a evaluat un sistem de moderare.[1][2]
Comparația noastră principală a pornit de la grupul aleatoriu al ediției publicate și a păstrat fragmentele cu exact 10 evaluări distincte și complete. Menținerea numărului la 10 a oferit fiecărui fragment același număr de ocazii de a primi o selecție în pereche. A selectat totodată 13.824 dintre cele 37.492 de fragmente din eșantionul aleatoriu publicat, deci rezultatul nu descrie întregul grup.[3]
Fiecare fragment selectat a fost numărat 1 dată. Am verificat dacă oricare etichetă apărea undeva, apoi dacă ambele apăreau în răspunsul unei singure persoane la același fragment. Cele 5 categorii se exclud reciproc și însumează 13.824. Numitorul de 155 de fragmente provine din cele 2 categorii cu ambele etichete, nu din toate evaluările sau toate fragmentele sursă.[4]
Înainte să examinăm perechile, am fixat grupurile de eșantionare, regula de acoperire, verificarea anului și un minimum de 100 de fragmente în comparația condiționată principală. Cele 155 observate au îndeplinit cerința. Nu am stabilit un procent necesar, nu am schimbat regula ca să favorizăm un rezultat și nu am combinat materialul din jurul blocărilor cu grupul aleatoriu.
Cercetarea originală folosea deja evaluări individuale, iar lucrări ulterioare au agregat separat fiecare câmp de atac prin majoritate. Contribuția noastră mai restrânsă este această comparație descriptivă a persoanelor care au furnizat cele 2 opțiuni într-un set fix de evaluări. Nu este o corectare a metodelor acelor studii. Fișierele de descărcat oferă rezultate agregate, metode și instrucțiuni de reproducere folosind fișierele sursă publice disponibile separat.[6][7]
Fă următoarea evaluare mai ușor de urmărit
Întrebarea utilă când predai un caz de moderare pe rețelele sociale este cine a făcut fiecare observație și ce descria. În această comparație pe material de arhivă selectat, 57 din 155 de fragmente cu ambele etichete nu aveau niciun evaluator individual care să fi selectat perechea. Relația s-ar pierde într-o sinteză care conține doar cele 2 denumiri de etichete.
Păstrează legate observațiile persoanei, contextul relevant și decizia finală. O afacere sau un creator poate astfel să explice ce conține cazul și cum rezultă acțiunea aleasă din acestea, fără să ceară unei etichete de categorie să țină locul întregii evaluări.
Nu este necesară înregistrarea. Pachetul include rezultate agregate anonime, metode, instrucțiuni de reproducere și fișa reutilizabilă. Nu conține textul original al discuțiilor, ID-uri de revizie, ID-uri ale evaluatorilor sau date demografice. Fișierele sursă publice originale sunt disponibile separat în ediția publicată la care duce linkul.
Surse și note
- Sursă: Wikipedia Talk Labels: Personal Attacks, Figshare versiunea 6, DOI 10.6084/m9.figshare.4054689.v6, publicat în februarie 2017 sub CC0. Am folosit attack_annotated_comments.tsv (fișierul 7554634) și attack_annotations.tsv (fișierul 7554637), cu verificări pe baza sumelor MD5 ale producătorului și a sumelor SHA-256 calculate independent. Influence IQ a finalizat selecția, calculele și interpretarea la 25 octombrie 2026 (UTC). Studiul nu a colectat comentarii noi, nu a creat adnotări noi și nu a măsurat o platformă socială în funcțiune.
- Producătorul definește quoting_attack drept percepția unui evaluator că textul citează/relatează un atac din alt comentariu, iar recipient_attack drept un atac la adresa destinatarului. Interfața permitea alegeri multiple. Atacul în general este un răspuns separat din sursă, nu un OR reconstruit din subtipuri în această analiză. Textul publicat concatenează adăugirile făcute într-o revizie; nu este un rezumat al editării, nu este neapărat o postare întreagă și nu reprezintă o conversație completă. Spațiile de nume pentru discuții, grupurile de eșantionare și subseturile train/dev/test ale modelului își păstrează sensurile documentate.
- Fișierele complete conțineau 115.864 de fragmente unice, 1.365.217 perechi unice revizie/evaluator și 4.053 de evaluatori. Verificarea structurală nu a găsit perechi duplicate, înregistrări asociate fără corespondent, rânduri malformate sau valori lipsă/nevalide ale marcajelor. Eligibilitatea cerea exact 10 evaluări distincte și complete pentru toate cele 5 marcaje sursă, ambele spații de nume pentru discuții documentate și toate subseturile modelului, fiecare fragment fiind numărat 1 dată, cu pondere egală. Grupul aleatoriu principal a păstrat 13.824 din 37.492 de fragmente. Grupul îmbogățit cu material din jurul blocărilor, selectat separat, a păstrat 42.383 din 78.372. Repetarea evaluatorilor în fragmente diferite era legitimă; nu s-a impus unirea textelor identice, eliminarea pe criterii de coerență între marcaje sau recodificarea atacului în general.
- Fie Q selecția de citare/relatare făcută de oricare evaluator și R selecția de atac la adresa destinatarului pentru un fragment eligibil. Pentru prezența ambelor undeva în setul de evaluări, trebuie să existe cel puțin 1 Q și 1 R în cele 10 evaluări. Prezența la același evaluator cere în plus Q și R în 1 răspuns revizie/evaluator; cazurile cu etichete numai la evaluatori diferiți nu conțin niciun astfel de răspuns. Numitorul condiționat principal este 98 + 57 = 155; fracțiile exacte 98/155 și 57/155 sunt afișate ca 63,2 % și 36,8 %. Procentele folosesc aritmetică rațională exactă și rotunjire la 1 zecimală, cu rotunjirea jumătăților în sus. Înainte să calculăm perechile, am cerut cel puțin 100 de fragmente cu ambele etichete pentru comparația condiționată principală, fără un prag procentual favorabil. Nu s-a formulat niciun interval de încredere pentru populație, test de semnificație, afirmație de independență sau estimare a acurateței.
- Verificarea de sensibilitate prestabilită, îmbogățită cu material din jurul blocărilor, a folosit aceeași regulă de exact 10 evaluări și a rămas separată de analiza principală pe eșantionul aleatoriu. Cele 5 efective erau 20.911 fără nicio etichetă dintre cele 2, 959 cu citare/relatare fără atac la adresa destinatarului, 18.056 cu atac la adresa destinatarului fără citare/relatare, 1.354 cu ambele la același evaluator și 1.103 cu ambele numai la evaluatori diferiți; total 42.383, numitor condiționat 2.457. Excluderea anului 2016 din eșantionul aleatoriu principal a lăsat 13.809 fragmente, cu cele 5 efective 12.012 / 406 / 1.236 / 98 / 57 în aceeași ordine. Cele 155 de fragmente din comparația condiționată și împărțirea perechilor 98/57 au rămas neschimbate. Sunt verificări descriptive, nu replicări independente la nivel de populație sau dovezi că grupurile de eșantionare sunt comparabile.
- Lucrarea din 2017 a lui Wulczyn, Thain și Dixon, Ex Machina: Personal Attacks Seen at Scale, a prezentat activitatea de crowdsourcing și modelare de la baza setului de date. Lucrarea WAC din 2020 a lui Cécillon și a colegilor săi a păstrat o matrice evaluator–câmp și a agregat separat câmpurile de atac prin majoritate. Sunt metode existente, nu erori stabilite de acest studiu. Comparația noastră folosește prezența etichetei la oricare dintre cei 10 evaluatori și asocierea în același răspuns, nu performanța etichetelor majoritare. Comparația Influence IQ numără dacă cele 2 opțiuni au fost furnizate de același evaluator sau numai de evaluatori diferiți în fiecare fragment selectat.
- Prezentarea sursei descrie 2001–2015, iar lucrarea originală 2004–2015; fișierele exacte ale versiunii 6 folosite în analiză conțin valori de an 2001–2016. Schema producătorului pentru statutul de autentificare indică 0/1, în timp ce fișierul publicat folosește False/True; șirurile marcajelor binare sunt 0.0/1.0. Am păstrat aceste diferențe documentate/observate fără să le atribuim o cauză. Parserul acceptă exact valorile literale publicate, fără rotunjire sau conversia forțată a valorilor etichetelor. Pachetul documentează versiunile sursă, regulile de selecție și pașii de reproducere a analizei din fișierele publice.
- Cele 2 grupuri de evaluare cu 10 persoane, răspunsurile evaluatorilor A/B și alegerile de predare sunt exemple didactice fictive. Nu conțin text original de discuție sau identificatori din setul de date. Ambele grupuri inventate au 1 selecție de citare/relatare și 1 selecție de atac la adresa destinatarului, dar numai primul are o pereche de la aceeași persoană. Fișa și ilustrațiile conceptuale sunt explicații practice, nu fluxuri de lucru observate în sursă, politici de moderare testate sau garanții ale unor decizii mai bune.
Toate versiunile lingvistice sunt traduse direct din sursa în engleză. Fiecare ediție descrie același set istoric de date Wikipedia în engleză și aceleași evaluări selectate. Traducerea nu produce rezultate despre piața locală. Influence IQ răspunde de analiză, interpretare și traduceri.