Merchandising în comerțul electronic: testează ipotezele despre poziția produselor
Un experiment istoric cu 10 cărți arată cum o ajustare simplă pentru amplasare poate rata părți ale tiparului și cum să testezi această ipoteză înainte de a compara carduri de produs.
Reanaliză originală a experimentului din 2024 despre alegerea cărților, publicat de Compiani, Morozov și Seiler.
Rezumat
Înainte de a decide că o ofertă este mai bună decât alta, o afacere trebuie să țină cont de locul în care a fost afișată fiecare. Am folosit un experiment publicat din 2024, cu 10 cărți electronice, pentru a testa 2 moduri de a ține cont de poziție. O ajustare separată pentru fiecare poziție a prezis alegerile mai bine în ansamblu decât aceeași ajustare pentru fiecare treaptă în josul listei. La unele poziții individuale a fost mai puțin precisă, de aceea contează comparația completă.
Ambele modele au folosit aceleași informații despre cărți și prețuri. Le-am estimat pe datele a 6.176 de participanți și le-am verificat predicțiile pe alți 3.088 de participanți. Alegerile au fost ipotetice și fiecare persoană trebuia să selecteze o carte. Pentru afacerile și creatorii care compară carduri de produs, lecția este să testeze ipotezele despre amplasare înainte de a atribui rezultatele unei oferte. Studiul nu estimează o creștere a vânzărilor și nu identifică ordinea optimă a produselor.
Să presupunem că produsul din partea de sus a unei pagini primește cele mai multe clicuri. Este o ofertă mai bună sau l-a ajutat locul în listă? O afacere are nevoie de un răspuns util înainte de a rescrie celelalte carduri, de a reduce prețul articolelor care par mai slabe sau de a schimba sortimentul.
A ține cont de poziție pare simplu până când întrebi cum. Ar trebui ca fiecare treaptă în josul listei să primească aceeași ajustare? Am folosit un experiment istoric pentru a compara această abordare simplă cu una mai flexibilă, apoi le-am testat pe participanți excluși din estimarea modelelor.
Aceleași produse, poziții diferite
Ce ar trebui să-ți arate o comparație a poziției produselor?
O comparație a cardurilor de produs ar trebui să te ajute să separi articolul oferit de modul în care a fost prezentat. Dacă un produs apare de obicei primul și altul de obicei ultimul, totalurile lor nu arată singure dacă cumpărătorii preferă una dintre oferte.
Abordarea simplă pe care o testăm aplică aceeași ajustare scorului de preferință care stă la baza modelului pentru fiecare treaptă în josul listei. Întrebarea utilă este dacă prezice alegerile suficient de bine în comparație cu o abordare care permite ajustări diferite pentru poziții diferite.
Am testat aceste 2 abordări folosind un experiment publicat despre alegerea cărților. Rezultatul este relevant pentru afacerile și creatorii care compară produse pe o pagină de colecție sau într-o vitrină digitală. Oferă un mod de a examina o ipoteză de măsurare, nu o regulă despre locul în care să pui cel mai vândut articol.
Acest lucru contează când o ofertă apare în mai multe locuri. Un creator ar putea evidenția același material descărcabil într-o colecție și pe o pagină de lansare. Un comerciant ar putea schimba ordinea produselor dintr-o categorie. Articolul, prețul, publicul și prezentarea pot varia împreună. O ajustare pentru poziție este o ipoteză despre o parte a acelei comparații și merită verificată separat.
Ce au ales oamenii în experimentul cu cărți?
Giovanni Compiani, Ilya Morozov și Stephan Seiler le-au cerut unor persoane recrutate prin Prolific să facă alegeri ipotetice dintre 10 cărți electronice, cu ordine și prețuri randomizate. Participanții trebuiau să selecteze o carte; nu exista opțiunea de a nu cumpăra nimic. Folosim prima sarcină din fiecare set de răspunsuri păstrat, nu sarcina ulterioară din care era eliminată cartea aleasă.[1]
Autorii raportează deja răspunsurile la poziție și preț. Cercetarea lor mai amplă studiază cum ajută textul și imaginile la estimarea substituției produselor. Întrebarea noastră este mai restrânsă: înlocuirea unui singur termen pentru poziție îmbunătățește predicțiile pentru participanți ale căror alegeri au fost excluse din estimarea modelului?
Aplicarea regulilor inițiale de eligibilitate păstrează 9.265 de seturi de răspunsuri, cu 9.264 de identificatori distincți de participant Prolific. 1 identificator apare de 2 ori. Păstrăm împreună ambele seturi de răspunsuri și acordăm acelui participant aceeași pondere totală ca fiecărui alt participant. Un set de răspunsuri nu reprezintă automat o persoană distinctă, iar prima sarcină nu este neapărat prima expunere a acelei persoane la experiment.[2][3]
Datele calendaristice păstrate din sursă sunt între 11 iunie și 26 iunie 2024. Manuscrisul descrie intervalul 14–27 iunie, așa că prezentăm diferența și nu excludem înregistrări după dată. Eligibilitatea după țară și vârstă nu a fost stabilită în materialele examinate; acestea nu sunt estimări pentru cumpărătorii din SUA sau pentru o altă populație națională.[1][2]
Datele aceluiași participant rămân împreună pe parcursul comparației
Seturi de răspunsuri pentru prima sarcină, selectate după regulile inițiale de eligibilitate ale autorilor; datele calendaristice din înregistrările sursă păstrate sunt 11–26 iunie 2024.
| Grup | Participanți (după identificatorul platformei) | Seturi de răspunsuri păstrate |
|---|---|---|
| Întregul eșantion păstrat | 9.264 | 9.265 |
| Antrenare | 6.176 | 6.176 |
| Rezervat pentru evaluare | 3.088 | 3.089 |
Care model al poziției a prezis mai bine alegerile grupului rezervat?
Modelul flexibil al poziției a prezis mai bine alegerile grupului rezervat, potrivit măsurii de evaluare prestabilite. Ambele modele țin cont de cartea oferită și de prețul ei afișat. Diferă doar prin modul în care reprezintă poziția.
Modelul de referință folosește 1 singur coeficient, același pentru fiecare treaptă în josul listei. Modelul flexibil folosește ajustări separate pentru pozițiile de la 2 la 10, în raport cu prima. Astfel are mai multă libertate, dar și mai mulți parametri de estimat. O potrivire mai bună pe propriile date de antrenare nu ar fi suficientă, singură, pentru a tranșa comparația.
De aceea am estimat ambele modele folosind 6.176 de participanți și le-am evaluat pe ceilalți 3.088 de participanți. Toate seturile de răspunsuri ale unui participant au rămas de aceeași parte a împărțirii. Grupul de test conține 3.089 de seturi de răspunsuri deoarece îl include pe participantul cu participare repetată.
Pentru a compara predicțiile, am folosit un scor logaritmic negativ. Un model primește o penalizare mai mică atunci când atribuie o probabilitate mai mare alegerii pe care o face efectiv o persoană. Primește o penalizare mai mare când atribuie acelei alegeri o probabilitate foarte mică. Scorurile logaritmice negative medii mai mici sunt mai bune.
Media pentru grupul rezervat a fost 2,2260 pentru modelul de referință și 2,2154 pentru modelul flexibil, în unități de logaritm natural, numite și nat. Acestea sunt scoruri ale predicțiilor, nu procente de răspunsuri corecte. Scorurile de antrenare și de test sunt afișate împreună pentru a nu baza comparația pe sarcina mai ușoară de a descrie date pe care modelul le-a văzut deja.
2 modele, evaluate pe aceiași participanți
Alegeri selectate pentru prima sarcină cu 10 cărți, din 2024. Antrenare: 6.176 de participanți și seturi de răspunsuri. Test: 3.088 de participanți și 3.089 de seturi de răspunsuri.
| Model al poziției | Scor de antrenare (nat) | Scor pentru grupul rezervat (nat) |
|---|---|---|
| 1 termen liniar pentru poziție | 2,2046 | 2,2260 |
| Termeni separați pentru poziții | 2,1899 | 2,2154 |
Îmbunătățirea în comparația pereche a fost de 0,0106 nat per participant, cu un interval aproximativ de 95 % de la 0,0044 la 0,0168. Aici, o îmbunătățire pozitivă favorizează modelul flexibil. Rezultatul este mic pe această scară de evaluare, dar intervalul se află deasupra valorii 0.[4]
Acest interval tratează cele 2 modele estimate ca fixe și presupune grupuri independente de participanți. Nu include incertitudinea estimării modelelor pe un alt eșantion de antrenare. Constatarea susține o îmbunătățire predictivă în această sarcină istorică selectată; nu transformă diferența de scor într-o creștere a vânzărilor.
Modelul flexibil îmbunătățește scorul logaritmic pe grupul rezervat
Comparație pereche între 3.088 de participanți de test din sarcina istorică selectată cu 10 cărți.
| Comparație | Îmbunătățire (nat) | Interval de 95 %: limita inferioară (nat) | Interval de 95 %: limita superioară (nat) |
|---|---|---|---|
| Scorul logaritmic al modelului flexibil minus cel al modelului de referință | 0,0106 | 0,0044 | 0,0168 |
Unde s-au abătut cele 2 modele de la alegerile observate?
Comparația completă a pozițiilor arată de ce scorul general trebuie însoțit de detalii. Pentru fiecare poziție, comparăm ponderea alegerilor observate cu probabilitatea medie atribuită de fiecare model. Sunt medii cu ponderi egale pe participant în grupul rezervat, nu rate de clic.
La poziția 1, ponderea observată a fost 17,16 %. Modelul de referință a prezis 14,64 %, iar modelul flexibil 17,73 %. La poziția 10, ponderea observată a fost 9,18 %, față de predicțiile de 6,37 % și 8,74 %. Modelul flexibil s-a apropiat mai mult la ambele capete ale acestei liste.
Alegeri observate și prezise la toate cele 10 poziții
Grup rezervat: 3.088 de participanți și 3.089 de seturi de răspunsuri pentru prima sarcină din experimentul publicat din 2024.
| Poziție | Ponderea alegerilor observate | Probabilitatea medie a modelului de referință | Probabilitatea medie a modelului flexibil | Seturi de răspunsuri cu alegerea respectivă |
|---|---|---|---|---|
| Poziția 1 | 17,16 % | 14,64 % | 17,73 % | 530 |
| Poziția 2 | 13,60 % | 13,20 % | 14,84 % | 420 |
| Poziția 3 | 9,91 % | 12,06 % | 9,74 % | 306 |
| Poziția 4 | 10,91 % | 11,21 % | 9,26 % | 337 |
| Poziția 5 | 9,20 % | 10,09 % | 8,94 % | 284 |
| Poziția 6 | 7,08 % | 9,25 % | 8,01 % | 219 |
| Poziția 7 | 8,00 % | 8,44 % | 7,57 % | 247 |
| Poziția 8 | 7,12 % | 7,67 % | 7,47 % | 220 |
| Poziția 9 | 7,84 % | 7,08 % | 7,69 % | 242 |
| Poziția 10 | 9,18 % | 6,37 % | 8,74 % | 284 |
Modelul flexibil nu s-a apropiat mai mult peste tot. La poziția 4, ponderea observată a fost 10,91 %. Modelul de referință a prezis 11,21 %, iar modelul flexibil 9,26 %. Flexibilitatea suplimentară a îmbunătățit scorul general pe grupul rezervat, lăsând totuși o discrepanță mai mare la acea poziție.
Tabelul următor arată ponderile observate minus cele prezise. O diferență pozitivă înseamnă că modelul a prezis o pondere prea mică a alegerilor la acea poziție; o diferență negativă înseamnă că a prezis prea mult. Afișarea tuturor celor 10 poziții împiedică un rezultat favorabil de la un capăt al listei să țină locul comparației complete.
Abaterile ambelor modele față de alegerile observate
Ponderea alegerilor observate minus probabilitatea medie prezisă pentru fiecare dintre cele 10 poziții, folosind aceiași 3.088 de participanți de test.
| Poziție | Observat minus modelul de referință | Observat minus modelul flexibil |
|---|---|---|
| Poziția 1 | 2,52 puncte procentuale | -0,57 puncte procentuale |
| Poziția 2 | 0,41 puncte procentuale | -1,24 puncte procentuale |
| Poziția 3 | -2,15 puncte procentuale | 0,17 puncte procentuale |
| Poziția 4 | -0,29 puncte procentuale | 1,65 puncte procentuale |
| Poziția 5 | -0,89 puncte procentuale | 0,26 puncte procentuale |
| Poziția 6 | -2,17 puncte procentuale | -0,93 puncte procentuale |
| Poziția 7 | -0,44 puncte procentuale | 0,43 puncte procentuale |
| Poziția 8 | -0,55 puncte procentuale | -0,35 puncte procentuale |
| Poziția 9 | 0,76 puncte procentuale | 0,14 puncte procentuale |
| Poziția 10 | 2,81 puncte procentuale | 0,44 puncte procentuale |
Aceste rânduri despre poziții sunt descriptive, fără afirmații separate de semnificație statistică. Experimentul nu a măsurat mișcările ochilor sau atenția, iar această analiză nu identifică motivul diferențelor dintre poziții. Un tipar curbat al ponderilor observate nu infirmă nici el, de unul singur, modelul de referință: termenul său pentru poziție este liniar în scorul de preferință care stă la baza modelului, nu în procentele alegerilor.
Simpla scădere a ponderilor observate pentru prima și ultima poziție ar răspunde unei alte întrebări. Acele ponderi rezumă alegeri între produse și prețuri. Ambele modele estimate țin cont de identitatea cărții și de preț înainte de a atribui probabilități celor 10 opțiuni. Nici diferența dintre capete, nici comparația modelelor nu îți spun ce s-ar întâmpla dacă ai muta un anumit produs într-un magazin online în funcțiune.
Un șablon de măsurare a poziției produselor pe care îl poți folosi
Înainte de a compara oferte, scrie un brief scurt de măsurare. Șablonul următor poate fi consultat fără înscriere și are rol ilustrativ. Aplică lecția studiului despre verificarea ipotezelor; nu promite că același model se va potrivi magazinului tău online.
Decizie: „Trebuie să decidem [ce comparație de produse sau modificare de prezentare] pentru [pagină sau campanie], în [perioadă].” Precizează decizia înainte de a alege un indicator favorabil.
Rezultat: „Vom măsura [alegerea, clicul, adăugarea în coș sau cumpărarea].” Alege rezultatul pe care înregistrările tale îl susțin efectiv. Păstrează alături alternativele oferite, ordinea și prețurile lor afișate. Un rezultat dintr-o alegere obligatorie trebuie păstrat separat de un rezultat de cumpărare.
Unitate: „Unitatea noastră este [participantul sau o altă unitate clar definită]. Vizitele sau seturile de răspunsuri repetate vor fi tratate prin [regulă].” Păstrează împreună observațiile aceleiași persoane când evaluezi predicțiile pentru persoane noi. Nu trata identificatorul unei sesiuni anonime ca dovadă a unei persoane unice.
Comparație: „Ambele modele vor folosi aceleași produse, informații despre prețuri și observații eligibile. Vor diferi prin [ipoteza despre poziție].” Specifică atât alternativa simplă, cât și pe cea mai flexibilă.
Evaluare: „Vom rezerva [un grup definit] înainte de estimare și vom compara [o măsură de evaluare numită explicit]. Vom arăta toate pozițiile.” Decide cum vei raporta un rezultat neconcludent sau mai slab înainte de a-l vedea.
Utilizare: „Acest rezultat va ajuta la luarea [deciziei de măsurare]. Mai sunt necesare dovezi despre [rezultatul comercial nemăsurat aici] înainte de [decizia comercială].” Această ultimă propoziție împiedică transformarea neobservată a unui exercițiu de predicție într-o prognoză a veniturilor.
Păstrează același participant de aceeași parte a testului
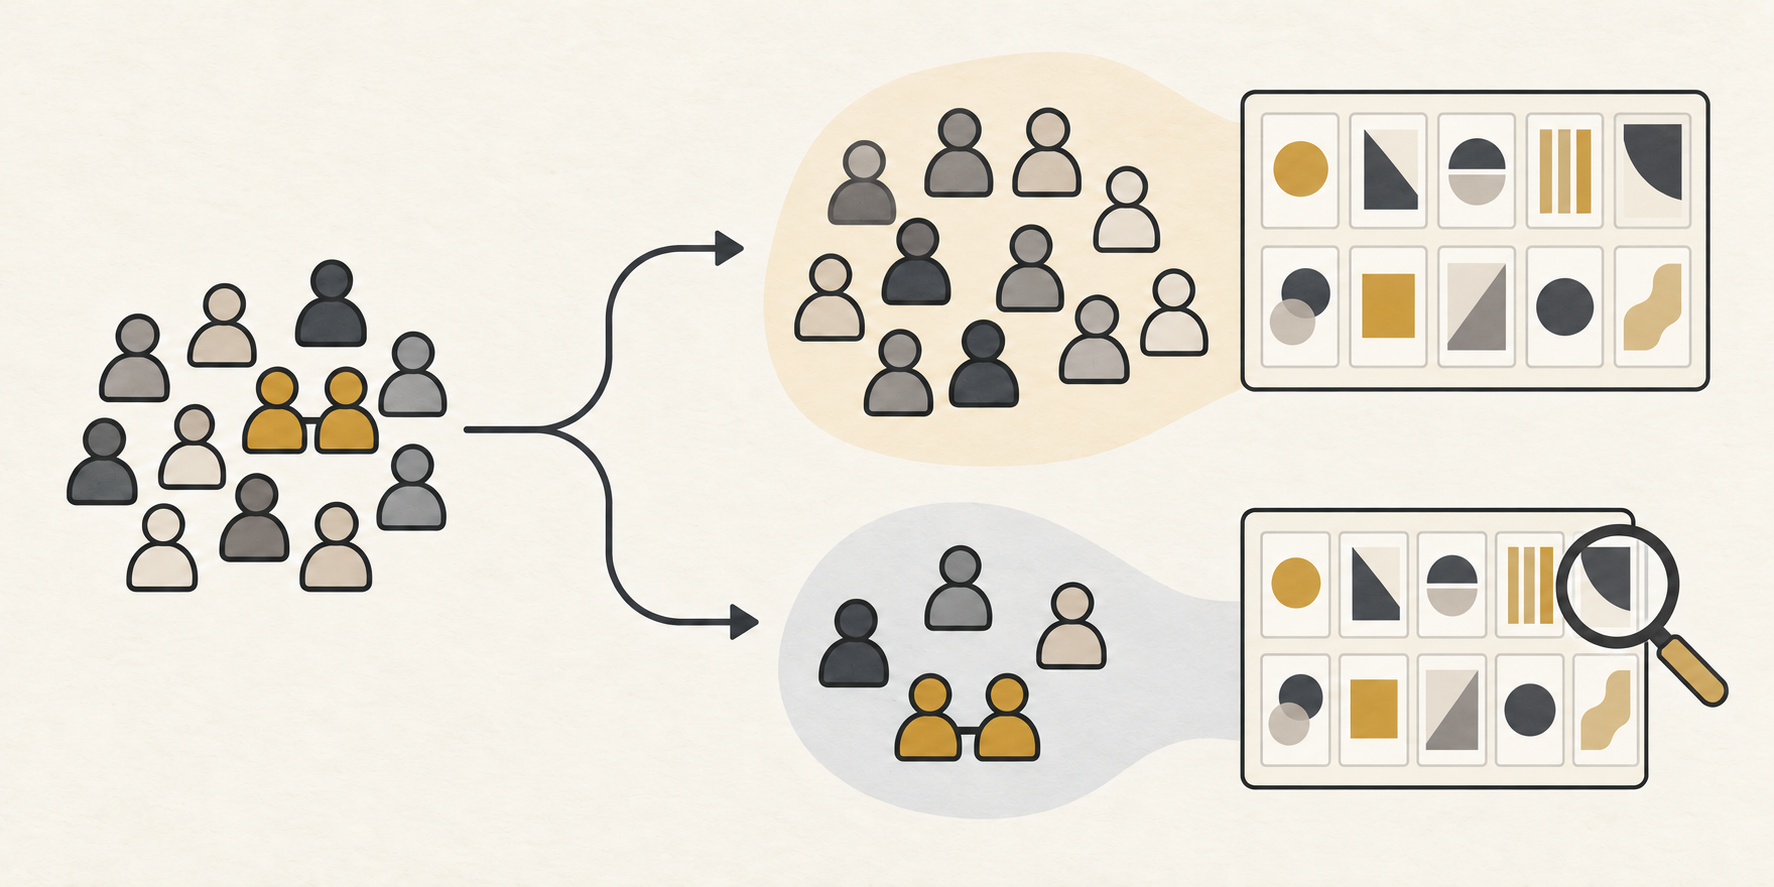
Definește comparația
Precizează produsul, poziția, rezultatul și unitatea de observație.
Rezervă grupul de evaluare
Păstrează împreună seturile de răspunsuri ale fiecărui participant.
Verifică rezultatul complet
Compară predicțiile și arată fiecare poziție, inclusiv rezultatele mai slabe.
Un exemplu explicat: un creator care compară oferte digitale
Să luăm un creator fictiv care vinde un caiet de exerciții de scriere, un atelier și un pachet. Pachetul apare în partea de sus a unei pagini de lansare și primește cele mai multe clicuri. Creatorul se gândește să rescrie descrierile celorlalte produse.
Brieful de măsurare schimbă întrebarea imediată. Rezultatul observat este un clic, nu o vânzare. Înregistrările disponibile trebuie să arate ce oferte au fost afișate, în ce ordine și la ce prețuri. Dacă pachetul ocupă mereu primul loc, acele înregistrări nu pot separa clar pachetul de poziția sa.
Brieful completat al creatorului ar putea spune: „Vrem să știm dacă modul nostru de a ține cont de poziție prezice clicurile vizitatorilor noi. Vom compara aceleași oferte și informații despre prețuri, vom păstra împreună observațiile repetate și vom raporta comparația completă a pozițiilor. Nu vom face nicio afirmație despre cumpărări pe baza înregistrărilor de clicuri.” Acesta este un exemplu fictiv de întrebare de măsurare, nu un rezultat propus.
Un pas următor rezonabil este planificarea unei comparații cu suficientă variație pentru a distinge produsul de poziție, păstrând aceeași definiție a rezultatului. Creatorul ar putea apoi compara o ajustare simplă pentru poziție cu una mai flexibilă pe un grup rezervat. Ar fi un studiu nou al acelei pagini; experimentul cu cărți nu îi oferă o rată de clic așteptată.
Dacă abordarea flexibilă prezice mai bine rezultatele grupului rezervat, creatorul are un motiv să reexamineze felul în care raportul ține cont de amplasare. Acest lucru tot nu arată că mutarea pachetului va crește veniturile. O decizie comercială ar necesita dovezi despre schimbarea efectivă a prezentării și despre rezultatul care contează pentru afacere.
Dacă comparația este neconcludentă, creatorul ar trebui să spună acest lucru. Flexibilitatea suplimentară nu înseamnă automat un instrument mai bun pentru afacere. Câștigul practic este o succesiune mai clară: înțelege ce pot separa înregistrările, testează ipoteza de măsurare, apoi decide dacă este necesar un alt experiment.
Cum a calculat Influence IQ comparația?
Am folosit setul editat de răspunsuri publicat de autori și regulile inițiale de selecție. Primele 553 de înregistrări pilot sau de test sunt excluse pe baza poziției lor fixe în fișier. Cadrul rămas conține 10.775 de seturi de răspunsuri. Filtrele de înțelegere păstrează 9.344; filtrul de finalizare păstrează 9.265.[2]
Consimțământul, starea de finalizare și regula duratei minime de 60 de secunde nu elimină alte seturi de răspunsuri la etapele respective. Finalizarea și durata sunt filtre aplicate după expunere, astfel că grupul păstrat este un eșantion selectat.
Identificatorii participanților Prolific definesc grupurile. O împărțire deterministă bazată pe hash atribuie 2/3 din grupuri antrenării și restul testului, fără să folosească alegerile lor. În fiecare grup, toate seturile de răspunsuri păstrate pentru prima sarcină împart egal contribuția acelui participant. Aceeași ponderare se aplică estimării, evaluării și tabelelor de poziție.[3]
Ambele modele sunt modele logit multinomiale fără penalizare, cu 9 variabile indicatoare pentru cărți și 1 termen liniar pentru preț. Modelul de referință adaugă 1 termen liniar pentru poziție, ajungând la 11 parametri. Modelul flexibil adaugă 9 variabile indicatoare de poziție, ajungând la 19. Poziția 1 și cel mai mic identificator numeric de produs sunt categoriile de referință. Toate seturile de opțiuni eligibile conțin aceleași 10 produse, iar concordanța identificatorului selectat, a prețului și a poziției este verificată.
Estimăm modelele pe grupul de antrenare, păstrăm coeficienții estimați și apoi evaluăm alegerile de test. Intervalul folosește abaterea standard a diferențelor de scor pereche la nivel de participant, 3.088 de unități de participant și 3.087 de grade de libertate. Este un interval Student-t aproximativ, cu excepția situației în care sunt îndeplinite ipotezele exacte de normalitate a scorurilor. Toate cele 10 comparații de poziție rămân descriptive.[4]
Optimizatorul principal al modelului de referință a returnat un avertisment numeric. A îndeplinit totuși fiecare condiție de precizie stabilită înainte de estimare, inclusiv comparația cu o a doua inițializare. Am păstrat acea estimare inițială; diagnosticele detaliate sunt incluse în materialele de reproducere.[5]
Fișierele descărcabile oferă rezultatele afișate, codul original al analizei și rezultatele numerice agregate. Exclud înregistrările sursă cu răspunsuri, identificatorii participanților și materialele grafice ale cărților. Obține datele sursă separat din materialele publicate de autori. Influence IQ răspunde pentru această reanaliză și interpretarea ei.
Fișierul CSV folosește limba acestei pagini. Pachetul conține codul original de calcul, documentația tradusă a metodei și rezultate agregate. Înregistrările sursă cu răspunsuri și materialele grafice ale cărților nu sunt incluse; obține datele separat din materialele publicate de autori.
Surse și note
- Compiani, Morozov și Seiler, Demand Estimation with Text and Image Data, versiunea 4 a manuscrisului, 17 februarie 2026, secțiunea 3 și anexa C. Autorii studiază deja răspunsurile la poziție și preț. Comparația noastră pe participanți rezervați pentru evaluare este o reanaliză originală, cu un scop mai restrâns.
- Materialele DeepLogitReplication publicate de autori, la commitul 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. Respectăm pragul inițial de excludere a înregistrărilor pilot, stabilit după poziția în fișierul editat de răspunsuri, și regulile de eligibilitate ale autorilor. Datele calendaristice păstrate din sursă sunt 11–26 iunie 2024, diferite de intervalul 14–27 iunie descris în manuscris; datele nu determină includerea.
- Prolific distinge identificatorul participantului de cel al studiului sau al unui set de răspunsuri. Păstrăm identificatorii exacți ai participanților pentru grupare. Acești identificatori nu verifică independent că fiecare reprezintă o persoană diferită și nu stabilesc dacă un set de răspunsuri păstrat a fost prima expunere a acelei persoane la experiment.
- Comparația prestabilită de Influence IQ calculează media diferenței dintre log-probabilitatea modelului flexibil și cea a modelului de referință, mai întâi în cadrul fiecărui participant de test, apoi între participanți. Intervalul de 95 % este media plus sau minus valoarea critică Student-t înmulțită cu abaterea standard la nivel de participant, împărțită la rădăcina pătrată din 3.088. Presupune grupuri independente de participanți, este condiționat de estimările fixe din antrenare și exclude incertitudinea estimării pe datele de antrenare; exactitatea cere ca diferențele la nivel de participant să aibă distribuții normale identice, cu varianță comună.
- Estimarea modelului de referință cu inițializare la zero a returnat un avertisment de precizie. Valoarea absolută maximă a gradientului mediu a fost 3,12×10⁻⁹, decrementul Newton 2,50×10⁻⁸, iar diferența maximă de log-probabilitate între 2 inițializări 7,46×10⁻⁸, sub limitele prestabilite de 10⁻⁸, 10⁻⁶ și 10⁻⁷. Ambele modele au îndeplinit și condițiile de curbură pozitivă și de concordanță a funcției obiectiv. Au fost păstrați coeficienții principali obținuți cu inițializare la zero.
Articolul în engleză este versiunea sursă. Versiunile în alte limbi descriu același experiment istoric; nu sunt estimări ale cumpărăturilor specifice unei țări.