Meça os trechos de podcast antes de normalizá-los novamente
Em um estudo de caso com 72 trechos, conferir a exportação existente e corrigir 9 trechos atingiu os mesmos limites de entrega que normalizar todos os 72. Em contrapartida, foram necessárias 9 exportações extras.
Comparamos 72 trechos fixos de 6 programas do HPR publicados entre 8 e 21 de outubro de 2026, depois de normalizar cada episódio completo em laboratório.
Resumo
Um criador deve normalizar novamente cada trecho de podcast depois de masterizar o episódio inteiro? Comparamos 3 fluxos em 72 trechos fixos de 15, 30 e 60 segundos de 6 programas publicados do HPR. Reutilizar o arquivo-mestre do episódio produziu 63 exportações claramente dentro dos limites de sonoridade e pico verdadeiro, 7 falhas inequívocas e 2 casos no limite.
Tanto a normalização de cada corte quanto a medição das exportações existentes antes de uma correção seletiva produziram 72 arquivos finais dentro dos limites. A correção seletiva exigiu 9 normalizações e 81 exportações; normalizar sempre exigiu 72 normalizações e 72 exportações. Na correção seletiva, a soma das medianas por janela do tempo decorrido de processamento nativo foi de 64,0 segundos, contra 108,6 segundos ao normalizar sempre. Este teste finito sustenta uma decisão de manter ou corrigir a exportação final; não estima a resposta de ouvintes nem o tempo completo de produção de quem edita.
Você terminou um episódio de podcast e preparou seu arquivo-mestre de áudio. Agora alguém da equipe de publicação precisa de trechos curtos. A sonoridade do episódio já foi ajustada, mas os novos arquivos contêm apenas uma pequena parte dele. Cada corte deve passar novamente pela normalização ou algumas exportações podem manter o áudio herdado do arquivo-mestre?
Testamos essa decisão com 3 fluxos reais: reutilizar o arquivo-mestre, normalizar cada corte ou medir cada exportação existente e corrigir apenas as que não atendiam claramente aos limites escolhidos. A comparação incluiu as verificações e exportações de substituição exigidas por cada caminho, por isso evitar uma etapa de normalização, por si só, não contou como economia.
A maioria das exportações deste lote pôde ser mantida. 9 precisaram de correção pela regra escolhida. Conferir primeiro produziu a mesma quantidade de arquivos finais dentro dos limites que normalizar sempre, com menos operações de normalização, mas mais exportações. Para um criador ou uma pequena empresa, é uma escolha sobre como preparar e aprovar os arquivos entregues à próxima pessoa.
Um episódio completo vira vários arquivos mais curtos
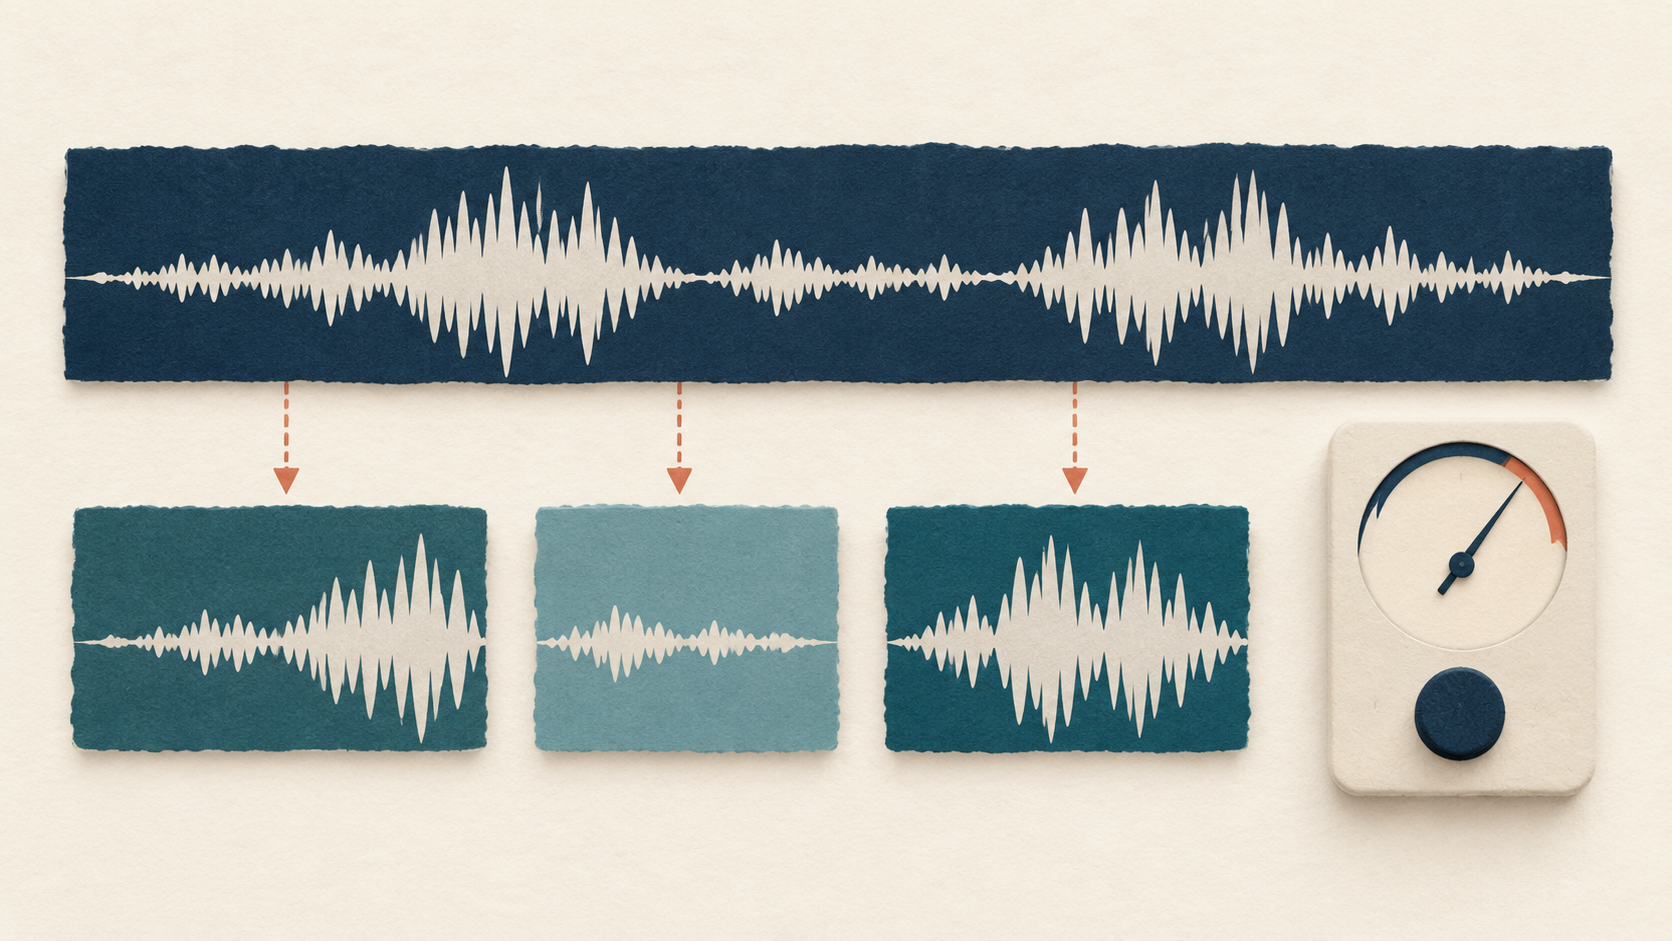
A exportação pronta foi o ponto de decisão
Um episódio pode atingir uma meta geral de sonoridade enquanto um trecho curto fica fora dela. A sonoridade integrada resume o áudio durante o intervalo medido. Mudar esse intervalo muda o que é resumido. Uma conversa baixa, uma passagem mais alta ou uma pausa pode ocupar uma proporção diferente em um trecho curto e no episódio inteiro.
Usamos 2 medidas de entrega. A sonoridade integrada, apresentada aqui em LUFS, descreve o nível ao longo do trecho segundo as regras de ponderação e aplicação de limiares do medidor. O pico verdadeiro estima picos entre amostras digitais. Passar em uma verificação não estabelece que a outra também passou, e nenhuma delas é uma avaliação auditiva da clareza da fala, do ruído ou da qualidade da edição.
Nossa referência foi a recomendação da Apple para podcasts: sonoridade geral próxima de −16, com tolerância de ±1, e pico verdadeiro de no máximo −1. A Apple expressa a recomendação de sonoridade em LKFS; nosso medidor do FFmpeg informa LUFS. Testamos um intervalo de entrega de −17 a −15 LUFS e um teto de pico verdadeiro de −1 dBTP. São os limites escolhidos para esta comparação, não uma exigência de todas as plataformas sociais.[3]
O processador do episódio completo tinha como metas −16 LUFS e −1,5 dBTP. Depois, fizemos os mesmos cortes fixos desse arquivo-mestre de episódio para os 3 fluxos. Cada arquivo final era AAC estéreo a 192 kbps e 48 kHz em um contêiner M4A. Medimos a exportação decodificada, por isso o resultado descreve o arquivo produzido pelo fluxo, e não apenas o áudio que entra no codificador.
O fluxo de reutilização exportou cada corte e o conferiu. O fluxo de normalizar sempre normalizou cada corte antes de exportar e conferir. O fluxo de medir e depois corrigir começou pela exportação de reutilização, manteve-a quando passou e a corrigiu nos outros casos. Portanto, os 3 incluíram uma verificação final de entrega.
O resultado final de entrega para as mesmas 72 janelas
Cada fluxo usou todas as 72 janelas fixas dos mesmos arquivos-mestres de episódios. As contagens descrevem janelas distintas; as repetições para medir o tempo não são trechos adicionais.
| Fluxo | Aprovações inequívocas | Falhas inequívocas | Casos no limite |
|---|---|---|---|
| Reutilizar o arquivo-mestre | 63 | 7 | 2 |
| Normalizar cada corte | 72 | 0 | 0 |
| Medir e depois corrigir | 72 | 0 | 0 |
9 correções substituíram 72 normalizações
Das 72 exportações feitas diretamente dos arquivos-mestres dos episódios, 63 ficaram claramente dentro dos dois limites de entrega. Outras 7 ficaram claramente fora de pelo menos 1 limite. As 2 restantes estavam próximas demais de um limite para a precisão exibida pelo medidor estabelecer uma aprovação ou falha inequívoca. Mantivemos essa terceira categoria visível, em vez de tratar esses arquivos como falhas confirmadas.
O fluxo seletivo corrigiu tanto as 7 falhas inequívocas quanto os 2 casos no limite. Todas as suas 72 exportações finais atenderam à regra conservadora de aprovação. Normalizar cada corte também produziu 72 exportações finais que atendiam a essa regra. A diferença foi quanto áudio cada fluxo processou novamente: 9 cortes no seletivo, contra todos os 72 no de normalizar sempre.
Essa economia veio com exportações extras. A correção seletiva primeiro produziu 72 arquivos e depois substituiu 9 deles, totalizando 81 exportações. Normalizar sempre produziu 72 exportações. Um criador que decide entre os dois precisa dos dois números. Menos operações de normalização não significam automaticamente menos arquivos gravados ou menos processamento total.
Para cada correção, voltamos ao corte original sem perdas do arquivo-mestre do episódio. Medimos esse corte para normalização, aplicamos a segunda passagem, exportamos um arquivo AAC de substituição e o conferimos. Não normalizamos um arquivo AAC já codificado nem usamos suas medidas para definir o ganho de outra entrada PCM.
Conferir primeiro ainda tinha um custo de processamento
O fluxo seletivo usou menos tempo medido de processamento que normalizar cada trecho, mesmo incluindo suas exportações e verificações extras. As somas das medianas por janela do tempo decorrido foram de 52,3 segundos para reutilização, 108,6 para normalizar sempre e 64,0 para medir e depois corrigir. O tempo de CPU seguiu a mesma ordem: 56,3, 120,1 e 69,3 segundos, respectivamente.
Esses totais incluem os processos exigidos do FFmpeg e do ffprobe em cada fluxo: exportar, ler propriedades dos arquivos, decodificar para verificações de qualidade, analisar o PCM para normalização e fazer qualquer exportação de substituição. No fluxo seletivo, a primeira exportação e sua verificação foram contabilizadas mesmo quando o arquivo precisou de correção depois. A segunda exportação e sua verificação também foram contabilizadas.
Cada janela passou por cada fluxo 3 vezes, com alternância da ordem de execução. Calculamos a mediana do tempo de processamento de cada janela e depois somamos essas 72 medianas. Portanto, a tabela mostra uma soma de medianas por janela, não o tempo decorrido de 1 lote de produção observado. As 648 execuções são repetições de medição de tempo das mesmas 72 janelas em 3 fluxos, não 648 trechos diferentes.
As medidas vieram de 1 computador Apple M4 usando 1 processo de trabalho. Cobrem o processamento nativo do FFmpeg e do ffprobe, incluindo a inicialização dos processos. Excluem o cálculo de hashes e a serialização em Python, a preparação compartilhada dos arquivos-mestres dos episódios completos e dos cortes, além de qualquer tempo gasto por uma pessoa para escolher, revisar ou repassar os trechos. Não são estimativas do tempo completo de trabalho de quem edita.
Esse escopo muda a escolha prática. Uma equipe cujo sistema de exportação já mede os arquivos finais pode usar o resultado para decidir quais cortes precisam de outra passagem de normalização. Uma equipe que precisa abrir outra ferramenta e gerenciar as substituições manualmente pode enfrentar uma escolha diferente. Nossos totais de processamento não atribuem um custo a esse trabalho manual nem estabelecem como outro editor ou dispositivo vai se sair.
A correção seletiva usou menos normalizações e mais exportações
Operações reais para 1 conjunto de 72 janelas; as colunas de tempo somam a mediana de cada janela em 3 execuções em um Apple M4, usando 1 processo de trabalho.
| Fluxo | Operações de normalização | Exportações AAC | Tempo decorrido de processamento nativo (segundos) | Tempo de CPU do processamento nativo (segundos) |
|---|---|---|---|---|
| Reutilizar o arquivo-mestre | 0 | 72 | 52,3 | 56,3 |
| Normalizar cada corte | 72 | 72 | 108,6 | 120,1 |
| Medir e depois corrigir | 9 | 81 | 64,0 | 69,3 |
Os trechos de 15 segundos precisaram de mais correções neste lote
Cada duração teve o mesmo denominador: 24 janelas, extraídas de 4 posições em cada um dos 6 programas. Na reutilização, foram aprovados 19 trechos de 15 segundos, 22 de 30 segundos e 22 de 60 segundos. As quantidades correspondentes enviadas para correção foram 5, 2 e 2.
O motivo da correção foi diferente na duração maior. Todos os 5 casos de 15 segundos e os 2 de 30 segundos foram falhas inequívocas segundo os limites escolhidos. Os 2 casos restantes de 60 segundos estavam no limite. Tratá-los como candidatos à correção foi uma escolha de fluxo feita antes dos resultados, não uma evidência de que ambos estavam definitivamente fora do intervalo de entrega.
Os trechos foram aninhados em torno dos mesmos centros. Um corte de 15 segundos ficava dentro de um de 30 segundos, que ficava dentro de um de 60 segundos. São extrações relacionadas dos mesmos programas. A tabela descreve este lote; não estabelece uma probabilidade geral de que um trecho de podcast de 15 segundos precisará de correção.
Todas as 9 correções se concentraram em 2 programas: 4 em HPR Beer Garden 22 - Bitter e 5 na apresentação de murph na conferência. Cada um dos outros 4 programas forneceu 12 trechos aprovados na reutilização. Essa concentração torna uma única porcentagem geral uma promessa pouco confiável para o próximo episódio. Uma equipe pode encontrar um lote sem correções ou outro com várias, mesmo usando as mesmas configurações de exportação.
5 dos 24 trechos mais curtos foram enviados para correção
Cada duração inclui 4 centros fixos de cada um dos 6 programas. As janelas mais longas envolvem os mesmos centros, portanto são extrações relacionadas.
| Duração do trecho | Janelas testadas | Aprovações inequívocas na reutilização | Enviados para correção |
|---|---|---|---|
| 15 segundos | 24 | 19 | 5 |
| 30 segundos | 24 | 22 | 2 |
| 60 segundos | 24 | 22 | 2 |
1 episódio de apresentação mostra o repasse dos arquivos
O episódio publicado “murph gives a presentation talk about Hacker Public Radio at the OLF conference” forneceu 12 cortes fixos. O HPR o publicou em 15 de outubro de 2026; sua página descreve uma apresentação em conferência feita em dezembro de 2025. Usamos o arquivo completo do podcast publicado, incluindo a identidade de marca, e depois preparamos o arquivo-mestre do episódio inteiro usado neste teste.[6]
Para esses 12 cortes, o fluxo de reutilização produziu 7 aprovações inequívocas, 4 falhas inequívocas e 1 caso no limite. Pela regra seletiva, os 7 arquivos aprovados foram mantidos. Os outros 5 cortes voltaram à fonte sem perdas para normalização e uma exportação de substituição. O conjunto final de entrega continha 12 arquivos aprovados, obtidos com 5 operações de normalização e 17 exportações.
Normalizar sempre os mesmos 12 cortes também produziu 12 arquivos aprovados, com 12 operações de normalização e 12 exportações. O caminho seletivo, portanto, evitou processar 7 cortes novamente, mas fez 5 exportações adicionais. Este episódio dá um exemplo concreto da troca mostrada nos resultados do lote completo, sem supor que a contagem de normalizações, sozinha, mede o trabalho.
Para um criador ou uma empresa que repassa esse conjunto a alguém da equipe de publicação, uma nota de conclusão útil identificaria os 12 arquivos finais, os limites de entrega usados e quais 5 arquivos substituíram uma exportação anterior. Uma pasta com as versões originais e corrigidas, sem uma seleção final clara, cria um problema separado de repasse que as medidas de sonoridade não resolvem.
Essas contagens se referem às nossas versões de laboratório do episódio. Não são uma avaliação de quem apresenta, da produção original nem de sua adequação aos ouvintes. Não escolhemos os cortes pelo que foi dito nem por como soavam. Suas posições foram fixadas antes de medir qualquer resultado de sonoridade.
Confira o arquivo que a outra pessoa vai publicar
Para um episódio já masterizado, a primeira decisão é a especificação de entrega dos trechos. Combine o intervalo de sonoridade, o teto de pico, o formato de arquivo e o destino pretendido antes de interpretar uma indicação de aprovação. Se um cliente ou uma plataforma usa outra especificação, essas contagens não se aplicam a ela sem mudanças.
Depois, decida se vai manter ou corrigir o arquivo exportado. No fluxo seletivo testado, quem edita podia manter qualquer arquivo que atendesse claramente aos dois limites. Uma falha inequívoca ou um resultado próximo demais do limite acionava a correção a partir do corte original sem perdas, seguida de uma exportação de substituição e outra verificação. Essa regra especifica o que fazer com um resultado incerto, em vez de deixá-lo a cargo de uma aprovação sem explicação.
A verificação final deve vir depois da última mudança que afeta o áudio entregue. Adicionar uma introdução, música, um fade ou uma nova edição produz um arquivo diferente do medido aqui. Um resultado associado a uma versão anterior não deve acompanhar a nova como se descrevesse essa exportação posterior. Mantenha a medida junto do arquivo realmente selecionado para entrega.
Mantenha a nota de entrega específica o suficiente para a próxima pessoa usar: o arquivo selecionado, os valores de sonoridade e pico, os limites aplicados e o status resultante. Uma nota que diz apenas “normalizado” nomeia uma etapa de processamento. Ela não informa à equipe de publicação se o arquivo final codificado foi medido nem se atendeu aos limites combinados.
A escolha entre o processamento seletivo e a normalização de todos os cortes também depende do repasse. A correção seletiva foi útil aqui porque a maioria das exportações existentes pôde ser mantida e só 9 precisaram de substituição. Normalizar sempre deu a cada corte um caminho mais simples, com uma única exportação. Ambos atingiram o mesmo resultado medido de entrega neste lote, organizando o processamento de formas diferentes.
Uma equipe pequena pode escolher o caminho que suas ferramentas permitem executar com clareza. As evidências favorecem medir antes de decidir que todos os cortes precisam de outra passagem de normalização. Elas não estabelecem que uma pessoa deva passar vários minutos gerenciando arquivos para economizar alguns segundos de processamento nativo. Mantenha a troca técnica medida separada do trabalho editorial que ainda precisa ser feito.
3 caminhos de um corte de episódio até uma exportação conferida
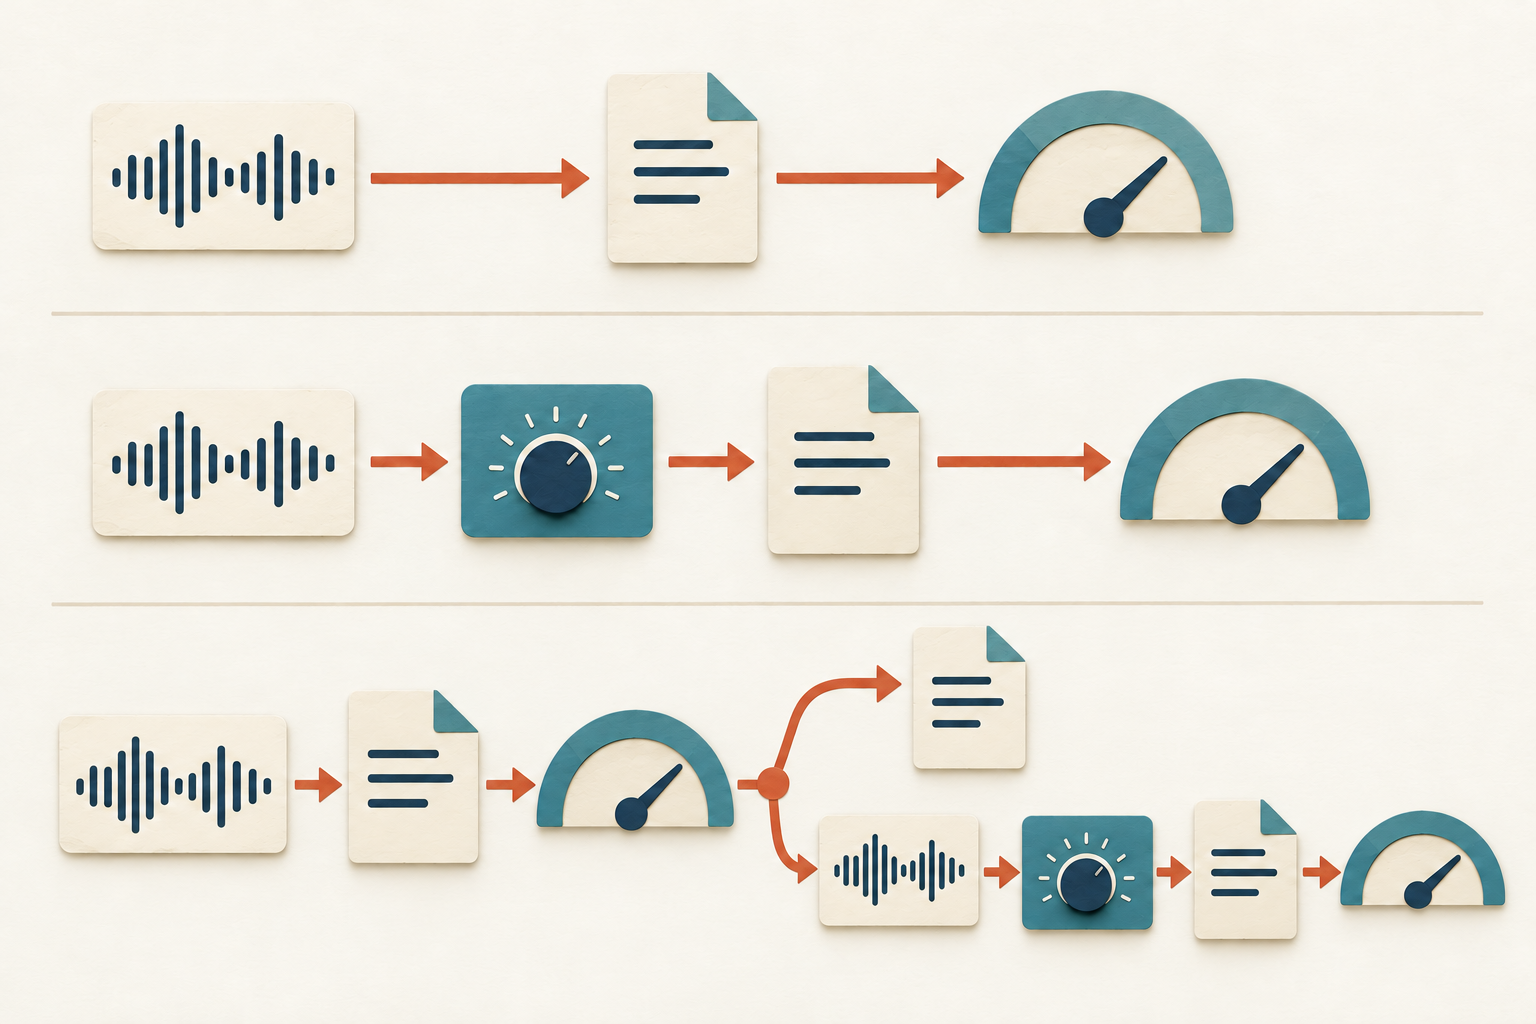
Reutilizar o arquivo-mestre
Exporte o corte original e depois meça o arquivo final.
Normalizar cada corte
Meça o corte PCM, normalize, exporte e confira o arquivo final.
Medir e depois corrigir
Confira a exportação existente. Mantenha os arquivos claramente aprovados; nos outros casos, volte ao corte PCM original, normalize, exporte novamente e confira de novo.
Como comparamos os 72 trechos
Selecionamos os 6 programas completos mais recentes do HPR publicados estritamente antes de 23 de outubro de 2026 cujas durações nas páginas do produtor estavam entre 20 e 60 minutos. Suas datas de publicação foram de 8 a 21 de outubro. A elegibilidade foi fixada pelos metadados antes dos resultados de áudio. Mantivemos os arquivos completos publicados com a identidade de marca e registramos suas durações reais decodificadas separadamente das durações informadas nas páginas.[1][2]
Este é um estudo de caso de 1 podcast comunitário de tecnologia, não uma amostra representativa de podcasts ou criadores. 2 programas selecionados eram painéis consecutivos do Beer Garden, com participantes recorrentes. As fontes publicadas já haviam passado por uma produção cujos detalhes não reconstruímos. Nossa normalização do episódio inteiro foi uma etapa adicional de laboratório, não uma simulação de gravações brutas de microfone.
Preparamos cada episódio completo com loudnorm em 2 passagens no FFmpeg 8.1.2, com metas de −16 LUFS e −1,5 dBTP, e depois mantivemos um arquivo-mestre PCM estéreo de 48 kHz. O LRA foi definido como 50 para que a configuração padrão de 7 LU não impusesse essa meta separada; a faixa de sonoridade não foi um resultado avaliado nos trechos curtos. O modo real de normalização, linear ou dinâmico, foi mantido nos registros das operações.[4]
Para cada programa, posicionamos os centros dos trechos exatamente em 20%, 40%, 60% e 80% da contagem de amostras decodificadas. Em cada centro, cortamos janelas aninhadas de 15, 30 e 60 segundos, resultando em 12 janelas por programa e 72 no total. Todos os fluxos usaram esses mesmos cortes dos mesmos arquivos-mestres. As posições não foram selecionadas por quem falava, pelo conteúdo, pelo silêncio nem pela sonoridade medida.
As classificações finais usaram o medidor nativo ebur128 no áudio de apresentação AAC decodificado. Levamos em conta o priming e o preenchimento no final do AAC para que cada medida cobrisse a quantidade pretendida de amostras. O resumo final do medidor exibe a sonoridade integrada e o pico verdadeiro com precisão de exibição de 0,1. Consideramos esse arredondamento tratando cada valor como um intervalo que se estende 0,05 em cada direção; isso é uma margem para arredondamento, não uma afirmação sobre a exatidão da medição.[5]
Para passar, todo o intervalo de arredondamento da sonoridade precisava estar entre −17 e −15 LUFS, e o extremo superior do intervalo de pico não podia superar −1 dBTP. Uma falha inequívoca ficava claramente fora de pelo menos 1 limite; os casos restantes foram classificados como no limite e corrigidos pelo fluxo seletivo. O download compartilhado fornece os resultados técnicos por janela, as definições de processamento, o código de cálculo e a reconciliação dos medidores. Nenhum áudio da fonte nem derivado é redistribuído.[7]
- Baixe os resultados exibidos (CSV)
- Baixe os resultados técnicos, as definições e o código de cálculo (ZIP)
Não é preciso se cadastrar. O ZIP compartilhado contém medidas técnicas, instruções originais de cálculo em inglês e explicações traduzidas. O texto do artigo, os rótulos das figuras e o CSV dos resultados exibidos estão disponíveis em todos os idiomas do artigo. O pacote reproduz os cálculos relatados a partir das medidas fornecidas, em vez de executar novamente todo o processamento de áudio. Não inclui áudio da fonte nem derivado.
Fontes e notas
- Arquivo de episódios do Hacker Public Radio. Programas selecionados: hpr4753, HPR Beer Garden 22 - Bitter, Kevie, 21 de outubro; hpr4749, apresentação de murph na OLF, murph, 15 de outubro; hpr4748, Programmable Logic Controls - Episode 5, Whiskeyjack, 14 de outubro; hpr4747, UNIX Curio #13 - Replacements for cat, Vance, 13 de outubro; hpr4745, BruCON interview 1: The BruCON organization, Kristoff, 9 de outubro; hpr4744, HPR Beer Garden 21 - Mild, Kevie, 8 de outubro. Todas as datas são de 2026. Os links dos episódios e os identificadores dos arquivos estão incluídos no pacote de análise.
- Política de contribuição do Hacker Public Radio. O produtor descreve suas transformações de publicação, incluindo conversão de formato e introdução/encerramento automáticos, e especifica a licença Creative Commons Attribution-ShareAlike 4.0 para os programas. Este estudo analisa os arquivos completos publicados. Não redistribui esses arquivos nem os trechos derivados.
- Apple Podcasts for Creators, Audio requirements, Audio levels. Recomenda sonoridade geral em torno de −16 dB LKFS com tolerância de ±1 dB e pico verdadeiro de no máximo −1 dB FS, com pré-condicionamento antes da codificação. Essa é a referência de podcast usada aqui, não uma especificação universal de entrega para plataformas sociais.
- Documentação dos filtros do FFmpeg 8.1.2, loudnorm. Descreve a normalização em 1 ou 2 passagens e nos modos linear ou dinâmico. O experimento usou o FFmpeg 8.1.2 nativo, com as configurações e os modos reais das operações mantidos no pacote.
- Código-fonte do ebur128 no FFmpeg 8.1.2, formatação do resumo final. A sonoridade integrada e o pico verdadeiro são exibidos com 1 casa decimal. A regra conservadora de 3 categorias do estudo lida com essa precisão de exibição; não é uma afirmação de exatidão de um medidor certificado. As classificações finais de entrega são separadas das estatísticas de entrada e saída do próprio normalizador.
- Episódio hpr4749 do HPR, murph gives a presentation talk about Hacker Public Radio at the OLF conference. Apresentador: murph; publicado em 15 de outubro de 2026. A página da fonte informa que a apresentação ocorreu em dezembro de 2025. O título do episódio e a data de publicação identificam a fonte, não constituem uma avaliação da produção de áudio original.
- Pacote de cálculo do Influence IQ. Contém medidas técnicas agregadas e por janela, atribuição das fontes, regras fixas de seleção e janelas, definições do tempo de processamento nativo, código de cálculo e reconciliação dos medidores. Reproduz os cálculos relatados a partir das medidas fornecidas; não é um pacote portátil para executar novamente todo o processamento de áudio. Não inclui áudio bruto ou derivado, texto da fala nem registros operacionais privados.
As edições em todos os idiomas descrevem o mesmo estudo de caso de 6 programas do HPR. A tradução não cria resultados para outro país, população de podcasts ou plataforma social.