Dois rótulos de moderação podem vir de revisores diferentes
O repasse de um comentário para revisão pode mostrar dois rótulos sem indicar quem os escolheu. Avaliações históricas da Wikipedia revelam por que esse detalhe faz diferença para a próxima pessoa que analisar o caso.
Análise original do Influence IQ de avaliações selecionadas no conjunto histórico de dados de ataques pessoais do projeto Wikipedia Detox. Análise concluída em 25 de outubro de 2026 (UTC).
Resumo
Entre 13.824 trechos históricos selecionados de discussões da Wikipedia, 155 receberam tanto o rótulo de citação/relato quanto o de ataque direcionado ao destinatário em algum ponto das 10 avaliações individuais. Em 98 desses 155 trechos, pelo menos um revisor marcou os dois rótulos. Nos outros 57, ou 36,8%, os rótulos vieram apenas de revisores diferentes. O percentual se refere a esses 155 trechos, não ao total de 13.824.[1][4]
Para empresas e criadores que gerenciam comentários nas redes sociais, a lição prática está no repasse: mantenha as observações de cada revisor vinculadas à avaliação dessa pessoa. Dois rótulos apresentados juntos não demonstram que alguém escolheu ambos. O estudo descreve avaliações subjetivas de trechos históricos de discussões, não erros de moderação nem uma regra para remover comentários. A ficha que pode ser copiada abaixo transforma essa distinção em um registro prático de revisão.
Imagine que um criador peça a um colega que analise um comentário difícil. O caso chega com dois rótulos: alguém está citando ou relatando um ataque e alguém está direcionando um ataque ao destinatário. Antes de decidir o que fazer, o colega precisa de mais uma informação: foi o mesmo revisor que fez as duas observações?
Essa é uma distinção real que um resumo pode perder. Uma pessoa pode ter escolhido as duas opções, ou duas pessoas podem ter se concentrado em aspectos diferentes do mesmo texto. Uma lista de rótulos, por si só, não informa ao próximo revisor qual dessas situações ocorreu. Também pode deixar incerto quais palavras cada pessoa estava descrevendo.
Exploramos essa questão com avaliações individuais de um conjunto de dados consolidado na pesquisa. O material original veio de páginas de discussão da Wikipedia. Aqui, ele serve para tornar visível a relação entre rótulos e revisores e ajudar empresas ou criadores a pensar nas informações que devem preservar ao repassar seus próprios casos.
Mantenha cada observação ligada a quem a fez
Comece pelo que cada rótulo realmente descreve
A primeira opção perguntava se o texto citava ou relatava um ataque pessoal originado em outro comentário. A segunda tratava de um ataque pessoal direcionado ao destinatário. Os revisores podiam marcar mais de uma opção. Eram avaliações do texto apresentado, não decisões de ocultá-lo nem provas de violação de uma política.[2]
Consideramos um rótulo presente quando pelo menos um dos 10 revisores o selecionou. A comparação levou em conta a escolha de qualquer revisor. Não exigimos maioria, não descrevemos os rótulos como consenso nem testamos se estavam corretos.
Dos 13.824 trechos selecionados, 12.025 não tinham nenhum desses dois rótulos. Outros 406 tinham um rótulo de citação/relato sem o de ataque direcionado ao destinatário, enquanto 1.238 tinham o de ataque direcionado ao destinatário sem o de citação/relato. Restaram 155 com os dois rótulos em algum ponto de suas avaliações.
Essas descrições se referem apenas a essas duas opções. Um trecho sem o rótulo de ataque direcionado ao destinatário ainda poderia ter outro tipo de rótulo de ataque. O rótulo de citação/relato não atesta que o texto era inofensivo. Nomes precisos evitam que uma categoria útil se transforme, sem percebermos, em uma conclusão mais ampla.
Como os 13.824 trechos selecionados foram classificados
Um rótulo estava presente se pelo menos um dos 10 revisores o escolheu. Estas cinco categorias tratam de duas opções específicas; “nenhum” não significa que o trecho não tivesse qualquer outro rótulo de ataque.
| Rótulos de citação/relato e de ataque direcionado ao destinatário | Trechos |
|---|---|
| Nenhum desses dois rótulos | 12.025 |
| Citação/relato sem ataque direcionado ao destinatário | 406 |
| Ataque direcionado ao destinatário sem citação/relato | 1.238 |
| Ambos os rótulos, com pelo menos uma dupla escolhida pelo mesmo revisor | 98 |
| Ambos os rótulos, fornecidos apenas por revisores diferentes | 57 |
57 trechos tinham os dois rótulos, mas nenhum revisor escolheu ambos
Nos 155 trechos, verificamos a resposta individual por trás de cada rótulo. Em 98, pelo menos uma pessoa marcou as duas opções para o mesmo trecho. Em 57, as escolhas de citação/relato e de ataque direcionado ao destinatário vieram apenas de pessoas diferentes. Nenhuma resposta individual nesses 57 continha a dupla.
A divisão foi de 63,2% com uma dupla de rótulos escolhida pelo mesmo revisor e 36,8% com rótulos fornecidos apenas por revisores diferentes. Os dois grupos pertenciam ao mesmo conjunto, definido de forma restrita, de 155 trechos. O total maior de 13.824 trechos continua importante porque mostra de onde partiu essa comparação condicional.[4]
A distinção muda o que é possível afirmar a partir de um resumo. Saber que os dois rótulos apareceram permite dizer que cada um foi escolhido em algum ponto do conjunto de avaliações. Isso, por si só, não permite afirmar que um revisor individual descreveu o texto das duas formas.
Nem a escolha dos dois rótulos pelo mesmo revisor resolve o sentido das palavras. Um trecho de origem podia reunir acréscimos feitos em uma revisão da Wikipedia, incluindo mais de uma publicação. A seleção das duas opções por uma pessoa não demonstra que a passagem citada era, ela própria, o ataque direcionado ao destinatário. Não examinamos trechos individuais para explicar suas avaliações.[2][6]
57 dos 155 trechos não tiveram uma dupla escolhida pelo mesmo revisor
Esta comparação inclui apenas os 155 trechos selecionados com os dois rótulos em algum ponto de suas 10 avaliações. Ela considera escolhas de qualquer revisor, não concordância da maioria nem resultados de moderação verificados.
| Quem forneceu os dois rótulos | Trechos | Percentual dos 155 trechos |
|---|---|---|
| Pelo menos um revisor escolheu ambos | 98 | 63,2% |
| Os rótulos vieram apenas de revisores diferentes | 57 | 36,8% |
Passe ao próximo revisor a observação por trás do rótulo
Em uma empresa, o caso pode passar de quem acompanha os comentários para a pessoa responsável pela conta. Para um criador, pode passar de um assistente para o próprio criador. Quem recebe o caso precisa entender o que foi observado antes de decidir se responde, busca mais contexto ou aplica a política vigente da conta.
Mantenha juntas as escolhas de cada pessoa. Se um revisor marcar as duas opções, preserve essa dupla como a avaliação dele. Se dois revisores escolherem opções diferentes, mantenha as respostas separadas. Um caso pode comportar mais de uma leitura sem transformá-las em uma avaliação que ninguém de fato fez.
Depois, acrescente uma breve explicação da passagem relevante. No seu fluxo de trabalho, identifique o que parece estar sendo citado, a quem o texto parece se dirigir e qual resposta ao redor ajuda a entender a troca. Deixe a incerteza visível quando o contexto disponível não responder à pergunta. São sugestões práticas; o conjunto de dados não testou seu efeito sobre as decisões.
Uma nota curta pode bastar. O objetivo é permitir que a próxima pessoa acompanhe o raciocínio da primeira sem reconstruir toda a revisão. Para uma equipe que passa casos entre turnos ou entre uma marca e um criador, isso significa repassar a observação original junto da categoria atribuída a ela.
Um exemplo fictício com totais de rótulos idênticos
Considere dois grupos de revisão inventados, cada um com 10 pessoas avaliando um trecho fictício. Os grupos ilustram a aritmética; não são pessoas, citações nem casos reais do conjunto de dados. Os dois resumos mostram uma seleção de citação/relato e uma de ataque direcionado ao destinatário.[8]
No primeiro grupo, o revisor A marca as duas opções. As outras 9 pessoas não marcam nenhuma dessas duas opções. Há uma pessoa cuja resposta contém a dupla. O repasse pode preservar corretamente a avaliação conjunta dessa pessoa e deixar a ação final para uma decisão separada.
No segundo grupo, o revisor A marca citação/relato e o revisor B marca ataque direcionado ao destinatário. As 8 pessoas restantes não marcam nenhuma opção. Os totais dos campos continuam sendo 1 e 1, mas ninguém escolheu ambos. Chamar isso de avaliação conjunta de uma pessoa acrescentaria uma relação que as respostas individuais não contêm.
O exemplo também explica por que contamos trechos em vez de somar todas as pessoas que atendiam à condição. Se duas pessoas do primeiro grupo tivessem escolhido os dois rótulos, o trecho ainda entraria uma única vez no grupo de escolha pelo mesmo revisor. A classificação verifica se existiu uma dupla assim, não quantas pessoas a forneceram.
No segundo grupo, um breve repasse fictício poderia dizer: “Decisão ainda em aberto. O revisor A identificou citação/relato; o revisor B identificou linguagem direcionada ao destinatário. Mantenha as duas notas junto do trecho e da resposta anterior. A pessoa responsável pela conta verificará a qual passagem cada revisor se referia antes de escolher a ação.” A nota transmite uma questão não resolvida sem reescrever as respostas de duas pessoas como a conclusão de uma só.
Em um repasse real, preserve as duas notas separadas do segundo grupo. O próximo revisor pode lê-las junto do texto, perguntar o que cada pessoa quis dizer e tomar a decisão conforme a política da conta. O estudo não demonstra se algum dos revisores estava certo nem qual ação deveria ser aplicada àquele caso fictício.
Totais iguais de rótulos podem vir de padrões de revisão diferentes
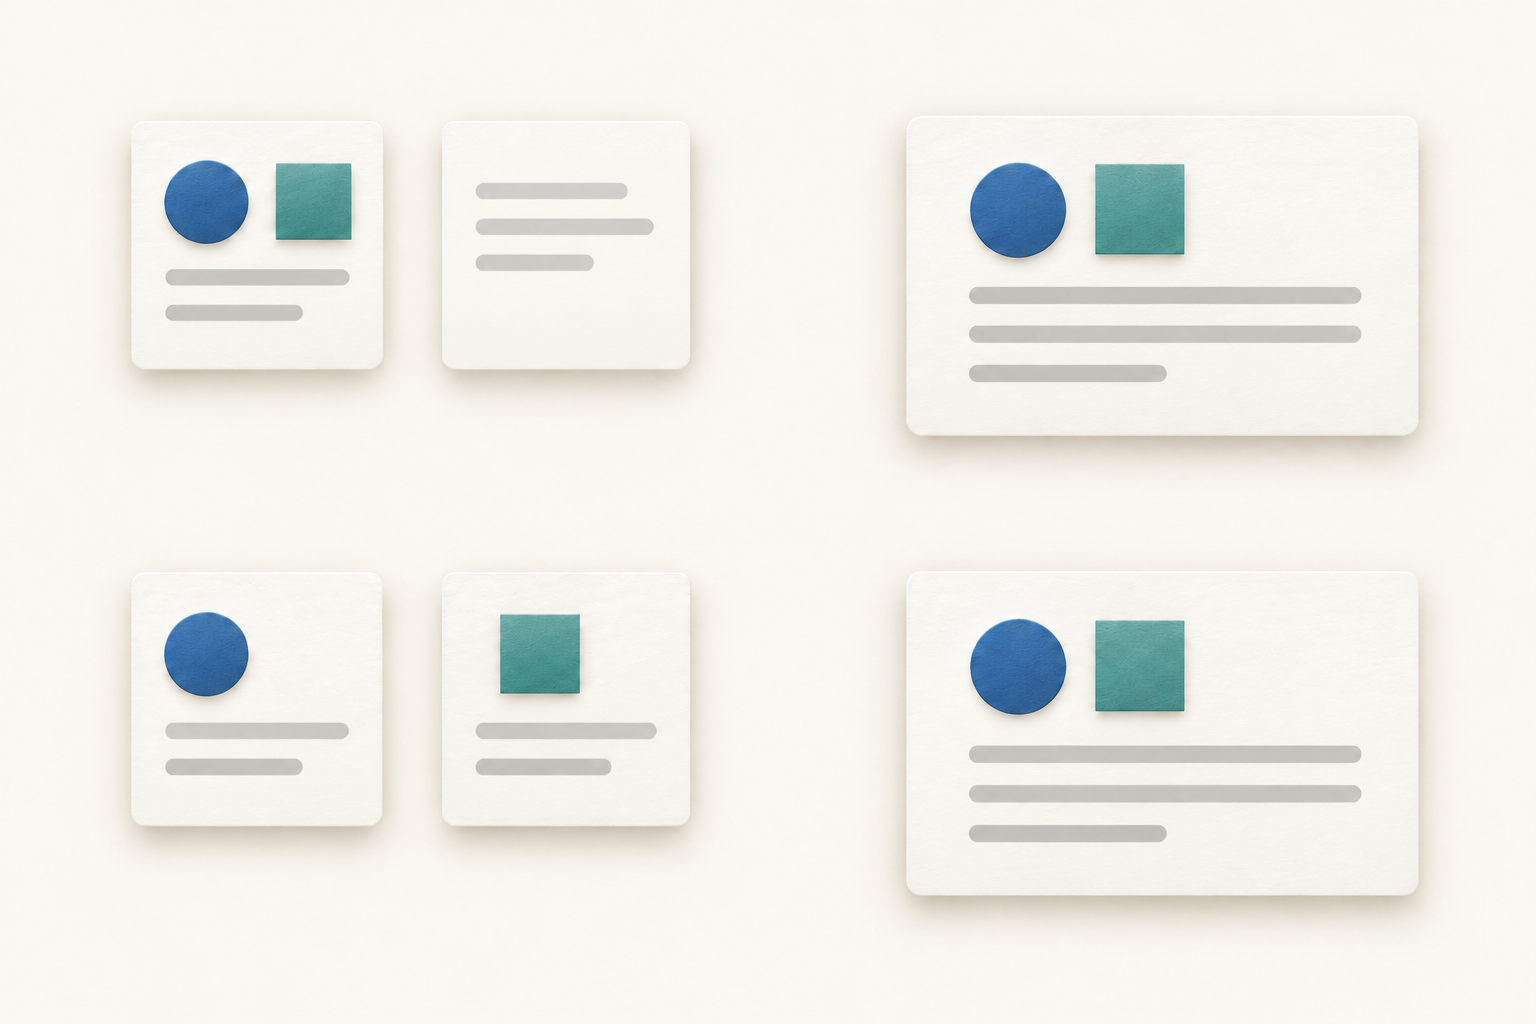
Um revisor marca ambos
O primeiro grupo inventado tem uma pessoa que marca os dois rótulos e 9 que não marcam nenhuma dessas duas opções.
Dois revisores marcam um rótulo cada
No segundo, uma pessoa marca citação/relato e outra marca ataque direcionado ao destinatário. As outras 8 não marcam nenhuma opção.
Separe a decisão de moderação da descrição
Descrever o que aparece em um comentário e decidir o que fazer com ele têm finalidades diferentes. Um revisor pode perceber uma citação enquanto a pessoa responsável pela conta ainda precisa considerar a troca ao redor e a política aplicável. Registre essas etapas separadamente para que alguém possa entender depois como se chegou à decisão.
Se sua empresa trabalha com um criador, defina em conjunto quem tomará essa decisão antes de surgir uma troca difícil. A pessoa que entende uma reclamação sobre o produto pode não ter autorização para mudar a abordagem de moderação da conta. Um repasse claro pode identificar as duas funções sem presumir que todo caso precise de vários revisores.
Se você cria conteúdo e trabalha sem equipe, pode registrar a mesma distinção em uma nota: o que observou, qual contexto verificou e o que decidiu. Uma pessoa pode realizar várias etapas e manter clara a finalidade de cada uma. Os dados não mostram que contratar mais pessoas ou acrescentar outra camada de revisão melhora os resultados.
Mantenha as observações separadas até entender a relação entre elas. Escolhas diferentes podem refletir focos distintos, em vez de relatos contraditórios. Marcar citação/relato não dá isenção automática, e marcar ataque direcionado ao destinatário não é uma recomendação de exclusão medida pelo estudo. A próxima ação útil é a que se apoia na troca real e nas regras da conta, não em uma ação inferida dos percentuais do nosso arquivo histórico.
Uma ficha de revisão de comentários para copiar
Copie estes campos para o documento de revisão ou repasse que você já usa. Inclua apenas as informações necessárias à equipe, com acesso adequado à conversa. A ficha está disponível aqui sem cadastro; é uma orientação prática, não um processo observado no estudo.[8]
Caso: [Link ou referência interna.] Conta/canal: [Onde a troca aparece.] Horário da verificação: [Data e hora.] Preserve a referência para que a próxima pessoa encontre o mesmo material.
Objetivo: [Qual pergunta exige uma decisão?] Responsável: [Quem decidirá?] Próxima pessoa: [Quem precisa receber o caso, se houver alguém?]
Texto apresentado: [A passagem em revisão, mantida no seu espaço de trabalho aprovado.] Contexto ao redor: [Respostas anteriores ou posteriores relevantes.] Contexto ausente: [O que não foi possível verificar.]
Revisor: [Nome ou referência interna do revisor.] Horário da avaliação: [Data e hora.] Mantenha separado o registro de cada pessoa, mesmo quando várias usam os mesmos rótulos.
Observação de citação/relato: [Sim, não ou incerto.] Fundamento: [Qual passagem parece citar ou relatar o ataque de outra pessoa?] Não use este campo para decidir se o texto é inofensivo.
Observação de ataque direcionado ao destinatário: [Sim, não ou incerto.] Fundamento: [Qual passagem parece se dirigir ao destinatário e por quê?] Responda a este campo de forma independente da observação de citação/relato.
Outras observações relevantes: [Qualquer outra questão que a política da conta exija considerar.] A ausência de um dos dois rótulos do estudo não descreve a troca por completo.
Relação entre as revisões: [Uma pessoa marcou ambos, pessoas diferentes marcaram opções distintas ou não está claro.] Se houver diferenças entre revisores, preserve as notas individuais antes de resumir o caso.
Referência da política: [A regra ou orientação aplicável.] Decisão: [A ação de fato escolhida ou a questão ainda não resolvida.] Motivo: [Como a observação e o contexto sustentam essa decisão.]
Acompanhamento: [Quem fará o quê a seguir, se necessário?] Horário do repasse: [Quando o caso passa para essa pessoa.] Resultado: [O que aconteceu após a decisão, se isso foi verificado.] Não registre uma ação planejada como concluída.
Revisar novamente quando: [Um evento específico ou uma informação de contexto ausente, se for necessária outra análise.] A ficha não exige rever todos os casos repetidamente; escolha um motivo adequado à situação.
A verificação por ano manteve os mesmos 155 trechos
Definimos duas verificações complementares antes de calcular as combinações de rótulos. A primeira excluiu trechos datados de 2016 porque o intervalo de anos dos arquivos publicados ultrapassava os períodos descritos na apresentação da fonte e no artigo original. Restaram 13.809 trechos elegíveis da amostra aleatória. Os mesmos 155 tinham os dois rótulos, com a mesma divisão de 98/57.[5]
A outra verificação usou material do conjunto de dados coletado separadamente em torno de eventos de bloqueio. Com a mesma regra de exatamente 10 avaliações, esse grupo continha 42.383 trechos. Dos 2.457 com ambos os rótulos no conjunto de avaliações, 1.354 tinham uma dupla escolhida pelo mesmo revisor e 1.103 tinham rótulos fornecidos apenas por pessoas diferentes: 55,1% e 44,9%, respectivamente.
O grupo com maior presença de eventos de bloqueio tem outra finalidade de amostragem, por isso o mantivemos separado. Seus percentuais não substituem o resultado principal nem se tornam evidência sobre comentários atuais de marcas. A verificação por ano trata do intervalo de datas registrado; nenhuma das duas verificações elimina a necessidade de interpretar os dados como avaliações subjetivas de trechos históricos selecionados.
Como se compararam as duas verificações definidas previamente
Cada linha usa exatamente 10 avaliações completas por trecho. A amostra com maior presença de bloqueios tem uma finalidade de amostragem separada. Excluir 2016 trata da diferença entre o intervalo de anos dos arquivos publicados e as descrições da fonte.
| Comparação definida previamente | Trechos elegíveis | Trechos que receberam os dois rótulos no conjunto de avaliações | Com uma dupla escolhida pelo mesmo revisor | Apenas por revisores diferentes | Percentual dos trechos com ambos os rótulos fornecidos apenas por revisores diferentes |
|---|---|---|---|---|---|
| Amostra aleatória, exatamente 10 avaliações | 13.824 | 155 | 98 | 57 | 36,8% |
| Amostra com maior presença de bloqueios, mantida separada | 42.383 | 2.457 | 1.354 | 1.103 | 44,9% |
| Amostra aleatória sem 2016 | 13.809 | 155 | 98 | 57 | 36,8% |
Como ligamos os rótulos às avaliações individuais
Usamos a versão 6 de Wikipedia Talk Labels: Personal Attacks, um conjunto público de dados do projeto Wikipedia Detox. Os arquivos disponibilizados contêm textos derivados de revisões históricas de páginas de discussão e várias avaliações de colaboradores de uma plataforma de trabalho coletivo para cada trecho. Esta análise usou as respostas individuais; não criou novas avaliações nem avaliou um sistema de moderação.[1][2]
Nossa comparação principal partiu do grupo de amostra aleatória da versão publicada e manteve trechos com exatamente 10 avaliações distintas e completas. Fixar o número em 10 deu a cada trecho a mesma quantidade de oportunidades de receber uma seleção conjunta. Isso também selecionou 13.824 dos 37.492 trechos disponibilizados na amostra aleatória, de modo que o resultado não descreve todo esse grupo.[3]
Cada trecho selecionado contribuiu com uma contagem. Verificamos se algum dos rótulos aparecia em qualquer avaliação e, depois, se ambos apareciam na resposta de uma pessoa ao mesmo trecho. As cinco categorias são mutuamente exclusivas e somam 13.824. O denominador de 155 trechos vem das duas categorias com ambos os rótulos, não do total de avaliações nem de todos os trechos de origem.[4]
Antes de examinar as combinações, fixamos os grupos de amostragem, a regra de cobertura, a verificação por ano e um mínimo de 100 trechos na comparação condicional principal. Os 155 observados atenderam a esse requisito. Não exigimos um percentual específico, não mudamos a regra para favorecer um resultado nem juntamos o material com maior presença de bloqueios ao grupo aleatório.
A pesquisa original já usava avaliações individuais, e trabalhos posteriores agregaram cada campo de ataque por maioria. Nossa contribuição mais restrita é esta comparação descritiva de quem forneceu as duas opções em um conjunto fixo de avaliações. Não se trata de uma correção dos métodos desses estudos. O material para download oferece resultados agregados, métodos e instruções de reprodução com os arquivos públicos de origem, disponíveis separadamente.[6][7]
Facilite a compreensão da próxima revisão
A pergunta útil ao repassar um caso de moderação nas redes sociais é quem fez cada observação e o que estava descrevendo. Nesta comparação de material histórico selecionado, 57 dos 155 trechos com ambos os rótulos não tiveram nenhum revisor individual que marcasse a dupla. Essa relação se perderia em um resumo que trouxesse apenas os nomes dos dois rótulos.
Mantenha conectados as observações da pessoa, o contexto relevante e a decisão final. Assim, uma empresa ou um criador pode explicar o que o caso contém e por que a ação escolhida decorre disso, sem esperar que um rótulo de categoria faça o trabalho de toda a revisão.
Não é necessário cadastro. O pacote inclui resultados agregados anônimos, métodos, instruções de reprodução e a ficha reutilizável. Não contém textos originais das discussões, IDs de revisão, IDs de trabalhadores nem dados demográficos. Os arquivos públicos originais estão disponíveis separadamente na versão vinculada.
Fontes e notas
- Fonte: Wikipedia Talk Labels: Personal Attacks, versão 6 do Figshare, DOI 10.6084/m9.figshare.4054689.v6, disponibilizada em fevereiro de 2017 sob CC0. Usamos attack_annotated_comments.tsv (arquivo 7554634) e attack_annotations.tsv (arquivo 7554637), com verificações de MD5 do produtor e SHA-256 calculado de forma independente. O Influence IQ concluiu a seleção, os cálculos e a interpretação em 25 de outubro de 2026 (UTC). O estudo não coletou novos comentários, não criou novas anotações nem mediu uma plataforma social em funcionamento.
- O produtor define quoting_attack como a percepção de um trabalhador de que há citação/relato de um ataque vindo de outro comentário, e recipient_attack como um ataque direcionado ao destinatário. A interface permitia várias escolhas. Ataque geral é uma resposta de origem separada, não uma operação OR reconstruída a partir dos subtipos nesta análise. O texto disponibilizado concatena acréscimos feitos durante uma revisão; não é um resumo da edição, não corresponde necessariamente a uma publicação inteira nem a uma conversa completa. Os espaços de nomes de discussão, os grupos amostrais e as divisões train/dev/test do modelo mantêm seus significados documentados.
- Os arquivos completos continham 115.864 trechos únicos, 1.365.217 pares únicos de avaliação por revisão/trabalhador e 4.053 trabalhadores. A verificação estrutural não encontrou pares duplicados, vínculos sem correspondência, linhas malformadas nem valores ausentes ou inválidos nos indicadores. A elegibilidade exigiu exatamente 10 avaliações distintas e completas nos 5 indicadores de origem, nos dois espaços de nomes de discussão documentados e em todas as divisões do modelo, com uma contagem de peso igual por trecho. O grupo aleatório principal manteve 13.824 de 37.492 trechos. O grupo separado com maior presença de bloqueios manteve 42.383 de 78.372. Era legítimo que trabalhadores se repetissem em trechos diferentes; não houve fusão por texto idêntico, exclusão por coerência entre indicadores nem recodificação de ataque geral.
- Considere Q como qualquer seleção de citação/relato e R como qualquer seleção de ataque direcionado ao destinatário em um trecho elegível. A presença de ambos exige pelo menos um Q e um R em algum ponto das 10 avaliações. A presença de uma dupla do mesmo revisor exige, além disso, Q e R em uma única resposta revisão/trabalhador; a presença apenas entre revisores diferentes não tem essa resposta. O denominador condicional principal é 98 + 57 = 155; as frações exatas 98/155 e 57/155 são exibidas como 63,2% e 36,8%. Os percentuais usam aritmética racional exata e arredondamento para cima no empate, com 1 casa decimal. Antes de calcular as combinações, exigimos pelo menos 100 trechos com ambos os rótulos para a comparação condicional principal, sem um limiar percentual favorável. Não foram calculados intervalos de confiança populacionais, testes de significância ou estimativas de precisão, nem foi feita uma afirmação de independência.
- A análise de sensibilidade previamente definida para a amostra com maior presença de bloqueios usou a mesma regra de exatamente 10 avaliações e ficou separada da amostra aleatória principal. Suas cinco contagens foram: 20.911 sem nenhum dos rótulos, 959 com citação/relato sem ataque direcionado ao destinatário, 18.056 com ataque direcionado ao destinatário sem citação/relato, 1.354 com ambos pelo mesmo revisor e 1.103 com ambos apenas por revisores diferentes; total de 42.383 e denominador condicional de 2.457. Excluir 2016 da amostra aleatória principal deixou 13.809 trechos, com cinco contagens de 12.012 / 406 / 1.236 / 98 / 57, nessa mesma ordem. Seus 155 trechos condicionais e a divisão de 98/57 não mudaram. São verificações descritivas, não replicações independentes da população nem evidência de que os grupos amostrais sejam comparáveis.
- O trabalho de Wulczyn, Thain e Dixon de 2017, Ex Machina: Personal Attacks Seen at Scale, estabeleceu a pesquisa de coleta colaborativa e modelagem que fundamenta os dados. O artigo sobre WAC de Cécillon e colegas, de 2020, manteve uma matriz por trabalhador e campo e agregou os campos de ataque separadamente por maioria. São métodos existentes, não erros demonstrados por este estudo. Nossa comparação usa a presença de rótulos em qualquer uma das 10 avaliações e a combinação na mesma resposta, não o desempenho de rótulos definidos por maioria. A comparação do Influence IQ conta se as duas opções vieram do mesmo revisor ou apenas de revisores diferentes em cada trecho selecionado.
- A apresentação da fonte descreve 2001–2015 e o artigo original, 2004–2015; os arquivos fixados da versão 6 contêm anos de 2001–2016. O esquema do produtor para o estado de login informa 0/1, enquanto o arquivo disponibilizado usa False/True; as strings dos indicadores binários são 0.0/1.0. Preservamos essas diferenças entre documentação e observação sem atribuir uma causa. O analisador aceita os valores literais exatos dos arquivos, sem arredondar nem converter os valores dos rótulos. O pacote documenta as versões de origem, as regras de seleção e as etapas para reproduzir a análise a partir dos arquivos públicos.
- Os dois grupos de revisão de 10 pessoas, as respostas dos revisores A/B e as escolhas de repasse são exemplos didáticos fictícios. Não contêm textos originais das discussões nem identificadores do conjunto de dados. Os dois grupos inventados têm uma seleção de citação/relato e uma de ataque direcionado ao destinatário, mas só o primeiro tem uma dupla marcada pela mesma pessoa. A ficha e as ilustrações conceituais são explicações práticas, não fluxos observados na fonte, políticas de moderação testadas ou garantias de decisões melhores.
Todas as versões de idioma são traduzidas diretamente da fonte em inglês. Cada edição descreve o mesmo conjunto histórico de dados da Wikipedia em inglês e as mesmas avaliações selecionadas. A tradução não cria resultados sobre mercados locais. O Influence IQ é responsável pela análise, pela interpretação e pelas traduções.