이커머스 머천다이징: 상품 위치에 대한 가정을 검증하세요
과거의 책 10권 선택 실험은 단순한 위치 조정이 패턴의 일부를 놓칠 수 있는 이유와 상품 카드를 비교하기 전에 그 가정을 검증하는 방법을 보여 줍니다.
Compiani, Morozov, Seiler가 공개한 2024년 도서 선택 실험을 독자적으로 재분석했습니다.
초록
한 제안이 다른 제안보다 더 강하다고 판단하기 전에 각각 어디에 표시됐는지 고려해야 합니다. 공개된 2024년 전자책 10권 선택 실험으로 위치를 반영하는 2가지 방법을 검증했습니다. 목록에서 1단계 내려갈 때마다 같은 조정값을 적용하는 방법보다, 위치마다 별도 조정값을 허용하는 방법이 전체 선택을 더 잘 예측했습니다. 일부 개별 위치에서는 정확도가 더 낮았으므로 전체 비교가 중요합니다.
모델 2개는 같은 책·가격 정보를 사용했습니다. 참여자 6,176명으로 학습하고 다른 3,088명으로 예측을 확인했습니다. 선택은 가상이었고 모두 반드시 책을 골라야 했습니다. 상품 카드를 비교하는 기업과 크리에이터에게 주는 시사점은 결과를 제안 자체의 성과로 돌리기 전에 배치 가정을 검증하라는 것입니다. 이 연구는 매출 증가를 추정하거나 최선의 상품 순서를 정하지 않습니다.
페이지 맨 위 상품이 가장 많은 클릭을 받는다고 가정해 보세요. 더 강한 제안이기 때문일까요, 목록의 위치가 도움이 됐을까요? 다른 카드를 다시 쓰거나, 성과가 약해 보이는 상품을 할인하거나, 상품 구성을 바꾸기 전에 기업은 유용한 답을 얻어야 합니다.
위치 반영은 방법을 묻기 전까지는 간단해 보입니다. 목록에서 1단계 내려갈 때마다 같은 조정값을 적용해야 할까요? 과거 실험으로 이 단순한 방법과 더 유연한 방법을 비교하고, 모델 학습에 쓰지 않은 참여자들로 둘 다 검증했습니다.
같은 상품, 다른 위치
상품 위치 비교는 무엇을 알려 줘야 하나요?
상품 카드 비교는 제안하는 상품과 제시 방식을 구분하는 데 도움이 되어야 합니다. 한 상품은 보통 처음에, 다른 상품은 보통 마지막에 나온다면 합계만으로 어느 제안을 쇼핑객이 더 선호하는지 알 수 없습니다.
검증할 단순한 방법은 목록에서 1단계 내려갈 때마다 모델의 기저 선호 점수에 같은 조정값을 적용합니다. 유용한 질문은 위치마다 다른 조정값을 허용하는 방법과 비교해 선택을 충분히 잘 예측하는지입니다.
공개 도서 선택 실험으로 이 2가지 방법을 검증했습니다. 결과는 모음 페이지나 디지털 스토어에서 상품을 비교하는 기업과 크리에이터에게 관련이 있습니다. 인기 상품의 배치 규칙이 아니라 측정 가정을 살펴보는 방법을 제공합니다.
제안이 여러 곳에 나타날 때 중요합니다. 크리에이터는 같은 다운로드 상품을 모음 페이지와 출시 페이지에 소개할 수 있습니다. 소매업체는 카테고리 목록의 순서를 바꿀 수 있습니다. 상품, 가격, 대상, 표현 방식이 함께 달라질 수 있습니다. 위치 조정은 그 비교의 일부에 대한 가정이며 따로 확인할 필요가 있습니다.
도서 실험에서 사람들은 무엇을 골랐나요?
Giovanni Compiani, Ilya Morozov, Stephan Seiler는 Prolific에서 모집한 참여자에게 순서와 가격을 무작위로 정한 전자책 10권 중 가상으로 고르게 했습니다. 반드시 책을 골라야 했으며 아무것도 사지 않는 선택지는 없었습니다. 유지한 각 제출 건의 첫 과제를 사용하며, 선택한 책을 제거한 후속 과제는 사용하지 않습니다.[1]
저자들은 이미 위치와 가격에 대한 반응을 보고합니다. 더 넓은 연구에서는 텍스트와 이미지가 상품 대체 관계를 추정하는 데 어떻게 도움이 되는지 살펴봅니다. 여기서는 더 좁게 묻습니다. 위치 항 1개를 바꾸면 모델 학습에 쓰지 않은 참여자의 선택 예측이 개선될까요?
원래 적격 기준을 따르면 제출 건 9,265건, 서로 다른 Prolific 참여자 ID 9,264개가 남습니다. ID 1개가 2번 나타납니다. 제출 건 2개를 함께 유지하고 그 참여자에게 다른 참여자와 같은 총가중치를 부여합니다. 제출 1건이 자동으로 별개의 사람을 뜻하지 않으며, 첫 과제가 반드시 그 사람이 실험을 처음 접한 때인 것도 아닙니다.[2][3]
유지된 원자료 날짜는 2024년 6월 11일–26일입니다. 원고는 6월 14일–27일로 설명하므로 차이를 밝히고 날짜에 따른 제외는 적용하지 않습니다. 검토한 자료에서 국가·연령 요건은 확인되지 않았습니다. 미국 쇼핑객이나 다른 국가 모집단에 대한 추정치가 아닙니다.[1][2]
비교 내내 같은 참여자를 함께 유지합니다
원저자 적격 규칙을 적용한 첫 과제 제출 건이며, 남은 원자료 날짜는 2024년 6월 11일–26일입니다.
| 집단 | 참여자 수(플랫폼 ID 기준) | 유지한 제출 건수 |
|---|---|---|
| 유지한 전체 | 9,264 | 9,265 |
| 학습 | 6,176 | 6,176 |
| 평가용으로 남겨 둔 집단 | 3,088 | 3,089 |
어느 위치 모델이 학습 외 집단의 선택을 더 잘 예측했나요?
유연한 위치 모델이 사전에 정한 점수 지표에서 학습 외 집단의 선택을 더 잘 예측했습니다. 모델 2개 모두 제시된 책과 표시 가격을 반영합니다. 위치를 표현하는 방식만 다릅니다.
기준 모델은 목록에서 1단계 내려갈 때마다 계수 1개를 사용합니다. 유연한 모델은 첫 위치를 기준으로 위치 2–10에 별도의 조정값을 씁니다. 더 자유롭지만 추정해야 할 매개변수도 많습니다. 자체 학습 데이터에 더 잘 맞는다는 사실만으로 비교가 결론나지는 않습니다.
따라서 참여자 6,176명으로 모델 2개를 학습하고 나머지 3,088명으로 평가했습니다. 같은 참여자의 모든 제출 건은 분할선의 같은 쪽에 뒀습니다. 평가 집단에는 반복 참여자가 포함되어 제출 건이 3,089건입니다.
예측 비교에는 음의 로그 점수를 사용했습니다. 실제 선택에 더 높은 확률을 부여하면 모델의 벌점이 작아집니다. 그 선택에 매우 낮은 확률을 부여하면 벌점이 커집니다. 평균 음의 로그 점수는 낮을수록 좋습니다.
학습 외 집단의 평균은 기준 모델 2.2260, 유연한 모델 2.2154였으며 자연로그 단위인 nats입니다. 예측 점수이며 정답 비율이 아닙니다. 모델이 이미 본 데이터를 설명하는 더 쉬운 작업에 비교를 의존하지 않도록 학습·평가 점수를 함께 보여 줍니다.
같은 참여자로 평가한 모델 2개
2024년 책 10권 실험에서 선정된 첫 과제 선택입니다. 학습: 참여자 6,176명, 제출 6,176건. 평가: 참여자 3,088명, 제출 3,089건.
| 위치 모델 | 학습 점수(nats) | 학습 외 평가 점수(nats) |
|---|---|---|
| 선형 위치 항 1개 | 2.2046 | 2.2260 |
| 위치별 별도 항 | 2.1899 | 2.2154 |
짝지은 개선량은 참여자당 0.0106 nats이며 근사 95% 구간은 0.0044–0.0168입니다. 여기서 양의 개선량은 유연한 모델에 유리합니다. 이 점수 척도에서 작은 결과이지만 구간은 0보다 위에 있습니다.[4]
이 구간은 학습된 모델 2개를 고정된 것으로 취급하고 참여자 집단의 독립성을 가정합니다. 다른 학습 표본으로 모델을 적합할 때 생기는 불확실성은 포함하지 않습니다. 선정된 과거 과제에서 예측이 개선됐다는 근거이며, 점수 차이를 매출 증가로 바꾸지는 않습니다.
유연한 모델은 학습 외 집단의 로그 점수를 개선합니다
선정된 과거 책 10권 과제에서 평가 참여자 3,088명 각각에 대해 모델 2개의 점수를 짝지어 비교합니다.
| 비교 | 개선량(nats) | 95% 구간 하한(nats) | 95% 구간 상한(nats) |
|---|---|---|---|
| 유연한 모델 로그 점수 − 기준 모델 로그 점수 | 0.0106 | 0.0044 | 0.0168 |
모델 2개는 어디에서 관찰된 선택을 놓쳤나요?
전체 위치 비교는 종합 점수와 함께 세부 결과가 필요한 이유를 보여 줍니다. 위치별 관찰 선택 비율과 각 모델이 부여한 평균 확률을 비교합니다. 학습 외 집단에서 참여자별로 동일한 가중치를 준 평균이며 클릭률이 아닙니다.
위치 1의 관찰 비율은 17.16%였습니다. 기준 모델은 14.64%, 유연한 모델은 17.73%를 예측했습니다. 위치 10의 관찰 비율은 9.18%, 예측은 각각 6.37%, 8.74%였습니다. 이 특정 목록의 양끝에서는 유연한 모델이 더 가까웠습니다.
위치 10개 전체의 관찰·예측 선택
학습 외 집단: 공개된 2024년 실험의 참여자 3,088명과 첫 과제 제출 3,089건.
| 위치 | 관찰 선택 비율 | 기준 모델 평균 확률 | 유연한 모델 평균 확률 | 해당 위치를 선택한 제출 건수 |
|---|---|---|---|---|
| 위치 1 | 17.16% | 14.64% | 17.73% | 530 |
| 위치 2 | 13.60% | 13.20% | 14.84% | 420 |
| 위치 3 | 9.91% | 12.06% | 9.74% | 306 |
| 위치 4 | 10.91% | 11.21% | 9.26% | 337 |
| 위치 5 | 9.20% | 10.09% | 8.94% | 284 |
| 위치 6 | 7.08% | 9.25% | 8.01% | 219 |
| 위치 7 | 8.00% | 8.44% | 7.57% | 247 |
| 위치 8 | 7.12% | 7.67% | 7.47% | 220 |
| 위치 9 | 7.84% | 7.08% | 7.69% | 242 |
| 위치 10 | 9.18% | 6.37% | 8.74% | 284 |
유연한 모델이 모든 곳에서 더 가깝지는 않았습니다. 위치 4의 관찰 비율은 10.91%였습니다. 기준 모델은 11.21%, 유연한 모델은 9.26%를 예측했습니다. 유연성이 늘면서 학습 외 집단의 종합 점수는 좋아졌지만 그 위치의 차이는 더 커졌습니다.
다음 표는 관찰 비율에서 예측 비율을 뺀 값입니다. 양의 차이는 그 위치의 선택을 모델이 너무 적게 예측했고, 음의 차이는 너무 많이 예측했다는 뜻입니다. 위치 10개를 모두 보여 주면 좋아 보이는 끝점 하나가 전체 비교를 대신하지 않습니다.
모델 2개와 관찰 선택의 차이
같은 평가 참여자 3,088명으로 구한, 위치 10개 각각의 관찰 선택 비율에서 평균 예측 확률을 뺀 값입니다.
| 위치 | 관찰 − 기준 모델 | 관찰 − 유연한 모델 |
|---|---|---|
| 위치 1 | 2.52 퍼센트포인트 | -0.57 퍼센트포인트 |
| 위치 2 | 0.41 퍼센트포인트 | -1.24 퍼센트포인트 |
| 위치 3 | -2.15 퍼센트포인트 | 0.17 퍼센트포인트 |
| 위치 4 | -0.29 퍼센트포인트 | 1.65 퍼센트포인트 |
| 위치 5 | -0.89 퍼센트포인트 | 0.26 퍼센트포인트 |
| 위치 6 | -2.17 퍼센트포인트 | -0.93 퍼센트포인트 |
| 위치 7 | -0.44 퍼센트포인트 | 0.43 퍼센트포인트 |
| 위치 8 | -0.55 퍼센트포인트 | -0.35 퍼센트포인트 |
| 위치 9 | 0.76 퍼센트포인트 | 0.14 퍼센트포인트 |
| 위치 10 | 2.81 퍼센트포인트 | 0.44 퍼센트포인트 |
위치별 행은 기술 통계이며 개별 유의성을 주장하지 않습니다. 실험은 안구 움직임이나 주의를 측정하지 않았고, 이 분석은 위치별 차이의 이유를 식별하지 않습니다. 관찰 비율이 곡선 형태라는 사실만으로 기준 모델이 반박되지도 않습니다. 위치 항이 선형인 대상은 선택 비율이 아니라 모델의 기저 선호 점수입니다.
처음과 마지막 관찰 비율을 단순히 빼면 다른 질문에 답하게 됩니다. 그 비율은 여러 상품·가격에 걸친 선택을 요약합니다. 학습된 모델 2개는 모두 책과 가격을 반영한 뒤 선택지 10개에 확률을 부여합니다. 양끝 차이나 모델 비교 어느 쪽도 실제 스토어에서 특정 상품을 옮기면 어떤 일이 생길지 알려 주지 않습니다.
직접 쓸 수 있는 상품 위치 측정 양식
제안을 비교하기 전에 짧은 측정 브리프를 쓰세요. 아래 양식은 가입 없이 쓸 수 있는 예시입니다. 가정을 확인하라는 연구의 시사점을 적용하며, 같은 모델이 해당 스토어에 맞는다고 약속하지 않습니다.
결정: ‘[기간]에 [페이지 또는 캠페인]의 [상품 비교 또는 표현 방식 변경]을 결정해야 합니다.’ 유리한 지표를 고르기 전에 결정을 명시하세요.
결과: ‘[선택, 클릭, 장바구니 추가 또는 구매]를 측정하겠습니다.’ 실제 기록이 뒷받침하는 결과를 고르세요. 제시한 대안, 순서, 표시 가격을 함께 유지하세요. 반드시 하나를 골라야 하는 결과는 구매 결과와 구분해야 합니다.
단위: ‘단위는 [참여자 또는 명확히 정의한 다른 단위]입니다. 반복 방문이나 제출은 [규칙]으로 처리합니다.’ 새로운 사람에 대한 예측을 평가할 때 같은 사람의 관찰은 함께 유지하세요. 익명 세션 식별자를 고유한 사람의 증거로 취급하지 마세요.
비교: ‘모델 2개는 같은 상품, 가격 정보, 요건을 충족한 관찰을 사용합니다. [위치 가정]만 다릅니다.’ 유연한 방법과 함께 단순한 대안도 명시하세요.
평가: ‘학습 전에 [정의한 집단]을 남겨 두고 [명시한 점수 지표]를 비교합니다. 모든 위치를 보여 주겠습니다.’ 결과를 보기 전에 미결론이나 더 나쁜 결과를 어떻게 보고할지 정하세요.
활용: ‘이 결과를 [측정 결정]에 참고합니다. [상업적 결정] 전에는 [여기서 측정하지 않은 상업적 결과]의 근거가 더 필요합니다.’ 마지막 문장은 예측 연습이 조용히 매출 전망으로 바뀌지 않게 합니다.
같은 참여자는 평가 분할의 같은 쪽에 두세요
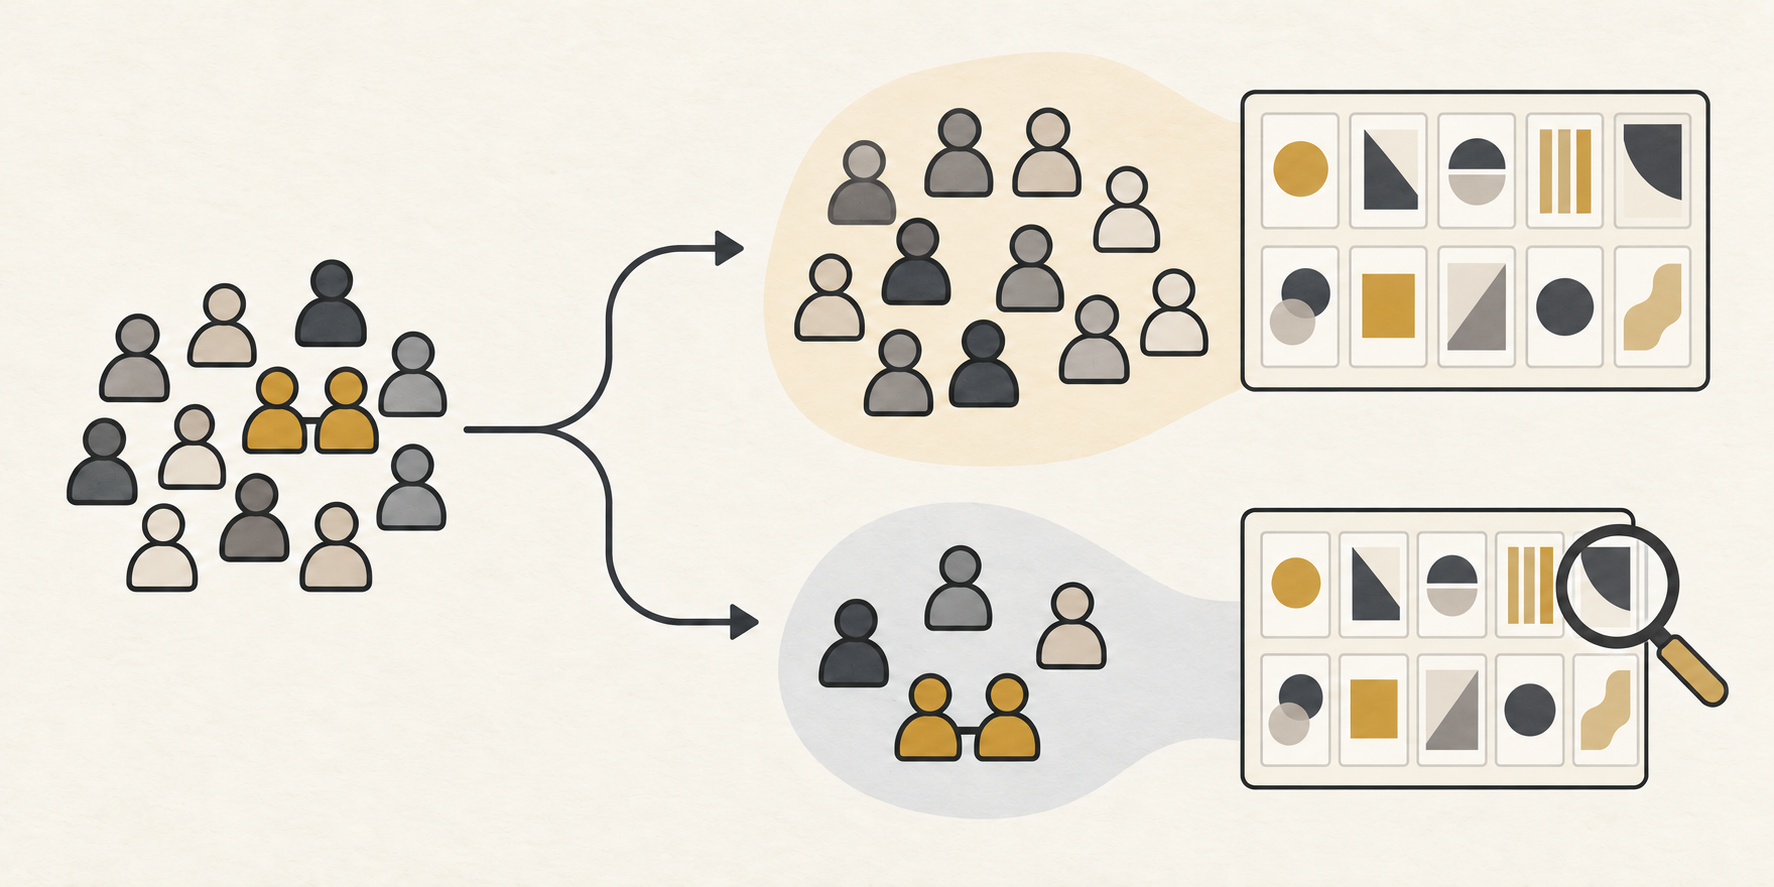
비교를 정의하세요
상품, 위치, 결과, 관찰 단위를 명시하세요.
평가 집단을 남겨 두세요
참여자별 제출 건을 함께 유지하세요.
전체 결과를 확인하세요
예측을 비교하고 더 나쁜 결과를 포함해 모든 위치를 보여 주세요.
작성 예시: 디지털 상품을 비교하는 크리에이터
글쓰기 워크북, 워크숍, 묶음 상품을 파는 가상의 크리에이터를 생각해 보겠습니다. 묶음 상품이 출시 페이지 맨 위에 나오고 클릭도 가장 많이 받습니다. 크리에이터는 다른 상품 설명을 다시 쓸지 고민합니다.
측정 브리프는 당장의 질문을 바꿉니다. 관찰 결과는 판매가 아니라 클릭입니다. 기록에는 어떤 제안을 어떤 순서와 가격으로 표시했는지 있어야 합니다. 묶음 상품이 항상 첫 칸에 있다면 그 기록으로 묶음 상품 자체와 위치를 명확히 분리할 수 없습니다.
완성한 브리프는 이렇게 쓸 수 있습니다. ‘위치를 반영하는 방식이 새 방문자의 클릭을 예측하는지 알고 싶습니다. 같은 제안·가격 정보를 비교하고, 반복 관찰을 함께 유지하며, 전체 위치 비교를 보고하겠습니다. 클릭 기록으로 구매를 주장하지 않겠습니다.’ 측정 질문의 가상 예시이며 제안하는 결과가 아닙니다.
타당한 다음 단계는 같은 결과 정의를 유지하면서 상품과 위치를 구분할 만큼 충분한 변동이 있는 비교를 계획하는 것입니다. 그다음 별도로 남겨 둔 집단에서 단순한 위치 조정과 더 유연한 방법을 비교할 수 있습니다. 해당 페이지의 새로운 연구가 되며, 도서 실험은 그 페이지의 예상 클릭률을 제공하지 않습니다.
유연한 방법이 남겨 둔 집단을 더 잘 예측하면 보고서의 위치 반영 방식을 재검토할 이유가 생깁니다. 그래도 묶음 상품을 옮기면 매출이 늘어난다고 보여 주지는 않습니다. 상업적 결정에는 실제 표현 방식의 변경과 비즈니스에 중요한 결과에 관한 근거가 필요합니다.
비교가 결론 나지 않으면 그렇게 밝혀야 합니다. 유연성이 늘어난다고 자동으로 더 나은 비즈니스 도구가 되지는 않습니다. 실무적 이점은 순서가 더 명확해지는 것입니다. 기록으로 무엇을 구분할 수 있는지 이해하고, 측정 가정을 검증한 뒤, 다른 실험이 필요한지 결정하세요.
Influence IQ는 비교를 어떻게 계산했나요?
저자들의 편집된 공개 응답과 원래 선정 규칙을 사용했습니다. 처음 553개의 예비·시험 기록은 고정된 파일 위치에 따라 제외합니다. 남은 틀에는 제출 10,775건이 있습니다. 이해도 필터 후 9,344건, 완료 필터 후 9,265건이 남습니다.[2]
동의, 완료 상태, 최소 60초 소요 시간 규칙은 각각의 단계에서 제출 건을 추가로 제거하지 않습니다. 완료와 소요 시간은 노출 이후 필터이므로 남은 집단은 선정된 표본입니다.
Prolific 참여자 ID로 집단을 정의합니다. 결정론적 해시 분할로 선택 내용을 사용하지 않고 집단의 3분의 2를 학습에, 나머지를 평가에 배정합니다. 각 집단 안에서는 유지한 첫 과제 제출 건마다 해당 참여자의 기여를 똑같이 나눕니다. 같은 가중치를 학습, 점수, 위치 표에 적용합니다.[3]
모델 2개 모두 벌점 없는 다항 로짓이며 책 지시변수 9개와 선형 가격 항 1개를 사용합니다. 기준 모델은 선형 위치 항 1개를 더해 매개변수 11개, 유연한 모델은 위치 지시변수 9개를 더해 19개입니다. 위치 1과 숫자가 가장 작은 상품 ID를 기준 범주로 씁니다. 모든 적격 선택 집합은 같은 상품 10개를 포함하며, 선택 ID·가격·위치의 일치 여부를 확인했습니다.
학습 집단에 모델을 적합하고 적합된 계수를 유지한 뒤 평가 선택에 점수를 매깁니다. 구간은 짝지은 참여자 점수 차이의 표준편차, 참여자 단위 3,088개, 자유도 3,087을 사용합니다. 정확한 정규 점수 가정이 성립하는 경우를 제외하면 근사 Student-t 구간입니다. 위치 비교 10개는 모두 기술 통계로 유지합니다.[4]
기준 모델의 주 최적화 도구가 수치 경고를 반환했습니다. 그래도 두 번째 시작점 비교를 포함해 적합 전에 지정한 정확도 조건을 모두 충족했습니다. 원래 적합 결과를 유지했으며 상세 진단을 재현 자료에 포함했습니다.[5]
다운로드에는 표시된 결과, 독자적인 분석 코드, 집계 수치 출력이 있습니다. 원자료 응답 행, 참여자 ID, 책 그림은 제외합니다. 원자료는 저자들의 공개 자료에서 별도로 확보하세요. 재분석과 해석은 Influence IQ의 책임입니다.
CSV는 이 페이지의 언어를 사용합니다. 패키지에는 독자적인 계산 코드, 번역된 방법 문서, 집계 결과가 있습니다. 원자료 응답 행과 책 에셋은 포함하지 않으며 저자들의 공개 자료에서 데이터를 별도로 확보해야 합니다.
출처 및 주석
- Compiani, Morozov, Seiler, Demand Estimation with Text and Image Data, 원고 버전 4, 2026년 2월 17일, 3절 및 부록 C. 저자들은 이미 위치와 가격에 대한 반응을 연구합니다. 학습 외 참여자를 비교하는 이 분석은 독자적이며 범위가 더 좁은 재분석입니다.
- 저자들의 DeepLogitReplication 공개 자료, 커밋 8c4f37a58c3a5049d3dff8ad171235b2c6ef01ec. 편집된 응답 파일의 원래 위치 기반 예비조사 제외 기준과 저자 적격 규칙을 따릅니다. 남은 원자료 날짜는 2024년 6월 11일–26일로, 원고의 6월 14일–27일 설명과 다릅니다. 날짜로 포함 여부를 정하지 않습니다.
- Prolific은 참여자 ID와 연구·제출 식별자를 구분합니다. 묶음을 위해 정확한 참여자 ID를 보존합니다. ID만으로 각각이 다른 사람인지 독립적으로 검증되거나, 유지한 제출 건이 그 사람의 첫 노출이었는지 확인되지는 않습니다.
- Influence IQ의 사전 지정 비교는 평가 참여자 안에서 유연한 모델 로그 확률에서 기준 모델 로그 확률을 뺀 값의 평균을 구한 뒤 참여자 전체에서 평균냅니다. 95% 구간은 평균에 Student-t 임계값과 참여자 표준편차를 곱하고 3,088의 제곱근으로 나눈 값을 더하고 뺍니다. 참여자 집단의 독립성을 가정하고 고정된 학습 적합에 조건을 두며 학습 적합 불확실성은 제외합니다. 정확한 구간이 되려면 참여자 차이가 공통 분산을 지닌 동일한 정규분포를 따라야 합니다.
- 기준 모델의 0 시작점 적합은 정밀도 경고를 반환했습니다. 최대 절대 평균 기울기는 3.12×10⁻⁹, Newton 감소량은 2.50×10⁻⁸, 시작점 2개의 최대 로그 확률 차이는 7.46×10⁻⁸로, 사전 지정 한계 10⁻⁸, 10⁻⁶, 10⁻⁷보다 작았습니다. 모델 2개 모두 양의 곡률·목적함수 일치 조건도 충족했습니다. 주 0 시작점 계수를 유지했습니다.
영어 기사가 원문입니다. 언어별 버전은 같은 과거 실험을 설명하며 국가별 쇼핑 추정치가 아닙니다.