फ़ीडबैक के लिए रेसिपी के कौन-से कमेंट पढ़ें?
सबसे अधिक अपवोट वाले या सबसे नए कमेंट पढ़ने से दिखने वाली रेटिंग का वितरण बदल सकता है. चुनी गई 100 रेसिपी चर्चाओं में 10-कमेंट के चयन की तुलना बताती है कि पढ़ने का तरीका उस सवाल के अनुसार क्यों होना चाहिए जिसका जवाब चाहिए.
UCI ने 2023 में जो रेसिपी आर्काइव जारी किया, उसके 18,182 कमेंट का विश्लेषण.
सार
किसी रेसिपी की चर्चा में रेटिंग का वितरण दिखाना लक्ष्य था, तो औसतन रैंडम चयन, सबसे अधिक अपवोट वाले या सबसे नए कमेंट चुनने से ज़्यादा करीब था. Influence IQ ने UCI के 2023 में जारी 18,182 कमेंट के ऐतिहासिक आर्काइव में से चुनी गई, ऊँची रेटिंग वाली 100 रेसिपी में 10-कमेंट के चयन की तुलना की. रेटिंग वितरण में औसत अपेक्षित अंतर रैंडम चयन के लिए 16.5 प्रतिशत अंक, अपवोट के लिए 18.7 और सबसे नए कमेंट के लिए 20.3 था. [1][4]
नतीजा 1–5 स्टार वाले और बिना रेटिंग वाले कमेंट के वितरण को मापता है, उनकी सलाह की उपयोगिता को नहीं. अपवोट से चुने कमेंट, रैंडम चयन के मुकाबले 46 रेसिपी में करीब और 54 में दूर थे. फ़ूड क्रिएटर और कम्युनिटी प्रबंधकों के लिए सीख है कि चर्चा का सार बताने वाले नमूने को जवाब की योजना बनाने वाले उदाहरणों से अलग रखें.
रेसिपी में सुधार करना है और उसके नीचे लंबी चर्चा है. क्या स्पष्ट करना है, यह तय करने से पहले कुछ कमेंट पढ़ने का समय है. क्या पहले सबसे अधिक वोट पाने वाले कमेंट पढ़ेंगे, सबसे नए कमेंट या चर्चा से रैंडम तरीके से चुने हुए कमेंट?
किसी वाक्य का अर्थ समझने से पहले ही यह चुनाव हो जाता है. इससे तय होता है कि क्रिएटर, संपादक या सहकर्मी को दिए ब्रीफ़ में किन लोगों की आवाज़ पहुँचेगी. हमने देखा कि चयन के 3 स्पष्ट नियमों से ब्रीफ़ की 1 मापी जा सकने वाली विशेषता कैसे बदली: रेटिंग का संतुलन, जिसमें बिना रेटिंग वाले कमेंट भी हैं.
बड़ी चर्चा की चुनी हुई झलक
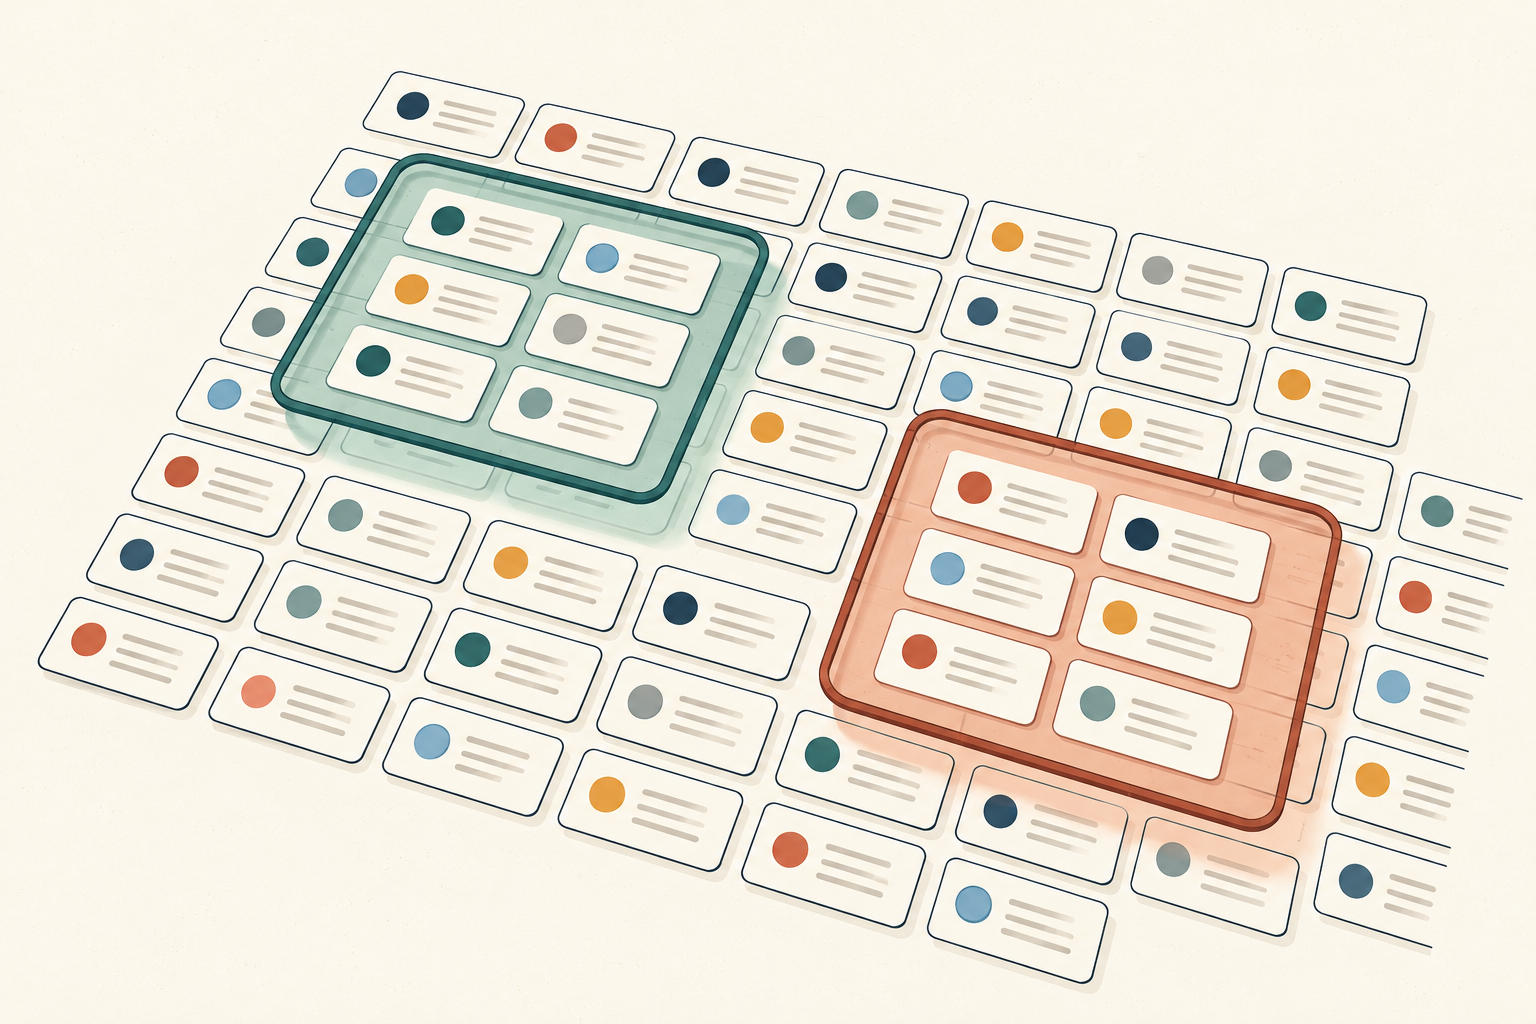
- चुने गए कमेंट
- आर्काइव की पूरी चर्चा
10 कमेंट से 3 अलग तस्वीरें मिल सकती हैं
आगे की सामग्री तैयार करने वाले रेसिपी क्रिएटर को तय करना होता है कि पहले क्या पढ़ें. सबसे अधिक अपवोट वाले कमेंट उपयोगी शॉर्टकट लग सकते हैं. सबसे नए कमेंट चर्चा समझने का दूसरा रास्ता देते हैं. दोनों कुछ कमेंट को पहले रखते हैं, लेकिन इनमें से कोई चयन अपने आप पूरी चर्चा का वर्णन नहीं करता.
हमने इस सीमित सवाल को UCI से 2023 में जारी सार्वजनिक डेटासेट में जाँचा: Taste of Home की चुनी गई, ऊँची रेटिंग वाली 100 रेसिपी के 18,182 पुराने कमेंट. हर रेसिपी में अपवोट से चुने 10, बनाए जाने के समय से चुने 10 और रैंडम तरीके से चुने 10 कमेंट की तुलना की. संदर्भ उस रेसिपी के सभी आर्काइव किए गए कमेंट की रेटिंग का वितरण था. [1]
पूरे रेटिंग वितरण से औसत अपेक्षित अंतर अपवोट से चयन के लिए 18.7 प्रतिशत अंक, सबसे नए कमेंट के लिए 20.3 और रैंडम चयन के लिए 16.5 था. इन औसतों में हर रेसिपी का बराबर योगदान था, चाहे उसमें कितने भी कमेंट हों. [4]
रैंडम चयन के मुकाबले अपवोट से चयन का अंतर 2.2 प्रतिशत अंक बड़ा और सबसे नए कमेंट का अंतर 3.8 अंक बड़ा था. ये अंतर रेटिंग वाले और बिना रेटिंग वाले कमेंट के वितरण के हैं. हमने यह नहीं मापा कि कौन से कमेंट में सबसे अच्छी खाना बनाने की सलाह, सबसे स्पष्ट व्याख्या या सबसे उपयोगी कारोबारी विचार थे.
फ़ूड क्रिएटर या कम्युनिटी प्रबंधक के लिए यह अंतर अहम है. कोई कमेंट ट्यूटोरियल का विचार देने जितना उपयोगी हो सकता है, भले वह चर्चा का सामान्य उदाहरण न हो. उसे उदाहरण मानना और चुने हुए कुछ कमेंट को सार मानना, अलग फ़ैसले हैं.
हर रेसिपी के पूरे रेटिंग वितरण से औसत अंतर
ऐतिहासिक UCI आर्काइव की चुनी गई 100 रेसिपी चर्चाओं में हर चयन के 10 कमेंट. कम अंतर का मतलब रेटिंग वाले और बिना रेटिंग वाले कमेंट के वितरण से अधिक मेल है.
| चयन का तरीका | औसत अपेक्षित अंतर |
|---|---|
| सबसे अधिक अपवोट वाले | 18.7 प्रतिशत अंक |
| बनने के समय के अनुसार सबसे नए | 20.3 प्रतिशत अंक |
| रैंडम चयन | 16.5 प्रतिशत अंक |
रेटिंग वितरण के अंतर का क्या मतलब है?
हर रेसिपी की चर्चा को 6 श्रेणियों के मिश्रण की तरह देखें: 1 से 5 स्टार और बिना रेटिंग वाले कमेंट. 10-कमेंट के नमूने का अपना मिश्रण होता है. हमने टोटल वेरिएशन दूरी नाम के माप से देखा कि इस छोटे मिश्रण और आर्काइव में मौजूद पूरी चर्चा के रेटिंग वितरण में कितना अंतर था.
सिर्फ़ 2 श्रेणियों का काल्पनिक उदाहरण लें. मान लें, आधे कमेंट 4 स्टार और आधे 5 स्टार देते हैं. अगर 10-कमेंट के चयन में 4 स्टार वाले 7 और 5 स्टार वाले 3 कमेंट हों, तो उसका मिश्रण 50% और 50% के बजाय 70% और 30% है. दूरी 20 प्रतिशत अंक है: 20-अंक के 2 निरपेक्ष अंतरों के योग का आधा.
यही गणना सभी 6 श्रेणियों में लागू होती है. छोटा मान आर्काइव के रेटिंग वितरण से अधिक मेल बताता है. इसका मतलब यह नहीं कि लिखी बात अधिक जानकारी देती है या कमेंट अधिक सच्चे हैं. 18.7 अंक का नतीजा यह भी नहीं कहता कि 18.7% कमेंट गलत हैं.
हमने बिना रेटिंग वाले कमेंट तुलना में रखे. UCI के अनुसार रेटिंग फ़ील्ड में 0 का अर्थ है कि रेटिंग नहीं दी गई; यह 1 स्टार से कम स्कोर नहीं है. इन्हें हटाने से जिस चर्चा का सार निकाला जा रहा है, वह बदल जाएगी. केवल संख्यात्मक श्रेणी नहीं बताती कि बिना रेटिंग वाले कमेंट में सवाल, तारीफ़, समस्या या कुछ और है. [1]
रैंडम चयन औसतन करीब था, हर रेसिपी में नहीं
समग्र तुलना से हर जगह लागू होने वाला विजेता नहीं मिलता. 100 में से 46 रेसिपी में अपवोट चयन का अपेक्षित अंतर रैंडम चयन से छोटा और 54 में बड़ा था. सबसे नए कमेंट का चयन 42 रेसिपी में करीब और 58 में दूर था. दोनों तुलनाओं में कहीं भी अंतर बिल्कुल बराबर नहीं था. [4]
ये हर रेसिपी के भीतर तरीकों के अपेक्षित अंतर की तुलनाएँ हैं. इसका मतलब यह नहीं कि उन 54 चर्चाओं में हर संभव रैंडम चयन अपवोट चयन से बेहतर होगा. 10 कमेंट का कोई ख़ास चयन पूरी चर्चा से बहुत मेल खा सकता है या उसके कुछ हिस्से छोड़ सकता है.
रैंडम नतीजा 10-कमेंट के हर संभव नमूने का औसत है, जहाँ सभी नमूनों की संभावना बराबर है. यह किस्मत से अच्छे निकले 1 चयन या किसी चुने हुए रैंडम सीड का परिणाम नहीं है. कटऑफ़ पर कई कमेंट के अपवोट या टाइमस्टैम्प बराबर होने पर, हमने बराबरी सुलझाने के हर संभव चयन का भी औसत लिया.
कटऑफ़ पर बराबरी के कारण अपवोट चयन में 70 रेसिपी और सबसे नए कमेंट के चयन में 4 रेसिपी के लिए औसत निकालना पड़ा. बराबर मान वाले कमेंट में लेखक, पंक्ति में स्थान या पहचानकर्ता के कारण किसी को प्राथमिकता नहीं दी गई. गणना तय चयन नियम का नतीजा पूछती है; किसी मनमाने क्रम को सबूत नहीं मानती. [4]
क्रिएटर के लिए व्यावहारिक सीख सीमित लेकिन उपयोगी है: अपवोट और नया होना, चयन के मानदंड हैं. इनमें से किसी से चर्चा का सार दें, तो यह चुनाव बताएँ. यह न मानें कि दिख रही छोटी सूची पूरे आर्काइव का संतुलन बनाए रखती है.
सभी रेसिपी चर्चाओं में एक ही तरीका करीब नहीं था
उसी रेसिपी के भीतर रैंकिंग से किए हर चयन की तुलना रैंडम चयन से है. ये अपेक्षित अंतरों की तुलनाएँ हैं, अलग-अलग रैंडम नमूने निकालने के नतीजे नहीं.
| चयन का तरीका | रैंडम चयन से कम अंतर | रैंडम चयन जितना अंतर | रैंडम चयन से अधिक अंतर |
|---|---|---|---|
| सबसे अधिक अपवोट वाले बनाम रैंडम | 46 | 0 | 54 |
| सबसे नए बनाम रैंडम | 42 | 0 | 58 |
कमेंट चुनने से पहले सवाल चुनें
ग्राहक फ़ीडबैक के तरीके अलग काम आते हैं. कारोबार बड़ा पैटर्न समझना, कोई ख़ास समस्या जाँचना या अगली पोस्ट के लिए सवाल ढूँढ़ना चाह सकता है. यह अध्ययन उस काम के एक हिस्से को देखता है: क्या छोटा चयन चर्चा का रेटिंग वितरण बनाए रखता है? यह फ़ीडबैक जुटाने के सभी तरीकों की रैंकिंग नहीं है.
सवाल हो, “यह चर्चा कुल मिलाकर कैसी है?”, तो पहले तय करें कि कौन से कमेंट इसमें शामिल हैं. उपलब्ध पूरी सूची से रैंडम चयन करने पर जान-बूझकर अपवोट या नए कमेंट को प्राथमिकता नहीं मिलती. इस आर्काइव में वह औसतन करीब था, फिर भी छोटे रैंडम नमूने में मापने योग्य अंतर था. हमने तुलना के लिए 10 कमेंट की सीमा चुनी थी; यह सलाह नहीं कि 10 कमेंट काफ़ी हैं.
सवाल हो, “अब किस बात का जवाब दूँ?”, तो किसी ख़ास कमेंट पर अलग से ध्यान देना उचित हो सकता है. किसी सामग्री की जगह दूसरी चीज़ इस्तेमाल करने का स्पष्ट सवाल रेसिपी जाँचने और व्याख्या तैयार करने का कारण हो सकता है. जवाब देने से पहले उस सवाल को आम बताना ज़रूरी नहीं. अगली सामग्री के लिए उसकी प्रासंगिकता अलग फ़ैसला है.
सवाल हाल के बदलावों का हो, तो कमेंट बनने का समय पढ़ने की प्रासंगिक अवधि तय कर सकता है. सार में वह अवधि साफ़ रखें. हमारे अध्ययन में सबसे नए कमेंट वे थे जिनके बनने के टाइमस्टैम्प सहेजे हुए आर्काइव में सबसे हाल के थे. इसका मतलब आज आने वाले कमेंट या वेबसाइट पर अभी दिख रहा क्रम नहीं था.
पूरे कमेंट आर्काइव की भी सीमा है. उसमें उन्हीं लोगों की बातें हैं जिन्होंने कमेंट करना चुना, उन सभी की नहीं जिन्होंने रेसिपी पढ़ी या आज़माई. कारोबार को कभी कमेंट न करने वालों की राय चाहिए, तो उन तक पहुँचने का अलग तरीका चाहिए. कमेंट आर्काइव से ज़्यादा मेल इस कमी को नहीं भर सकता. ऐसा अतिरिक्त फ़ीडबैक अलग रखें, ताकि उसका स्रोत और चयन समझ में आए.
2 अलग नोट रखें: एक में बताएँ कि चर्चा का सार देने के लिए कौन सा चयन किया; दूसरे में जाँचने लायक सवाल लिखें. यह योजना बनाने का सुझाव है, अध्ययन में परखा गया वर्कफ़्लो नहीं.
काल्पनिक उदाहरण: रेसिपी पर अगली सामग्री की योजना
मान लें, फ़ूड क्रिएटर बेकिंग की रेसिपी पर आगे की सामग्री बना रहा है. बहुत अपवोट वाला कमेंट पूछता है कि दूसरा पैन चलेगा या नहीं. क्रिएटर अगला वीडियो इस बात से शुरू करना चाहता है: “हर किसी को पैन के आकार से परेशानी हो रही है.” यह काल्पनिक प्रसंग है, डेटासेट से चुना कमेंट या रेसिपी नहीं.
पैन वाले सवाल का जवाब देना उपयोगी हो सकता है, भले यह न पता हो कि वह कितना आम है. अपवोट यह नहीं बताते कि किसने रेसिपी आज़माई या वही अनुभव किया.
ज़्यादा सटीक ब्रीफ़ होगा: “एक पाठक ने पूछा कि पैन का चुनाव इस रेसिपी पर कैसे असर डालता है. इस्तेमाल किया गया पैन दिखाएँ, उसके माप समझाएँ और बताएँ कि दूसरा सुझाने से पहले क्या जाँचना होगा.” फिर क्रिएटर खाना बनाने के विवरण सत्यापित कर सकता है. कमेंट शुरुआती सवाल देता है, जवाब साबित नहीं करता.
क्रिएटर चर्चा का सार भी देना चाहे, तो अलग नोट में बताए कि उसने क्या पढ़ा और कैसे चुना. उपलब्ध पूरी सूची से रैंडम नमूने में हर कमेंट को बराबर मौका मिलना चाहिए, बिना किसी कमेंट को दोबारा चुने. स्क्रॉल करके कुछ सुविधाजनक जगहों तक पहुँचना, यहाँ जाँची गई रैंडम प्रक्रिया नहीं है.
पूरी सूची उपलब्ध न हो, तो वही चयन बताएँ जो वास्तव में कर सकते हैं. “हमने इस सॉर्ट क्रम में पहले दिखने वाले कमेंट पढ़े” कहना, उसे प्रतिनिधि नमूना कहने से अधिक जानकारी देता है. उस अलग प्रक्रिया पर हमारे आर्काइव के संख्यात्मक अंतर लागू न करें.
आगे की सामग्री में उपकरण दिखाएँ और जाँचे हुए सवाल का जवाब दें. क्या स्पष्ट किया, यह दर्ज रखें, ताकि अगली समीक्षा अनुत्तरित सवालों पर ध्यान दे सके. उस व्याख्या को उसी आगे की सामग्री पर मिले फ़ीडबैक से परखें.
चयन और व्याख्या अलग रखें
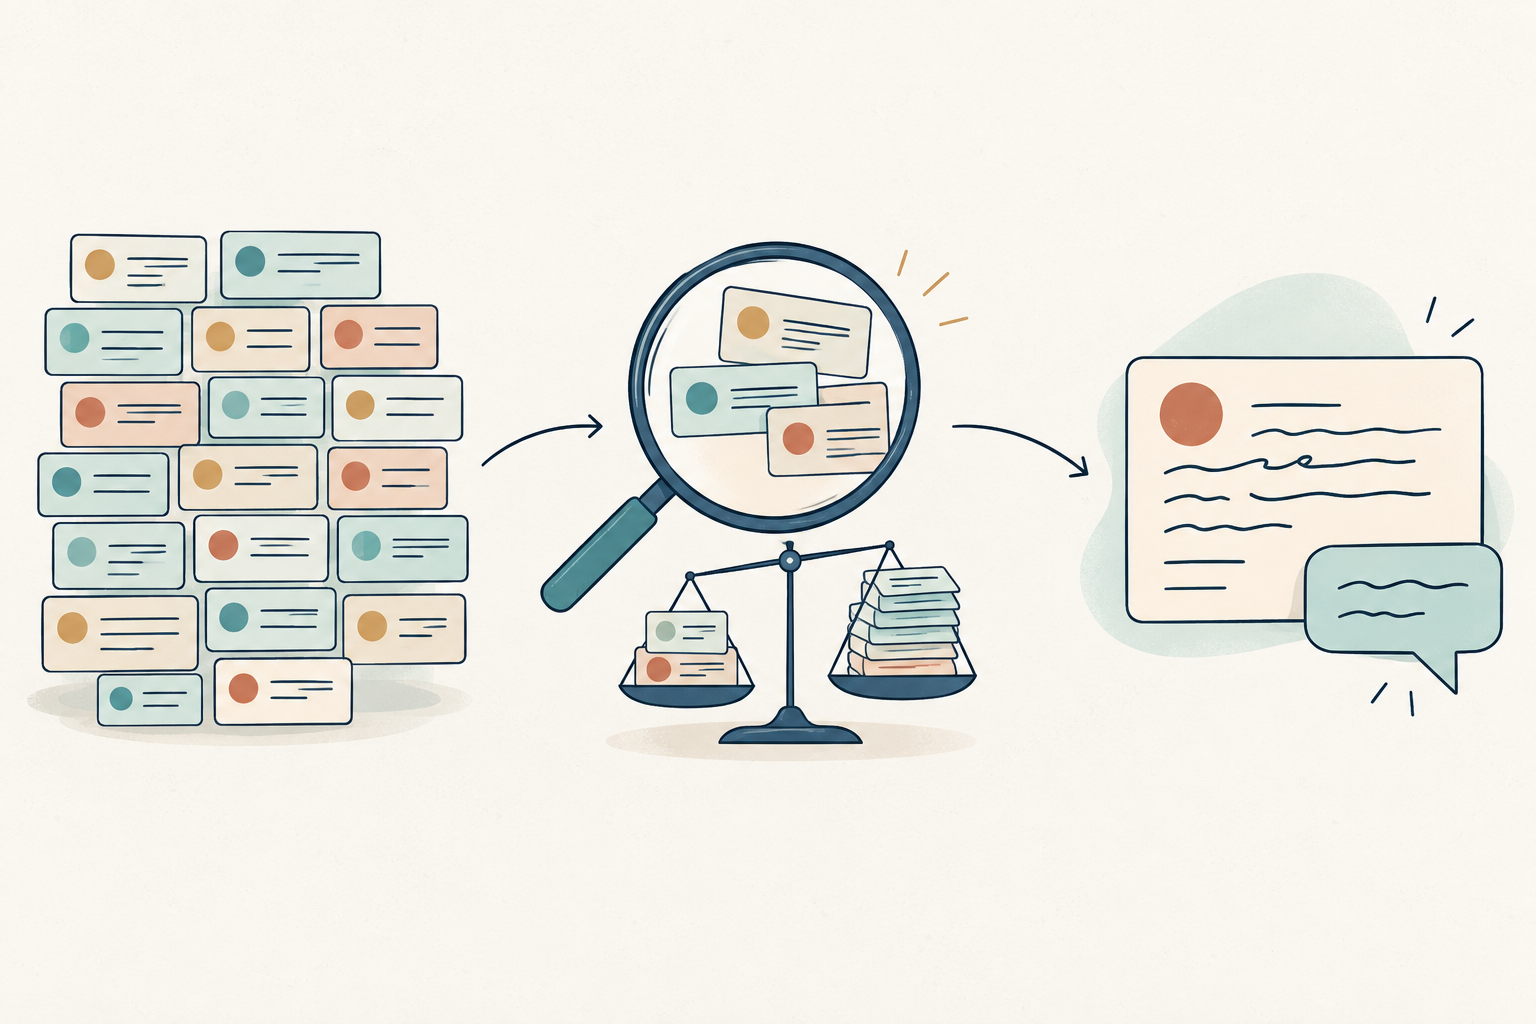
पढ़े जाने वाले कमेंट तय करें
पढ़ने से पहले चर्चा और चयन का नियम बताएँ.
सोचें कि चयन में क्या शामिल है
चुनी हुई झलक और पूरी चर्चा को अलग रखें.
कमेंट को उसके संदर्भ में पढ़ें
असल सवाल से जवाब की योजना बनाएँ और उत्तर जाँचें.
रेसिपी की चर्चा पढ़ने के लिए छोटा ब्रीफ़
कमेंट की समीक्षा का काम क्रिएटर या सहकर्मी को देने से पहले ये सवाल देखें. ये योजना बनाने की व्यावहारिक मदद हैं, स्रोत डेटासेट के सवाल नहीं.
फ़ैसला: पढ़ने से किस काम की जानकारी मिलेगी? ठोस काम बताएँ, जैसे रेसिपी का कोई चरण स्पष्ट करना या अगली सामग्री का विषय चुनना. उदाहरण माँगने और पूरी चर्चा का वर्णन माँगने को अलग रखें.
दायरा: कौन सी रेसिपी, प्लेटफ़ॉर्म और अवधि शामिल हैं? बताएँ कि उपलब्ध सूची पूरी है या नहीं. कमेंट को कमेंट ही गिनें; अलग सबूत के बिना उन्हें अलग-अलग लोग या सत्यापित ग्राहक न कहें.
चयन: पढ़े जाने वाले समूह में कमेंट कैसे आएँगे? सॉर्ट क्रम या रैंडम प्रक्रिया, पढ़े कमेंट की संख्या और बराबरी के मामलों का नियम दर्ज करें. बिना रेटिंग वाले कमेंट उस चर्चा का हिस्सा हों जिसे समझना है, तो उन्हें दायरे में रखें.
अवलोकन: चुने गए कमेंट ने वास्तव में क्या कहा? कमेंट के सीधे सवाल को अपनी व्याख्या से अलग रखें. मुद्दा समझने के लिए पर्याप्त संदर्भ रखें, लेकिन साझा ब्रीफ़ में निजी जानकारी न रखें.
अगला काम: प्रकाशन से पहले कौन सा दावा या रेसिपी का विवरण जाँचना है? यह जाँच उसे सौंपें जो जवाब दे सके. प्रस्तावित व्याख्या और उसे कहाँ देना है, यह लिखें; चुने उदाहरणों से बिना सबूत यह दावा न बनाएँ कि समस्या कितनी आम है.
हमने चयन के 3 तरीकों की तुलना कैसे की
स्रोत Ali, Matuszewski और Czupyt का Recipe Reviews and User Feedback डेटासेट है, जिसे UCI ने 2023 में CC BY 4.0 के तहत प्रकाशित किया. इसमें Taste of Home की ऊँची रेटिंग वाली 100 चुनी गई रेसिपी के कमेंट हैं. जारी होने का साल डेटा जुटाने की सटीक तारीख नहीं बताता, और उपलब्ध स्रोत सामग्री से यह स्थापित नहीं होता कि हर मूल कमेंट लिया गया था. यह ऐतिहासिक आर्काइव का विश्लेषण है, प्लेटफ़ॉर्म का मौजूदा मानक नहीं. [1][2][3]
हमने जारी पूरे आर्काइव की जाँच की: 100 रेसिपी क्रमांकों पर 18,182 अलग कमेंट पहचानकर्ता. हर रेसिपी में 10 से अधिक कमेंट थे, इसलिए सभी 100 तुलना में आए. एक व्यक्ति के कई कमेंट, कई कमेंट ही रहते हैं. हमने व्यक्ति के आधार पर डुप्लिकेट नहीं हटाए और न रिव्यू के टेक्स्ट, नाम, यूज़र की प्रतिष्ठा या स्रोत के रैंकिंग स्कोर का विश्लेषण किया.
हर रेसिपी के लिए अपवोट के नियम में दर्ज सबसे अधिक अपवोट वाले 10 कमेंट चुने गए. सबसे नए के नियम में कमेंट बनने के सबसे हाल के 10 टाइमस्टैम्प लिए गए. कटऑफ़ पर बराबरी होने पर बाकी जगहें भरने का हर संभव चयन समान संभावना वाला था. रैंडम चयन में रेसिपी के आर्काइव के हर 10-कमेंट उपसमूह की संभावना बराबर थी.
हर संभव चयन के लिए हमने 6 श्रेणियों वाले उसके रेटिंग वितरण की तुलना पूरे रेसिपी आर्काइव से की, फिर चयन नियम के तहत दूरी का औसत निकाला. सटीक प्रायिकता गणनाओं से यह अपेक्षित मान बिना सिमुलेशन मिलता है. दूरियों का औसत निकालना अहम है: पहले श्रेणियों के हिस्सों का औसत लेकर फिर दूरी निकालना अलग सवाल का जवाब देता और नमूना चयन की भिन्नता छिपा सकता था.
फिर हमने हर रेसिपी के अपेक्षित अंतर का औसत निकाला, हर रेसिपी को बराबर भार देकर. अंतर 1 दशमलव स्थान तक राउंड करने से पहले निकाले गए. 10-कमेंट की सीमा, पात्रता के नियम, तुलनाएँ और रिपोर्ट की योजना लक्ष्य नतीजे देखने से पहले तय थे. बाद में न कोई दूसरी सीमा चुनी गई, न अनुकूल रेसिपी का उपसमूह.
नतीजे इसी सीमित आर्काइव और बताए गए चयन नियमों का वर्णन करते हैं, इसलिए हमने पूरी आबादी का विश्वास अंतराल या कारणात्मक असर नहीं दिया. जमा अपवोट यह नहीं बताते कि कमेंट कितनी बार दिखा या वोट कब मिले. डेटासेट तैयार करने वालों का मूल शोधपत्र टेक्स्ट वर्गीकरण का अध्ययन करता है; यह विश्लेषण UCI की बताई स्टार श्रेणियों से चयन की जाँच करता है. तकनीकी विधि स्रोत फ़ील्ड का अंतर समझाती है. [1][2]
डाउनलोड में समेकित नतीजे, हर रेसिपी क्रमांक की संख्यात्मक जाँच और पुनर्गणना कोड हैं. कमेंट का टेक्स्ट, नाम या यूज़र पहचानकर्ता शामिल नहीं हैं. स्रोत रिकॉर्ड UCI से अलग उपलब्ध हैं; डेटासेट के लेखकों और रिपॉज़िटरी को श्रेय देने से हमारी व्याख्या के समर्थन का अर्थ नहीं निकलता. [1][3]
साइन अप की ज़रूरत नहीं है. डाउनलोड में समेकित तुलनाएँ, रेसिपी के क्रमवार स्थान के हिसाब से संख्यात्मक परिणाम और विधि की अनुवादित व्याख्याएँ हैं. कमेंट का टेक्स्ट, यूज़र नाम या अलग-अलग कमेंट के पहचानकर्ता शामिल नहीं हैं. स्रोत डेटासेट UCI पर अलग से उपलब्ध है. [1]
स्रोत और टिप्पणियाँ
- Ali, A., Matuszewski, S., और Czupyt, J. (2023). Recipe Reviews and User Feedback [डेटासेट]. UCI Machine Learning Repository. DOI: 10.24432/C5FG95. UCI की जानकारी के अनुसार 18,182 कमेंट हैं. स्टार 1–5 हैं और 0 का अर्थ है कि रेटिंग नहीं दी गई. Influence IQ की गणनाएँ जारी आर्काइव पर हैं, वेबसाइट के मौजूदा डेटा पर नहीं.
- डेटासेट तैयार करने वालों का शोधपत्र, “Textual Taste Buds: A Profound Exploration of Emotion Identification in Food Recipes through BERT and AttBiRNN Models,” चुनी गई रेसिपी के स्रोत और टेक्स्ट वर्गीकरण के अध्ययन का वर्णन करता है. उसमें best_score का विवरण UCI के रेटिंग फ़ील्ड से मेल नहीं खाता. हमने stars इस्तेमाल किया; best_score या रिव्यू के टेक्स्ट का विश्लेषण नहीं किया. उपलब्ध सामग्री से स्नैपशॉट का सटीक समय या संग्रह की पूर्णता स्थापित नहीं होती.
- UCI डेटासेट Creative Commons Attribution 4.0 के तहत लाइसेंस किया गया है. Influence IQ ने इससे नई समेकित तुलनाएँ निकाली हैं. डेटासेट को श्रेय देने का मतलब लेखकों, UCI या Taste of Home का समर्थन नहीं है. डाउनलोड में अलग-अलग कमेंट या यूज़र पहचान दोबारा नहीं बाँटी जाती.
- Influence IQ (2026). रेसिपी पर फ़ीडबैक की सैंपलिंग: विश्लेषण विधि, समेकित परिणाम और पुनर्गणना कोड. पैकेज में तय 10 कमेंट वाली तुलना, अपेक्षित टोटल वेरिएशन की सटीक गणनाएँ, बराबरी के मामलों को सँभालने का तरीका और रेसिपी के सभी 100 स्थानों के संख्यात्मक परिणाम दर्ज हैं. स्रोत डेटा UCI से अलग लिया जाता है. मूल तकनीकी फ़ाइलों के साथ अनुवादित व्याख्याएँ हैं.
लेख, योजना का ब्रीफ़, चित्रों के लेबल और परिणामों की CSV लेख की हर भाषा में उपलब्ध हैं. तकनीकी पुनर्गणना पैकेज में अनुवादित व्याख्याएँ हैं. हर संस्करण उसी ऐतिहासिक रेसिपी आर्काइव और विश्लेषण का वर्णन करता है.