एडिट लॉक करने से पहले अनूदित वॉइसओवर की अवधि मापें
अंग्रेज़ी में बोलकर पढ़ा गया पाठ दृश्य में समा सकता है, जबकि अनूदित रिकॉर्डिंग उससे लंबी हो सकती है. शोध के 200 पाठों की हमारी जोड़ीवार स्टडी बताती है कि दृश्य तय करने से पहले, प्रोडक्शन का काम सौंपते समय कई भाषाओं के वॉइसओवर की अवधि शामिल करना क्यों ज़रूरी है.
350 अंग्रेज़ी प्रॉम्प्ट के समूह में से, FLEURS के 10 टेस्ट कॉन्फ़िगरेशन में उपलब्ध समान 200 अनूदित पाठों (प्रॉम्प्ट) की रिकॉर्डिंग अवधि का वर्णनात्मक विश्लेषण. अवधि मेटाडेटा में दी गई है. ये शोध के लिए बोलकर पढ़े गए पाठ हैं, व्यावसायिक वॉइसओवर के काम नहीं. मेटाडेटा 24 अक्टूबर 2026 (UTC) को प्राप्त किया गया.
सार
क्या व्यवसाय को स्थानीय भाषा वाले वीडियो का समय अंग्रेज़ी वॉइसओवर के हिसाब से लॉक करना चाहिए? पहले अनूदित पाठों को बोलकर पढ़ने की अवधि मापें. हमने चुने गए FLEURS के सभी 10 टेस्ट कॉन्फ़िगरेशन में उपलब्ध 200 प्रॉम्प्ट की मेटाडेटा में दी गई रिकॉर्डिंग अवधि की तुलना की. दोहराई गई रीडिंग का हर प्रॉम्प्ट के भीतर मीडियन लेने के बाद, हर प्रॉम्प्ट को समान वज़न दिया गया. अंग्रेज़ी की तुलना में जोड़ीवार बदलाव का मीडियन डच रिकॉर्डिंग के लिए −6.1% से फ़िलिपीनो रिकॉर्डिंग के लिए +82.4% तक था. इनमें से कोई आँकड़ा पूरी भाषा के लिए प्रोडक्शन में अतिरिक्त समय रखने का नियम नहीं है.[1][2]
15 सेकंड का तय उदाहरण काम सौंपने की बात को ठोस बनाता है. जिन 186 प्रॉम्प्ट का अंग्रेज़ी मीडियन उस समय में समाया, उनमें से 110 के फ़िलिपीनो मीडियन उससे अधिक थे. अधिक सख़्त नियम में 178 प्रॉम्प्ट के सभी उपलब्ध अंग्रेज़ी टेक उस समय में समाए, जबकि उनमें से 72 के सभी उपलब्ध फ़िलिपीनो टेक उससे अधिक थे. अलग पाठक, लैंगिक संरचना, अनुवाद और विराम के असर अब भी आपस में उलझे हुए हैं. इस काम का योगदान रिकॉर्डिंग अवधि की ऐसी तुलना है जिसे जाँचा जा सकता है. इसमें सभी 9 लक्षित तुलनाएँ और अवधि के नतीजे निकालने से पहले चुना गया उदाहरण शामिल हैं, ताकि टीम एडिट तय करने से पहले समय मापकर पढ़ा गया पाठ माँग सके.
एडिटर के पास छोटा प्रोडक्ट वीडियो तैयार है. अंग्रेज़ी नैरेशन समय में समा जाता है, प्रोडक्ट तय फ़्रेम पर दिखता है और आख़िरी शॉट में ऑफ़र के लिए जगह है. उसी संदेश की अनूदित स्क्रिप्ट आती है. रिकॉर्डिंग को पहले से तैयार टाइमलाइन में जोड़ने वाली आख़िरी चीज़ मान लेना आसान लगता है.
यहीं जानकारी की कमी प्रोडक्शन की समस्या बन सकती है: किसी ने अनूदित पाठ को बोलकर पढ़ने की अवधि मापी ही नहीं. अर्थ के लिए मंज़ूर स्क्रिप्ट से एडिटर को पता नहीं चलता कि उसकी रिकॉर्डिंग कितना समय लेगी. काम सौंपते समय मंज़ूर शब्दों और रिकॉर्डिंग की अवधि, दोनों का होना उपयोगी है.
हमने अनूदित पाठों को बोलकर पढ़ने वाले शोध कॉर्पस FLEURS में इसी अंतर की जाँच की. समान 200 प्रॉम्प्ट में रिकॉर्डिंग की अवधि के संबंध कॉन्फ़िगरेशन के बीच भी बदले और एक ही पाठ की अलग रीडिंग के बीच भी. नीचे की तालिकाएँ ये अंतर सुरक्षित रखती हैं. वे व्यवसाय या क्रिएटर को असली प्रोडक्शन के लिए अवधि का प्रमाण माँगने की वजह देती हैं, शोध के औसत को अतिरिक्त समय की गारंटी बनाए बिना.
हर रिकॉर्ड किए गए संस्करण की अपनी अवधि रखें
समय का नियम अपनाने से पहले उसी पाठ की तुलना करें
पहली तालिका समान 200 मूल प्रॉम्प्ट के लिए हर लक्षित कॉन्फ़िगरेशन की तुलना अमेरिकी अंग्रेज़ी से करती है. हर प्रॉम्प्ट और कॉन्फ़िगरेशन के लिए हमने उपलब्ध रिकॉर्डिंग अवधि का मीडियन लिया. फिर लक्षित मीडियन को अंग्रेज़ी मीडियन से भाग देकर 1 से अंतर को प्रतिशत में लिखा. अंत में इन 200 जोड़ीवार बदलावों का सार निकाला. इसलिए 3 रीडिंग वाले प्रॉम्प्ट को भी 1 रीडिंग वाले जितना ही वज़न मिला.[2][4]
लैटिन अमेरिकी स्पैनिश रिकॉर्डिंग में जोड़ीवार बदलाव का मीडियन +24.8% था. प्रॉम्प्ट के स्तर पर बदलावों का बीच का आधा हिस्सा +10.2% से +47.0% तक था. जापानी में यही मीडियन +36.6% था और बीच का आधा हिस्सा +17.8% से +61.8% तक था. ये आँकड़े समान पाठों की जारी की गई रिकॉर्डिंग का वर्णन करते हैं; वे यह तय नहीं करते कि किसी भाषा में पाठ कैसे बोला जाना चाहिए.
यह कुल अवधि के 2 मीडियन को भाग देने से अलग है. उन्हीं समान प्रॉम्प्ट में अंग्रेज़ी प्रॉम्प्ट-सारों का मीडियन 9.3 सेकंड था और स्पैनिश का 11.6 सेकंड. दिखाए गए इन आँकड़ों को भाग देने से जोड़ीवार +24.8% नतीजा वापस नहीं मिलेगा. हमने पहले हर पाठ की जोड़ी मिलाई थी, इसलिए छोटे लक्षित पाठ की तुलना उसके अपने अंग्रेज़ी संदर्भ से होती है, वितरण के बीच के किसी दूसरे पाठ से नहीं.
डच रिकॉर्डिंग में जोड़ीवार बदलाव का मीडियन −6.1% था, जबकि फ़िलिपीनो रिकॉर्डिंग में +82.4% था. दोनों को तालिका में रखने से देखे गए संबंधों की पूरी सीमा दिखती है. इससे लेख यह संकेत भी नहीं देता कि हर अनूदित रिकॉर्डिंग लंबी थी. समान समूह में 71 डच प्रॉम्प्ट के मीडियन अंग्रेज़ी से लंबे थे, 2 बराबर थे और बाकी छोटे थे.
पंक्तियाँ विश्लेषण में इस्तेमाल कॉन्फ़िगरेशन के तय क्रम में हैं; उन्हें नतीजे के हिसाब से नहीं सजाया गया है. अपने स्रोत की तुलना से संबंधित पंक्ति पढ़ें और उसके शोध का संदर्भ साथ रखें. लैटिन अमेरिकी स्पैनिश और फ़िलिपीनो डेटासेट के मूल दायरे हैं. लेख दूसरी भाषा में प्रकाशित करने से वे रिकॉर्डिंग उस बाज़ार का प्रमाण नहीं बन जातीं.
अमेरिकी अंग्रेज़ी से रिकॉर्डिंग की लंबाई में जोड़ीवार बदलाव
हर पंक्ति में वही 200 अनूदित मूल प्रॉम्प्ट हैं. हर प्रॉम्प्ट की लक्षित मीडियन अवधि को उसकी अंग्रेज़ी मीडियन अवधि से भाग दिया जाता है; 1 से बदलाव को प्रतिशत में लिखा जाता है. Q25 और Q75 उन जोड़ीवार बदलावों के बीच के आधे हिस्से की सीमाएँ हैं.
| लक्षित रिकॉर्डिंग कॉन्फ़िगरेशन | सापेक्ष बदलाव का मीडियन (%) | 25वें पर्सेंटाइल पर बदलाव (%) | 75वें पर्सेंटाइल पर बदलाव (%) |
|---|---|---|---|
| लैटिन अमेरिकी स्पैनिश | 24.8% | 10.2% | 47.0% |
| फ़्रेंच (फ़्रांस) | 5.7% | -10.0% | 29.1% |
| जर्मन (जर्मनी) | 31.4% | 0.0% | 62.4% |
| डच (नीदरलैंड) | -6.1% | -21.6% | 8.9% |
| इंडोनेशियाई (इंडोनेशिया) | 26.3% | 11.4% | 49.9% |
| मलय (मलेशिया) | 11.3% | -1.2% | 29.1% |
| फ़िलिपीनो (फ़िलिपींस) | 82.4% | 54.2% | 120.1% |
| थाई (थाईलैंड) | 20.8% | 1.6% | 42.0% |
| जापानी (जापान) | 36.6% | 17.8% | 61.8% |
काम के लिए समय तय हो, तो फैलाव मायने रखता है
मीडियन 200 संबंधों को एक संख्या में समेट देता है. किसी खास दृश्य में फिर भी कोई खास रीडिंग समानी होती है. हर मीडियन के साथ दिए क्वार्टाइल बताते हैं कि ब्रीफ़ में सिर्फ़ बीच का मान ले जाने से उस फ़ैसले के लिए उपयोगी जानकारी क्यों छूट जाएगी.
फ़्रेंच रिकॉर्डिंग में जोड़ीवार बदलाव का मीडियन +5.7% था, लेकिन बीच का आधा हिस्सा −10.0% से +29.1% तक फैला था. छोटा केंद्रीय अंतर ऐसे पाठों के साथ मौजूद था जिनकी अवधि अंग्रेज़ी से कम भी थी और अधिक भी. जर्मन रिकॉर्डिंग में बदलाव का मीडियन +31.4% था और बीच का आधा हिस्सा लगभग 0.0% से +62.4% तक था. दिखाया गया 0.0% राउंड किया हुआ है; बिना राउंड किए निचला क्वार्टाइल थोड़ा सकारात्मक था.
ये अंतराल देखे गए जोड़ीवार बदलावों के बीच के आधे हिस्से का वर्णन करते हैं. ये विश्वास अंतराल, न्यूनतम से अधिकतम सीमाएँ या ऐसी सीमा नहीं हैं जिसमें भविष्य की व्यावसायिक रिकॉर्डिंग ज़रूर आएगी. मूल पाठ, अनुवाद और बोलने का अंदाज़ किसी नई प्रोडक्ट स्क्रिप्ट से अलग हैं. तालिका के मीडियन प्रतिशत की हूबहू कॉपी करने पर भी प्रोडक्शन टीम के पास एडिट के लिए ज़रूरी असली टेक नहीं होगा.
इस अंतर से व्यावहारिक सवाल बदल जाता है. यह पूछने के बजाय कि किसी भाषा को हमेशा कितना अतिरिक्त समय चाहिए, प्रोड्यूसर पूछ सकता है कि मंज़ूर अनूदित पाठ को बोलकर पढ़ने पर वह तय दृश्य में समाता है या नहीं. तालिका बताती है कि यह जाँच क्यों उपयोगी है; काम के लिए बनी रिकॉर्डिंग जवाब देती है.
एक पाठ की अलग रिकॉर्डिंग की अवधि अलग हो सकती है
मूल प्रॉम्प्ट 1662 को अवधि का सार निकालने से पहले चुना गया था, क्योंकि वह सभी 10 कॉन्फ़िगरेशन में उपलब्ध सबसे छोटी ID थी. उसकी तालिका में उस प्रॉम्प्ट की हर उपलब्ध रीडिंग है. हमने अवधियाँ देखने के बाद कोई चौंकाने वाला उदाहरण नहीं ढूँढ़ा और यहाँ प्रॉम्प्ट के शब्द या ऑडियो दोबारा नहीं दिए गए हैं.[3][4]
अंग्रेज़ी की 2 फ़ाइलें लगभग 8.4 और 11.2 सेकंड लंबी थीं, जिनका मीडियन 9.8 सेकंड था. जर्मन की 3 फ़ाइलों की अवधि 10.4 से 23.5 सेकंड थी और मीडियन 10.5 था. फ़िलिपीनो की 2 फ़ाइलों की अवधि 22.3 से 24.9 सेकंड थी और मीडियन 23.6 था. ये मूल मेटाडेटा से ली गई पूरी फ़ाइलों की अवधियाँ हैं, जिन्हें दिखाने के लिए 1 दशमलव स्थान तक राउंड किया गया है.
2 रीडिंग का मीडियन किसी की असली रिकॉर्डिंग की अवधि होने के बजाय गणितीय मध्यबिंदु हो सकता है. अंग्रेज़ी का दिखाया गया 9.8 सेकंड ऐसा ही सार है. टेक चुनने वाले एडिटर को फिर भी चुनी गई फ़ाइल की अपनी अवधि से काम करना होगा. टेक की संख्या और न्यूनतम से अधिकतम सीमा, मीडियन के साथ यह अंतर दिखाती हैं.
जर्मन रिकॉर्डिंग का फैलाव यह सावधानी भी सुझाता है कि हर सेकंड को अनुवाद की लंबाई की वजह न मानें. हमारे पास वक्ताओं की ID नहीं हैं और हमने न रिकॉर्डिंग सुनी, न बोलने के समय को विराम से अलग किया. यहाँ पढ़ने का अंदाज़, पाठक और रिकॉर्डिंग की परिस्थितियों के असर अलग नहीं किए जा सकते. उदाहरण प्रोडक्शन के लिए सरल माँग का समर्थन करता है: केवल भाषा के स्तर का अनुमान भेजने के बजाय इच्छित टेक या इच्छित शब्दों की ऐसी रीडिंग भेजें जिसकी अवधि मापी गई हो.
प्रॉम्प्ट 1662: मीडियन के साथ टेक की अवधि की सीमा रखें
सभी 10 कॉन्फ़िगरेशन में रिकॉर्डिंग वाली सबसे छोटी मूल ID, जिसे अवधि के सार निकालने से पहले उपलब्धता के आधार पर चुना गया था. सभी उपलब्ध टेक शामिल हैं. सेकंड मूल मेटाडेटा में पूरी फ़ाइल का वर्णन करते हैं; विराम अलग नहीं किए गए हैं.
| रिकॉर्डिंग कॉन्फ़िगरेशन | उपलब्ध टेक | सबसे छोटी फ़ाइल (सेकंड) | फ़ाइल अवधि का मीडियन (सेकंड) | सबसे लंबी फ़ाइल (सेकंड) |
|---|---|---|---|---|
| अमेरिकी अंग्रेज़ी | 2 | 8.4 | 9.8 | 11.2 |
| लैटिन अमेरिकी स्पैनिश | 3 | 8.8 | 9.5 | 9.5 |
| फ़्रेंच (फ़्रांस) | 2 | 6.4 | 6.8 | 7.1 |
| जर्मन (जर्मनी) | 3 | 10.4 | 10.5 | 23.5 |
| डच (नीदरलैंड) | 1 | 7.9 | 7.9 | 7.9 |
| इंडोनेशियाई (इंडोनेशिया) | 1 | 11.6 | 11.6 | 11.6 |
| मलय (मलेशिया) | 2 | 8.0 | 8.6 | 9.1 |
| फ़िलिपीनो (फ़िलिपींस) | 2 | 22.3 | 23.6 | 24.9 |
| थाई (थाईलैंड) | 3 | 6.5 | 8.7 | 10.1 |
| जापानी (जापान) | 2 | 12.1 | 13.3 | 14.6 |
15 सेकंड के उदाहरण में तुलना का आधार बताना ज़रूरी है
नतीजे निकालने से पहले हमने योजना के उदाहरण के लिए 15 सेकंड तय किए थे. यह प्लैटफ़ॉर्म की शर्त, विज्ञापन की सुझाई गई लंबाई या प्रोडक्शन के लिए सुरक्षित समय की छूट नहीं है. सवाल यह था कि क्या अंग्रेज़ी रिकॉर्डिंग का सार उस समय में समा सकता है, जबकि उसी लक्षित पाठ का सार उससे अधिक हो.
समान 200 प्रॉम्प्ट में से 186 का अंग्रेज़ी मीडियन अधिकतम 15 सेकंड था. उस पात्र समूह में लक्षित मीडियन 15 सेकंड से अधिक था: लैटिन अमेरिकी स्पैनिश के 20 प्रॉम्प्ट, जर्मन के 39 प्रॉम्प्ट, डच के 9 प्रॉम्प्ट, फ़िलिपीनो के 110 प्रॉम्प्ट और जापानी के 37 प्रॉम्प्ट में. हर गिनती की आधार-संख्या 186 है; बाकी तुलनाएँ डाउनलोड में सुरक्षित हैं.[6]
हमने उपलब्ध टेक के लिए अधिक सख़्त नियम भी इस्तेमाल किया. हर उपलब्ध अंग्रेज़ी रीडिंग को 15 सेकंड में समाना था और हर उपलब्ध लक्षित रीडिंग को उससे अधिक होना था. 178 अंग्रेज़ी प्रॉम्प्ट पात्र थे. ऐसा स्पैनिश के 11 प्रॉम्प्ट, जर्मन के 9 प्रॉम्प्ट, डच के 4 प्रॉम्प्ट, फ़िलिपीनो के 72 प्रॉम्प्ट और जापानी के 14 प्रॉम्प्ट में हुआ. ये गिनतियाँ केवल जारी किए गए टेक के बारे में हैं, पाठ को बोलने के हर संभव तरीके के बारे में नहीं.
अधिक सख़्त जाँच ऐसे गणितीय मध्यबिंदु पर निर्भर रहने से बचाती है जिसे किसी ने रिकॉर्ड नहीं किया. फिर भी इससे यह साबित नहीं होता कि पाठ तेज़ नहीं पढ़ा जा सकता, अलग तरह से एडिट नहीं किया जा सकता या उचित ढंग से दोबारा नहीं लिखा जा सकता. टीम के लिए उपयोगी अंतर यह है: दी गई किसी खास रिकॉर्डिंग के समाने का प्रमाण और यह मान लेना कि अंग्रेज़ी समाई थी, इसलिए दूसरा संस्करण भी समा जाएगा.
काल्पनिक लॉन्च बताता है कि काम कब सौंपना चाहिए
मान लें कि रसोई के सामान का काल्पनिक छोटा ब्रैंड किसी क्रिएटर से 15 सेकंड का प्रोडक्ट वीडियो बनवा रहा है. कॉन्सेप्ट में डेमो, ऑफ़र और आख़िरी प्रोडक्ट शॉट है. उसका अंग्रेज़ी पाठ बोलकर पढ़ने में 11 सेकंड लगते हैं. अनूदित ड्राफ़्ट को अर्थ के लिए मंज़ूरी मिल जाती है, लेकिन तय नैरेटर की पहली रीडिंग में 17 सेकंड लगते हैं. इस उदाहरण का ब्रैंड, स्क्रिप्ट, समय और काम काल्पनिक हैं; ये FLEURS में देखी गई बातें नहीं हैं.
अगर क्रिएटर ने हर शॉट पहले ही अंग्रेज़ी रीडिंग के हिसाब से लॉक कर दिया हो, तो 17 सेकंड की फ़ाइल एडिट के आख़िरी दौर में फ़ैसला करने को मजबूर करती है. क्लाइंट का काम सँभालने वाला व्यक्ति, अनूदित शब्दों की समीक्षा के दौरान ही समय मापकर रीडिंग माँगकर, इस फ़ैसले को अनकहा रहने से बचा सकता है. ब्रीफ़ में साफ़ होना चाहिए कि कौन-सा संदेश सही रहना चाहिए, दृश्य के लिए कितना समय है और इनमें बदलाव की मंज़ूरी कौन दे सकता है.
जवाब में नैरेटर को अपने-आप तेज़ बोलने के लिए कहना ज़रूरी नहीं. अनुवादक ऑफ़र सुरक्षित रखते हुए छोटा और स्वाभाविक वाक्य सुझा सकता है. एडिटर डेमो को अधिक समय दे सकता है, कोई कम ज़रूरी जानकारी साथ के टेक्स्ट में रख सकता है या तय फ़ॉर्मैट अनुमति दे, तो अलग कट तैयार कर सकता है. ये चर्चा करने योग्य प्रोडक्शन विकल्प हैं, हमारे कॉर्पस विश्लेषण से साबित सुधार नहीं.
इस काल्पनिक काम को सौंपते समय उपयोगी विवरण ऐसा हो सकता है: “लक्षित संस्करण: __. मंज़ूर स्क्रिप्ट: __. इच्छित टेक: __ सेकंड, दी गई फ़ाइल से मापे गए. दृश्य के लिए समय: __ सेकंड. ऑफ़र के शब्द और ज़रूरी खुलासे: __. स्क्रिप्ट में बदलाव की मंज़ूरी देने वाला व्यक्ति: __. एडिट की मंज़ूरी देने वाला व्यक्ति: __.” ये खाली जगहें असली टीम को भरनी हैं; शोध की तालिका इन्हें नहीं भर सकती.
कई लक्षित संस्करण हों, तो क्लाइंट का काम सँभालने वाला व्यक्ति पूरे प्रोजेक्ट को “अनुवाद मंज़ूर” लिखने के बजाय हर इच्छित टेक के लिए अलग पंक्ति रख सकता है. शब्दों की मंज़ूरी और अवधि की मंज़ूरी अलग सवालों के जवाब देती हैं. शुरुआती ट्रायल रीडिंग के बाद अनुवादक प्रोडक्ट के किसी दावे को बदले, तो क्रिएटर के पुरानी अवधि दोबारा इस्तेमाल करने से पहले वह बदलाव पंक्ति में दिखना चाहिए. यह काल्पनिक काम व्यवस्थित करने का प्रस्तावित तरीका है, प्रोजेक्ट का जोखिम कम करने का जाँचा हुआ उपाय नहीं.
संशोधित टेक मिलने पर क्रिएटर, भाषा और अर्थ के ज़िम्मेदार व्यक्ति के साथ पूरा संस्करण देख-सुन सकता है. सिर्फ़ अवधि से फ़िट तय करने पर असहज बोलने का अंदाज़ या न पढ़ा जा सकने वाला आख़िरी फ़्रेम छूट सकता है. इस स्टडी ने गुणवत्ता या ऑडियंस की प्रतिक्रिया नहीं मापी. काल्पनिक काम में इसका योगदान रिकॉर्डिंग की अवधि पहले जानना है; रचनात्मक फ़ैसले की ज़िम्मेदारी वीडियो बनाने वाले लोगों की ही रहती है.
समीक्षा में शब्द, टेक और दृश्य साथ रखें
कई भाषाओं में वॉइसओवर की अवधि के लिए उपयोगी दस्तावेज़ इतना छोटा हो कि काम के साथ जा सके. उसमें मंज़ूर स्क्रिप्ट का संस्करण, इच्छित रिकॉर्डिंग और दृश्य का समय पहचाना जा सके. इनमें से कुछ बदले, तो अगला काम पाने वाले व्यक्ति को दिखे कि अवधि का कौन-सा प्रमाण अब भी लागू है.
समय मापकर की गई शुरुआती ट्रायल रीडिंग, टीम के पास विकल्प रहते हुए टकराव दिखा सकती है. उसे ट्रायल रीडिंग के रूप में ही चिह्नित रखें; उसे इस बात का प्रमाण न मानें कि अंतिम नैरेटर भी उतना ही समय लेगा. इच्छित टेक मिलने पर अनुमान की जगह उसकी मापी हुई अवधि रखें और असली एडिट में उसकी समीक्षा करें.
उस समीक्षा में अनूदित संस्करण पूरा रखें. अर्थ जाँचने वाले व्यक्ति को दृश्य के साथ बोला गया पाठ सुनना चाहिए, जबकि एडिटर को देखना चाहिए कि विराम, प्रोडक्ट का सामने आना और आख़िरी फ़्रेम साथ कैसे काम करते हैं. फ़ाइल का समय में समाना प्रमाण का एक हिस्सा है; वह संस्करण की हर चीज़ की मंज़ूरी नहीं है.
नीचे के 4 चरण काम सौंपने का सुझाया गया तरीका हैं, FLEURS में जाँचा गया वर्कफ़्लो नहीं. वे शब्दों और रिकॉर्ड की गई अवधि के बीच स्टडी के अंतर को प्रोडक्शन के फ़ैसले पर लागू करते हैं. वे रीच, रिटेंशन, कन्वर्ज़न या प्रोजेक्ट में कितने संशोधन लगेंगे, इसकी कोई गारंटी नहीं देते.
4 बार काम सौंपते हुए रिकॉर्डिंग की अवधि साथ रखें
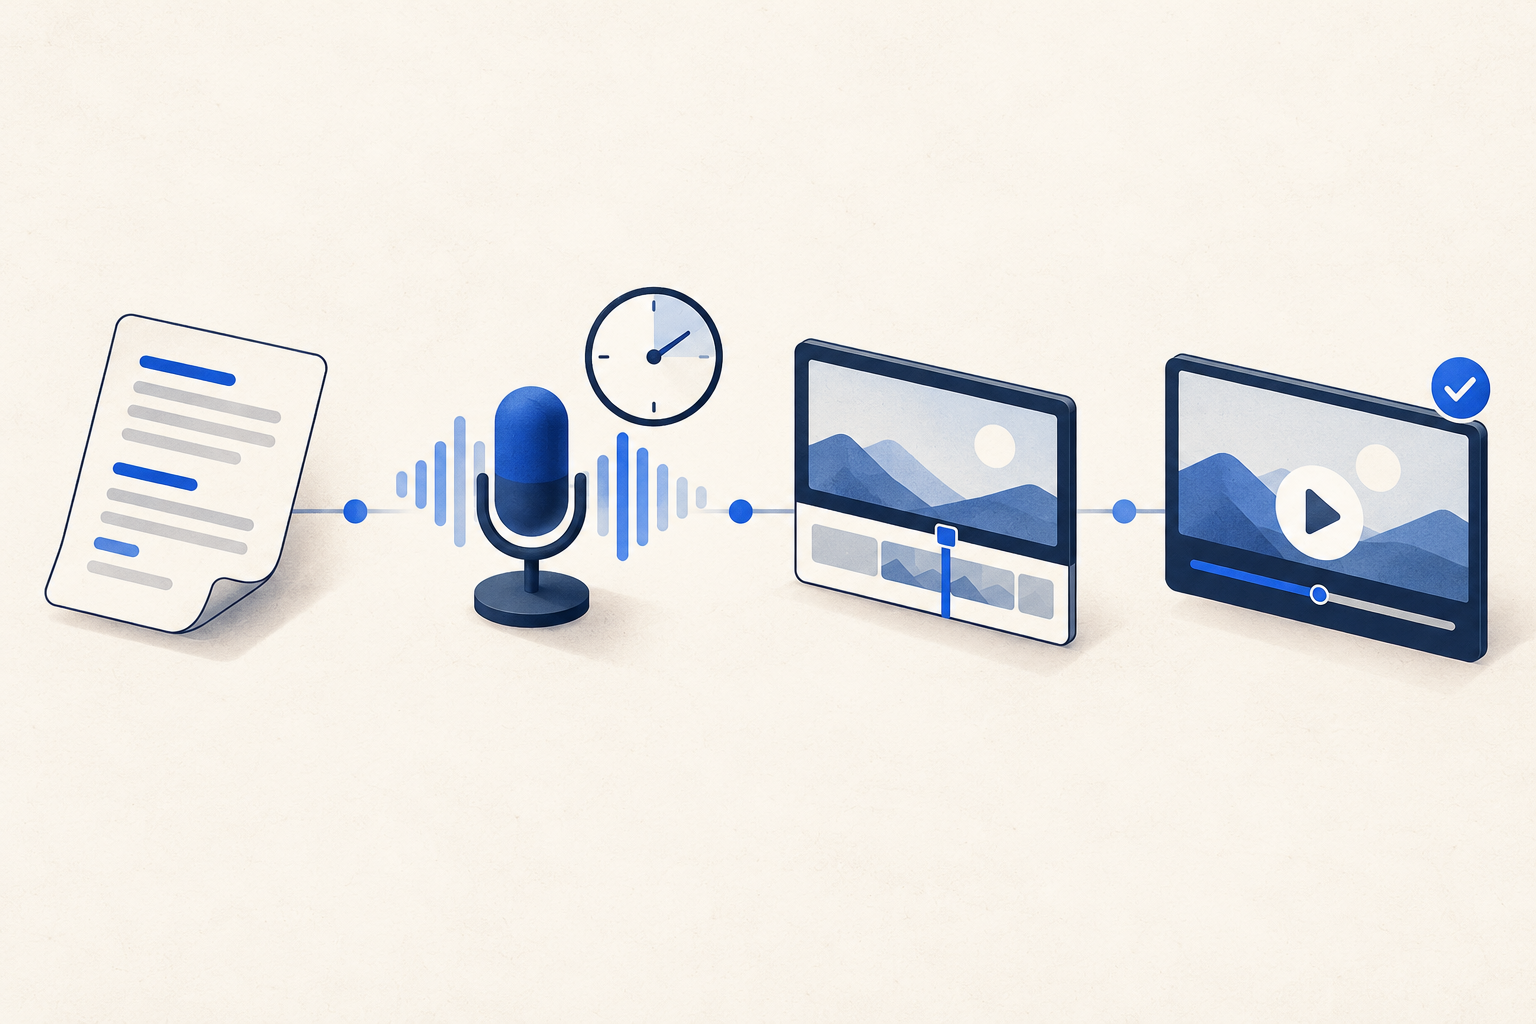
शब्द तय करें
लक्षित संस्करण, मंज़ूर स्क्रिप्ट और अर्थ की समीक्षा करने वाले व्यक्ति को पहचानें.
इच्छित रीडिंग की अवधि मापें
टेक की मापी हुई अवधि साथ दें; शुरुआती ट्रायल रीडिंग को अस्थायी बताएँ.
समय में समाने का हल तय करें
एडिट तय करने से पहले स्क्रिप्ट या दृश्य में किसी भी बदलाव पर सहमति लें.
पूरा संस्करण जाँचें
चुना गया टेक दृश्य, ऑफ़र और आख़िरी फ़्रेम के साथ जाँचें.
कोई आँकड़ा दोबारा इस्तेमाल करें, तो मेल खाता समूह भी दिखाएँ
समान समूह की तुलना में 350 अंग्रेज़ी टेस्ट प्रॉम्प्ट में से 200 शामिल हैं. बाकी 150 में चुना गया कम-से-कम एक कॉन्फ़िगरेशन उपलब्ध नहीं था. पूरी उपलब्धता चुनिंदा हो सकती है, इसलिए समान समूह को स्क्रिप्ट, भाषाओं या वॉइसओवर के कामों का यादृच्छिक नमूना नहीं कहना चाहिए.
हमने हर अंग्रेज़ी–लक्षित तुलना सभी उपलब्ध मेल खाने वाली जोड़ियों के साथ दोहराई. आधार-संख्याएँ डच के लिए 251 से फ़िलिपीनो और थाई के लिए 349 तक थीं. हमने समान समूह की तुलनाएँ केवल उन प्रॉम्प्ट के साथ भी दोहराईं जिनमें कम-से-कम 2 अंग्रेज़ी रीडिंग और 2 लक्षित रीडिंग थीं; ये उपसमूह 66 से 166 प्रॉम्प्ट तक थे. सभी 9 जोड़ीवार नतीजे और उनकी आधार-संख्याएँ डाउनलोड में हैं.[4]
दोहराई गई रीडिंग के उपसमूहों में हर कॉन्फ़िगरेशन के मीडियन जोड़ीवार बदलाव की दिशा मुख्य तुलना जैसी रही. यह सार निकालने के इस खास तरीके की उपयोगी जाँच है. इससे पाठकों का असर नियंत्रित नहीं होता और अलग जोड़ीवार नमूने तुलना योग्य आबादियाँ नहीं बन जाते. दोहराए गए टेक स्वतंत्र प्रतिभागी नहीं हैं.
प्राप्त जर्मन, डच, इंडोनेशियाई, मलय और फ़िलिपीनो रिकॉर्डिंग में सभी पर पुरुष का लेबल था; थाई रिकॉर्डिंग में सभी पर महिला का लेबल था. अंग्रेज़ी, स्पैनिश, फ़्रेंच और जापानी में मिले-जुले लेबल थे. वक्ताओं की ID के बिना विश्लेषण, कॉन्फ़िगरेशन के असर को पाठकों की संरचना, बोलने के अंदाज़, अनुवाद या रिकॉर्डिंग के शामिल रहने के असर से अलग नहीं कर सकता. तालिका को इन्हीं रिकॉर्डिंग का विवरण मानकर पढ़ें और कोई आँकड़ा दोबारा इस्तेमाल करें, तो यह सीमा भी साथ रखें.[7]
रिकॉर्डिंग की अवधि की तुलना कैसे की गई
FLEURS शोध का कॉर्पस है, जिसे 2022 में अनूदित पाठों को बोलकर पढ़ने वाली रिकॉर्डिंग के साथ पेश किया गया था. निर्माता और TensorFlow Datasets के दस्तावेज़ भाषाओं में समान मूल-पाठ ID और 16,000 Hz पर ऑडियो के कुल फ़्रेम का मेटाडेटा फ़ील्ड बताते हैं. हमने उस फ़ील्ड को 16,000 से भाग देकर, मेटाडेटा में दी गई पूरी फ़ाइल की अवधि सेकंड में निकाली. हमने ऑडियो डिकोड नहीं किया, वेवफ़ॉर्म की लंबाई नहीं जाँची और मौन नहीं हटाया.[1][2]
हमने टिप्पणियों में दर्ज निर्माता के तय संस्करण से 24 अक्टूबर 2026 (UTC) को 10 टेस्ट मेटाडेटा फ़ाइलें प्राप्त कीं. उपलब्ध प्रॉम्प्ट में उनकी कुल 7,528 रिकॉर्डिंग हैं. मिलान मूल ID से किया गया, पंक्ति की स्थिति से कभी नहीं. समान 200 प्रॉम्प्ट का समूह, 15 सेकंड के नियम, दोहराई गई रीडिंग की जाँच और उदाहरण 1662, उपलब्धता पता चलने के बाद और अवधि के सार निकालने से पहले तय किए गए थे.[3][4]
प्राप्त करने की तारीख स्रोत की उस समय की प्रति को पहचानती है जिसे हमने इस्तेमाल किया. उससे 2022 के शोध कॉर्पस के साथ पेश की गई रिकॉर्डिंग, नैरेटर या क्रिएटर का 2026 का सर्वे नहीं बन जातीं. सार्वजनिक डेटा में स्रोत का संस्करण सुरक्षित है, ताकि बाद में पढ़ने वाला व्यक्ति पुरानी सामग्री के नए विश्लेषण और नई जुटाई गई रीडिंग में अंतर कर सके.
पहले डेवलपमेंट स्प्लिट पर व्यवहार्यता जाँच में केवल 91 समान प्रॉम्प्ट मिले थे, जो उसकी 100 प्रॉम्प्ट की सीमा से कम थे, इसलिए उसे अलग रख दिया गया. टेस्ट डेटा प्राप्त करना पहले थाई मेटाडेटा की आकार-सीमा पर रुक गया था; दर्ज की गई बड़ी सीमा से वही तय टेस्ट समूह पूरा हुआ. ये व्यवहार्यता और पहुँच में बताए गए बदलाव हैं, नतीजों से अनजान रहकर पहले से पंजीकृत स्टडी का प्रमाण नहीं.
सभी जोड़ीवार गणनाओं में फ़्रेम की सटीक गिनती और भिन्न इस्तेमाल हुए. क्वार्टाइल के लिए (n−1) × p से तय स्थानों पर रैखिक इंटरपोलेशन किया गया. तालिकाएँ प्रतिशत और सेकंड को half-up राउंडिंग से 1 दशमलव स्थान तक दिखाती हैं; टेक की गिनती पूर्णांक रहती है. सार्वजनिक रूप से निकाले गए डेटा में प्रॉम्प्ट के सटीक सार, जोड़ीवार नतीजे, संवेदनशीलता जाँच और समय की दोनों परिभाषाएँ सुरक्षित हैं. हमने आबादी के विश्वास अंतराल या कारणात्मक प्रभाव नहीं निकाले.[4]
डबिंग में समय की सीमाएँ पहले से शोध का स्थापित विषय हैं.[5] यह लेख इन तय पाठों की जारी की गई फ़ाइलों की अवधि की ऐसी तुलना जोड़ता है जिसे दोहराया जा सकता है, साथ ही उसके दायरे और दोहराए गए टेक जाँचने की जानकारी देता है. यह एडिट लॉक करने से पहले अनूदित प्रोडक्शन के लिए अवधि का प्रमाण माँगने का समर्थन करता है; यह हर जगह लागू होने वाला विस्तार प्रतिशत नहीं देता.
- दिखाए गए 67 नतीजे डाउनलोड करें (CSV)
- सभी 350 प्रॉम्प्ट × 10 कॉन्फ़िगरेशन और टेक के सार डाउनलोड करें (CSV)
- सभी 9 जोड़ीवार तुलनाएँ, संवेदनशीलता जाँच और समय-नियम की गिनतियाँ डाउनलोड करें (CSV)
- स्रोत, तरीका और दोहराने का कोड डाउनलोड करें (ZIP)
साइन अप ज़रूरी नहीं. निकाले गए डेटा में अनुपलब्ध संयोजन और तुलना की असली आधार-संख्याएँ सुरक्षित हैं. साझा पैकेज में अंग्रेज़ी में तरीके के दस्तावेज़, स्रोत के संदर्भ और दोहराने का कोड है; मूल पाठ या ऑडियो दोबारा वितरित नहीं किए जाते. हर भाषा का संस्करण उसी तय कॉर्पस का वर्णन करता है.[8]
शोध की टिप्पणियाँ
- Conneau और अन्य, FLEURS: Few-shot Learning Evaluation of Universal Representations of Speech (2022), खंड 2.1–2.3. कॉर्पस में अनूदित पाठों को बोलकर पढ़ने की रिकॉर्डिंग हैं, हर वाक्य के लिए अधिकतम 3 सत्यापित रिकॉर्डिंग, 16 kHz पर सैंपल की गई. उन्हें जुटाने का तरीका और शोध का उद्देश्य, व्यावसायिक वॉइसओवर प्रोडक्शन के लिए प्रतिनिधित्व साबित नहीं करते. मूल पाठ FLORES से आते हैं; वे विज्ञापन की स्क्रिप्ट का नमूना नहीं हैं.
- TensorFlow Datasets, xtreme_s संस्करण 2 के फ़ीचर दस्तावेज़ और उसे सँभालने वाला पार्सर. मूल-पाठ ID भाषाओं में समान है और अलग रीडिंग में दोहराई जा सकती है; num_samples ऑडियो के कुल फ़्रेम दर्ज करता है. ऑडियो फ़ीचर 16,000 Hz बताता है. पार्सर मेटाडेटा की गिनती कॉपी करता है, उसे डिकोड किए वेवफ़ॉर्म से जाँचता नहीं. हमारे सेकंड मेटाडेटा में दी गई पूरी फ़ाइल की अवधि हैं; विराम अलग नहीं किए गए और वक्ता की पहचान नियंत्रित नहीं की गई.
- Google FLEURS मेटाडेटा, तय संस्करण ab93cf03f9d0cd083c853fad065a6377067408aa, टेस्ट भाग, 24 अक्टूबर 2026 (UTC) को प्राप्त. कॉन्फ़िगरेशन: en_us, es_419, fr_fr, de_de, nl_nl, id_id, ms_my, fil_ph, th_th और ja_jp. लिंक की गई अंग्रेज़ी TSV, 10 मूल फ़ाइलों में से एक है; पैकेज हर स्रोत का सटीक URL और SHA256 दर्ज करता है. मूल स्पैनिश लैटिन अमेरिकी है और fil_ph फ़िलिपीनो है.
- Influence IQ की गणनाएँ: हर कॉन्फ़िगरेशन में हर प्रॉम्प्ट का एक मीडियन; हर प्रॉम्प्ट को समान वज़न; लक्षित और अंग्रेज़ी मीडियन का जोड़ीवार अनुपात और सेकंड में जोड़ीवार अंतर. मुख्य आधार 350 अंग्रेज़ी प्रॉम्प्ट में से सभी 10 कॉन्फ़िगरेशन में समान 200 प्रॉम्प्ट हैं. दूसरी तुलनाओं में सभी उपलब्ध अंग्रेज़ी–लक्षित जोड़ियाँ और दोनों ओर कम-से-कम 2 टेक वाले समान प्रॉम्प्ट इस्तेमाल होते हैं. तरीका और उदाहरण का चयन उपलब्धता पता चलने के बाद, अवधि के सार निकालने से पहले तय हुए थे. दोहराने के पैकेज में सटीक भिन्न, इंटरपोलेशन, राउंडिंग और सभी आधार-संख्याएँ दर्ज हैं.
- Dubbing in Practice: A Large-scale Study of Human Localization With Insights for Automatic Dubbing (2023). पहले का शोध पेशेवर मानवीय डबिंग में समय की जाँच कर चुका है. हमारा योगदान FLEURS की फ़ाइल-अवधियों की सीमित जोड़ीवार तालिका और प्रोडक्शन में काम सौंपने के लिए उसकी दोबारा इस्तेमाल की जा सकने वाली व्याख्या है. यह डबिंग में समय की सीमाओं की खोज या पेशेवर डबिंग का बेंचमार्क नहीं है.
- योजना के उदाहरण के लिए 15 सेकंड की अवधि नतीजों से पहले तय थी. मीडियन नियम: 186 समान प्रॉम्प्ट का अंग्रेज़ी मीडियन ≤15 सेकंड है; गिनती उन प्रॉम्प्ट की है जिनका लक्षित मीडियन >15 है. सभी उपलब्ध टेक का नियम: 178 प्रॉम्प्ट में हर अंग्रेज़ी टेक ≤15 है; गिनती उन प्रॉम्प्ट की है जिनका हर उपलब्ध लक्षित टेक >15 है. सीमा के बराबर अवधि समय में समाती है. ये जारी रिकॉर्डिंग के वर्णनात्मक नतीजे हैं, प्लैटफ़ॉर्म की सलाह या हर संभव रीडिंग के बारे में दावा नहीं.
- प्राप्त मेटाडेटा में वक्ताओं की ID नहीं हैं. जर्मन, डच, इंडोनेशियाई, मलय और फ़िलिपीनो रिकॉर्डिंग में सभी पर पुरुष का लेबल है; थाई में सभी पर महिला का लेबल है. कॉन्फ़िगरेशन अनुपलब्ध होने से समान समूह में 350 अंग्रेज़ी प्रॉम्प्ट में से 150 हट जाते हैं. जोड़ीवार और दोहराई गई रीडिंग की जाँच अलग सीमित उपसमूहों का वर्णन करती है. वे कलाकार, लिंग, बोलने के अंदाज़, अनुवाद या रिकॉर्डिंग के शामिल रहने के मिले-जुले असर नहीं हटातीं. कोई विश्वास अंतराल, भाषा की गति की रैंकिंग, कारणात्मक प्रभाव या व्यावसायिक पूर्वानुमान रिपोर्ट नहीं किया गया है.
- स्रोत: Google FLEURS, CC BY 4.0 के तहत उपलब्ध. चयन, गणनाएँ, तालिकाएँ, संपादकीय व्याख्या और अनुवाद Influence IQ के रूपांतरण हैं; डेटासेट के लेखकों का समर्थन निहित नहीं है. सार्वजनिक पैकेज निकाले गए संख्यात्मक सार और कोड दोबारा वितरित करता है, मूल ऑडियो या पाठ नहीं. दिखाने के लिए राउंड करने से स्रोत की सटीक गिनती या साझा रिकॉर्डिंग समूह नहीं बदलता.
सभी भाषाओं के संस्करणों का स्रोत अंग्रेज़ी लेख है. हर संस्करण उन्हीं तय FLEURS टेस्ट रिकॉर्डिंग और अनूदित पाठों की रिपोर्ट देता है; लेख की भाषा किसी नए बाज़ार के बारे में प्रमाण नहीं बनाती. विश्लेषण, व्याख्या और अनुवाद की ज़िम्मेदारी Influence IQ की है.