कई जगहों की मार्केटिंग: वेबसाइट और सोशल लिंक का आपसी संबंध
एक साझा सोशल लिंक के साथ वेबसाइट के कई विकल्प हो सकते हैं. इसका उलटा भी होता है. स्थानों के डेटा की 10 एक्सपोर्ट फ़ाइलों की तुलना बताती है कि कैंपेन ब्रीफ़ में हर रिकॉर्ड का दोनों गंतव्यों से संबंध क्यों बनाए रखना चाहिए.
10–13 अक्तूबर 2026 को एकत्र किए गए AllThePlaces के 10 चुने हुए डेटा संग्राहकों की एक्सपोर्ट फ़ाइलों का Influence IQ विश्लेषण. URL पर आधारित तुलना में वेबसाइट और Facebook, दोनों के लिंक वाले 3,843 रिकॉर्ड हैं. स्रोत संदर्भ एक्सपोर्ट फ़ाइलों के पहचानकर्ता हैं, सत्यापित भौतिक स्थान नहीं.
सार
कई जगहों वाले कैंपेन में हर रिकॉर्ड का उसकी वेबसाइट और सोशल लिंक, दोनों से संबंध बनाए रखें, भले ही कोई लिंक दोहराया गया हो. हमने 10–13 अक्तूबर 2026 को एकत्र किए गए AllThePlaces के 10 चुने हुए डेटा संग्राहकों की एक्सपोर्ट फ़ाइलों में उन्हीं स्रोत संदर्भों पर दिए लिंक की तुलना की. वेबसाइट और Facebook, दोनों के URL वाले 3,843 रिकॉर्ड में Staples की फ़ाइल में 1 Facebook URL के साथ 1,758 अलग-अलग वेबसाइट URL जुड़े हैं. Lush में उलटा संबंध है: 13 वेबसाइट URL के साथ 408 अलग-अलग Facebook URL हैं. 7 संग्राहकों के सभी जोड़ी वाले रिकॉर्ड में एक-से-एक संबंध है. [1]
यह तुलना दिए गए टेक्स्ट मानों और एक्सपोर्ट फ़ाइलों के पहचानकर्ताओं की है, सत्यापित पेज, खातों या भौतिक स्थानों की नहीं. इन फ़ाइलों में केवल Facebook के लिए URL की जोड़ियाँ हैं. Instagram और Twitter के शाब्दिक टेक्स्ट मान (टोकन) अलग से दिए गए हैं. 10 फ़ाइलों में 15,797 ऐसे रिकॉर्ड हैं जिनकी स्रोत पहचान तय हो चुकी है, इसलिए कवरेज तालिका में अधूरी जोड़ियाँ भी दिखती हैं. व्यावहारिक सीख यह है कि गंतव्यों को मंज़ूरी देते समय हर संदर्भ का वेबसाइट और सोशल लिंक से संबंध और कैंपेन का तय दायरा बनाए रखें, भले ही लिंक को केवल एक बार सहेजा गया हो.
क्रिएटर के पास स्थानीय ऑफ़र, डिज़ाइन और लिंक की सूची है. पोस्ट को मंज़ूरी मिलने से पहले किसी को अभी भी तय स्थान का उस सूची की सही प्रविष्टियों से संबंध जोड़ना होगा. अगर कई रिकॉर्ड में साझा सोशल लिंक है, तो क्या उनका वेबसाइट गंतव्य भी साझा होना चाहिए?
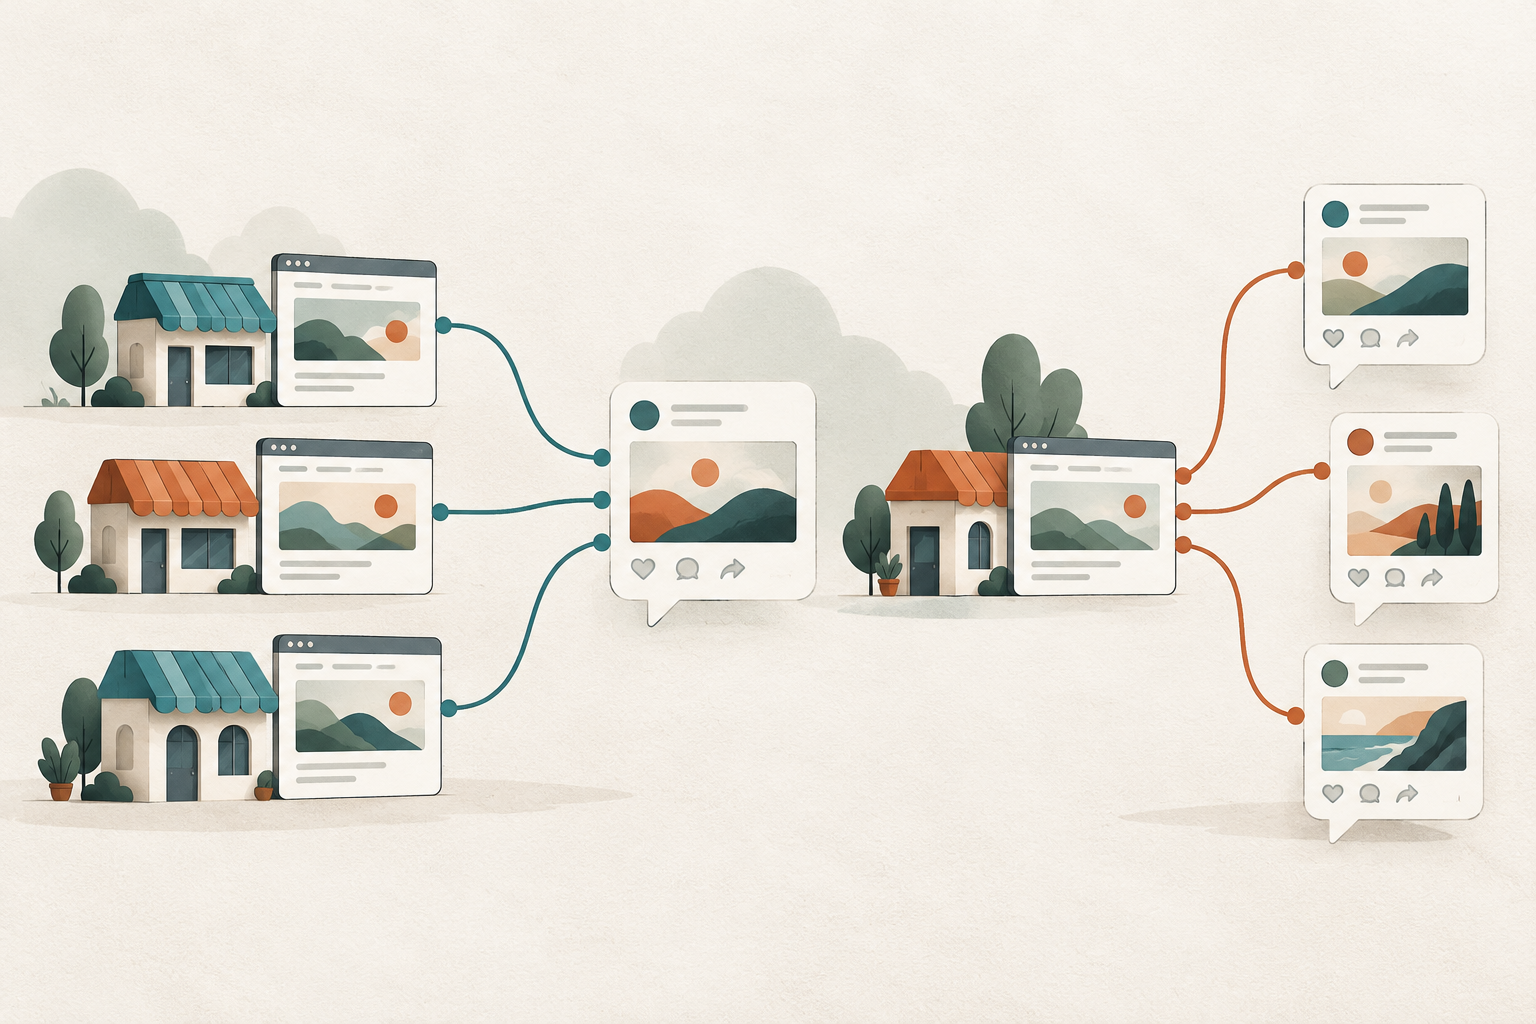
दिए गए लिंक के समूह हमेशा एक जैसे नहीं होते. इन फ़ाइलों में कुछ रिकॉर्ड के दोनों तरफ़ अलग-अलग लिंक हैं. कुछ में Facebook लिंक साझा है, लेकिन वेबसाइट URL अलग हैं. कुछ में वेबसाइट साझा है, लेकिन Facebook URL अलग हैं. ये संबंध दिखते रहने से ब्रीफ़ तैयार करने वाला व्यक्ति ज़्यादा स्पष्टता से चुनाव कर सकता है.
संबंध किसी भी दिशा में हो सकता है
दोनों लिंक वाले रिकॉर्ड से शुरू करें
तुलना की शुरुआत स्रोत संदर्भ से होती है: एक्सपोर्ट फ़ाइल में रिकॉर्ड से जुड़ा पहचानकर्ता. हम उस पहचानकर्ता को उसे देने वाले डेटा संग्राहक के साथ रखते हैं. संग्राहक AllThePlaces के लिए डेटा एकत्र करता है; ज़रूरी नहीं कि वह 1 ब्रांड हो. उदाहरण के लिए Bravo की फ़ाइल में कई ब्रांड हो सकते हैं, जबकि OZK की फ़ाइल में बैंक और ATM के रिकॉर्ड हैं. [1]
10 फ़ाइलों में 3,843 रिकॉर्ड में इस्तेमाल योग्य वेबसाइट URL और इस्तेमाल योग्य Facebook URL, दोनों थे. हमने हर संग्राहक के उन्हीं रिकॉर्ड पर इन 2 फ़ील्ड की तुलना की. बाकी सोशल फ़ील्ड में URL के बजाय शाब्दिक टेक्स्ट मान थे, इसलिए उनके परिणाम लेख में आगे अलग से दिए गए हैं.
तालिका बताती है कि यह संबंध कितना अलग हो सकता है. Arcaplanet के 484 जोड़ी वाले रिकॉर्ड में 484 अलग-अलग वेबसाइट URL और 484 अलग-अलग Facebook URL हैं. AutoZone में हर गिनती 692 है. Bravo, J.Crew, Madewell, PetSuites और Coffee Bean के भी जोड़ी वाले सेट में हर रिकॉर्ड का अलग वेबसाइट URL और अलग Facebook URL है.
इसलिए इस तुलना में 10 में से 7 संग्राहकों में सीधा एक-से-एक संबंध है. मूल जोड़ियाँ रखने वाली टीम कोई अतिरिक्त समूह बनाए बिना उस संबंध को अपने ब्रीफ़ में रख सकती है. Staples, Lush और OZK के ज़्यादा केंद्रित समूहों के साथ ये मामले भी निष्कर्ष का हिस्सा हैं.
यहाँ “अलग” का मतलब हमारे सीमित बदलाव वाले तुलना नियमों के अनुसार दिए गए URL के अलग-अलग टेक्स्ट मान हैं. हम पाथ, क्वेरी और फ़्रैगमेंट सुरक्षित रखते हैं. हम गंतव्यों पर जाकर जाँच नहीं करते और लिंक सिर्फ़ इसलिए नहीं मिलाते कि शायद वे एक ही पेज खोलते हों. गिनतियाँ लिंक की सूची बताती हैं, सत्यापित अलग पेज या खाते नहीं. [2]
10 एक्सपोर्ट फ़ाइलों में वेबसाइट और Facebook लिंक के समूह अलग-अलग हैं
10–13 अक्तूबर 2026 को एकत्र की गई AllThePlaces फ़ाइलें. हर पंक्ति में केवल वेबसाइट URL और Facebook URL, दोनों वाले रिकॉर्ड हैं. तय तुलना नियमों के अनुसार अलग लिंक का मतलब दिए गए URL के अलग टेक्स्ट मान हैं.
| संग्राहक की एक्सपोर्ट फ़ाइल | दोनों URL वाले रिकॉर्ड | अलग-अलग वेबसाइट URL | अलग-अलग Facebook URL |
|---|---|---|---|
| Arcaplanet | 484 | 484 | 484 |
| AutoZone | 692 | 692 | 692 |
| Bravo | 7 | 7 | 7 |
| J.Crew | 69 | 69 | 69 |
| Lush | 408 | 13 | 408 |
| Madewell | 24 | 24 | 24 |
| OZK | 242 | 2 | 242 |
| PetSuites | 93 | 93 | 93 |
| Staples | 1,804 | 1,804 | 47 |
| The Coffee Bean & Tea Leaf | 20 | 20 | 20 |
अधूरे रिकॉर्ड भी दिखते रहने दें
3,843 जोड़ियाँ ऐसे 15,797 स्रोत रिकॉर्ड से आती हैं जिनकी पहचान तय हो चुकी है. जोड़ी की तुलना दोनों फ़ील्ड वाले रिकॉर्ड का सवाल हल करती है; यह फ़ाइलों में मिली हर चीज़ का पूरा विवरण नहीं है. 10 फ़ाइलों में 9,174 रिकॉर्ड में वेबसाइट URL है, Facebook URL नहीं. 8 में Facebook है, वेबसाइट नहीं और 2,772 में दोनों नहीं हैं. [4]
कवरेज में काफ़ी अंतर है. PetSuites के 94 में से 93 रिकॉर्ड में दोनों URL हैं. AutoZone के 7,400 में से 692 में दोनों हैं, हालाँकि सभी 7,400 में वेबसाइट URL है. Staples के 5,425 में से 1,804 में दोनों हैं. उसके 2,727 रिकॉर्ड में इन 2 फ़ील्ड में से कोई भी नहीं है. स्रोत का कुल और जोड़ियों का कुल साथ रखने से ये अंतर दिखते हैं.
नीचे हर फ़ील्ड वाले रिकॉर्ड गिने गए हैं, इसलिए वेबसाइट और Facebook के कॉलम में कुछ रिकॉर्ड साझा हैं. ये अलग-अलग गंतव्यों की गिनतियाँ नहीं हैं और इन्हें अलग समूह मानकर जोड़ना नहीं चाहिए. पहले की संबंधों वाली तालिका केवल अपने जोड़ी वाले रिकॉर्ड में अलग-अलग लिंक गिनती है.
इस स्रोत में कोई फ़ील्ड न होना आगे जाँचने की बात है, इस बात का प्रमाण नहीं कि व्यवसाय की वेबसाइट या सोशल मौजूदगी नहीं है. डेटा एकत्र करने की प्रक्रिया तय कर सकती है कि एक्सपोर्ट फ़ाइल में क्या बचता है. AutoZone का मौजूदा कोड कुछ सोशल मान हटाता है और बाद में जानकारी जोड़ने की प्रक्रिया खाली मान भर सकती है. मौजूदा कोड समझाता है कि स्रोत में छूटी जानकारी को सावधानी से क्यों पढ़ना चाहिए, लेकिन हम यह तय नहीं कर सकते कि हर ऐतिहासिक फ़ील्ड किस कोड संस्करण से बना. [5]
कैंपेन की कामकाजी शीट में अधूरे रिकॉर्ड को उनके संदर्भों के साथ अलग समीक्षा सूची में रखें. दर्ज करें कि किस फ़ील्ड की जाँच चाहिए और उसे कौन हल करेगा. इससे विकल्पों की छोटी सूची बनाते समय अधूरी जोड़ी चुपचाप गायब नहीं होगी. उसका आख़िरी गंतव्य तय करने का काम मौजूदा समीक्षा में ही होगा.
जोड़ी की तुलना हर स्रोत एक्सपोर्ट के कुछ हिस्से को कवर करती है
10–13 अक्तूबर 2026 को एकत्र की गई AllThePlaces की 10 चुनी हुई एक्सपोर्ट फ़ाइलों के रिकॉर्ड. हर फ़ील्ड की गिनती में उस संग्राहक के वे सभी संदर्भ आते हैं जिनकी स्रोत पहचान तय है. इनमें वे रिकॉर्ड भी हैं जो वेबसाइट और Facebook की जोड़ी की तुलना में नहीं आ सकते.
| संग्राहक की एक्सपोर्ट फ़ाइल | स्रोत पहचान तय हो चुके सभी रिकॉर्ड | वेबसाइट URL वाले रिकॉर्ड | Facebook URL वाले रिकॉर्ड | दोनों URL वाले रिकॉर्ड |
|---|---|---|---|---|
| Arcaplanet | 626 | 626 | 484 | 484 |
| AutoZone | 7,400 | 7,400 | 692 | 692 |
| Bravo | 250 | 241 | 7 | 7 |
| J.Crew | 693 | 658 | 76 | 69 |
| Lush | 678 | 676 | 408 | 408 |
| Madewell | 162 | 159 | 25 | 24 |
| OZK | 275 | 274 | 242 | 242 |
| PetSuites | 94 | 94 | 93 | 93 |
| Staples | 5,425 | 2,698 | 1,804 | 1,804 |
| The Coffee Bean & Tea Leaf | 194 | 191 | 20 | 20 |
हैंडल जैसे दिए गए मान को URL से अलग रखें
Instagram और Twitter की फ़ील्ड को अलग तरह से पढ़ना चाहिए. इन 10 फ़ाइलों में उनके खाली न होने वाले इस्तेमाल योग्य मान पूरे URL के बजाय शाब्दिक टेक्स्ट हैं. कुछ हैंडल जैसे लगते हैं, लेकिन विश्लेषण उन्हें सत्यापित नहीं करता और उनसे लिंक नहीं बनाता. हम वर्तनी, बड़े-छोटे अक्षर और शुरुआत का कोई भी @ जस का तस रखते हैं और इन टेक्स्ट मानों की तुलना अलग से करते हैं. [6]
वेबसाइट URL भी मौजूद होने पर Instagram टेक्स्ट मान वाले 3,711 रिकॉर्ड और Twitter टेक्स्ट मान वाले 3,501 रिकॉर्ड हैं. दोनों सेट में एक ही स्रोत संदर्भ हो सकते हैं, इसलिए उन्हें जोड़ने से अलग-अलग स्थानों की गिनती नहीं मिलेगी. तालिका में हर संग्राहक और प्लेटफ़ॉर्म का मेल रखा गया है, जिसमें 0 जोड़ी वाले रिकॉर्ड भी शामिल हैं.
टेक्स्ट मानों के परिणाम यह भी बताते हैं कि काम सौंपने से पहले फ़ॉर्मैट जाँचना क्यों ज़रूरी है. Staples में Instagram टेक्स्ट मान वाली 2,697 जोड़ियाँ हैं, जिनमें 2,697 वेबसाइट URL और 2 अलग शाब्दिक टेक्स्ट मान हैं. J.Crew में Instagram टेक्स्ट मान वाली 658 जोड़ियाँ, 655 वेबसाइट URL और 3 टेक्स्ट मान हैं. PetSuites में 86 जोड़ियाँ, 86 वेबसाइट URL और 86 टेक्स्ट मान हैं. ये मान कहाँ ले जाते हैं, इसकी जाँच से पहले ही दिए गए संबंधों में अंतर दिखता है.
टेक्स्ट मान स्रोत की उपयोगी जानकारी हो सकता है, भले ही वह कैंपेन के गंतव्य वाले फ़ील्ड में पेस्ट करने के लिए तैयार न हो. मूल मान बनाए रखें, उसका प्लेटफ़ॉर्म पहचानें और बाद में सत्यापित किए गए URL को अलग फ़ील्ड में रखें. दर्ज करें कि उसे किसने और कब सत्यापित किया. इससे एक्सपोर्ट फ़ाइल में दी जानकारी और कैंपेन टीम के मंज़ूर किए विकल्प का अंतर बना रहता है.
यह तालिका मानों के रूप की जाँच है, प्लेटफ़ॉर्म की रैंकिंग या सत्यापित खातों की गिनती नहीं. रिपोर्ट में URL और टेक्स्ट मान के परिणाम अलग रहने चाहिए, वैसे ही जैसे कामकाजी ब्रीफ़ में इन 2 रूपों का अंतर बना रहना चाहिए.
शाब्दिक सोशल मान सूची का अलग हिस्सा बने रहते हैं
10–13 अक्तूबर 2026 को एकत्र किए गए AllThePlaces के सभी 10 चुने हुए संग्राहकों की एक्सपोर्ट फ़ाइलें. हर पंक्ति वेबसाइट URL को दिए गए सोशल फ़ील्ड के शाब्दिक टेक्स्ट मान से जोड़ती है. इन फ़ाइलों में Instagram या Twitter के लिए URL की कोई जोड़ी नहीं मिली.
संग्राहक और प्लेटफ़ॉर्म की सभी 20 पंक्तियाँ देखें
| संग्राहक की एक्सपोर्ट फ़ाइल और सोशल फ़ील्ड | वेबसाइट URL और टेक्स्ट मान वाले रिकॉर्ड | अलग-अलग वेबसाइट URL | अलग-अलग शाब्दिक टेक्स्ट मान |
|---|---|---|---|
| Arcaplanet · Twitter फ़ील्ड | 0 | 0 | 0 |
| Arcaplanet · Instagram फ़ील्ड | 0 | 0 | 0 |
| AutoZone · Twitter फ़ील्ड | 0 | 0 | 0 |
| AutoZone · Instagram फ़ील्ड | 0 | 0 | 0 |
| Bravo · Twitter फ़ील्ड | 1 | 1 | 1 |
| Bravo · Instagram फ़ील्ड | 7 | 7 | 7 |
| J.Crew · Twitter फ़ील्ड | 647 | 644 | 2 |
| J.Crew · Instagram फ़ील्ड | 658 | 655 | 3 |
| Lush · Twitter फ़ील्ड | 0 | 0 | 0 |
| Lush · Instagram फ़ील्ड | 2 | 1 | 1 |
| Madewell · Twitter फ़ील्ड | 153 | 153 | 1 |
| Madewell · Instagram फ़ील्ड | 159 | 159 | 1 |
| OZK · Twitter फ़ील्ड | 2 | 1 | 1 |
| OZK · Instagram फ़ील्ड | 0 | 0 | 0 |
| PetSuites · Twitter फ़ील्ड | 0 | 0 | 0 |
| PetSuites · Instagram फ़ील्ड | 86 | 86 | 86 |
| Staples · Twitter फ़ील्ड | 2,698 | 2,698 | 3 |
| Staples · Instagram फ़ील्ड | 2,697 | 2,697 | 2 |
| The Coffee Bean & Tea Leaf · Twitter फ़ील्ड | 0 | 0 | 0 |
| The Coffee Bean & Tea Leaf · Instagram फ़ील्ड | 102 | 102 | 1 |
तय ऑडियंस को केंद्र में रखकर मंज़ूरी का ब्रीफ़ बनाएँ
मान लें कि क्रिएटर एक कैफ़े समूह की 3 शाखाओं के लिए सप्ताहांत का प्रमोशन तैयार कर रहा है. कैंपेन Riverside और Station शाखाओं के आसपास के ग्राहकों के लिए है; Hill शाखा ब्रीफ़ के दायरे से बाहर है. समन्वय करने वाले व्यक्ति की सूची में हर शाखा का वेबसाइट लिंक अलग है और सभी 3 पंक्तियों में वही दिया गया सोशल लिंक है. यह काल्पनिक उदाहरण है, डेटा में देखा गया कैंपेन नहीं.
3 वेबसाइट लिंक और 1 सोशल लिंक वाली सपाट फ़ाइल से क्रिएटर को ख़ुद पता लगाना पड़ता है कि कौन-सी वेबसाइट किस शाखा की है और प्रमोशन में कौन-सी शाखाएँ आती हैं. संदर्भ बनाए रखने वाला ब्रीफ़ सोशल गंतव्य को एक बार रखकर उसके 3 सदस्य जोड़ सकता है और Riverside तथा Station को कैंपेन के तय दायरे के रूप में चिह्नित कर सकता है.
इसके बाद समन्वय करने वाला व्यक्ति हर मंज़ूर पोस्ट के लिए वेबसाइट गंतव्य चुन सकता है या अलग स्थानीय संस्करण माँग सकता है. सोशल लिंक दोहराने से यह चुनाव तय नहीं होता. इससे यह भी नहीं पता चलता कि कैंपेन केवल तय ऑडियंस तक पहुँच सकता है या नहीं. वितरण की सेटिंग और पोस्ट करने की असल योजना को अलग मंज़ूरी चाहिए.
अब उलटी सूची की कल्पना करें: सभी 3 शाखाओं के संदर्भों पर 1 साझा वेबसाइट लिंक है, जबकि सोशल लिंक अलग हैं. वेबसाइट को मंज़ूरी देने के बाद भी क्रिएटर के पास कई सोशल गंतव्य बचते हैं. ब्रीफ़ को बताना चाहिए कि हर तय पोस्ट के साथ कौन-सा संदर्भ और सोशल गंतव्य जुड़ता है. यह जवाब पाने के लिए वेबसाइट के समूह पर निर्भर नहीं रहना चाहिए.
अपनी टीम की सूची से ये फ़ील्ड भरें:
कैंपेन और तय दायरा: [कैंपेन; शामिल स्थान या ऑडियंस].
स्रोत और शामिल संदर्भ: [सिस्टम; एक्सपोर्ट की तारीख; डेटा संग्राहक; रिकॉर्ड के पहचानकर्ता].
हर संदर्भ के लिंक: [पूरा वेबसाइट URL; सोशल प्लेटफ़ॉर्म; पूरा सोशल URL या असत्यापित टेक्स्ट मान].
प्रस्तावित जोड़ी और सदस्य: [किस वेबसाइट और सोशल लिंक के मेल का इस्तेमाल कौन-से संदर्भ करते हैं].
मंज़ूर विकल्प: [चुना गया गंतव्य और कारण; समीक्षक; जाँच की तारीख].
बाकी मामले: [खाली या अनिश्चित मान; ज़िम्मेदार व्यक्ति; अगला कदम].
संदर्भों की सूची से दायरा जाँचा जा सकता है; मंज़ूरी निर्णय दर्ज करती है. गंतव्य बदलने पर टीम देख सकती है कि उससे कौन-से संदर्भ जुड़े थे और उन प्रविष्टियों को फिर जाँच सकती है. अगर वही लिंक जानबूझकर दोहराया गया है, तो सदस्य संदर्भों की जानकारी खोए बिना वह समूह में रह सकता है. इस तरह छोटा ब्रीफ़ पूरे स्रोत एक्सपोर्ट की नकल बने बिना संबंध सुरक्षित रख सकता है.
कैंपेन शीट पर हर संबंध बनाए रखें
संदर्भ बनाए रखें
प्रविष्टि के साथ स्रोत का पहचानकर्ता और कैंपेन का तय दायरा जुड़े रहने दें.
दोनों गंतव्य जोड़ें
दिखाएँ कि हर संदर्भ के साथ कौन-सा वेबसाइट और सोशल मान जुड़ता है. साझा मान भी शामिल करें.
मंज़ूर विकल्प दर्ज करें
ब्रीफ़ के साथ मौजूदा सत्यापन, चुना गया गंतव्य और अनसुलझे मामले रखें.
दिए गए लिंक की तुलना कैसे हुई
हमने AllThePlaces के 10 अक्तूबर 2026 के लेबल वाले रन से 10 एक्सपोर्ट फ़ाइलें चुनीं. फ़ाइलों में डेटा एकत्र करने के समय 10–13 अक्तूबर के बीच के हैं. गंतव्यों के परिणाम देखने से पहले चुनाव के लिए Yext पर आधारित संग्राहकों का तय समूह और स्रोत कोड के नियम इस्तेमाल किए गए. यह उन्हीं फ़ाइलों की सीमित तुलना है, व्यवसायों का प्रतिनिधि नमूना नहीं. [1]
रिकॉर्ड की पहचान उसके संग्राहक और स्रोत संदर्भ से होती है. विश्लेषण से पहले हमने तय किया था कि खाली पहचानकर्ता, दोहराए संदर्भ और परस्पर विरोधी गंतव्य मान कैसे सँभालने हैं. वास्तविक फ़ाइलों के सभी 15,797 फ़ीचर, 15,797 संदर्भों में तय हुए. कोई खाली या अमान्य पहचानकर्ता, परस्पर विरोधी संदर्भ समूह या डुप्लिकेट के कारण अतिरिक्त रिकॉर्ड नहीं था. इसके बाद वेबसाइट और सोशल फ़ील्ड की गुणवत्ता अलग-अलग जाँची गई.
URL के लिए हम इस्तेमाल योग्य HTTP या HTTPS सिंटैक्स और सोशल फ़ील्ड के लिए सही प्लेटफ़ॉर्म होस्ट की शर्त रखते हैं. स्कीम और होस्ट को छोटे अक्षरों में बदलते हैं, जबकि पाथ, क्वेरी स्ट्रिंग, फ़्रैगमेंट और बाकी अंतर सुरक्षित रखते हैं. हम रीडायरेक्ट का पीछा नहीं करते और यह नहीं मानते कि अलग वर्तनी का मतलब वास्तविक दुनिया में अलग खाते हैं. देखे गए सभी गंतव्य मान URL, शाब्दिक टेक्स्ट मान या खाली मान की श्रेणी में आए. तय नियमों के तहत कोई गंतव्य मान अनिर्णीत नहीं रहा. [2]
पूरे परिणामों में हर संग्राहक और प्लेटफ़ॉर्म रहता है, 0 जोड़ी वाले मामले भी. समूह हमेशा एक ही संग्राहक के भीतर बनते हैं और दोहराव उसी जोड़ी वाले रिकॉर्ड सेट में तय होता है. 7 समेकित तालिकाओं में दोनों दिशाओं में समूहों के आकार का पूरा वितरण और जोड़ियों में खाली फ़ील्ड का हिसाब है. स्रोत से की गई स्वतंत्र पुनर्गणना में सभी 7 तालिकाएँ मेल खाईं. डाउनलोड में विधि और दूसरी जगह चलाया जा सकने वाला विश्लेषण कोड है; मूल स्रोत फ़ाइलें अलग से डाउनलोड करनी होती हैं. [7]
- चित्रों के मान और दायरे के लेबल डाउनलोड करें (CSV)
- सभी समेकित तालिकाएँ, विधि और विश्लेषण कोड डाउनलोड करें (ZIP)
चित्रों की CSV में 170 गिनती वाले मान हैं, हर डेटा पंक्ति में 1 मान, जो 4 चित्रों की 50 पंक्तियों से लिए गए हैं. ZIP में सभी 7 समेकित तालिकाएँ हैं, जिनमें जोड़ियों का पूरा कवरेज और समूहों के आकार के वितरण शामिल हैं. इसमें रिकॉर्ड स्तर के स्रोत रेफ़रेंस या डेस्टिनेशन स्ट्रिंग नहीं हैं. अनुवादित निर्देश शामिल हैं; गणना दोबारा करने के लिए मूल सार्वजनिक स्रोत फ़ाइलें अलग से डाउनलोड करनी होंगी.
स्रोत और नोट
- स्रोत: AllThePlaces के योगदानकर्ता. तय रन का लेबल 2026-10-10-13-32-41 है. चुनी गई 10 फ़ाइलों में डेटा एकत्र करने के समय 10–13 अक्तूबर 2026 के हैं. चुनाव में मौजूदा Yext संग्राहकों के स्रोत का तय संस्करण e4264a6b9586fccd8815fe1796981e0ffce51e5f और तारीख वाली संग्राहक सूची इस्तेमाल हुई. इससे हर फ़ाइल का ऐतिहासिक कोड संस्करण तय नहीं होता. संग्राहकों के नाम एक्सपोर्ट फ़ाइलों की पहचान हैं. Bravo में कई ब्रांड हो सकते हैं और OZK में बैंक और ATM के रिकॉर्ड हैं.
- अनुमत शुरुआती और आख़िरी खाली जगह हटाने के बाद तुलना केवल URL की स्कीम और होस्ट को छोटे अक्षरों में बदलती है. HTTP और HTTPS का अंतर, पोर्ट की वर्तनी, पाथ, क्वेरी स्ट्रिंग, फ़्रैगमेंट और खाली क्वेरी या फ़्रैगमेंट के विभाजक बने रहते हैं. सोशल URL में उसकी फ़ील्ड के लिए घोषित होस्ट होना चाहिए. रीडायरेक्ट, पेज की सामग्री और खाते की पहचान नहीं जाँची गई. दिए गए अलग-अलग टेक्स्ट मान वास्तविक दुनिया में फिर भी उसी गंतव्य के हो सकते हैं.
- Facebook URL की कुल 3,843 जोड़ियाँ हैं. दोहराव की 4 तय स्थितियों में 0 रिकॉर्ड में दोनों लिंक दोहराए गए हैं, 1,758 में केवल Facebook, 649 में केवल वेबसाइट और 1,436 में कोई भी लिंक दोहराया नहीं गया. दोहराव हर संग्राहक के जोड़ी वाले सेट के भीतर तय होता है. केवल Facebook दोहराने वाले सभी 1,758 रिकॉर्ड Staples के हैं. केवल वेबसाइट दोहराने वाले 649 रिकॉर्ड में Lush के 408 और OZK के 241 हैं. शोध पैकेज में समूहों के आकार के पूरे वितरण रखे गए हैं.
- स्रोत पहचान तय हो चुके 15,797 संदर्भों में Facebook कवरेज यह है: 3,843 में वेबसाइट और Facebook, दोनों के URL; 9,174 में केवल वेबसाइट; 8 में केवल Facebook और 2,772 में दोनों नहीं. केवल Facebook वाले 8 रिकॉर्ड में J.Crew के 7 और Madewell का 1 है. कवरेज की ये 4 श्रेणियाँ स्रोत संदर्भों को अलग-अलग हिस्सों में बाँटती हैं. वेबसाइट मौजूद होने और Facebook मौजूद होने के अलग कॉलम में कुछ रिकॉर्ड साझा हैं.
- मौजूदा स्रोत कोड में फ़ील्ड हटाने और जानकारी जोड़ने के चरण हैं. AutoZone, Twitter को साझा पाइपलाइन से हटाता है और अपने संग्राहक के तर्क में Instagram के साथ Facebook के 2 सटीक मान हटाता है. Coffee Bean भी Twitter हटाता है. बाद में Name Suggestion Index से जानकारी जोड़ने का चरण खाली फ़ील्ड भर सकता है. इन मौजूदा प्रक्रियाओं से किसी खास ऐतिहासिक एक्सपोर्ट मान या छूटी जानकारी का मूल साबित नहीं होता.
- सोशल फ़ील्ड का टेक्स्ट मान ऐसा गैर-URL टेक्स्ट है जो अक्षरों के तय, सीमित नियम से मेल खाता है. वर्तनी, बड़े-छोटे अक्षर और शुरुआत का कोई भी @ जस का तस रखा जाता है. किसी टेक्स्ट मान को URL के बराबर नहीं माना जाता और खाते के रूप में सत्यापित नहीं किया जाता. वेबसाइट के साथ जोड़ी वाले टेक्स्ट मान के सेट में Instagram के 3,711 और Twitter के 3,501 रिकॉर्ड हैं. वही संदर्भ दोनों सेट में आ सकते हैं. 0 जोड़ी वाली पंक्तियाँ भी दिखती रहती हैं.
- AllThePlaces अपने बनाए डेटा को CC0 के तहत उपलब्ध कराता है. Influence IQ समेकित तुलनाएँ और विश्लेषण कोड तैयार करता है; परिणामों से स्रोत प्रोजेक्ट या नाम लिए गए उत्पादकों के समर्थन का संकेत नहीं मिलता. शोध पैकेज में सभी 7 समेकित तालिकाएँ और अनुवादित पुनर्गणना निर्देश हैं. इसमें रिकॉर्ड स्तर के रेफ़रेंस या डेस्टिनेशन स्ट्रिंग नहीं हैं; विश्लेषण दोबारा करने के लिए मूल सार्वजनिक स्रोत फ़ाइलें अलग से डाउनलोड करनी होंगी.
इस लेख का स्रोत संस्करण अंग्रेज़ी में है. सभी भाषा संस्करण AllThePlaces की उन्हीं 10 चुनी हुई एक्सपोर्ट फ़ाइलों का वर्णन करते हैं, जिन्हें 10–13 अक्तूबर 2026 को एकत्र किया गया था. अनुवाद से निष्कर्ष किसी स्थानीय बाज़ार या व्यवसायों की मौजूदा स्थिति का मानक नहीं बन जाते.