मॉडरेशन के 2 लेबल अलग समीक्षकों से आ सकते हैं
टिप्पणी की समीक्षा आगे सौंपते समय 2 लेबल दिख सकते हैं, लेकिन उन्हें किसने चुना यह नहीं. Wikipedia के ऐतिहासिक आकलन बताते हैं कि अगला व्यक्ति मामला पढ़े, तो यह जानकारी क्यों महत्वपूर्ण है.
Wikipedia Detox के व्यक्तिगत हमलों वाले ऐतिहासिक डेटासेट के चुने हुए आकलनों का मूल Influence IQ विश्लेषण. विश्लेषण 25 अक्टूबर, 2026 (UTC) को पूरा हुआ.
सार
Wikipedia की चर्चाओं के 13,824 चुने हुए ऐतिहासिक अंशों में से 155 अंशों में, हर अंश के 10 व्यक्तिगत आकलनों में कहीं-न-कहीं हमले का उद्धरण/वर्णन करने वाला लेबल और संबोधित व्यक्ति पर हमले का लेबल दोनों मिले. उन 155 में से 98 अंशों में कम-से-कम 1 समीक्षक ने दोनों लेबल चुने. बाकी 57, यानी 36.8%, में लेबल केवल अलग समीक्षकों से आए. यह प्रतिशत उन 155 अंशों का है, सभी 13,824 का नहीं.[1][4]
सोशल मीडिया टिप्पणियाँ संभालने वाले व्यवसायों और क्रिएटर के लिए व्यावहारिक सीख काम आगे सौंपने से जुड़ी है: हर समीक्षक के अवलोकन उसके अपने आकलन से जुड़े रखें. 2 लेबल साथ दिखने से यह स्थापित नहीं होता कि किसी 1 व्यक्ति ने दोनों चुने. अध्ययन ऐतिहासिक चर्चा-अंशों पर व्यक्तिपरक आकलन बताता है, मॉडरेशन की गलतियाँ या टिप्पणी हटाने का नियम नहीं. नीचे कॉपी की जा सकने वाली वर्कशीट इस अंतर को समीक्षा के व्यावहारिक रिकॉर्ड में बदलती है.
मान लें कि क्रिएटर किसी कठिन टिप्पणी को देखने के लिए सहकर्मी से कहता है. आगे सौंपे गए रिकॉर्ड में 2 लेबल हैं: कोई हमले को उद्धृत कर रहा है या उसका वर्णन कर रहा है, और कोई संबोधित व्यक्ति पर हमला कर रहा है. क्या करना है यह तय करने से पहले सहकर्मी को 1 और बात चाहिए: क्या दोनों अवलोकन उसी समीक्षक ने किए?
सार में यह वास्तविक अंतर खो सकता है. कोई व्यक्ति दोनों विकल्प चुन सकता है, या 2 लोग उसी पाठ के अलग पहलुओं पर ध्यान दे सकते हैं. केवल लेबलों की सूची अगले समीक्षक को नहीं बता सकती कि कौन-सा पैटर्न हुआ. यह भी अस्पष्ट रह सकता है कि हर व्यक्ति किन शब्दों की बात कर रहा था.
हमने स्थापित शोध डेटासेट के व्यक्तिगत आकलनों से इस प्रश्न को देखा. मूल सामग्री Wikipedia के चर्चा पृष्ठों से आई थी. यहाँ उसका काम लेबल और समीक्षक का संबंध स्पष्ट करना है, ताकि व्यवसाय या क्रिएटर अपने काम को आगे सौंपते समय बचाकर रखने योग्य जानकारी पर विचार कर सकें.
हर अवलोकन उसके समीक्षक से जुड़ा रखें
शुरुआत इस बात से करें कि हर लेबल वास्तव में क्या बताता है
पहले विकल्प में पूछा गया था कि क्या पाठ किसी अन्य टिप्पणी में हुए व्यक्तिगत हमले को उद्धृत करता है या उसका वर्णन करता है. दूसरा विकल्प संबोधित व्यक्ति पर व्यक्तिगत हमले से जुड़ा था. समीक्षक 1 से अधिक विकल्प चुन सकते थे. ये दिखाए गए पाठ पर आकलन थे; उसे छिपाने के फ़ैसले या नीति टूटने के प्रमाण नहीं.[2]
10 समीक्षकों में से कम-से-कम 1 ने लेबल चुना हो तो हमने उसे मौजूद माना. यह किसी भी समीक्षक के चयन की तुलना थी. हमने बहुमत आवश्यक नहीं किया, लेबलों को सर्वसम्मति नहीं कहा और उनकी शुद्धता नहीं परखी.
13,824 चुने हुए अंशों में से 12,025 में इन 2 लेबलों में से कोई नहीं था. अन्य 406 में उद्धरण/वर्णन का लेबल था, संबोधित व्यक्ति पर हमले का नहीं; जबकि 1,238 में संबोधित व्यक्ति पर हमले का लेबल था, उद्धरण/वर्णन का नहीं. इससे 155 अंश बचे जिनके आकलनों में कहीं-न-कहीं दोनों लेबल थे.
ये वर्णन केवल इन 2 विकल्पों के हैं. संबोधित व्यक्ति पर हमले का लेबल न होने पर भी अंश में किसी अन्य तरह के हमले का लेबल हो सकता था. उद्धरण/वर्णन का लेबल यह प्रमाणित नहीं करता कि पाठ नुकसानरहित था. सटीक नाम रखने से उपयोगी श्रेणी चुपचाप अधिक व्यापक निष्कर्ष में नहीं बदलती.
13,824 चुने हुए अंशों को कैसे लेबल दिए गए
10 समीक्षकों में से कम-से-कम 1 ने चुना हो तो लेबल मौजूद था. ये 5 श्रेणियाँ 2 खास विकल्पों के बारे में हैं; “कोई नहीं” से यह निष्कर्ष नहीं निकलता कि अंश में हमले के किसी भी प्रकार का लेबल नहीं था.
| उद्धरण/वर्णन और संबोधित व्यक्ति पर हमले के लेबल | अंश |
|---|---|
| इन दोनों लेबलों में से कोई नहीं | 12,025 |
| उद्धरण/वर्णन, संबोधित व्यक्ति पर हमला नहीं | 406 |
| संबोधित व्यक्ति पर हमला, उद्धरण/वर्णन नहीं | 1,238 |
| दोनों लेबल; कम-से-कम 1 समीक्षक ने दोनों चुने | 98 |
| दोनों लेबल, केवल अलग समीक्षकों से | 57 |
57 अंशों में दोनों लेबल थे, लेकिन किसी समीक्षक ने दोनों नहीं चुने
155 अंशों के भीतर हमने हर लेबल के पीछे का व्यक्तिगत जवाब जाँचा. 98 में कम-से-कम 1 व्यक्ति ने उसी अंश के लिए दोनों विकल्प चुने. 57 में उद्धरण/वर्णन और संबोधित व्यक्ति पर हमले के चयन केवल अलग लोगों से आए. उन 57 में किसी व्यक्तिगत जवाब में जोड़ी नहीं थी.
विभाजन था: 63.2% में एक ही समीक्षक की जोड़ी और 36.8% में केवल अलग समीक्षकों से मिले लेबल. दोनों समूह उसी संकीर्ण रूप से परिभाषित 155 अंशों के सेट के थे. 13,824 अंशों का बड़ा आधार भी महत्वपूर्ण है, क्योंकि वह बताता है कि सशर्त तुलना कहाँ से शुरू हुई.[4]
इस अंतर से बदलता है कि सार के आधार पर आप क्या दावा कर सकते हैं. दोनों लेबल मिले, यह जानने से कहा जा सकता है कि समीक्षा सेट में कहीं-न-कहीं हर लेबल चुना गया था. केवल इससे यह नहीं कहा जा सकता कि किसी व्यक्तिगत समीक्षक ने पाठ को दोनों तरह से वर्णित किया.
एक ही समीक्षक वाला पैटर्न भी शब्दों का अर्थ तय नहीं करता. स्रोत का अंश Wikipedia के किसी संशोधन के दौरान जोड़े गए पाठ को साथ रख सकता था, जिसमें 1 से अधिक पोस्ट भी हो सकती थीं. किसी समीक्षक के दोनों विकल्प चुनने से यह नहीं दिखता कि उद्धृत हिस्सा ही संबोधित व्यक्ति पर हमला था. आकलनों की वजह समझाने के लिए हमने व्यक्तिगत अंश नहीं पढ़े.[2][6]
155 अंशों में से 57 में एक ही समीक्षक की जोड़ी नहीं थी
इस तुलना में केवल वे 155 चुने अंश हैं जिनके 10 आकलनों में कहीं-न-कहीं दोनों लेबल थे. यह किसी भी समीक्षक के चयन लेती है, बहुमत की सहमति या सत्यापित मॉडरेशन परिणाम नहीं.
| दोनों लेबल किसने दिए | अंश | 155 अंशों का हिस्सा |
|---|---|---|
| कम-से-कम 1 समीक्षक ने दोनों चुने | 98 | 63.2% |
| लेबल केवल अलग समीक्षकों से आए | 57 | 36.8% |
अगले समीक्षक को लेबल के पीछे का अवलोकन दें
व्यवसाय में काम टिप्पणियाँ देखने वाले से खाते के ज़िम्मेदार व्यक्ति तक जा सकता है. क्रिएटर के लिए सहायक से क्रिएटर तक. जवाब देना है, और संदर्भ चाहिए या खाते की मौजूदा नीति लागू करनी है—यह तय करने से पहले अगले व्यक्ति को समझना चाहिए कि क्या देखा गया था.
हर व्यक्ति के चयन साथ रखें. समीक्षक दोनों विकल्प चुने तो जोड़ी उसके आकलन के रूप में रखें. 2 समीक्षक अलग विकल्प चुनें तो अलग जवाब बचाकर रखें. किसी मामले के 1 से अधिक अर्थ हो सकते हैं; उन्हें ऐसा आकलन न बनाएँ जो वास्तव में किसी ने किया ही नहीं.
फिर संबंधित हिस्से की छोटी व्याख्या जोड़ें. अपनी प्रक्रिया में बताएँ कि क्या उद्धृत लगता है, किसे संबोधित किया गया लगता है और पहले-पिछले किस जवाब से बातचीत समझने में मदद मिलती है. उपलब्ध संदर्भ प्रश्न का जवाब न दे तो अनिश्चितता स्पष्ट रखें. ये व्यावहारिक सुझाव हैं; डेटासेट ने फ़ैसलों पर उनका असर नहीं परखा.
छोटी टिप्पणी पर्याप्त हो सकती है. उद्देश्य है कि अगला व्यक्ति पूरी समीक्षा फिर बनाए बिना पहले व्यक्ति का तर्क समझ सके. शिफ़्टों के बीच या ब्रैंड और क्रिएटर के बीच मामले सौंपने वाली टीम को इसलिए मूल अवलोकन और उससे जुड़ी श्रेणी दोनों देने चाहिए.
लेबलों की एक जैसी कुल गिनतियों वाला काल्पनिक उदाहरण
2 गढ़े हुए समीक्षा समूह मानें, हर समूह में 10 लोग 1 काल्पनिक अंश का आकलन करते हैं. समूह गणना समझाते हैं; ये डेटासेट के वास्तविक लोग, उद्धरण या मामले नहीं हैं. दोनों सारों में उद्धरण/वर्णन का 1 चयन और संबोधित व्यक्ति पर हमले का 1 चयन दिखता है.[8]
पहले समूह में समीक्षक A दोनों विकल्प चुनता है. बाकी 9 लोग इन 2 विकल्पों में से कोई नहीं चुनते. किसी 1 व्यक्ति के जवाब में जोड़ी है. काम आगे सौंपते समय उस व्यक्ति का संयुक्त आकलन सही रूप में रखा जा सकता है, जबकि अंतिम कार्रवाई अलग फ़ैसले के लिए छोड़ दी जाए.
दूसरे समूह में समीक्षक A उद्धरण/वर्णन और समीक्षक B संबोधित व्यक्ति पर हमला चुनता है. बाकी 8 इन दोनों विकल्पों में से कोई नहीं चुनते. खानों का कुल अब भी 1 और 1 है, लेकिन किसी व्यक्ति ने दोनों नहीं चुने. इसे किसी 1 व्यक्ति का संयुक्त आकलन कहना ऐसा संबंध जोड़ देगा जो व्यक्तिगत जवाबों में नहीं है.
उदाहरण यह भी समझाता है कि हर मिलते व्यक्ति को जोड़ने के बजाय हमने अंश क्यों गिने. पहले समूह के 2 लोगों में से हर एक ने दोनों लेबल चुने होते, तब भी अंश एक ही समीक्षक वाले समूह में केवल 1 बार आता. वर्गीकरण पूछता है कि ऐसी जोड़ी थी या नहीं, यह नहीं कि कितने लोगों ने दी.
दूसरे समूह के लिए काम सौंपने की छोटी काल्पनिक टिप्पणी हो सकती है: “फ़ैसला अभी बाकी है. समीक्षक A ने उद्धरण/वर्णन पहचाना; समीक्षक B ने संबोधित व्यक्ति पर निर्देशित भाषा पहचानी. दोनों नोट्स अंश और उससे पहले के जवाब के साथ रखें. कार्रवाई चुनने से पहले खाते का ज़िम्मेदार व्यक्ति जाँचेगा कि हर समीक्षक किस हिस्से की बात कर रहा था.” टिप्पणी अनसुलझा प्रश्न आगे देती है, 2 लोगों के जवाबों को किसी 1 व्यक्ति का निष्कर्ष नहीं बनाती.
वास्तविक रूप से काम सौंपते समय दूसरे समूह के 2 नोट्स अलग रखें. अगला समीक्षक उन्हें पाठ के साथ पढ़कर पूछ सकता है कि हर व्यक्ति का क्या अर्थ था, फिर खाते की नीति के अनुसार फ़ैसला कर सकता है. अध्ययन यह स्थापित नहीं करता कि कोई समीक्षक सही था या उस काल्पनिक मामले में कौन-सी कार्रवाई होनी चाहिए.
लेबलों की कुल गिनतियाँ समान होने पर भी समीक्षा के पैटर्न अलग हो सकते हैं
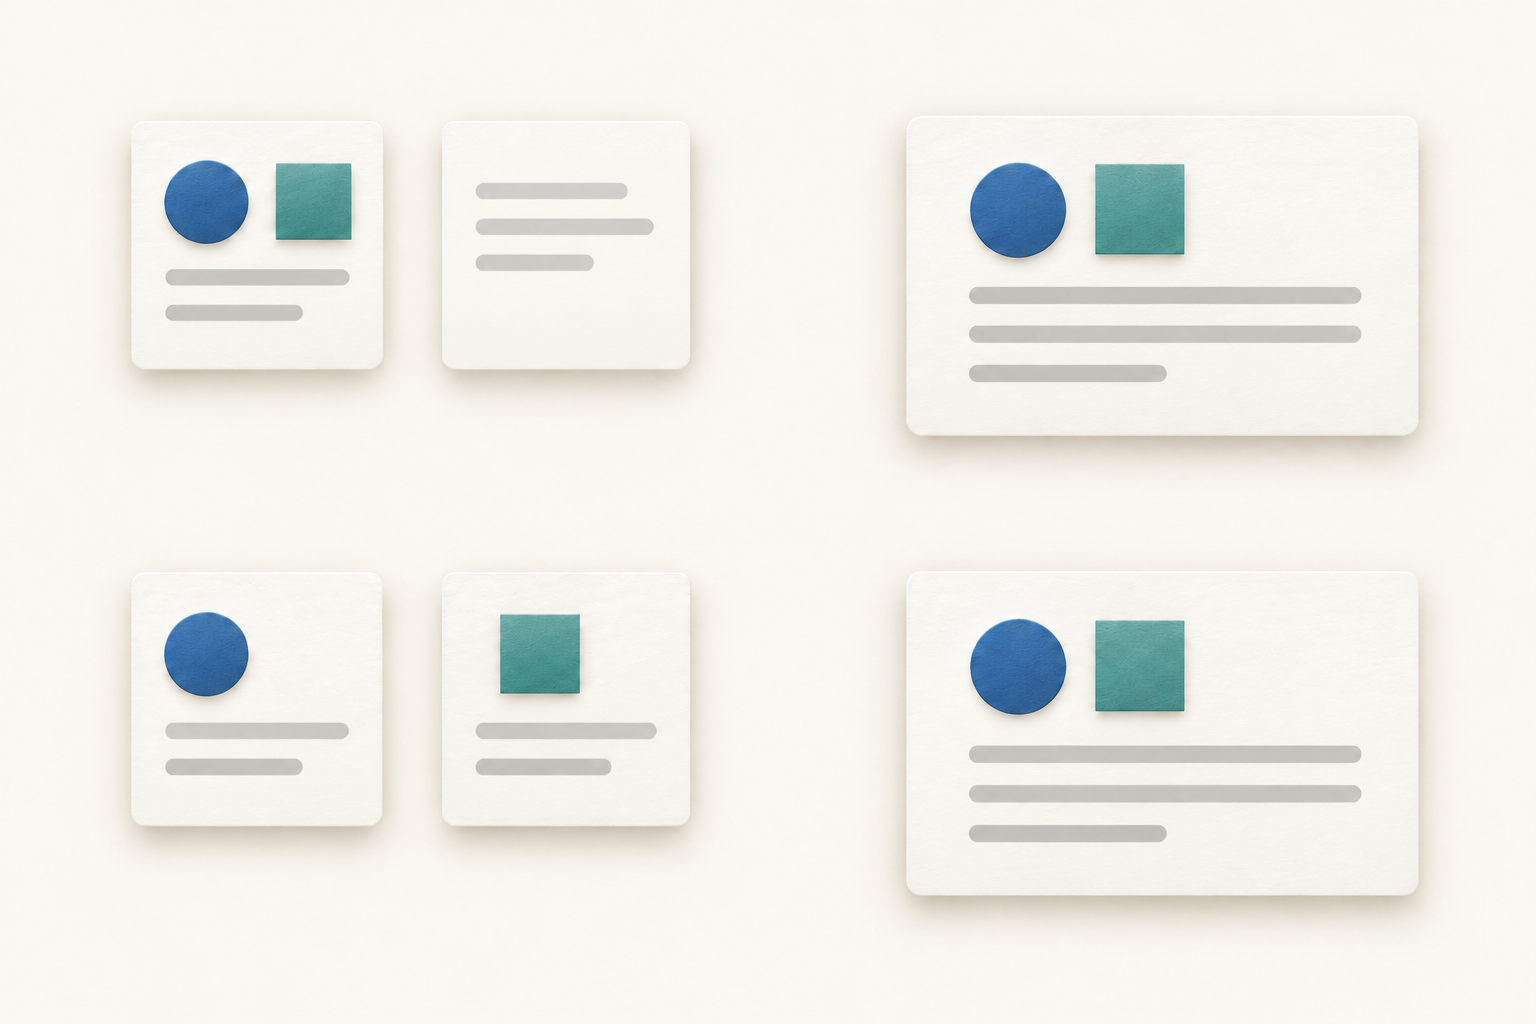
1 समीक्षक दोनों चुनता है
पहले काल्पनिक समूह में 1 व्यक्ति दोनों लेबल चुनता है और 9 लोग इन 2 विकल्पों में से कोई नहीं चुनते.
2 समीक्षकों में हर एक 1 विकल्प चुनता है
दूसरे में 1 व्यक्ति उद्धरण/वर्णन और दूसरा संबोधित व्यक्ति पर हमला चुनता है. बाकी 8 इन दोनों विकल्पों में से कोई नहीं चुनते.
नीति का फ़ैसला और वर्णन अलग रखें
टिप्पणी में क्या दिखता है उसका वर्णन और उसके साथ क्या करना है इसका फ़ैसला अलग उद्देश्यों के लिए हैं. समीक्षक उद्धृत भाषा देख सकता है, जबकि खाते के ज़िम्मेदार व्यक्ति को अब भी आसपास की बातचीत और लागू नीति पर विचार करना हो. ये चरण अलग रखें, ताकि बाद में पढ़ने वाला देख सके कि फ़ैसला कैसे हुआ.
क्रिएटर के साथ काम करने वाला व्यवसाय कठिन बातचीत आने से पहले तय करे कि यह फ़ैसला कौन करेगा. उत्पाद की शिकायत समझने वाला व्यक्ति ज़रूरी नहीं कि खाते के मॉडरेशन का तरीका बदलने के लिए अधिकृत हो. स्पष्ट हस्तांतरण दोनों भूमिकाएँ बता सकता है, बिना यह माने कि हर मामले में कई समीक्षक चाहिए.
अकेले काम कर रहे क्रिएटर के लिए यही अंतर 1 नोट में रह सकता है: आपने क्या देखा, कौन-सा संदर्भ जाँचा और क्या तय किया. कोई व्यक्ति कई चरण पूरे करते हुए उनके उद्देश्य स्पष्ट रख सकता है. डेटासेट यह नहीं दिखाता कि कर्मचारी या समीक्षा की दूसरी परत जोड़ने से बेहतर परिणाम मिलते हैं.
अलग अवलोकन तब तक अलग रखें जब तक उनका संबंध न समझ लें. अलग चयन विरोधाभासी बयान होने के बजाय ध्यान के अलग विषय दिखा सकते हैं. उद्धरण/वर्णन का चयन अपने-आप छूट नहीं है, और संबोधित व्यक्ति पर हमले का चयन हटाने की मापी गई सिफ़ारिश नहीं है. उपयोगी अगली कार्रवाई वास्तविक बातचीत और खाते के नियमों पर आधारित है, हमारे पुराने संग्रह के प्रतिशतों से निकाली गई कार्रवाई पर नहीं.
टिप्पणी की समीक्षा वाली वर्कशीट कॉपी करें
ये खाने अपने मौजूदा समीक्षा दस्तावेज़ या काम सौंपने के रिकॉर्ड में कॉपी करें. टीम को जितनी जानकारी चाहिए केवल उतनी रखें और बातचीत के अनुसार उचित पहुँच दें. वर्कशीट यहाँ साइन अप किए बिना उपलब्ध है; यह व्यावहारिक मार्गदर्शन है, अध्ययन में देखी गई प्रक्रिया नहीं.[8]
मामला: [लिंक या आंतरिक संदर्भ.] खाता/चैनल: [बातचीत कहाँ दिखती है.] जाँच का समय: [तारीख़ और समय.] संदर्भ स्थिर रखें, ताकि अगला व्यक्ति वही सामग्री ढूँढ़ सके.
उद्देश्य: [किस प्रश्न पर फ़ैसला चाहिए?] ज़िम्मेदार व्यक्ति: [कौन तय करेगा?] अगला व्यक्ति: [काम आगे किसे सौंपना है, यदि किसी को हो?]
दिखाया गया पाठ: [समीक्षा वाला हिस्सा, आपके स्वीकृत वर्कस्पेस में रखा हुआ.] आसपास का संदर्भ: [संबंधित पहले या बाद के जवाब.] अनुपलब्ध संदर्भ: [क्या जाँचा नहीं जा सका.]
समीक्षक: [नाम या आंतरिक समीक्षक संदर्भ.] आकलन का समय: [तारीख़ और समय.] कई लोग वही लेबल इस्तेमाल करें, तब भी हर व्यक्ति की प्रविष्टि अलग रखें.
उद्धरण/वर्णन का अवलोकन: [हाँ, नहीं या अस्पष्ट.] आधार: [कौन-सा हिस्सा किसी अन्य व्यक्ति के हमले को उद्धृत करता या उसका वर्णन करता लगता है?] इस खाने को नुकसानरहित होने का फ़ैसला न बनाएँ.
संबोधित व्यक्ति पर हमले का अवलोकन: [हाँ, नहीं या अस्पष्ट.] आधार: [कौन-सा हिस्सा संबोधित व्यक्ति की ओर निर्देशित लगता है, और क्यों?] यह जवाब उद्धरण/वर्णन वाले अवलोकन से स्वतंत्र रखें.
अन्य संबंधित अवलोकन: [कोई अन्य मुद्दा जिस पर खाते की नीति के अनुसार विचार चाहिए.] अध्ययन के 2 लेबलों में से कोई न होने को बातचीत का पूरा विवरण न मानें.
समीक्षाओं का संबंध: [किसी 1 व्यक्ति ने दोनों चुने, अलग लोगों ने अलग विकल्प चुने, या अस्पष्ट.] समीक्षकों में अंतर हो तो मामले का सार बनाने से पहले उनके व्यक्तिगत नोट्स बचाकर रखें.
नीति का संदर्भ: [लागू नियम या मार्गदर्शन.] फ़ैसला: [वास्तव में चुनी गई कार्रवाई या अनसुलझा प्रश्न.] कारण: [अवलोकन और संदर्भ उस फ़ैसले का आधार कैसे बनते हैं.]
आगे की कार्रवाई: [आगे कौन क्या करेगा, यदि कुछ करना हो?] सौंपने का समय: [काम उस व्यक्ति को कब जाएगा.] परिणाम: [फ़ैसले के बाद क्या हुआ, यदि जाँचा गया हो.] नियोजित कार्रवाई को पूरा चिह्नित न करें.
फिर समीक्षा कब करें: [कोई खास घटना या ग़ायब संदर्भ, यदि दोबारा देखना आवश्यक हो.] वर्कशीट हर मामले की बार-बार समीक्षा आवश्यक नहीं करती; स्थिति के अनुसार उचित कारण इस्तेमाल करें.
वर्ष की जाँच में वही 155 अंश रहे
लेबल की जोड़ियाँ निकालने से पहले हमने 2 सहायक जाँचें तय की थीं. पहली में 2016 के अंश हटाए गए, क्योंकि जारी फ़ाइलों के वर्षों का दायरा स्रोत के विवरण और मूल शोधपत्र की अवधियों से आगे था. इससे यादृच्छिक नमूने के 13,809 पात्र अंश बचे. उन्हीं 155 में दोनों लेबल थे और वही 98/57 विभाजन रहा.[5]
दूसरी जाँच में डेटासेट की वह सामग्री इस्तेमाल हुई जो ब्लॉक करने की घटनाओं के आसपास से अलग चुनी गई थी. ठीक 10 आकलन वाले उसी नियम से इसमें 42,383 अंश थे. कहीं-न-कहीं दोनों लेबल वाले 2,457 अंशों में से 1,354 में उसी समीक्षक की जोड़ी और 1,103 में केवल अलग लोगों से आए लेबल थे: क्रमशः 55.1% और 44.9%.
ब्लॉक करने की घटनाओं के आसपास चुने समूह का नमूना-उद्देश्य अलग है, इसलिए उसे अलग रखा गया. उसके प्रतिशत मुख्य परिणाम की जगह नहीं लेते और आज की ब्रैंड टिप्पणियों का प्रमाण नहीं बनते. वर्ष की जाँच दर्ज तारीख़ों के दायरे से जुड़ी है; कोई जाँच यह आवश्यकता नहीं हटाती कि इन्हें चुने हुए ऐतिहासिक अंशों पर व्यक्तिपरक आकलन माना जाए.
पहले से चुनी 2 जाँचों की तुलना
हर पंक्ति में प्रति अंश ठीक 10 पूरे आकलन हैं. ब्लॉक-घटनाओं के आसपास चुने नमूने का उद्देश्य अलग है. 2016 हटाने से जारी फ़ाइलों के वर्षों और स्रोत के विवरण में अंतर की जाँच होती है.
| पहले से चुनी तुलना | पात्र अंश | कहीं भी दोनों लेबल वाले अंश | एक ही समीक्षक की जोड़ी वाले | केवल अलग समीक्षकों वाले | दोनों लेबल वाले अंशों में केवल अलग समीक्षकों से लेबल मिलने वाले अंशों का हिस्सा |
|---|---|---|---|---|---|
| यादृच्छिक नमूना, ठीक 10 आकलन | 13,824 | 155 | 98 | 57 | 36.8% |
| ब्लॉक-घटनाओं के आसपास से चुना नमूना, अलग रखा गया | 42,383 | 2,457 | 1,354 | 1,103 | 44.9% |
| 2016 को हटाकर यादृच्छिक नमूना | 13,809 | 155 | 98 | 57 | 36.8% |
हमने लेबलों को व्यक्तिगत आकलनों से कैसे जोड़ा
हमने Wikipedia Detox परियोजना के सार्वजनिक डेटासेट Wikipedia Talk Labels: Personal Attacks का संस्करण 6 इस्तेमाल किया. जारी फ़ाइलों में ऐतिहासिक चर्चा पृष्ठों के संशोधनों से बना पाठ और हर अंश पर कई क्राउडवर्कर के आकलन हैं. इस विश्लेषण ने व्यक्तिगत जवाब लिए; नए आकलन नहीं बनाए और किसी मॉडरेशन प्रणाली का मूल्यांकन नहीं किया.[1][2]
मुख्य तुलना रिलीज़ के यादृच्छिक नमूना समूह से शुरू हुई और केवल ठीक 10 अलग, पूरे आकलन वाले अंश रखे गए. संख्या 10 रखने से हर अंश को जोड़ी वाला चयन मिलने के बराबर अवसर मिले. इससे जारी यादृच्छिक नमूने के 37,492 अंशों में से 13,824 भी चुने गए, इसलिए परिणाम उस पूरे समूह का वर्णन नहीं करता.[3]
हर चुने हुए अंश ने 1 गिनती दी. हमने देखा कि कोई भी लेबल कहीं मिला या नहीं, फिर क्या उसी अंश पर किसी 1 व्यक्ति के जवाब में दोनों मिले. ये 5 श्रेणियाँ एक-दूसरे से अलग हैं और उनका योग 13,824 है. 155 अंशों का हर दोनों लेबल वाली 2 श्रेणियों से आता है, सभी आकलनों या स्रोत के सभी अंशों से नहीं.[4]
जोड़ियाँ देखने से पहले हमने नमूना समूह, आकलनों की संख्या का नियम, वर्ष की जाँच और मुख्य सशर्त तुलना में कम-से-कम 100 अंश तय किए. मिले हुए 155 ने यह आवश्यकता पूरी की. हमने कोई आवश्यक प्रतिशत नहीं रखा, परिणाम के पक्ष में नियम नहीं बदला और ब्लॉक-घटनाओं वाली सामग्री को यादृच्छिक समूह से नहीं मिलाया.
मूल शोध ने व्यक्तिगत आकलन पहले ही इस्तेमाल किए थे और बाद के शोध ने हर हमले वाले फ़ील्ड को बहुमत से जोड़ा था. हमारा सीमित योगदान आकलनों के तय सेट में ये 2 विकल्प किसने दिए, इसकी वर्णनात्मक तुलना है. यह उन अध्ययनों की विधियों का सुधार नहीं है. डाउनलोड में अलग उपलब्ध सार्वजनिक स्रोत फ़ाइलों से इस्तेमाल करने के लिए समेकित परिणाम, विधियाँ और गणना दोहराने के निर्देश हैं.[6][7]
अगली समीक्षा समझना आसान बनाएँ
सोशल मीडिया मॉडरेशन का काम सौंपते समय उपयोगी प्रश्न है कि हर अवलोकन किसने किया और वह किस बात का वर्णन कर रहा था. इस चुने हुए पुराने संग्रह की तुलना में दोनों लेबल वाले 155 अंशों में से 57 में किसी व्यक्तिगत समीक्षक ने जोड़ी नहीं चुनी. केवल 2 लेबलों के नाम वाला सार यह संबंध खो देगा.
व्यक्ति के अवलोकन, संबंधित संदर्भ और अंतिम फ़ैसला जुड़े रखें. तब व्यवसाय या क्रिएटर बता सकता है कि मामले में क्या है और चुनी गई कार्रवाई का आधार क्या है, बिना किसी श्रेणी के लेबल से पूरी समीक्षा का काम लेने के.
साइन अप आवश्यक नहीं. पैकेज में अनाम समेकित परिणाम, विधियाँ, गणना दोहराने के निर्देश और दोबारा इस्तेमाल की जा सकने वाली वर्कशीट है. इसमें मूल चर्चा-पाठ, संशोधन ID, वर्कर ID या जनसांख्यिकीय जानकारी नहीं है. मूल सार्वजनिक स्रोत फ़ाइलें लिंक की गई रिलीज़ से अलग उपलब्ध हैं.
स्रोत और टिप्पणियाँ
- स्रोत: Wikipedia Talk Labels: Personal Attacks, Figshare संस्करण 6, DOI 10.6084/m9.figshare.4054689.v6, फ़रवरी 2017 में CC0 के तहत जारी. हमने attack_annotated_comments.tsv (फ़ाइल 7554634) और attack_annotations.tsv (फ़ाइल 7554637) इस्तेमाल किए, जिन पर निर्माता के MD5 और स्वतंत्र रूप से निकाले गए SHA-256 की जाँच हुई. Influence IQ ने चयन, गणनाएँ और व्याख्या 25 अक्टूबर, 2026 (UTC) को पूरी कीं. अध्ययन ने नई टिप्पणियाँ इकट्ठी नहीं कीं, नए एनोटेशन नहीं बनाए और किसी चालू सोशल प्लेटफ़ॉर्म को नहीं मापा.
- निर्माता quoting_attack को किसी अन्य टिप्पणी के हमले के उद्धरण/वर्णन के बारे में वर्कर की धारणा और recipient_attack को संबोधित व्यक्ति पर हमला बताता है. इंटरफ़ेस में कई चयन संभव थे. सामान्य हमला स्रोत का अलग जवाब है, इस विश्लेषण में उपप्रकारों से दोबारा बनाया गया OR नहीं. जारी पाठ किसी संशोधन के दौरान जोड़े गए हिस्से जोड़ता है; यह संपादन का सार, आवश्यक रूप से 1 पूरी पोस्ट या पूरी बातचीत नहीं है. चर्चा के नेमस्पेस, नमूना समूह और मॉडल के train/dev/test विभाजन अपना दस्तावेज़ित अर्थ बनाए रखते हैं.
- पूरी फ़ाइलों में 115,864 अलग अंश, संशोधन/वर्कर आकलनों की 1,365,217 अलग जोड़ियाँ और 4,053 वर्कर थे. संरचना की जाँच में दोहरी जोड़ियाँ, बिना मिलान वाले जोड़, गलत बनी पंक्तियाँ या ग़ायब/अमान्य फ़्लैग मान नहीं मिले. पात्रता के लिए स्रोत के सभी 5 फ़्लैग, दोनों दस्तावेज़ित चर्चा नेमस्पेस और सभी मॉडल विभाजनों में ठीक 10 अलग पूरे आकलन चाहिए थे; हर अंश की 1 बराबर-भार वाली गिनती थी. मुख्य यादृच्छिक समूह में 37,492 में से 13,824 अंश रहे. अलग चुने ब्लॉक-घटना वाले समूह में 78,372 में से 42,383 रहे. अलग अंशों पर वर्कर का दोबारा आना वैध था; एक जैसे पाठ मिलाना, फ़्लैगों की संगति के आधार पर हटाना या सामान्य हमले को फिर कोड करना लागू नहीं किया गया.
- मान लें कि पात्र अंश पर Q उद्धरण/वर्णन के किसी चयन और R संबोधित व्यक्ति पर हमले के किसी चयन को बताता है. दोनों की मौजूदगी के लिए 10 आकलनों में कहीं कम-से-कम 1 Q और 1 R चाहिए. उसी समीक्षक की जोड़ी के लिए अतिरिक्त रूप से किसी 1 संशोधन/वर्कर जवाब में Q और R चाहिए; केवल अलग समीक्षकों वाली श्रेणी में ऐसा जवाब नहीं होता. मुख्य सशर्त हर 98 + 57 = 155 है; सटीक भिन्न 98/155 और 57/155 को 63.2% और 36.8% दिखाया गया है. प्रतिशत सटीक परिमेय गणना और 1 दशमलव तक half-up राउंडिंग लेते हैं. जोड़ियाँ निकालने से पहले मुख्य सशर्त तुलना में दोनों लेबल वाले कम-से-कम 100 अंश आवश्यक किए गए, किसी अनुकूल प्रतिशत की सीमा के बिना. आबादी का विश्वास-अंतराल, सांख्यिकीय सार्थकता परीक्षण, स्वतंत्रता का दावा या सटीकता का अनुमान नहीं दिया गया.
- पहले से तय ब्लॉक-घटना वाली संवेदनशीलता जाँच ने ठीक 10 आकलन वाला वही नियम लिया और मुख्य यादृच्छिक समूह से अलग रही. उसकी 5 गिनतियाँ थीं: 20,911 में इन दोनों लेबलों में से कोई नहीं, 959 में उद्धरण/वर्णन लेकिन संबोधित व्यक्ति पर हमला नहीं, 18,056 में संबोधित व्यक्ति पर हमला लेकिन उद्धरण/वर्णन नहीं, 1,354 में एक ही समीक्षक से दोनों और 1,103 में केवल अलग समीक्षकों से दोनों; कुल 42,383, सशर्त हर 2,457. मुख्य यादृच्छिक समूह से 2016 हटाने पर 13,809 अंश रहे, जिनकी 5 गिनतियाँ उसी क्रम में 12,012 / 406 / 1,236 / 98 / 57 थीं. उसके 155 सशर्त अंश और 98/57 का विभाजन नहीं बदले. ये वर्णनात्मक जाँचें हैं, आबादी की स्वतंत्र पुनरावृत्तियाँ या नमूना समूहों के तुलनीय होने का प्रमाण नहीं.
- Wulczyn, Thain और Dixon के 2017 के Ex Machina: Personal Attacks Seen at Scale ने मूल क्राउडसोर्सिंग और मॉडलिंग का काम स्थापित किया. Cécillon और सहयोगियों के 2020 के WAC शोधपत्र ने वर्कर और फ़ील्ड की मैट्रिक्स रखी और हमले के फ़ील्ड अलग-अलग बहुमत से जोड़े. ये पहले से मौजूद विधियाँ हैं, इस अध्ययन से स्थापित गलतियाँ नहीं. हमारी तुलना 10 में किसी के लेबल चुनने और उसी जवाब में जोड़ी पर है, बहुमत लेबल के प्रदर्शन पर नहीं. Influence IQ की तुलना गिनती है कि हर चुने अंश में 2 विकल्प उसी समीक्षक ने दिए या केवल अलग समीक्षकों ने.
- स्रोत का विवरण 2001–2015 और मूल शोधपत्र 2004–2015 बताता है; तय संस्करण 6 की फ़ाइलों में वर्ष 2001–2016 हैं. निर्माता की स्कीमा में लॉग-इन स्थिति के लिए 0/1 है, जबकि जारी फ़ाइल False/True लेती है; बाइनरी फ़्लैग स्ट्रिंग 0.0/1.0 हैं. हमने दस्तावेज़ और देखे गए पाठ के ये अंतर किसी कारण का दावा किए बिना बनाए रखे. पार्सर जारी किए गए ठीक इन्हीं मानों को स्वीकार करता है, बिना लेबल मान राउंड किए या जबरन दूसरे रूप में बदले. पैकेज स्रोत संस्करण, चयन नियम और सार्वजनिक फ़ाइलों से विश्लेषण दोहराने के चरण बताता है.
- 2 काल्पनिक 10-व्यक्ति समीक्षा समूह, समीक्षक A/B के जवाब और काम सौंपने के विकल्प सिखाने के उदाहरण हैं. इनमें डेटासेट का मूल चर्चा-पाठ या पहचानकर्ता नहीं हैं. दोनों काल्पनिक समूहों में उद्धरण/वर्णन का 1 चयन और संबोधित व्यक्ति पर हमले का 1 चयन है, लेकिन केवल पहले में एक ही व्यक्ति की जोड़ी है. वर्कशीट और वैचारिक चित्र व्यावहारिक व्याख्याएँ हैं, स्रोत में देखी प्रक्रियाएँ, परखी गई मॉडरेशन नीतियाँ या बेहतर फ़ैसलों की गारंटी नहीं.
हर भाषा का अनुवाद सीधे अंग्रेज़ी स्रोत से किया गया है. हर संस्करण उसी ऐतिहासिक अंग्रेज़ी Wikipedia डेटासेट और चुने हुए आकलनों का वर्णन करता है. अनुवाद स्थानीय बाज़ार के निष्कर्ष नहीं बनाता. विश्लेषण, व्याख्या और अनुवाद की ज़िम्मेदारी Influence IQ की है.